Note de l’auteur : en partant de la conception du super-agent DeepSeek, nous examinons comment répartir les modèles entre router et workers dans un système multi-agent, et comment les tokens lus dans le cache influencent le coût de l’architecture.
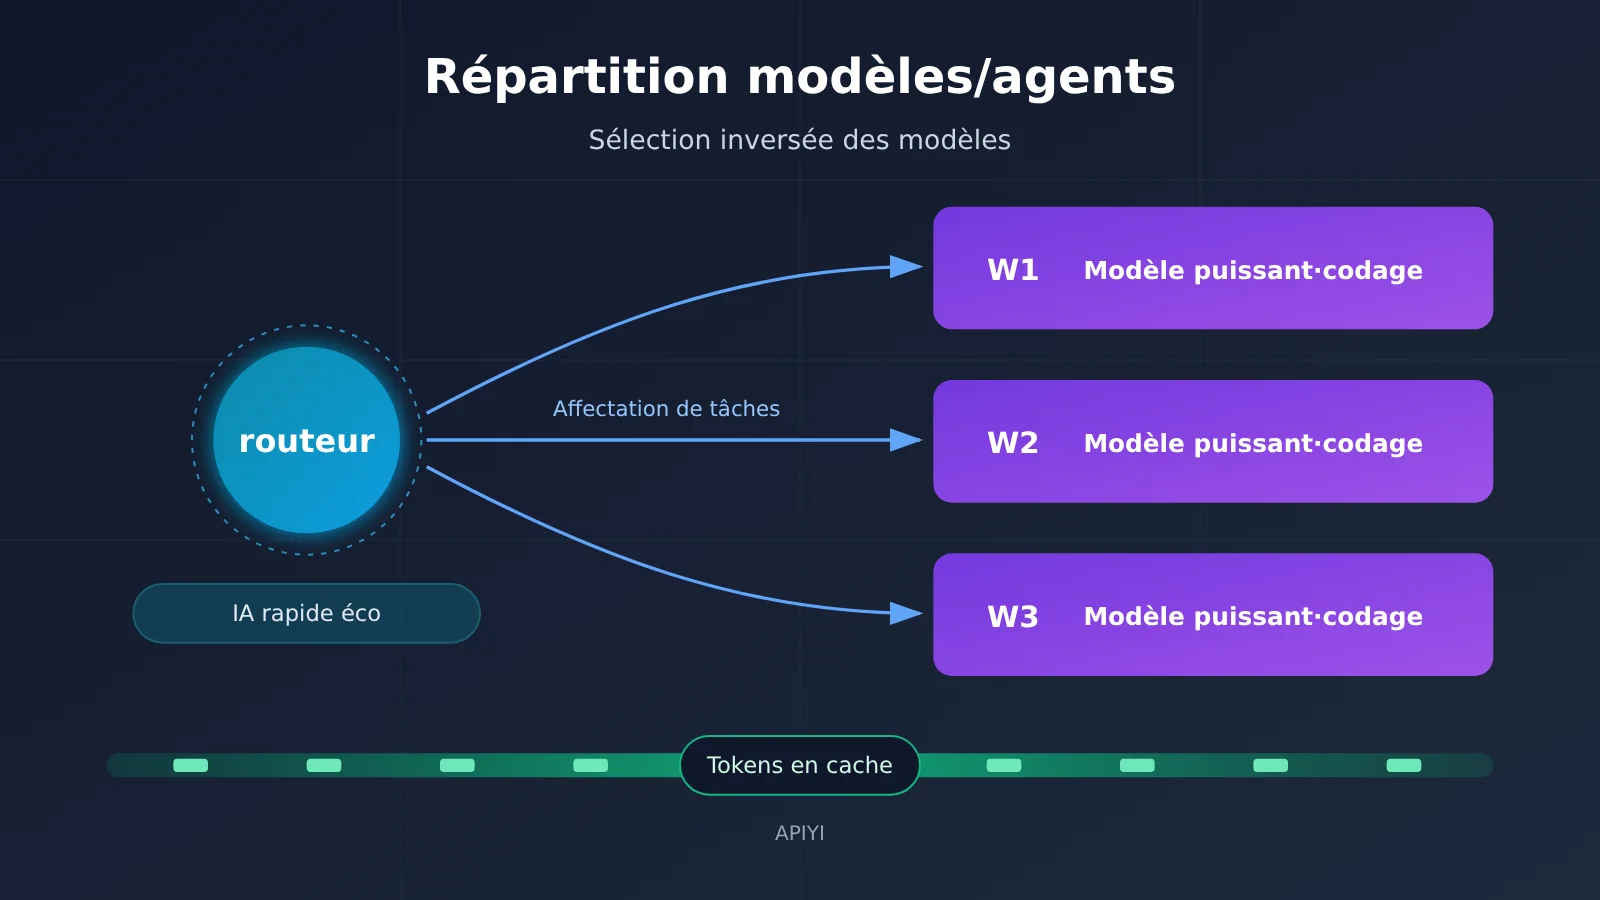
Quand on construit un système de codage multi-agent, on a souvent tendance à confier le rôle de « commandant en chef » au modèle le plus puissant, puis à utiliser des modèles moins chers pour les exécutants. La conception du super-agent présentée par l’équipe DeepSeek Harness en novembre 2026 propose l’inverse : un modèle économique pour le router, un modèle puissant pour les workers. Le router, chargé du dialogue et de la répartition des tâches, utilise un modèle léger ; les workers, qui écrivent le code, utilisent le modèle le plus puissant.
Cet article ne se contente pas de relayer une annonce. Nous transformons cette architecture en critères concrets de sélection des modèles : quelles capacités faut-il au router et aux workers ? Comment estimer les tokens lus dans le cache ? Quand choisir un modèle économique ? DeepSeek qualifie lui-même les données de test citées ici de résultats « indicatifs » : nous en préciserons les limites.
Ce que vous allez en retirer : à la fin de cet article, vous pourrez définir une répartition des modèles par rôle pour votre propre système multi-agent et estimer son ordre de grandeur en coût à partir du volume de lectures dans le cache.
Points clés de l’attribution des modèles multi-agents
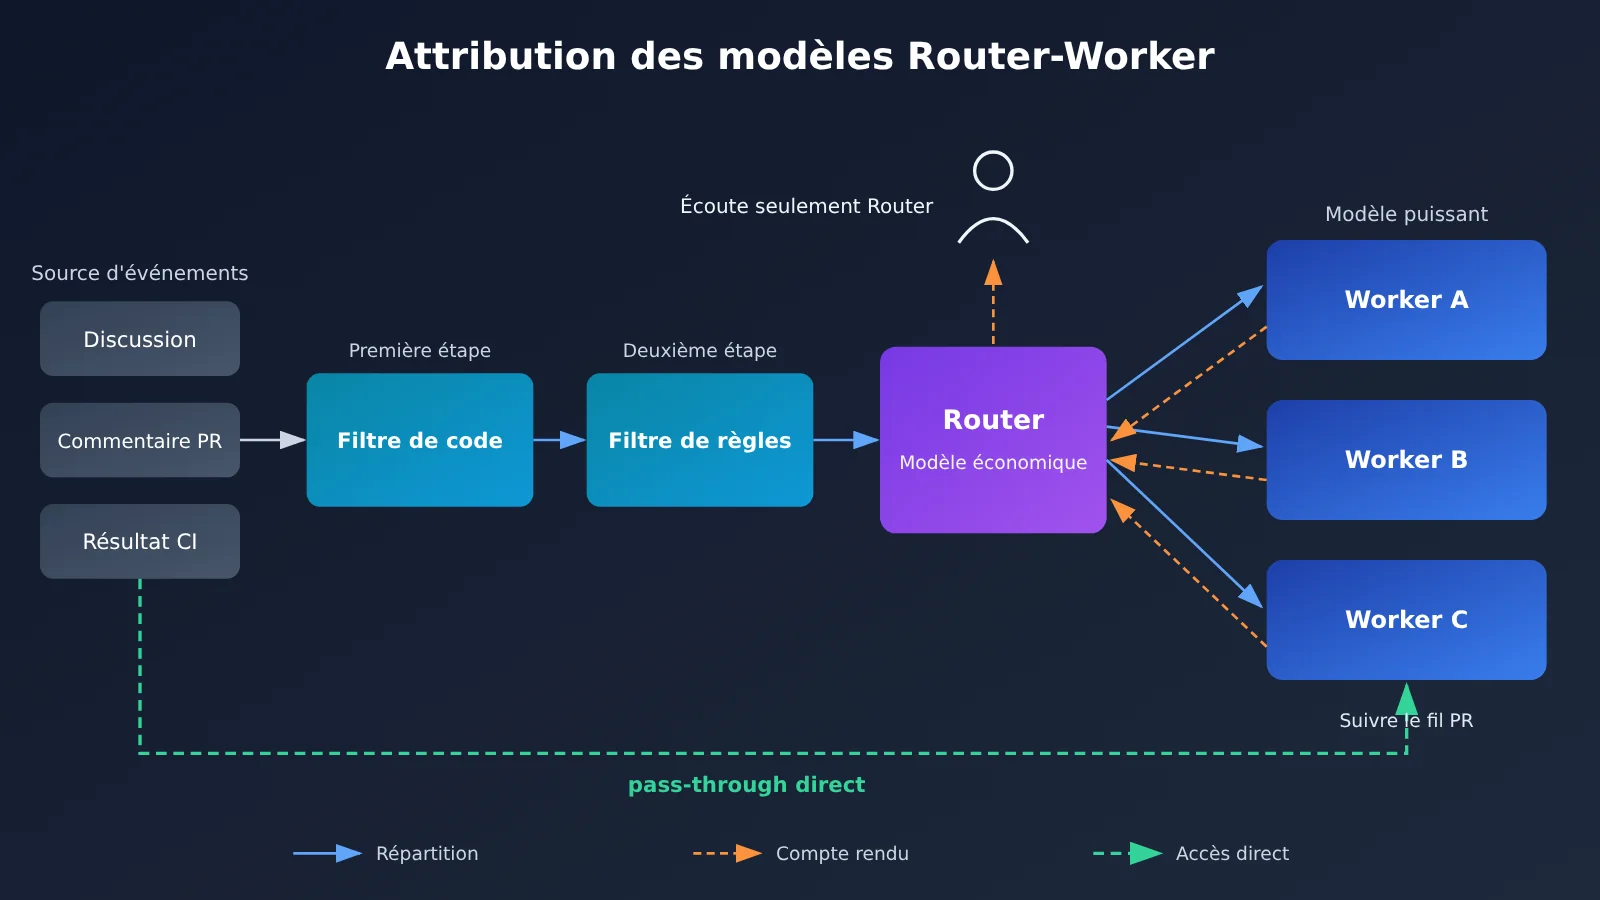
La conception de DeepSeek repose sur deux niveaux. Le router est une session persistante qui communique avec l’utilisateur, distribue les tâches et suit les relations entre elles. Chaque worker ne prend en charge qu’une tâche à la fois, dispose de son propre contexte vierge et ne dialogue jamais directement avec l’utilisateur : il rend compte uniquement au router. Le tableau ci-dessous pose les bases de l’attribution des modèles selon cette répartition.
| Rôle | Responsabilité principale | Écrit du code | Niveau de modèle recommandé | Justification |
|---|---|---|---|---|
| router | Dialogue, distribution des tâches et suivi de leurs relations | Non, il peut fonctionner sans accès au shell | Léger, économique et rapide | Le travail est simple mais les appels sont fréquents : la latence et le coût unitaire comptent davantage |
| worker | Prise en charge d’une tâche et réalisation du code | Oui | Le modèle de codage le plus performant disponible | La qualité du code détermine directement le résultat livré |
| Couche de filtrage des déclencheurs | Élimination du bruit dans les discussions de groupe et les notifications CI | Non | Du code ordinaire au premier niveau, puis un petit modèle au second | La plupart des événements n’ont pas besoin d’être transmis à un modèle |
Pourquoi « inverser » l’attribution des modèles multi-agents
Selon DeepSeek, le facteur limitant du codage assisté par IA n’est plus la capacité des modèles, mais l’attention humaine. Une personne ne peut généralement suivre que 3 à 5 sessions d’agents actives en même temps. Au-delà, il devient difficile de savoir laquelle attend une approbation, laquelle est bloquée ou encore quelles sont les deux sessions qui modifient discrètement la même PR. La valeur du router ne réside donc pas dans son « intelligence », mais dans sa capacité à distribuer les tâches et à en assurer le suivi de manière fiable. Il ne décompose pas les tâches : il se contente de les attribuer et de les suivre, contrairement au modèle courant où un « agent principal » découpe le travail en étapes.
Puisque le router n’a pas besoin de raisonnement approfondi et n’écrit pas de code, lui attribuer le modèle le plus cher serait du gaspillage. C’est le worker qui produit le code, et la qualité de celui-ci détermine le succès ou l’échec de la livraison : c’est donc là qu’il faut consacrer le budget aux modèles puissants. Voilà ce que signifie « inverser le choix des modèles » : plus un rôle est proche de l’utilisateur, plus le modèle est léger ; plus il est proche du code, plus le modèle est puissant.
Quelles capacités faut-il pour le router et les workers ?
Pour choisir les bons modèles, il faut décomposer les responsabilités de chaque rôle en capacités. La liste ci-dessous peut servir directement à évaluer les modèles candidats.
| Capacité | Exigences pour le router | Exigences pour le worker | Conseil de sélection |
|---|---|---|---|
| Suivi des instructions et classification | Élevées : doit classer les tâches de façon fiable | Moyennes | Pour le router, tester en priorité la précision de la répartition |
| Contexte long et retour sur l’historique | Moyennes : développement progressif à partir de résumés par ID | Élevées : doit lire beaucoup de code | Pour le worker, examiner la fenêtre de contexte et les capacités de recherche dans le code |
| Qualité de génération du code | Non nécessaire | Priorité absolue | Ne pas lésiner sur le budget du worker |
| Latence de réponse | Priorité élevée : prend fréquemment des décisions | Moyenne : une tâche individuelle peut prendre plus de temps | Choisir un modèle rapide de type Flash pour le router |
| Sensibilité au prix unitaire | Très élevée : volume de lecture du cache considérable | Moyenne | Le prix unitaire du router pèse sur la facture totale |
| Appel d’outils | Limité : l’accès au shell peut être supprimé | Important : doit exécuter du code et des tests | Délimiter les permissions de chaque rôle |
Une exigence du router passe facilement inaperçue : son architecture doit l’empêcher de « mettre lui-même les mains dans le code ». DeepSeek l’a volontairement privé d’accès au shell pour éliminer cette possibilité. Lors du choix du modèle, inutile donc de chercher un router « capable de tout faire » : mieux vaut accepter qu’il « ne sache que distribuer le travail ».
Coût des tokens lus en cache dans la répartition des modèles entre agents
Un router peu coûteux ne suffit pas : dans cette architecture, le principal poste de dépense est la lecture des tokens en cache. Le router maintient une session longue et relit régulièrement le contexte en cache, tandis que plusieurs workers s’exécutent en parallèle et lisent chacun une grande quantité de contexte. Les résultats des tests de DeepSeek montrent clairement l’ampleur du problème.
| Indicateur | Valeur | Précision |
|---|---|---|
| Nombre de messages par tour | Environ 300 | Dont environ 20 véritables demandes de travail |
| Temps moyen d’exécution du super-agent | 12,4 minutes | Jusqu’à 15,7 minutes pour les cas les plus lents |
| Temps de référence en session unique pour les cas les plus lents | 29,5 minutes | Utilisé comme point de comparaison |
| Charge de décision du router | D’environ 1 à environ 40 décisions par minute | Le temps par décision passe de 6,4 à 1,6 seconde |
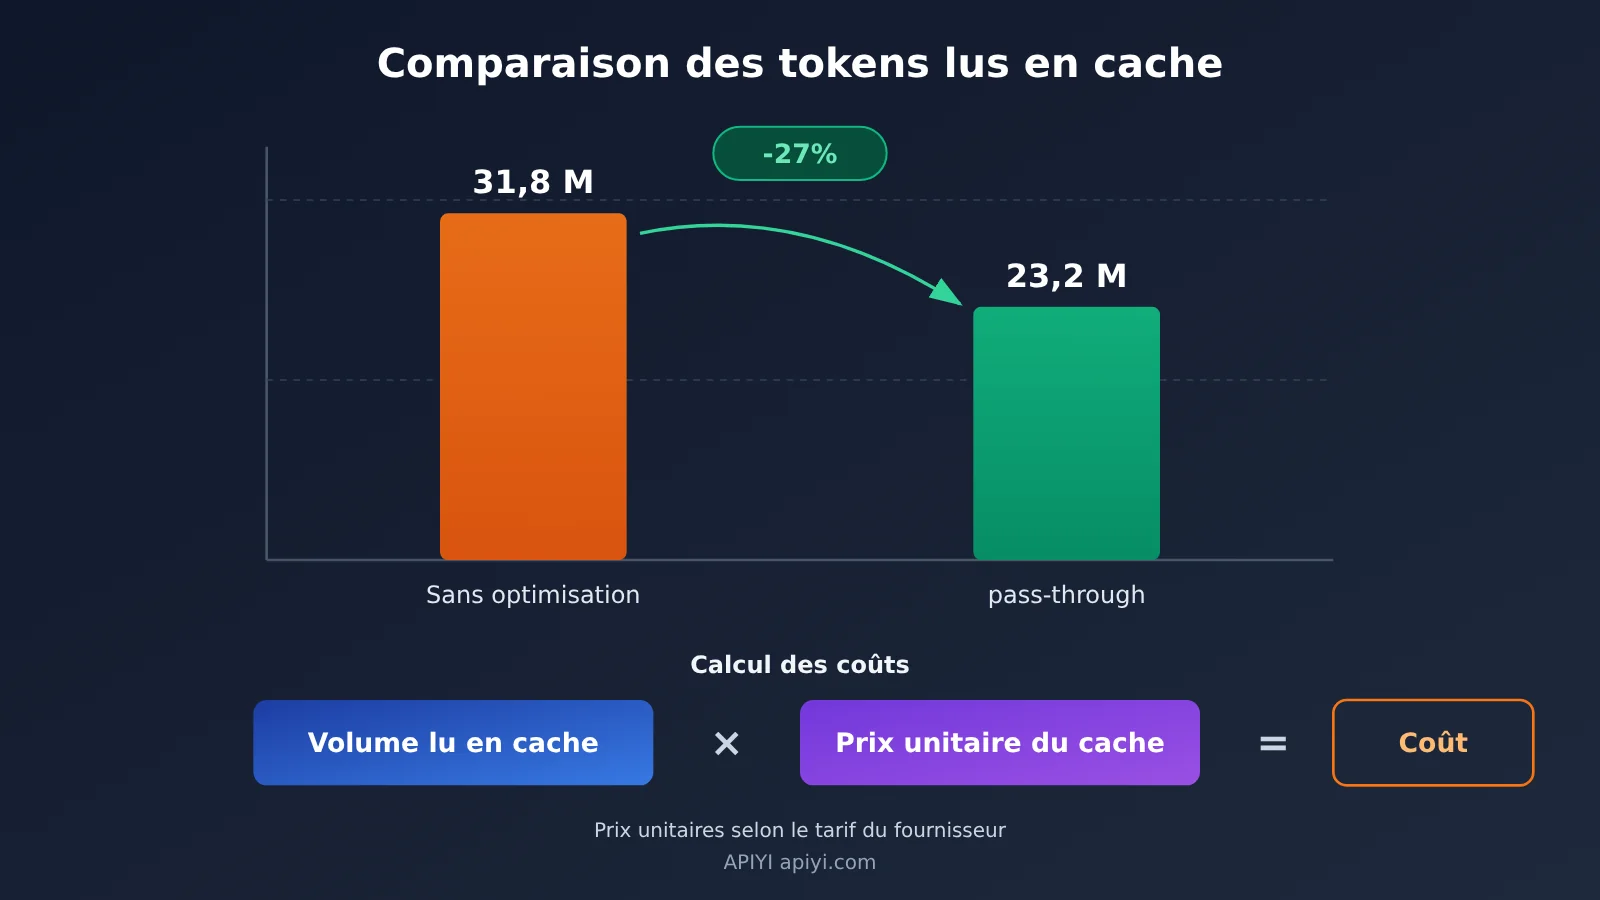
| Tokens lus en cache | 23,2 millions | Avec l’optimisation pass-through activée |
| Tokens lus en cache sans optimisation | 31,8 millions | Lorsque les workers ne s’abonnent pas directement aux fils de discussion |
| Coût du cache | Environ 7 dollars | Selon le tarif Flash de DeepSeek en heures creuses |
Comment estimer le coût d’une allocation de modèles multi-agents à partir des lectures de cache
Pour estimer le coût d’une exécution, on peut le décomposer en trois parties : le nombre de tokens lus depuis le cache multiplié par leur prix unitaire, plus les tokens d’entrée non trouvés dans le cache multipliés par le prix d’entrée, plus les tokens de sortie multipliés par le prix de sortie. Dans une architecture router-worker, la première partie représente souvent de loin la plus grande part du coût. C’est donc le prix de lecture du cache qu’il faut surveiller en priorité lors du choix d’un modèle.
En partant des chiffres rapportés : environ 7 dollars pour 23,2 millions de tokens lus depuis le cache représentent à peu près 0,3 dollar par million de tokens. Il s’agit uniquement d’une estimation déduite des chiffres rapportés, pas d’un tarif officiel : consultez la grille tarifaire actuelle du fournisseur pour connaître le prix réel. Avec cet ordre de grandeur, vous pouvez comparer les prix de lecture du cache des modèles envisagés et voir rapidement combien coûterait la même charge de travail avec un modèle plus cher.
L’optimisation pass-through mérite aussi qu’on s’y attarde. Une fois que le worker s’abonne au fil, les nouveaux événements lui sont transmis directement, sans passer par le router. Le volume de lecture du cache passe ainsi de 31,8 à 23,2 millions de tokens, soit une baisse d’environ 27 %. Autrement dit, optimiser l’architecture peut réduire directement la facture, tout comme choisir un modèle moins cher.
Trois limites à garder en tête sur les données d’origine
- L’étape de codage est simulée : pendant le test, l’écriture du code est remplacée par un outil qui consomme uniquement du temps. Le test mesure donc l’ordonnancement, pas la qualité du code. Il ne permet pas de déterminer quel modèle est le plus efficace pour le worker.
- Les données sont indicatives : DeepSeek précise que ces chiffres sont donnés à titre indicatif et ne constituent pas un benchmark rigoureux.
- La comparaison avec la gamme Sonnet est contradictoire : le résumé du compte rendu estime le coût à environ 4,64 dollars avec un modèle de la gamme Sonnet, tandis que le corps de l’article indique que le même usage serait « nettement plus cher » dans une gamme haut de prix. Mieux vaut ne pas citer cette comparaison précise avant de l’avoir vérifiée dans l’article original de DeepSeek.
Premiers pas pour répartir les modèles entre plusieurs agents
Pour appliquer cette logique à votre système, vous pouvez suivre les étapes ci-dessous. Pas de code ici : tous les paramètres sont présentés directement dans le texte, pour faciliter leur adaptation à votre framework.
- Définissez les rôles avant de choisir les modèles : listez tous les rôles de votre système qui invoquent un modèle. Distinguez au minimum le router, le worker et le filtre de déclenchement, puis précisez pour chacun s’il écrit du code et s’il a besoin d’outils.
- Faites du nom du modèle un paramètre de configuration : définissez séparément pour chaque rôle des paramètres comme
router_model,worker_modeletfilter_model, plutôt que d’inscrire les noms des modèles en dur dans le code métier. - Garantissez la délégation par la structure : retirez au router les outils d’exécution comme le shell. L’expérience de DeepSeek montre qu’avec une invite neutre, un agent à session unique n’a délégué aucune des 5 exécutions, la plus lente ayant pris près d’une demi-heure. Même lorsque l’invite demandait explicitement de déléguer, l’agent a estimé dans 1 cas sur 5 que la tâche était trop petite et l’a exécutée lui-même.
- Filtrez en amont : utilisez d’abord du code classique pour écarter les événements inutiles selon leur source et une liste d’autorisation. Ne transmettez ensuite au modèle que les événements retenus, pour qu’il les évalue selon les règles de l’équipe.
- Consignez les lectures depuis le cache : à chaque exécution, enregistrez trois catégories de tokens : lectures depuis le cache, entrées non mises en cache et sorties. Utilisez ensuite la formule présentée plus haut pour calculer le coût de chaque exécution.
- Comparez les modèles : conservez le même ensemble de tâches et remplacez uniquement
router_model. Observez les variations de précision dans la répartition, de latence et de coût avant de décider s’il faut passer à une gamme inférieure.
Aux étapes 2 et 6, le mode d’intégration a un effet direct sur l’efficacité des tests. Si le router et le worker viennent de fournisseurs différents, chacun avec sa propre clé et sa configuration SDK, chaque changement peut demander de nombreuses modifications. Avec une plateforme à interface unifiée comme APIYI apiyi.com, vous pouvez utiliser la même clé API et le même format de requête compatible OpenAI, puis modifier uniquement le paramètre model pour attribuer au router et au worker des modèles de fournisseurs différents. Les comparaisons demandent ainsi beaucoup moins d’efforts.
🚀 Conseil pour démarrer : pour valider un prototype, configurez d’abord les modèles du router et du worker sur APIYI apiyi.com avec la même clé. Exécutez ensuite le même ensemble de tâches et consignez la consommation de tokens. Pour connaître les modèles disponibles, notamment ceux de la gamme Flash de DeepSeek, consultez la liste actuelle de la plateforme.
Quand choisir un modèle économique dans une architecture multi-agents
Un modèle économique ne convient pas à tous les rôles. Le tableau ci-dessous vous aide à déterminer lesquels peuvent utiliser un modèle moins coûteux.
| Caractéristiques du scénario | Recommandation | Raison | Mode d’accès |
|---|---|---|---|
| Le rôle se limite à la répartition, au suivi et à la vérification du contexte en cache | Choisir un modèle rapide et économique | La tâche est simple : le prix unitaire et la latence déterminent l’expérience | APIYI apiyi.com ou API officielle du fournisseur |
| Le rôle génère et modifie du code | Choisir un modèle performant | La qualité du code détermine celle du résultat livré | APIYI apiyi.com ou API officielle du fournisseur |
| Le volume de lecture du cache atteint plusieurs dizaines de millions et l’exécution se répète chaque jour | Réduire en priorité le prix unitaire de lecture du cache | Le coût du cache augmente linéairement avec le nombre d’exécutions | Calculer les coûts d’après la grille tarifaire du fournisseur |
| Tâche ponctuelle et légère | Opter pour une facturation à l’usage | Le volume est trop faible pour justifier une architecture plus complexe | Tout service facturant à l’usage |
| Tâche automatisée fréquente et gourmande en tokens | Évaluer un abonnement mensuel ou une offre à limites élevées | Le coût marginal de chaque exécution ne se répercute plus sur la facture | Selon les conditions de l’abonnement |
Pour illustrer la dernière ligne, Claude Code Pass était proposé, selon un article publié à la même période, à 9,99 dollars par mois. L’offre prévoyait des limites de débit environ 2 à 5 fois plus élevées pour des modèles ouverts comme Kimi K3.1 Pro, GLM 5.3 et DeepSeek V4.1 Flash, ainsi que trois plafonds d’utilisation : sur 5 heures, par semaine et par mois. L’article estimait aussi qu’un modèle rapide et économique était techniquement plus adapté aux étapes limitées aux décisions de routage ou à la vérification du contexte en cache, et pas seulement moins cher. Ce type d’offre vous limite toutefois aux modèles inclus dans le forfait : si un worker dépend d’un modèle extérieur, il lui faut un autre mode d’accès.
Risques et limites de la répartition des modèles entre agents
La répartition des modèles répond aux questions de coût et de partage des tâches, mais elle ne résout pas les problèmes encore ouverts de cette architecture. DeepSeek en reconnaît deux : d’abord, la mémoire à long terme. Après plusieurs mois de fonctionnement, conserver l’historique pertinent sans saturer la fenêtre de contexte reste difficile. Ensuite, l’injection d’invites : tout agent qui lit des événements externes, comme des discussions de groupe ou des commentaires sur une PR, peut être manipulé. Or, le routeur et les workers sont reliés par une boucle partagée dans le cloud : une source d’événements compromise pourrait théoriquement propager des instructions à toutes les machines auxquelles le système accède.
Cela a un impact direct sur la répartition des modèles. Utiliser un modèle peu coûteux pour le routeur ne signifie pas qu’on peut relâcher sa protection : c’est précisément lui qui entre en premier en contact avec les événements externes. Lors de son déploiement interne, DeepSeek a d’abord fait fonctionner les comportements proactifs en mode journalisation, en consignant « ce qui aurait été fait » sans exécuter les actions immédiatement. Prenons la stratégie de « reproduction et correction silencieuses » : lorsqu’un bug est signalé, l’agent tente de le reproduire en arrière-plan. S’il le confirme et le corrige, il soumet une PR pendant que la conversation est encore en cours ; s’il ne parvient pas à le reproduire, il ne publie rien. Pour un nouveau système, il est plus prudent d’observer d’abord les journaux, puis d’accorder progressivement davantage d’autonomie.
Enfin, le prototype DSH Super Agent est clairement présenté sur GitHub comme un code de recherche, et non comme un produit finalisé. On peut s’inspirer de sa conception, mais il n’est pas recommandé de le déployer directement en production.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que l’« inversion du choix des modèles » dans un système multi-agents ?
Le router utilise un modèle léger et économique, tandis que le worker utilise le modèle le plus performant. Le router se contente de dialoguer, de répartir et de suivre les tâches : il n’écrit pas de code. C’est le worker qui s’occupe du développement. Il est donc préférable de consacrer le budget du modèle puissant au worker plutôt qu’au « chef d’orchestre ».
Q2 : Quelle est la différence entre l’architecture router-worker et un agent principal qui décompose les tâches ?
Dans le second cas, l’agent principal doit décomposer la tâche en étapes, ce qui exige de meilleures capacités de raisonnement. Le router de DeepSeek ne décompose rien : il se contente d’attribuer et de suivre les tâches. Il peut donc utiliser un modèle plus léger. En contrepartie, le worker doit être capable de mener chaque tâche à bien de manière autonome.
Q3 : Quand cette conception a-t-elle été rendue publique ? Peut-on utiliser DSH Super Agent directement ?
L’article qui la présente a été publié le 3 novembre 2026. DSH Super Agent est un prototype de recherche publié sur GitHub en même temps que l’article. Ses auteurs précisent qu’il ne s’agit pas d’un produit pris en charge et qu’il sert uniquement à comprendre l’architecture.
Q4 : Peut-on apprendre à un agent unique à déléguer uniquement à l’aide d’invites ?
Les tests de DeepSeek montrent que ce n’est pas fiable : avec une invite neutre, aucune délégation n’a eu lieu sur cinq exécutions. Même avec une invite insistant sur la délégation, une exécution n’a donné lieu à aucune délégation. Pour déléguer de manière fiable, il faut une séparation structurelle, par exemple en divisant les sessions et en retirant les outils d’exécution, plutôt que de rédiger des invites plus longues.
Q5 : Comment configurer facilement des modèles de différents fournisseurs pour le router et le worker dans un même système ?
L’essentiel est de configurer le nom du modèle séparément pour chaque rôle et d’uniformiser le mode d’accès :
1. Inscrivez-vous sur APIYI apiyi.com et obtenez une clé API
2. Dans la configuration du système, définissez séparément le paramètre `model` du router et celui du worker
3. Gardez le même format de requête et changez uniquement le nom du modèle pour comparer les résultats
Vous évitez ainsi de gérer une configuration SDK distincte pour chaque fournisseur. Consultez la liste actuelle de la plateforme pour connaître les modèles disponibles.
Q6 : Peut-on utiliser directement les données de coût de l’article original pour établir un budget ?
Ce n’est pas recommandé. La phase de développement est simulée, les données sont seulement indicatives et les comparaisons de prix avec la gamme Sonnet ne sont pas cohérentes d’un passage à l’autre. Il vaut mieux mesurer les lectures de cache sur vos propres tâches, puis multiplier le résultat par le tarif actuel. Sur APIYI apiyi.com, exécutez les mêmes tâches avec différents modèles pour obtenir des données adaptées à votre cas.
Q7 : Quelles sont les limites connues de cette architecture ?
Il y en a trois principales : la dégradation de la mémoire après une longue période de fonctionnement ; les risques d’injection d’invite liés à la lecture d’événements externes ; et le volume important de tokens lus depuis le cache, qui peut faire grimper les coûts avec un modèle cher. Par ailleurs, il manque actuellement des données sur les performances selon le modèle utilisé par le router : il faut donc faire ses propres tests.
Points clés de l’attribution des modèles dans un système multi-agents
- Inverser le choix des modèles : un modèle léger et peu coûteux pour le router, un modèle puissant pour les workers qui écrivent le code.
- L’attention est le goulot d’étranglement : une personne ne peut généralement suivre que 3 à 5 sessions à la fois ; le router centralise les échanges.
- La délégation passe par la structure : retirer au router ses outils d’exécution est bien plus fiable que de modifier l’invite.
- Le cache pèse lourd dans les coûts : une série de tests a atteint 23,2 millions de tokens lus depuis le cache ; le prix unitaire est donc déterminant.
- L’optimisation de l’architecture réduit aussi les coûts : une transmission directe en pass-through a réduit les lectures du cache d’environ 27 %.
- Les données sont à citer avec prudence : le codage était simulé, les résultats ne sont qu’indicatifs et la comparaison des prix reste à vérifier.
- Une interface unifiée facilite les tests : avec APIYI apiyi.com, il suffit de modifier le paramètre
modelpour comparer différentes répartitions.
Bilan
Un modèle peu coûteux pour le router, un modèle puissant pour les workers : voici les principes essentiels de cette répartition multi-agents :
- Choisir selon le rôle : un modèle rapide et économique pour l’agent qui répartit et suit les tâches sans écrire de code ; un modèle puissant pour les agents de codage.
- Calculer les coûts en fonction du cache : les tokens lus depuis le cache représentent la principale dépense de cette architecture. Comparez donc en priorité leur prix unitaire.
- Décider à partir des tests : les données de l’article original donnent seulement une indication. Pour trancher, mesurez les coûts et les résultats sur vos propres tâches.
Commencez par créer un prototype router-worker avec un petit ensemble de tâches, en configurant le nom du modèle pour chaque rôle. Remplacez ensuite progressivement le modèle du router pour observer l’évolution de la précision de répartition et des coûts. Vous pouvez utiliser APIYI apiyi.com pour accéder aux modèles de plusieurs fournisseurs avec une seule clé et mener cette comparaison à partir de vos propres données.
📚 Ressources
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding : analyse de la conception du super-agent de DeepSeek
- Lien :
mindstudio.ai/blog/deepseek-super-agent-harness-design -
Contenu : architecture routeur-worker, expériences de délégation, données sur les tokens mis en cache et questions en suspens
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan : analyse de la formule mensuelle à limites élevées
- Lien :
mindstudio.ai/blog/claude-code-pass-pricing - Contenu : compromis entre facturation à l’usage et abonnement mensuel pour les workflows multi-agents gourmands en tokens
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI, apiyi.com, pour discuter de l’attribution des modèles dans les systèmes multi-agents. Vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com.