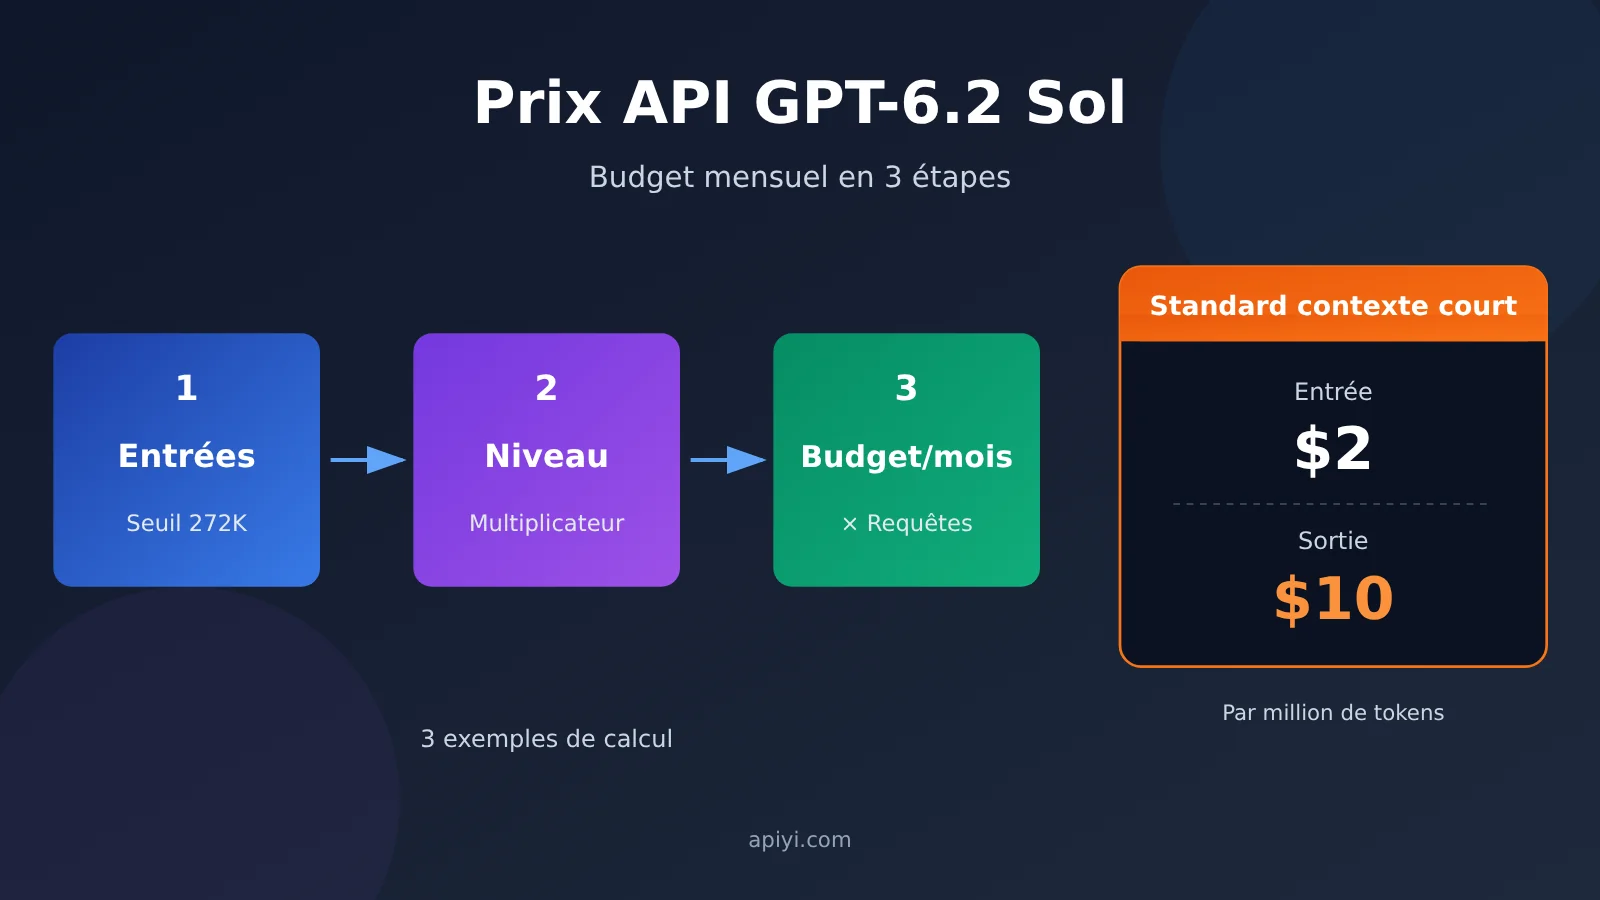
Le coût d’un appel à l’API GPT-6.2 Sol se détermine en trois étapes. La première consiste à examiner le volume total d’entrée d’une requête, avec un seuil de 272K tokens pour distinguer le contexte court du contexte long : au-delà de ce seuil, les tarifs d’entrée et de cache de toute la requête sont multipliés par 2, et ceux de sortie par 1,5. La deuxième étape consiste à choisir le niveau de service selon le délai de livraison : Standard correspond au tarif de référence, Batch applique une réduction de 50 %, les fenêtres en arrière-plan 8h et 2h sont facturées respectivement à 60 % et 70 % du tarif de référence, Fast est facturé 2 fois ce tarif, et Ultrafast 3 fois avant le 2027-02-28 (heure du Pacifique), puis 6 fois après cette date. La troisième étape multiplie le coût d’une requête par le nombre de requêtes mensuelles, puis ajoute les coûts liés aux appels d’outils, aux éventuels frais régionaux applicables et aux nouvelles tentatives.
Pour le contexte court en Standard, les tarifs affichés sont les suivants : entrée normale à $2.00 par million de tokens, lecture du cache à $0.10, sortie (y compris les tokens de raisonnement) à $10.00. À ce tarif, une requête interactive avec 20 000 tokens en entrée et 3 000 en sortie coûte environ $0.07, soit environ $140 pour 2 000 requêtes par mois. Dans cet article, tous les prix sont exprimés en dollars par million de tokens ; la date de vérification est le 2026-11-20 (heure de Pékin).
Carte des connaissances tarifaires et index de lecture de l’API GPT-6.2 Sol
L’ensemble de l’article se déroule dans l’ordre suivant : évaluation du volume d’entrée → choix du niveau selon le délai de livraison → appels cumulés. Le tableau ci-dessous regroupe, pour chaque étape, la question à laquelle il faut répondre, le résultat produit et le numéro de section correspondant dans le corps du texte. Le résultat d’une section sert d’entrée à la suivante.
| Étape | Question à laquelle répondre | Résultat de cette étape | Numéro de section |
|---|---|---|---|
| Évaluation du volume d’entrée | Cette requête relève-t-elle d’un contexte court ou d’un contexte long | Grille tarifaire de base applicable | 1, 3.2 |
| Choix du niveau selon le délai de livraison | L’utilisateur attend en ligne, ou la livraison peut se faire quelques heures plus tard, voire le lendemain | Multiplicateur du niveau de service | 2, 3.1 |
| Appels cumulés | Combien de requêtes par mois, et quelles autres dépenses accessoires | Budget mensuel | 2, 4 |
| Recalcul par canal | Si l’on change de canal de facturation, combien coûte la même requête | Comparatif des canaux et tableau budgétaire | 4 |
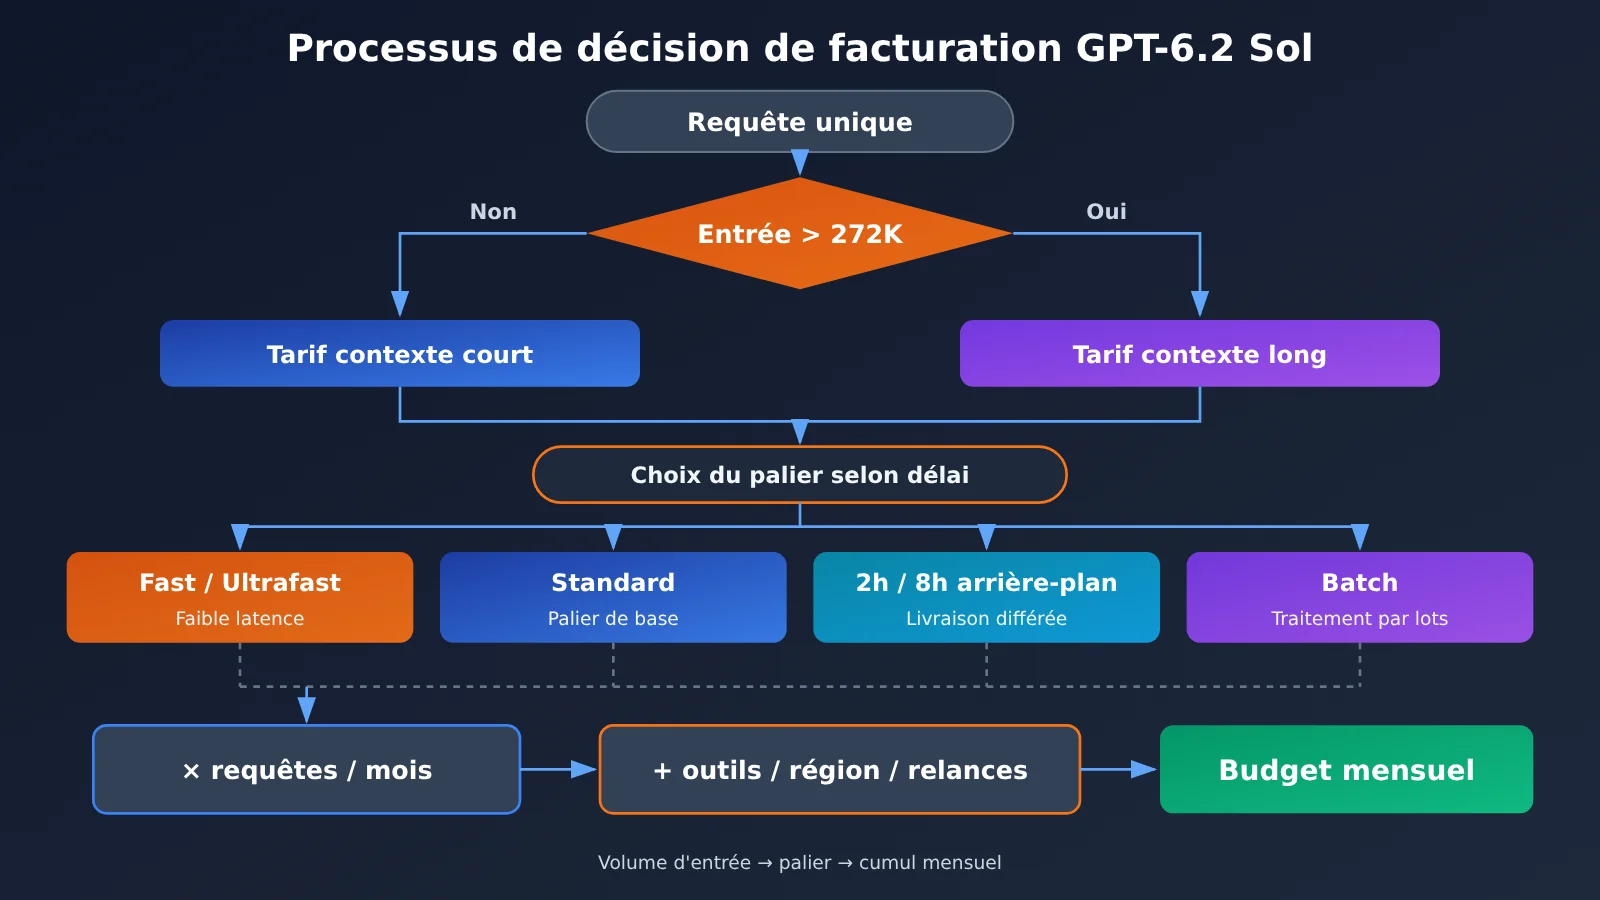
Côté ordre de lecture, la section 1 présente les tarifs de base, qui servent de fondement à tous les exemples de calcul qui suivent. Les sections 2 et 3 correspondent respectivement à deux types d’activité : « l’utilisateur attend le résultat en ligne » et « la livraison peut être différée ». Vous pouvez donc ne lire que la section qui vous concerne. La section 4 applique les méthodes présentées plus haut aux tarifs publics d’APIYI apiyi.com et aux tarifs officiels d’OpenAI, en menant les calculs en parallèle, puis fournit un tableau de budget mensuel que vous pouvez remplir directement.
Terminologie de facturation de GPT-6.2 Sol à connaître
| Terme | Explication |
|---|---|
| Token | Unité de base servant à mesurer le texte et les autres entrées/sorties du modèle ; les quantités font foi selon les statistiques renvoyées par le serveur |
| Standard | Niveau de traitement standard de l’API officielle, qui sert aussi de base de tarification pour les multiplicateurs des autres niveaux |
| Lecture du cache | Lorsqu’une requête réutilise un préfixe historique déjà mis en cache, cette partie de l’entrée est facturée au tarif de lecture du cache |
| Écriture du cache | Catégorie de facturation distincte pour conserver un préfixe éligible en vue d’une réutilisation ultérieure, avec deux paliers : 30 minutes et 12 heures |
| Sortie facturée | Volume de sortie comptabilisé par l’API, incluant les tokens de raisonnement et la sortie finale |
| Batch API | Interface permettant de soumettre à un traitement par lots en arrière-plan des requêtes indépendantes préparées à l’avance, sous forme de fichier |
| Fenêtre d’achèvement | Délai cible fixé pour la réponse initiale, une fois la requête en arrière-plan acceptée |
| Fast et Ultrafast | Deux niveaux à tarif élevé destinés aux scénarios à faible latence |
1. Quels sont les tarifs d’une requête à l’API GPT-6.2 Sol ?
1.1 Les cinq catégories de facturation du niveau Standard
L’ID de modèle API de GPT-6.2 Sol est gpt-6.2-sol, et il peut être appelé via deux points de terminaison : Responses et Chat Completions. Une requête peut concerner jusqu’à cinq catégories de facturation. Le tableau ci-dessous présente les tarifs officiels du niveau Standard. Le tarif de base en contexte court est identique à celui de GPT-6.1 Sol ; la colonne contexte long est calculée selon les multiplicateurs indiqués sur la fiche du modèle.
| Catégorie de facturation Standard | Contexte court (entrée ≤ 272K) | Contexte long (entrée > 272K) |
|---|---|---|
| Entrée normale | $2.00 | $4.00 |
| Lecture du cache | $0.10 | $0.20 |
| Écriture dans le cache 30 minutes | $2.50 | $5.00 |
| Écriture dans le cache 12 heures | $5.00 | $10.00 |
| Sortie (tokens de raisonnement inclus) | $10.00 | $15.00 |
Trois points prêtent facilement à erreur de calcul.
- L’écriture dans le cache ne se cumule pas avec l’entrée normale. Les tokens écrits dans le cache sont facturés une seule fois au tarif complet de la tranche 30 minutes ou 12 heures, sans être facturés en plus au tarif d’entrée normale.
- Les tokens de raisonnement sont inclus dans la sortie. Le
usage.output_tokensrenvoyé par Responses correspond au volume total de sortie ; l’usage de raisonnement est généralement indiqué comme sous-élément dansoutput_tokens_details.reasoning_tokens. Il suffit de calculer le budget sur ce total. - Le changement de tranche s’applique à la requête entière. Dès que le volume total d’entrée dépasse 272K, l’entrée, le cache et la sortie de toute la requête basculent vers les tarifs du contexte long ; ce n’est pas seulement la partie qui dépasse le seuil qui est majorée.
La fiche du modèle indique également une fenêtre de contexte de 1 050 000 tokens, une entrée maximale de 922 000 tokens et une sortie maximale de 128 000 tokens. 922K correspond à l’entrée maximale autorisée, tandis que 272K est le seuil de changement de tranche de facturation ; les deux ne sont pas liés.
1.2 Dépenses au-delà des frais de modèle
Le tableau ci-dessus ne couvre que les frais de tokens du modèle. Dans l’API Responses, Sol peut faire appel à des outils comme la recherche de fichiers, la recherche web, l’interpréteur de code et la génération d’images ; ces outils sont facturés selon leurs propres règles dès qu’on les utilise vraiment. Pour une génération d’images, c’est Sol qui déclenche l’appel à l’outil, mais l’image est produite par un outil d’image distinct, et les frais d’image se comptent à part. Un déploiement dans une région donnée peut aussi entraîner des frais régionaux applicables. Dans le tableau budgétaire, réservez une colonne à part pour ces postes : ne les mélangez pas avec le prix unitaire des tokens.
1.3 Lire l’usage réel facturé via le code
Après l’estimation, il faut calibrer avec le champ usage d’une vraie requête. L’exemple ci-dessous appelle Sol via l’interface compatible OpenAI et convertit les frais de modèle de cette requête selon le tarif Standard en contexte court :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句话说明 Batch API 适合什么任务。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"输入 {u.input_tokens},其中缓存 {cached},输出 {u.output_tokens},模型费约 ${cost:.6f}")
Cette conversion ne vaut que pour une requête Standard dont l’entrée ne dépasse pas 272K et sans écriture de cache. En production, je vous conseille d’écrire le usage de chaque requête dans les logs, de le regrouper par type de tâche, puis de le reporter dans le tableau budgétaire de la section 4.
🎯 Recommandation officielle : avant de figer le budget, lancez d’abord une vingtaine à une cinquantaine de vraies requêtes métier pour observer la distribution des entrées et des sorties. Les nouveaux utilisateurs d’APIYI (apiyi.com) disposent d’un quota d’essai gratuit, parfaitement adapté à ce genre de calibrage sur petit échantillon.
2. Comment calculer les niveaux d’interaction et le budget mensuel de GPT-6.2 Sol
2.1 Coût d’une même requête sur les trois niveaux d’interaction
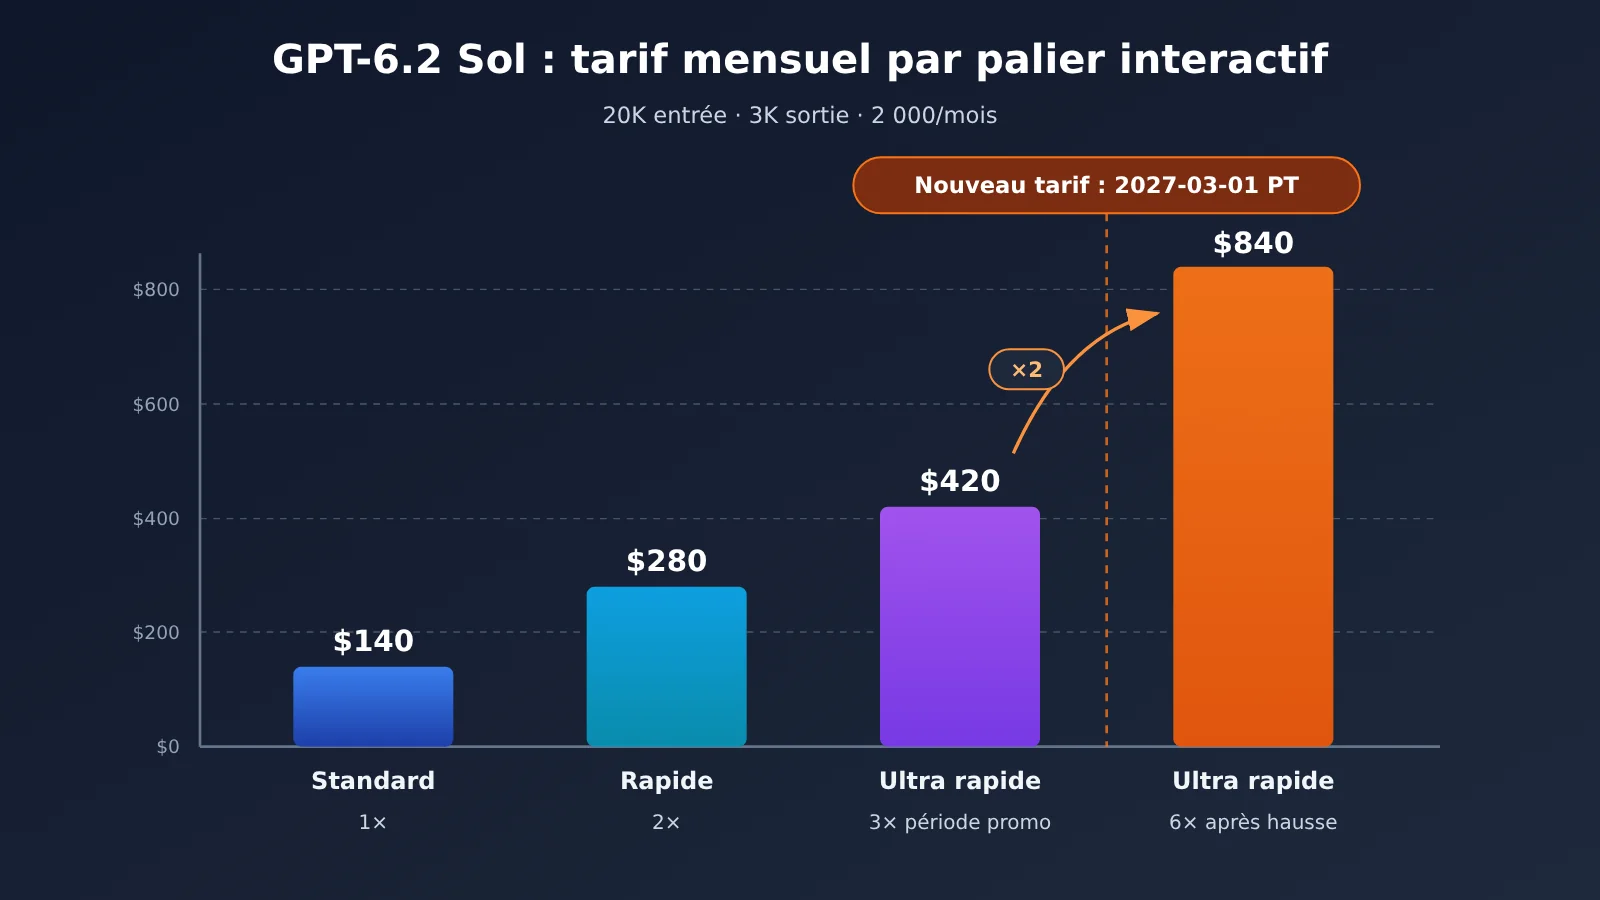
Dans les scénarios interactifs, l’utilisateur attend le résultat dans l’interface ; les options disponibles sont Standard, Fast et Ultrafast. Fast est facturé 2× le tarif Standard ; Ultrafast est facturé 3× jusqu’au 28 février 2027 (heure du Pacifique), puis 6× à partir du 1er mars 2027. GPT-6.2 Sol ne prend pas en charge le niveau Flex.
L’exemple suppose qu’une requête comporte 20 000 tokens d’entrée normaux et 3 000 tokens de sortie facturables, sans cache, sans outils, sans frais régionaux et sans nouvelles tentatives, à raison de 2 000 requêtes par mois. Le coût par requête en Standard est de 20000×2/1e6 + 3000×10/1e6 = $0.07.
| Niveau de service | Multiplicateur | Coût par requête | 2 000 requêtes/mois |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast (jusqu’au 28 février 2027 PT) | 3× | $0.21 | $420 |
| Ultrafast (à partir du 1er mars 2027 PT) | 6× | $0.42 | $840 |
2.2 Conditions à garder en tête pour lire ce tableau
Le tableau fixe l’usage par requête pour faciliter la planification du budget. En pratique, la consommation de tokens et la latence d’une même tâche varient selon le niveau et la requête. Avant la mise en production, il faut faire passer un lot de requêtes réelles sur chaque niveau envisagé pour vérifier.
Si vous établissez un budget avec Ultrafast avant mars 2027, préparez aussi une version calculée sur la base de 6×. Dans cet exemple, après l’ajustement tarifaire, le coût mensuel passe de $420 à $840 ; la hausse intervient le 1er mars à l’heure du Pacifique, soit l’après-midi du 1er mars à l’heure de Pékin.
💡 Conseil de choix du niveau : pour la plupart des requêtes interactives, commencez par Standard, et ne basculez vers Fast ou Ultrafast que les points d’entrée sensibles à la latence. En testant en parallèle avec la même clé API via APIYI apiyi.com, vous pourrez obtenir plus rapidement les données réelles de latence et d’usage pour chaque niveau.
3. Estimation des coûts : traitement nocturne et longs documents avec GPT-6.2 Sol
3.1 Tâches par lots de nuit : 2h, 8h et Batch
Trois façons d’obtenir une remise quand une tâche n’a pas besoin d’une réponse immédiate. Le mode arrière-plan de Responses facture les fenêtres d’achèvement 2h et 8h à respectivement 70 % et 60 % du tarif Standard par token du modèle — mais la requête doit être en Standard et non-streaming, et la fenêtre désigne le délai cible de la réponse initiale ; soonest ne donne droit à aucune remise de fenêtre. Batch API facture 50 % du Standard, s’envoie par fichier et offre une fenêtre de traitement de 24 heures.
Prenons un exemple : 10 000 requêtes, chacune avec 50 000 tokens d’entrée ordinaires et 4 000 tokens de sortie facturés, sans cache ni outils. Le coût Standard d’une requête est 50000×2/1e6 + 4000×10/1e6 = $0.14.
| Mode | Tarif | Coût par requête | Total pour 10 000 requêtes | Quand le choisir |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | Besoin du résultat rapidement |
Arrière-plan 2h |
70% | $0.098 | $980 | L’application doit recevoir une réponse initiale en deux heures et réinjecter les résultats d’outils en cours de tâche |
Arrière-plan 8h |
60% | $0.084 | $840 | Soumission le soir, livraison avant la reprise du lendemain, avec interaction progressive |
| Batch API | 50% | $0.07 | $700 | Requêtes déjà prêtes et indépendantes, livraison possible le lendemain |
Le mieux est de raisonner par forme de tâche. Pour la classification, l’extraction et autres tâches indépendantes qu’on peut entièrement rédiger avant l’envoi, prenez Batch comme référence de prix. Si l’application doit fournir un résultat d’outil en milieu de tâche pour continuer, estimez chaque étape séparément, puis choisissez la fenêtre 2h ou 8h en fonction du délai de livraison global de votre application.
Il y a aussi une contrainte de capacité : les requêtes en arrière-plan à tarif réduit et Batch partagent un quota de file d’attente distinct. Avant de planifier un envoi massif, vérifiez le quota de tokens d’entrée en attente, pour éviter que les requêtes restent coincées dans la file.
3.2 Longs documents : le saut de coût au passage des 272K
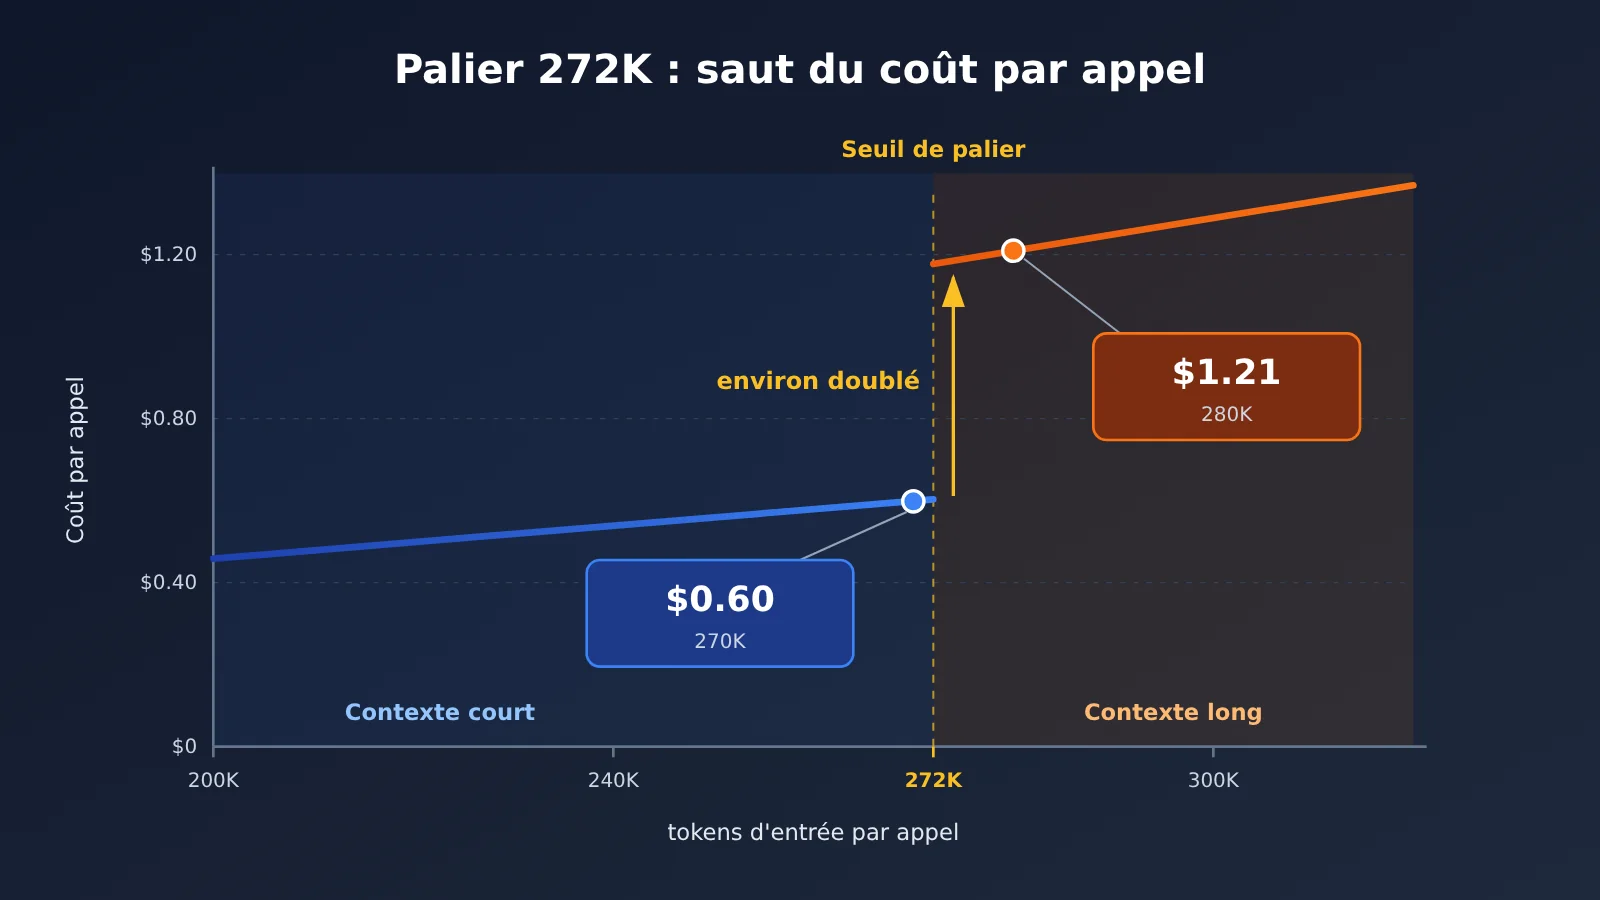
Le saut de coût sur les longs documents vient de la règle de changement de palier. L’exemple suppose aucun cache ni outil, une sortie fixe de 6 000 tokens, le palier Standard, et des entrées de 270 000 puis 280 000 :
| Volume d’entrée | Tarif applicable | Calcul | Coût par appel de modèle |
|---|---|---|---|
| 270,000 | Contexte court | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | Contexte long | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
L’entrée n’augmente que de 10 000 tokens, et pourtant le coût par requête passe de $0.60 à $1.21, soit environ le double. La raison : toute la requête bascule au tarif long contexte, et le prix unitaire de sortie passe lui aussi de $10 à $15.
Pour établir un budget, enregistrez la distribution des entrées de chaque requête par file métier, estimez séparément les requêtes courantes et les pics de longs documents, puis additionnez. Si vous comptez faire passer l’entrée sous 272K en tronquant les documents, vérifiez aussi que le contenu tronqué conserve bien les éléments de preuve nécessaires à la livraison — sinon, l’économie réalisée risque d’être absorbée par le retravail.
4. Remplir le budget mensuel de GPT-6.2 Sol par canal
4.1 Recalcul en parallèle des tarifs publics d’APIYI et des tarifs officiels d’OpenAI
Le 20 novembre 2026, en relisant le tableau récapitulatif public des modèles d’APIYI et l’interface publique de tarification, on retrouve gpt-6.2-sol dans les deux ; le tableau indique les deux points d’entrée responses et chat. La grille publique applique elle aussi un palier à 272 000 tokens d’entrée, mais l’expression de calcul du palier long diffère des multiplicateurs officiels.
| Catégorie de facturation (USD / million de tokens) | OpenAI palier court | OpenAI palier long | APIYI apiyi.com palier court | APIYI apiyi.com palier long |
|---|---|---|---|---|
| Entrée standard | $2.00 | $4.00 | $2.00 | $3.00 |
| Lecture de cache | $0.10 | $0.20 | $0.10 | $0.15 |
| Écriture de cache | $2.50 (30 minutes) | $5.00 (30 minutes) | $2.50 | $3.75 |
| Sortie | $10.00 | $15.00 | $10.00 | $11.25 |
En reprenant le recalcul d’usage de la section 3.2 : pour 270 000 tokens d’entrée et 6 000 tokens de sortie, les deux canaux facturent $0.60. Pour 280 000 tokens d’entrée et 6 000 tokens de sortie, le tarif officiel d’OpenAI s’élève à $1.21, tandis que la formule publique d’APIYI donne (280000×3 + 6000×11.25)÷1e6 = $0.9075, soit environ $0.30 d’écart par appel. Plus la part de documents longs est élevée, plus cet écart pèse sur le budget mensuel.
L’écart ci-dessus est déduit uniquement des paramètres publiés par les deux parties. Les remises Batch et de fenêtre d’arrière-plan évoquées plus haut s’appuient sur les exemples de calcul officiels d’OpenAI ; pour un appel via APIYI, référez-vous à la configuration et à la facture actuelles d’APIYI pour le groupe de compte, la facturation réelle, les paliers disponibles et les capacités de l’API.
4.2 Tableau budgétaire mensuel : une ligne par type de tâche
Concrétisez l’algorithme précédent dans un tableau : chaque type de tâche occupe une ligne, remplie selon l’utilisation moyenne par requête, puis multipliée par le nombre de requêtes mensuelles. Lorsqu’un workflow comporte plusieurs invocations du modèle (par exemple, le raisonnement multi-étapes d’un agent), enregistrez chaque étape sur sa propre ligne, puis additionnez le tout ligne par ligne.
| Type de tâche | Requêtes/mois | Entrée normale moyenne | Lecture de cache moyenne | Écriture de cache (palier) | Sortie facturable moyenne | Palier de contexte | Niveau de service | Frais supplémentaires (outils / région) | Taux de nouvelle tentative prévu | Coût mensuel |
|---|---|---|---|---|---|---|---|---|---|---|
| Interaction avec le service client | 2,000 | 20,000 | 0 | 0 | 3,000 | Court | Standard | Aucun | 0% | $140 |
| Classification nocturne | 10,000 | 50,000 | 0 | 0 | 4,000 | Court | Batch | Aucun | 0% | $700 |
| Revue de contrat | À renseigner | À renseigner | 6,000 | Long | Standard | À renseigner | À renseigner |
Les chiffres des deux premières lignes proviennent des exemples de calcul de cet article et peuvent servir de référence pour remplir le tableau. La formule du coût mensuel est « coût du modèle par requête × nombre de requêtes mensuelles × (1 + taux de nouvelle tentative) + frais supplémentaires ». Le coût du modèle par requête doit être extrait de la grille tarifaire de la section 1, en fonction du palier de contexte et du niveau de service indiqués sur la ligne.
🚀 Conseil de mise en œuvre : une fois le tableau budgétaire rempli, sélectionnez les deux types de tâches les plus coûteux et exécutez une série de requêtes réelles pour chacun d’eux sur APIYI apiyi.com. Remplacez ensuite les valeurs estimées par les valeurs mesurées de
usage: vous obtiendrez un budget prêt à être transmis au service financier.
4.3 Vérifier la fiabilité du budget
Une fois la facture du premier mois récupérée, vérifiez trois choses ligne par ligne.
- Dans la distribution réelle des entrées, la part des requêtes dépassant 272K est-elle proche de l’estimation ?
- La part des tokens de raisonnement dans
output_tokensest-elle nettement supérieure à celle observée pendant les tests ? - Le nombre réel de nouvelles tentatives et d’appels d’outils a-t-il bien été comptabilisé ?
Si l’écart sur ces trois points reste inférieur à 10 %, vous pourrez réutiliser ce tableau tel quel le mois suivant ; le point qui présente l’écart le plus important est celui où il faudra ajuster en priorité la consommation ou le palier.
Références
- Tarification officielle de l’API OpenAI : multiplicateurs par palier de service et remises Batch / fenêtre d’arrière-plan
- Lien :
developers.openai.com/api/docs/pricing
- Lien :
- Fiche modèle GPT-6.2 Sol : fenêtre de contexte, règles de changement de palier à 272K et limites
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol
- Lien :
- Guide du mode arrière-plan et de la Batch API : fenêtre d’achèvement, exigences de non-streaming et quotas de file d’attente
- Lien :
developers.openai.com/api/docs/guides/background,developers.openai.com/api/docs/guides/batch
- Lien :
- Tableau général des modèles APIYI et API publique de tarification : point d’entrée référencé pour
gpt-6.2-solet expression de calcul du prix par palier- Lien :
docs.apiyi.com/models.md,api.apiyi.com/api/pricing
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : pour toute question liée aux règles de facturation et à la configuration du compte, vous pouvez nous contacter depuis la page d’accueil du site officiel APIYI. Vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com.