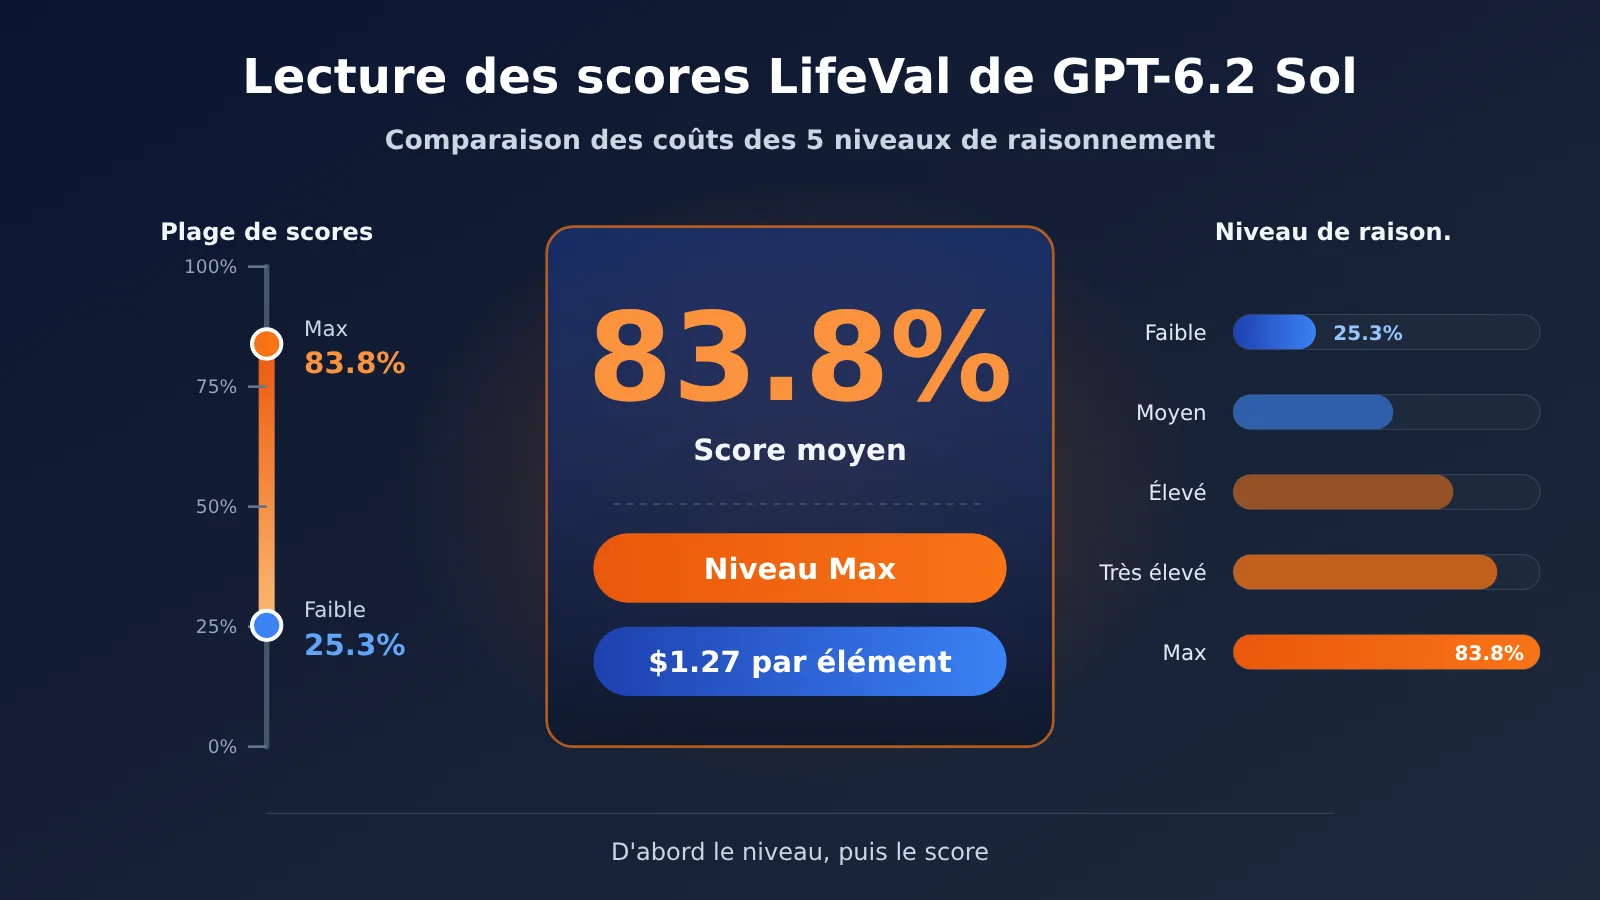
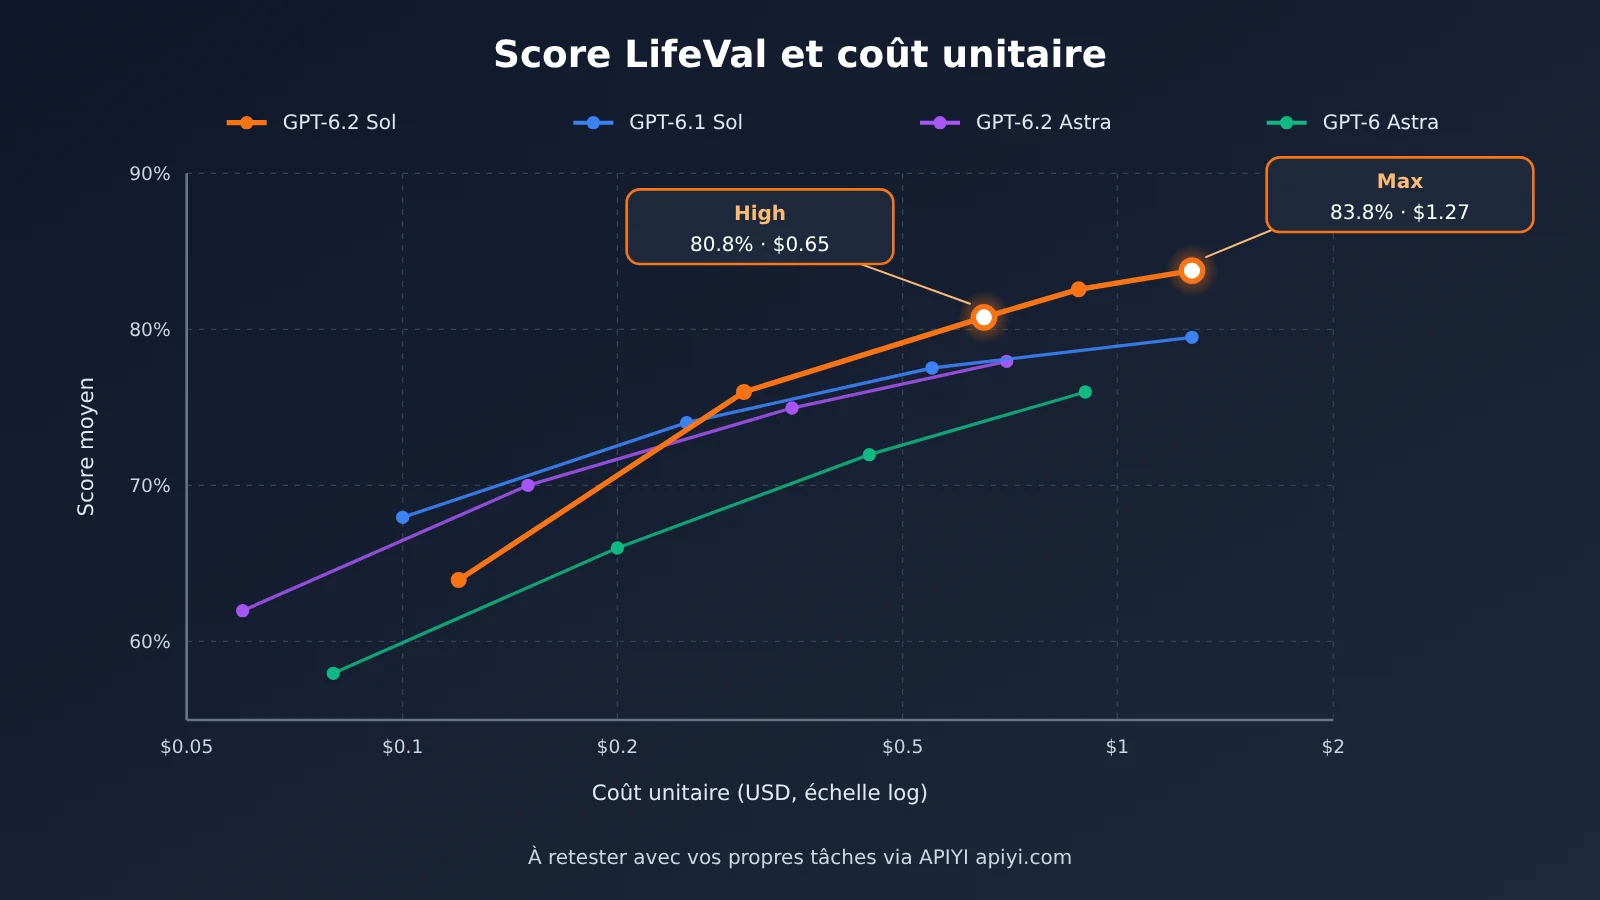
83.8% ne signifie pas « 83.8% des tâches sont toutes terminées », mais correspond au score moyen LifeVal de GPT-6.2 Sol au niveau de raisonnement Max. Ce score est obtenu en attribuant des points selon le barème de chaque tâche, puis en les additionnant ; le coût moyen par tâche correspondant est de $1.27. Avec le même modèle au niveau Low, le score moyen tombe à 25.3% ; au niveau High, il atteint 80.8%, pour un coût par tâche de $0.65. Donc, quand on parle des performances LifeVal de GPT-6.2 Sol, il faut d’abord préciser le niveau.
Conclusion : le classement officiel présente « une combinaison de scores et de coûts pour des tâches et un environnement donnés », et non un classement général que l’on pourrait transposer tel quel dans votre produit. Dans ce jeu de données LifeVal, le niveau High est un point de départ à tester en priorité. Le choix final du niveau devra toujours être validé avec vos propres tâches, en jugeant sur les livrables et l’état réel.
Ce que vous allez apprendre en lisant cet article
- Quelles tâches LifeVal mesure, et comment exprimer correctement 83.8%.
- Les scores et coûts des cinq niveaux de raisonnement de GPT-6.2 Sol, ainsi que la comparaison à niveau égal avec GPT-6.1 Sol, GPT-6 Astra et GPT-6.2 Astra.
- Pourquoi les affirmations officielles « un coût d’environ un septième » et « une forte baisse au niveau Low » peuvent être vraies en même temps.
- Comment s’inspirer de la méthode de validation de LifeVal pour concevoir des tâches d’évaluation reproductibles pour votre assistant quotidien.
Sommaire : le tableau To Know explique d’abord les termes d’évaluation utilisés plus loin ; l’aperçu des implications précise ensuite ce que les utilisateurs ordinaires et les développeurs doivent chacun surveiller. La partie faits objectifs présente successivement l’origine des tâches LifeVal et leur mode de notation, ainsi que les données par niveau présentes dans l’image de publication du 17 novembre. La partie analyse et interprétation décompose d’abord les dénominateurs de plusieurs comparaisons, puis propose un exemple de validation pour un assistant d’itinéraire et d’agenda, directement réutilisable, et précise les limites de transposition.
À savoir : les concepts clés pour comprendre le score LifeVal de GPT-6.2 Sol
| Concept | Explication succincte |
|---|---|
| LifeVal | Référentiel utilisé par OpenAI pour mesurer la performance d’un assistant IA sur des tâches numériques quotidiennes et personnalisées |
| Contexte personnalisé | Préférences de l’utilisateur, historique, conditions propres à la tâche, etc., autant d’informations qui modifient ce qu’on considère comme une « réponse acceptable » |
| Grille d’évaluation | Décomposition de l’achèvement d’une tâche en plusieurs exigences vérifiables une par une |
| Environnement contrôlé | Environnement d’évaluation où les applications, les données et l’état initial sont préconfigurés, ce qui facilite la vérification du résultat des actions |
| Différence d’état du backend | Relevé des changements d’état de l’application avant et après le test, pour confirmer que les opérations des outils ont réellement pris effet |
| Valeur de récompense moyenne | Indicateur agrégé des scores obtenus par chaque tâche selon la grille d’évaluation ; les pourcentages publiés dans les graphiques correspondent à ce type de « score moyen » |
| Intensité de raisonnement | Niveau contrôlant l’effort de raisonnement du modèle ; cet article compare Low, Medium, High, Xhigh et Max |
| Coût par tâche | Coût moyen par tâche dans les graphiques d’évaluation, qui varie selon l’usage du modèle et les tarifs appliqués |
Aperçu express de l’impact du LifeVal de GPT-6.2 Sol
- Utilisateurs grand public : quand vous voyez « 83,8 % », comprenez-le comme « un score moyen sur un ensemble de tâches quotidiennes d’utilisateurs anglophones américains », et non comme un taux de réussite. À noter aussi : le même modèle peut afficher des écarts importants selon le niveau de raisonnement, et l’expérience produit dépend du niveau choisi par l’éditeur de l’application.
- Chefs de produit : le niveau Low est le moins cher, mais cette fois-ci, sur LifeVal, il est nettement devancé par le niveau Low de la génération précédente, Sol. Si vous reconduisez la configuration de niveaux de l’ancienne version lors d’une mise à niveau, vous risquez de vous retrouver dans la situation où « le nouveau modèle donne de moins bons résultats ».
- Développeurs d’API : ce qui mérite d’être repris, c’est la conception de l’acceptation dans LifeVal, à savoir une évaluation séparée du livrable, de l’état de l’environnement et de la réponse. Comparer horizontalement les niveaux Low, Medium et High sur un même lot de tâches internes est plus fiable que de citer directement les chiffres des classements.
Faits objectifs : quelles tâches sont utilisées pour évaluer GPT-6.2 Sol sur LifeVal ?
Origine et calendrier de publication de LifeVal
LifeVal est une évaluation conçue par OpenAI pour mesurer des tâches d’agents personnalisés du quotidien. La page de recherche d’OpenAI est datée du 2 novembre 2026, et l’article scientifique associé du 3 novembre. Le 17 novembre, OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol, en joignant sur la page de lancement un graphique LifeVal contenant les résultats par palier des nouveaux modèles (identifiant du graphique lifeval-v2).
La répartition des tâches dans l’article provient d’études sur l’emploi du temps menées aux États-Unis et dans plusieurs pays, ainsi que d’une enquête sur la disposition à payer auprès de la population américaine ; elle aboutit à un classement des activités quotidiennes en 148 catégories. L’évaluation menée dans l’article repose sur 169 tâches. À noter que les modèles évalués dans l’article s’arrêtent à GPT-6 Astra : les chiffres par palier de la série GPT-6.2 n’apparaissent que dans le graphique officiel publié ultérieurement.
Selon le positionnement officiel, Sol cible les tâches professionnelles quotidiennes à haute fréquence, la programmation courante et les agents multi-étapes capables de passer à l’échelle, tandis qu’Astra cible les raisonnements plus difficiles et les livrables professionnels. Ce positionnement correspond bien aux « tâches d’assistant du quotidien » que mesure LifeVal.
Conception des tâches LifeVal : une même demande, des réponses acceptables qui varient selon les personnes
La particularité de LifeVal, c’est la personnalisation. Prenons l’exemple de la comparaison d’écoles après un déménagement : selon l’âge des enfants, le trajet domicile-travail ou les préférences en matière de district scolaire, la réponse acceptable ne sera pas la même. Autre exemple : pour trouver un logement en arbitrant entre budget et temps de trajet, le plafond de budget et la durée de trajet acceptable déterminent directement quels biens comptent comme résultats acceptables.
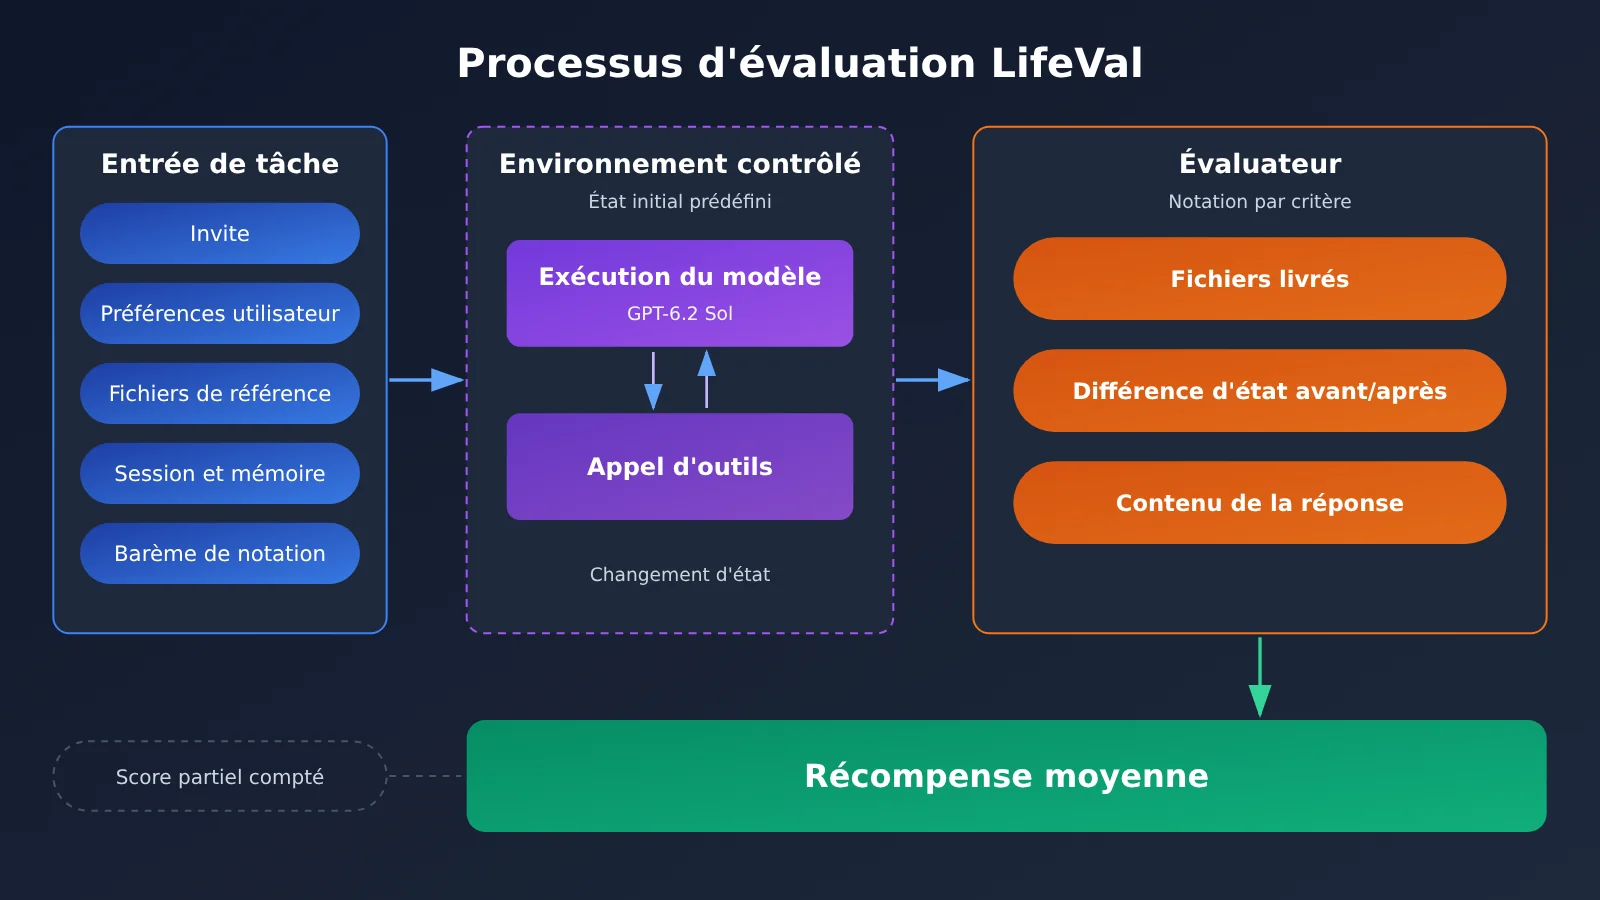
Dans la terminologie de l’article, chaque tâche comporte une invite, des préférences utilisateur, des fichiers de référence, des sessions et mémoires pertinentes, une grille d’évaluation, ainsi qu’un environnement contrôlé dont l’état est prédéfini. Une fois l’exécution terminée, l’évaluateur peut vérifier trois catégories d’éléments : les fichiers livrés par le modèle, l’état avant/après de l’environnement manipulé par les outils, et la réponse du modèle ; il attribue ensuite des points séparément selon les exigences de la tâche.
Pourquoi 83.8% ne peut être qualifié que de « score moyen »
L’axe vertical du graphique de résultats du papier représente la récompense moyenne. Par conséquent, 83.8% doit s’énoncer comme un « score moyen », et non comme « 83.8% des tâches ont été exécutées avec succès de bout en bout ». Même une tâche qui ne satisfait qu’une partie des critères de notation apporte une part du score.
Le papier précise également plusieurs limites : dans l’environnement hors ligne et dans les pages web mises en cache, certaines informations qui évoluent avec le temps subsistent ; l’échantillon de population est essentiellement composé d’utilisateurs anglophones orientés vers les États-Unis. Autrement dit, les scores ne peuvent pas être transposés directement à d’autres régions, d’autres langues ou d’autres écosystèmes applicatifs.
Graphique de publication LifeVal de GPT-6.2 Sol : cinq niveaux de score et coût par item
Le tableau ci-dessous reprend les données publiques du graphique interactif LifeVal figurant sur la page de publication OpenAI du 17 novembre 2026. Chaque cellule indique « score moyen / coût moyen par tâche (USD) » ; il s’agit de données d’évaluation publiques déclarées par OpenAI, et non de mesures réalisées par un organisme indépendant.
| Modèle | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
Le texte de l’annonce indique que, dans LifeVal, Sol obtient un meilleur score que GPT-6 Astra pour un coût d’environ un septième de ce dernier. L’objet de la comparaison est ici GPT-6 Astra, la génération phare précédente, et non GPT-6.2 Astra de la même période. L’autre comparaison de l’annonce, portant sur FrontierCode 2.0, utilise en revanche GPT-6.2 Astra : ne mélangez pas les deux séries de conclusions à la lecture.
📌 Précision sur le périmètre des données : le « coût par item » du tableau est la moyenne issue du graphique d’évaluation officiel ; il dépend de la longueur des entrées, de la longueur des sorties et de l’usage d’outils propres à cette évaluation. Le coût de vos propres tâches doit être remesuré avec de vraies requêtes : vous pouvez, via APIYI apiyi.com, enchaîner les différents niveaux de Sol avec la même clé API et comparer directement la facture.
Informations d’accès API pour GPT-6.2 Sol
L’ID du modèle API est gpt-6.2-sol. Il est accessible via Responses et Chat Completions ; les appels de fonctions et les outils intégrés passent par le chemin Responses, et aucun des deux points de terminaison n’accepte le niveau de raisonnement none. Le tarif officiel Standard en contexte court est de $2.00 en entrée et $10.00 en sortie (USD / million de tokens, la sortie inclut les tokens de raisonnement), identique à GPT-6.1 Sol.
Au 20 novembre 2026, le tableau public des modèles et l’interface de tarification d’APIYI listent tous les deux gpt-6.2-sol, avec les points d’entrée responses et chat. La tarification du palier court est identique à l’officielle ; les groupes réellement disponibles, la plage de paramètres et la facturation font foi selon la configuration actuelle et la facturation d’APIYI apiyi.com.
Analyse : comment le « coût divisé par sept » et le recul de Low dans GPT-6.2 Sol LifeVal peuvent-ils être vrais en même temps ?
Commencez par aligner les objets de comparaison et le dénominateur
Sur une même image, on peut lire à la fois un « progrès considérable » et un « net recul » : la raison profonde, c’est que l’objet de comparaison et le niveau de gamme ne sont pas les mêmes. Les écarts et les ratios du tableau ci-dessous sont calculés à partir des valeurs officiellement publiées.
| Groupe de comparaison | Valeurs des deux côtés | Écart de score | Relation de coût |
|---|---|---|---|
| 6.2 Sol Max vs le fleuron de la génération précédente, GPT-6 Astra Max | 83,8 %/1,27 $ vs 79,8 %/9,04 $ | +4,0 points de pourcentage | environ 14,0 %, soit « environ un septième » |
| 6.2 Sol Max vs 6.1 Sol Max | 83,8 %/1,27 $ vs 79,5 %/1,27 $ | +4,3 points de pourcentage | coût identique |
| 6.2 Sol Low vs 6.1 Sol Low | 25,3 %/0,089 $ vs 66,8 %/0,52 $ | −41,5 points de pourcentage | coût plus faible, mais chute marquée du score |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70,3 %/0,38 $ vs 75,5 %/0,73 $ | −5,2 points de pourcentage | coût d’environ la moitié |
| 6.2 Sol High vs 6.1 Sol Max | 80,8 %/0,65 $ vs 79,5 %/1,27 $ | +1,3 points de pourcentage | environ la moitié |
| 6.2 Sol Max vs 6.2 Astra Max | 83,8 %/1,27 $ vs 86,1 %/4,23 $ | −2,3 points de pourcentage | environ 30 % |
Dans ces chiffres, les « points de pourcentage » décrivent l’écart entre les scores moyens, tandis que le « ratio de coût » décrit le rapport entre les coûts moyens par élément : les deux ne sont pas convertibles l’un en l’autre. Le « un septième » ne tient que pour le groupe « 6.2 Sol Max vs GPT-6 Astra Max ». Si l’on prend le GPT-6.2 Astra de la même période, Sol est au contraire inférieur de 2,3 points de pourcentage sur le niveau Max.
💡 Conseil de choix : l’écart entre différents niveaux d’un même modèle peut être plus grand que l’écart entre modèles différents. Je vous suggère de lancer d’abord, sur APIYI apiyi.com, une comparaison par niveau avec un jeu de tâches fixe, puis de décider du niveau par défaut — plutôt que de reconduire tel quel le paramétrage de niveaux de l’ancien modèle.
Le signal du niveau Low : une mise à niveau ne peut pas se faire par « remplacement sans réfléchir »
Sur LifeVal, le niveau Low de 6.2 Sol ne dépasse pas 25,3 %, soit 41,5 points de pourcentage de moins que 6.1 Sol Low. Les documents de lancement officiels indiquent que Sol consomme moins de tokens de sortie sur un certain nombre de tâches, et que le coût moyen par élément du niveau Low n’est que de 0,089 $. Une hypothèse raisonnable : sur des tâches personnalisées à plusieurs étapes, un effort de raisonnement réduit ne suffit pas à couvrir les contraintes de préférences et la manipulation d’outils. Ce n’est qu’une supposition : l’éditeur n’a donné aucune explication sur cette baisse du niveau Low.
Pour une équipe produit, la conséquence est immédiate. Si votre application utilisait jusqu’ici le niveau Low sur 6.1 Sol pour réduire les coûts, changer directement l’ID du modèle sans ajuster le niveau peut faire baisser sensiblement la qualité sur les tâches quotidiennes complexes. À l’inverse, le niveau Max dépasse le Sol de la génération précédente de 4,3 points de pourcentage à coût par élément identique, ce qui confirme que le plafond du nouveau modèle s’est bel et bien élevé.
Pourquoi High est le niveau à tester en priorité dans cette évaluation
En passant de High à Xhigh puis à Max, 6.2 Sol ne gagne que 1,8 puis 1,2 point de pourcentage, tandis que le coût moyen par élément augmente de 0,23 $ puis de 0,39 $. Le niveau High atteint 80,8 % pour 0,65 $, ce qui dépasse déjà le niveau Max de 6.1 Sol et celui de GPT-6 Astra. Si l’on s’en tient à LifeVal, High est le point de départ qui offre le meilleur compromis entre qualité et coût.
Ce jugement repose toutefois sur trois conditions préalables : une distribution des tâches proche de LifeVal, un environnement linguistique et applicatif proche du public anglophone américain, et une structure de coûts proche du ratio entrée/sortie de cette évaluation. Si l’une de ces conditions n’est pas remplie, la conclusion peut changer. En pratique, la démarche la plus prudente consiste à démarrer avec High, puis à décider, selon le taux de réussite sur vos propres tâches, s’il faut redescendre à Medium ou monter à Xhigh, voire Max.
Analyse et évaluation : valider votre propre assistant GPT-6.2 Sol avec l’approche LifeVal
Créer une tâche d’itinéraire familial à faible risque
Le point le plus utile à retenir de LifeVal n’est pas le score lui-même, mais la méthode de validation fondée sur les livrables et les états. Voici un exemple d’itinéraire familial : on donne d’abord à l’assistant trois contraintes strictes — points de départ et d’arrivée, conditions d’accessibilité, plafond budgétaire — et on lui demande de fournir des propositions candidates avec des trajets vérifiables, ainsi qu’un brouillon d’agenda modifiable.
| Critère d’évaluation | Méthode de vérification | Automatisable |
|---|---|---|
| Respect des contraintes de lieu | Les points de départ et d’arrivée de la proposition correspondent à ceux fournis | Vérifiable automatiquement |
| Respect des conditions d’accessibilité | La description du trajet couvre explicitement les exigences d’accessibilité | Partiellement automatisable, contrôle manuel par échantillon nécessaire |
| Budget non dépassé | Extraire les montants de la proposition et les comparer au plafond | Vérifiable automatiquement |
| Les liens étayent-ils l’information ? | Les liens sont accessibles et leur contenu correspond à la proposition | Nécessite une vérification manuelle |
| Le fichier de brouillon d’agenda existe-t-il ? | Vérifier l’état avant/après du fichier de sortie ou de l’entrée de calendrier | Vérifiable automatiquement |
| L’assistant pose-t-il une question quand une information clé manque ? | Omettre volontairement des informations comme la date et voir s’il relance | Nécessite un jugement manuel |
Ces critères correspondent aux trois axes de validation de LifeVal : les livrables (le brouillon d’agenda), les changements d’état (le fichier ou l’entrée a-t-il vraiment été écrit), et la qualité de la réponse (respect des contraintes et relance proactive). Faites tourner le même lot de tâches en Low, Medium et High, puis combinez taux de réussite et coût pour choisir le niveau initial.
Exemple minimal : appeler GPT-6.2 Sol et suivre la consommation de raisonnement
L’exemple ci-dessous appelle gpt-6.2-sol via l’interface Responses, puis lit les tokens de sortie ainsi que les tokens de raisonnement qu’ils contiennent, pour faciliter ensuite le calcul du coût de chaque poste.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Voir le script de comparaison des niveaux (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Une seule clé suffit pour comparer plusieurs niveaux
)

# Tarif Standard pour contexte court, USD / million de tokens (les tokens de sortie incluent les tokens de raisonnement)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # Date volontairement absente, pour vérifier s'il pose spontanément la question
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """Attribue une note à chaque critère du barème et renvoie un score entre 0 et 1"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
Les vérifications automatiques du script ne couvrent que les critères de notation « vérifiables automatiquement » ; l’authenticité des liens et la qualité des questions de suivi demandent encore une vérification manuelle. Pour les valeurs des paramètres de niveau de raisonnement (en particulier les chaînes correspondant à Xhigh et Max), référez-vous à la documentation officielle actuelle et aux explications des paramètres du canal utilisé.
🚀 Démarrage rapide : inscrivez-vous sur APIYI (apiyi.com) pour obtenir un crédit de test gratuit. La plateforme propose une interface compatible OpenAI ; le script ci-dessus fonctionne en remplaçant simplement la clé, ce qui est pratique pour une première validation sur un petit échantillon avant de choisir définitivement un niveau.
Les limites de transfert des conclusions de LifeVal pour GPT-6.2 Sol
Transposer les conclusions de LifeVal à votre propre produit implique de considérer au moins trois différences. La première concerne la langue et la région : l’échantillon de l’étude est dominé par des utilisateurs anglophones américains, et l’écosystème des applications de cartes, de paiement et de calendrier dans un contexte chinois est complètement différent. La deuxième concerne l’environnement : LifeVal fonctionne dans un environnement contrôlé avec des pages web mises en cache, tandis qu’un produit réel rencontrera des fluctuations réseau, des échecs d’autorisation d’outils et des différences d’état de compte. La troisième concerne la structure des coûts : les tarifs officiels par élément correspondent au ratio entrée/sortie de cette évaluation ; au-delà de 272K tokens d’entrée pour une requête à long contexte, toute la requête bascule vers un tarif plus élevé, et le coût par élément peut donc s’écarter considérablement de celui indiqué dans les graphiques.
Une utilisation raisonnable consiste donc à traiter les graphiques officiels comme un moyen de « réduire le champ des candidats », et votre propre jeu de tâches comme la base de la « décision finale ». Pour un assistant quotidien complexe, vous pouvez d’abord établir une référence avec le niveau High, puis tester séparément si Medium respecte les contraintes strictes essentielles, et si Xhigh ou Max réduisent nettement les reprises manuelles — en vous appuyant sur les taux de conformité réels et la facture.
Une fois votre jeu de tâches, vos critères d’évaluation et vos contrôles d’environnement prêts, la mise à niveau du modèle n’est plus un « changement de modèle en fonction du classement », mais un processus d’ingénierie que l’on peut retester à chaque fois. Lorsque vous devez comparer plusieurs modèles et plusieurs niveaux à répétition, vous pouvez utiliser l’interface unifiée d’APIYI apiyi.com pour faire tourner GPT-6.2 Sol, GPT-6.2 Astra et d’autres dans le même script de validation.
Références
-
Annonce de publication d’OpenAI GPT-6.2 Astra et Sol (avec les graphiques de classification LifeVal)
- Lien :
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - Description : publié le 2026-11-17 ; source des données par niveau utilisées dans cet article
- Lien :
-
Page de recherche et article LifeVal
- Lien :
openai.com/index/lifeval,cdn.openai.com/pdf/lifeval.pdf - Description : source des tâches, méthode de notation et limitations (article §3–§5)
- Lien :
-
Fiche modèle et tarification officielle de GPT-6.2 Sol
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol - Description : spécifications de la fenêtre de contexte, règles de facturation des contextes court et long, et limites
- Lien :
-
Tableau récapitulatif des modèles APIYI
- Lien :
docs.apiyi.com/models.md - Description : modèles publics répertoriés, points d’accès et informations de tarification
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter sur le site officiel APIYI, apiyi.com. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com.