Note de l’auteur : Fable 5.5 et GPT-6.2 Astra ont tous deux des démos publiques, mais aucune ne porte sur la même tâche. Cet article examine le niveau de preuve de 6 démos, compare les spécifications officielles et les prix des modèles phares actuellement disponibles, Fable 5.1 et GPT-6 Astra, puis propose une méthode d’évaluation reproductible pour choisir son modèle.
Commençons par la conclusion : on ne sait pas encore si Fable 5.5 ou GPT-6.2 Astra est le plus performant. Aucun des deux modèles n’a été officiellement lancé. Au 3 novembre 2026, le catalogue de modèles d’Anthropic propose toujours Fable 5.1, et celui d’OpenAI GPT-6 Astra (sources : pages officielles des modèles des deux entreprises ; niveau de preuve : documentation officielle). Les démos publiques des deux modèles se trouvent sur le même site de test tiers, Model Tests, et ont été réalisées par @notjazii. Mais elles ne portent pas sur la même tâche. Fable 5.5 compte 5 créations, dont un jeu, un court-métrage, un SVG et une réalisation WebGL ; GPT-6.2 Astra n’a qu’un GIF d’animation en pixel art. Les tâches étant différentes, impossible de désigner un gagnant.
Cet article ne propose donc pas de classement. Il répond à trois questions : ce que ces démos permettent ou non de prouver ; les différences entre les spécifications officielles de Fable 5.1 et de GPT-6 Astra, qu’on peut comparer dès aujourd’hui ; et la manière de préparer une évaluation interne de 20 à 50 tâches, qu’il suffira de relancer en changeant le nom du modèle une fois les nouveaux modèles disponibles. Les autres rumeurs, comme Mythos 5.5 et Gemini 4 Carbon, ne sont pas abordées ici.
Ce n’est pas un article de compromis qui se contente de dire que « chacun a ses points forts ». Quand les preuves manquent, nous le dirons clairement ; quand elles permettent de trancher, nous donnerons une recommandation.
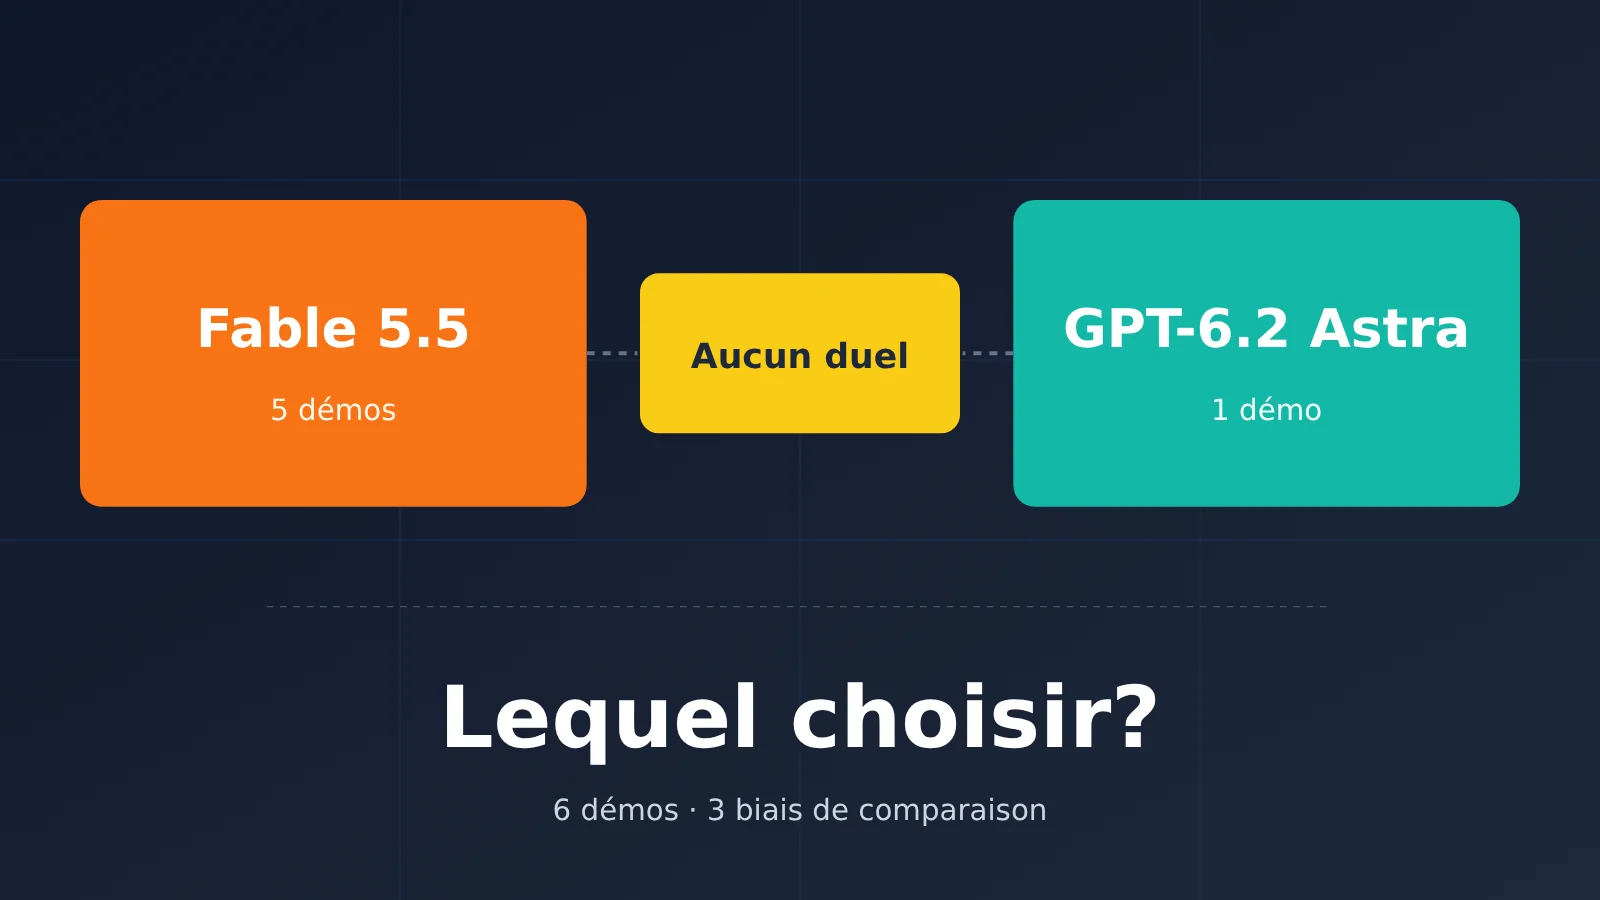
Liste des démos publiques de Fable 5.5 et GPT-6.2 Astra
Verdict : les démos montrent que les modèles peuvent produire des réalisations fonctionnelles, mais les sujets, le nombre de tests et les niveaux utilisés diffèrent. On ne peut donc pas les comparer directement.
Le site Model Tests recense 11 projets et 8 modèles, chacun accompagné d’une date, du nom du modèle et d’un type (source : page du site ; niveau de preuve : déclarations de la communauté). Le tableau ci-dessous rassemble les 6 réalisations attribuées à Fable 5.5 et GPT-6.2 Astra, ainsi que quelques références disponibles sur le site. Dans tous les cas, le modèle utilisé est déclaré par l’auteur.
| Réalisation | Modèle indiqué par l’auteur | Type | Date | Points clés |
|---|---|---|---|---|
| VoxelCraft | Fable 5.5 xhigh | Jeu HTML jouable | 2026-11-01 | Clone de Minecraft en un seul fichier, avec modes survie et créatif, fabrication, four, enchantements, redstone, villageois, plusieurs biomes, Nether et End |
| The Last Page | Fable 5.5 xhigh | Court-métrage sonore de 66 secondes | 2026-11-02 | Un renard, une bibliothèque au clair de lune, une tempête de pages et un envol vers les nuages |
| Open Me | Fable 5.5 xhigh | Expérience interactive WebGL | 2026-11-02 | WebGL2 avec ray marching et musique générative ; nécessite un GPU dédié |
| Acorn Bread on a Stick | Fable 5.5 xhigh | SVG écrit à la main | 2026-11-02 | Illustration de pain aux glands |
| Fruit Basket | Fable 5.5 max | Nature morte entièrement vectorielle | 2026-11-02 | Panier de fruits réaliste de 3000×2400, sans image matricielle |
| Tsukimi Moon Ferry | GPT 6.2 Astra Max | GIF animé en pixel art | 2026-11-02 | Une ville fluviale japonaise sous la pleine lune : château, mont Fuji, pont rouge, carpes volantes, lanternes flottantes et ferry |
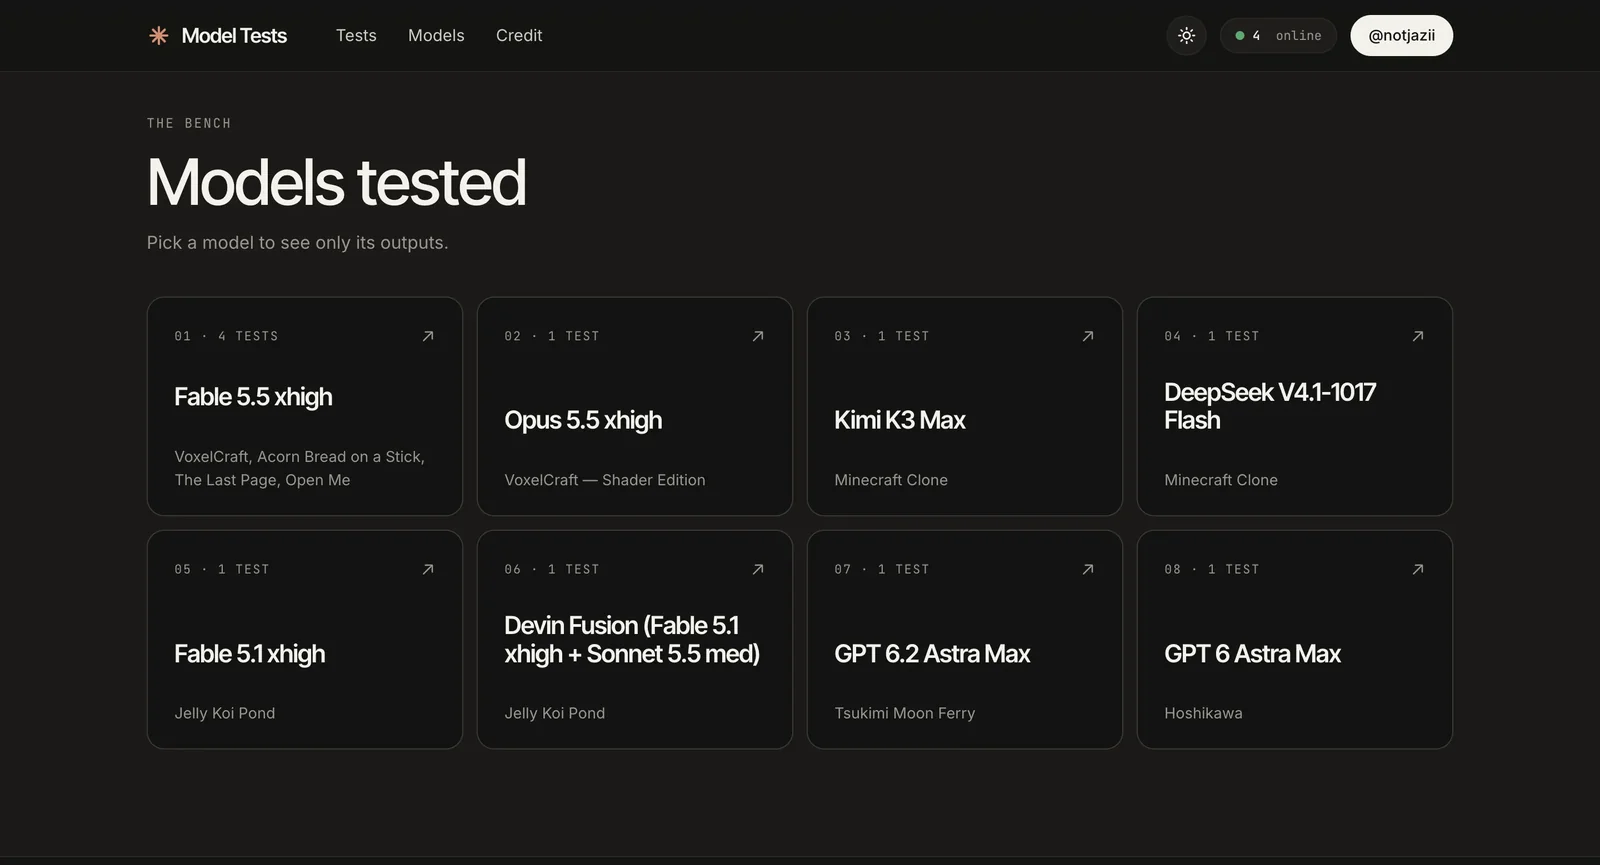
Légende : liste des modèles sur Model Tests. Fable 5.5 xhigh compte 4 tests, contre 1 seul pour GPT-6.2 Astra Max et 1 aussi pour GPT-6 Astra Max (capture du 2026-11-03).
Le site propose aussi quelques réalisations utiles comme points de comparaison. Hoshikawa, attribué à GPT 6 Astra Max, est lui aussi une animation en pixel art d’une petite ville japonaise sous la pleine lune (2026-11-02). Son style est proche de celui de Tsukimi Moon Ferry : c’est la seule comparaison du site entre l’ancienne et la nouvelle version d’OpenAI sur un sujet similaire. VoxelCraft — Shader Edition, attribué à Opus 5.5 xhigh (2026-11-01), répond au même sujet que le VoxelCraft de Fable 5.5. Kimi K3 Max et DeepSeek V4.1-1017 Flash ont également réalisé chacun un clone de Minecraft (2026-10-17).
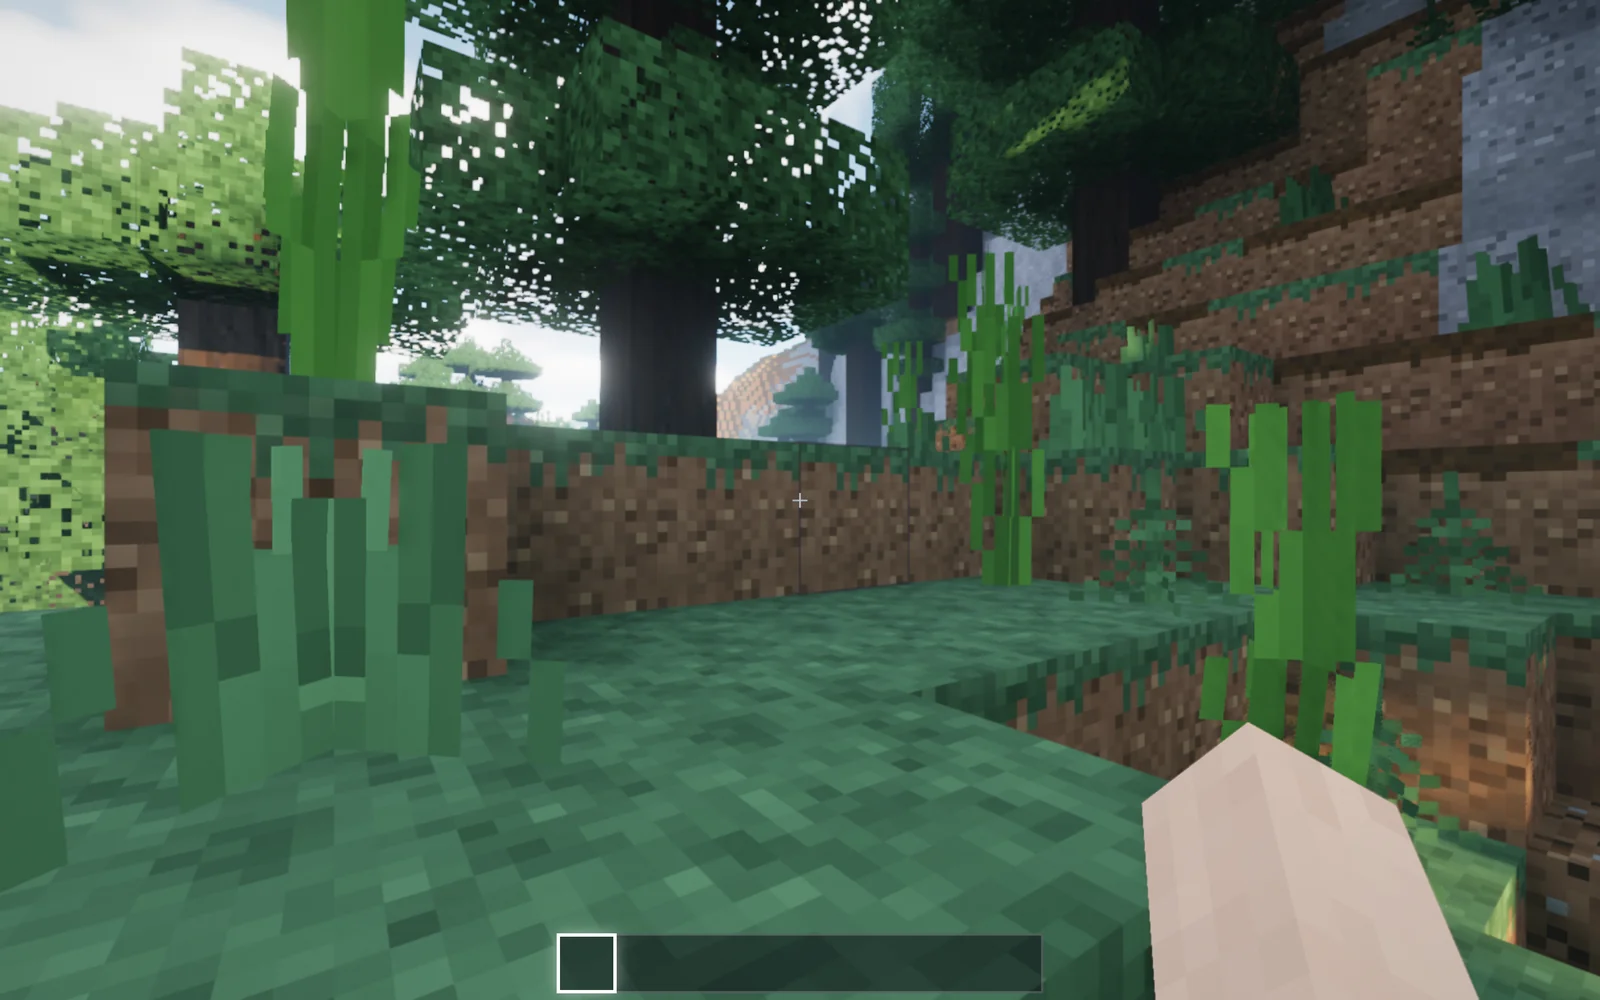
Légende : VoxelCraft de Fable 5.5 xhigh, un clone de Minecraft en un seul fichier dans lequel on peut se déplacer dès l’ouverture (capture du 2026-11-03).
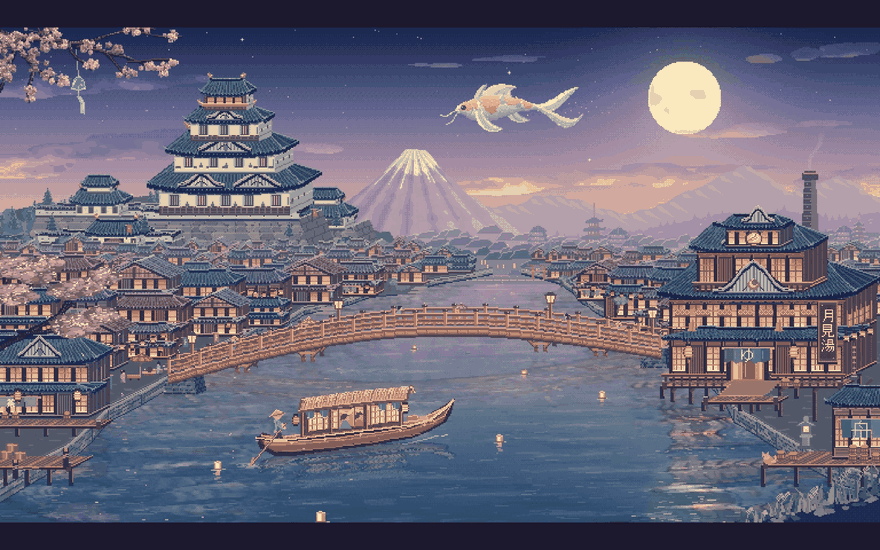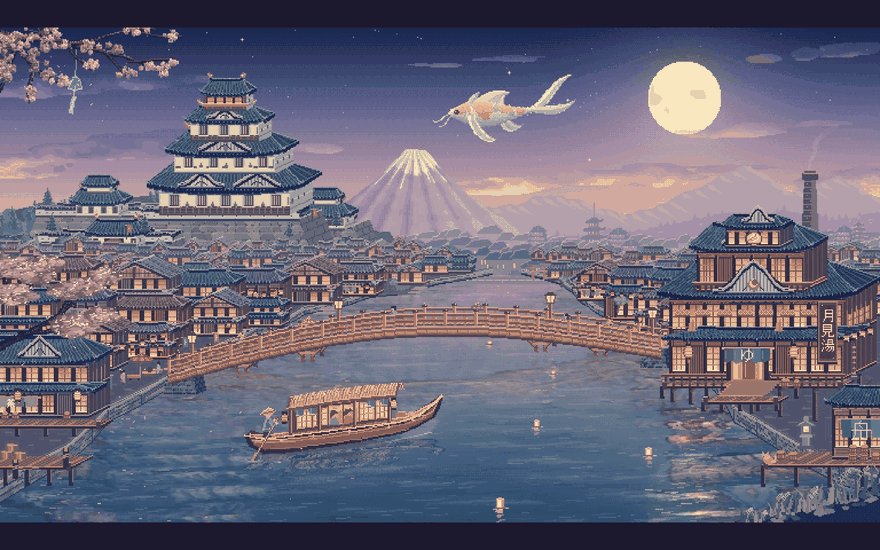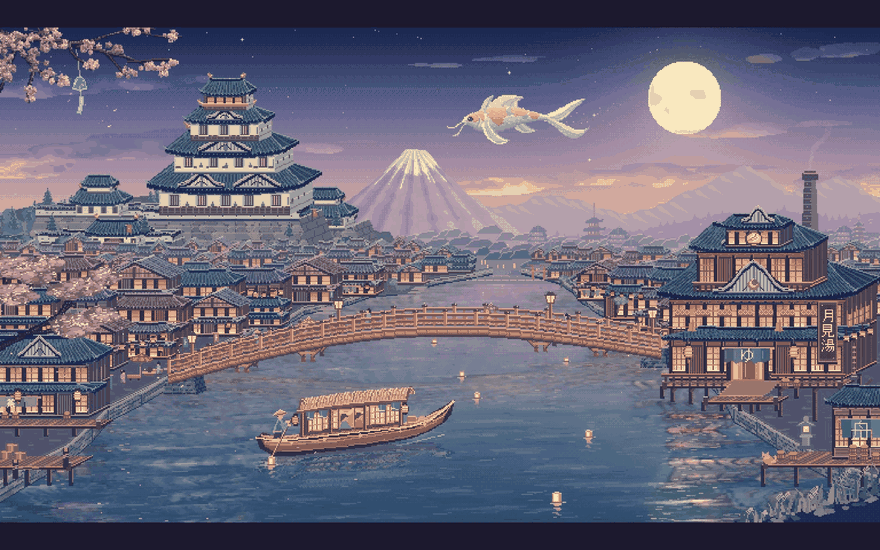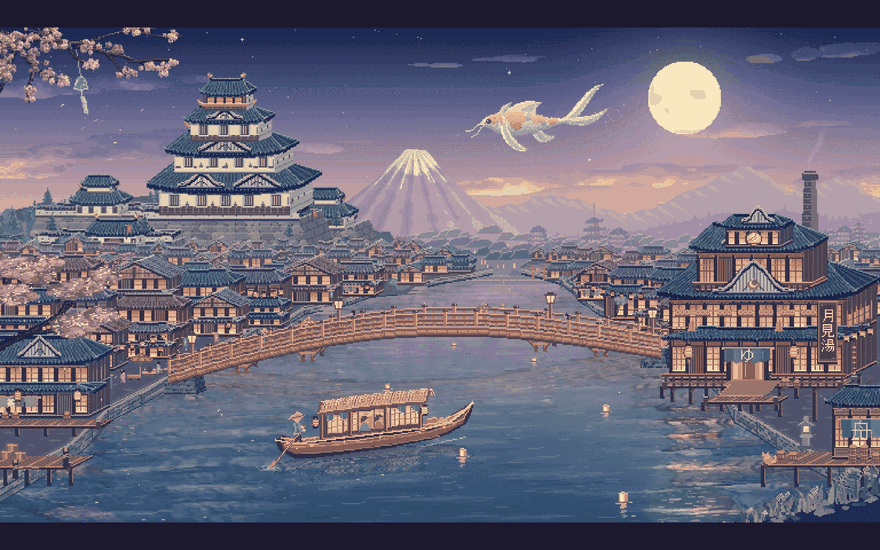
Légende : Tsukimi Moon Ferry de GPT-6.2 Astra Max, une animation GIF en pixel art montrant une ville fluviale japonaise sous la pleine lune (capture d’écran du 2026-11-03).
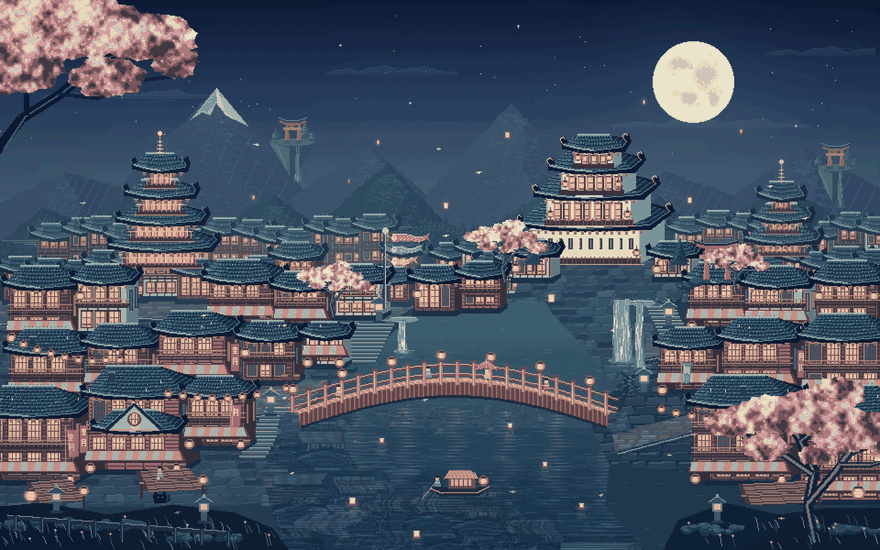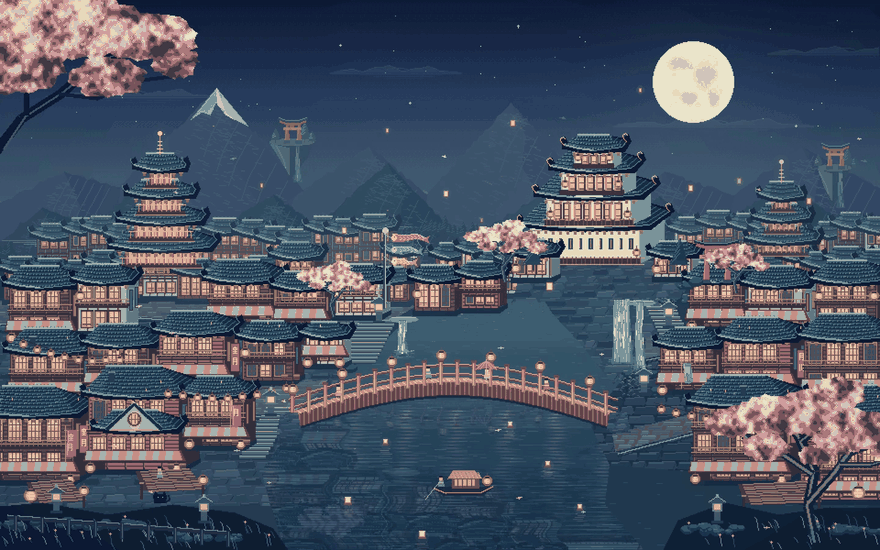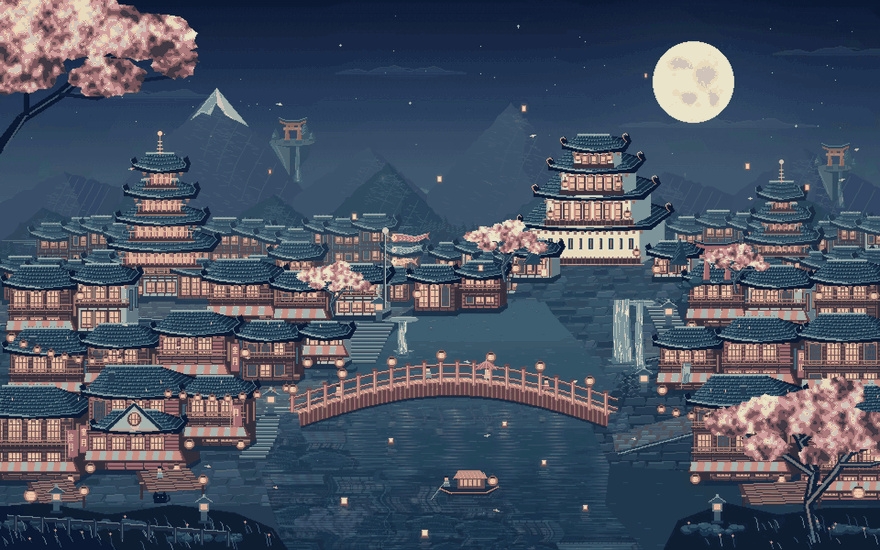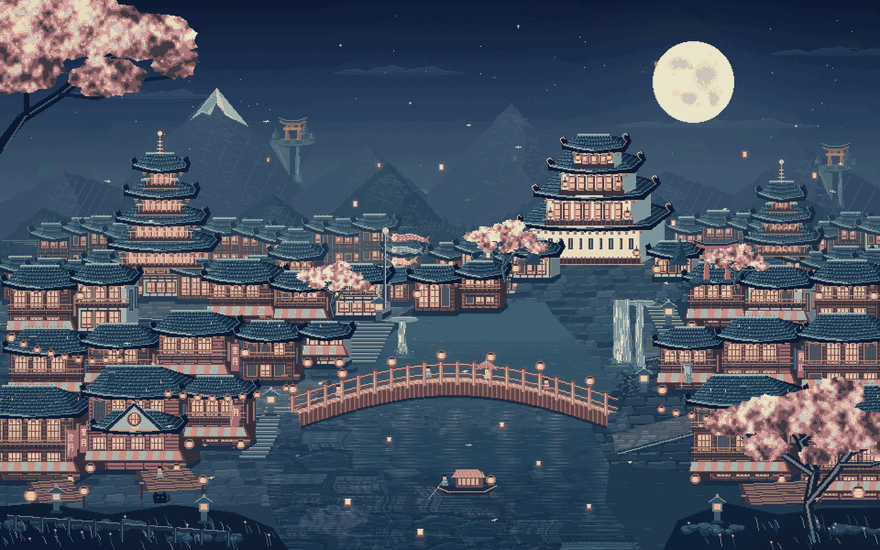
Légende : Hoshikawa de GPT-6 Astra Max, utilisé comme point de comparaison. Cette animation provient du même site et reprend le même style que celle de 6.2 (capture d’écran du 2026-11-03).
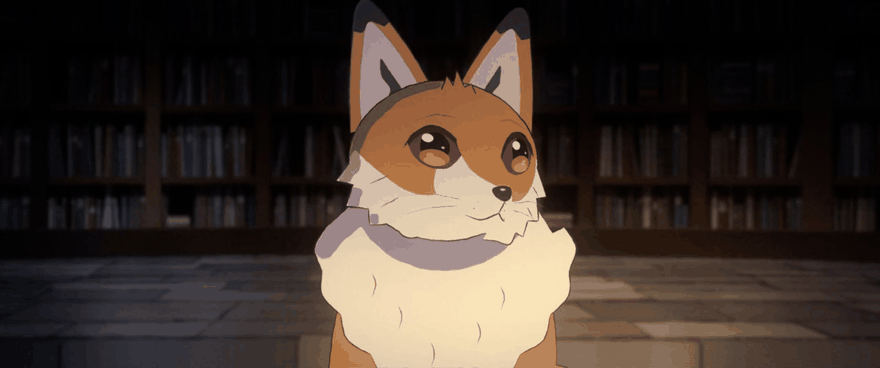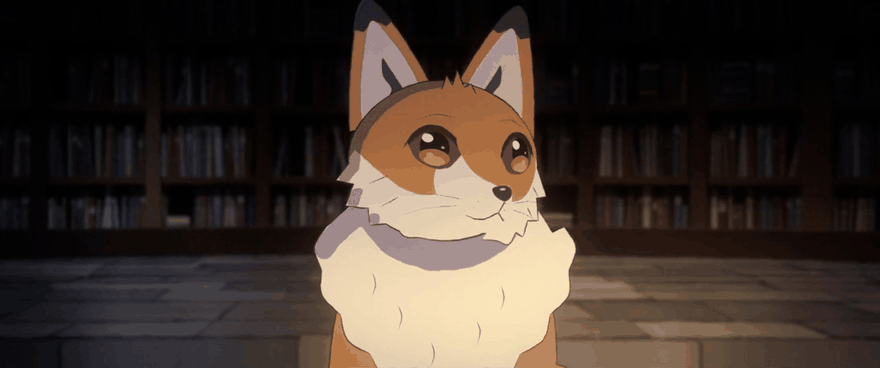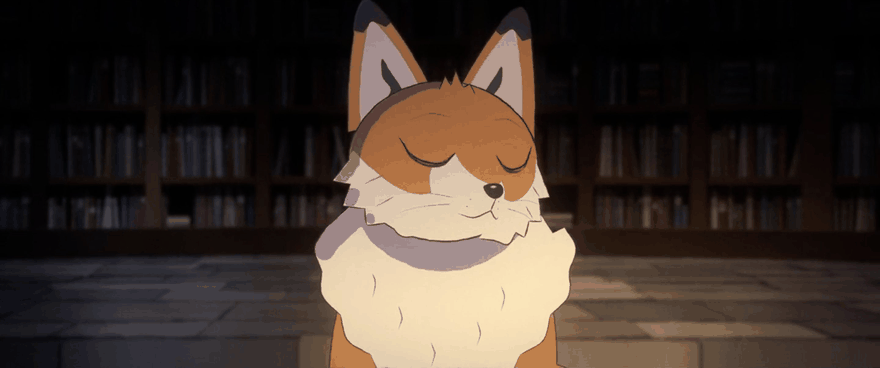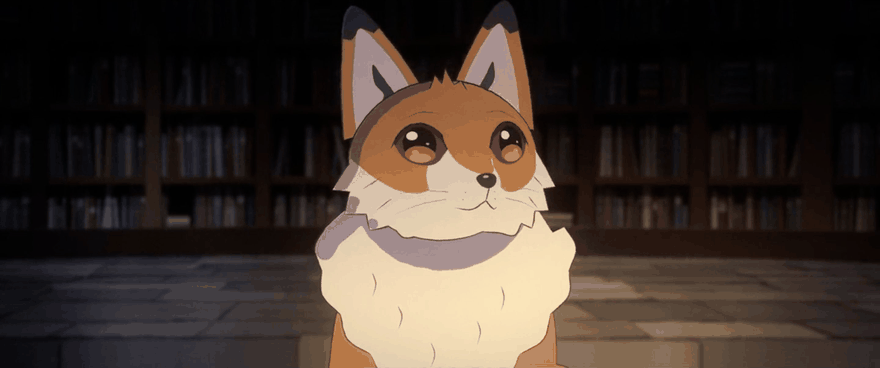
Légende : un extrait de The Last Page, court métrage sonore de 66 secondes réalisé avec Fable 5.5 xhigh, montrant le renard dans une bibliothèque au clair de lune (GIF extrait le 2026-11-03, sans son).
Jelly Koi Pond est la seule œuvre du site pour laquelle le coût et le temps de réalisation sont indiqués. La version Fable 5.1 xhigh a pris environ 1 h 40 et coûté 25 $ ; la combinaison Devin Fusion (Fable 5.1 xhigh et Sonnet 5.5 med) a pris environ 1 heure et coûté 11 $ (date : 2026-10-21 ; niveau de preuve : déclarations de la communauté). Pour toutes les autres œuvres, le site ne publie ni durée ni coût, et nous ne les estimons pas dans cet article.
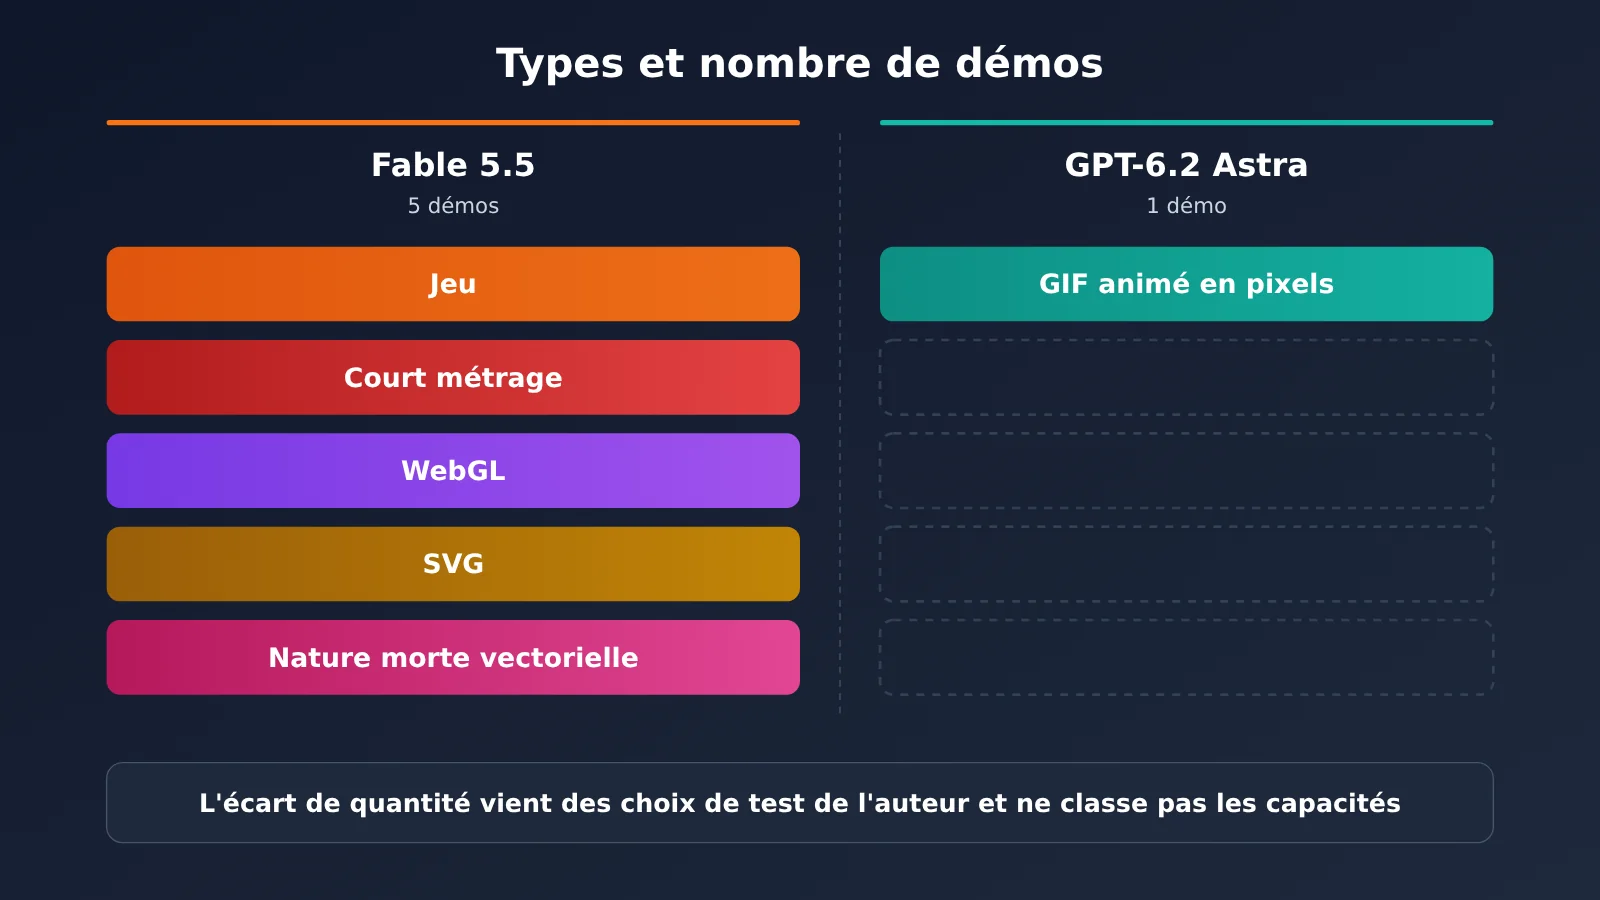
Le graphique ci-dessus montre la répartition des démos par type et par nombre, pas un classement des capacités. Pour mesurer l’écart réel entre les modèles phares actuels des deux entreprises sur vos propres tâches, vous pouvez invoquer claude-fable-5-1 et gpt-6-astra avec la même clé API sur APIYI apiyi.com.
Fable 5.5 vs GPT-6.2 Astra : trois points qui « semblent équitables, mais ne le sont pas »
Verdict : même site, même auteur… On pourrait croire à un comparatif en bonne et due forme. Pourtant, il y a au moins trois différences qui le rendent inéquitable.
Premier point : des exercices complètement différents
Les cinq réalisations de Fable 5.5 couvrent quatre catégories : jeux, courts métrages, WebGL et SVG. Celles de GPT-6.2 Astra se limitent à l’animation en pixels. Les deux modèles n’ont réalisé aucun exercice en commun. L’animation en pixels met à l’épreuve la composition et la cohérence d’une image à l’autre, tandis qu’un jeu dans un fichier unique teste l’organisation d’un code long et la gestion des états. Impossible de comparer directement les deux. Pour une comparaison dans le temps, GPT-6.2 Astra ne peut être comparé qu’à GPT-6 Astra (Hoshikawa) sur le même site, et Fable 5.5 qu’à Opus 5.5 (VoxelCraft — Shader Edition).
Deuxième point de déséquilibre : niveaux de raisonnement, dates et quantités ne sont pas comparables
La plupart des créations de Fable 5.5 portent la mention xhigh ; seule Fruit Basket est associée au niveau max. Pour GPT-6.2 Astra, c’est le niveau Max qui est indiqué. Ces niveaux correspondent à des budgets de raisonnement différents : on ne peut donc pas comparer directement la qualité des résultats. Il y a aussi cinq démonstrations d’un côté contre une seule de l’autre. Ce choix reflète simplement ce que l’auteur a décidé de tester, pas les résultats d’une évaluation officielle. Prendre le nombre de démonstrations comme indicateur des capacités est l’une des erreurs d’interprétation les plus fréquentes dans cette discussion.
Troisième point discutable : impossible de vérifier à quel modèle attribuer les résultats
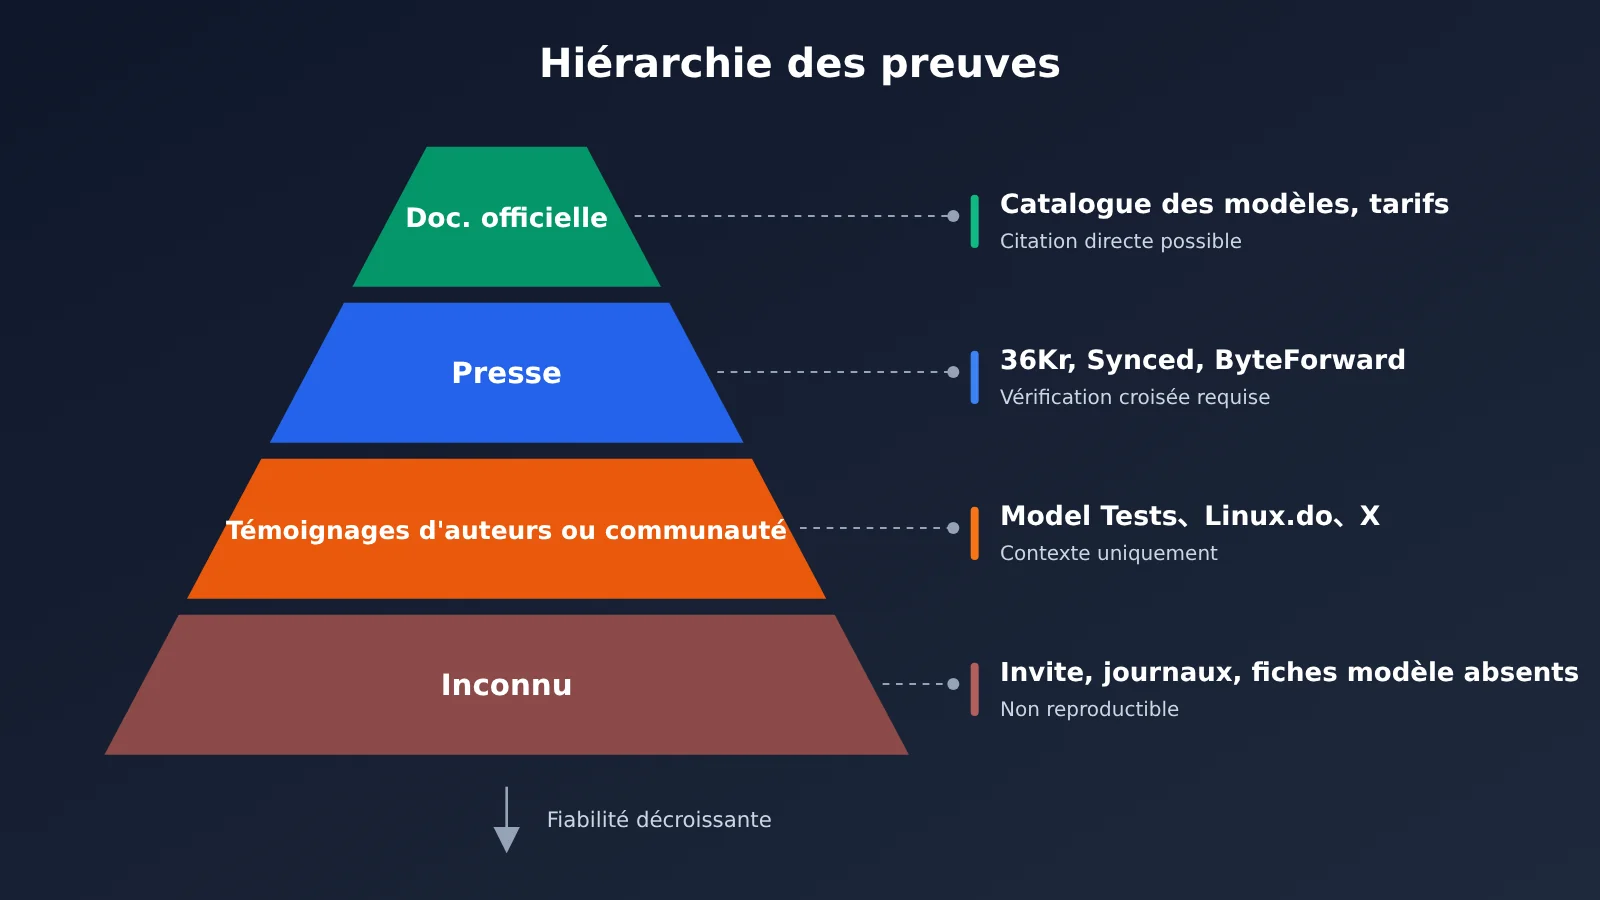
Aucune des démos ne publie ses invites, ses journaux d’invocation ou sa fiche de modèle : l’attribution repose entièrement sur les indications de l’auteur. Dans sa vérification du 02-11, ByteForward indique que certaines démos étiquetées « Fable 5.5 » pourraient résulter de requêtes Opus 5.5 redirigées vers un nouveau modèle, tandis que le sélecteur affichait toujours Opus 5.5 (niveau de preuve : article d’un seul média). Dans ces conditions, on peut seulement écrire « l’auteur affirme qu’il s’agit de Fable 5.5 », pas « Fable 5.5 a produit ce résultat ».
Le tableau ci-dessous classe les affirmations concernant ces deux modèles selon leur niveau de preuve. Si vous les relayez au sein de votre équipe, nous vous conseillons de conserver cette colonne.
| Affirmation | Source | Date | Niveau de preuve |
|---|---|---|---|
| Le catalogue d’Anthropic s’arrête à Fable 5.1, sans Fable 5.5 | Pages des tarifs et des actualités d’Anthropic | Consultées le 03-11 | Documentation officielle |
| Le catalogue d’OpenAI s’arrête à GPT-6 Astra, sans GPT-6.2 Astra | Catalogue des modèles OpenAI | Consulté le 03-11 | Documentation officielle |
LiteLLM a ajouté une entrée tarifaire azure_ai/claude-fable-5-5 |
Relevé de TestingCatalog | 13-10 | Relevé d’un tiers |
| Fable 5.5 prend en charge 1 million de tokens en entrée et 128 000 en sortie | 36 氪/新智元 | 02-11 | Article d’un seul média |
| Les évaluations compilées qualifient GPT-6.2 Astra de « bond significatif » | 机器之心/新浪 | 02-11 | Synthèse médiatique, sans benchmark |
| gpt-6.2-astra représente 1,6 % du détail d’utilisation | Linux.do @fourfour | 01-11 | Déclaration d’un membre de la communauté |
| gpt-6.2-astra représente 19,8 % du détail d’utilisation | X @TokenGremlin | 01-11 | Déclaration d’un membre de la communauté |
| Attribution des modèles aux démos sur Model Tests | Auteur @notjazii | Du 01-11 au 02-11 | Affirmation de l’auteur |
| Certaines démos Fable 5.5 résulteraient en fait de requêtes Opus 5.5 redirigées | ByteForward | 02-11 | Article d’un seul média |
Les données de trafic concernant GPT-6.2 Astra méritent une précision. Le message sur Linux.do présente la répartition de l’utilisation de Codex du 25-10 au 31-10 : gpt-6-astra représente encore 97,7 %, contre seulement 1,6 % pour gpt-6.2-astra. Dans les 13 lignes de facturation du même message, 12 concernent encore gpt-6-astra, avec une vitesse comprise entre 44 et 73 tok/s. Sur X, TokenGremlin a publié une version faisant état de 19,8 %, qui a été plus largement diffusée (environ 155 000 vues). Ces deux chiffres proviennent de captures d’écran publiées par des comptes personnels, et non de données officielles. 机器之心 précise d’ailleurs que les captures prouvent seulement que « certains utilisateurs déclarent avoir obtenu un accès ». Par ailleurs, GPT-6.2 Betelgeuse / Bel est un autre nom de code de modèle de base, qui circulait déjà auparavant : ce n’est pas la même chose que 6.2 Astra.
Les impressions de la communauté se contredisent aussi. Certains estiment que Fable 5.5 est plus performant, d’autres qu’il fait jeu égal avec Opus 5.5. Pour GPT-6.2 Astra, certains le jugent inférieur à Opus 5.5, d’autres n’y voient qu’une amélioration progressive, et d’autres encore estiment qu’il dépasse Opus 5.5 sur plusieurs aspects. Ces avis ne s’appuient ni sur des benchmarks ni sur des tailles d’échantillon : ils servent tout au plus à donner du contexte.
Fable 5.1 vs GPT-6 Astra : comparaison des spécifications et tarifs officiels
Verdict : les nouveaux modèles n’ont pas encore de spécifications officielles. Seuls les modèles phares actuels peuvent être comparés sur une base commune. Leurs tarifs unitaires sont identiques ; les vraies différences concernent la facturation des entrées longues, la date limite des connaissances et les niveaux de raisonnement.
Fable 5.1 et GPT-6 Astra affichent les mêmes tarifs officiels : 10 $ en entrée et 50 $ en sortie par million de tokens. Leur sortie maximale est de 128K, et leur fenêtre de contexte respective atteint 1M et 1,05M. Les données ci-dessous proviennent des pages officielles des deux modèles, consultées le 2026-11-03. Il s’agit donc de données issues de la documentation officielle.
| Spécification | Fable 5.1 | GPT-6 Astra |
|---|---|---|
| ID du modèle | Fable 5.1 officiel d’Anthropic | gpt-6-astra |
| Fenêtre de contexte | 1M | 1,05M |
| Sortie maximale | 128K | 128K |
| Date limite des connaissances | 2026-06 | 2026-04-30 |
| Contrôle du raisonnement | Adaptive thinking toujours activé, avec un niveau d’effort high par défaut |
low / medium / high / xhigh / max |
| Capacités des outils | Se référer à la documentation officielle | Appel de fonctions, recherche sur le Web, recherche dans les fichiers, computer use |
La différence entre les contrôles de raisonnement a un effet direct sur la conception des évaluations. L’Adaptive thinking de Fable 5.1 est toujours activé, avec un niveau d’effort high par défaut ; GPT-6 Astra propose cinq niveaux. Leurs noms ne correspondent pas d’un modèle à l’autre : on peut essayer de les rapprocher, mais pas les considérer comme parfaitement équivalents. Lors d’une évaluation, mieux vaut noter le niveau choisi plutôt que de supposer que high vaut high dans les deux cas.
Côté tarifs, les prix unitaires officiels sont identiques, mais les modalités de facturation diffèrent sensiblement. Le tableau ci-dessous présente à la fois les tarifs officiels et ceux proposés sur la plateforme APIYI (en dollars par million de tokens).
| Élément facturé | Tarif officiel Fable 5.1 | Tarif officiel GPT-6 Astra | Tarif proposé sur APIYI apiyi.com |
|---|---|---|---|
| Entrée | 10 $ | 10 $ | claude-fable-5-1 : 10 $ ; gpt-6-astra : 10 $ de 0 à 272 000 tokens |
| Entrée longue | 10 $ jusqu’à 1M | Se référer à la page officielle | gpt-6-astra : 20 $ de 272 001 à 1 050 000 tokens |
| Sortie | 50 $ | 50 $ | 50 $ pour les deux |
| Accès au cache / lecture | 0,25 $ | Se référer à la page officielle | claude-fable-5-1 : 0,25 $ ; gpt-6-astra : 1 $ |
| Écriture dans le cache | 12,50 $ pour 5 minutes, 20 $ pour 1 heure | Se référer à la page officielle | Se référer à la liste des modèles de la plateforme |
| Points de terminaison | messages | responses、chat | claude-fable-5-1 : chat / messages ; gpt-6-astra : responses / chat |
Pour les équipes qui analysent de longs documents ou cherchent à comprendre de grandes bases de code, ce tableau est plus utile que la question « lequel est le plus performant ? ». Lorsque l’entrée d’une requête dépasse 272 000 tokens, son tarif double à 20 $ pour gpt-6-astra, tandis que celui de claude-fable-5-1 reste à 10 $ jusqu’à 1M. Le prix de lecture du cache varie aussi d’un facteur quatre : 0,25 $ contre 1 $. Si votre usage implique des invocations répétées avec le même contexte long, ces deux écarts se verront nettement sur la facture. Pour les modèles et les tarifs, référez-vous à la liste des modèles de la plateforme.
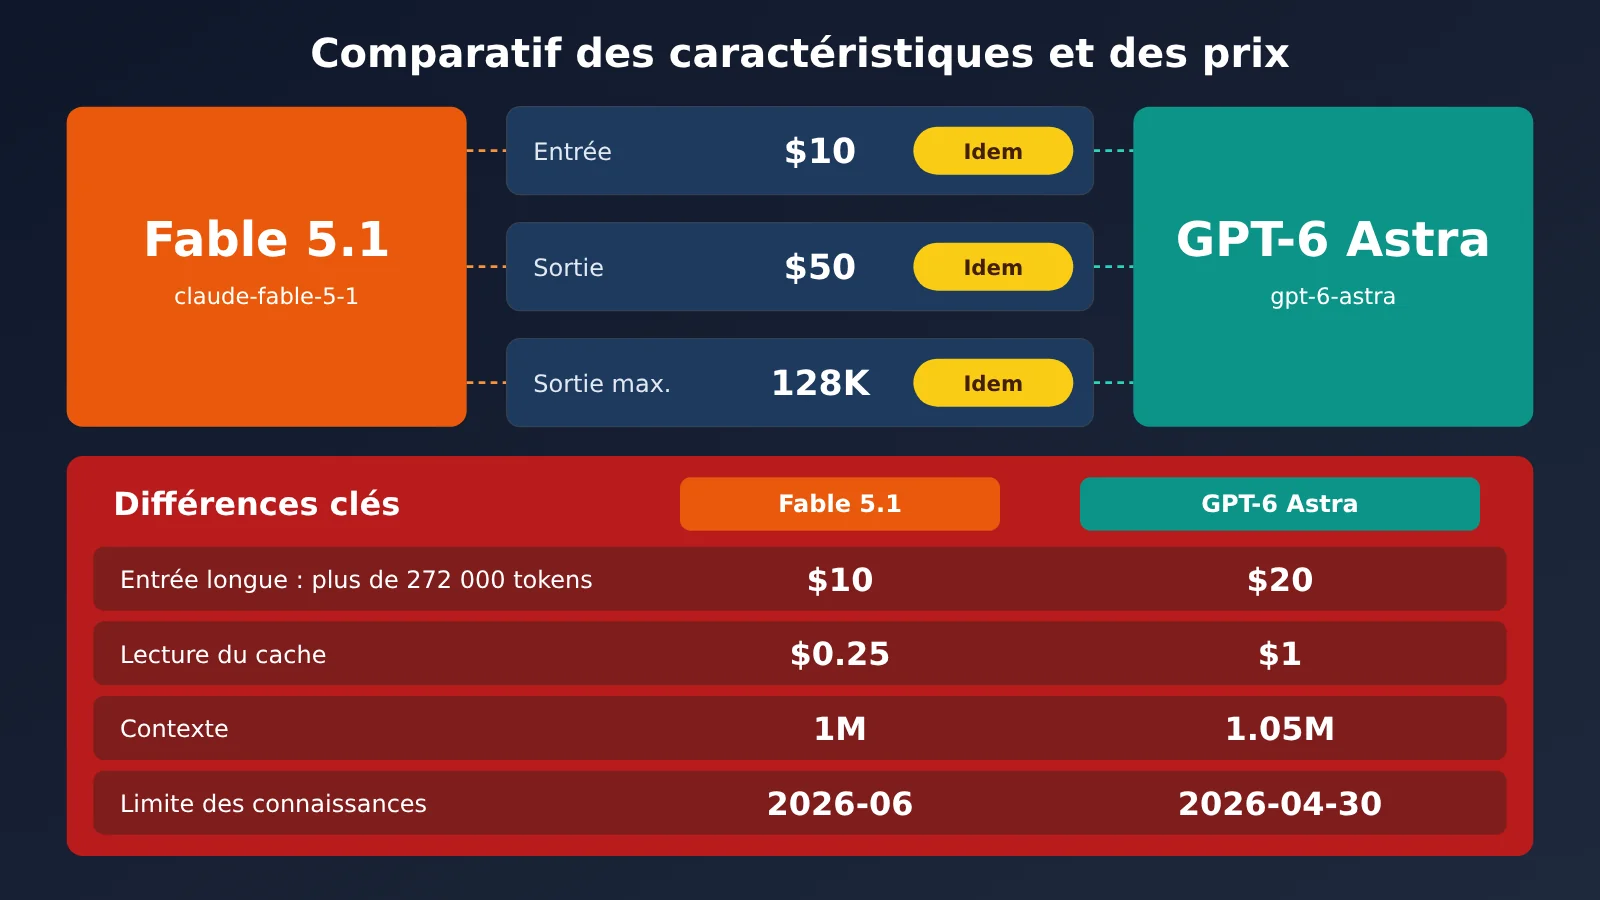
Les prix du graphique proviennent des pages officielles des modèles et de l’interface des prix de la plateforme APIYI apiyi.com. Ils ont été relevés le 3 novembre 2026.
Que peut-on utiliser en attendant Fable 5.5 et GPT-6.2 Astra ?
En bref : les nouveaux modèles ne disposent pas d’API officielle pour le moment. On peut toutefois établir une référence avec les modèles phares actuels des deux fournisseurs et préparer le cadre d’évaluation.
Au 3 novembre 2026, l’interface des modèles d’APIYI renvoie 259 modèles, contre 277 pour l’interface des prix. On y trouve notamment gpt-6-astra, gpt-6.1-sol, gpt-6.1-terra, gpt-6-luna et claude-fable-5-1, mais ni gpt-6.2-astra ni claude-fable-5-5. Il est donc déjà possible de comparer les modèles phares actuels des deux fournisseurs avec une même clé API. Le même jour, une requête messages envoyée à claude-fable-5-1 avec max_tokens réglé sur 32 a renvoyé HTTP 200 : l’interface est opérationnelle.
L’intégration est compatible avec le SDK OpenAI. Il suffit de définir base_url sur https://api.apiyi.com/v1 et d’indiquer le nom de modèle claude-fable-5-1 ou gpt-6-astra. Si vous avez besoin du format messages natif d’Anthropic, claude-fable-5-1 le prend également en charge. Pour gpt-6-astra, vous pouvez utiliser les points de terminaison responses ou chat.
🚀 Pour commencer rapidement : inscrivez-vous sur APIYI apiyi.com et utilisez le crédit d’essai gratuit destiné aux nouveaux utilisateurs. Testez d’abord
claude-fable-5-1etgpt-6-astrasur 3 à 5 tâches, vérifiez que le format de sortie et l’enregistrement des tokens sont corrects, puis passez au jeu de tests complet.
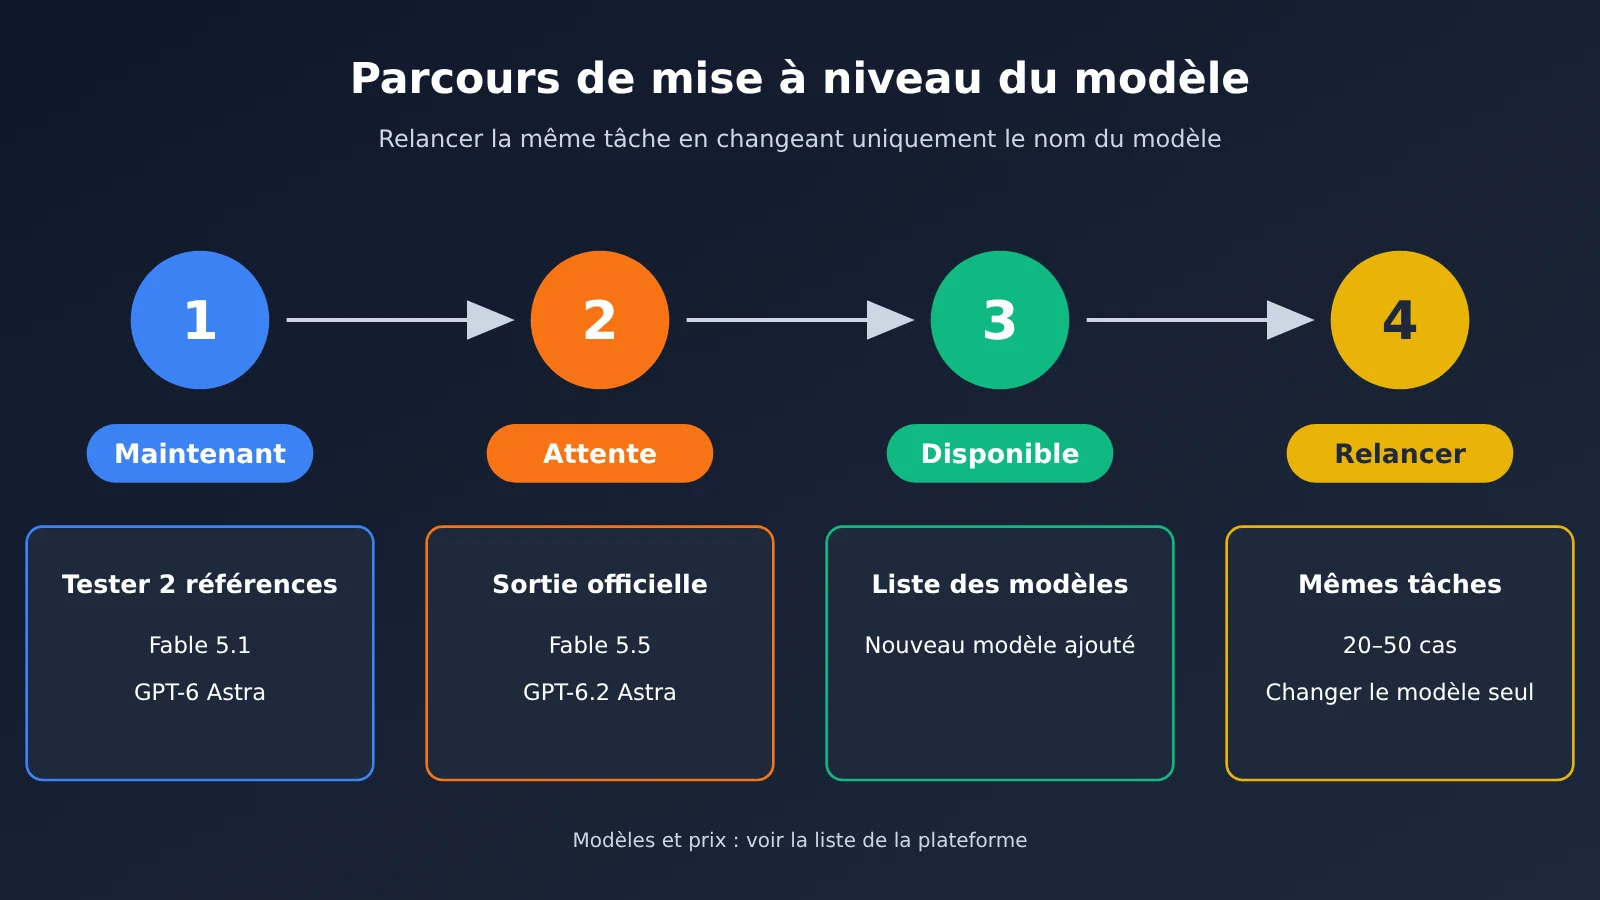
L’intérêt n’est pas de connaître à l’avance les performances des nouveaux modèles, mais de préparer le jeu de tests, les critères de notation et le tableau de suivi. Une fois Fable 5.5 ou GPT-6.2 Astra officiellement lancé, l’équipe n’aura qu’à changer le nom du modèle pour obtenir, en un ou deux jours, des conclusions adaptées à ses propres cas d’usage, sans dépendre des démos et des captures d’écran d’autres personnes.
Fable 5.5 vs GPT-6.2 Astra : comment choisir et tester
Notre conseil : inutile d’attendre les nouveaux modèles. Établissez d’abord une référence avec les modèles phares actuels, puis choisissez à partir de 20 à 50 de vos propres tâches, plutôt que de démos publiques.
Au 2026-11-03, Fable 5.5 et GPT-6.2 Astra ne sont pas encore disponibles sur APIYI. Dès leur sortie, nous les ajouterons à la plateforme aussi vite que possible. Pour les références et les tarifs, consultez la liste des modèles sur la plateforme. En attendant, voici quelques pistes pour orienter votre choix :
- Documents longs, grandes bases de code, utilisation répétée de longs contextes : évaluez d’abord
claude-fable-5-1. Le tarif d’entrée reste inchangé jusqu’à 1M de tokens et la lecture du cache ne coûte que $0.25, ce qui rend les coûts plus prévisibles. - Besoin d’ajuster finement le budget de raisonnement, recours à la recherche web ou à l’utilisation d’un ordinateur : évaluez d’abord
gpt-6-astra. Il propose cinq niveaux de raisonnement et les capacités d’outils annoncées officiellement sont plus complètes. - Tâches front-end dans un seul fichier et visualisations créatives : les deux modèles disposent d’exemples de réalisations, mais les attributions reposent sur les déclarations de leurs auteurs. Servez-vous-en comme source d’inspiration, puis vérifiez les résultats avec vos propres tâches.
- Sensibilité à l’actualité des connaissances : les connaissances de Fable 5.1 s’arrêtent à 2026-06, contre 2026-04-30 pour GPT-6 Astra. Cet écart d’environ deux mois peut être compensé à l’aide d’outils de recherche.
Mettre en place sa propre évaluation
Le principe est simple : « tout garder identique, sauf le nom du modèle ». Voici les étapes à suivre :
- Sélectionnez 20 à 50 tâches issues de cas d’usage réels, couvrant les principaux types : code, documents longs, sortie structurée, etc. Définissez un critère de réussite pour chacune.
- Gardez identiques l’invite système, l’invite utilisateur, le nombre maximal de tokens en sortie et le niveau de raisonnement. Pour Fable 5.1, notez l’
effort; pour GPT-6 Astra, notez le nom du niveau. - Pour chaque tâche, consignez les input tokens, les output tokens, le temps de bout en bout et le résultat de l’évaluation humaine.
- Signalez séparément les tâches dont l’entrée dépasse 272 000 tokens et calculez leur coût selon le tarif par palier applicable.
- Exécutez d’abord les deux modèles de référence,
claude-fable-5-1etgpt-6-astra. Une fois les nouveaux modèles disponibles, relancez les mêmes tâches en ne changeant que le nom du modèle.
Le tableau de suivi devrait contenir au minimum les champs suivants pour faciliter les comparaisons entre modèles et dans le temps :
| Champ | Données à consigner | Utilité |
|---|---|---|
| ID et type de tâche | Code / document long / sortie structurée, etc. | Ventiler le taux de réussite par scénario |
| Nom du modèle et niveau de raisonnement | Par exemple gpt-6-astra high |
Garantir des conditions identiques lors des nouvelles exécutions |
| input / output tokens | Données usage renvoyées par la plateforme | Calculer le coût réel par tâche |
| Durée | De la requête à la réponse complète | Évaluer l’expérience d’interaction |
| Validation humaine | Oui / non + raison | Mesurer la qualité finale |
💡 Conseil : exécuter les modèles des deux fournisseurs avec une même clé évite que les différences de réseau ou de limites de débit liées à plusieurs comptes ne faussent les résultats. Avec APIYI apiyi.com, les appels passent par une interface commune et les champs usage ont le même format, ce qui facilite leur consolidation dans un tableau.
Questions fréquentes et conseils pratiques
Q1 : Les démos sur Model Tests montrent-elles que Fable 5.5 est plus performant que GPT-6.2 Astra ?
Non. Les deux modèles n’ont pas été soumis au même exercice, les niveaux de raisonnement, les dates et le nombre de réalisations diffèrent, et l’identité des modèles repose sur les déclarations de leurs auteurs. Tout au plus, ces démos montrent que, selon leurs auteurs, les deux modèles peuvent produire des résultats fonctionnels ou consultables.
Q2 : Fable 5.5 et GPT-6.2 Astra sont-ils sortis ? Quand seront-ils disponibles ?
Au 2026-11-03, aucun des deux modèles ne figure dans les catalogues officiels des deux entreprises et aucune date de sortie fiable n’a été annoncée. À cette même date, Fable 5.5 et GPT-6.2 Astra ne sont pas encore disponibles sur APIYI. Nous les ajouterons dès que possible ; consultez la liste des modèles de la plateforme pour connaître les références et les prix. Une fois disponibles, vous pourrez les retrouver directement dans la liste des modèles sur APIYI, à l’adresse apiyi.com.
Q3 : La capture d’écran indiquant 19.8% du trafic est-elle crédible ?
Elle provient d’une capture personnelle de l’utilisateur X TokenGremlin. Une publication antérieure sur Linux.do indiquait seulement 1.6%, et le sélecteur de modèles affichait toujours GPT-6 Astra. Les témoignages des utilisateurs ne concordent pas non plus. Ces deux chiffres sont issus de déclarations de la communauté, pas de données officielles : ils montrent seulement que ce nom de modèle est apparu dans le détail de consommation de certains comptes.
Q4 : Faut-il attendre les nouveaux modèles ou utiliser les modèles phares actuels ?
Nous vous conseillons de commencer par les modèles phares actuels. Fable 5.1 et GPT-6 Astra ont les mêmes tarifs unitaires, leurs capacités sont parmi les meilleures et ils peuvent déjà être utilisés en production. Le plus important est de préparer dès maintenant votre jeu de tests pour pouvoir tirer rapidement des conclusions à l’arrivée des nouveaux modèles. Sur APIYI, à l’adresse apiyi.com, vous pouvez utiliser les crédits de test gratuits pour effectuer un essai sur un petit échantillon et valider votre processus d’évaluation.
Q5 : Les deux modèles phares actuels ont les mêmes tarifs. Le coût peut-il quand même différer ?
Oui. Pour `gpt-6-astra`, lorsque l’entrée d’une requête dépasse 272,000 tokens, son tarif passe de $10 à $20 ; la lecture du cache coûte $1, contre $0.25 pour `claude-fable-5-1`. La différence est particulièrement marquée avec de longs contextes et un taux élevé de lectures depuis le cache. Mieux vaut calculer les coûts à partir de votre distribution réelle de tokens.
Recommandations
Pour les équipes qui choisissent un modèle ce mois-ci, nous recommandons trois étapes : cette semaine, rassemblez 20 à 50 tâches représentatives de vos activités et définissez leurs critères de validation ; puis, sur APIYI apiyi.com, testez claude-fable-5-1 et gpt-6-astra avec la même clé API pour établir deux références, en consignant le nombre de tokens, le temps d’exécution et le taux de validation humaine ; enfin, une fois Fable 5.5 ou GPT-6.2 Astra officiellement lancé et disponible sur la plateforme, relancez les mêmes tests en changeant uniquement le nom du modèle. Vous disposerez alors de données comparatives fondées sur vos propres tâches et obtenues dans les mêmes conditions : elles seront plus fiables que n’importe quelle démo ou capture d’écran. Consultez la liste des modèles sur la plateforme pour connaître les modèles et les tarifs en vigueur.
Sources
- Catalogue des modèles OpenAI : caractéristiques et tarifs officiels de GPT-6 Astra
- Lien :
developers.openai.com/api/docs/models - Note : consulté le 2026-11-03 ; GPT-6.2 Astra ne figure pas dans le catalogue
- Tarifs et page des modèles de la plateforme Anthropic : caractéristiques, tarifs et facturation du cache officiels de Fable 5.1
- Lien :
platform.claude.com - Note : consulté le 2026-11-03 ; Fable 5.5 ne figure ni sur la page des tarifs ni sur celle des actualités
- Model Tests, site de tests indépendant : collection de démos publiques de l’auteur @notjazii
- Lien :
model-tests.vercel.app - Note : l’attribution des modèles repose sur les déclarations de l’auteur ; aucune invite ni aucun journal d’invocation n’est fourni
Auteur : équipe technique APIYI
Échanges techniques : rendez-vous sur la page d’accueil d’APIYI apiyi.com pour nous contacter. Les modèles et la documentation d’intégration sont disponibles sur docs.apiyi.com.