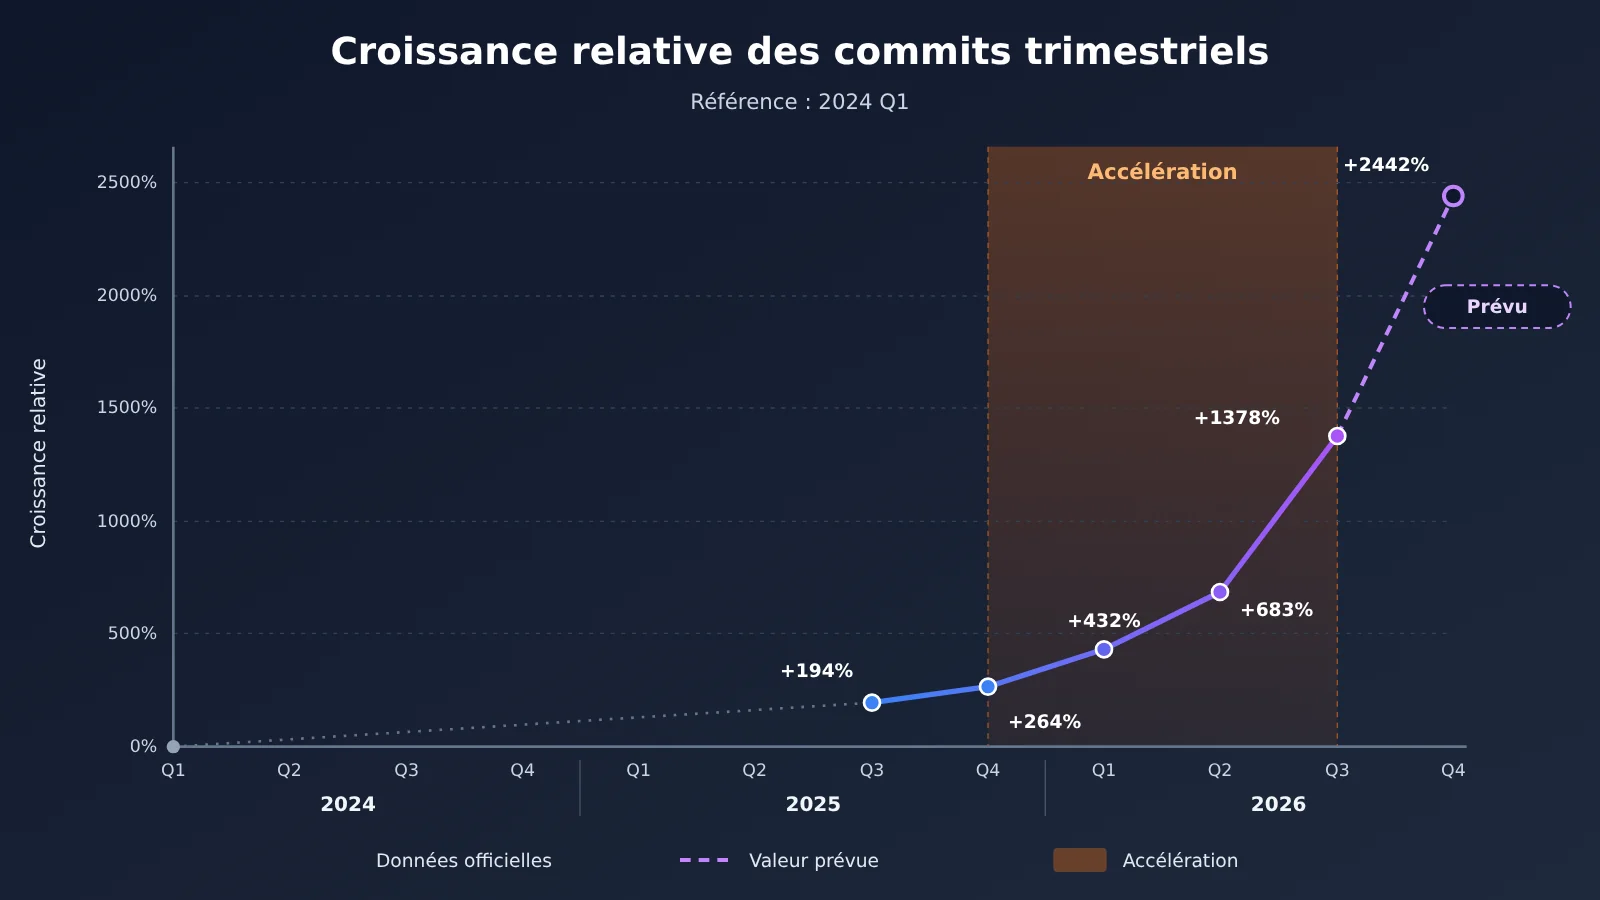
Note de l’auteur : OpenAI dévoile Pando, son nouveau backend Git. Sous l’effet de Codex, le nombre de commits trimestriels dans son dépôt monolithique devrait augmenter de 2442 % par rapport au premier trimestre 2024. Cet article retrace les effets de la programmation assistée par IA, de la génération de code jusqu’à Git, à l’intégration continue et à la revue de code.
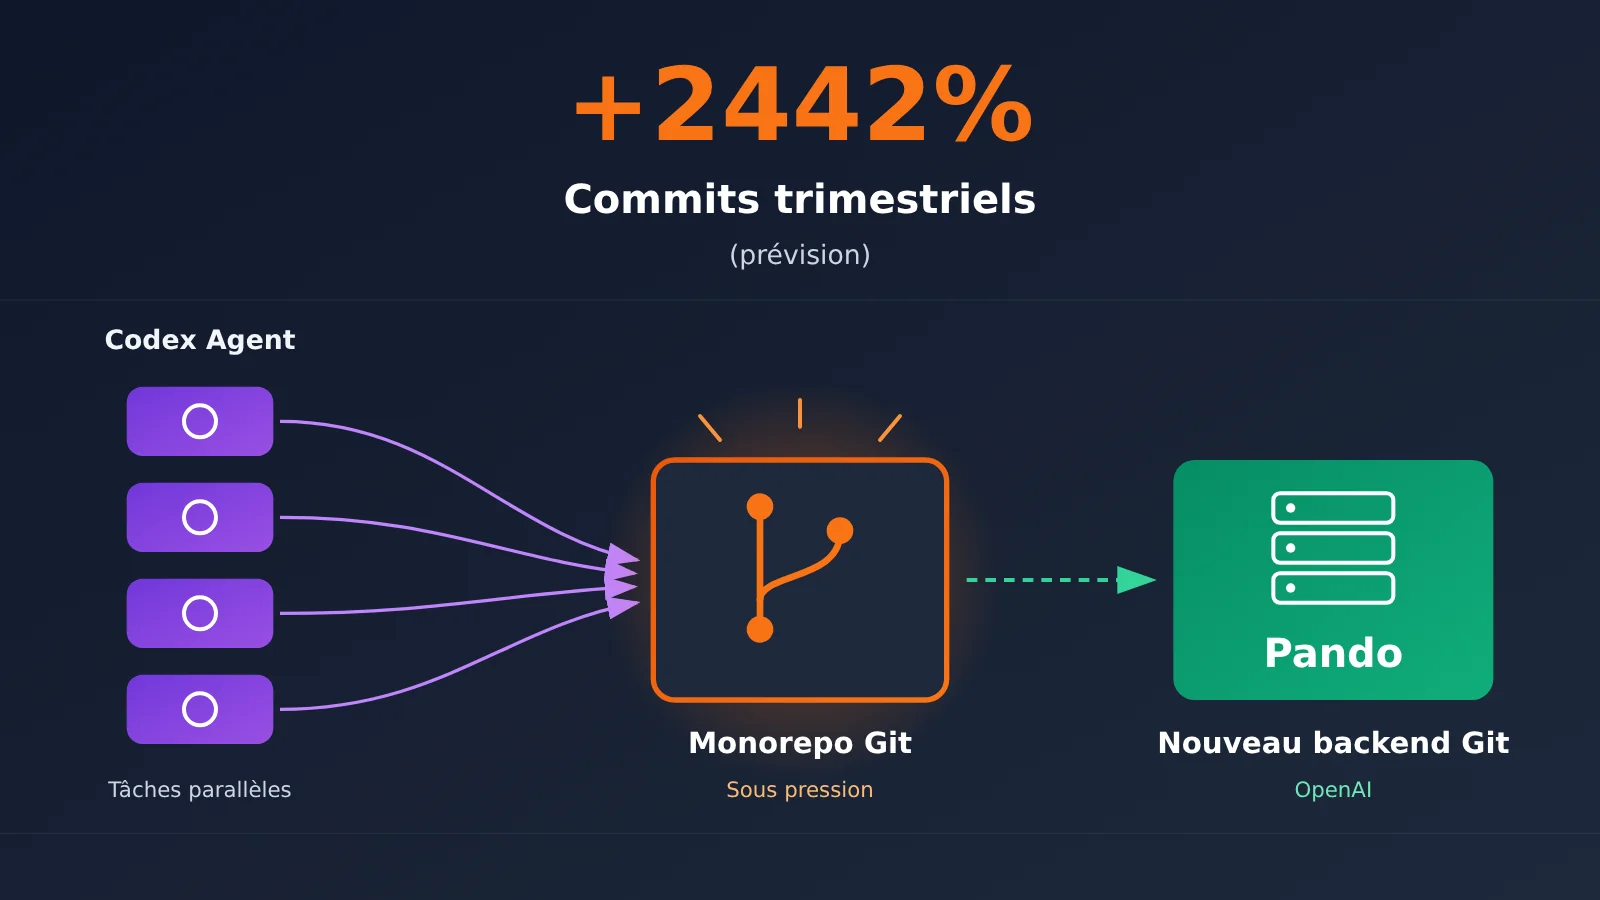
Le 2 novembre 2026, OpenAI a publié l’article technique « Scaling Git at OpenAI ». Un graphique indique que le nombre de commits trimestriels dans le dépôt monolithique d’OpenAI devrait augmenter de 2442 % au quatrième trimestre 2026 par rapport au premier trimestre 2024. Pour faire face à la pression exercée par les développements simultanés avec Codex, OpenAI a reconstruit son backend Git et l’a baptisé Pando.
Ce n’est ni une rumeur ni un slogan marketing affirmant que « l’IA multiplie le volume de code par 24 ». Ces chiffres proviennent du blog d’ingénierie officiel d’OpenAI, dans un article signé par Aaron Friel, Taylor Blau et Ted Nyman. Deux précisions s’imposent : les 2442 % sont une prévision, puisque le quatrième trimestre n’est pas encore terminé ; la mesure porte sur le nombre de commits fusionnés dans la branche master, et non sur le nombre de lignes de code, encore moins sur la productivité.
L’essentiel : cet article explique comment les tâches parallèles de Codex changent l’échelle du développement logiciel chez OpenAI, pourquoi l’infrastructure Git subit une pression accrue et vers où se déplacent les goulots d’étranglement.
Codex et l’infrastructure Git d’OpenAI : l’essentiel en bref
Commençons par les faits. Toutes les informations du tableau proviennent des communications officielles d’OpenAI ; les éléments non publiés sont clairement signalés.
| Élément | Détails |
|---|---|
| Date de publication | 2 novembre 2026, « Scaling Git at OpenAI » |
| Équipe à l’origine de la publication | Équipe d’ingénierie d’OpenAI (Aaron Friel, Taylor Blau, Ted Nyman) |
| Contenu principal | Pando, un nouveau backend de serveur Git compatible avec le protocole et les clients Git standards |
| Contexte direct | Codex accroît le parallélisme du développement, ce qui entraîne des problèmes de performance et de fiabilité dans l’ancien système Git |
| Mise en production | Trafic de production pris en charge depuis avril 2026 ; environ 10 semaines entre le lancement du projet et sa mise en service |
| Résultats clés | Latence médiane des pushs réduite de près de 80 %, et près de 1 PB de données Git livrées chaque jour |
| Disponibilité externe | Usage interne à OpenAI uniquement ; aucune publication du serveur, aucun tarif ni aucune date d’ouverture annoncés |
L’évolution trimestrielle des commits portée par Codex
De nombreux articles ne citent que le chiffre de 2442 %. La série trimestrielle complète donne une meilleure idée de l’évolution. Le tableau ci-dessous prend 2024 Q1 comme référence et comptabilise les commits fusionnés dans la branche master du dépôt monolithique d’OpenAI.
| Trimestre | Croissance par rapport à 2024 Q1 | Multiplication approximative par rapport à la référence |
|---|---|---|
| 2024 Q2 | +35 % | 1.35 |
| 2024 Q4 | +98 % | 1.98 |
| 2025 Q2 | +194 % | 2.94 |
| 2025 Q4 | +264 % | 3.64 |
| 2026 Q1 | +432 % | 5.32 |
| 2026 Q2 | +683 % | 7.83 |
| 2026 Q3 | +1,378 % | 14.78 |
| 2026 Q4 | +2,442 % (prévision) | 25.42 |
Ces données révèlent trois choses. Premièrement, la croissance était déjà en cours entre 2024 et 2025 : on ne peut donc pas l’attribuer entièrement à Codex. Deuxièmement, la courbe devient nettement plus raide entre les +264 % de 2025 Q4 et les +1,378 % de 2026 Q3. Cette accélération correspond à la tendance au développement parallèle par des agents décrite par OpenAI. Troisièmement, OpenAI n’a publié que les taux de croissance relatifs, sans communiquer le nombre absolu de commits par trimestre.
Une autre mesure, calculée différemment, va dans le même sens. Le 20 juillet 2026, le blogue destiné aux développeurs d’OpenAI indiquait, dans sa présentation de Codex Code Review, que le nombre hebdomadaire de pull requests internes avait plus que doublé par rapport au quatrième trimestre précédent. Cette mesure et la croissance trimestrielle des commits reposent sur des méthodes de calcul et des périodes différentes : on ne peut ni les additionner ni convertir l’une en l’autre. Toutes deux montrent néanmoins une augmentation rapide de l’activité liée aux modifications de code.
Comment Codex met l’infrastructure Git sous pression
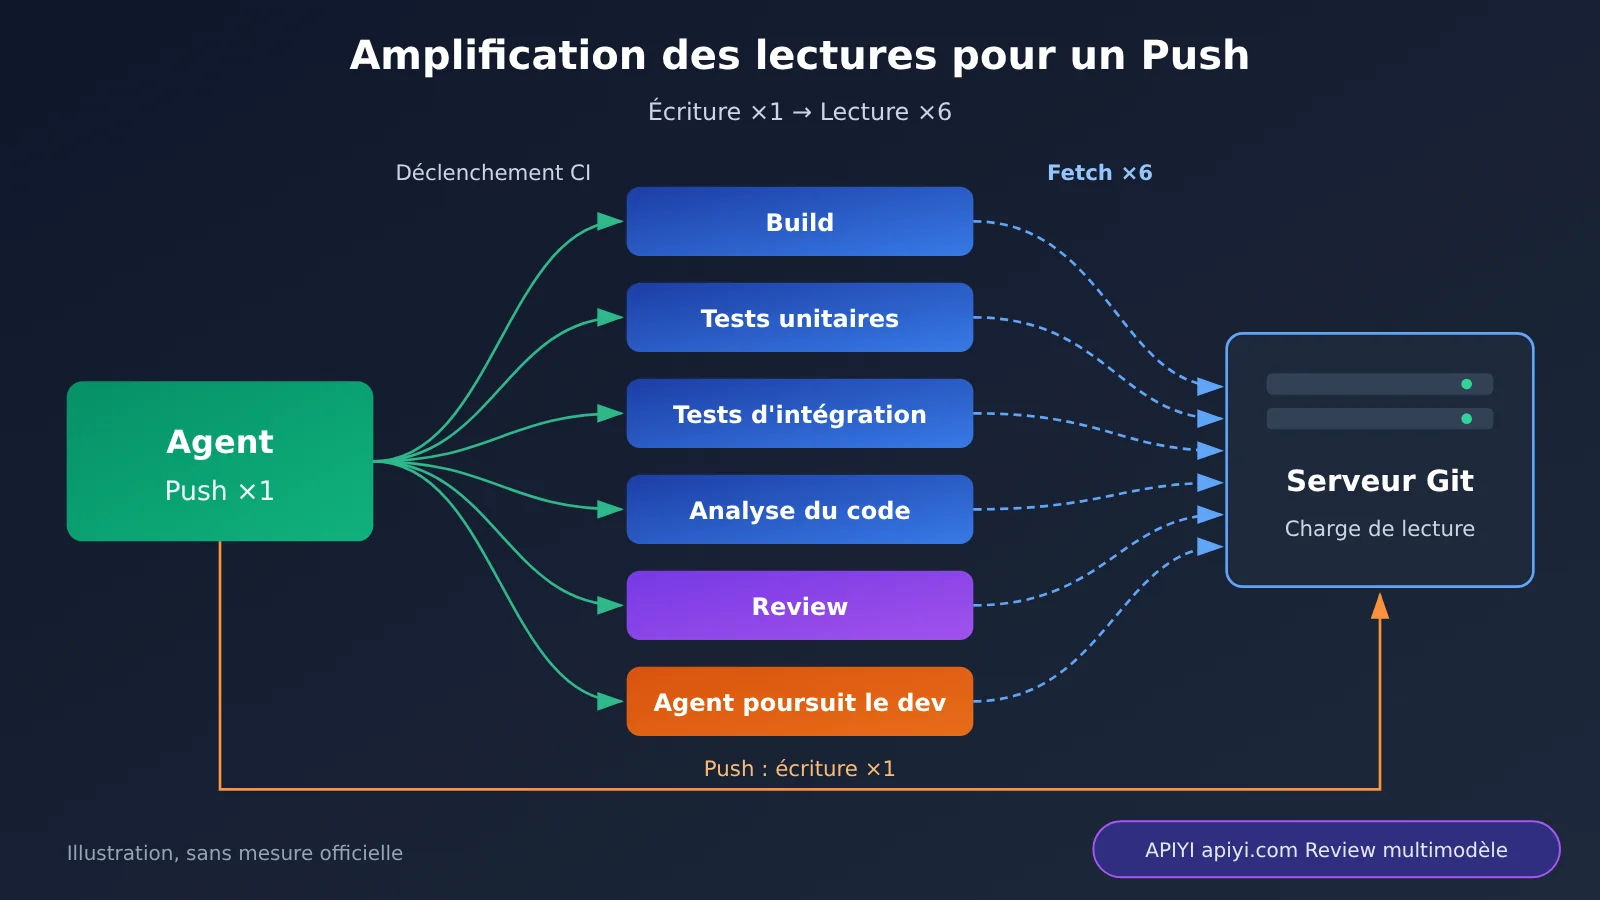
On pourrait penser que le fait que l’IA écrive du code plus vite ne concerne que les développeurs. Mais l’explication d’OpenAI pointe un autre effet : Codex augmente le nombre de tâches exécutées en parallèle dans tout le système d’ingénierie. Un ingénieur peut confier simultanément à plusieurs agents des fonctionnalités indépendantes. Chaque agent crée des branches, des commits et des push, qui déclenchent à leur tour toute une série de lectures automatisées.
Le tableau ci-dessous résume cette chaîne de causalité d’après les explications officielles d’OpenAI.
| Étape | Ce qui se passe | Effet sur l’infrastructure Git |
|---|---|---|
| A. Baisse du coût d’exécution | Les ingénieurs confient simultanément à plusieurs agents des modifications sur des fonctionnalités indépendantes | Le nombre de tâches de développement augmente |
| B. Parallélisme accru | Davantage de branches, de commits et de push Git | Les requêtes d’écriture et les mises à jour de branches se multiplient |
| C. Amplification par les pipelines | Un push déclenche plusieurs builds, tests et analyses CI | Le même commit est récupéré à répétition par des fetch |
| D. Pression sur l’infrastructure partagée | Les fusions, la synchronisation des états et la distribution des données de version augmentent en même temps | Les push et les fetch ralentissent, les fusions échouent |
| E. Déplacement du goulot d’étranglement | Le modèle écrit du code plus vite, mais Git, la CI et la revue de code ne montent pas en capacité au même rythme | Les étapes en aval freinent la livraison |
Un exemple d’amplification de la charge
Prenons un exemple purement illustratif : les chiffres ne proviennent pas de mesures d’OpenAI. Supposons qu’un push déclenche 6 tâches CI, chacune récupérant le code une fois avec un fetch. Ainsi, 100 push peuvent entraîner environ 600 lectures du code. Si les agents multiplient le nombre de push, le volume de lectures augmente dans les mêmes proportions.
Le nombre réel de requêtes dépend du cache CI, de la réutilisation des tâches et de l’architecture des builds, mais la tendance est claire. La hausse des écritures est amplifiée côté lecture : c’est là que le serveur Git atteint ses limites en premier. OpenAI souligne d’ailleurs qu’un même commit peut être récupéré à répétition par plusieurs tâches CI, travaux de recherche et environnements de développement.
Que s’est-il passé avec l’ancien système Git d’OpenAI ?
OpenAI a indiqué qu’à partir de fin 2025, les systèmes qui soutenaient son dépôt monolithique avaient de plus en plus de mal à absorber la charge. Parmi les symptômes : des opérations Git Fetch et Push plus lentes, des échecs de fusion et une fiabilité de l’infrastructure parfois inférieure à 90 %.
Il faut bien comprendre ce que signifie « inférieure à 90 % ». Ce chiffre décrit la fiabilité du système à certaines périodes ; les modalités de calcul et la série chronologique complète n’ont pas été publiées. Il ne signifie donc ni que « 10 % du code présente des défauts », ni que « plus de 10 % des commits d’OpenAI ont échoué ».
D’un point de vue technique, l’ancienne architecture présentait deux goulets d’étranglement structurels :
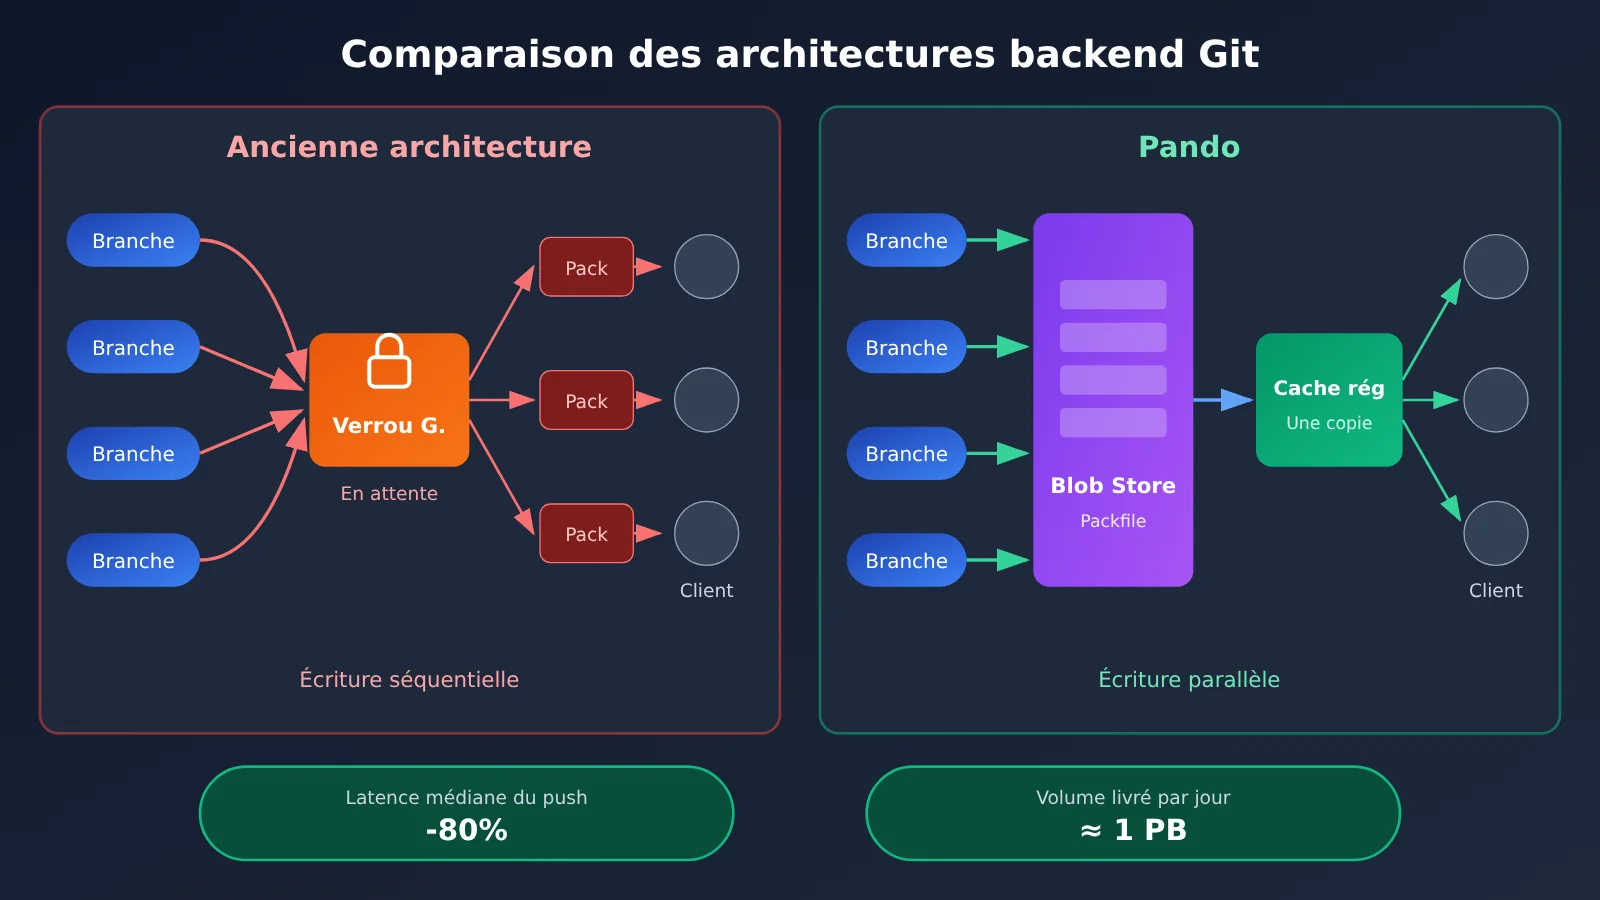
- Les mises à jour de branches nécessitaient une coordination globale : de nombreux services Git distribués traditionnels doivent maintenir un état cohérent pour toutes les références du dépôt. Même lorsque deux agents modifient des branches sans aucun rapport, leurs opérations peuvent emprunter le même chemin de coordination.
- Les paquets à télécharger étaient recalculés plusieurs fois : comme les clients disposent d’historiques Git différents, le serveur doit souvent parcourir les objets, les empaqueter et les compresser séparément pour chacun d’eux. Lorsque plusieurs agents lisent la même version, ces opérations coûteuses sont répétées.
À l’époque où les ingénieurs humains étaient les principaux utilisateurs, ces deux limites restaient acceptables. Mais avec l’arrivée simultanée d’un grand nombre d’agents et de tâches CI, elles sont devenues des goulets d’étranglement.
Comment Pando répond à la pression exercée par Codex sur Git
OpenAI n’a pas abandonné Git. Pando utilise toujours le protocole et les clients Git standard : les commandes et les workflows des ingénieurs restent donc globalement inchangés. Ce sont le stockage côté serveur, la mise à jour des références et la distribution des données qui ont été repensés. Le tableau ci-dessous compare les principales différences entre l’ancienne solution et Pando.
| Dimension | Serveur Git traditionnel | Pando |
|---|---|---|
| Écriture sur les branches | Coordination forte à l’échelle du dépôt : même des branches sans rapport peuvent s’attendre mutuellement | Chaque branche est mise à jour indépendamment ; seule une modification de la même Ref nécessite une coordination |
| Modèle de cohérence | Instantané cohérent à l’échelle du dépôt | Cohérence causale : l’ordre des opérations et la lecture de ses propres écritures sont garantis sur une même branche |
| Distribution des données | Recréation et compression des paquets selon l’état du client | Réutilisation des Packfiles enregistrés lors du Push et distribution via un cache |
| Cache | Dépend de l’implémentation | Service de cache régional, avec un taux de succès supérieur à 99 % pour les Packfiles |
| Compatibilité client | Git standard | Git standard, avec distribution via le mécanisme packfile-uri |
Les deux idées clés de Pando
La première est la concurrence des écritures. Pando ne cherche plus à maintenir un instantané cohérent de l’ensemble du dépôt à un instant donné. Chaque branche gère désormais sa propre version. Les Push sur différentes branches peuvent s’exécuter en parallèle ; seuls les conflits entre requêtes modifiant une même Ref doivent être traités. En contrepartie, lorsqu’un client lit plusieurs branches en une seule opération, celles-ci peuvent correspondre à des instants différents. OpenAI estime que ce compromis convient à ses besoins.
La seconde est la réutilisation pour les lectures. Pando stocke chaque Packfile reçu lors d’un Push comme une donnée immuable dans un Blob Store. Lorsqu’un autre client effectue un Fetch, le serveur sélectionne des Packfiles existants à lui envoyer en fonction des Commit qu’il possède déjà et de ceux qu’il demande, au lieu de recréer des paquets. En arrière-plan, il fusionne aussi progressivement de nombreux petits Packfiles en ensembles plus volumineux, pour éviter qu’un client resté longtemps sans mise à jour ait à télécharger trop de fichiers.
Les chiffres de production publiés par OpenAI comprennent une baisse de près de 80 % de la latence médiane des Push, près de 1 PB de données Git distribuées chaque jour et un pic de distribution de Packfiles supérieur à 57 TB en une heure. Attention : 1 PB correspond au volume distribué. Les lectures répétées des mêmes données sont comptabilisées, ce qui ne signifie pas que 1 PB de nouveau code est produit chaque jour.
À noter que Pando lui-même a été développé avec la participation d’Agents. Selon OpenAI, son architecture centrale a été conçue par un ingénieur, puis plusieurs équipes d’Agents ont participé à son implémentation. La validation s’est appuyée sur une suite de tests de compatibilité Git et sur des tests par simulation déterministe. OpenAI n’affirme toutefois pas que tout le code a été écrit par l’IA.
Les effets de la programmation assistée par l’IA : le goulot d’étranglement se déplace
Quels effets pour les développeurs et les équipes ?
Ce qui compte vraiment dans l’histoire de Pando, ce n’est pas qu’OpenAI ait développé son propre backend Git, mais la tendance qu’elle révèle : la programmation assistée par l’IA réduit le coût de génération du code et reporte la pression en aval de la chaîne de développement. Git n’est que le premier maillon où le problème est apparu : la revue de code, les tests et l’intégration subissent la même pression.
Dans son article sur Codex Code Review, OpenAI reconnaît que de plus en plus de PR attendent d’être examinées. Les personnes chargées des revues ont du mal à comprendre rapidement les contraintes héritées et à évaluer les risques de compatibilité des API. Codex Code Review peut donc lire les règles de revue définies dans le fichier AGENTS.md du dépôt. Il peut ainsi protéger les contrats d’API existants, repérer les journaux susceptibles d’exposer des données clients et éviter de perturber les intégrations avec les services existants.
Pour les équipes de développement qui utilisent l’IA, cela implique plusieurs ajustements concrets :
- Documenter les règles de revue : consignez les contraintes implicites de l’équipe dans un fichier de règles comme AGENTS.md, pour que la revue par l’IA puisse s’y référer.
- Prévoir une marge pour la CI : lorsque les agents travaillent en parallèle, le nombre de tâches CI peut augmenter avant les coûts de personnel. Évaluez à l’avance les besoins en cache et les quotas de concurrence.
- Revoir les indicateurs : ne vous limitez pas au nombre de commits ou de PR. Suivez aussi le délai de livraison et le taux d’échec des changements.
- Donner la priorité à la validation : la couverture des tests, les tests avec objets simulés et les tests de compatibilité déterminent si le code produit par les agents peut être fusionné en toute confiance.
Exemple minimal de revue de code par plusieurs modèles d’IA
Pour tester dans votre dépôt un processus de revue de diff fondé sur des règles, vous pouvez créer rapidement un prototype avec une interface compatible OpenAI. L’exemple ci-dessous lit le diff local et demande au modèle de le commenter selon des critères définis :
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # Remplacez par un modèle de programmation disponible sur la plateforme
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
Voir le code complet (lecture des règles d’AGENTS.md et comparaison de plusieurs modèles)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Une seule clé pour invoquer des modèles de plusieurs fournisseurs
)

def load_rules(path: str = "AGENTS.md") -> str:
    """Lit les règles de revue du dépôt ou renvoie les règles par défaut si le fichier n’existe pas"""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """Récupère le diff à examiner"""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """Invoque le modèle pour examiner les modifications selon les règles"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # Remplacez ces valeurs par les noms des modèles à comparer pour observer leurs différences de revue
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 Conseil pour démarrer : pour créer un prototype de revue de code par IA, vous pouvez obtenir des crédits de test gratuits sur APIYI apiyi.com. Une seule clé API permet d’invoquer des modèles OpenAI, Claude, Gemini et d’autres fournisseurs, ce qui facilite la comparaison de leurs revues selon les règles de votre dépôt.
Impact sur le secteur
Dans son article, The New Stack estime qu’OpenAI fait partie des premiers utilisateurs intensifs d’agents de codage. Les tensions qu’elle rencontre sur son infrastructure pourraient annoncer les difficultés auxquelles d’autres grandes entreprises et plateformes d’hébergement de code seront confrontées. Il s’agit toutefois d’une analyse de tendance de la part du média : elle ne prouve pas que GitHub ou GitLab ont déjà subi les mêmes pannes.
La communauté des développeurs est elle aussi partagée. Les optimistes estiment que la baisse du coût du développement rendra viables de nombreux petits projets qui ne valaient pas la peine d’être lancés auparavant. Les sceptiques soulignent quant à eux qu’un plus grand nombre de commits ne signifie pas que les logiciels apportent plus de valeur : si la revue et les tests ne suivent pas, la livraison ne sera pas nécessairement plus rapide. D’autres rappellent que les problèmes d’échelle des grands monorepos ne datent pas de l’ère de l’IA.
Comprendre les données de Codex : cinq indicateurs à ne pas confondre
Lorsqu’on discute des effets de la programmation assistée par IA, l’erreur la plus fréquente consiste à mélanger différents indicateurs. Le tableau ci-dessous aide à comprendre ce que chaque donnée permet ou non de déduire.
| Indicateur | Ce qu’il mesure | Situation dans cette actualité |
|---|---|---|
| Nombre de commits | Fréquence des commits | Croissance trimestrielle estimée à +2 442 %, seule la valeur relative est disponible |
| Nombre de PR | Activité liée aux propositions de modification et à leur fusion | Le nombre hebdomadaire de PR a plus que doublé par rapport au T4 précédent |
| Nombre de lignes de code | Volume de code | Non communiqué ; impossible à déduire de la croissance des commits |
| Lead Time | Temps écoulé entre le début d’une modification et sa livraison | Non communiqué |
| Taux d’échec des changements | Proportion des mises en production qui provoquent un incident | Non communiqué |
Le cas de Pando montre que la charge de travail liée au développement de code chez OpenAI a fortement augmenté et que l’infrastructure Git existante a atteint ses limites. Il ne prouve pas que la qualité des logiciels ou la productivité des développeurs ont augmenté dans les mêmes proportions, et ne permet pas non plus d’estimer combien d’ingénieurs Codex a remplacés.
Par ailleurs, Harness Engineering, présenté par OpenAI en février 2026, est une autre expérience indépendante : en partant d’un dépôt vide, un projet de l’ordre du million de lignes a été réalisé en environ cinq mois, avec près de 1 500 PR au total. Ces données concernent un autre projet, sans lien avec Pando, mais elles reflètent la même tendance : le travail des ingénieurs se concentre de plus en plus sur l’architecture, la chaîne d’outils, les boucles de rétroaction et la validation du code.
💡 Conseil pour choisir : si votre équipe commence elle aussi à utiliser des agents de codage, comparez d’abord à petite échelle les performances de plusieurs modèles en génération et en revue de code. L’interface unifiée d’APIYI apiyi.com permet de passer rapidement d’un modèle à l’autre et de les évaluer avec les mêmes jeux de test avant de choisir votre modèle principal.
Questions fréquentes (FAQ)
Q1 : Codex a-t-il vraiment multiplié par 24 le volume de code produit par OpenAI ?
Ce n’est pas ce que disent les chiffres. Selon les données officielles, « le nombre trimestriel de commits fusionnés dans master devrait augmenter de 2 442 % par rapport au premier trimestre 2024 ». Il s’agit d’une prévision qui porte sur le nombre de commits, pas sur le nombre de lignes de code. Un commit peut contenir des modifications plus ou moins importantes : ce chiffre ne mesure donc ni le volume de code ni la productivité.
Q2 : Pando remplace-t-il GitHub ?
Non. Pando est un backend serveur compatible avec le protocole Git standard, utilisé uniquement en interne chez OpenAI. Au 3 novembre 2026, aucun serveur, tarif ou date d’ouverture au public n’a été annoncé. OpenAI a publié le dépôt d’un client Git amélioré, et certaines modifications ont été intégrées au projet Git en amont. Cela ne signifie pas que le serveur Pando est devenu open source.
Q3 : Une équipe classique doit-elle reconstruire son infrastructure Git comme OpenAI ?
Pour la plupart des équipes, non. OpenAI travaille avec un monorepo de très grande taille et de nombreux agents exécutés en parallèle. Pour les petites et moyennes équipes, les principaux obstacles sont généralement les quotas CI, la couverture des tests et les ressources humaines disponibles pour la revue de code. Mieux vaut renforcer ces aspects en priorité.
Q4 : Comment tester à faible coût un processus de revue de code par IA ou un agent de développement ?
Vous pouvez commencer par créer un prototype minimal avec une interface compatible avec OpenAI. Suivez l’exemple de code de cet article pour lire le diff et le fichier de règles, puis confiez la revue au modèle. En vous inscrivant sur APIYI apiyi.com, vous obtenez des crédits de test gratuits. Remplacez ensuite base_url par `https://api.apiyi.com/v1` pour comparer les résultats de revue de plusieurs modèles avec une même clé API.
Q5 : La programmation assistée par IA ne risque-t-elle pas simplement de produire davantage de code de mauvaise qualité ?
C’est justement au cœur du débat dans la communauté, et la question reste ouverte. OpenAI n’a pas publié l’évolution du taux de défauts, du taux de retours arrière ou du coût net de développement. On ne peut donc affirmer ni que la qualité s’est globalement dégradée, ni qu’elle s’est améliorée. L’approche la plus prudente consiste à suivre à la fois les délais de livraison et le taux d’échec des changements au sein de votre équipe. Vous pouvez aussi utiliser APIYI apiyi.com pour accéder à plusieurs modèles et croiser leurs revues, afin de réduire le risque qu’un seul modèle passe à côté d’un problème.
Codex et évolution de l’infrastructure Git : les points clés
- Bien interpréter les chiffres : 2 442 % correspond à la croissance prévue du nombre de commits trimestriels au quatrième trimestre 2026, et non à celle du nombre de lignes de code.
- La croissance s’accélère nettement : la courbe devient plus abrupte après le quatrième trimestre 2025, mais la hausse avait commencé dès 2024.
- La pression vient de la concurrence des tâches : Codex permet d’exécuter davantage de tâches en parallèle, et la hausse des écritures est amplifiée par les lectures effectuées par la CI.
- L’ancien système ne tient plus : à partir de fin 2025, les opérations Push et Fetch ralentissent, et la fiabilité passe parfois sous les 90 %.
- La solution Pando : écritures indépendantes par branche, réutilisation des Packfiles et mise en cache ont permis de réduire la latence médiane des Push de près de 80 %.
- Les goulots d’étranglement se déplacent en aval : la revue de code, les tests, l’intégration et la livraison deviennent les nouvelles contraintes.
- Pour commencer : utilisez l’interface unifiée d’APIYI apiyi.com pour créer rapidement un prototype de revue avec plusieurs modèles.
En résumé
Les changements apportés par Codex chez OpenAI se résument à trois points :
- À l’échelle du développement : le nombre de commits trimestriels dans le dépôt monolithique devrait augmenter de 2 442 % par rapport au premier trimestre 2024. Le nombre de PR double lui aussi : l’activité de modification du code est fortement amplifiée.
- Côté infrastructure : les agents exécutés en parallèle créent davantage de branches, de Push et de lectures par la CI. L’ancien backend Git a rencontré des problèmes de performance et de fiabilité ; OpenAI a construit Pando en environ 10 semaines pour y répondre.
- Dans les processus d’ingénierie : écrire du code n’est plus l’étape la plus lente. Les capacités de revue, de test et de livraison déterminent si la programmation avec l’IA peut réellement créer de la valeur.
Pour la plupart des équipes, plutôt que de chercher à multiplier les commits, mieux vaut d’abord renforcer les capacités de validation et de revue, puis augmenter progressivement le nombre d’agents exécutés en parallèle. Pour tester rapidement un processus de revue par IA ou d’agent de développement, vous pouvez utiliser le crédit gratuit d’APIYI apiyi.com pour comparer les performances réelles de plusieurs modèles.
📚 Sources
- Scaling Git at OpenAI : article technique officiel d’OpenAI sur Pando (2026-11-02)
- Lien :
openai.com/index/scaling-git-at-openai -
À propos : source principale des faits présentés et des données sur la croissance trimestrielle des commits
-
Custom Code Review rules for Codex : blog des développeurs d’OpenAI (2026-07-20)
- Lien :
developers.openai.com/blog/custom-code-review-rules-for-codex -
À propos : source concernant le doublement du nombre hebdomadaire de PR et les règles de revue dans AGENTS.md
-
Harness engineering : expérience indépendante d’OpenAI sur le développement par des agents (2026-02-11)
- Lien :
openai.com/index/harness-engineering -
À propos : cas distinct pour comprendre l’évolution du rôle des ingénieurs, sans lien avec le projet Pando
-
OpenAI Git Fork : dépôt public du client Git maintenu par OpenAI
- Lien :
github.com/openai/git -
À propos : pour découvrir les améliorations du client, notamment packfile-uri
-
Article de The New Stack : analyse externe de Pando (2026-11-02)
- Lien :
thenewstack.io - À propos : référence pour l’analyse des tendances du secteur
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI. Pour en savoir plus sur l’intégration des modèles, consultez le centre de documentation docs.apiyi.com.