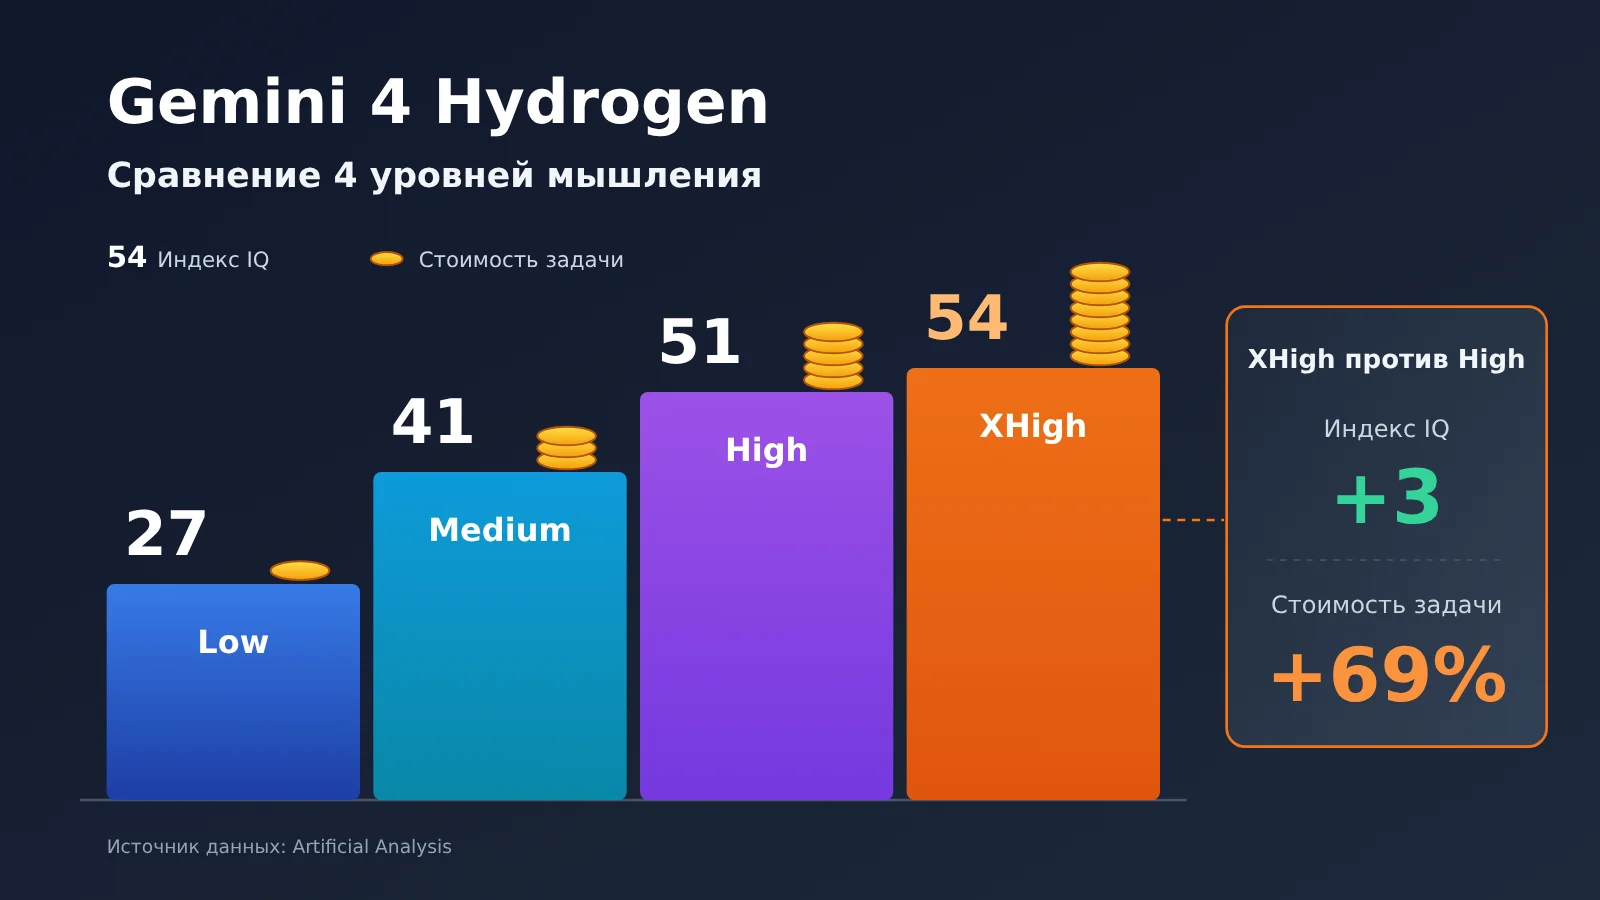
Краткое резюме в одном предложении: По данным четырёхуровневого тестирования Artificial Analysis, при переходе Gemini 4 Hydrogen с High на XHigh индекс интеллекта вырос всего на 3 балла, а стоимость выполнения тестовых заданий увеличилась примерно на 69%. Поэтому уровень мышления лучше выбирать под сложность задачи.
12 ноября 2026 года компания Google официально выпустила Gemini 4 Hydrogen и одновременно предложила четыре уровня мышления: Low, Medium, High и XHigh. Все четыре уровня используют один и тот же ID модели и один и тот же тариф за токены, но в независимых тестах их баллы, стоимость и время ожидания сильно различаются.
Это не рекомендация в духе «чем выше уровень, тем лучше». В этой статье на основе стандартизированных данных тестирования Artificial Analysis мы рассчитываем предельную выгоду каждого уровня и даём чёткие рекомендации по выбору уровня в зависимости от типа задачи.
Ключевая ценность: после прочтения вы сможете определить, какой уровень подходит вашему бизнесу, и как управлять расходами на рассуждения с помощью параметра thinking_level.
Термины, которые нужно знать перед сравнением четырёх уровней рассуждения Gemini 4 Hydrogen
- thinking_level: параметр уровня рассуждения, который задаёт глубину размышлений модели. Hydrogen поддерживает четыре значения: Low, Medium, High и XHigh.
- Токены рассуждения: токены, которые модель использует для размышлений перед выдачей финального ответа. Согласно официальной странице цен Google, они тарифицируются как выходные токены.
- Токен: единица измерения, которой модель обрабатывает текст, изображения и другую информацию; API тарифицируется за миллион токенов.
- Harness: тестовый фреймворк, который формирует входные данные для модели, выполняет вызовы инструментов и оценивает задачи. Результаты, полученные с разными Harness, нельзя сравнивать напрямую.
- API: интерфейс, через который программы вызывают сервис. Примеры кода в этой статье используют формат, совместимый с OpenAI.
Почему результаты четырёх уровней одного и того же Gemini 4 Hydrogen так сильно отличаются?
Gemini 4 Hydrogen — высокоэффективная модель от Google DeepMind, предназначенная в первую очередь для повседневного программирования и выполнения задач AI-агентов. Идентификатор модели в API — gemini-4-hydrogen. Четыре уровня рассуждения — это не четыре разные модели, а четыре глубины рассуждения одной и той же модели. В документации Google Cloud для каждого уровня указаны рекомендуемые задачи:
| Уровень рассуждения | Официальное рекомендуемое применение | Глубина рассуждения | По умолчанию? |
|---|---|---|---|
| Low | Простые задачи, такие как классификация | Неглубокий | Нет |
| Medium | Обычное программирование | Средний | Нет (уровень по умолчанию для 3.8 Flash) |
| High | Многошаговые агенты | Глубокий | ✅ По умолчанию для Hydrogen |
| XHigh | Сложные задачи, требующие глубоких рассуждений | Самый глубокий | Нет |
Почему при одинаковой цене четырёх уровней рассуждения Hydrogen счёт получается разным?
По состоянию на 13 ноября 2026 года официальная цена Google для тарифа Standard составляет $1.50 за миллион входных токенов и $7.50 за миллион выходных токенов — между четырьмя уровнями разницы нет. Всё дело в расходе токенов: чем выше уровень, тем больше токенов рассуждения модель создаёт до ответа, и эти токены тарифицируются по цене выходных.
Поэтому «одинаковая цена за токен» не означает «одинаковая стоимость каждой задачи». Один и тот же вопрос на XHigh может породить в несколько раз больше рассуждений, чем на High, и счёт тоже вырастет. Оценивая стоимость, нельзя смотреть только на длину финального ответа — нужно учитывать и невидимую часть рассуждений.
Четыре режима Gemini 4 Hydrogen в реальных тестах: сравнение баллов, стоимости и скорости
Данные ниже взяты у сторонней организации Artificial Analysis; тестирование провели в день публикации. Индекс интеллекта, стоимость задачи оценки и среднее время взяты из её Intelligence Index v5.0.1; задержка до первого токена ответа и общее количество выходных токенов — из снимка страницы от 13 ноября 2026 года. Все приведённые данные — результаты сторонних стандартизированных оценок, а не собственных измерений на этом сайте.
| Уровень рассуждений | Индекс интеллекта | Средняя стоимость на задачу | Среднее время на задачу | Задержка до первого токена ответа | Выходные токены за полный набор тестов |
|---|---|---|---|---|---|
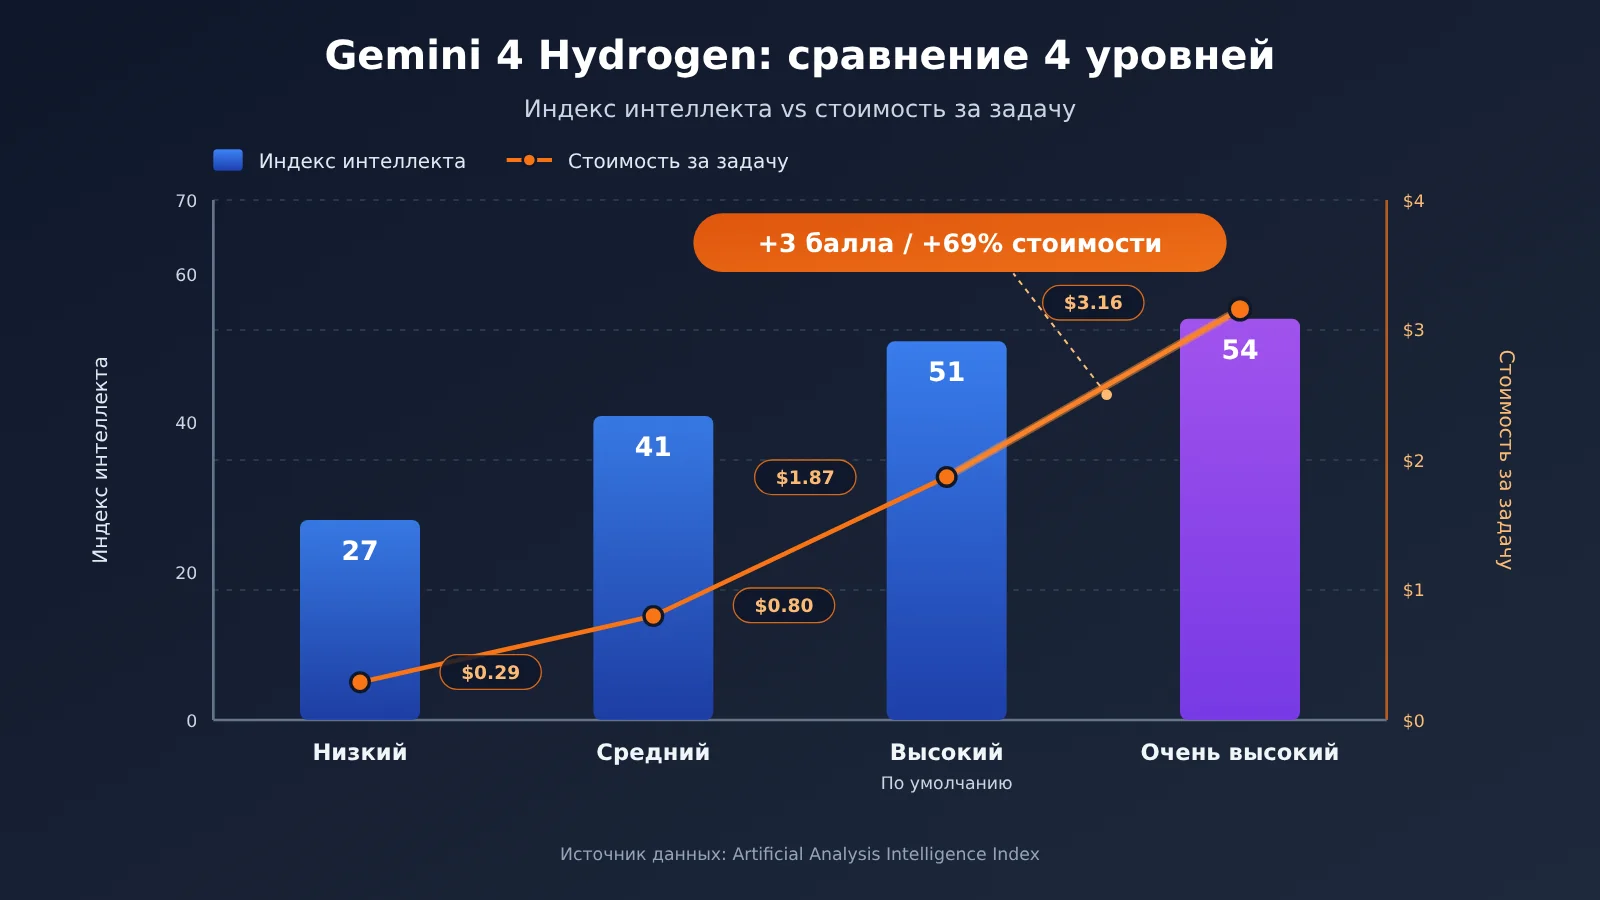
| Low | 27 | $0.29 | 1,3 мин | ~5,7 с | 20,3 млн |
| Medium | 41 | $0.80 | 3,7 мин | ~11,8 с | 54,4 млн |
| High (по умолчанию) | 51 | $1.87 | 8,3 мин | ~18,9 с | 110 млн |
| XHigh | 54 | $3.16 | 13,5 мин | ~37,8 с | 304 млн |
Не путайте три временных показателя
В таблице есть три типа показателей, и они означают разное:
- Индекс интеллекта: агрегированная оценка способностей по нескольким бенчмаркам; показывает только относительный уровень в рамках этого набора оценок.
- Среднее время на задачу: взвешенный показатель, рассчитанный по числу выходных токенов задачи и сквозной скорости вывода; отражает стандартизированную нагрузку оценки. Если пользователь задаёт простой вопрос, ему не обязательно ждать 8,3 минуты.
- Задержка до первого токена ответа: время ожидания от отправки запроса до появления первого токена ответа, включая этап рассуждений модели; в диалоговых сценариях это наиболее ощутимый для пользователя показатель.
Из таблицы видно, что разрыв в баллах между Medium и High (10 баллов) намного больше, чем между High и XHigh. У модели с одним и тем же названием реальная разница в возможностях между уровнями может превышать 20 баллов, поэтому, сравнивая Hydrogen с другими моделями, сначала нужно уточнить, какой уровень используется у другой модели.
Gemini 4 Hydrogen XHigh стоит на 69% дороже, чем High, — так что же вы за это получаете?
Если сравнить все четыре уровня попарно, можно увидеть выгоду и цену каждого шага повышения. Проценты прироста в таблице ниже рассчитаны редакцией на основе данных, опубликованных Artificial Analysis.
| Путь повышения уровня | Изменение индекса интеллекта | Изменение стоимости задачи | Изменение среднего времени | Дополнительная стоимость за +1 балл |
|---|---|---|---|---|
| Low → Medium | +14 балла | +176% | +185% | около $0.036 |
| Medium → High | +10 баллов | +134% | +124% | около $0.107 |
| High → XHigh | +3 балла | +69% | +63% | около $0.43 |
Убывающая отдача: предельная стоимость четырёх уровней мышления Hydrogen
При переходе с High на XHigh индекс интеллекта растёт с 51 до 54, примерно на 5.9%; стоимость одной задачи увеличивается с $1.87 до $3.16, время выполнения — с 8.3 до 13.5 минуты, а задержка первого ответа удваивается с примерно 18.9 секунды до примерно 37.8 секунды. Если считать «за каждый дополнительный балл», предельная стоимость XHigh примерно в 12 раз выше, чем у перехода Low → Medium.
Причина в основном в объёме токенов. На полном наборе тестов High выдаёт около 110 млн токенов, а XHigh — около 304 млн, то есть примерно в 2.76 раза больше. Однако счёт не вырос в 2.76 раза, потому что общая стоимость включает ещё и входные токены, попадания в кэш и способ взвешивания тестовых задач, так что пересчитывать расходы напрямую по кратности выходных токенов нельзя.
Низкий средний балл не означает, что на сложных задачах выгода тоже низкая
Индекс интеллекта — это средний результат по множеству задач, и разница в 3 балла может объясняться двумя сценариями: на большинстве задач оба уровня показывают одинаковый результат, а на нескольких особо сложных XHigh заметно лучше. Для таких задач, как научные рассуждения, математические доказательства или крупный рефакторинг с переходом между файлами, где «одна ошибка — и всё рушится», дополнительные размышления XHigh могут решить, справится ли модель с задачей вообще.
Поэтому точнее будет сказать так: на обычных задачах XHigh даёт очень низкую отдачу за деньги, но на некоторых особо сложных задачах может быть необходим. Стоит ли платить на 69% больше — нужно проверять на собственной выборке задач, а не смотреть только на средний балл.
🎯 Технический совет: возьмите сначала 20–50 реальных задач и прогоните их на High и XHigh, сравнив долю успешных решений и затраты на одну задачу. Через APIYI apiyi.com можно провести A/B-тест, переключая параметры с тем же API-ключом, без изменения структуры бизнес-кода.
Для каких задач подходят четыре уровня размышления Gemini 4 Hydrogen?
Если совместить официальные рекомендации Google с приведёнными выше данными о стоимости, можно дать такие советы по сложности задач:
| Тип задачи | Рекомендуемый уровень | Типичные примеры | Почему именно так |
|---|---|---|---|
| Классификация, извлечение данных, приведение к формату | Low | Классификация обращений, извлечение полей, форматирование JSON, простые вопросы-ответы | Самая низкая стоимость, задержка до первого токена около 5.7 секунды — хорошо для высокой параллельности |
| Обычная работа с кодом и контентом | Medium | Написание функций в одном файле, переписывание текстов, суммаризация документов, обычная автоматизация бизнес-процессов | На 14 баллов выше Low, а стоимость всё ещё меньше половины от High |
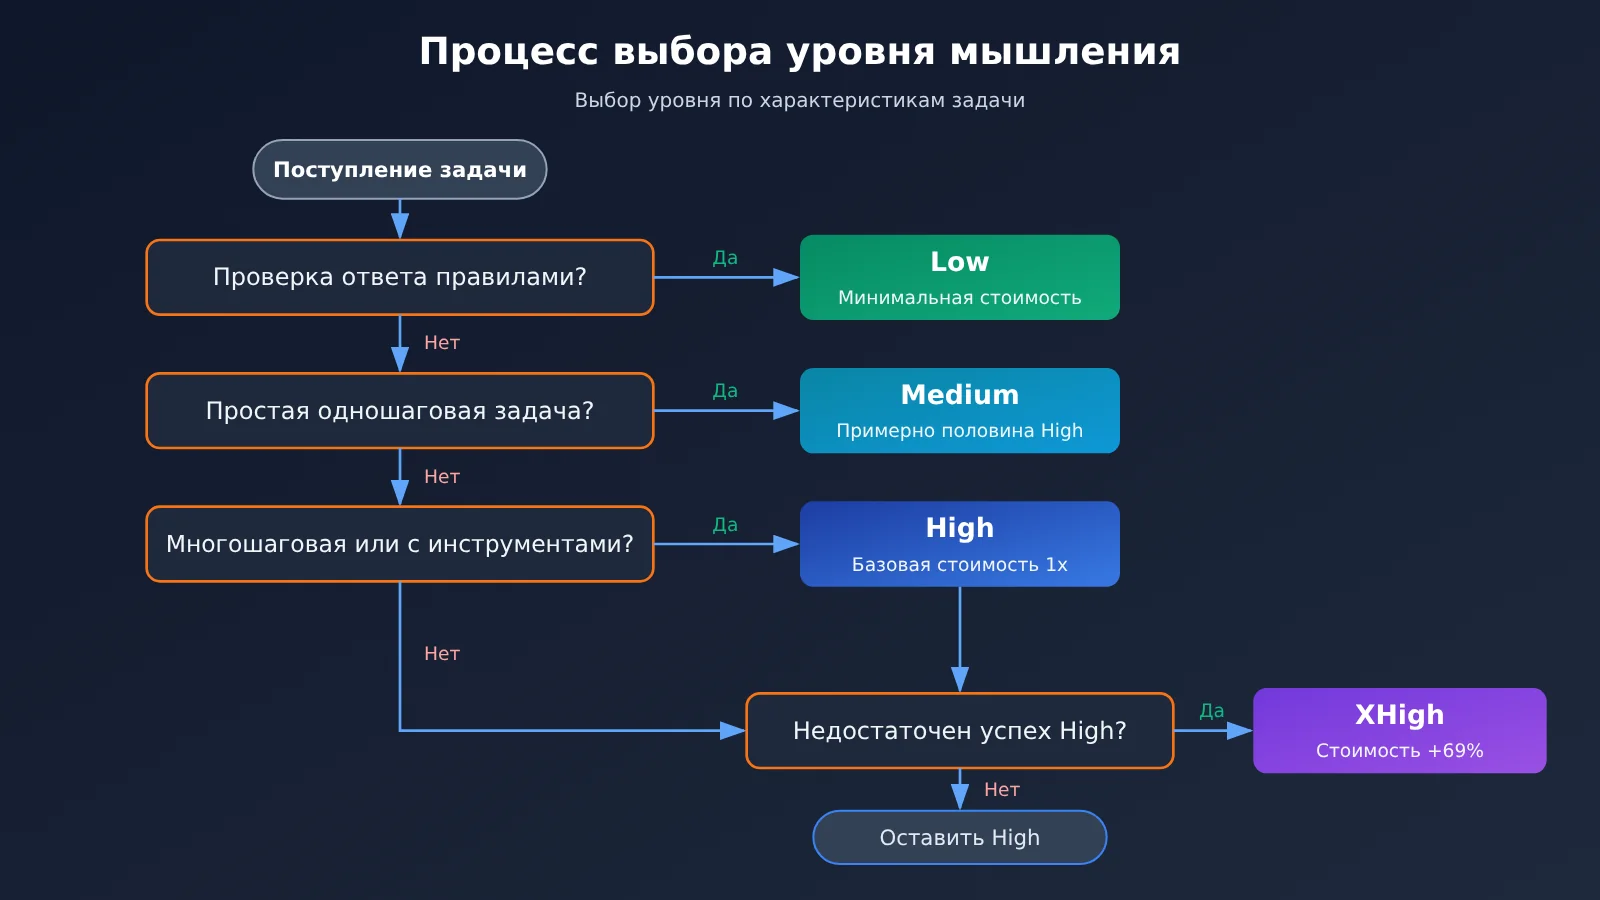
| Многошаговые агенты и вызовы инструментов | High | Исправление багов в нескольких файлах, последовательные вызовы инструментов, анализ после поиска по базе | Уровень по умолчанию от Google, разумный баланс возможностей и стоимости |
| Сложные рассуждения | XHigh | Научные рассуждения, математические доказательства, рефакторинг крупных программных проектов | Использовать только тогда, когда успешность High явно недостаточна |
Когда подходят низкие уровни Hydrogen
Low и Medium подходят для задач с чётко поставленной целью и легко проверяемым ответом. Например, вытащить сумму и дату из договора или разложить отзывы пользователей по десяти категориям: в таких задачах даже долгие размышления вряд ли повысят точность — они лишь добавят задержку и расходы. А в сценариях, чувствительных к задержке до первого токена (живой чат, автодополнение поиска), примерно 5.7 секунды у Low заметно лучше, чем примерно 37.8 секунды у XHigh.
Когда подходят высокие уровни Hydrogen
High — это уровень по умолчанию, заданный Google, он подходит для большинства агентных рабочих процессов. Переходить на XHigh стоит только тогда, когда задача «снова и снова проваливается на High, и стоимость повторных попыток уже превышает стоимость повышения уровня». Учтите: в официальной карточке модели Google тоже отмечает, что высокие уровни размышления могут заметно увеличивать время работы и стоимость, иногда случаются задержки и таймауты, поэтому для длинных цепочек задач нужно заранее настроить таймауты и политику повторных попыток.
Как разработчику контролировать затраты на рассуждения Gemini 4 Hydrogen
Параметр thinking_level и значения по умолчанию
Hydrogen выбирает уровень рассуждений с помощью параметра thinking_level; если его не передать, по умолчанию используется High. При миграции с Gemini 3.8 Flash стоит учесть несколько моментов:
- В 3.8 Flash по умолчанию был Medium. После миграции, если не передавать параметр, автоматически включится High, и счёт может вырасти.
thinking_budgetиMINIMALбольше не поддерживаются — при их использовании вернётся HTTP 400.- Пользовательские значения
temperature,top_pиtop_kбудут игнорироваться. - При многораундовых вызовах инструментов необходимо корректно сохранять и передавать обратно thought signatures.
Минимальный пример: вызов Hydrogen по уровням
Ниже — вызов в формате, совместимом с OpenAI, с передачей уровня размышлений через extra_body. На разных платформах поля для передачи этого параметра могут отличаться — конкретное имя поля уточняйте в документации платформы.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # единый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "把这条反馈分类:退款太慢"}],
    extra_body={"thinking_level": "low"}  # для простой классификации используем Low
)
print(resp.choices[0].message.content)
Посмотреть полный код: градация по сложности задачи с автоматическим повышением уровня
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# сопоставление типов задач с уровнями по умолчанию
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """Начинаем с низкого уровня, при неудачной проверке повышаем его шаг за шагом; max_level ограничивает максимальный уровень"""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # логируем токены — для расчёта стоимости успешных задач
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="提取订单号,只返回数字:订单 A-20261113-889 已发货",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 Быстрый старт: APIYI apiyi.com предоставляет OpenAI-совместимый интерфейс — одного API-ключа достаточно, чтобы вызывать Gemini, Claude, OpenAI и другие популярные модели. Новым пользователям доступен бесплатный тестовый лимит — удобно сначала обкатать описанную выше стратегию уровней, а потом выходить в прод.
Стратегия уровней: сначала низкий, при неудаче — повышаем
Рекомендуемый подход — «по умолчанию низкий, повышаем по необходимости»: для простых задач фиксируем Low или Medium; сложные начинаем с High и поднимаем до XHigh только при провале проверки; и для каждого типа задач задаём максимальный потолок уровня, чтобы избежать неожиданного роста затрат. Это та же логика разделения труда между моделями, что Google использует в Antigravity Orchestrator, только здесь мы регулируем глубину рассуждений одной и той же модели.
Четыре метрики для оценки оптимизации уровней Hydrogen
| Метрика оптимизации | Как считается | Зачем смотреть |
|---|---|---|
| Точность / доля успеха | Число задач, прошедших проверку ÷ общее число задач | После понижения уровня качество не должно заметно падать |
| Сквозное время | Общее время от запроса до получения пригодного результата, включая повторы | Задержка первого токена — лишь часть этого времени |
| Расход токенов | Входные + выходные (вместе с рассуждениями) токены | Токены рассуждений тарифицируются по цене выхода |
| Стоимость успешной задачи | Общие затраты ÷ число успешных задач | Низкий уровень с частыми провалами и повторами может выйти дороже высокого |
«Стоимость успешной задачи» лучше всего отражает реальные расходы. Если в Medium 30% задач приходится перезапускать, а High справляется с первого раза, то стоимость успешной задачи у High может оказаться даже ниже.
Часто задаваемые вопросы (FAQ)
Q1: Четыре уровня мышления Gemini 4 Hydrogen — это четыре разные модели?
Нет. Четыре уровня — это разные глубины рассуждения одной и той же модели `gemini-4-hydrogen`, которые переключаются параметром thinking_level. Цена за токен одинаковая, разница лишь в количестве генерируемых токенов рассуждения.
Q2: XHigh всего на 3 балла выше High — значит, его вообще незачем использовать?
Так понимать нельзя. 3 балла — это средняя разница по множеству задач. В научных рассуждениях, математических доказательствах и крупных инженерных задачах XHigh может определять, будет ли задача вообще выполнена. Для обычных задач соотношение цены и качества у XHigh низкое, но для небольшого числа очень сложных задач он может оказаться необходимым.
Q3: Среднее время High — 8.3 минуты. Получается, каждый вопрос надо ждать столько?
Нет. 8.3 минуты — это взвешенное время выполнения стандартизированных оценочных задач Artificial Analysis. Для обычных диалогов лучше ориентироваться на задержку первого токена ответа: у High это около 18.9 секунды, у Low — около 5.7 секунды. Фактическая длительность ещё зависит от длины задачи.
Q4: Что произойдёт, если не передать thinking_level?
По умолчанию используется High. В проектах, мигрирующих с Gemini 3.8 Flash (по умолчанию Medium), если оставить старый код без передачи параметра, уровень рассуждения автоматически повысится, а вместе с ним может вырасти и стоимость. Рекомендую задавать уровень явно.
Q5: Как быстро сравнить, как разные уровни работают в моём бизнесе?
Советую подготовить набор реальных примеров задач, прогнать их на разных уровнях и собрать статистику успешности и расхода токенов:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ и бесплатную тестовую квоту
2. Используйте код из этой статьи, меняя значение `thinking_level`
3. Выберите самый подходящий уровень по «стоимости успешной задачи»
Q6: Какие известные проблемы есть у высоких уровней рассуждения Hydrogen?
В карточке модели Google упоминается, что высокие уровни рассуждения могут заметно увеличивать время выполнения и стоимость, иногда появляются задержки или тайм-ауты. Кроме того, на Hacker News пользователи сообщали о случаях чрезмерного выполнения в некоторых агентных задачах. Рекомендую для длинных задач задавать тайм-аут, максимальный уровень и условия остановки.
Q7: Какая самая частая ошибка при оценке стоимости по токенам?
Оценивать только по количеству символов в итоговом ответе. Токены рассуждения входят в цену вывода: у XHigh на полном наборе оценочных задач выходных токенов примерно в 2.76 раза больше, чем у High. Просмотр фактической детализации расхода в консоли APIYI apiyi.com надёжнее ручных подсчётов.
Gemini 4 Hydrogen: четыре уровня рассуждения — ключевые выводы
- Одна модель, разные уровни: цена за единицу одинакова для всех четырёх уровней, а фактическая стоимость задачи зависит от расхода токенов рассуждения.
- Убывающая отдача очевидна: High → XHigh добавляет 3 балла, а стоимость оценочной задачи увеличивается примерно на 69%.
- Задержка удваивается: у XHigh задержка до первого ответа около 37.8 секунды — вдвое больше, чем у High.
- По умолчанию — High: при переходе с 3.8 Flash нужно явно указывать уровень.
- Выбирайте уровень по сложности: для классификации — Low, для обычных задач — Medium, для агентов — High, а XHigh — только для действительно сложных задач.
- Смотрите на стоимость успешных задач: учитывайте и повторные попытки — только так можно сравнить реальные расходы разных уровней.
- Проверяйте на примерах: через APIYI apiyi.com можно одним ключом сравнить эффект всех четырёх уровней.
Итог
Основные выводы из сравнения четырёх уровней рассуждения Gemini 4 Hydrogen:
- Разрыв в возможностях велик: от 27 баллов у Low до 54 баллов у XHigh — в рамках одного и того же названия модели возможности отличаются вдвое.
- Маржинальная стоимость растёт: дополнительные расходы за каждый следующий балл увеличиваются с примерно $0.036 при переходе Low → Medium до примерно $0.43 при переходе High → XHigh.
- XHigh стоит использовать по необходимости: средний балл отличается незначительно, но для немногих особо сложных задач он всё ещё может быть решающим.
Рекомендация для повседневной работы: явно задавайте thinking_level, для простых задач используйте низкий уровень, для сложных этапов повышайте его, а окончательным критерием считайте стоимость успешных задач.
Рекомендуем быстро проверить эффект каждого уровня на реальных примерах задач через APIYI apiyi.com: платформа предоставляет OpenAI-совместимый интерфейс и бесплатные тестовые квоты.
📚 Справочные материалы
- Artificial Analysis — страница оценки Gemini 4 Hydrogen по четырём уровням: индекс интеллекта, стоимость задачи, время выполнения и задержка
- Ссылка:
artificialanalysis.ai/models/gemini-4-hydrogen-low - Ссылка:
artificialanalysis.ai/models/gemini-4-hydrogen-medium - Ссылка:
artificialanalysis.ai/models/gemini-4-hydrogen-high - Ссылка:
artificialanalysis.ai/models/gemini-4-hydrogen -
Пояснение: источник всех сравнительных данных по четырём уровням в этой статье; задержка — динамический показатель
-
Официальный блог Google — Introducing Gemini 4 Hydrogen: анонс релиза
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Пояснение: позиционирование модели, спектр возможностей и кейсы партнёров
-
Руководство для разработчиков Google Cloud — Gemini 4 Hydrogen:
thinking_levelи моменты, важные при миграции - Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Пояснение: рекомендуемое применение каждого из четырёх уровней, уровень по умолчанию, несовместимые параметры
-
Страница цен Google AI Studio: официальные цены API для Hydrogen
- Ссылка:
aistudio.google.com/docs/pricing -
Пояснение: цены для режимов Standard, Batch, Flex и Priority, правила тарификации thinking-токенов
-
Карточка модели Google DeepMind: ограничения и оценка безопасности
- Ссылка:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Пояснение: риски по времени выполнения при высоком уровне размышлений, известные проблемы вроде отказов от ответа и галлюцинаций
Автор: техническая команда APIYI
Обсудить технические вопросы: заходите на главную страницу сайта APIYI и свяжитесь с нами — там вы найдёте больше материалов по подключению моделей серии Gemini.