Résumé : l’API Google Decisions attribue directement un score à des options fixes, sans générer de texte. Cet article utilise les tarifs publics pour estimer son coût dans des tâches de classification, de modération et de routage, et s’appuie sur des données officielles et tierces pour délimiter son domaine d’application.
Conclusion en bref : le 11 novembre 2026, Google a publié Gemini Decisions API (identifiant de modèle gemini-decision-1). Cette API permet de réaliser, en une seule requête, de 1 à 1 000 décisions indépendantes sur une même entrée. Le tarif d’entrée est de 0,10 $ par million de tokens, sans frais de tokens de sortie génératifs. D’après les tarifs publics, vérifier 1 000 règles dans un même document de 10K tokens revient à environ 1/20 du coût de Gemini 3.5 Flash-Lite, soit une économie théorique de 94,9 %. Classer une fois chacune de 1 000 messages permet une économie théorique de 73,1 %. Les tests officiels de Google indiquent un avantage de coût d’environ 4,7 fois. Dans des tests tiers portant sur une seule question, cet avantage est d’environ 1,5 fois. Les tâches qui se limitent à la classification, à la modération ou au routage, et dont les réponses peuvent être définies à l’avance dans un ensemble d’options fixes, sont les plus adaptées à une réduction des coûts avec cette API.
La suite de l’article explique d’abord le fonctionnement de cette interface et les trois types de décisions, puis utilise des formules reproductibles pour estimer le coût de trois cas d’usage métier typiques, et éclaire l’écart entre le « environ 5 fois » officiel et les mesures indépendantes. Elle compare ensuite les données de vitesse publiées par Google et l’évaluation indépendante d’Artificial Analysis, afin de déterminer si la précision répond aux exigences de production. Enfin, elle propose un exemple d’appel minimal, un tableau de sélection et une liste de vérification des coûts avant mise en production.
À savoir : notions préalables
| Terme | Explication |
|---|---|
| Decisions API | Interface de décision lancée par Google : elle renvoie directement un résultat et une probabilité pour des options fixes. |
| Gemini Decision 1 | Modèle dédié qui alimente cette interface ; son ID de modèle est gemini-decision-1. |
| Token | Unité de base utilisée par le modèle pour traiter et facturer ; le texte, les images, etc., sont convertis en tokens. |
| Shared Input | Partie de l’entrée d’une requête qui est commune à toutes les décisions demandées. |
| Closed-set Decision | Décision dont l’ensemble des réponses possibles est défini à l’avance, par exemple « oui/non » ou « choisir parmi A/B/C ». |
| noul | Décision binaire qui renvoie la probabilité de « Yes ». |
| choice | Sélection d’une option parmi 2 à 255 options prédéfinies. |
| score | Notation selon des niveaux ordonnés définis à l’avance ; le résultat est une espérance pondérée. |
| Confidence | Estimation par le modèle de la probabilité que le résultat choisi soit correct. |
| Single Forward Pass | Le modèle calcule les scores de chaque option en une seule passe, sans générer le texte token par token. |
| Context Window | Quantité totale de contenu qu’une requête peut contenir ; pour ce modèle, elle est de 262 144 tokens. |
| TPM / RPM | Nombre de tokens traités par minute / nombre de requêtes par minute ; il s’agit de la limite de débit. |
1 Ce que Google a publié : la Gemini Decisions API, conçue pour répondre à des questions fermées
1.1 Différences entre Gemini Decision 1 et les modèles génératifs classiques
La Gemini Decisions API a été ouverte le 11 novembre 2026 via Gemini Developer API v1beta, avec pour point de terminaison REST POST https://generativelanguage.googleapis.com/v1beta/decisions. Sa fonction principale consiste à évaluer des probabilités sur des options définies à l’avance, puis à renvoyer la décision, la probabilité de chaque option, le niveau de confiance et la consommation de tokens. Les entrées acceptent le texte, les images, l’audio, la vidéo et le PDF.
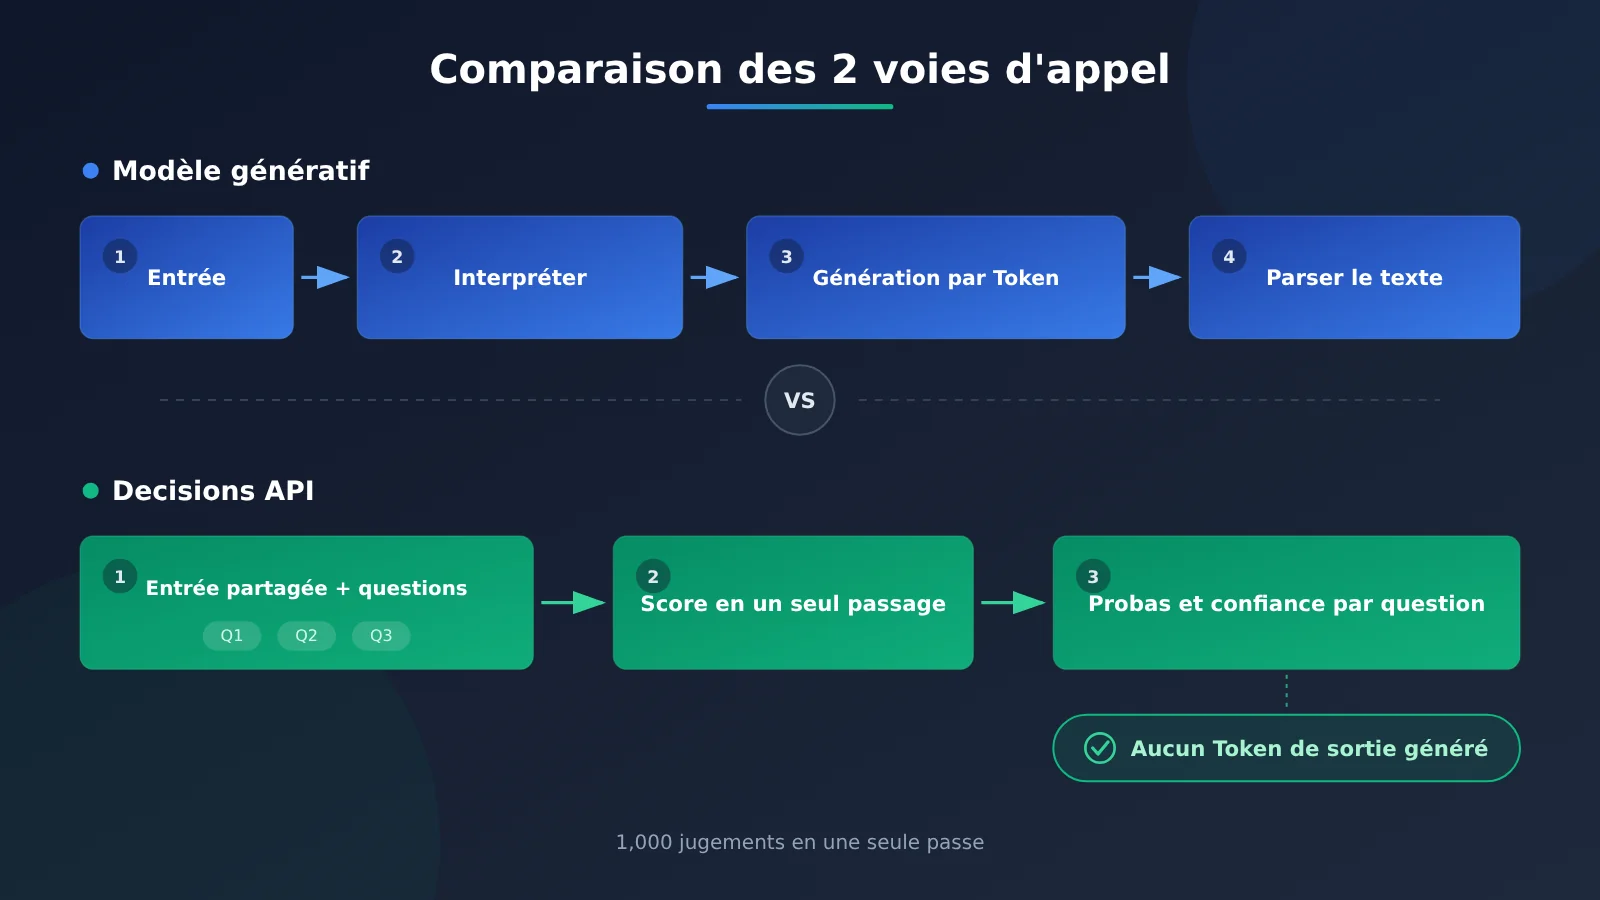
Avec un modèle génératif classique, le traitement d’une tâche de classification se déroule ainsi : on lit le contenu, on interprète la consigne, puis le modèle génère une réponse token par token — et le développeur doit ensuite analyser cette réponse. La Decisions API change le processus : elle lit d’abord le contenu partagé, puis note directement chaque option prédéfinie de chaque question. Pour des tâches comme la classification, la modération ou le routage, il suffit d’une étiquette ou d’un simple « oui/non » ; générer une longue réponse consomme des tokens de sortie et ralentit la réponse. Supprimer cette étape, c’est précisément ce qui permet de réduire les coûts et la latence.
1.2 Les trois modes de décision de la Decisions API et les tâches qu’ils couvrent
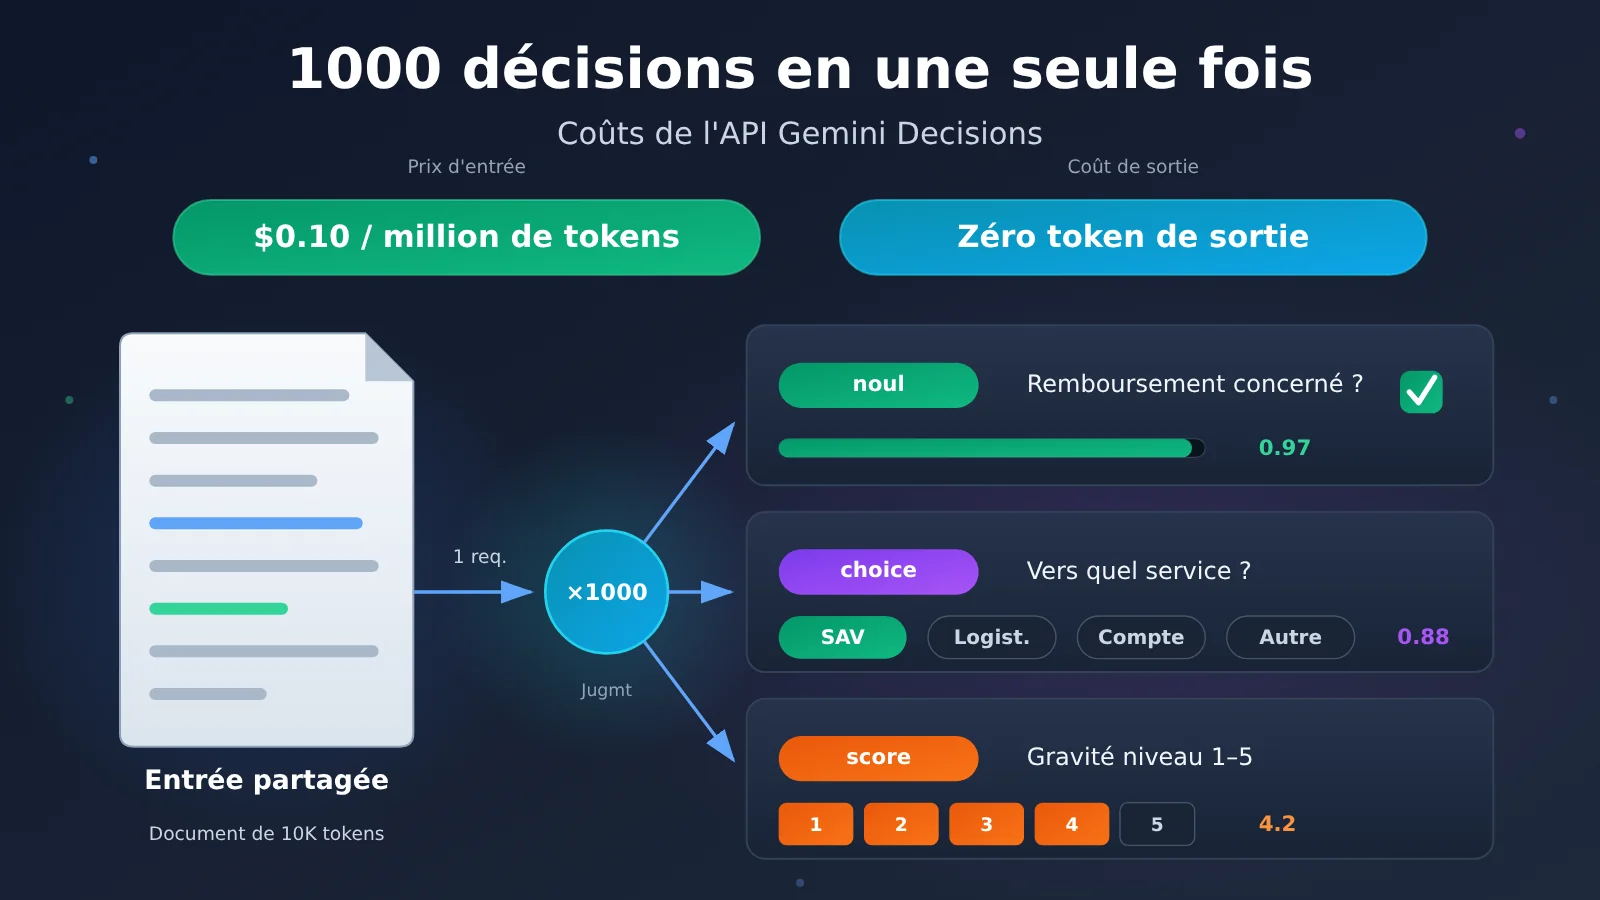
Prenons l’exemple d’un message au service client : « J’ai acheté un casque la semaine dernière et l’écouteur gauche ne produit aucun son. Ça fait trois jours que j’ai demandé un remboursement et personne ne me répond. Si rien n’est fait, je dépose une réclamation sur la plateforme. » Sur ce seul message, on peut poser dans la même requête trois questions indépendantes les unes des autres.
| Type de décision | Exemple de question | Contenu renvoyé | Tâches typiques |
|---|---|---|---|
| noul | Ce message concerne-t-il un remboursement ? | La probabilité de « Oui », par exemple 0.97 | Présence ou non d’une violation, mention d’un prix, nécessité d’une escalade vers un superviseur |
| choice | À quel service faut-il transmettre : service après-vente / logistique / compte / autre ? | Sélectionne « service après-vente » et fournit la probabilité de chaque option | Répartition des tickets, classification d’articles, choix d’outil par un agent |
| score | Quel niveau de gravité pour la réclamation, sur une échelle de 1 à 5 ? | Une valeur attendue pondérée calculée à partir des probabilités de chaque niveau, par exemple 4.2 | Pertinence, gravité, notation de la priorité des prospects |
choice accepte de 2 à 255 options, et score de 2 à 255 niveaux. score renvoie une valeur attendue calculée à partir des probabilités de chaque niveau : on peut donc l’utiliser directement pour trier ou fixer un seuil, sans avoir à extraire un score d’un texte d’évaluation.
2 Combien l’API Decisions de Google peut-elle réellement faire économiser : chiffrage sur trois scénarios métier
2.1 Pourquoi une entrée partagée réduit la consommation de tokens
La structure tarifaire de l’API Decisions présente trois caractéristiques : une entrée partagée n’est facturée qu’une seule fois par requête, les instructions propres à chaque question restent facturées en tokens d’entrée, et le résultat de la décision ne génère pas de frais de sortie générative. À titre de comparaison, le prix standard officiel de Gemini 3.5 Flash-Lite est de 0,30 $ par million de tokens en entrée et de 2,50 $ par million de tokens en sortie (tarification officielle du 13 novembre 2026).
Posons S comme le nombre de tokens d’une entrée partagée, Q le nombre de questions indépendantes portant sur cette entrée, Tq le nombre moyen de tokens par question, To le nombre moyen de tokens de sortie par question pour le modèle génératif, et N le nombre de blocs d’entrée. Sous l’hypothèse simplificatrice selon laquelle « les deux interfaces facturent le même nombre de tokens d’entrée » :
Coût API Decisions   C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Coût Flash-Lite      C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
Taux d'économie      = (1 − C_D / C_F) × 100%
Il s’agit d’un modèle de calcul destiné à comprendre le mécanisme ; Google ne fournit pas de taux d’économie fixe. Les deux interfaces ont leurs propres coûts d’encodage des instructions et de format, et les frais réels dépendent des tokens facturés renvoyés par chacune.
2.2 De 1 décision à 1 000 décisions : comment les coûts évoluent
Le tableau ci-dessous est un exemple théorique dérivé des prix publics, sans test de charge réel. Dans le scénario ①, les 1 000 décisions portent toutes sur un même document : il s’agit de 1 000 questions indépendantes posées sur une seule entrée, ce qui constitue une charge complètement différente de « 1 000 documents analysés une fois chacun ».
| Scénario métier | Hypothèses principales | Decisions API | Flash-Lite | Économie théorique |
|---|---|---|---|---|
| ① Vérifier 1 000 règles sur un document | Document de 10K tokens, 20 tokens par règle, Flash-Lite produit 20 tokens par règle, les deux étant fusionnés en une seule requête | $0,003 | $0,059 | 94,9 % |
| ② Classifier 1 000 messages une fois chacun | 300 tokens par message, 50 tokens d’instruction de décision, Flash-Lite produit 10 tokens | $0,035 | $0,130 | 73,1 % |
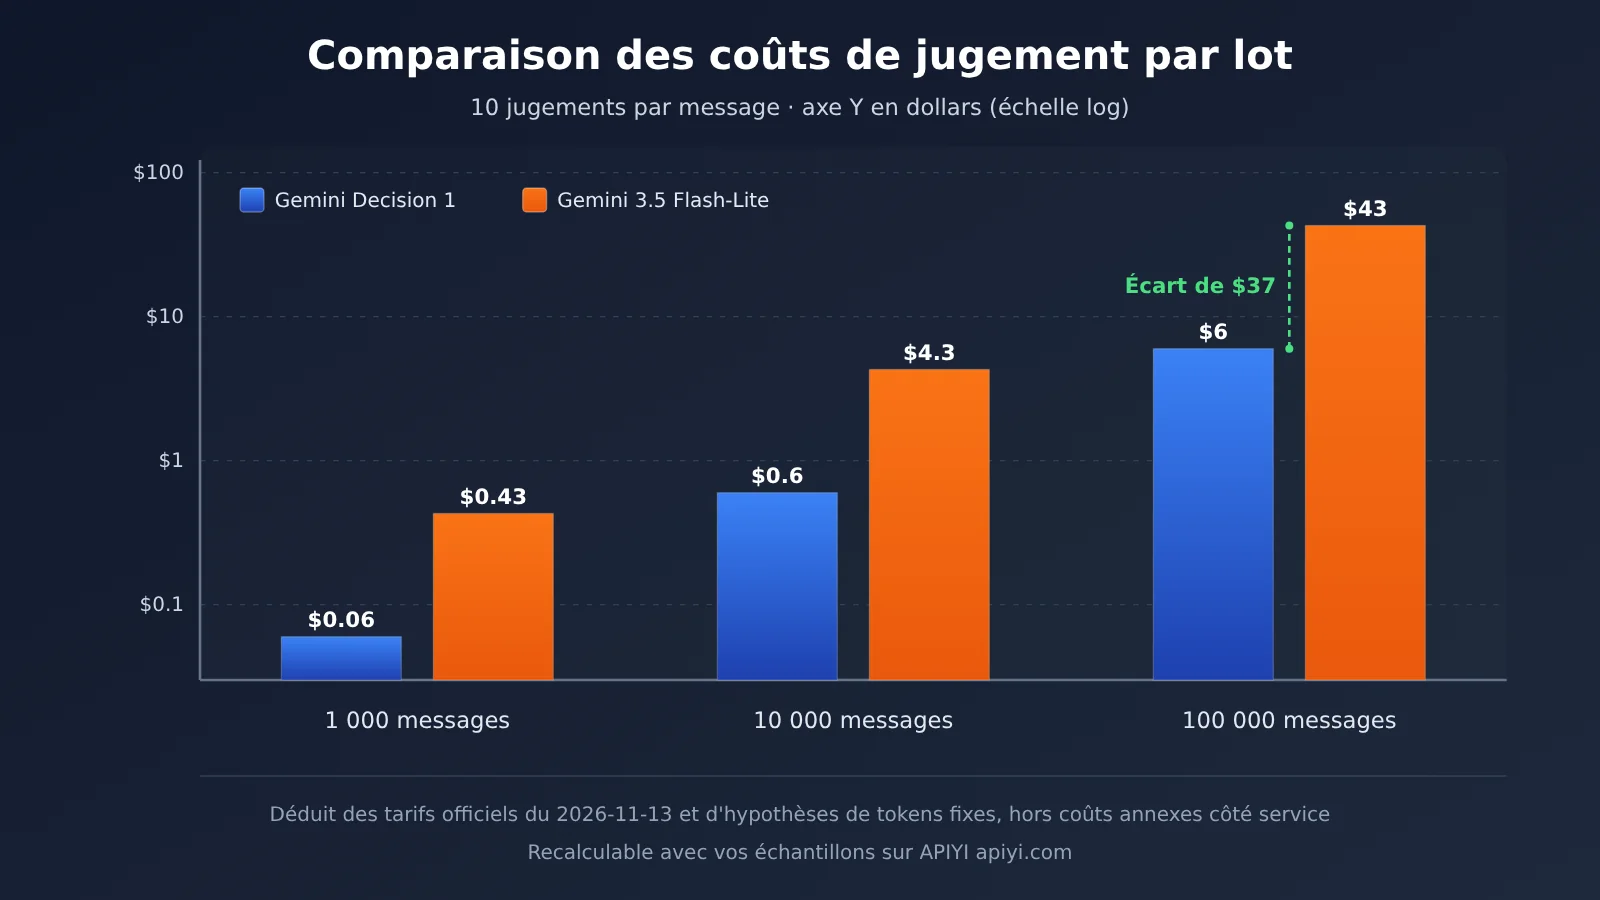
| ③ Effectuer 10 décisions sur chacun des 1 000 messages | 300 tokens par message, 30 tokens par décision, Flash-Lite produit 10 tokens par décision, une requête par message | $0,060 | $0,430 | 86,0 % |
Ces trois scénarios montrent deux choses. Dans le scénario ②, chaque requête ne contient qu’une seule question, et l’on obtient quand même 73,1 % d’économie théorique : cela vient du fait que le prix unitaire des entrées tombe à un tiers et que les coûts de sortie sont ramenés à zéro. Les économies des scénarios ① et ③ sont plus élevées parce que l’entrée partagée est amortie sur plusieurs questions, tandis que Flash-Lite doit générer une sortie pour chaque question.
Reprenons les paramètres du scénario ③ en changeant d’échelle : pour traiter 100 000 messages, soit 1 million de décisions au total, le coût d’invocation du modèle avec Decisions API est de 6 dollars, contre 43 dollars avec Flash-Lite, soit un écart de 37 dollars. Ce chiffre ne couvre que les frais d’invocation du modèle ; il n’inclut ni les nouvelles tentatives, ni la relecture humaine après un faux positif, ni le passage à un modèle plus puissant, ni le transport et le stockage, ni les coûts de refonte technique.
Si vous voulez refaire le calcul avec vos propres échantillons métier, commencez par faire passer le même lot de données dans un modèle génératif, relevez les tokens réels en entrée et en sortie, puis réinjectez-les dans la formule ci-dessus. Avec APIYI apiyi.com, une seule clé API suffit pour appeler Gemini, GPT, Claude et bien d’autres modèles génératifs, de quoi établir rapidement cette base de coûts.
2.3 Pourquoi le « environ 5 fois » de Google n’est pas une réponse universelle
Lors de son lancement, Google a indiqué que, dans ses tests officiels, le coût de Decision 1 représentait environ 1/4,7 de celui de Gemini 3.5 Flash-Lite. Le testeur indépendant RanThis a publié le 12 novembre 2026 une autre série de chiffres, obtenus à partir de vrais appels API : 100 messages en anglais, 20 messages en vietnamien, chaque requête ne demandant qu’un seul jugement binaire.
- Précision : sur 100 jugements en anglais, Decision 1 a vu juste 99 fois, Flash-Lite 98 fois.
- Coût : le coût extrapolé pour mille jugements en anglais s’élevait respectivement à 0,0113 $ et 0,0166 $, soit environ 32 % de moins pour Decision 1, un écart d’environ 1,5 fois.
- Latence : la latence médiane par requête était de 0,18 seconde contre 0,58 seconde.
- Consommation de tokens : Decision 1 facturait en moyenne environ 113 tokens d’entrée par requête, Flash-Lite environ 47 tokens d’entrée plus 1 token de sortie.
La raison de cet écart est claire : les instructions et le format propres à l’interface Decisions font plus que doubler les tokens d’entrée facturés, ce qui annule une partie de l’avantage sur le prix unitaire. Quand l’entrée est très courte, qu’on ne pose qu’une seule question à la fois et que le modèle génératif n’a qu’un seul token à produire, l’économie est minimale. Lorsque RanThis a regroupé les 10 questions portant sur le même courriel dans une seule requête Decision 1, puis les a comparées à 10 requêtes Flash-Lite séparées, l’écart s’est creusé jusqu’à environ 5,4 fois ; dans cette comparaison, Flash-Lite n’avait pas procédé au même regroupement, il s’agit donc d’une comparaison entre deux manières différentes de formuler les requêtes.
Les variables qui déterminent l’économie réelle sont donc : la longueur de l’entrée partagée, le nombre de questions par entrée, la longueur de sortie du modèle génératif, le fait que les deux côtés aient ou non regroupé leurs requêtes, et les coûts fixes inhérents à l’interface. La dérivation de la formule, les benchmarks officiels et les mesures tierces proviennent de conditions différentes : il faut les examiner séparément au moment de choisir.
3 1,000 jugements d’un coup : à quoi sert vraiment l’API Decisions ?
3.1 Audit de documents : un seul support pour plusieurs règles
C’est avec les « documents longs + nombreuses règles » que l’avantage de l’entrée partagée s’exprime le mieux. Un contrat, un dossier d’appel d’offres ou une fiche produit doivent être vérifiés point par point face à une liste de conformité : présence d’une clause de pénalité, mention d’un transfert de données à l’étranger, délai de paiement supérieur à 60 jours, date de signature manquante, etc. Plus le document est long et plus les règles sont nombreuses, plus l’entrée partagée est amortie : c’est précisément cette structure qui produit les 94.9 % d’économies théoriques du scénario ①.
Autre atout de ce type de tâche : le résultat peut être versé directement dans un tableau. Chaque règle correspond à un jugement noul, qui renvoie une probabilité et un niveau de confiance ; le programme peut alors marquer « conforme / non conforme / à revérifier » selon un seuil, et les auditeurs ne regardent que les entrées à revérifier.
3.2 Routage d’agents et classification de contenu
À chaque étape, un agent doit décider de l’action suivante : faut-il lancer une recherche web, exécuter du code, passer la main à un autre outil ? Ces décisions ont des options fixes, sont appelées très souvent et sont sensibles à la latence : idéal pour un choix traité en un seul appel. Les usages internes révélés par Google se concentrent d’ailleurs là-dessus : Gemini Notebook s’en sert pour choisir le modèle et le niveau de réflexion selon la nature de la question, avec jusqu’à 40 % de latence en moins sur les requêtes ordinaires ; Google Search l’utilise pour les contrôles de sécurité des outils MCP et la détection de contenu adversarial ; CC sélectionne rapidement une réaction parmi plus de 200 Emoji candidats. Ce sont les chiffres de Google : les résultats réels pour des développeurs externes dépendent de leur propre charge.
Les workflows de production de contenu sont un autre prolongement. Une fois une actualité IA collectée, le système doit déterminer s’il s’agit d’un nouvel événement, si cela concerne les développeurs, si cela touche au prix des API, s’il existe une source officielle, si le sujet se prête à un tutoriel, et attribuer une note de valeur au contenu. Ces six conditions sont indépendantes les unes des autres : on peut les regrouper dans une seule requête Decisions pour filtrer, puis confier les sujets retenus à un modèle génératif pour la recherche, la rédaction et la relecture. C’est un exemple de solution conçu à partir des capacités de l’interface. La seconde partie, la génération, peut passer par APIYI apiyi.com pour changer de modèle à la demande et comparer qualité rédactionnelle et coût.
3.3 Les trois limites des 1,000 questions
- Les questions doivent être indépendantes les unes des autres. Au sein d’une même requête, les jugements ne peuvent pas lire les résultats des autres. Pour un enchaînement du type « déterminer d’abord s’il s’agit d’une plainte, puis la classer par type de plainte », c’est au programme de combiner les résultats, et de relancer une requête si nécessaire.
- 1,000 questions partagent une fenêtre de contexte de 262,144 tokens. L’entrée partagée et l’ensemble des questions occupent cette fenêtre : plus l’instruction de chaque question est longue, moins il reste de place pour le document.
- Les données officielles de faible latence ne couvrent que les petites requêtes. Dans les tests de Google, la plage où la latence reste à peu près stable correspond à 1 à 100 questions par requête et un contexte inférieur à 16K tokens. Avec 1,000 questions et un contexte proche de la saturation, il faut mesurer la latence soi-même.
4 Au-delà du prix bas : la précision et la vitesse de Gemini Decisions API peuvent-elles vraiment tenir la production ?
4.1 La vitesse annoncée par Google et les données d’usage interne
Google publie un temps de calcul médian du modèle de 50 à 100 ms, pour une latence de bout en bout de 150 à 250 ms, avec comme conditions de test 1 à 100 questions par appel et un contexte ne dépassant pas 16K Token. Ces chiffres montrent que le modèle a sa place dans une chaîne temps réel, par exemple pour le routage à chaque étape d’un Agent ou pour la répartition immédiate des messages utilisateur. La latence médiane de 0.18 seconde mesurée par RanThis sur une question unique tombe d’ailleurs pile dans cette plage.
4.2 Ce que nous apprennent les évaluations tierces
Artificial Analysis a publié les premiers résultats de son Decision Index v2.1, calculés selon un mélange entre score brut et tâches réelles. Les coûts du tableau ci-dessous correspondent au coût mixte des tâches de ce benchmark : c’est une mesure différente du « prix par million de Token ».
| Modèle de décision | Score global | Temps par tâche | Coût estimé par million de tâches | Taux de réussite complète sur les 15 items (AA-Paperclip) |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
Deux enseignements méritent l’attention. D’un côté, le prix unitaire par Token de Gemini Decision 1 est bas, mais sur cette distribution de tâches, le coût estimé par million de tâches dépasse celui de Drex Max et de Jev : la façon de formuler les requêtes et la structure des tâches changent donc l’économie finale. De l’autre, dans le test documentaire AA-Paperclip, la proportion de documents où Decision 1 traite les 15 jugements en une seule passe et tombe juste partout atteint 33 %. Regrouper plusieurs jugements dans un même appel fait baisser le coût, mais la précision de chaque jugement doit encore être vérifiée séparément.
4.3 Utiliser le niveau de confiance pour empêcher l’exécution automatique des erreurs
Le niveau de confiance est l’estimation probabiliste que le modèle donne de son propre résultat. Il permet de décider quels résultats exécuter automatiquement et lesquels confier à un humain. Au moment de la mise en production, je recommande de l’accompagner de trois pratiques :
- Définir un seuil de confiance : par exemple, si la confiance d’un jugement de remboursement passe sous 0.85, on renvoie vers un humain ; au-dessus du seuil seulement, on étiquette ou on assigne automatiquement.
- Ajouter une option
otherau paramètrechoice: quand aucune option ne convient, le modèle en choisit quand même une ; ajouter « autre / impossible à déterminer » permet de bloquer une partie des entrées hors périmètre. On peut aussi ajouter unnoulséparé pour un contrôle de portée. - Garder des contraintes de code pour les opérations à haut risque : pour le montant d’un remboursement, le bannissement d’un compte ou un blocage pour conformité, il faut, en plus du jugement du modèle, des règles codées en dur et une relecture humaine.
5 Comment les développeurs doivent-ils utiliser et choisir l’API Gemini Decisions ?
5.1 Comment envoyer sa première requête
La documentation officielle exige le SDK Python google-genai 3.2 ou une version plus récente ; les SDK JavaScript et REST sont également pris en charge. L’intégration nécessite une clé API de Google AI Studio. L’exemple ci-dessous est reconstitué à partir de la structure du SDK officiel : il effectue à la fois un jugement binaire et un jugement de catégorisation sur la même actualité. Il n’a pas été réellement exécuté ni validé dans le cadre de cet article ; pour les noms de champs, référez-vous au guide officiel destiné aux développeurs.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input : entrée partagée par toutes les questions, facturée une seule fois
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions : jugements indépendants ; la clé sert d’ID de question
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # résultat de chaque question, probabilité de chaque option et niveau de confiance
print(result.usage)    # nombre de tokens facturés ; c’est la référence pour le calcul des coûts
Les quatre champs clés ont le rôle suivant : input contient le contenu partagé, questions contient les questions indépendantes (pour la syntaxe de définition des niveaux du type score, voir le guide officiel), answers permet de lire les résultats de jugement et les probabilités, et usage permet de lire les tokens facturés. Pour estimer les coûts, utilisez impérativement la valeur réelle de usage ; la section 2.3 a déjà montré que les coûts fixes de l’interface influencent fortement le coût par question.
Pour comparer les coûts, il faut aussi une référence avec un modèle génératif. Ci-dessous, nous utilisons l’interface compatible OpenAI d’APIYI pour appeler Flash-Lite et effectuer la même classification, en enregistrant la consommation de tokens :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d’APIYI
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # utiliser le nom exact figurant dans la liste des modèles de la plateforme
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # tokens d’entrée et de sortie, à reporter dans la formule de la section 2.1
Voir le script de comparaison par lots : coût des deux interfaces calculé séparément sur le même échantillon
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # prix standard officiel Flash-Lite, USD/million de tokens
DECISION_IN = 0.10                 # prix d'entrée Decision 1, la sortie n'est pas facturée

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """Fusionne toutes les questions de chaque échantillon en une seule requête générative et cumule le coût réel facturé"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Prend les tokens d'entrée `usage` renvoyés à chaque appel par l'API Decisions et calcule le coût total"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 Conseil pour démarrer rapidement : commencez par sélectionner 200 à 500 échantillons métier réels, faites tourner le modèle génératif pour obtenir une précision de référence et une consommation de tokens, puis comparez avec le champ
usagede l’API Decisions. APIYI apiyi.com propose une interface compatible OpenAI et un quota de test gratuit pour les nouveaux utilisateurs, ce qui est parfait pour réaliser rapidement cette étape de test de référence.
5.2 Quand choisir Decisions API, et quand continuer avec un modèle génératif
| Type de tâche | Approche recommandée | Raison |
|---|---|---|
| Vérifier un même document long contre plusieurs règles | Decisions API | L’entrée partagée amortit le coût, les jugements sont indépendants les uns des autres |
| Routage des outils d’agent, choix de modèle | Decisions API | Les options sont fixes, latence faible |
| Contrôle de sécurité du contenu et détection d’infractions | Decisions API | Plusieurs conditions nulles indépendantes, répartition possible via le niveau de confiance |
| Classification des tickets de support, étiquetage après-vente e-commerce | Decisions API | Ensemble d’étiquettes fixe |
| Filtrage des sujets, notation de la priorité des pistes | Decisions API | Adapté à un score sur une échelle prédéfinie |
| Résumé, reformulation, rédaction | Modèle génératif | Nécessite une sortie en langage naturel |
| Recherche complexe, argumentation, proposition d’idées nouvelles | Modèle génératif | Nécessite un raisonnement ouvert |
| Processus où les jugements dépendent les uns des autres dans l’ordre | Orchestration programmatique + requêtes multiples, ou modèle génératif | Les questions d’une même requête ne peuvent pas se référencer entre elles |
La sortie structurée des modèles génératifs (JSON Schema) permet aussi de contraindre la réponse à un format fixe, mais le modèle continue de générer le contenu token par token et facture la sortie, et il faut un traitement supplémentaire pour obtenir les probabilités. Decisions API renvoie directement la probabilité et le niveau de confiance de chaque option, la sortie n’est pas facturée, le prix à payer étant qu’elle ne peut répondre qu’à des questions dont les options sont fixées à l’avance.
5.3 Quels autres coûts faut-il calculer avant la mise en production
Au-delà du prix unitaire, plusieurs éléments influencent directement le « coût total par décision correcte » :
- Coût réel en tokens : fiez-vous à
usage; dans les scénarios à entrée courte et à question unique, les coûts fixes représentent la part la plus importante. - Limites de requêtes : le niveau gratuit est de 200 RPM, 50 000 TPM et 10 000 RPD ; le niveau payant Tier 1 est de 1 500 RPM, 1 million de TPM et 50 000 RPD. Les requêtes à contexte long atteignent souvent d’abord la limite TPM.
- Absence de cache et de traitement par lots : pas de prise en charge du Context Caching, de la Batch API ni de l’inférence Flex/Priority ; réutiliser le même document long ne permet donc pas de bénéficier d’une remise de cache.
- Contraintes fonctionnelles : impossible de placer du contenu média dans les instructions de la question, ni de transmettre directement l’historique complet de la conversation, les blocs de réflexion ou d’appel d’outils ; les conversations multi-tours doivent d’abord être reformatées en entrée texte.
- Erreurs de jugement et relecture humaine : la proportion de cas à faible confiance transférés à un humain et les coûts de reprise après une erreur doivent être intégrés au coût unitaire.
- Conditions de traitement des données : les données d’utilisation du niveau gratuit peuvent servir à améliorer les produits Google ; la grille tarifaire officielle indique que le niveau payant n’est pas utilisé à cette fin. Avant de traiter des documents clients, vérifiez le niveau utilisé.
- Travail d’ingénierie : réécrire les invites génératives en questions noul / choice / score, définir des seuils et une logique de repli, tout cela demande des efforts de développement.
Si vous comptez passer par une plateforme API tierce, vérifiez qu’elle prend en charge le point de terminaison dédié /v1beta/decisions : une plateforme qui ne propose que les Chat Completions ne peut pas appeler directement la Decisions API. Avant d’utiliser APIYI apiyi.com, consultez la liste des modèles et des points de terminaison dans le centre de documentation, ou contactez la plateforme pour confirmer la prise en charge.
6 Conclusion : les tâches de classification, d’audit et de routage peuvent être confiées à Gemini Decisions API
Pour revenir à la question du titre, voici trois conclusions :
- Les tâches à options fixes méritent d’être traitées en priorité avec Decisions API. D’après les prix publics, une classification à une seule question permet théoriquement d’économiser environ 73 %, et l’audit de mille règles sur un même long document environ 95 % ; un test indépendant sur une question unique montre un avantage d’environ 32 %.
- « Une entrée, plusieurs questions indépendantes » est la structure au plus fort potentiel d’économie. L’entrée partagée n’est facturée qu’une seule fois : plus il y a de questions, plus l’entrée est longue et plus la sortie du modèle génératif est longue, plus l’écart se creuse.
- Le vrai critère reste le coût total par décision correcte en production. Le prix unitaire du token et le plafond de 1 000 questions ne sont qu’un point de départ : la précision, la part de traitement humain après arbitrage par niveau de confiance, les quotas et le coût d’ingénierie déterminent ensemble le gain réel.
La démarche la plus sûre : commencer par établir une ligne de base avec un modèle génératif sur des échantillons réels, puis comparer usage et la précision sur Decisions API, en concevant séparément la couche de décision et la couche de génération. Pour le choix du modèle et la comparaison des coûts de la couche de génération, on peut passer par APIYI apiyi.com avec une interface unifiée.
📚 Références
- Guide développeur et grille tarifaire de Google Gemini Decisions API : capacités de l’interface, limitations, quotas et prix officiels
- Lien :
ai.google.dev -
Description : ID de modèle, types de questions, fenêtre de contexte, limites de débit et utilisation du SDK
-
Article publié sur le blog officiel de Google : date de publication, données de latence et cas d’usage internes
- Lien :
blog.google -
Description : temps de calcul de 50–100 ms, avantage de coût d’environ 4,7 fois, cas comme Gemini Notebook
-
Point de terminaison REST de Gemini Decisions API
- Lien :
generativelanguage.googleapis.com/v1beta/decisions -
Description : point de terminaison officiel pour les appels via REST
-
Artificial Analysis Decision Index v2.1 : évaluation tierce des modèles de décision
- Lien :
artificialanalysis.ai -
Description : score composite, durée des tâches, coût par million de tâches et taux de réponses entièrement correctes (AA-Paperclip)
-
Test indépendant RanThis (2026-11-12) : petit test basé sur de vrais appels
- Description : comparaison du coût par question, de la latence et de la consommation de tokens, ainsi que des résultats des requêtes regroupant plusieurs questions
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil de APIYI apiyi.com ; davantage de ressources d’intégration sont disponibles sur le centre de documentation docs.apiyi.com