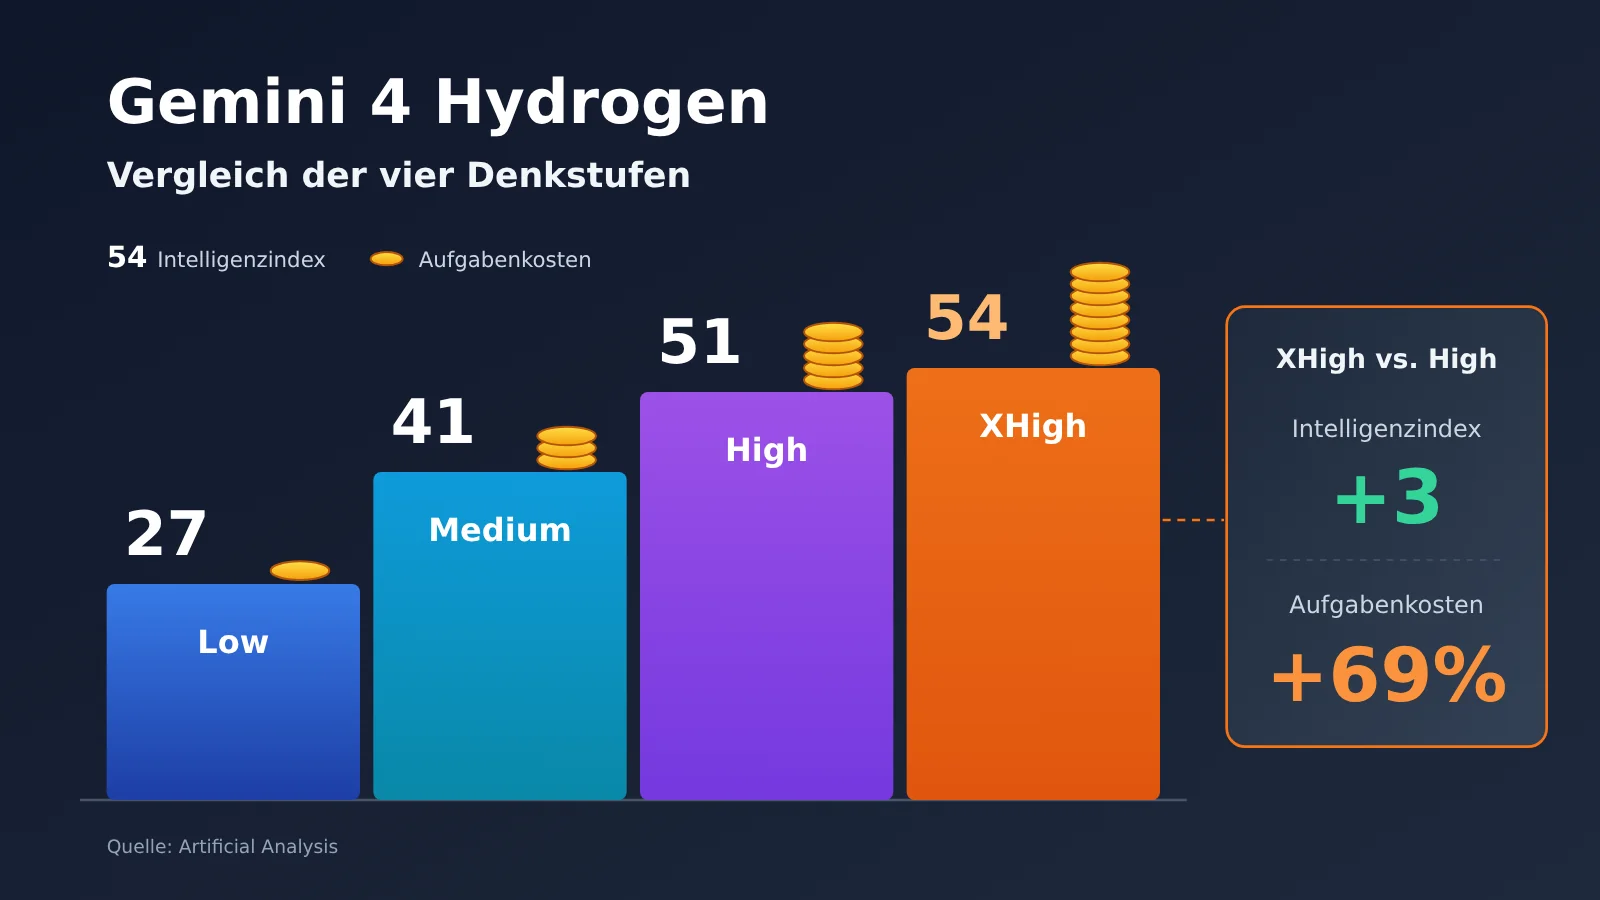
Kurzfassung: Die vierstufige Evaluierung von Artificial Analysis zeigt: Beim Wechsel von Gemini 4 Hydrogen von High auf XHigh steigt der Intelligenzindex nur um 3 Punkte, während die Kosten für die Evaluierungsaufgaben um rund 69 % zunehmen. Die Denkstufe sollte daher besser nach der Aufgabenschwierigkeit konfiguriert werden.
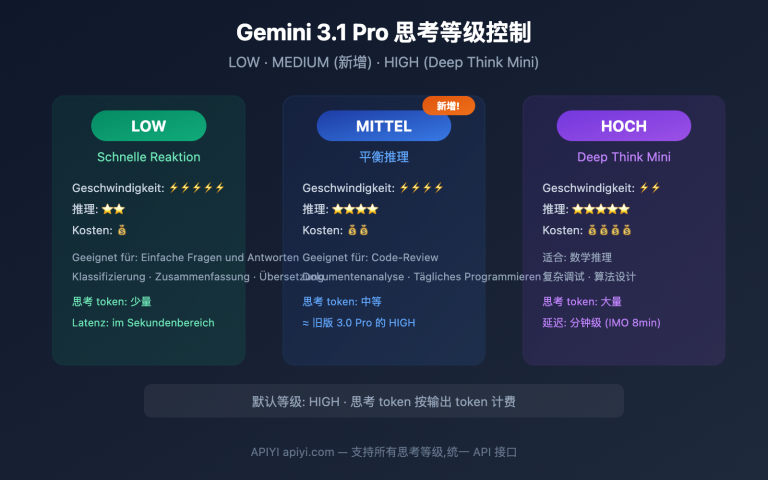
Google hat Gemini 4 Hydrogen am 12. November 2026 offiziell veröffentlicht und bietet dazu vier Denkstufen: Low, Medium, High und XHigh an. Alle vier Stufen verwenden dieselbe Modell-ID und dieselben Token-Preise, unterscheiden sich in den Bewertungen von Drittanbietern jedoch deutlich bei Punktzahl, Kosten und Wartezeit.
Dies ist keine Empfehlung nach dem Motto „je höher die Stufe, desto besser“. Dieser Artikel berechnet anhand der standardisierten Evaluierungsdaten von Artificial Analysis den Grenznutzen jeder Stufe und gibt je nach Aufgabentyp klare Empfehlungen zur Stufe.
Der zentrale Nutzen: Nach dem Lesen dieses Artikels können Sie einschätzen, welche Stufe für Ihr Geschäft geeignet ist und wie Sie mit dem Parameter thinking_level die Denkkosten steuern.
Begriffe, die Sie kennen sollten, bevor Sie die vier Denkstufen von Gemini 4 Hydrogen vergleichen
- thinking_level: Parameter, der die Reasoning-Tiefe des Modells steuert. Hydrogen unterstützt vier Werte: Low, Medium, High und XHigh.
- Thinking-Token: Token, die das Modell vor der endgültigen Antwort für das Reasoning erzeugt. Laut der offiziellen Preisseite von Google werden sie zum Output-Preis abgerechnet.
- Token: Die Maßeinheit, in der das Modell Text, Bilder und andere Informationen verarbeitet; die API rechnet pro Million Token ab.
- Harness: Testframework, das die Eingaben für das Modell zusammenstellt, Tool-Aufrufe ausführt und Aufgaben bewertet. Ergebnisse, die mit unterschiedlichen Harnesses erzielt wurden, lassen sich nicht direkt miteinander vergleichen.
- API: Schnittstelle, über die Programme einen Dienst aufrufen. Die Codebeispiele in diesem Artikel verwenden das OpenAI-kompatible Format.
Warum unterscheiden sich die vier Stufen desselben Gemini 4 Hydrogen so stark?
Gemini 4 Hydrogen ist ein hocheffizientes Modell von Google DeepMind, das vor allem für alltägliches Programmieren und die Ausführung von AI-Agent-Aufgaben gedacht ist; die Modell-ID in der API lautet gemini-4-hydrogen. Die vier Denkstufen sind keine vier Modelle, sondern vier Reasoning-Tiefen desselben Modells. Die Google-Cloud-Dokumentation nennt für jede Stufe einen empfohlenen Einsatzbereich:
| Denkstufe | Offiziell empfohlene Nutzung | Reasoning-Tiefe | Standard? |
|---|---|---|---|
| Low | Einfache Aufgaben wie Klassifizierung | Flach | Nein |
| Medium | Routine-Programmierung | Mittel | Nein (Standardstufe von 3.8 Flash) |
| High | Mehrstufige Agent-Aufgaben | Tief | ✅ Standard bei Hydrogen |
| XHigh | Komplexes, tiefgehendes Reasoning | Am tiefsten | Nein |
Gleicher Preis pro Token in allen vier Stufen – warum fällt die Rechnung trotzdem anders aus?
Stand 13. November 2026 liegen die offiziellen Standard-Preise von Google bei 1,50 $ pro Million Input-Token und 7,50 $ pro Million Output-Token – ohne Unterschied zwischen den vier Stufen. Die Differenz entsteht durch den Token-Verbrauch: Je höher die Stufe, desto mehr Thinking-Token erzeugt das Modell vor der Antwort, und diese Token werden zum Output-Preis abgerechnet.
„Gleicher Preis pro Token“ heißt also nicht „gleiche Kosten pro Aufgabe“. Dieselbe Frage kann unter XHigh ein Vielfaches des Reasoning-Umfangs von High erzeugen, und die Rechnung wächst entsprechend mit. Bei der Kostenschätzung sollten Sie nicht nur die Länge der endgültigen Antwort betrachten, sondern auch den unsichtbaren Reasoning-Anteil mit einrechnen.
Gemini 4 Hydrogen: Messdaten der vier Denkstufen im Vergleich – Punkte, Kosten und Geschwindigkeit
Die folgenden Daten stammen von der unabhängigen Organisation Artificial Analysis; die Evaluation wurde am Tag der Veröffentlichung abgeschlossen. Intelligenzindex, Kosten pro Evaluationsaufgabe und durchschnittliche Dauer stammen aus dem Intelligence Index v5.0.1; die Latenz bis zum ersten Antwort-Token und die Gesamtzahl der Ausgabe-Token stammen aus einem Seiten-Snapshot vom 13. November 2026. Alle Angaben sind standardisierte Evaluationsergebnisse Dritter und keine eigenen Messungen dieser Website.
| Denkstufe | Intelligenzindex | Durchschnittliche Kosten pro Aufgabe | Durchschnittliche Dauer pro Aufgabe | Latenz bis zum ersten Antwort-Token | Ausgabe-Token der gesamten Evaluation |
|---|---|---|---|---|---|
| Low | 27 | 0,29 $ | 1,3 Min. | ca. 5,7 s | 20,3 Mio. |
| Medium | 41 | 0,80 $ | 3,7 Min. | ca. 11,8 s | 54,4 Mio. |
| High (Standard) | 51 | 1,87 $ | 8,3 Min. | ca. 18,9 s | 110 Mio. |
| XHigh | 54 | 3,16 $ | 13,5 Min. | ca. 37,8 s | 304 Mio. |
Drei Kennzahlen mit unterschiedlicher Bedeutung
Die Tabelle enthält drei Arten von Kennzahlen, die nicht dasselbe aussagen:
- Intelligenzindex: eine kombinierte Fähigkeitspunktzahl aus mehreren Benchmarks; sie zeigt nur die relative Leistung innerhalb dieser Evaluation.
- Durchschnittliche Dauer pro Aufgabe: eine gewichtete Kennzahl aus der Anzahl der Ausgabe-Token pro Aufgabe und der End-to-End-Ausgabegeschwindigkeit. Sie bildet eine standardisierte Evaluationslast ab. Wer eine einfache Frage stellt, muss deshalb nicht unbedingt 8,3 Minuten warten.
- Latenz bis zum ersten Antwort-Token: die Wartezeit von der Anfrage bis zum ersten sichtbaren Antwort-Token, einschließlich der Denkphase des Reasoning-Modells. In Dialogsituationen ist sie die Kennzahl, die Nutzer am direktesten wahrnehmen.
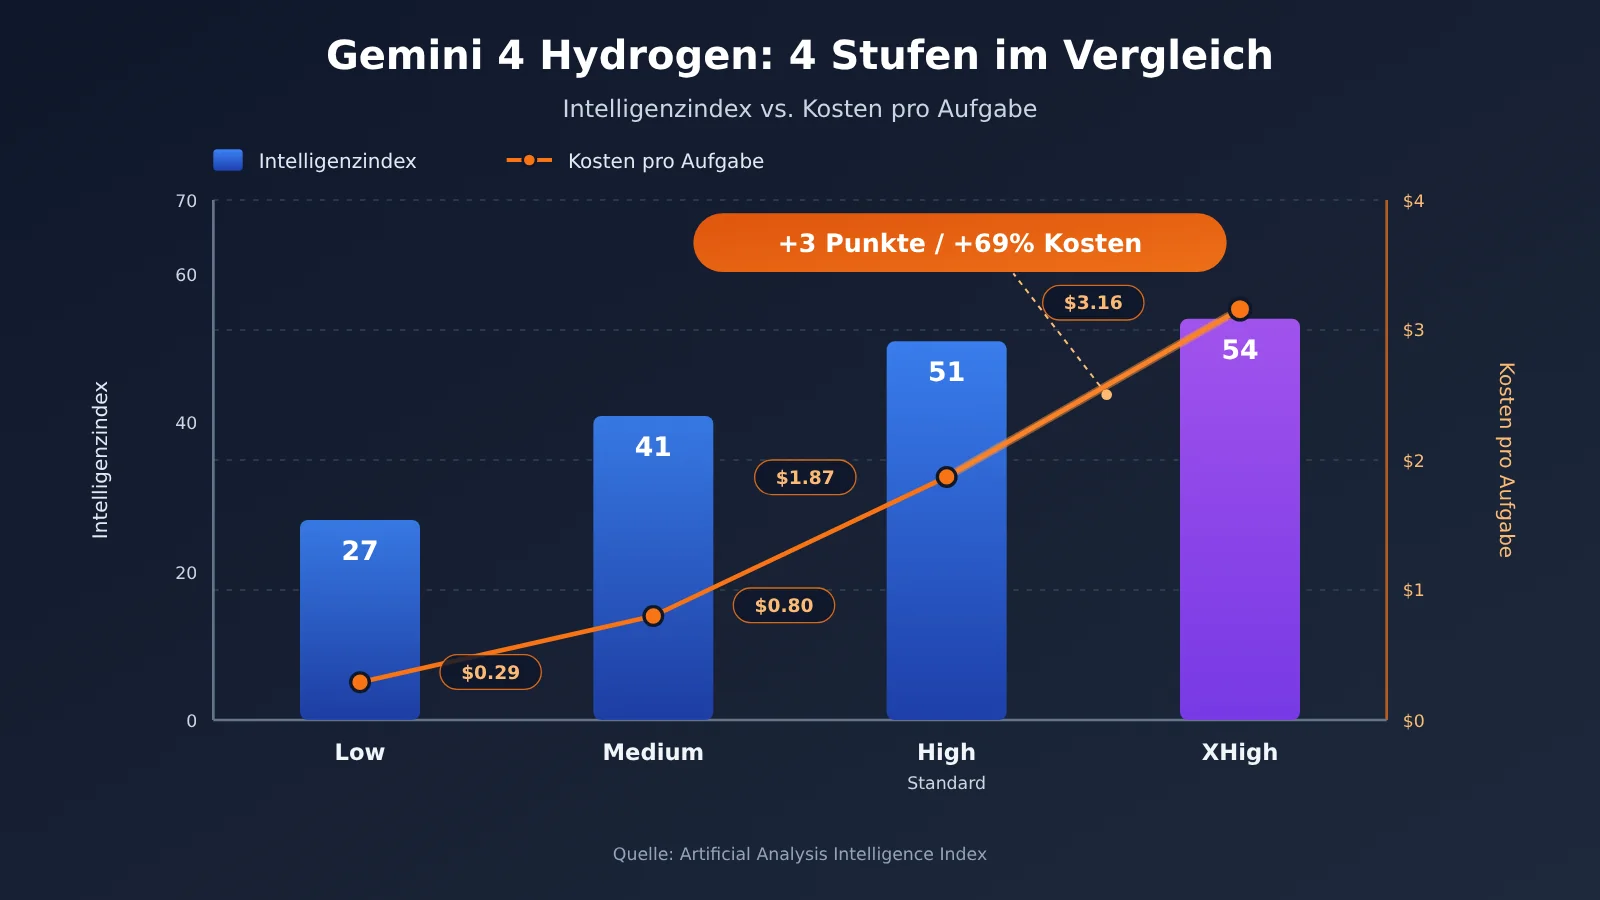
In der Tabelle zeigt sich: Der Punkteabstand von Medium zu High (10 Punkte) ist deutlich größer als der von High zu XHigh. Unter demselben Modellnamen kann der tatsächliche Fähigkeitsunterschied zwischen den Stufen mehr als 20 Punkte betragen. Beim Vergleich von Hydrogen mit anderen Modellen muss daher zuerst geklärt werden, welche Stufe dort verwendet wird.
Gemini 4 Hydrogen XHigh kostet 69 % mehr als High – was bekommt man dafür?
Vergleicht man die Daten der vier Stufen paarweise, ergeben sich Nutzen und Kosten jedes Upgrades. Die Inkrementverhältnisse in der folgenden Tabelle hat die Redaktion auf Basis der von Artificial Analysis veröffentlichten Daten berechnet.
| Upgrade-Pfad | Änderung des Intelligenzindex | Änderung der Aufgabenkosten | Änderung der durchschnittlichen Dauer | Zusätzliche Kosten pro zusätzlichem Punkt |
|---|---|---|---|---|
| Low → Medium | +14 Punkte | +176 % | +185 % | ca. $0.036 |
| Medium → High | +10 Punkte | +134 % | +124 % | ca. $0.107 |
| High → XHigh | +3 Punkte | +69 % | +63 % | ca. $0.43 |
Abnehmender Ertrag: die Grenzkosten der vier Denkstufen von Hydrogen
Beim Upgrade von High auf XHigh steigt der Intelligenzindex von 51 auf 54, also um etwa 5,9 %; die Kosten pro Aufgabe steigen von $1.87 auf $3.16, die Dauer von 8,3 Minuten auf 13,5 Minuten, und die Latenz bis zur ersten Antwort verdoppelt sich von etwa 18,9 Sekunden auf etwa 37,8 Sekunden. Umgerechnet auf „pro zusätzlichem Punkt“ sind die Grenzkosten von XHigh etwa 12-mal so hoch wie die von Low → Medium.
Der Hauptgrund liegt im Token-Verbrauch. High gibt über das gesamte Benchmark-Set etwa 110 Millionen Token aus, XHigh etwa 304 Millionen – rund das 2,76-Fache. Die Rechnung steigt jedoch nicht um das 2,76-Fache, weil die Gesamtkosten auch Eingabe-Token, Cache-Treffer und die Gewichtung der Benchmark-Aufgaben umfassen; aus dem Vielfachen der Ausgabe-Token lässt sich der Preis nicht direkt ableiten.
Ein niedriger Durchschnittswert heißt nicht, dass der Nutzen bei komplexen Aufgaben ebenfalls gering ist
Der Intelligenzindex ist der Durchschnitt über mehrere Aufgaben; ein Unterschied von 3 Punkten kann aus zwei Situationen stammen: Bei den meisten Aufgaben verhalten sich beide Stufen gleich, bei wenigen sehr schwierigen Aufgaben ist XHigh deutlich besser. Bei Aufgaben wie wissenschaftlichem Schlussfolgern, mathematischen Beweisen oder großen dateiübergreifenden Refactorings, bei denen „ein falscher Schritt alles verdirbt“, kann das zusätzliche Nachdenken von XHigh darüber entscheiden, ob die Aufgabe gelingt.
Daher ist die genauere Aussage: Für gewöhnliche Aufgaben ist das Preis-Leistungs-Verhältnis von XHigh sehr schlecht, für einige wenige sehr schwierige Aufgaben kann es notwendig sein. Ob sich die 69 % Aufpreis lohnen, muss man mit eigenen Aufgabenbeispielen prüfen und nicht nur am Durchschnittswert ablesen.
🎯 Technischer Tipp: Wählen Sie zunächst 20–50 echte Aufgabenbeispiele aus, führen Sie sie jeweils mit High und XHigh aus und vergleichen Sie Erfolgsquote und Kosten pro Aufgabe. Über APIYI apiyi.com können Sie mit demselben API-Schlüssel die Parameter umschalten und so einen A/B-Test durchführen, ohne die Struktur des Anwendungscodes ändern zu müssen.
Für welche Aufgaben eignen sich die vier Denkstufen von Gemini 4 Hydrogen?
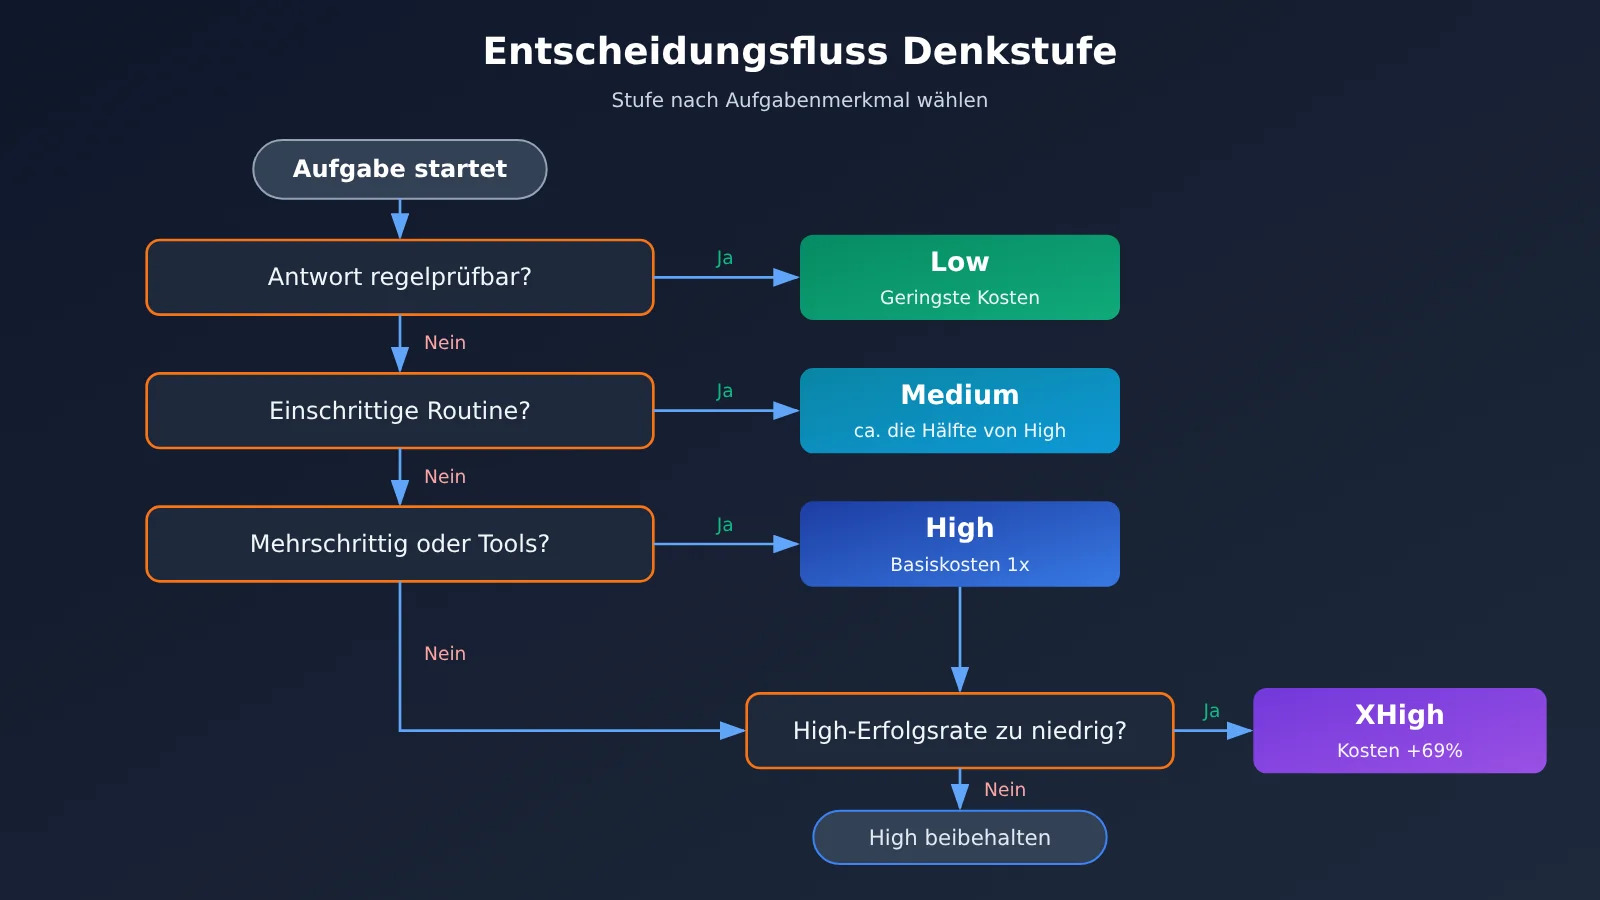
Kombiniert man die offiziellen Empfehlungen von Google mit den oben genannten Kostendaten, ergeben sich je nach Aufgabenschwierigkeit folgende Empfehlungen:
| Aufgabentyp | Empfohlene Stufe | Typische Beispiele | Begründung |
|---|---|---|---|
| Klassifizierung, Extraktion, Formatierung | Low | Ticket-Klassifizierung, Feldextraktion, JSON-Formatierung, einfache Frage-Antwort-Aufgaben | Geringste Kosten, Latenz bis zum ersten Token rund 5,7 Sekunden, gut geeignet für hohe Parallelität |
| Routinecode und Inhaltsverarbeitung | Medium | Funktionen für eine einzelne Datei schreiben, Textüberarbeitung, Dokumentzusammenfassung, allgemeine Geschäftsautomatisierung | 14 Punkte höher als Low, Kosten bleiben unter der Hälfte von High |
| Mehrstufige Agenten und Tool-Aufrufe | High | Dateiübergreifende Bugfixes, aufeinanderfolgende Tool-Aufrufe, Recherche mit anschließender Gesamtanalyse | Von Google voreingestellte Standardstufe, ausgewogenes Verhältnis von Leistung und Kosten |
| Hochkomplexes Reasoning | XHigh | Wissenschaftliches Reasoning, mathematische Beweise, Refactoring großer Softwareprojekte | Nur einsetzen, wenn die Erfolgsquote von High erkennbar nicht ausreicht |
Wann sich die niedrigen Stufen von Hydrogen eignen
Low und Medium passen zu Szenarien, in denen das Aufgabenziel klar und die Antwort leicht zu überprüfen ist. Zum Beispiel Betrag und Datum aus einem Vertrag extrahieren oder Nutzerfeedback in zehn Kategorien einordnen – bei solchen Aufgaben bringt längeres Nachdenken kaum mehr Genauigkeit, sondern nur zusätzliche Latenz und Kosten. In Szenarien, die empfindlich auf die Latenz bis zum ersten Token reagieren, etwa Echtzeit-Chat oder Autovervollständigung in der Suche, ist Low mit rund 5,7 Sekunden deutlich besser als XHigh mit etwa 37,8 Sekunden.
Wann sich die hohen Stufen von Hydrogen eignen
High ist die von Google voreingestellte Standardstufe und passt für die meisten Agenten-Workflows. Erst wenn eine Aufgabe das Muster zeigt „High scheitert wiederholt, die Retry-Kosten übersteigen bereits die Kosten der höheren Stufe“, lohnt sich der Wechsel zu XHigh. Zu beachten ist, dass auch die offizielle Modellkarte von Google darauf hinweist, dass hohe Denkstufen Dauer und Kosten deutlich erhöhen können und gelegentlich Verzögerungen oder Timeouts auftreten – bei langen Aufgabeketten sollten Timeout- und Retry-Strategien sauber konfiguriert sein.
Wie Entwickler die Thinking-Kosten von Gemini 4 Hydrogen steuern
Parameter thinking_level und Standardwerte
Hydrogen wählt über den Parameter thinking_level die Thinking-Stufe aus; wird er nicht übergeben, ist High der Standard. Bei der Migration von Gemini 3.8 Flash gibt es einige Punkte zu beachten:
- Bei 3.8 Flash ist Medium der Standard. Nach der Migration wird ohne Parameterübergabe automatisch High verwendet, wodurch die Rechnung steigen kann.
thinking_budgetundMINIMALwerden nicht mehr unterstützt; ihre Verwendung führt zu HTTP 400.- Benutzerdefinierte Werte für temperature, top_p und top_k werden ignoriert.
- Bei Multi-Turn-Tool-Aufrufen müssen Thought-Signaturen korrekt gespeichert und zurückübermittelt werden.
Minimalbeispiel: Hydrogen stufenweise aufrufen
Im Folgenden wird das Modell im OpenAI-kompatiblen Format aufgerufen; die Denkstufe wird über extra_body übergeben. Je nach Plattform kann sich das Feld unterscheiden, über das dieser Parameter weitergereicht wird. Der genaue Feldname richtet sich nach der Plattformdokumentation.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "把这条反馈分类:退款太慢"}],
    extra_body={"thinking_level": "low"}  # Für einfache Klassifizierung Low verwenden
)
print(resp.choices[0].message.content)
Vollständigen Implementierungscode ansehen: Aufgaben nach Schwierigkeit einstufen und automatisch hochstufen
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Zuordnung von Aufgabentypen zu Standardstufen
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """Zuerst eine niedrige Stufe verwenden; bei fehlgeschlagener Validierung schrittweise hochstufen. max_level begrenzt die höchste Stufe."""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # Token protokollieren, um die Kosten erfolgreicher Aufgaben zu berechnen
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="提取订单号,只返回数字:订单 A-20261113-889 已发货",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 Schnellstart: APIYI apiyi.com bietet eine OpenAI-kompatible Schnittstelle. Mit einem einzigen API-Schlüssel lassen sich gängige Modelle wie Gemini, Claude und OpenAI aufrufen. Neue Nutzer erhalten ein kostenloses Testkontingent – ideal, um die oben beschriebene Stufenstrategie zuerst auszuprobieren und dann live zu gehen.
Stufenstrategie: Zuerst niedrig, bei Fehlschlag hochstufen
Die empfohlene Vorgehensweise lautet „standardmäßig niedrig, bei Bedarf hochstufen“: Einfache Aufgaben fest auf Low oder Medium festlegen; komplexe Aufgaben mit High beginnen und nur bei fehlgeschlagener Validierung auf XHigh hochstufen; und für jede Aufgabenart eine Obergrenze für die höchste Stufe setzen, um unerwartete Kostenexplosionen zu vermeiden. Das entspricht dem Ansatz von Google im Antigravity Orchestrator, verschiedene Modelle arbeitsteilig einzusetzen – nur dass hier die Denktiefe desselben Modells angepasst wird.
Die Wirkung der Hydrogen-Stufenoptimierung an vier Kennzahlen messen
| Optimierungskennzahl | Berechnung | Warum es wichtig ist |
|---|---|---|
| Genauigkeit / Erfolgsrate | Anzahl der validierten Aufgaben ÷ Gesamtzahl der Aufgaben | Die Qualität darf nach dem Herunterstufen nicht deutlich sinken |
| End-to-End-Zeit | Gesamtdauer von der Anfrage bis zum brauchbaren Ergebnis, inklusive Wiederholungen | Die Latenz bis zum ersten Token ist nur ein Teil davon |
| Token-Verbrauch | Eingabe- + Ausgabe-Token (inkl. Denken) | Denk-Token werden zum Ausgabepreis abgerechnet |
| Kosten pro erfolgreicher Aufgabe | Gesamtkosten ÷ Anzahl erfolgreicher Aufgaben | Häufige Fehlschläge und Wiederholungen auf niedriger Stufe können teurer sein als eine höhere Stufe |
Die „Kosten pro erfolgreicher Aufgabe“ spiegeln die tatsächlichen Ausgaben am besten wider. Wenn bei Medium 30 % der Aufgaben erneut ausgeführt werden müssen, während High schon beim ersten Versuch erfolgreich ist, können die Kosten pro erfolgreicher Aufgabe bei High sogar niedriger ausfallen.
Häufig gestellte Fragen (FAQ)
F1: Sind die vier Denkstufen von Gemini 4 Hydrogen vier verschiedene Modelle?
Nein. Die vier Stufen sind unterschiedliche Inferenztiefen desselben Modells `gemini-4-hydrogen` und werden über den Parameter thinking_level umgeschaltet. Der Token-Preis ist identisch – der Unterschied liegt in der Anzahl der erzeugten Denk-Token.
F2: XHigh liegt nur 3 Punkte über High – braucht man es dann überhaupt nicht?
So sollte man das nicht verstehen. Die 3 Punkte sind der durchschnittliche Abstand über viele verschiedene Aufgaben hinweg. Bei wissenschaftlichem Schließen, mathematischen Beweisen und großen Engineering-Aufgaben kann XHigh darüber entscheiden, ob eine Aufgabe überhaupt gelöst wird. Für gewöhnliche Aufgaben ist das Preis-Leistungs-Verhältnis von XHigh eher schlecht, für einige wenige sehr schwierige Aufgaben kann es dagegen notwendig sein.
F3: Die durchschnittliche Dauer von 8,3 Minuten bei High bedeutet doch, dass ich bei jeder Frage so lange warten muss?
Nein. Die 8,3 Minuten sind die gewichtete Laufzeit für die standardisierten Benchmark-Aufgaben von Artificial Analysis. Bei normalen Dialogen sollte man eher die Latenz bis zum ersten Antwort-Token betrachten: Sie liegt bei High bei etwa 18,9 Sekunden, bei Low bei etwa 5,7 Sekunden. Die tatsächliche Dauer hängt außerdem von der Länge der Aufgabe ab.
F4: Was passiert, wenn thinking_level nicht übergeben wird?
Standardmäßig wird High verwendet. Bei Projekten, die von Gemini 3.8 Flash (Standard: Medium) migriert wurden, steigt die Denkstufe automatisch an, wenn der alte Code ohne Parameter weiterverwendet wird – und damit möglicherweise auch die Kosten. Es empfiehlt sich daher, die Stufe explizit zu setzen.
F5: Wie kann ich schnell vergleichen, welche Stufe in meinem eigenen Geschäftsbereich am besten funktioniert?
Am besten bereiten Sie eine Reihe echter Aufgabenbeispiele vor, lassen sie mit den verschiedenen Stufen laufen und erfassen Erfolgsquote und Token-Verbrauch:
1. Bei APIYI apiyi.com registrieren und API-Schlüssel sowie kostenloses Testkontingent erhalten
2. Den Code aus diesem Artikel verwenden und den Wert von `thinking_level` ändern
3. Anhand der „Kosten pro erfolgreich erledigter Aufgabe“ die passende Stufe auswählen
F6: Welche bekannten Probleme gibt es bei den hohen Denkstufen von Hydrogen?
Die Google-Modellkarte weist darauf hin, dass hohe Denkstufen Dauer und Kosten deutlich erhöhen können und gelegentlich Verzögerungen oder Timeouts auftreten. Außerdem berichten Nutzer auf Hacker News, dass bei manchen Agent-Aufgaben eine übermäßige Ausführung zu beobachten ist. Für lange Aufgaben sollten Sie daher Timeouts, eine maximale Stufe und Abbruchbedingungen festlegen.
F7: Was ist der häufigste Irrtum bei der Kostenschätzung anhand von Token?
Nur anhand der Wortzahl der endgültigen Antwort zu schätzen. Denk-Token werden zum Ausgabepreis gerechnet; bei der vollständigen XHigh-Benchmark-Suite liegt die Anzahl der Ausgabe-Token etwa beim 2,76-Fachen von High. Die tatsächlichen Verbrauchsdetails in der Konsole von APIYI apiyi.com anzusehen ist verlässlicher als eine manuelle Schätzung.
Gemini 4 Hydrogen: Vier Denkstufen – die wichtigsten Erkenntnisse
- Gleiches Modell, unterschiedliche Stufen: Der Stückpreis ist bei allen vier Stufen gleich; die tatsächlichen Kosten einer Aufgabe hängen vom Verbrauch an Denk-Token ab.
- Deutlich abnehmender Nutzen: Von High auf XHigh bringt 3 Punkte mehr, erhöht die Kosten der Benchmark-Aufgabe aber um etwa 69 %.
- Doppelte Latenz: Bei XHigh liegt die Latenz bis zur ersten Antwort bei etwa 37,8 Sekunden – doppelt so lang wie bei High.
- Standard ist High: Bei der Migration von 3.8 Flash muss die Stufe explizit festgelegt werden.
- Stufe nach Schwierigkeit wählen: Low für Klassifizierung, Medium für Routineaufgaben, High für Agenten, XHigh nur für schwierige Aufgaben.
- Kosten pro erfolgreicher Aufgabe betrachten: Erst wenn Wiederholungsversuche mit eingerechnet werden, lassen sich die tatsächlichen Kosten der einzelnen Stufen vergleichen.
- Mit Stichproben verifizieren: Über APIYI apiyi.com lässt sich mit einem einzigen API-Schlüssel die Wirkung aller vier Stufen vergleichen.
Zusammenfassung
Die zentralen Ergebnisse des Vergleichs der vier Denkstufen von Gemini 4 Hydrogen:
- Große Leistungsunterschiede: Von 27 Punkten bei Low bis 54 Punkten bei XHigh – unter demselben Modellnamen unterscheidet sich die Leistung um den Faktor zwei.
- Steigende Grenzkosten: Die Zusatzkosten pro weiterem Punkt steigen von etwa $0,036 bei Low → Medium auf etwa $0,43 bei High → XHigh.
- XHigh nur bei Bedarf einsetzen: Der Unterschied beim Durchschnittswert ist gering, bei einigen wenigen sehr schwierigen Aufgaben kann XHigh aber entscheidend sein.
Für den Alltag gilt: thinking_level explizit setzen, einfache Aufgaben mit einer niedrigen Stufe erledigen, bei komplexen Schritten die Stufe erhöhen und die Kosten pro erfolgreicher Aufgabe als endgültigen Maßstab verwenden.
Empfehlenswert ist es, die Wirkung der einzelnen Stufen über APIYI apiyi.com schnell mit echten Aufgabenbeispielen zu prüfen; die Plattform bietet eine OpenAI-kompatible Schnittstelle und ein kostenloses Testkontingent.
📚 Referenzen
- Artificial Analysis – Gemini 4 Hydrogen, Bewertungsseite für alle vier Stufen: Intelligenzindex, Aufgabenkosten, Dauer und Latenzdaten
- Link:
artificialanalysis.ai/models/gemini-4-hydrogen-low - Link:
artificialanalysis.ai/models/gemini-4-hydrogen-medium - Link:
artificialanalysis.ai/models/gemini-4-hydrogen-high - Link:
artificialanalysis.ai/models/gemini-4-hydrogen -
Erläuterung: Quelle sämtlicher Vergleichsdaten der vier Stufen in diesem Artikel; die Latenz ist ein dynamischer Kennwert
-
Google offizieller Blog – Introducing Gemini 4 Hydrogen: Produktankündigung
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Erläuterung: Positionierung des Modells, Fähigkeitsumfang und Partnerfallbeispiele
-
Google Cloud Entwicklerhandbuch – Gemini 4 Hydrogen: thinking_level und Hinweise zur Migration
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Erläuterung: empfohlene Einsatzbereiche der vier Stufen, Standardstufe, inkompatible Parameter
-
Google AI Studio Preisseite: offizielle API-Preise für Hydrogen
- Link:
aistudio.google.com/docs/pricing -
Erläuterung: Preise für die Modi Standard, Batch, Flex und Priority, Abrechnungsregeln für Denk-Token
-
Google DeepMind Modellkarte: Einschränkungen und Sicherheitsbewertung
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Erläuterung: Zeitrisiko bei hohen Denkstufen, bekannte Probleme wie Antwortverweigerungen und Halluzinationen
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website, um weitere Materialien zur Integration der Gemini-Modellreihe zu erhalten