Note de l’auteur : à volume de tokens identique, le tarif standard actuel de Gemini 4 Hydrogen est le double de celui de 3.8 Flash. Pour choisir parmi les quatre modèles Gemini, il ne suffit pas de regarder le prix unitaire : il faut aussi considérer le coût par tâche réussie, ainsi que les dates de révision tarifaire déjà annoncées officiellement.
Google a officiellement lancé Gemini 4 Hydrogen le 12 novembre 2026. Beaucoup de développeurs ont d’abord pensé : « La nouvelle génération de Flash arrive, elle devrait être moins chère ». La réalité est inverse : selon les tarifs standard de l’API Google Gemini, le prix de Hydrogen par million de tokens est le double de celui de 3.8 Flash, mais il reste moins cher que les Argon et Carbon de la même série.
Ce n’est pas une analyse de compromis où chaque modèle aurait ses mérites. Dans cet article, nous utilisons uniformément les tarifs standard de l’API Google Gemini (vérifiés le 13 novembre 2026, en dollars / million de tokens). Nous commençons par calculer combien coûte chaque modèle pour un même volume d’activité, puis nous déterminons dans quelles conditions Hydrogen devient réellement avantageux, et enfin nous proposons des recommandations de choix directement applicables, en tenant compte des changements tarifaires du 1er décembre et du 1er janvier de l’année prochaine.
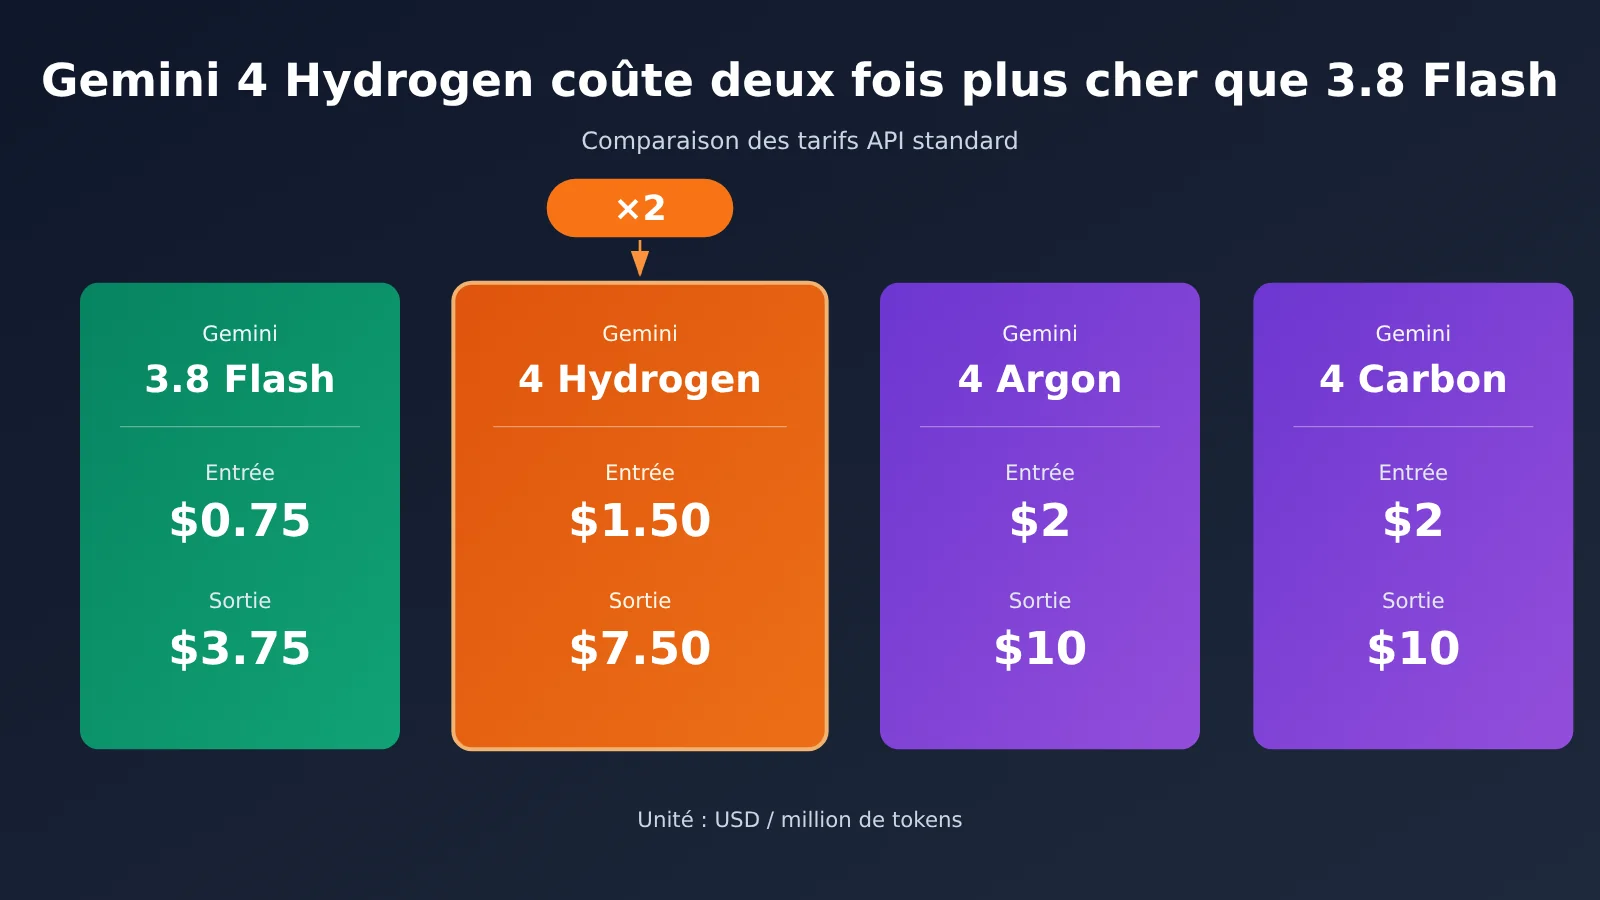
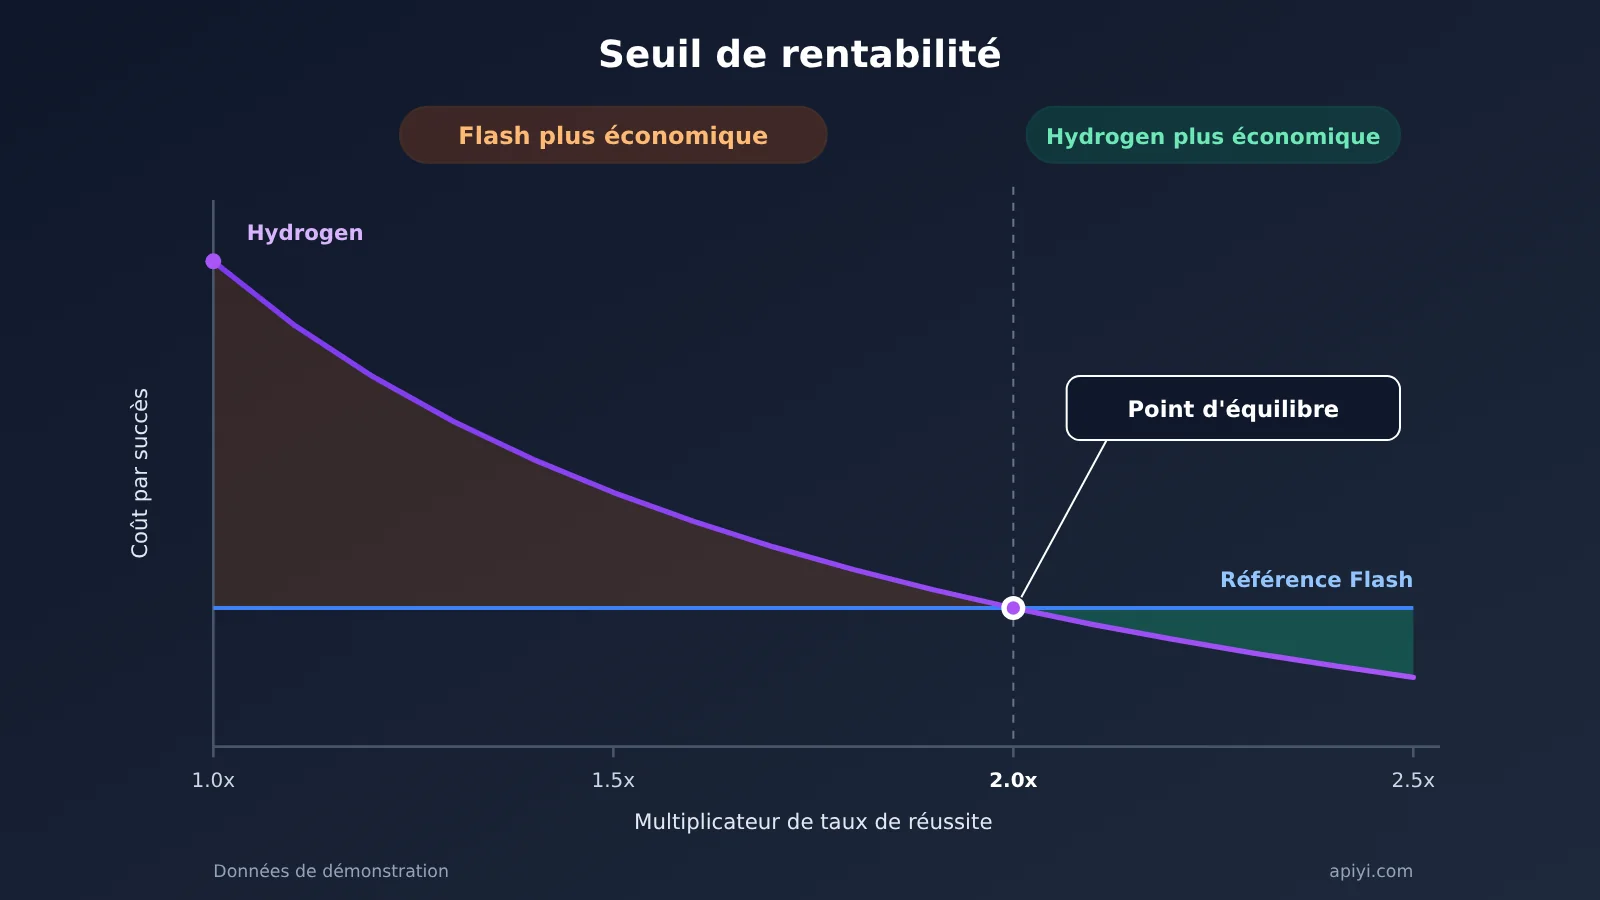
En une phrase : le prix unitaire par token de Hydrogen est actuellement 2 fois celui de 3.8 Flash. Le passage à Hydrogen vaut la peine si, et seulement si, il permet de diviser par deux le volume total de tokens facturés, ou de doubler le taux de réussite d’une tentative.
5 termes à connaître avant de lire
Voici quelques notions qui influenceront directement votre perception du prix de Gemini 4 Hydrogen. Je vous conseille d’y jeter un œil avant de continuer :
- Token : unité de mesure utilisée par le modèle lorsqu’il traite du texte, des images ou d’autres informations. L’API facture séparément les tokens d’entrée et les tokens de sortie.
- Tokens de raisonnement : tokens consommés pendant le processus de raisonnement du modèle. La page tarifaire officielle de Google précise clairement que les tokens de raisonnement sont facturés au tarif de sortie. Si vous estimez donc le coût uniquement à partir de la longueur de la réponse finale, vous obtiendrez un résultat trop bas.
- Cache implicite : la plateforme réutilise automatiquement les préfixes d’entrée qui remplissent les conditions requises. La partie qui bénéficie du cache est facturée au tarif de cache. Hydrogen prend en charge le cache implicite, avec un préfixe minimal de 4096 tokens, mais pas le cache explicite.
- Grounding : consiste à relier la réponse générée à des preuves externes récupérées, par exemple avec Google Search Grounding. Cette partie est facturée séparément en fonction du nombre de requêtes de recherche.
- API : interface permettant à un programme d’appeler un service. Les prix mentionnés dans cet article concernent la facturation lors de l’appel de l’API par un programme, et non l’abonnement à l’application Gemini.
Les principales différences de prix entre Gemini 4 Hydrogen, 3.8 Flash, Argon et Carbon
Comment sont facturés les quatre modèles Gemini depuis la sortie de Hydrogen
Le tableau ci-dessous récapitule les tarifs standard d’appel de l’API Google Gemini. Les prix proviennent de la page de tarification officielle et ont été vérifiés le 13 novembre 2026.
| Modèle | Prix d’entrée actuel | Prix de sortie actuel | Ajustement annoncé | Positionnement officiel |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | Ajustement à $1.50 / $7.50 à partir du 2027-01-01 | Modèle de la génération précédente au meilleur rapport qualité-prix |
| Gemini 4 Hydrogen | $1.50 | $7.50 | Aucun ajustement tarifaire progressif annoncé publiquement pour l’instant | Programmation quotidienne et exécution d’agents |
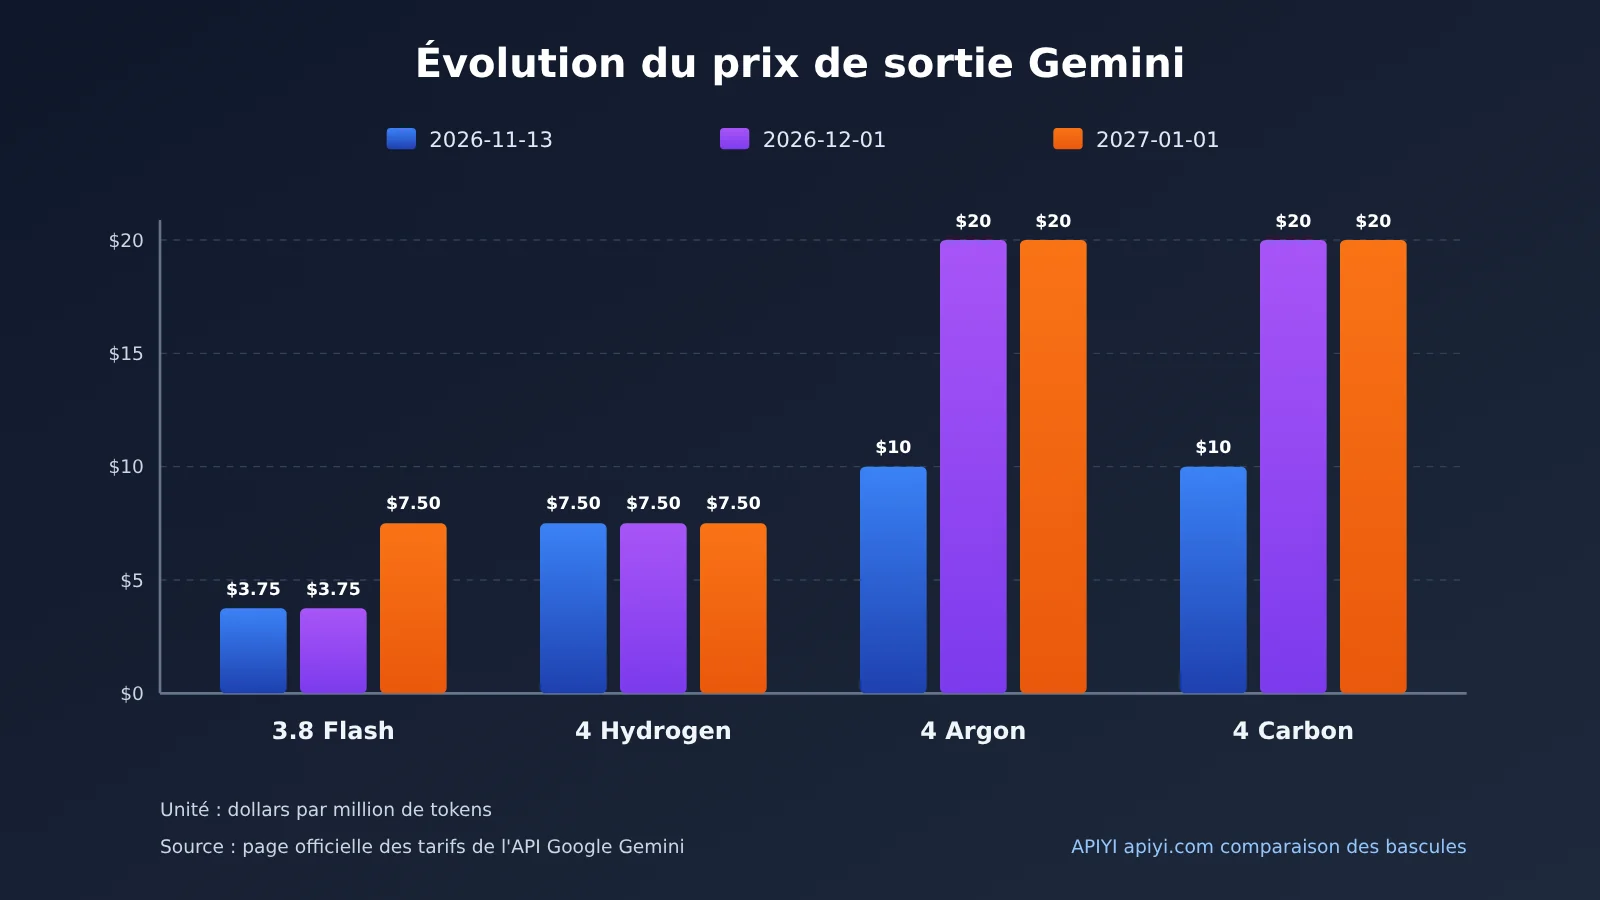
| Gemini 4 Argon | $2.00 | $10.00 | Ajustement à $4 / $20 à partir du 2026-12-01 | Raisonnement complexe et approfondi sur longue durée |
| Gemini 4 Carbon | $2.00 | $10.00 | Ajustement à $4 / $20 à partir du 2026-12-01 | Raisonnement complexe et approfondi sur longue durée |
L’unité de prix est le dollar américain par million de tokens. On voit dans le tableau que les prix d’entrée et de sortie de Hydrogen valent exactement le double des tarifs actuels de 3.8 Flash. Pour les utilisateurs qui migrent depuis Flash, Hydrogen représente donc une hausse de prix, et non une baisse du tarif unitaire.
Ars Technica décrit Hydrogen comme le modèle qui succède à la série Flash, ce qui laisse facilement penser que son prix se situe lui aussi dans la gamme Flash. En réalité, son tarif se place entre Flash et Argon/Carbon : c’est une gamme intermédiaire.
Les autres modes de facturation de Hydrogen
Outre l’appel standard, Hydrogen propose plusieurs modes de facturation adaptés à différentes exigences de latence :
- Appels par lots Batch / Flex : entrée $0.75, sortie $3.75, soit exactement la moitié du tarif standard.
- Appels prioritaires Priority : entrée $2.70, sortie $13.50.
- Entrée avec correspondance de cache implicite : $0.075 en appel standard, $0.0375 en Batch et Flex.
- Niveau API gratuit : gratuit, mais avec des quotas. La documentation officielle précise que le contenu du niveau gratuit peut être utilisé pour améliorer les produits Google, et que ce niveau n’offre pas de quota de requêtes Search Grounding gratuites.
À noter également : les tarifs de Google Cloud Agent Platform varient selon la région. Hors région Global, le tarif standard de Hydrogen est de $1.65 en entrée et $8.25 en sortie, soit 10 % de plus que le tarif Global. Pour rester cohérent, toutes les comparaisons de cet article s’appuient sur les tarifs standard de l’API Google Gemini, sans mélanger avec les tarifs régionaux des plateformes cloud d’entreprise.
Comparaison du coût mensuel entre Gemini 4 Hydrogen et 3.8 Flash à volume d’activité équivalent
Budget mensuel sur un exemple unifié
L’écart de prix unitaire finit toujours par se voir sur la facture du mois. On part ici d’une charge de travail type : 1 000 appels par mois, avec 8 000 tokens d’entrée et 2 000 tokens de sortie (tokens de réflexion inclus) par appel, aux tarifs standard de l’API, sans compter les hits de cache, les frais d’outils ni les tentatives répétées.
La formule de calcul est la suivante :
Coût mensuel = (Tokens d'entrée du mois × Prix unitaire d'entrée + Tokens de sortie du mois × Prix unitaire de sortie) ÷ 1,000,000
Entrée mensuelle = 1,000 × 8,000 = 8,000,000 Token
Sortie mensuelle = 1,000 × 2,000 = 2,000,000 Token
| Modèle | Calcul | Budget mensuel au 2026-11-13 | Budget selon les ajustements tarifaires annoncés |
|---|---|---|---|
| 3.8 Flash | 8 × 0.75 + 2 × 3.75 | $13.50 | $27.00 (à partir du 2027-01-01) |
| 4 Hydrogen | 8 × 1.50 + 2 × 7.50 | $27.00 | $27.00 |
| 4 Argon | 8 × 2.00 + 2 × 10.00 | $36.00 | $72.00 (à partir du 2026-12-01) |
| 4 Carbon | 8 × 2.00 + 2 × 10.00 | $36.00 | $72.00 (à partir du 2026-12-01) |
Il s’agit d’un budget de scénario calculé à partir des tarifs officiels, et non d’une mesure de la consommation réelle des modèles. Deux choses ressortent du tableau : en novembre, Hydrogen coûte bel et bien le double de Flash ; et selon les échéances annoncées, au 1er janvier 2027, le tarif standard de Flash rejoindra le niveau actuel d’Hydrogen.
Impact des tokens de réflexion, du cache, des appels par lots et de la recherche sur la facture Gemini
Le budget ci-dessus correspond à un cas idéal ; la facture réelle dépend aussi de quatre facteurs.
Premièrement, les tokens de réflexion. Le niveau de réflexion par défaut de Hydrogen est High (celui de 3.8 Flash est Medium), et les tokens de réflexion sont facturés au prix de sortie. Si vous migrez directement sans ajuster le niveau, le nombre de tokens de sortie risque fort d’augmenter sensiblement. Les évaluations indépendantes d’Artificial Analysis montrent que, pour les quatre niveaux Low, Medium, High et XHigh, le coût moyen par tâche de référence de Hydrogen s’élève respectivement à environ $0.29, $0.80, $1.87 et $3.16. À noter : il s’agit de données issues de ses tâches d’évaluation standardisées, qui ne correspondent pas au coût par message d’une conversation ordinaire.
Deuxièmement, le cache implicite. En supposant que, sur les 8,000 tokens d’entrée de chaque appel, 6,000 soient des invites système fixes et des préfixes de document (au-delà du seuil minimal de 4096 tokens), et que tout corresponde au cache, le coût mensuel de Hydrogen serait de : 2 × 1.50 + 6 × 0.075 + 2 × 7.50 = $18.45, soit environ un tiers de moins que $27. Il s’agit d’une extrapolation hypothétique de la rédaction ; le taux de correspondance réel doit être vérifié sur la facture.
Troisièmement, les appels par lots. Pour les tâches qui n’exigent pas de réponse en temps réel, comme une analyse par lots nocturne, passer à Batch fait descendre le coût mensuel exemple de Hydrogen à $13.50, soit le même niveau que le prix standard de Flash.
Quatrièmement, l’outil de recherche. Dans le niveau payant, les 5,000 premières requêtes de recherche Google Search Grounding chaque mois sont gratuites (quota partagé avec Gemini 3 et les modèles plus récents) ; au-delà, 1,000 requêtes coûtent $14, et une seule requête de modèle peut déclencher plusieurs recherches. Les applications de type agent doivent surveiller ce poste séparément.
🎯 Conseil technique : Pour une évaluation des coûts, je vous conseille d’appeler les quatre modèles avec le même jeu d’échantillons métier réels et de noter le champ usage à chaque appel. Avec APIYI apiyi.com, une seule clé API et une interface compatible OpenAI permettent de changer de modèle, ce qui réduit la charge de maintenance de plusieurs SDK (pour les modèles réellement disponibles, référez-vous à la liste des modèles de la plateforme).
Comment comparer par le code le coût réel de quatre modèles Gemini
Exemple d’appel minimal
Le code ci-dessous appelle Hydrogen via l’interface compatible OpenAI et affiche la consommation de tokens :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用三句话解释隐式缓存"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Surveiller prompt_tokens et completion_tokens
Voir l’implémentation complète : comparer par lots le coût des quatre modèles sur une même tâche
import openai

# Prix unitaire : USD par million de tokens, tarif standard de l'API Google Gemini, vérifié le 2026-11-13
PRICES = {
    "gemini-3.8-flash":  (0.75, 3.75),
    "gemini-4-hydrogen": (1.50, 7.50),
    "gemini-4-argon":    (2.00, 10.00),
    "gemini-4-carbon":   (2.00, 10.00),
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_once(model: str, prompt: str) -> dict:
    """Appelle le modèle une fois et renvoie l'usage plus le coût estimé au tarif standard"""
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p_in, p_out = PRICES[model]
    # completion_tokens inclut généralement les tokens de réflexion ; se fier aux champs renvoyés
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1_000_000
    return {
        "model": model,
        "input": u.prompt_tokens,
        "output": u.completion_tokens,
        "cost_usd": round(cost, 6),
        "text": resp.choices[0].message.content,
    }

def compare(prompt: str, check) -> None:
    """check : fonction qui détermine si la sortie a bien accompli la tâche"""
    for model in PRICES:
        try:
            r = run_once(model, prompt)
            ok = check(r["text"])
            print(f'{r["model"]:20} in={r["input"]:6} out={r["output"]:6} '
                  f'cost=${r["cost_usd"]:.5f} success={ok}')
        except Exception as e:
            print(f"{model:20} error: {e}")

if __name__ == "__main__":
    compare(
        "写一个 Python 函数,解析 ISO8601 日期并处理时区,附带单元测试",
        check=lambda t: "def " in t and "assert" in t,
    )
L’intérêt de ce script, c’est de réunir dans une même statistique la « réussite » et le « coût ». Le prix unitaire seul ne permet pas de conclure : ce n’est qu’en lançant chaque modèle plusieurs dizaines de fois et en calculant le coût moyen d’une réussite qu’on obtient un chiffre vraiment parlant.
🚀 Pour démarrer vite : les nouveaux utilisateurs peuvent s’inscrire sur APIYI apiyi.com et récupérer un quota de test gratuit, puis lancer le script de comparaison ci-dessus avec leurs propres invites avant de choisir le modèle à utiliser en production.
Gemini 4 Hydrogen : quand vaut-il encore la peine d’y mettre deux fois le prix ?
Passer du prix unitaire au coût par tâche réussie
Pour les tâches qui demandent plusieurs étapes, ce qu’il faut vraiment comparer, c’est le coût espéré par tâche menée à bien :
Coût par tentative C = (T_in × P_in + T_out × P_out) ÷ 10^6
Coût par réussite = C ÷ taux de réussite par tentative
Aux prix de novembre 2026, le coût par token de Hydrogen est exactement le double de celui de Flash. On en déduit deux conditions d’équilibre :
- Si les deux modèles ont le même taux de réussite, Hydrogen doit réduire d’environ 50 % le total de tokens facturés pour que le coût reste équivalent.
- Si les deux consomment le même nombre de tokens par tentative, Hydrogen doit atteindre un taux de réussite par tentative deux fois supérieur à celui de Flash pour que le coût espéré par réussite soit équivalent.
Voici un exemple de calcul éditorial ; tous les taux de réussite sont des hypothèses, pas des mesures réelles :
| Scénario hypothétique | Coût par tentative | Taux de réussite hypothétique | Coût espéré par réussite |
|---|---|---|---|
| Flash sur une tâche d’agent multi-étapes | $0.0135 | 40 % | $0.0338 |
| Hydrogen sur la même tâche | $0.0270 | 80 % | $0.0338 (équivalent) |
| Hydrogen sur la même tâche | $0.0270 | 90 % | $0.0300 (moins cher) |
| Flash sur une tâche de classification simple | $0.0135 | 95 % | $0.0142 |
| Hydrogen sur une tâche de classification simple | $0.0270 | 98 % | $0.0276 (presque deux fois plus cher) |
La conclusion est simple : sur les tâches simples que Flash sait déjà bien faire, le surcoût de Hydrogen ne se récupère pratiquement jamais ; sur les tâches complexes où Flash échoue souvent et qu’il faut réessayer à répétition, Hydrogen a une chance d’égaler le coût, voire de le réduire.
Ce que disent les données de performance officielles
Les chiffres publiés par Google indiquent que Hydrogen obtient 57,0 % sur Terminal-Bench 4.1, contre 18,2 % pour Flash 3.8. Google affirme aussi qu’à conditions de test identiques, les tâches sont terminées environ 2,5 fois plus vite et que la fréquence des faits inventés baisse de plus d’un facteur 5. Parmi les chiffres communiqués par les partenaires, Box réduit de 12 % sa consommation de tokens sur les tâches documentaires d’entreprise, et STAN de 23 % sur le total de ses tokens.
Ces chiffres demandent une lecture prudente. Ce sont des résultats de tests officiels ou de partenaires, qu’on ne peut pas convertir directement en pourcentage d’économies dans votre cas. Une économie de 12 % à 23 % de tokens reste très loin du seuil d’équilibre de 50 % : savoir si Hydrogen permet d’économiser dépend donc surtout de la hausse du taux de réussite, pas des tokens économisés. Par ailleurs, aller plus vite réduit le temps d’attente et l’occupation des machines, mais cela ne vient pas en déduction directe de la facture API.
Scénarios recommandés pour Gemini 4 Hydrogen, Flash, Argon et Carbon
Quand choisir 3.8 Flash
- Tâches de traitement par lots volumineux et à processus stable : par exemple classification de texte, extraction de champs, génération de résumés, conversion de format. Flash affiche déjà un bon taux de réussite sur ce type de tâches ; passer à Hydrogen ne ferait que doubler la facture.
- Activités sensibles au prix et capables de tolérer une nouvelle tentative occasionnelle : jusqu’au 31 décembre 2026, Flash est le modèle le moins cher à l’unité parmi ces quatre modèles.
Quand choisir Gemini 4 Hydrogen
- Génération et débogage de code : Google souligne sa capacité à effectuer des modifications précises, sans toucher au code sans rapport, ce qui convient aux tâches comme corriger des bugs, mettre à jour des dépendances ou exécuter des tests.
- Exécution d’un agent en plusieurs étapes : appels d’outils en chaîne, recherche parallèle, ajustement de stratégie après l’échec d’un outil : c’est là son terrain de prédilection.
- Traitement de documents complexes : prend en charge divers formats comme PDF, Word, Excel et PPT ; une seule requête peut contenir jusqu’à 3000 images ou documents.
- Rôle d’exécutant dans un système multi-modèles : Carbon ou Argon se charge de la planification, Hydrogen de l’exécution concrète et de la validation.
Quand choisir Argon ou Carbon
Google positionne Argon et Carbon sur des tâches de raisonnement approfondi, complexes et longues ; les documents de référence ne précisent pas de différence plus fine entre les deux. Selon la répartition des rôles proposée dans cet article, Argon convient aux travaux complexes qui demandent un raisonnement assez poussé tout en accordant une certaine importance à l’efficacité ; Carbon convient à la conception d’architecture, au raisonnement très exigeant et aux projets d’ingénierie de longue durée. Le processus Antigravity Orchestrator présenté par Google illustre cette répartition : Carbon analyse le dépôt et élabore un plan, Hydrogen réalise les modifications et les tests, puis repasse à Carbon en cas d’erreur complexe. Google indique que cette approche réduit en moyenne de 24 % la consommation de quota par rapport à l’utilisation de Carbon seul, tout en accélérant la réalisation des tâches de 19 %.
| Type de tâche | Modèle prioritaire | Considérations de coût | Plateformes disponibles |
|---|---|---|---|
| Classification, extraction, résumé et autres tâches par lots | 3.8 Flash | Prix unitaire le plus bas, taux de réussite déjà suffisant | Google officiel, APIYI apiyi.com |
| Programmation quotidienne, correction de bugs | 4 Hydrogen | Le gain de taux de réussite compense un prix unitaire deux fois plus élevé | Google officiel, APIYI |
| Agent multi-étapes, appels d’outils | 4 Hydrogen | Moins de nouvelles tentatives et d’étapes d’exécution | Google officiel, APIYI |
| Raisonnement complexe avec priorité à l’efficacité | 4 Argon | Prix unitaire doublé après le 1er décembre | Google officiel, APIYI |
| Conception d’architecture, ingénierie de longue durée | 4 Carbon | À associer à Hydrogen pour répartir l’exécution | Google officiel, APIYI |
La disponibilité réelle des modèles sur APIYI est celle indiquée dans la liste des modèles de la plateforme.
Recommandations de décision après l’ajustement tarifaire de Gemini 4 Hydrogen
Comment les deux paliers de tarification modifient le choix du modèle
| Période | Flash | Hydrogen | Argon / Carbon | Choix du modèle |
|---|---|---|---|---|
| Du 2026-11-13 au 11-30 | $0.75 / $3.75 | $1.50 / $7.50 | $2 / $10 | Écart de prix réduit entre Hydrogen et Argon/Carbon |
| Du 2026-12-01 au 12-31 | $0.75 / $3.75 | $1.50 / $7.50 | $4 / $20 | Argon/Carbon atteint 2.67 fois le prix de Hydrogen |
| À partir du 2027-01-01 | $1.50 / $7.50 | $1.50 / $7.50 | $4 / $20 | Flash perd son avantage tarifaire et rejoint Hydrogen |
Ce tableau met en évidence deux points clés pour la planification. À court terme, en novembre, Argon/Carbon ne coûte qu’environ un tiers de plus que Hydrogen : les tâches nécessitant une réflexion approfondie peuvent être concentrées sur cette période. À moyen terme, à partir de janvier prochain, Flash et Hydrogen auront le même prix unitaire ; Hydrogen, plus performant, deviendra l’option par défaut la plus raisonnable dans la plupart des cas, à condition que Google ne publie pas de nouvelle grille tarifaire entre-temps.
Vérifications de compatibilité avant de migrer vers Hydrogen
Lors d’une migration de 3.8 Flash vers Hydrogen, les configurations suivantes ne peuvent pas être reprises telles quelles, sous peine d’erreurs ou de dérive des coûts :
- Les niveaux
thinking_budgetetMINIMALne sont plus pris en charge ; les utiliser renvoie une erreur HTTP 400. - Le niveau de réflexion par défaut passe de Medium à High ; il faut évaluer activement s’il convient de le réduire.
- Les valeurs personnalisées de temperature, top_p et top_k sont ignorées.
- La mise en cache explicite n’est pas prise en charge : il faut s’appuyer sur le cache implicite et placer le contenu fixe au début de l’invite.
- Les appels d’outils à plusieurs tours doivent correctement sauvegarder et renvoyer les thought signatures.
💡 Conseil de choix : ne basculez pas tout d’un coup en vous fiant au nom du modèle. Je recommande de diviser le trafic par type de tâche et de mesurer séparément le coût de chaque succès. Avec l’interface unifiée d’APIYI apiyi.com, il suffit de modifier le paramètre
modelpour faire une comparaison A/B entre les quatre modèles, ce qui facilite la définition d’une stratégie de routage basée sur les données.
FAQ — Questions fréquentes
Q1 : Quel est le positionnement du modèle Gemini 4 Hydrogen ?
Hydrogen est un modèle publié par Google DeepMind le 12 novembre 2026, dont l’ID API est `gemini-4-hydrogen`, et qui se positionne sur le codage quotidien et l’exécution d’agents IA à haute efficacité. La fiche officielle du modèle indique qu’il est adapté à partir de Gemini 4 Carbon. La fenêtre de contexte totale est de 1 048 576 Tokens, l’entrée, la réflexion et la sortie partageant ce même quota.
Q2 : Combien coûte Gemini 4 Hydrogen de plus que 3.8 Flash ?
D’après les tarifs standards de l’API Google Gemini au 13 novembre 2026, les prix d’entrée et de sortie de Hydrogen sont tous deux le double de ceux de 3.8 Flash (1,50 $ / 7,50 $ contre 0,75 $ / 3,75 $). Avec la charge d’exemple de cet article, le coût mensuel est respectivement de 27 $ et 13,50 $.
Q3 : Quand les prix d’Argon et Carbon augmentent-ils ?
La page tarifaire officielle précise qu’Argon et Carbon passent de 2 $ / 10 $ à 4 $ / 20 $ à compter du 1er décembre 2026. 3.8 Flash passe à 1,50 $ / 7,50 $ à partir du 1er janvier 2027. Hydrogen n’a pour l’instant aucun calendrier public d’ajustement progressif des tarifs.
Q4 : Quel niveau de réflexion est le plus rentable pour Hydrogen ?
La recommandation officielle est : Low pour la classification, Medium pour le codage courant, High pour les agents multi-étapes, XHigh pour le raisonnement complexe et approfondi. Les données d’Artificial Analysis montrent que XHigh ne dépasse High que de 3 points sur l’indice d’intelligence (54 contre 51), alors que le coût moyen par tâche de référence grimpe de 1,87 $ à 3,16 $. Dans la plupart des cas, il n’est donc pas conseillé d’activer XHigh par défaut.
Q5 : Comment comparer rapidement le coût réel des quatre modèles Gemini ?
La solution la plus simple consiste à passer par une interface d’agrégation multi-modèles :
1. Créez un compte sur APIYI apiyi.com pour obtenir une clé API et un quota d’essai gratuit ;
2. Remplacez le base_url dans le code de cet article par `https://api.apiyi.com/v1` ;
3. Lancez le script de comparaison avec vos propres échantillons de tâches réelles et calculez le coût de chaque exécution réussie.
Q6 : Quelles sont les faiblesses connues de Hydrogen ?
La fiche officielle du modèle mentionne plusieurs problèmes : il peut encore produire des hallucinations ; ses connaissances s’arrêtent en mars 2026 ; par rapport à 3.8 Flash, l’indicateur de refus injustifié s’est dégradé de 5,57 points de pourcentage ; le rapport de sécurité complet n’était pas encore publié au moment de la vérification. Au début du lancement, des utilisateurs ont aussi signalé la disparition de l’option du modèle et des échecs d’appel, et certains ont mentionné sur Hacker News un comportement excessif dans certaines tâches d’agent.
Q7 : Comment les équipes en Chine peuvent-elles tester la sélection de modèles Gemini de manière stable ?
Google adopte une stratégie de déploiement progressif : la disponibilité peut varier selon les régions et les comptes. Pour les équipes qui doivent comparer en même temps Gemini, Claude, GPT et d’autres modèles, APIYI apiyi.com permet un accès unifié via une interface compatible OpenAI, avec facturation à l’usage, sans avoir à réécrire le script de test pour chaque fournisseur.
Points clés de la comparaison des prix de Gemini 4 Hydrogen
- Prix doublé : le prix unitaire standard actuel de Hydrogen est 2 fois celui de 3.8 Flash. Il s’agit donc d’une hausse, pas d’une baisse.
- Position intermédiaire : Hydrogen reste moins cher qu’Argon et Carbon, mais après décembre l’écart passera à 2,67 fois.
- Seuil de rentabilité : il faudrait que le nombre de tokens soit divisé par deux, ou que le taux de réussite par tentative double, pour que le coût de Hydrogen rejoigne celui de Flash.
- Variables de facturation : les tokens de réflexion, le cache implicite, le mode Batch et le nombre de recherches modifient sensiblement le coût réel.
- Dates de changement tarifaire : le 2026-12-01, Argon et Carbon augmentent ; le 2027-01-01, Flash et Hydrogen passent au même prix.
- Comment vérifier : mesurez le coût par réussite sur de vrais échantillons. L’interface unifiée d’APIYI permet de comparer les quatre modèles.
En résumé
Voici les points essentiels pour choisir entre Gemini 4 Hydrogen, 3.8 Flash, Argon et Carbon :
- Regarder le prix unitaire : en novembre, Flash est le moins cher, Hydrogen coûte le double, Argon et Carbon sont encore plus chers — et leurs tarifs doubleront le 1er décembre.
- Regarder le coût par réussite : pour les tâches simples, continuez avec Flash ; pour le code et les agents, là où Flash échoue facilement, évaluez Hydrogen ; le raisonnement approfondi revient à Argon ou Carbon, et l’exécution à Hydrogen.
- Regarder le calendrier : la planification budgétaire doit intégrer les deux dates de changement tarifaire. À partir de 2027, Hydrogen deviendra très probablement le choix par défaut en matière de rapport qualité-prix.
Ce choix est au fond un arbitrage entre le coût et la valeur de la tâche. Le prix unitaire se consulte directement ; le taux de réussite, lui, ne peut se mesurer qu’avec vos propres données. Je recommande de commencer par une campagne de comparaison sur de vraies tâches avec le quota gratuit d’APIYI apiyi.com, puis de définir la stratégie de routage des modèles à partir des résultats.
📚 Références
- Blog officiel de Google – Introducing Gemini 4 Hydrogen : annonce de lancement et cas d’usage de partenaires
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Description : positionnement officiel et comparaison des performances avec Gemini 3.8 Flash
-
Tarification officielle de l’API Google Gemini : prix standards des quatre modèles et dates de révision tarifaire
- Lien :
aistudio.google.com/docs/pricing -
Description : source de tous les prix cités dans cet article, vérifiée le 2026-11-13
-
Fiche modèle de Google DeepMind : capacités, limites et évaluations de sécurité de Hydrogen
- Lien :
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Description : données d’évaluation croisée entre modèles et limites connues
-
Documentation technique de Google Cloud : spécifications de l’API et points d’attention pour la migration
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Description : limites de la fenêtre de contexte, règles de mise en cache, compatibilité des paramètres
-
Tarification par région de Google Cloud : écart de prix entre Global et Non-global
- Lien :
cloud.google.com/model-garden/pricing -
Description : référence des tarifs régionaux de la plateforme cloud d’entreprise
-
Artificial Analysis : évaluation indépendante des quatre niveaux de réflexion de Hydrogen
- Lien :
artificialanalysis.ai/models/gemini-4-hydrogen -
Description : indice d’intelligence, durée d’exécution et coût des tâches de référence pour chaque niveau
-
Blog Google Antigravity : orchestration multi-modèles avec Orchestrator
- Lien :
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity - Description : données officielles sur la répartition des rôles et la collaboration entre Carbon et Hydrogen
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com