Kimi K3.1 Pro et sa version Highspeed offrent les mêmes capacités. La seule différence de Highspeed, c’est la vitesse : selon le fabricant, le modèle est 2 à 3 fois plus rapide. En contrepartie, les tarifs doublent pratiquement dans toutes les catégories. Seul le tarif en cas de succès du cache reste inchangé : 0,20 $ pour les deux versions. En pratique, choisissez Highspeed si vous attendez le résultat devant votre écran, et la version standard si vous lancez des tâches en lot en arrière-plan.
Cette conclusion repose sur trois éléments : le blog officiel de Moonshot précise que les deux modèles ont les « mêmes capacités » (« same capabilities »), la page officielle des tarifs présente cinq prix unitaires, et la documentation officielle de Kimi Code indique que Highspeed consomme environ deux fois plus de quota. Dans la suite, chaque fait est classé selon trois niveaux de source : « déclaration officielle », « source tierce » ou « non vérifié ». En l’absence de données, nous le signalons clairement plutôt que de présenter une estimation comme un résultat mesuré.
Cet article ne cherche pas à déterminer lequel des deux modèles est le plus intelligent. Puisqu’ils ont les mêmes capacités, la seule question est celle du rapport coût-bénéfice : payer deux fois plus pour obtenir un résultat de même qualité plus rapidement, est-ce que ça vaut le coup ?
Ce que vous trouverez dans cet article : un tableau des tarifs en cinq catégories, une méthode pour convertir le temps d’attente en coût, deux calculs que vous pouvez vérifier vous-même et un tableau de recommandations pour six types de situations.
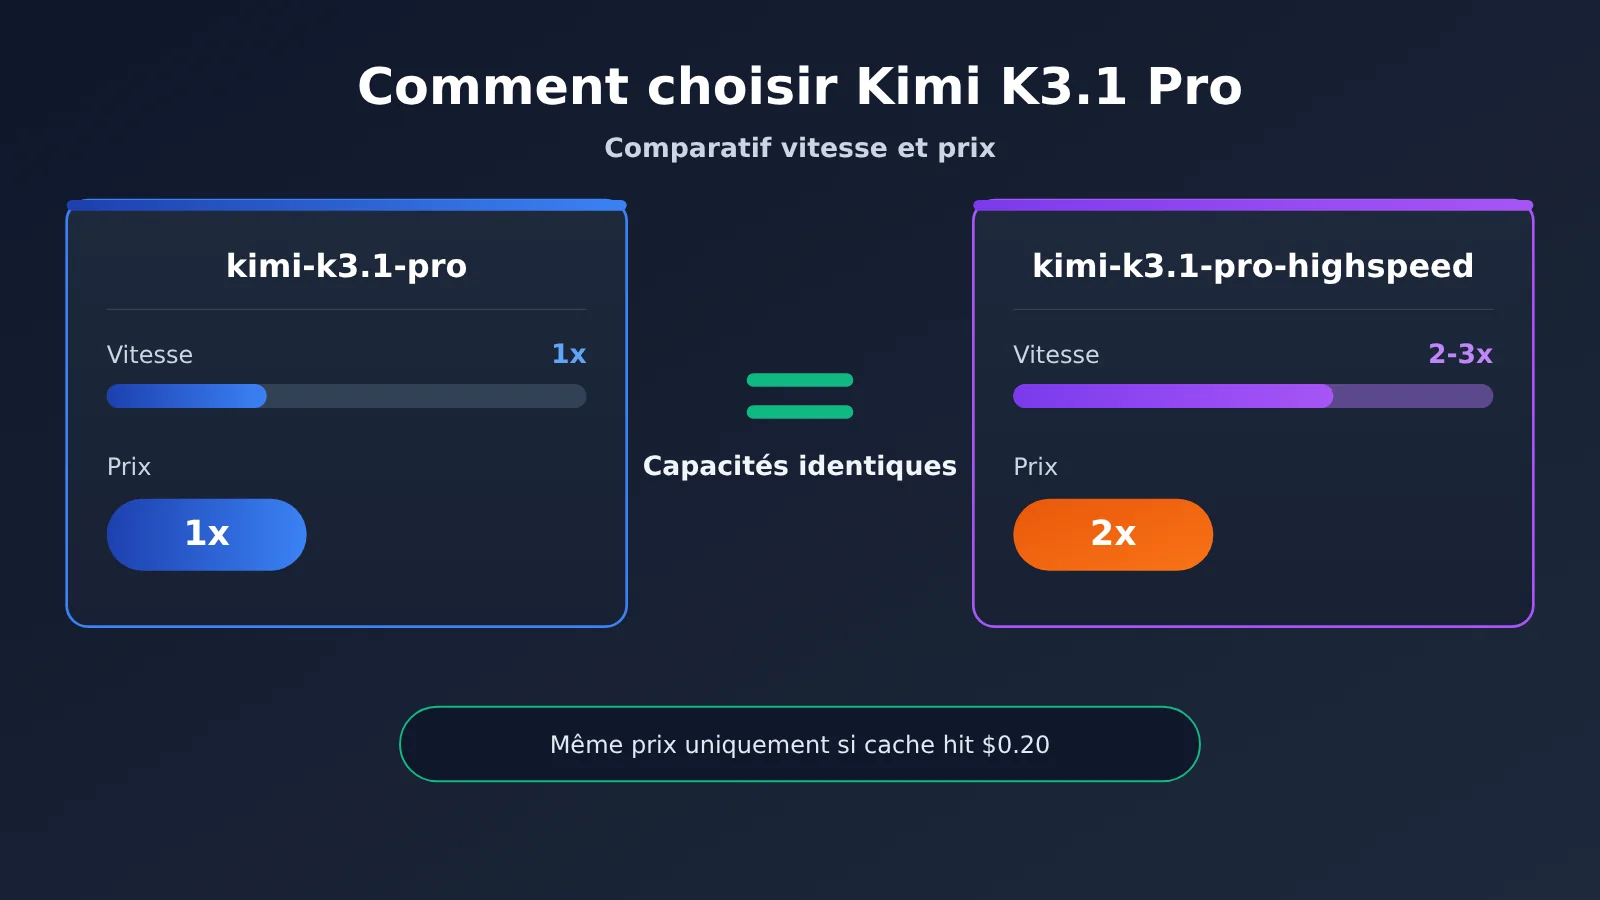
1. Principales différences entre Kimi K3.1 Pro et Highspeed : mêmes capacités, seule la vitesse et le prix changent
Commençons par une vue d’ensemble. Le tableau ci-dessous compare les deux modèles sur tous les critères disponibles et précise la source des informations dans la dernière colonne. La longueur du contexte correspond à la quantité totale de texte que le modèle peut « voir » en une seule fois, exprimée en tokens. Un token est l’unité de base utilisée pour la facturation et le calcul ; pour simplifier, on peut le voir comme un fragment de mot.
| Critère de comparaison | kimi-k3.1-pro (version standard) | kimi-k3.1-pro-highspeed | Niveau de la source |
|---|---|---|---|
| Capacités du modèle | Référence | Identiques à celles de la version standard | Déclaration officielle |
| Longueur du contexte | 1,048,576 tokens | 1,048,576 tokens | Déclaration officielle |
| Vitesse de génération | Référence | 2 à 3 fois plus rapide, selon l’annonce officielle | Déclaration officielle, sans données détaillées |
| Prix unitaire | Référence | Deux fois plus cher, sauf pour les requêtes avec cache | Tarifs officiels |
| Accès à Kimi Code | Abonnement Plus ou supérieur (contexte de 1 M de tokens : abonnement Pro ou supérieur) | Abonnement Pro ou supérieur | Documentation officielle |
| Consommation du quota Kimi Code | Référence | Environ deux fois plus élevée | Documentation officielle |
| Canaux officiels disponibles | kimi.ai, Kimi Work, Kimi Code, Kimi API | Identiques | Blog officiel |
La conclusion est simple : à part la vitesse, le prix et les conditions d’abonnement, les deux modèles ne présentent aucune autre différence. Se tromper de modèle ne change pas la qualité des résultats : cela vous coûtera simplement plus d’argent ou de temps.
1.1 Comparaison des tarifs de Kimi K3.1 Pro et Highspeed (les cinq postes)
Les tarifs ci-dessous ont été relevés le 2026-10-24. Ils sont exprimés en dollars par million de tokens, hors taxes, et proviennent de la grille tarifaire officielle. Quelques précisions sur la facturation : les « entrées » correspondent au contenu que vous envoyez au modèle, et les « sorties » à celui qu’il génère. Le « cache » permet à la plateforme de conserver un préfixe identique d’une requête à l’autre, par exemple le code d’un projet que vous incluez régulièrement. Lorsqu’un préfixe déjà enregistré est réutilisé, on parle de « cache hit » et le tarif appliqué est réduit. La première mise en cache est facturée au tarif d’écriture, selon une durée de conservation de 5 minutes ou d’une heure.
| Poste de facturation | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | Multiplicateur |
|---|---|---|---|
| Entrée (cache non touché) | $2.00 | $4.00 | 2× |
| Sortie | $10.00 | $20.00 | 2× |
| Entrée avec cache hit | $0.20 | $0.20 | Identique, le seul poste sans hausse |
| Écriture du cache (5 minutes) | $2.00 | $4.00 | 2× |
| Écriture du cache (1 heure) | $4.00 | $8.00 | 2× |
Les données publiques du développeur indépendant Simon Willison confirment également ce point : Highspeed coûte deux fois plus cher, mais le tarif des entrées avec cache hit reste le même que celui de la version standard. Ce détail pèsera dans les calculs qui suivent. Si la plupart des entrées de vos requêtes bénéficient d’un cache hit, le coût total réel de Highspeed sera inférieur au double, car la part la plus importante des entrées n’est pas majorée.
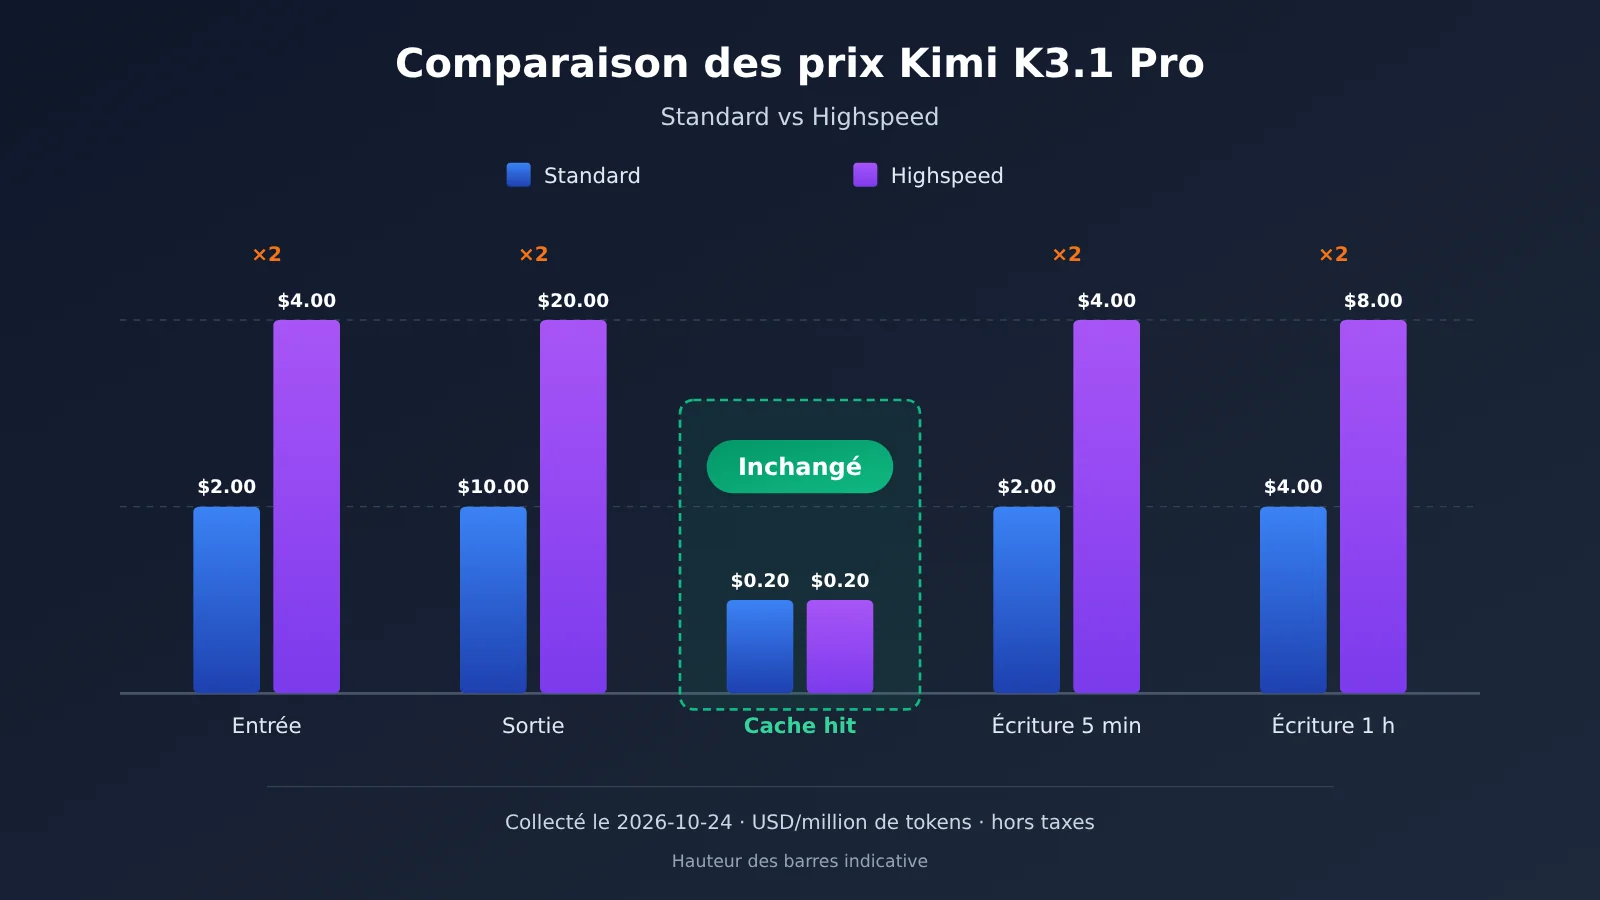
Précision sur les tarifs : le graphique et le tableau ci-dessus reprennent les tarifs officiels. Si vous passez par APIYI apiyi.com, les noms et les tarifs des modèles sur la plateforme sont ceux indiqués dans la liste des modèles. Ces deux modèles sont en cours d’intégration ; nous les proposerons dès que possible.
2. Quelle est la différence de vitesse entre Kimi K3.1 Pro et Highspeed ?
Soyons honnêtes : il existe très peu de données de vitesse à ce jour. La seule indication officielle est une fourchette de multiplicateurs. Les tests tiers ne portent que sur la version standard, et aucun benchmark public n’a mesuré le nombre précis de tokens par seconde de Highspeed. Les tokens par seconde indiquent combien de tokens le modèle peut générer en une seconde : plus cette valeur est élevée, moins il faut attendre la fin de la réponse.
| Donnée | Valeur | Niveau de fiabilité de la source | Remarques |
|---|---|---|---|
| Vitesse de Highspeed par rapport à la version standard | 2 à 3 fois celle de la version standard | Déclaration officielle | Conditions de test et données détaillées non publiées |
| Vitesse de génération de la version standard | 80,7 tokens/seconde | Source tierce (Artificial Analysis) | Niveau 2 sur une échelle de quatre |
| Vitesse de génération de Highspeed | Aucune donnée | Non vérifiée | Aucun test tiers réalisé séparément à ce jour |
| Volume moyen généré par tâche pour la version standard | Environ 55 K tokens | Source tierce (Artificial Analysis) | Correspond aux tâches de test de son Intelligence Index |
| Coût par tâche pour la version standard | Environ 1,98 $ (2,11 $ sur la page du modèle) | Source tierce (Artificial Analysis) | Idem |
La question « combien de tokens par seconde pour Highspeed ? » n’a donc pas de réponse fiable pour le moment. Les articles qui avancent un chiffre précis s’appuient soit sur leurs propres mesures — dont il faut examiner les conditions de test —, soit sur une estimation obtenue en multipliant 80,7 par 2 ou 3. Nous ne reprendrons pas ce genre de chiffre : voici plutôt une méthode d’évaluation qui ne dépend pas de données de benchmark.
2.1 Comment choisir entre les versions de Kimi K3.1 Pro : convertir le temps d’attente en coût
La vitesse n’a de valeur que si elle réduit le temps d’attente de quelqu’un. Si personne n’attend, gagner en vitesse n’a aucune importance. Voici une méthode en quatre étapes :
- Estimez le temps d’attente par requête : nombre de tokens générés ÷ vitesse. Avec la version standard à 80,7 tokens/seconde et une sortie de 1 500 tokens, le contenu visible prend environ 19 secondes à générer. Attention : les deux versions activent toujours le mode de réflexion, qui prend lui aussi du temps. L’attente réelle sera donc plus longue, selon la tâche.
- Estimez le temps que Highspeed peut vous faire gagner : d’après le multiplicateur officiel de 2 à 3, il faudrait attendre environ 6 à 10 secondes pour une sortie de même longueur, soit un gain d’environ 10 secondes par requête. Il s’agit d’une estimation, pas d’une mesure : vérifiez-la avec vos propres requêtes.
- Multipliez par le nombre de requêtes et le coût horaire : avec 100 interactions par jour et un gain de 10 secondes à chaque fois, vous économisez environ 17 minutes. Multipliez ces 17 minutes par le coût de votre temps ou de celui de votre équipe.
- Comparez avec le surcoût : utilisez la méthode de la section 3 pour calculer combien Highspeed coûte en plus par jour. Si la valeur du temps gagné dépasse ce surcoût, le choix en vaut la peine.
Attention à une erreur fréquente : une vitesse multipliée par trois ne signifie pas que la productivité est multipliée par trois. La génération du modèle ne représente qu’une étape du processus. Le temps passé à lire le code, réfléchir, apporter des modifications et lancer des tests ne diminue pas pour autant. Seules les quelques secondes d’attente du modèle sont économisées. À l’étape 3, basez donc votre calcul sur le temps d’attente réel, sans multiplier directement votre production.
3. Deux calculs de coûts : Kimi K3.1 Pro et Highspeed
Les deux calculs ci-dessous sont basés sur les tarifs officiels. Toutes les étapes sont détaillées : vous pouvez refaire les calculs avec votre propre nombre de tokens.
3.1 Scénario A : 20 modifications de code interactives
Hypothèses : chaque requête contient 30 000 tokens en entrée, dont 25 000 tokens de contexte du dépôt transmis à répétition et 5 000 tokens de nouveau contenu. Chaque réponse contient 1 500 tokens. Les 20 requêtes sont espacées de moins de 5 minutes, le cache reste donc actif.
Version standard :
- Première requête : entrée
30000 × $2 / 100万 = $0.06, dont 25 000 tokens sont mis en cache. Cette partie coûte25000 × $2 / 100万 = $0.05 - À chaque requête suivante, les tokens provenant du cache sont facturés au tarif de
25000 × $0.2 / 100万 = $0.005 - Nouveau contenu par requête :
5000 × $2 / 100万 = $0.01 - Sortie par requête :
1500 × $10 / 100万 = $0.015 - Total par requête :
$0.005 + $0.01 + $0.015 = $0.03
Highspeed :
- Le tarif des tokens provenant du cache ne change pas :
$0.005 - Le nouveau contenu coûte deux fois plus cher :
5000 × $4 / 100万 = $0.02 - La sortie coûte deux fois plus cher :
1500 × $20 / 100万 = $0.03 - Total par requête :
$0.005 + $0.02 + $0.03 = $0.055, soit environ $0.06
En ajoutant le coût ponctuel de la mise en cache lors de la première requête, les 20 requêtes reviennent à environ $0.66 avec la version standard et $1.26 avec Highspeed. Si l’on compare strictement le coût par requête, Highspeed revient à environ 1,8 fois le prix de la version standard, et non tout à fait au double, car les tokens provenant du cache ne coûtent pas plus cher.
Conclusion : c’est environ deux fois plus cher, mais le temps d’attente est réduit de plus de moitié, selon le facteur annoncé officiellement. Les quelque $0.6 supplémentaires achètent quelques minutes d’attente en moins sur les 20 requêtes. Pour la plupart des développeurs, ça vaut le coup.
3.2 Scénario B : 1 000 traitements par lots hors ligne
Hypothèses : chaque requête contient 8 000 tokens en entrée et 600 tokens en sortie. Le traitement porte sur 1 000 requêtes sans préfixe réutilisable : le cache ne sert donc à rien.
- Coût unitaire avec la version standard :
(8000 × $2 + 600 × $10) / 100万 = $0.016 + $0.006 = $0.022, soit$22pour 1 000 requêtes - Coût unitaire avec Highspeed :
(8000 × $4 + 600 × $20) / 100万 = $0.032 + $0.012 = $0.044, soit$44pour 1 000 requêtes
Conclusion : c’est une perte sèche. Personne n’attend le résultat de chaque requête, et la durée totale d’exécution dépend généralement du niveau de parallélisme et de la file d’attente. Les $22 supplémentaires n’apportent aucun avantage perceptible.
| Poste de calcul | Scénario A : modifications de code interactives | Scénario B : traitement par lots hors ligne |
|---|---|---|
| Nombre de requêtes | 20 | 1 000 |
| Le cache peut-il être utilisé ? | Oui, 25 000 tokens réutilisés | Non |
| Coût total avec la version standard | Environ $0.66 | $22 |
| Coût total avec Highspeed | Environ $1.26 | $44 |
| Multiplicateur de prix réel | Environ 1,8 à 1,9 fois | 2 fois |
| Quelqu’un attend-il le résultat ? | Oui | Non |
| Conclusion | Deux fois plus cher, mais plus de la moitié du temps d’attente en moins : ça vaut le coup | Perte sèche : choisissez la version standard |
4. Choisir Kimi K3.1 Pro ou Highspeed selon le cas d’usage
Appliquez les critères ci-dessus aux situations courantes pour obtenir directement le tableau suivant. La décision repose sur deux questions : quelqu’un attend-il le résultat ? Peut-on profiter du cache ?
| Situation | Recommandation | Pourquoi |
|---|---|---|
| Programmation interactive | Highspeed | Quelqu’un attend devant l’écran que les modifications soient faites. Le contexte du dépôt peut être récupéré depuis le cache, et le surcoût réel reste inférieur à 2×. |
| Agent conversationnel | Highspeed | Les requêtes courtes s’enchaînent sur plusieurs tours, avec des appels d’outils. L’attente à chaque tour finit par se faire nettement sentir. |
| Démonstrations et diffusions en direct | Highspeed | Le public suit la démonstration. Des réponses lentes nuisent directement au déroulement de la présentation, et l’écart de coût sur quelques dizaines d’appels est négligeable. |
| Nettoyage de données par lots | Version standard | Personne n’attend le résultat d’une requête en particulier. La vitesse n’apporte pas de valeur supplémentaire : le doublement du prix ne fait qu’augmenter les coûts. |
| Évaluation hors ligne | Version standard | L’évaluation porte uniquement sur la qualité des résultats. Les deux versions ont les mêmes capacités, et la vitesse n’influe pas sur la note. |
| Tâches planifiées | Version standard | Les tâches s’exécutent la nuit ou en arrière-plan. Les terminer quelques minutes plus tôt ne change rien, et le coût est un critère important. |
Si un produit couvre ces deux types de situations, vous pouvez aussi combiner les versions : utilisez kimi-k3.1-pro-highspeed pour les requêtes des utilisateurs en interaction directe, et kimi-k3.1-pro pour les résumés, l’archivage et les traitements par lots en arrière-plan. Les deux modèles ont les mêmes capacités ; changer de nom de modèle ne nécessite pas de modifier l’invite.
5. Le troisième levier pour accélérer Kimi K3.1 Pro : reasoning_effort et le quota Kimi Code
Avant de payer plus, il vaut la peine d’essayer une option gratuite pour gagner en vitesse. Les deux modèles réfléchissent toujours avant de répondre, en effectuant un raisonnement interne. La durée de cette réflexion est contrôlée par le paramètre reasoning_effort, que l’on peut comprendre comme le niveau de profondeur demandé au modèle. Plus le niveau est bas, moins il réfléchit longtemps et plus vite il donne sa réponse. Voici ce qu’indique la documentation officielle :
reasoning_effortpropose trois niveaux :low,highetmax. La valeur par défaut estmax.- Pour obtenir des réponses plus rapides, vous pouvez d’abord essayer de régler la version standard sur
low. Si la vitesse vous convient et que la qualité reste acceptable, inutile de payer le double pour Highspeed. - Réduire le niveau de raisonnement peut diminuer la profondeur d’analyse pour les tâches complexes : vous échangez de la qualité contre de la vitesse. Highspeed, en revanche, permet d’aller plus vite sans toucher à la qualité, mais coûte plus cher. Les deux options ont donc des contreparties différentes.
- Vous pouvez aussi les combiner : Highspeed avec
lowconvient aux situations où la latence est particulièrement importante et où les tâches ne sont pas trop complexes.
Un autre point facile à manquer concerne Kimi Code. Cet outil de programmation de Moonshot fonctionne avec un quota d’utilisation lié à l’abonnement. Voici ce que précise la documentation officielle de Kimi Code :
k3.1-pronécessite un abonnement Plus ou supérieur. Pour utiliser une fenêtre de contexte de 1M, il faut un abonnement Pro ou supérieur.k3.1-pro-highspeednécessite un abonnement Pro ou supérieur.- La version Highspeed consomme environ deux fois plus de quota. À abonnement égal, elle permet donc de réaliser environ deux fois moins de tâches.
Pour les appels API, veillez également à omettre les paramètres suivants dans vos requêtes, comme l’exige la documentation officielle. Ne les transmettez pas manuellement :
temperatureest fixé à1.0top_pest fixé à0.95nest fixé à1presence_penaltyetfrequency_penaltysont fixés à0max_completion_tokensvaut131072par défaut et peut atteindre1048576
6. En dehors de l’offre officielle, comment utiliser Kimi K3.1 Pro plus facilement : l’intégrer avec APIYI
L’API officielle est compatible avec les formats OpenAI et Anthropic, notamment les interfaces Chat Completions, Responses et Messages. « Compatible avec OpenAI » signifie que vous pouvez généralement réutiliser votre code existant avec le SDK OpenAI : il suffit de modifier l’adresse et la clé API, puis de changer le nom du modèle.
Les développeurs en Chine peuvent utiliser APIYI, sur apiyi.com, pour appeler plusieurs modèles avec une seule clé API et payer à l’usage. Les nouveaux utilisateurs disposent d’un crédit d’essai gratuit. Voici comment procéder :
- Format OpenAI : définissez
base_urlsurhttps://api.apiyi.com/v1 - Format Anthropic : définissez l’adresse de base sur
https://api.apiyi.com - Pour
model, indiquez le nom correspondant dans la liste des modèles de la plateforme.
À noter : lors de notre vérification du 24 octobre 2026, la liste des modèles d’APIYI comprenait déjà plusieurs modèles de la série Kimi, dont kimi-k2.5, kimi-k2.6, kimi-k2.7-code et kimi-k3. En revanche, kimi-k3.1-pro et kimi-k3.1-pro-highspeed n’étaient pas encore disponibles. Leurs noms et leurs tarifs sur la plateforme seront indiqués dans la liste des modèles. Nous proposerons ce modèle dès que possible. En attendant, vous pouvez tester le parcours d’appel et votre stratégie de cache avec les modèles Kimi déjà disponibles. Une fois le modèle publié, il vous suffira d’en modifier le nom.
7. Conseils pour choisir entre Kimi K3.1 Pro et Highspeed
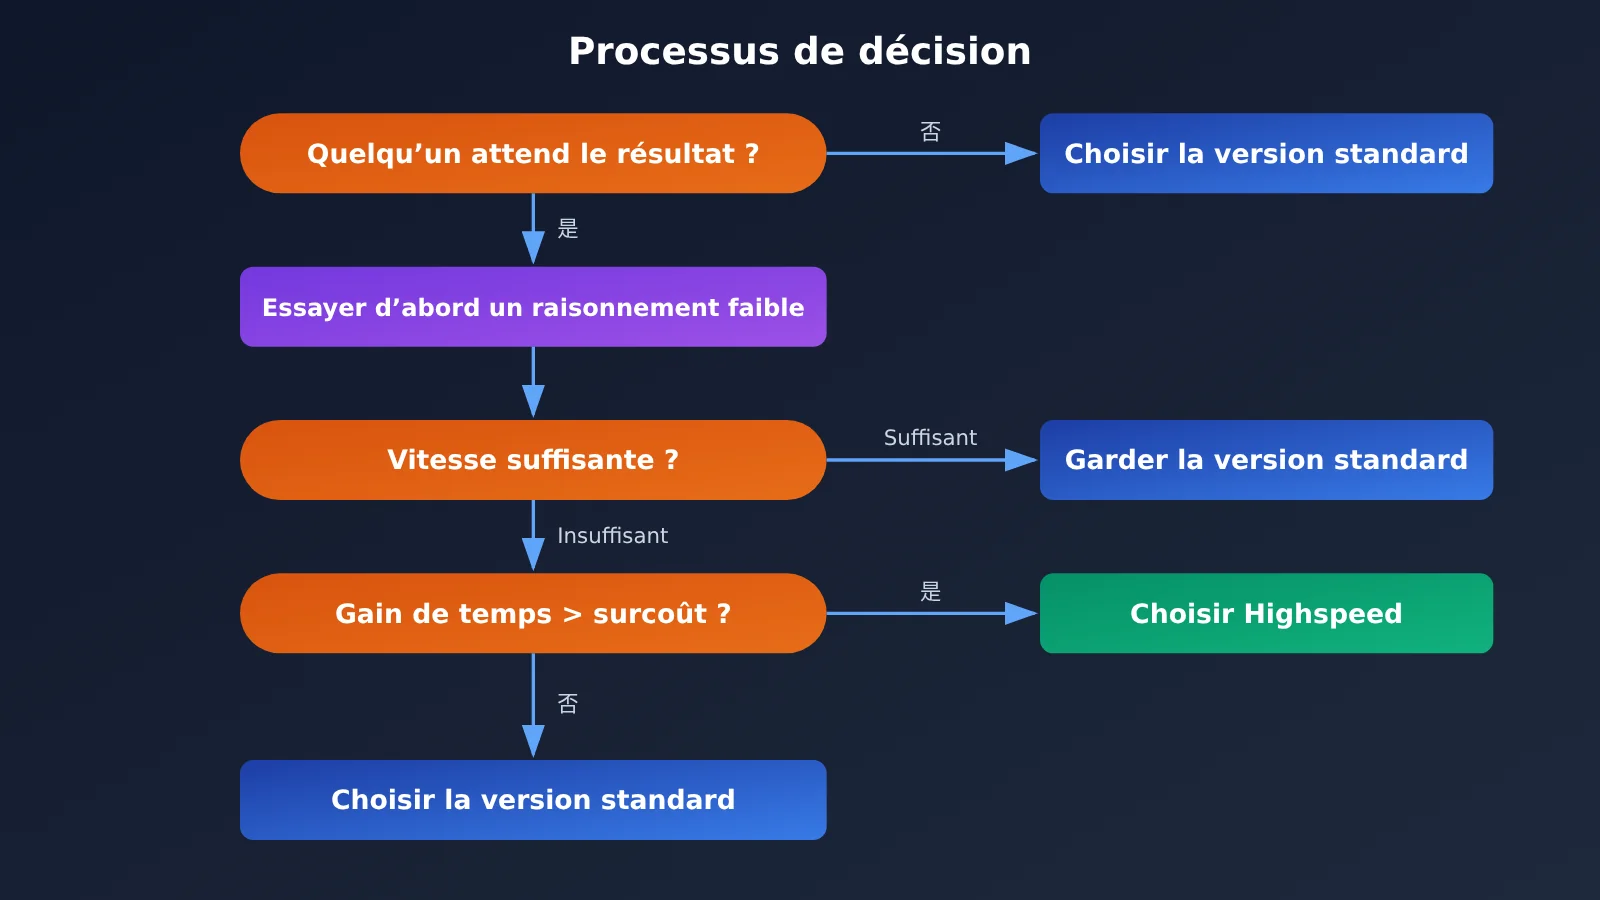
Notre conseil : commencez par vous demander si quelqu’un attend le résultat. Si personne n’attend, choisissez la version standard. Si quelqu’un attend, réduisez d’abord
reasoning_effortàlowpour voir si cela suffit. Si le modèle reste trop lent, passez à Highspeed. Pour savoir si le changement en vaut la peine, convertissez le temps d’attente économisé en coût, selon la méthode de la section 2, puis comparez-le à l’écart de prix calculé dans la section 3. Nous vous conseillons de réaliser quelques tests avec vos propres requêtes sur APIYI, apiyi.com. Les modèles disponibles et leurs tarifs pour la gamme K3.1 Pro seront indiqués dans la liste des modèles de la plateforme dès leur lancement. Nous proposerons ce modèle dès que possible.
Quelques principes faciles à appliquer :
- Utilisez la version standard par défaut et réservez Highspeed aux cas où vous en avez besoin, plutôt que d’en faire votre configuration par défaut.
- Plus vous réutilisez les préfixes, plus Highspeed est intéressant, car le tarif des requêtes servies depuis le cache ne double pas.
- Si votre équipe utilise les deux versions, répartissez les requêtes selon leur point d’entrée : Highspeed pour les interactions en temps réel, la version standard pour les tâches en arrière-plan.
- Dans Kimi Code, tenez compte de votre quota si vous utilisez Highspeed : ce modèle consomme environ deux fois plus de quota.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que Kimi K3.1 Pro Highspeed ?
C’est une version rapide lancée en même temps que Moonshot et Kimi K3.1 Pro, sous le nom de modèle `kimi-k3.1-pro-highspeed`. Selon l’annonce officielle, elle est 2 à 3 fois plus rapide que K3.1 Pro, avec les mêmes capacités et une fenêtre de contexte de 1 048 576 tokens.
Q2 : La version Highspeed est-elle moins performante que la version standard, ou meilleure ?
D’après les informations officielles, les deux versions ont les mêmes capacités. La version plus rapide n’est donc pas moins intelligente, et la version plus chère n’est pas plus intelligente. La qualité des réponses dépend surtout du niveau de `reasoning_effort`, et non de la version choisie.
Q3 : De combien la version Highspeed est-elle plus rapide ? Existe-t-il des chiffres précis en tokens par seconde ?
L’annonce officielle indique seulement une vitesse multipliée par « 2 à 3 », sans publier de données détaillées. Le site tiers Artificial Analysis a mesuré une vitesse de génération de 80,7 tokens par seconde pour la version standard, mais n’a pas testé séparément la version Highspeed. Sa vitesse exacte n’est donc pas vérifiée à ce jour. Le mieux est de la mesurer avec vos propres requêtes.
Q4 : Pourquoi la version Highspeed ne coûte-t-elle pas forcément exactement deux fois plus cher ?
Parce que le tarif des entrées avec cache est de 0,20 $ par million de tokens pour les deux versions. Si une grande partie des entrées correspond à un préfixe répété et peut être récupérée depuis le cache, elle n’entraîne aucun surcoût. Le coût total est donc multiplié par moins de 2. Dans le scénario A de cet article, une requête revient à environ 1,8 fois le prix de la version standard.
Q5 : Comment utiliser Kimi K3.1 Pro et Highspeed depuis la Chine continentale ?
Vous pouvez utiliser l’API officielle de Kimi, ou passer par l’interface compatible avec OpenAI d’APIYI, sur apiyi.com. Il suffit de remplacer `base_url` par `https://api.apiyi.com/v1`. Les noms des modèles et leurs tarifs sur APIYI sont ceux indiqués dans la liste des modèles de la plateforme. L’intégration est en cours ; nous proposerons ce modèle dès que possible.
Q6 : Quelles sont les limites connues de la gamme Kimi K3.1 Pro ?
– Les deux modèles activent toujours le mode réflexion. Il est impossible de désactiver complètement le raisonnement ; seul le niveau de `reasoning_effort` peut être ajusté.
– Des paramètres comme `temperature` et `top_p` sont définis à l’avance et doivent être omis des requêtes. Il est donc impossible de contrôler le style en ajustant les paramètres d’échantillonnage.
– Dans Kimi Code, la version Highspeed nécessite un abonnement Pro ou supérieur et consomme environ deux fois plus de quota.
– L’annonce officielle indique que les poids complets seront publiés avant le 4 novembre 2026. Ils ne sont pas encore disponibles.
Kimi K3.1 Pro ou Highspeed : points à retenir
- Performances identiques : Highspeed apporte uniquement plus de vitesse, pas de meilleures réponses.
- Prix doublés : le prix des entrées, des sorties et des deux niveaux d’écriture du cache est multiplié par deux. Seul le prix des requêtes servies depuis le cache reste identique, à 0,20 $.
- Peu de données sur la vitesse : le fabricant annonce une vitesse 2 à 3 fois supérieure, mais les tests indépendants n’ont mesuré que la version standard, à 80,7 tokens/s.
- Tenez compte du temps d’attente : convertissez le temps d’attente en coût, puis comparez-le au surcoût. Ne confondez pas vitesse multipliée par deux et efficacité multipliée par deux.
- Choisissez la version rapide pour les interactions : Highspeed convient à la programmation interactive, aux agents conversationnels et aux démonstrations en direct.
- Choisissez la version standard pour les traitements par lots : pour le nettoyage de données en masse, les évaluations hors ligne et les tâches planifiées, Highspeed ne fait qu’augmenter la facture.
- Réduisez d’abord le niveau de raisonnement : régler
reasoning_effortsurlowest une option gratuite pour accélérer le traitement.
En résumé
Pour choisir entre Kimi K3.1 Pro et Highspeed, retenez trois points essentiels :
- Les deux versions ont les mêmes capacités : votre choix n’a aucun effet sur la qualité des réponses. La différence porte uniquement sur la vitesse, le prix et les conditions d’abonnement.
- Le surcoût a une exception : sur les cinq tarifs, quatre doublent. Le prix des requêtes servies depuis le cache ne change pas. Plus vous réutilisez les préfixes, moins Highspeed coûte réellement plus cher.
- La version rapide ne vaut le coup que si quelqu’un attend : pour les usages interactifs, Highspeed permet de réduire de plus de moitié le temps d’attente moyennant un prix environ deux fois plus élevé. Pour les traitements par lots, elle ne fait qu’augmenter la facture.
En pratique, commencez par tester la version standard avec reasoning_effort=low. Si la vitesse reste insuffisante, passez à Highspeed et vérifiez le coût à l’aide de la formule de la section 3, en utilisant votre propre nombre de tokens. Pour accéder à la série K3.1 Pro via APIYI (apiyi.com), consultez la liste des modèles de la plateforme pour connaître les références et les tarifs à jour. Nous proposerons ce modèle dès que possible.
Références
- Site officiel et blog de Kimi : annonce de lancement de K3.1 Pro et Highspeed, présentation de leurs capacités et des canaux de distribution
- Lien :
kimi.ai -
Remarque : source de l’affirmation officielle selon laquelle Highspeed est « 2 à 3 fois plus rapide, à capacités égales »
-
Artificial Analysis : mesures indépendantes de la vitesse et du coût des modèles
- Lien :
artificialanalysis.ai -
Remarque : source des données sur la version standard : 80,7 tokens/s, volume de sortie par tâche et coût
-
Blog de Simon Willison : compte rendu public d’un développeur
- Lien :
simonwillison.net -
Remarque : confirme que Highspeed coûte deux fois plus cher, tandis que le tarif des requêtes avec cache correspond à celui de la version standard
-
Liste des modèles APIYI : modèles disponibles sur la plateforme et tarifs
- Lien :
docs.apiyi.com/models - Remarque : disponibilité de la série Kimi sur la plateforme vérifiée le 24 octobre 2026
Auteur : équipe technique d’APIYI
Échanges techniques : pour consulter d’autres informations sur l’intégration, rendez-vous dans le centre de documentation sur docs.apiyi.com. Les modèles de la série Kimi K3.1 Pro disponibles sur la plateforme et leurs tarifs sont indiqués dans la liste des modèles. Nous proposerons ce modèle dès que possible.