Note de l’auteur : au 8 novembre 2026, Gemini 4 Flash n’a toujours pas d’identifiant de modèle officiel. Cet article examine les sources des indices liés aux noms de code Hydrogen et Hyperion, clarifie leurs rapports avec Gemini 4 Argon et Gemini 3.8 Flash, et propose une liste de points à vérifier pour choisir un modèle et se préparer avant la sortie.
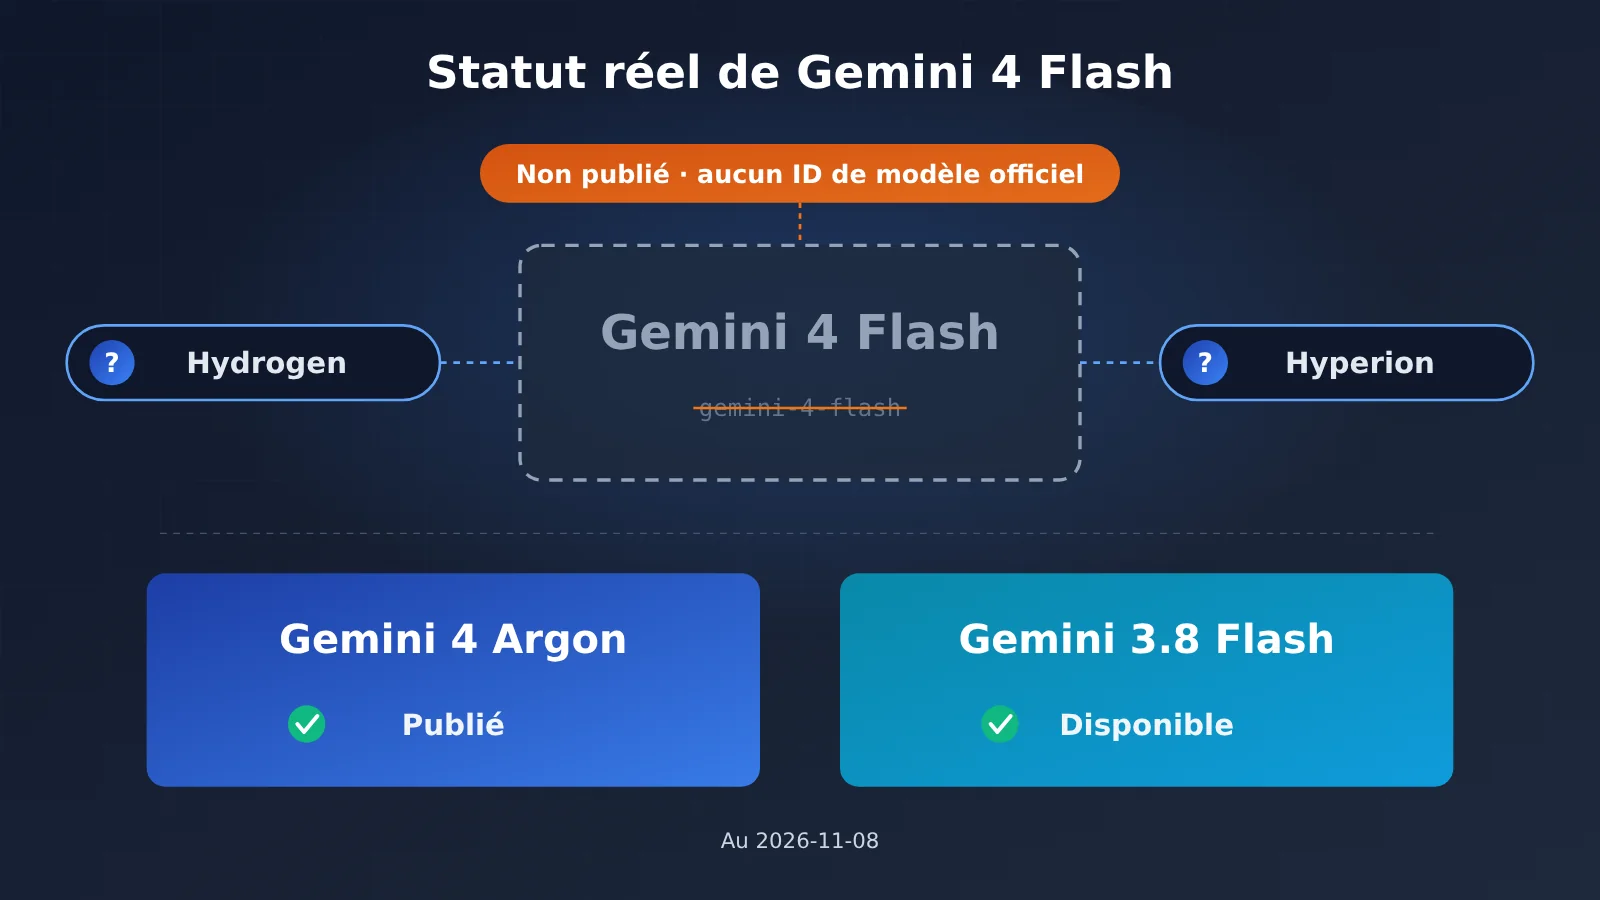
Commençons par la conclusion : Gemini 4 Flash n’est pas encore sorti. Au 8 novembre 2026, Google n’a annoncé aucun identifiant officiel pour Gemini 4 Flash. On ne trouve pas non plus gemini-4-flash dans la documentation de référence des modèles Gemini API, et aucune date de sortie officielle n’a été communiquée. Si votre équipe envisage de mettre son planning en pause parce que « Flash arrive la semaine prochaine », mieux vaut attendre.
À ce jour, deux modèles sont réellement disponibles. Si vous avez besoin des capacités d’un modèle phare et d’une longue fenêtre de contexte, utilisez gemini-4-argon. Si vous cherchez à gérer un grand nombre de requêtes simultanées, avec une faible latence et des coûts maîtrisés, utilisez Gemini 3.8 Flash. Les noms de code Hydrogen et Hyperion méritent qu’on les surveille, mais pour l’instant, ce ne sont que des indices issus de fuites, pas des signes de sortie imminente.
Il ne s’agit pas de dénigrer le nouveau modèle. Nous distinguons simplement les faits confirmés, les indices issus de fuites et les simples rumeurs, pour vous aider à planifier sur la base d’informations vérifiables.
L’essentiel : en 3 minutes, faites le point sur la situation réelle de Gemini 4 Flash et découvrez ce que vous pouvez utiliser dès maintenant et ce qu’il faut préparer avant sa sortie.
Gemini 4 Flash est-il sorti ? Fixons d’abord un critère clair
Avant de discuter des rumeurs autour d’un modèle, mieux vaut que toute l’équipe s’accorde sur ce que signifie « sorti ». Sinon, le chef de produit voit une fuite, l’ingénieur une capture d’écran, et chacun tire sa propre conclusion. Nous recommandons de ne prendre en compte que les canaux officiels de Google et d’exiger que plusieurs conditions soient réunies.
| Critère | Condition précise | Statut actuel de Gemini 4 Flash |
|---|---|---|
| ID officiel du modèle | Présent sur la page de référence des modèles dans la documentation de l’API Gemini | ❌ Absent : seul gemini-4-argon apparaît |
| Page des tarifs | Prix du modèle indiqué sur la page des tarifs de l’API Gemini | ❌ Absent |
| Disponible dans AI Studio | Sélectionnable directement dans la liste déroulante des modèles d’AI Studio | ❌ Aucune option officielle |
| Annonce officielle | Publiée sur le blog officiel ou par un compte officiel de Google | ❌ Aucune |
La règle est simple : les trois premiers critères doivent être remplis simultanément pour considérer que le modèle est « sorti ». Une annonce officielle est un plus, mais sans ID de modèle ni tarif, les développeurs ne peuvent toujours pas l’intégrer en production. Selon ces critères, Gemini 4 Flash ne remplit aucune des quatre conditions : la conclusion est sans ambiguïté.
Cette grille a un autre avantage : elle peut être intégrée directement au processus d’adoption des modèles de l’équipe. Qu’il s’agisse d’un nouveau modèle Gemini, Claude ou d’un autre fournisseur, vous pouvez d’abord vérifier ces critères, puis décider s’il vaut la peine de consacrer des ressources à son évaluation.
💡 Conseil pratique : en plus de la documentation officielle, la liste des modèles disponibles auprès de votre fournisseur d’accès constitue un point de vérification utile. Chez APIYI apiyi.com, par exemple, la liste des modèles dans la console fait référence pour savoir si un modèle peut être appelé. Une rumeur, aussi populaire soit-elle, ne suffit pas à faire apparaître un modèle dans cette liste.
Gemini 4 Flash : faits, fuites et rumeurs
Classer les informations qui circulent selon leur fiabilité est plus efficace que de les débattre une par une. Ce tableau résume les éléments sur lesquels repose notre analyse :
| Information | Catégorie | Source | Peut-on s’y fier pour prendre une décision ? |
|---|---|---|---|
| Gemini 4 Flash n’est pas sorti et n’a pas d’identifiant de modèle officiel | Fait confirmé | Référence des modèles de l’API Gemini | ✅ Oui |
gemini-4-argon est sorti, avec une fenêtre de contexte de 1M et un accès API |
Fait confirmé | Documentation de l’API Gemini | ✅ Oui |
| Gemini 3.8 Flash est le modèle Flash le plus récent, sorti le 2 septembre 2026 | Fait confirmé | Annonce officielle de Google | ✅ Oui |
| Gemini 4 Flash porte le nom de code interne Hydrogen et compte cinq checkpoints | Indice issu d’une fuite | Révélation d’un compte sur X | ⚠️ À suivre uniquement |
| La vitesse de sortie de Hydrogen est de 300 à 500 tokens/s | Indice issu d’une fuite | Révélation d’un compte sur X | ⚠️ Ne peut pas servir à planifier les capacités |
| Tests A/B sur LMArena et AI Studio à partir de fin octobre | Indice issu d’une fuite | Révélation d’un compte sur X | ⚠️ À suivre uniquement |
| La famille de modèles Hyperion apparaît dans un build de Devin | Indice issu d’une fuite | Build de Devin de Cognition | ⚠️ Non confirmé par le fournisseur |
| « Hyperion est Gemini 4 Flash » | Pure spéculation | Hypothèse de la communauté | ❌ Non |
| « Gemini 4 Flash sortira à une date précise » | Pure rumeur | Aucune source officielle | ❌ Non |
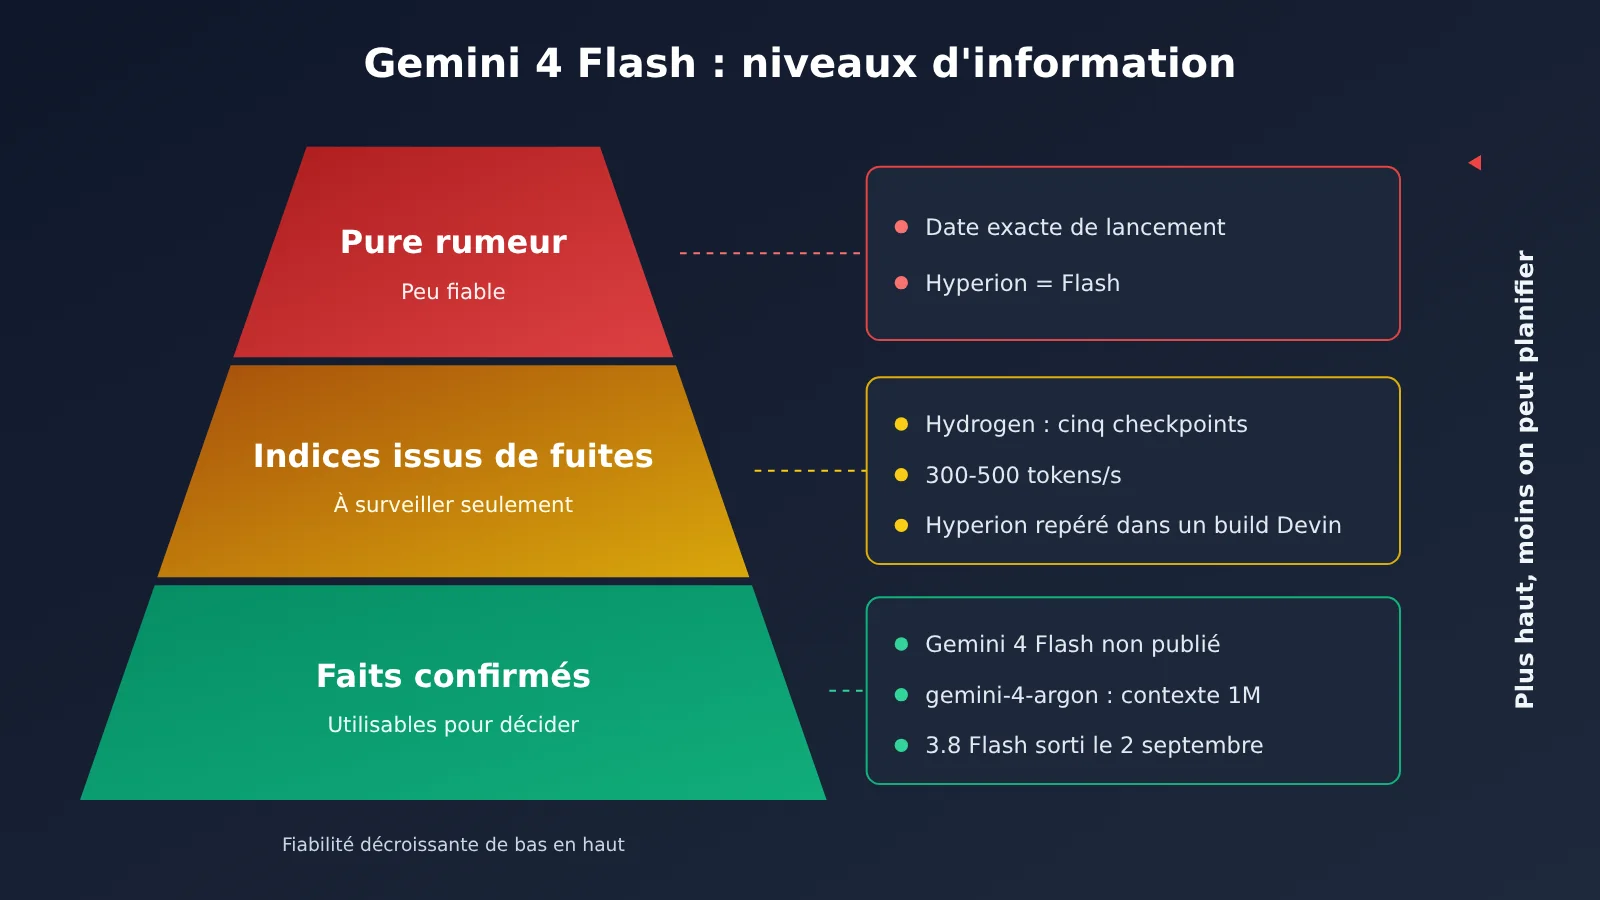
Gemini 4 Flash, nom de code Hydrogen : où en sont les informations divulguées ?
Hydrogen est actuellement le nom de code le plus étroitement associé à Gemini 4 Flash. Selon des informations divulguées sur X, Gemini 4 Flash porterait le nom de code interne Hydrogen et aurait déjà connu cinq checkpoints. Ces mêmes sources avancent une vitesse de génération de 300-500 tokens/s et indiquent que le modèle participe à des tests A/B sur LMArena et AI Studio depuis fin octobre.
Ces informations semblent précises, mais il faut garder leur origine à l’esprit. Toutes les affirmations concernant Hydrogen proviennent de comptes X, et non de la documentation officielle, du blog ou d’une fiche de modèle Google. Les cinq checkpoints indiqueraient que le modèle est « toujours en cours d’itération interne » : ce n’est pas une preuve qu’il est sur le point d’être finalisé.
Ce que les indices sur Hydrogen signifient pour les développeurs
Même en prenant toutes ces informations pour argent comptant, les conclusions restent très limitées. Les tests A/B signifient que le modèle pourrait apparaître anonymement sur des plateformes d’évaluation : les utilisateurs ne peuvent ni le sélectionner directement, ni obtenir un identifiant de modèle stable. La fourchette de 300-500 tokens/s est large et les conditions de test ne sont pas précisées. Elle ne permet donc pas d’estimer la latence de votre service ni sa capacité à traiter des requêtes simultanées.
Pour les développeurs, la lecture la plus utile est la suivante : Hydrogen suggère que Google travaille probablement sur un modèle de niveau Flash pour la famille Gemini 4, mais rien n’est encore établi concernant le calendrier, le prix ou les limites de ses capacités. Vous pouvez l’ajouter à votre liste de veille, mais pas en faire une dépendance dans votre planning.
- À faire : surveiller les pages de référence des modèles et de tarification de l’API Gemini, ainsi que les changements dans la liste déroulante des modèles d’AI Studio.
- À éviter : modifier à l’avance les délais d’expiration en production sur la base des 300-500 tokens/s, ou reporter le lancement d’une fonctionnalité en attendant Hydrogen.
Nom de code Hyperion : quel rapport avec Gemini 4 Argon ?
Hyperion ne vient pas de la même source que Hydrogen. Ce nom de famille de modèles est apparu dans un build de Devin, le produit de Cognition, où il figure dans une liste avant Gemini 4 Argon. C’est cette position qui a amené la communauté à se demander si Hyperion avait un lien avec la série Gemini 4.
Mais deux points sont à clarifier. D’abord, aucun fournisseur n’a confirmé ce qu’est Hyperion : il pourrait s’agir d’un modèle Google, mais aussi simplement d’un nom de code interne donné par Cognition à une version préliminaire. Ensuite, même si Hyperion était bien un modèle Google, rien ne prouve qu’il appartienne à la gamme Flash.
Pourquoi Hyperion n’est pas forcément Gemini 4 Flash
Dans les produits tiers, les noms des modèles ne correspondent pas toujours aux noms officiels des fournisseurs. Les développeurs d’outils donnent souvent des noms de code aux modèles en avant-première, que ce soit pour des tests internes, un déploiement progressif ou des raisons de confidentialité. Quant à l’ordre d’une liste, il peut simplement suivre l’alphabet, la date de mise en service ou des priorités internes : il ne permet pas de déduire les caractéristiques d’un modèle.
Ce que l’on peut dire d’Hyperion est donc très limité : une famille de modèles encore inconnue du public est apparue dans un build tiers, rien de plus. Rapprocher cet indice de Hydrogen pour conclure que « Gemini 4 Flash est déjà utilisé dans Devin », c’est tirer une conclusion abusive en combinant plusieurs indices.
Gemini 4 Argon et Gemini 3.8 Flash : les deux modèles disponibles aujourd’hui
En attendant l’arrivée de Gemini 4 Flash, ces deux modèles sont les principales options Gemini disponibles pour les développeurs. Leurs positionnements sont bien distincts : l’un privilégie les capacités, l’autre l’efficacité.
Gemini 4 Argon : le modèle phare déjà disponible de la famille Gemini 4
gemini-4-argon est le premier modèle phare de la famille Gemini 4 et, à ce jour, le seul modèle Gemini 4 dans la documentation de référence de l’API Gemini. Il dispose d’une fenêtre de contexte de 1M et est déjà accessible via l’API officielle. Il convient notamment à l’analyse de longs documents, à la compréhension de grandes bases de code, au raisonnement croisé sur plusieurs fichiers et aux tâches où la qualité de la réponse compte plus que la vitesse.
Argon et Gemini 4 Flash appartiennent à la même génération, mais occupent des segments différents. L’existence d’Argon ne signifie pas que Flash suivra bientôt : aucun calendrier de lancement officiel n’a été communiqué pour les deux modèles.
Gemini 3.8 Flash : le choix Flash le plus récent
Gemini 3.8 Flash est sorti le 2 septembre 2026 et constitue actuellement le modèle Flash le plus récent de Google. Il vise les tâches à forte concurrence, à faible latence ou sensibles aux coûts, comme la classification par lots, l’extraction d’informations, les premières réponses du service client, la complétion en temps réel et les appels légers à des outils par un agent.
Avant la sortie de Gemini 4 Flash, 3.8 Flash est le choix le plus réaliste dans cette catégorie. Plutôt que d’attendre la prochaine génération, mieux vaut mesurer dès maintenant ses performances et ses coûts : ces données serviront de référence pour évaluer Gemini 4 Flash par la suite.
| Modèle | ID du modèle officiel / statut | Caractéristiques principales | Cas d’usage | Plateformes disponibles |
|---|---|---|---|---|
| Gemini 4 Argon | gemini-4-argon, disponible |
Premier modèle phare Gemini 4, fenêtre de contexte de 1M | Long contexte, raisonnement complexe, réponses de haute qualité | API officielle Google, APIYI apiyi.com |
| Gemini 3.8 Flash | Disponible (2026-09-02) | Modèle Flash le plus récent, faible latence | Forte concurrence, réponse en temps réel, tâches sensibles aux coûts | API officielle Google, APIYI |
| Gemini 4 Flash | Aucun ID de modèle officiel | Non disponible | Impossible à planifier pour le moment | Se référer à la documentation officielle et à la liste de la console |
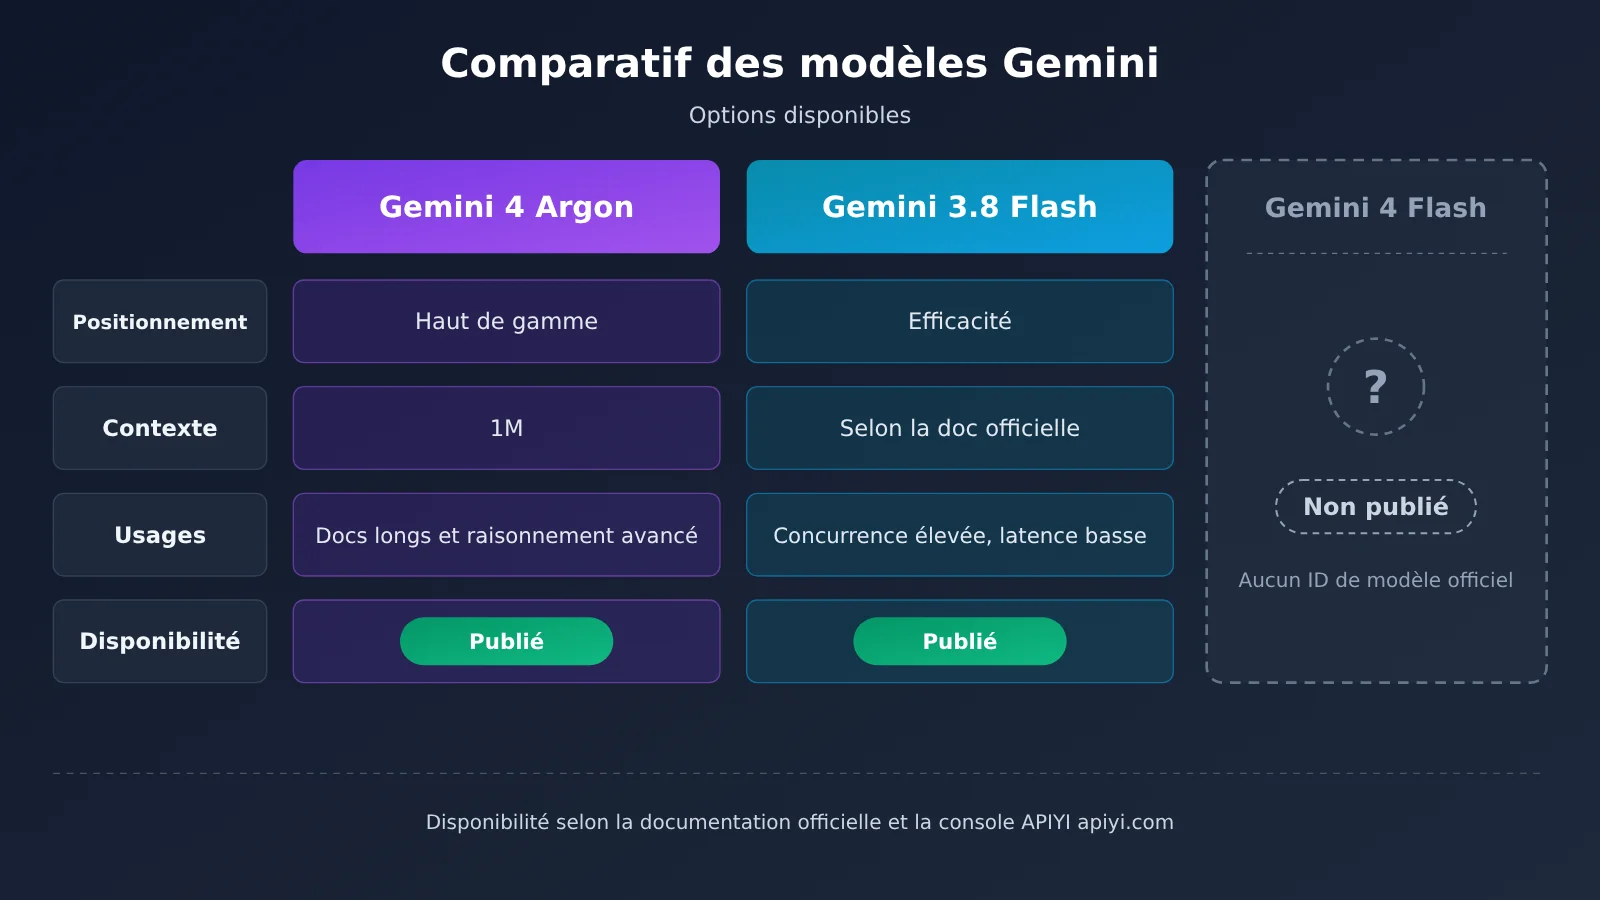
Quel modèle choisir avant la sortie de Gemini 4 Flash : combiner Argon et 3.8 Flash
La plupart des systèmes en production n’ont pas besoin de miser sur un seul modèle. Une approche plus prudente consiste à répartir les tâches par niveau, en confiant à Argon et à 3.8 Flash ce qu’ils font le mieux, puis à utiliser au besoin des modèles d’autres fournisseurs comme solution de repli ou point de comparaison.
- Les tâches complexes avec Argon : confiez à
gemini-4-argonles opérations sensibles à la qualité, comme la recherche dans de longs contextes, la synthèse de plusieurs documents ou la revue de code. - Les tâches fréquentes avec 3.8 Flash : confiez à Gemini 3.8 Flash les opérations appelées souvent et à faible valeur unitaire, comme la classification, l’extraction, la reformulation ou la reconnaissance d’intention.
- Le routage en cascade : utilisez d’abord 3.8 Flash, puis passez à Argon si le niveau de confiance est insuffisant ou si l’entrée est trop longue. Vous conciliez ainsi coût et qualité.
- La comparaison entre fournisseurs : conservez un modèle Claude ou OpenAI comme solution de rechange pour les parcours critiques, afin d’éviter que les variations d’un seul fournisseur perturbent votre activité.
Cette architecture par niveaux offre aussi un avantage moins évident : lorsque Gemini 4 Flash sera vraiment disponible, il suffira de remplacer le modèle de la « couche des tâches fréquentes » pour tester progressivement le nouveau modèle, avec un impact maîtrisé. À l’inverse, coder en dur toutes les invocations vers un seul modèle dès maintenant rendrait le changement plus coûteux.
🎯 Conseil : le plus compliqué avec une combinaison de modèles est de gérer plusieurs clés et systèmes de facturation. Avec APIYI apiyi.com, une seule clé API permet d’invoquer Gemini 4 Argon, Gemini 3.8 Flash, ainsi que des modèles Claude et OpenAI. L’interface est compatible avec le format OpenAI : il suffit de modifier le paramètre
modelpour changer de modèle, ce qui facilite le routage par niveaux décrit ci-dessus.
Préparer l’arrivée de Gemini 4 Flash : quatre chantiers techniques
Ne pas bouleverser son planning à cause de rumeurs ne veut pas dire rester les bras croisés. La bonne approche consiste à préparer l’intégration des nouveaux modèles en amont. Ainsi, quel que soit le jour où Gemini 4 Flash sera disponible, vous pourrez l’évaluer en quelques heures plutôt qu’en quelques semaines.
| Préparation | Actions concrètes | Avantages à la sortie du nouveau modèle |
|---|---|---|
| Jeu d’évaluation | Sélectionner des échantillons représentatifs issus de cas métier réels, puis fixer les entrées et les critères de notation | Évaluer le nouveau modèle dès sa sortie, sans se fier à ses impressions |
| Correspondance des modèles | Faire référence uniquement à des noms logiques dans le code métier, comme fast-tier, puis les associer aux ID des modèles dans la configuration |
Remplacer un modèle en modifiant uniquement la configuration, sans toucher au code métier |
| Référence de coûts | Consigner la consommation actuelle de tokens, le coût par requête et la distribution des latences pour Argon et 3.8 Flash | Déterminer si le nouveau modèle est réellement moins cher et plus rapide |
| Retour arrière et déploiement progressif | Basculer une proportion du trafic et conserver une option de retour en un clic vers l’ancien modèle | Limiter rapidement les conséquences si le nouveau modèle ne répond pas aux attentes |
Correspondance des modèles et jeu d’évaluation : changer de modèle par simple configuration
La correspondance des modèles est la plus facile à oublier des quatre préparations, mais aussi l’une des plus utiles à mettre en place à l’avance. Maintenez dans votre centre de configuration une table « niveau logique → ID du modèle » : par exemple, quality-tier correspond à gemini-4-argon et fast-tier à Gemini 3.8 Flash. Si votre couche d’intégration utilise APIYI, tous les modèles partagent la même base_url : https://api.apiyi.com/v1. Il suffit alors de maintenir les noms des modèles dans la table, sans gérer une adresse et une clé distinctes pour chacun.
Pour le jeu d’évaluation, prévoyez trois types d’échantillons : des requêtes typiques, des cas rares et difficiles, et des cas qui ont déjà posé problème. Le nombre d’échantillons n’a pas besoin d’être élevé : l’essentiel est de les fixer et de pouvoir les réutiliser. Dès que Gemini 4 Flash disposera d’un ID de modèle officiel, vous pourrez exécuter le même jeu d’évaluation et le comparer directement à 3.8 Flash.
Référence de coûts et journaux d’utilisation : remplacer les suppositions par des données
Une référence de coûts doit s’appuyer sur des données d’invocation réelles, et non sur le tarif affiché sur le site officiel multiplié par un volume estimé. Pendant au moins une semaine à un mois, suivez la consommation de tokens et le nombre de requêtes par modèle et par activité, tout en enregistrant les latences P50 et P95. Si le nouveau modèle promet d’être « plus rapide et moins cher », vous pourrez ainsi le vérifier avec les données de votre propre activité.
📊 Conseil pour les données : APIYI, sur apiyi.com, propose une facturation et des journaux d’utilisation unifiés. Les enregistrements d’invocation des différents modèles sont regroupés au même endroit, ce qui facilite l’établissement d’une référence de coûts pour Argon et 3.8 Flash. Consultez la console et la documentation pour connaître les prix et les disponibilités.
Questions fréquentes sur Gemini 4 Flash
Q1 : Peut-on déjà utiliser Gemini 4 Flash ?
Non. Au 8 novembre 2026, Google n’a pas publié Gemini 4 Flash : l’identifiant de modèle `gemini-4-flash` n’apparaît pas dans la documentation de Gemini API et aucune date officielle n’a été annoncée. Le seul modèle Gemini 4 actuellement disponible est `gemini-4-argon`.
Q2 : Hydrogen et Hyperion sont-ils le même modèle ?
Rien ne permet de l’affirmer. Hydrogen provient d’une rumeur publiée sur un compte X au sujet du nom de code interne de Gemini 4 Flash. Hyperion apparaît dans une version de Devin de Cognition, mais son éditeur ne l’a pas confirmé : il pourrait s’agir d’un modèle Google ou d’un nom de code donné par Cognition à une version préliminaire. Ces deux noms ont des sources différentes : il ne faut ni les associer ni les considérer comme des informations officielles.
Q3 : Faut-il attendre Gemini 4 Flash ou utiliser Gemini 3.8 Flash dès maintenant ?
Utilisez Gemini 3.8 Flash dès maintenant. C’est le modèle Flash le plus récent et il convient aux tâches nécessitant un grand nombre de requêtes simultanées, une faible latence ou une maîtrise des coûts. Les évaluations et les données de coût recueillies aujourd’hui serviront de référence pour évaluer Gemini 4 Flash plus tard. Avec APIYI apiyi.com, vous pouvez invoquer 3.8 Flash et Argon avec la même clé API, ce qui facilite la mise en place d’une approche à plusieurs niveaux.
Q4 : Comment vérifier dès sa sortie que Gemini 4 Flash est disponible ?
Vérifiez les critères précis présentés dans cet article : un identifiant de modèle officiel dans la documentation de Gemini API, un tarif sur la page des prix et la possibilité de sélectionner le modèle dans AI Studio. Il faut que les trois conditions soient réunies pour considérer le modèle comme publié. Pour savoir s’il est accessible via APIYI apiyi.com, consultez la liste des modèles dans la console. Une fois le modèle affiché, validez son fonctionnement avec votre jeu d’évaluation préparé à l’avance.
Gemini 4 Flash : points clés et liste de vérification des rumeurs
À retenir :
- Statut de lancement : au 8 novembre, Gemini 4 Flash n’est pas sorti. Aucun ID de modèle ni aucune date n’ont été officiellement annoncés.
- Hydrogen : ce nom de code interne a été révélé par un compte X. Les cinq checkpoints et le débit de 300-500 tokens/s n’ont pas été confirmés officiellement.
- Hyperion : apparu dans une version de Devin, avant Argon, ce nom n’a pas été confirmé par le fournisseur. Rien ne permet d’en déduire qu’il s’agit de Flash.
- Gemini 4 Argon : premier modèle phare de Gemini 4 à être sorti, il dispose d’une fenêtre de contexte de 1M et est accessible par API.
- Gemini 3.8 Flash : sorti le 2 septembre 2026, c’est actuellement l’option de la catégorie Flash la plus réaliste.
- Conseil pratique : ne mettez pas votre planning en pause. Préparez dès maintenant un jeu d’évaluation, une correspondance entre les modèles, une base de référence des coûts et un mécanisme de retour arrière.
Liste de vérification des rumeurs sur Gemini 4 Flash
La prochaine fois que vous voyez passer une annonce indiquant que « Gemini 4 Flash est sorti », vérifiez chaque point de cette liste :
| Point à vérifier | Comment vérifier | Critère de validation |
|---|---|---|
| ID officiel du modèle | Consulter la page de référence des modèles dans la documentation Gemini API | Un ID de modèle Gemini 4 Flash explicite apparaît |
| Tarification | Consulter la page des tarifs de Gemini API | Les prix en entrée et en sortie sont indiqués |
| AI Studio | Ouvrir le sélecteur de modèles dans AI Studio | Le modèle peut être sélectionné directement, et ne fait pas seulement partie d’un test A/B anonyme |
| Annonce officielle | Consulter le blog ou les comptes officiels de Google | Un article de lancement officiel a été publié |
| Source de l’information | Remonter à la source initiale de l’annonce | Elle vient d’une source officielle, et non d’un compte X ou d’une version tierce |
| Correspondance du nom de code | Vérifier si une source officielle relie le nom de code au nom définitif | La correspondance est confirmée officiellement, et ne repose pas sur des suppositions de la communauté |
| Disponibilité | Vérifier la liste des modèles dans la console de votre plateforme | Le modèle figure dans la liste et peut être appelé |
Les trois premiers critères doivent être remplis simultanément pour considérer que le modèle est sorti. Les quatre suivants servent à évaluer la fiabilité de l’information. Tant que le premier critère n’est pas rempli, classez l’annonce dans la catégorie « à surveiller » plutôt que « pour décision », aussi précise soit-elle.
Résumé
L’état de Gemini 4 Flash se résume en trois points :
- Il n’est pas encore sorti : pas d’identifiant de modèle officiel, pas de tarif, pas de date. Hydrogen et Hyperion ne sont que des indices.
- Des alternatives sont déjà disponibles :
gemini-4-argonpour les usages haut de gamme et les longs contextes, Gemini 3.8 Flash pour les requêtes simultanées et la faible latence. - Mieux vaut se préparer qu’attendre : jeu d’évaluation, correspondance des modèles, référence de coûts, déploiement progressif et retour arrière. En les préparant à l’avance, vous pourrez basculer rapidement à la sortie du nouveau modèle.
Pour les équipes de développement et produit, le mieux est de poursuivre le planning actuel tout en industrialisant l’intégration des nouveaux modèles. Nous recommandons d’utiliser une seule clé sur APIYI apiyi.com pour tester dès maintenant la combinaison Argon et 3.8 Flash, puis d’établir une référence de coûts à partir des journaux d’utilisation. Une fois Gemini 4 Flash officiellement disponible, vous pourrez le comparer aux modèles existants dans le cadre d’un déploiement progressif.
Références
- Référence des modèles Gemini API : identifiants officiels et spécifications des fenêtres de contexte
- Lien :
ai.google.dev/gemini-api/docs/models -
Note : première source à consulter pour vérifier si Gemini 4 Flash est sorti
-
Page des tarifs Gemini API : tarifs officiels des modèles
- Lien :
ai.google.dev/gemini-api/docs/pricing -
Note : les tarifs des nouveaux modèles y sont publiés après leur sortie officielle
-
Google AI Studio : plateforme officielle pour essayer les modèles
- Lien :
aistudio.google.com - Note : permet de vérifier si le modèle peut être sélectionné
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI. Pour en savoir plus sur l’intégration des modèles, consultez le centre de documentation docs.apiyi.com.