Anmerkung des Autors: Bei gleicher Token-Last liegt der aktuelle Standardpreis von Gemini 4 Hydrogen beim Doppelten von 3.8 Flash. Bei der Auswahl unter den vier Gemini-Modellen zählt neben dem Stückpreis auch, was eine erfolgreich abgeschlossene Aufgabe jeweils kostet – und wann die offiziell bereits angekündigten Preisanpassungen greifen.
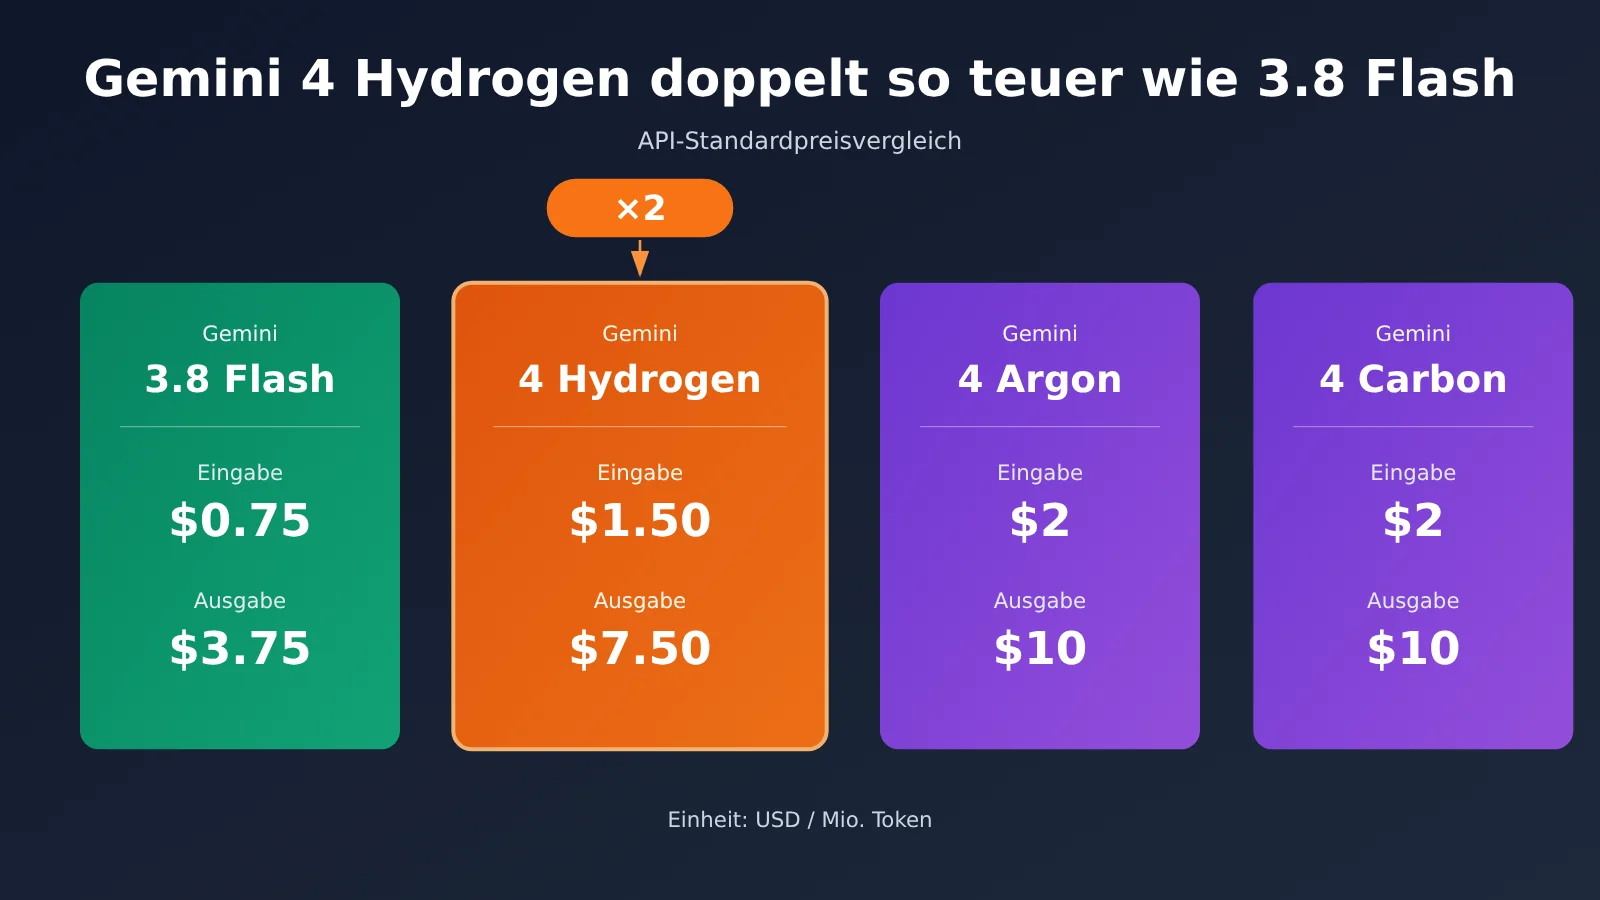
Google hat Gemini 4 Hydrogen am 12. November 2026 offiziell veröffentlicht. Viele Entwickler denken zuerst: „Eine neue Flash-Generation ist da, die müsste doch günstiger sein.“ Tatsächlich ist es genau umgekehrt: Nach den Standardpreisen der Google Gemini API kostet Hydrogen pro Million Token doppelt so viel wie 3.8 Flash – aber weniger als die Argon und Carbon aus derselben Reihe.
Das hier ist keine ausgewogene Analyse, bei der jedes Modell irgendwie seine Berechtigung hat. Wir verwenden durchgängig die Standardpreise der Google Gemini API (Stand der Prüfung: 13. November 2026, Angaben in US-Dollar pro Million Token), rechnen zuerst durch, was die vier Modelle bei gleichem Geschäftsvolumen jeweils kosten, leiten dann ab, unter welchen Bedingungen Hydrogen überhaupt ein guter Deal ist, und geben zum Schluss – mit Blick auf die Preisanpassungen zum 1. Dezember und zum 1. Januar des kommenden Jahres – eine direkt umsetzbare Empfehlung zur Auswahl.
Zusammenfassung in einem Satz: Der Token-Stückpreis von Hydrogen liegt derzeit beim Doppelten von 3.8 Flash. Ob sich ein Wechsel lohnt, hängt davon ab, ob es die gesamte abgerechnete Token-Menge halbieren oder die Erfolgsquote pro Versuch verdoppeln kann.
Fünf Begriffe, die Sie vor dem Lesen kennen sollten
Die folgenden Konzepte beeinflussen direkt, wie Sie den Preis von Gemini 4 Hydrogen einschätzen. Am besten gehen Sie sie kurz durch:
- Token: Die Maßeinheit, die das Modell bei der Verarbeitung von Text, Bildern und anderen Informationen verwendet. Die API rechnet Eingabe-Token und Ausgabe-Token getrennt ab.
- Denk-Token: Token, die beim Denkprozess des Modells verbraucht werden. Auf der offiziellen Google-Preisseite steht ausdrücklich, dass Denk-Token zum Ausgabepreis abgerechnet werden. Wenn Sie also nur die Länge der endgültigen Antwort zugrunde legen, fällt die Kostenschätzung zu niedrig aus.
- Implizites Caching: Die Plattform verwendet passende Eingabe-Präfixe automatisch wieder. Der Teil, der einen Cache-Treffer erzielt, wird zum Cache-Preis abgerechnet. Hydrogen unterstützt implizites Caching mit einem Mindestpräfix von 4096 Token; explizites Caching wird nicht unterstützt.
- Grounding: Dabei werden generierte Antworten mit abgerufenen externen Belegen verknüpft, etwa bei Google Search Grounding. Dieser Teil wird zusätzlich nach der Anzahl der Suchanfragen abgerechnet.
- API: Eine Schnittstelle, über die Programme einen Dienst aufrufen. Die Preise in diesem Artikel beziehen sich alle auf die Abrechnung beim Programmaufruf der API und nicht auf ein Gemini-App-Abo.
Die zentralen Preisunterschiede zwischen Gemini 4 Hydrogen, 3.8 Flash, Argon und Carbon
Wie die vier Gemini-Modelle nach dem Hydrogen-Release abgerechnet werden
Die folgende Tabelle zeigt die Standardpreise für Aufrufe der Google Gemini API. Die Preise stammen von der offiziellen Preisseite, Stand der Überprüfung: 13. November 2026.
| Modell | Aktueller Eingabepreis | Aktueller Ausgabepreis | Angekündigte Anpassung | Offizielle Positionierung |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | ab 2027-01-01 Anpassung auf $1.50 / $7.50 | Vorgängermodell mit hohem Preis-Leistungs-Verhältnis |
| Gemini 4 Hydrogen | $1.50 | $7.50 | derzeit keine öffentlich bekannte Staffelpreis-Anpassung | Alltägliches Programmieren und Agent-Ausführung |
| Gemini 4 Argon | $2.00 | $10.00 | ab 2026-12-01 Anpassung auf $4 / $20 | Komplexe, lang andauernde tiefe Inferenz |
| Gemini 4 Carbon | $2.00 | $10.00 | ab 2026-12-01 Anpassung auf $4 / $20 | Komplexe, lang andauernde tiefe Inferenz |
Alle Stückpreise sind in US-Dollar pro Million Token angegeben. Aus der Tabelle wird ersichtlich, dass Hydrogens Eingabe- und Ausgabepreis genau das Doppelte des aktuellen Preises von 3.8 Flash betragen. Für Nutzer, die von Flash umsteigen, bedeutet Hydrogen also eine Preiserhöhung – der Stückpreis wird nicht gesenkt.
In seiner Berichterstattung beschreibt Ars Technica Hydrogen als Modell, das die Flash-Reihe ablöst. Das kann leicht den Eindruck erwecken, sein Preis läge ebenfalls auf dem Flash-Niveau. Tatsächlich liegt sein Preis zwischen Flash und Argon/Carbon, also im mittleren Segment.
Weitere Abrechnungsmodelle für Hydrogen
Neben dem Standardaufruf gibt es bei Hydrogen noch mehrere Abrechnungsmodelle, die zu unterschiedlichen Latenzanforderungen passen:
- Batch (Stapelaufruf) / Flex: Eingabe $0.75, Ausgabe $3.75 – genau die Hälfte des Standardpreises.
- Priority (bevorzugter Aufruf): Eingabe $2.70, Ausgabe $13.50.
- Eingabe bei implizitem Cache-Treffer: beim Standardaufruf $0.075, bei Batch und Flex $0.0375.
- Kostenlose API-Stufe: kostenlos, aber mit Kontingentgrenzen. Laut offizieller Dokumentation können Inhalte der kostenlosen Stufe zur Verbesserung von Google-Produkten verwendet werden, und die kostenlose Stufe bietet kein kostenloses Anfragekontingent für Search Grounding.
Außerdem ist zu beachten, dass die Preise der Google Cloud Agent Platform zusätzlich nach Region variieren. In Nicht-Global-Regionen liegt der Standardpreis für Hydrogen bei $1.65 für die Eingabe und $8.25 für die Ausgabe – also 10 % über dem Global-Preis. Um eine einheitliche Vergleichsbasis zu gewährleisten, verwendet dieser Artikel durchgängig die Standardpreise der Google Gemini API und vermischt nicht die regionalen Angebote der Enterprise-Cloud-Plattform.
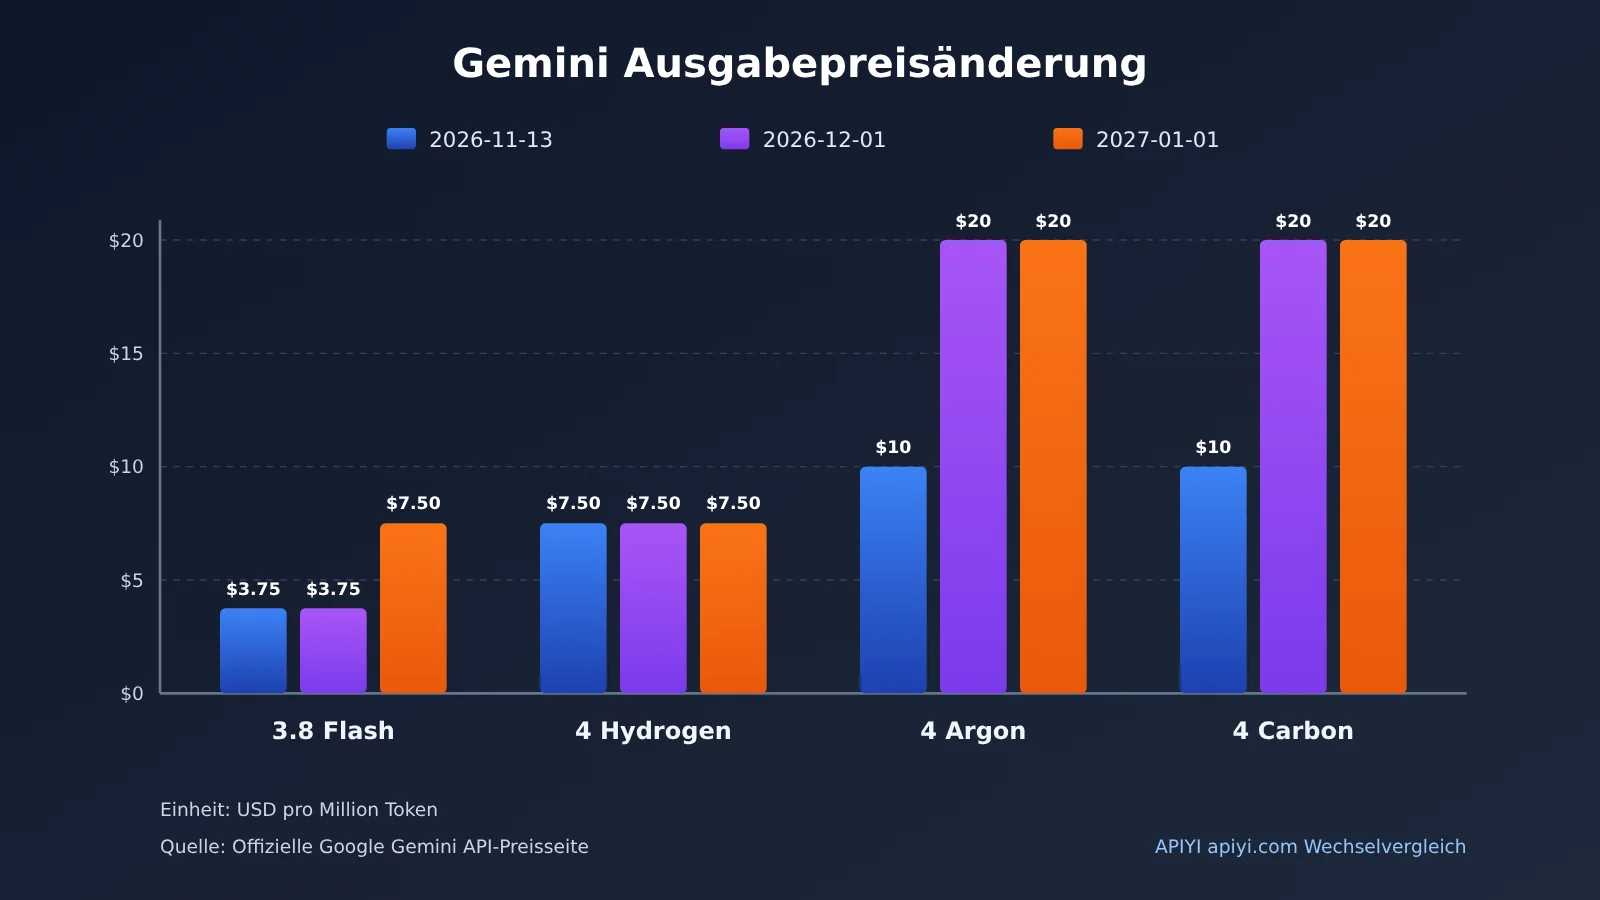
Monatlicher Kostenvergleich bei gleichem Geschäftsvolumen: Gemini 4 Hydrogen vs. 3.8 Flash
Monatsbudget anhand eines einheitlichen Beispiels
Der Preisunterschied pro Einheit schlägt sich am Ende in der Monatsrechnung nieder. Hier legen wir ein einheitliches Beispiel-Lastprofil zugrunde: 1.000 Aufrufe pro Monat, jeweils 8.000 Input-Token und 2.000 Output-Token (inkl. Denk-Token), berechnet mit den Standard-API-Preisen. Cache-Treffer, Tool-Gebühren und Wiederholungen lassen wir vorerst außen vor.
Die Berechnungsformel lautet:
Monatskosten = (Monatliche Input-Token × Input-Preis + Monatliche Output-Token × Output-Preis) ÷ 1,000,000
Monatlicher Input = 1,000 × 8,000 = 8,000,000 Token
Monatlicher Output = 1,000 × 2,000 = 2,000,000 Token
| Modell | Berechnung | Monatsbudget (Stand 2026-11-13) | Budget nach angekündigter Preisanpassung |
|---|---|---|---|
| 3.8 Flash | 8 × 0.75 + 2 × 3.75 | $13.50 | $27.00 (ab 2027-01-01) |
| 4 Hydrogen | 8 × 1.50 + 2 × 7.50 | $27.00 | $27.00 |
| 4 Argon | 8 × 2.00 + 2 × 10.00 | $36.00 | $72.00 (ab 2026-12-01) |
| 4 Carbon | 8 × 2.00 + 2 × 10.00 | $36.00 | $72.00 (ab 2026-12-01) |
Dies ist ein Szenario-Budget, das sich aus der offiziellen Preisliste ergibt – keine Messung des tatsächlichen Verbrauchs der Modelle. Aus der Tabelle lassen sich zwei Dinge ablesen: Im November kosten Hydrogen-Aufrufe tatsächlich doppelt so viel wie Flash; und nach den bereits veröffentlichten Terminen werden die Standardpreise von Flash zum 1. Januar 2027 auf das aktuelle Niveau von Hydrogen steigen.
Auswirkungen von Thinking-Token, Caching, Batch-Aufrufen und Suche auf die Gemini-Rechnung
Das obige Budget ist nur der Idealfall. Die tatsächliche Rechnung wird noch von vier Faktoren beeinflusst.
Erstens: Thinking-Token. Die standardmäßige Thinking-Stufe von Hydrogen ist High (bei 3.8 Flash ist Medium die Standardeinstellung). Thinking-Token werden zum Ausgabepreis abgerechnet. Wenn Sie direkt migrieren, ohne die Stufe anzupassen, steigen die Ausgabe-Token wahrscheinlich deutlich an. Eine unabhängige Auswertung von Artificial Analysis zeigt, dass die durchschnittlichen Kosten für Benchmark-Aufgaben bei Hydrogen in den vier Stufen Low, Medium, High und XHigh bei etwa $0.29, $0.80, $1.87 bzw. $3.16 liegen. Beachten Sie, dass dies die Daten aus standardisierten Benchmark-Aufgaben sind und nicht mit den Kosten einer einzelnen Nachricht in einer normalen Konversation gleichgesetzt werden können.
Zweitens: implizites Caching. Angenommen, von den 8.000 Eingabe-Token pro Aufruf sind 6.000 Token ein fester System-Prompt und ein Dokumentpräfix (über der Mindestschwelle von 4096 Token) und alle werden aus dem Cache bedient, dann betragen die Monatskosten für Hydrogen: 2 × 1.50 + 6 × 0.075 + 2 × 7.50 = $18.45 – rund ein Drittel weniger als $27. Dies ist eine auf Annahmen basierende Rechnung der Redaktion; die tatsächliche Cache-Trefferquote sollte anhand der Rechnung überprüft werden.
Drittens: Batch-Aufrufe. Bei Aufgaben, die keine Echtzeit-Antwort erfordern, etwa nächtliche Batch-Analysen, sinken die beispielhaften Monatskosten von Hydrogen durch die Umstellung auf Batch auf $13.50 und liegen damit auf dem Niveau des Flash-Standardpreises.
Viertens: Suchtools. In der kostenpflichtigen Stufe sind die ersten 5.000 Suchanfragen pro Monat bei Google Search Grounding kostenlos (das Kontingent wird mit Gemini 3 und neueren Modellen geteilt); darüber hinaus werden pro 1.000 Anfragen $14 berechnet, und eine einzelne Modellanfrage kann mehrere Suchvorgänge auslösen. Agenten-Anwendungen sollten diesen Posten separat überwachen.
🎯 Technische Empfehlung: Bei der Kostenbewertung empfiehlt es sich, dieselbe Gruppe realer Geschäftsbeispiele mit allen vier Modellen aufzurufen und jeweils das
usage-Feld zu protokollieren. Über APIYI apiyi.com können Sie mit einem einzigen API-Schlüssel und einer OpenAI-kompatiblen Schnittstelle zwischen verschiedenen Modellen wechseln, was den Aufwand für die Pflege mehrerer SDKs reduziert (die konkret verfügbaren Modelle richten sich nach der Modellliste der Plattform).
So vergleichen Sie die tatsächlichen Kosten von vier Gemini-Modellen mit Code
Minimales Aufrufbeispiel
Der folgende Code ruft Hydrogen über die OpenAI-kompatible Schnittstelle auf und gibt den Token-Verbrauch aus:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI einheitliche Schnittstelle
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用三句话解释隐式缓存"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # auf prompt_tokens und completion_tokens achten
Vollständige Implementierung ansehen: Kostenvergleich der vier Modelle für dieselbe Aufgabe
import openai

# Stückpreis: USD pro Million Token, Standardpreise der Google Gemini API, geprüft am 2026-11-13
PRICES = {
    "gemini-3.8-flash":  (0.75, 3.75),
    "gemini-4-hydrogen": (1.50, 7.50),
    "gemini-4-argon":    (2.00, 10.00),
    "gemini-4-carbon":   (2.00, 10.00),
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_once(model: str, prompt: str) -> dict:
    """Ruft das Modell einmal auf und gibt Verbrauch sowie die zu Standardpreisen geschätzten Kosten zurück"""
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p_in, p_out = PRICES[model]
    # completion_tokens enthält in der Regel bereits die Thinking-Token; maßgeblich sind die zurückgegebenen Felder
    cost = (u.prompt_tokens * p_in + u.completion_tokens * p_out) / 1_000_000
    return {
        "model": model,
        "input": u.prompt_tokens,
        "output": u.completion_tokens,
        "cost_usd": round(cost, 6),
        "text": resp.choices[0].message.content,
    }

def compare(prompt: str, check) -> None:
    """check: Funktion, die beurteilt, ob die Ausgabe die Aufgabe erfolgreich erledigt hat"""
    for model in PRICES:
        try:
            r = run_once(model, prompt)
            ok = check(r["text"])
            print(f'{r["model"]:20} in={r["input"]:6} out={r["output"]:6} '
                  f'cost=${r["cost_usd"]:.5f} success={ok}')
        except Exception as e:
            print(f"{model:20} error: {e}")

if __name__ == "__main__":
    compare(
        "写一个 Python 函数,解析 ISO8601 日期并处理时区,附带单元测试",
        check=lambda t: "def " in t and "assert" in t,
    )
Der Wert dieses Skripts liegt darin, dass es „hat es funktioniert?“ und „wie viel hat es gekostet?“ in derselben Auswertung zusammenführt. Aus dem reinen Stückpreis lässt sich keine Schlussfolgerung ziehen – erst wenn man jedes Modell einige Dutzend Mal laufen lässt und die durchschnittlichen Kosten pro erfolgreichem Lauf berechnet, entsteht eine belastbare Vergleichsbasis.
🚀 Schnellstart: Neue Nutzer können sich bei APIYI apiyi.com registrieren und ein kostenloses Testkontingent abholen, das obige Vergleichsskript mit den eigenen echten Eingabeaufforderungen durchlaufen und erst danach entscheiden, welches Modell in der Produktion eingesetzt wird.
Gemini 4 Hydrogen zum doppelten Preis: Wann es sich trotzdem lohnt
Vom Stückpreis zu den Kosten pro erfolgreich erledigter Aufgabe
Bei Aufgaben, die mehrere Schritte erfordern, sollte man tatsächlich die erwarteten Kosten pro erfolgreich abgeschlossener Aufgabe vergleichen:
Kosten pro Versuch C = (T_in × P_in + T_out × P_out) ÷ 10^6
Kosten pro Erfolg = C ÷ Erfolgsquote pro Versuch
Bei den Preisen von November 2026 kostet Hydrogen pro Token genau doppelt so viel wie Flash. Daraus lassen sich zwei Break-even-Bedingungen ableiten:
- Wenn beide dieselbe Erfolgsquote haben, muss Hydrogen die Gesamtzahl der abgerechneten Token um etwa 50 % senken, damit die Kosten gleich bleiben.
- Wenn beide pro Versuch gleich viele Token verbrauchen, muss Hydrogen bei der Erfolgsquote pro Versuch doppelt so hoch liegen wie Flash, damit die erwarteten Kosten pro Erfolg gleich bleiben.
Das folgende Beispiel ist eine redaktionelle Herleitung; alle Erfolgsquoten sind angenommene Werte, keine Messergebnisse:
| Annahmeszenario | Kosten pro Versuch | Angenommene Erfolgsquote | Erwartete Kosten pro Erfolg |
|---|---|---|---|
| Flash bearbeitet eine mehrstufige Agent-Aufgabe | $0.0135 | 40% | $0.0338 |
| Hydrogen bearbeitet dieselbe Aufgabe | $0.0270 | 80% | $0.0338 (gleichbleibend) |
| Hydrogen bearbeitet dieselbe Aufgabe | $0.0270 | 90% | $0.0300 (günstiger) |
| Flash bearbeitet eine einfache Klassifizierungsaufgabe | $0.0135 | 95% | $0.0142 |
| Hydrogen bearbeitet eine einfache Klassifizierungsaufgabe | $0.0270 | 98% | $0.0276 (fast doppelt so teuer) |
Die Schlussfolgerung ist klar: Bei einfachen Aufgaben, die Flash ohnehin gut erledigt, lassen sich die Mehrkosten von Hydrogen kaum wieder hereinholen; bei komplexen Aufgaben, bei denen Flash häufig scheitert und wiederholt versucht werden muss, kann Hydrogen die Kosten ausgleichen oder sogar senken.
Was die offiziellen Leistungsdaten zeigen
Von Google veröffentlichte Daten zeigen, dass Hydrogen auf Terminal-Bench 4.1 einen Wert von 57.0 % erreicht, 3.8 Flash kommt auf 18.2 %. Laut offiziellen Angaben werden Aufgaben unter denselben Testbedingungen außerdem etwa 2.5-mal schneller abgeschlossen und die Häufigkeit erfundener Fakten sinkt um mehr als das 5-Fache. In von Partnern veröffentlichten Daten reduzierte Box den Token-Verbrauch bei Unternehmensdokument-Aufgaben um 12 %, und STAN senkte den Gesamt-Token-Verbrauch um 23 %.
Diese Zahlen müssen mit Vorsicht interpretiert werden. Es handelt sich um Testergebnisse von Google oder Partnern, die sich nicht direkt in einen Prozentsatz deiner Kosteneinsparungen umrechnen lassen. Eine Token-Einsparung von 12 % bis 23 % liegt noch weit von der Break-even-Schwelle von 50 % entfernt. Ob Hydrogen Geld spart, hängt daher vor allem von der höheren Erfolgsquote ab, nicht von der Token-Einsparung. Außerdem verkürzt die höhere Geschwindigkeit Wartezeiten und Maschinenbelegung, doch das lässt sich nicht direkt mit der API-Rechnung verrechnen.
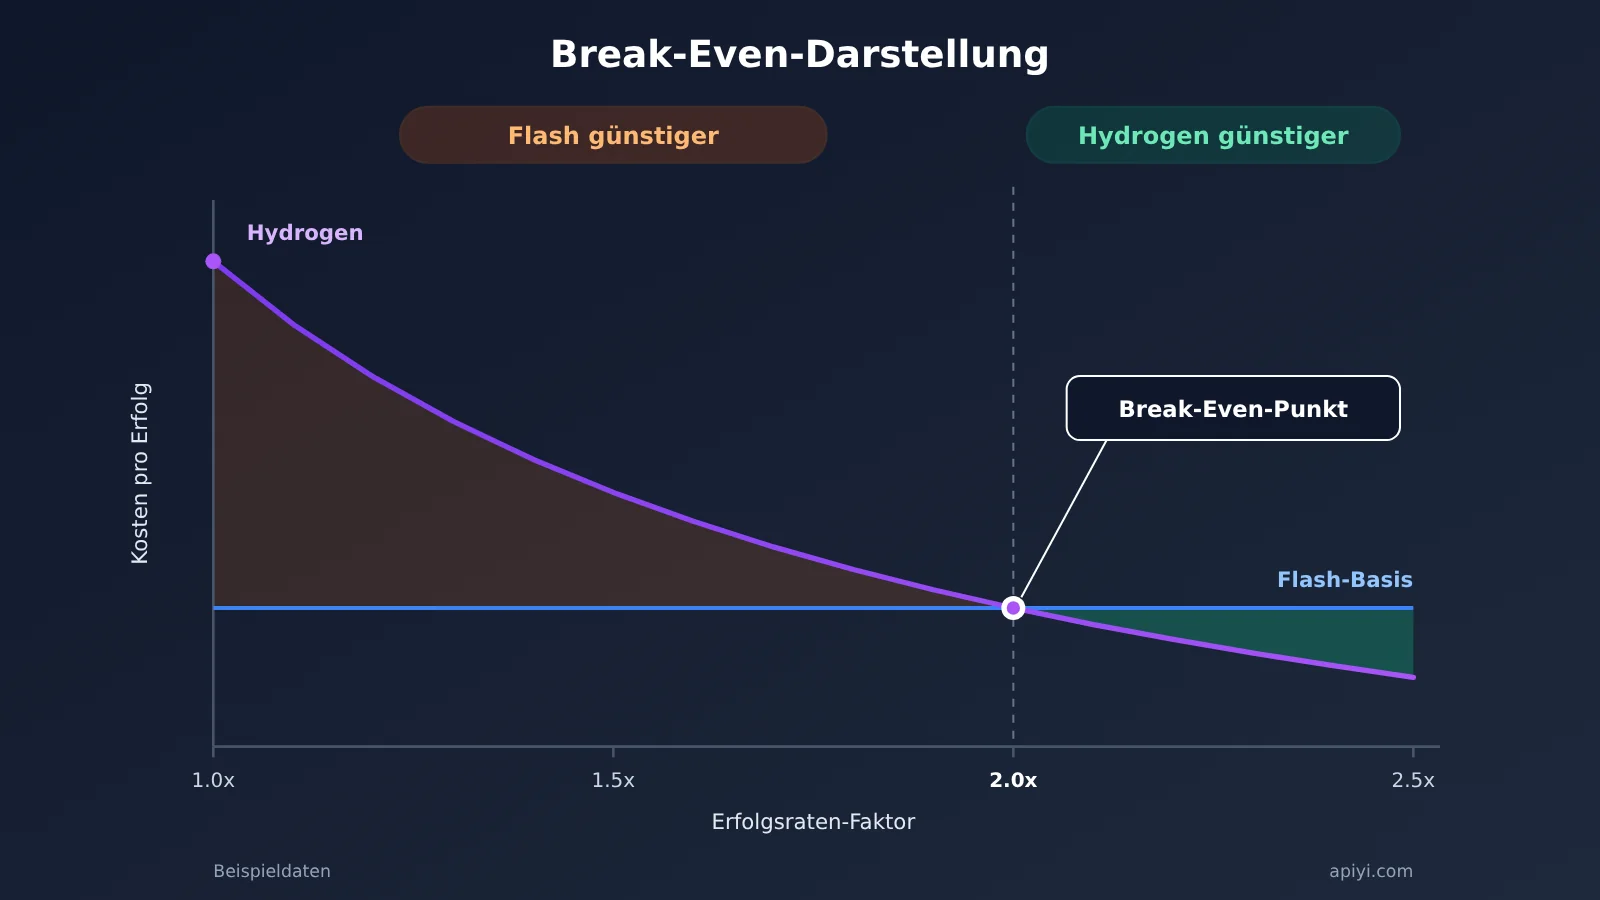
Szenarioempfehlungen für Gemini 4 Hydrogen, Flash, Argon und Carbon
Szenarien für 3.8 Flash
- Große Mengen mit stabilen Abläufen: etwa Textklassifizierung, Feldextraktion, Zusammenfassungen oder Formatkonvertierung. Bei solchen Aufgaben ist die Erfolgsquote von Flash von Haus aus hoch; Hydrogen würde nur die Rechnung verdoppeln.
- Preissensible Workflows, die gelegentliche Wiederholungsversuche verkraften: Bis zum 31. Dezember 2026 hat Flash von den vier Modellen den niedrigsten Stückpreis.
Szenarien für Gemini 4 Hydrogen
- Codegenerierung und Debugging: Laut Google nimmt das Modell präzise Änderungen vor und fasst irrelevanten Code nicht an – ideal für Bugfixing, Abhängigkeitsupdates und Testläufe.
- Mehrstufige Agent-Ausführung: aufeinanderfolgende Tool-Aufrufe, paralleles Retrieval und Strategieanpassung, wenn ein Tool-Aufruf fehlschlägt – das sind seine Kernbereiche.
- Komplexe Dokumentenverarbeitung: Unterstützt unter anderem PDF, Word, Excel und PPT; eine einzelne Anfrage kann bis zu 3000 Bilder oder Dokumente enthalten.
- Ausführende Instanz in Multi-Modell-Systemen: Carbon oder Argon übernehmen die Planung, Hydrogen die praktische Umsetzung und Validierung.
Szenarien für Argon oder Carbon
Google positioniert Argon und Carbon beide als Modelle für komplexe, zeitintensive Aufgaben mit tiefgehendem Reasoning. Die Referenzunterlagen nennen keine feineren Unterschiede zwischen beiden. Nach der in diesem Artikel empfohlenen Arbeitsteilung passt Argon zu komplexen Arbeiten, die tieferes Reasoning erfordern und bei denen Effizienz eine größere Rolle spielt; Carbon passt zu Architekturdesign, anspruchsvollem Reasoning und langfristigen Engineering-Aufgaben. Der von Google beschriebene Ablauf des Antigravity Orchestrator folgt genau dieser Arbeitsteilung: Carbon analysiert das Repository und erstellt einen Plan, Hydrogen führt Änderungen und Tests aus, und bei komplexen Fehlern geht es zurück an Carbon. Google gibt an, dass dieser Ansatz im Vergleich zur alleinigen Nutzung von Carbon den Kontingentverbrauch um durchschnittlich 24 % senkt und die Fertigstellungsgeschwindigkeit um 19 % erhöht.
| Aufgabentyp | Bevorzugtes Modell | Kostenaspekt | Verfügbare Plattformen |
|---|---|---|---|
| Batch-Aufgaben wie Klassifizierung, Extraktion und Zusammenfassung | 3.8 Flash | Niedrigster Stückpreis, Erfolgsquote bereits ausreichend | Google (offiziell), APIYI apiyi.com |
| Alltägliche Programmierung, Bugfixing | 4 Hydrogen | Höhere Erfolgsquote gleicht den doppelten Stückpreis aus | Google (offiziell), APIYI |
| Mehrstufige Agenten, Tool-Aufrufe | 4 Hydrogen | Weniger Wiederholungsversuche und Ausführungsschritte | Google (offiziell), APIYI |
| Komplexes Reasoning mit Fokus auf Effizienz | 4 Argon | Stückpreis verdoppelt sich nach dem 1. Dezember | Google (offiziell), APIYI |
| Architekturdesign, langfristige Engineering-Projekte | 4 Carbon | Ausführung nach Aufgabenverteilung mit Hydrogen empfohlen | Google (offiziell), APIYI |
Die tatsächliche Verfügbarkeit der Modelle bei APIYI richtet sich nach der Modellliste der Plattform.
Gemini 4 Hydrogen: Entscheidungsempfehlungen nach der Preisanpassung
Wie zwei Preisanpassungszeitpunkte die Modellauswahl verändern
| Zeitraum | Flash | Hydrogen | Argon / Carbon | Auswahlkonstellation |
|---|---|---|---|---|
| 2026-11-13 bis 11-30 | $0.75 / $3.75 | $1.50 / $7.50 | $2 / $10 | Geringer Preisunterschied zwischen Hydrogen und Argon/Carbon |
| 2026-12-01 bis 12-31 | $0.75 / $3.75 | $1.50 / $7.50 | $4 / $20 | Argon/Carbon kostet das 2.67-Fache von Hydrogen |
| ab 2027-01-01 | $1.50 / $7.50 | $1.50 / $7.50 | $4 / $20 | Flash verliert den Preisvorteil und liegt gleichauf mit Hydrogen |
Diese Tabelle zeigt zwei Planungsaspekte. Kurzfristig ist Argon/Carbon im November nur etwa ein Drittel teurer als Hydrogen; Aufgaben, die tiefgehende Inferenz erfordern, können in dieser Zeit gebündelt abgeschlossen werden. Mittelfristig haben Flash und Hydrogen ab Januar nächsten Jahres denselben Stückpreis; das leistungsfähigere Hydrogen wird in den meisten Szenarien zur sinnvolleren Standardoption – vorausgesetzt, Google veröffentlicht in diesem Zeitraum keine weiteren Preisanpassungen.
Kompatibilitätsprüfung vor der Migration zu Hydrogen
Bei der Migration von 3.8 Flash zu Hydrogen können die folgenden Konfigurationen nicht direkt übernommen werden; andernfalls können Fehler auftreten oder die Kosten außer Kontrolle geraten:
thinking_budgetund die StufeMINIMALwerden nicht mehr unterstützt; bei Verwendung wird HTTP 400 zurückgegeben.- Die standardmäßige Denkstufe ändert sich von Medium zu High; es sollte aktiv geprüft werden, ob eine Herabstufung sinnvoll ist.
- Benutzerdefinierte temperature-, top_p- und top_k-Werte werden ignoriert.
- Explizites Caching wird nicht unterstützt; stattdessen muss auf implizites Caching gesetzt werden, und feste Inhalte müssen am Anfang der Eingabeaufforderung stehen.
- Bei Tool-Aufrufen über mehrere Runden müssen Thought Signatures korrekt gespeichert und zurückgegeben werden.
💡 Auswahlempfehlung: Wechseln Sie nicht allein anhand des Modellnamens den gesamten Traffic auf einmal. Teilen Sie den Traffic nach Aufgabentyp auf und erfassen Sie die Kosten pro erfolgreichem Aufruf separat. Über die einheitliche Schnittstelle von APIYI apiyi.com können Sie allein durch Ändern des Parameters
modeleinen A/B-Vergleich zwischen den vier Modellen durchführen, um auf Basis der Daten eine Routing-Strategie festzulegen.
Häufig gestellte Fragen (FAQ)
F1: Welche Positionierung hat das Modell Gemini 4 Hydrogen?
Hydrogen ist ein Modell, das Google DeepMind am 12. November 2026 veröffentlicht hat. Seine API-ID lautet `gemini-4-hydrogen`, und es ist auf hocheffizientes alltägliches Programmieren sowie die Ausführung von KI-Agenten ausgerichtet. Die offizielle Modellkarte zeigt, dass es aus Gemini 4 Carbon abgeleitet wurde. Das gesamte Kontextbudget beträgt 1.048.576 Token – Eingabe, Denken und Ausgabe teilen sich dieses Kontingent.
F2: Wie viel teurer ist Gemini 4 Hydrogen als 3.8 Flash?
Nach den Standardpreisen der Google Gemini API vom 13. November 2026 liegen die Eingabe- und Ausgabepreise von Hydrogen jeweils doppelt so hoch wie bei 3.8 Flash ($1,50 / $7,50 gegenüber $0,75 / $3,75). Bei der Beispiel-Last aus diesem Artikel betragen die monatlichen Kosten $27 bzw. $13,50.
F3: Wann werden Argon und Carbon teurer?
Die offizielle Preisseite vermerkt, dass Argon und Carbon ab dem 1. Dezember 2026 von $2 / $10 auf $4 / $20 angepasst werden. 3.8 Flash wird ab dem 1. Januar 2027 auf $1,50 / $7,50 angepasst. Für Hydrogen gibt es derzeit keine öffentlich bekannte gestaffelte Preisanpassung.
F4: Welche Denkstufe ist bei Hydrogen am günstigsten?
Die offizielle Empfehlung lautet: Low für Klassifizierung, Medium für reguläres Programmieren, High für mehrstufige Agenten, XHigh für komplexes tiefes Schlussfolgern. Die Daten von Artificial Analysis zeigen, dass XHigh den Intelligenzindex nur um 3 Punkte über High liegt (54 gegenüber 51), während die durchschnittlichen Kosten pro Benchmark-Aufgabe von $1,87 auf $3,16 steigen. Deshalb sollte XHigh in den meisten Szenarien nicht standardmäßig aktiviert werden.
F5: Wie lassen sich die tatsächlichen Kosten der vier Gemini-Modelle schnell vergleichen?
Am einfachsten geht das über eine aggregierte Schnittstelle, die mehrere Modelle unterstützt:
1. Registrieren Sie ein Konto bei APIYI apiyi.com und holen Sie sich den API-Schlüssel sowie ein kostenloses Testkontingent;
2. Setzen Sie im Code dieses Artikels die base_url auf `https://api.apiyi.com/v1`;
3. Führen Sie das Vergleichsskript mit Ihren eigenen echten Aufgabenbeispielen aus und erfassen Sie die Kosten pro erfolgreichem Durchlauf.
F6: Welche bekannten Schwächen hat Hydrogen?
Laut offizieller Modellkarte umfassen die genannten Probleme: Es kann weiterhin Halluzinationen erzeugen; das Wissen endet im März 2026; im Vergleich zu 3.8 Flash ist der Indikator für unbegründete Ablehnungen um 5,57 Prozentpunkte schlechter geworden; der vollständige Sicherheitsbericht war zum Zeitpunkt der Prüfung noch nicht veröffentlicht. In der Anfangsphase nach der Veröffentlichung berichteten Nutzer zudem von Problemen beim Rollout wie verschwundenen Modelloptionen und fehlgeschlagenen Aufrufen; auf Hacker News erwähnte ein Nutzer außerdem, dass es bei manchen Agenten-Aufgaben zur übermäßigen Ausführung kommt.
F7: Wie können Teams in China zuverlässig Modellauswahl-Tests für Gemini durchführen?
Google verwendet eine schrittweise Rollout-Strategie, sodass die Verfügbarkeit je nach Region und Konto unterschiedlich ausfallen kann. Teams, die Gemini, Claude, GPT und weitere Modelle gleichzeitig vergleichen möchten, können über APIYI apiyi.com eine OpenAI-kompatible Schnittstelle für den einheitlichen Zugang nutzen – nutzungsbasierte Abrechnung, und die Testskripte müssen nicht für jeden Anbieter separat umgeschrieben werden.
Gemini 4 Hydrogen Preisvergleich: Die wichtigsten Erkenntnisse
- Verdoppelter Stückpreis: Der aktuelle Standardpreis von Hydrogen ist doppelt so hoch wie der von 3.8 Flash – es handelt sich also um eine Preiserhöhung, nicht um eine Preissenkung.
- Mittleres Segment: Hydrogen ist günstiger als Argon und Carbon; nach Dezember wächst der Abstand auf das 2,67-Fache.
- Gewinnschwelle: Erst wenn sich die Token halbieren oder die Erfolgsrate pro Versuch verdoppelt, ziehen die Kosten von Hydrogen mit Flash gleich.
- Rechnungsvariablen: Reasoning-Token, impliziter Cache, Batch-Modus und Anzahl der Suchvorgänge verändern die tatsächlichen Kosten erheblich.
- Preisanpassungstermine: Am 2026-12-01 werden Argon/Carbon teurer, am 2027-01-01 sind Flash und Hydrogen gleich teuer.
- Validierung: Mit echten Stichproben die Kosten pro Erfolg ermitteln – über die einheitliche API von APIYI lassen sich die vier Modelle vergleichen.
Fazit
Die Auswahlkriterien für Gemini 4 Hydrogen im Vergleich zu 3.8 Flash, Argon und Carbon sind wie folgt:
- Stückpreis prüfen: Im November ist Flash am günstigsten, Hydrogen kostet doppelt so viel, Argon und Carbon sind noch teurer und verdoppeln sich am 1. Dezember.
- Kosten pro Erfolg prüfen: Für einfache Aufgaben weiterhin Flash verwenden; bei Aufgaben wie Programmierung und Agenten, bei denen Flash leicht scheitert, kann der Wechsel zu Hydrogen erwogen werden; Aufgaben mit tiefem Reasoning Argon oder Carbon überlassen, die Ausführung Hydrogen.
- Zeitplan beachten: Die Budgetplanung muss zwei Preisanpassungstermine berücksichtigen; ab 2027 dürfte Hydrogen die standardmäßige Wahl mit gutem Preis-Leistungs-Verhältnis werden.
Diese Entscheidung ist im Kern ein Abwägen zwischen Kosten und Aufgabenwert. Der Stückpreis lässt sich direkt nachschlagen, die Erfolgsrate muss man mit eigenen Daten messen. Es empfiehlt sich, zunächst bei APIYI apiyi.com mit dem kostenlosen Kontingent einen Durchlauf mit echten Aufgaben zum Vergleich durchzuführen und dann anhand der Ergebnisse eine Modell-Routing-Strategie festzulegen.
📚 Referenzen
- Offizieller Google-Blog – Introducing Gemini 4 Hydrogen: Ankündigung und Partnerbeispiele
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Beschreibung: Offizielle Positionierung, Leistungsvergleich mit 3.8 Flash
-
Offizielle Preisgestaltung der Google Gemini API: Standardpreise der vier Modelle und Termine für Preisanpassungen
- Link:
aistudio.google.com/docs/pricing -
Beschreibung: Quelle aller in diesem Artikel genannten Preise, geprüft am 2026-11-13
-
Google DeepMind Modellkarte: Fähigkeiten, Grenzen und Sicherheitsbewertung von Hydrogen
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Beschreibung: Modellübergreifende Evaluierungsdaten und bekannte Einschränkungen
-
Google Cloud technische Dokumentation: API-Spezifikation und Hinweise zur Migration
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Beschreibung: Kontextlimits, Caching-Regeln, Parameterkompatibilität
-
Regionale Preisgestaltung von Google Cloud: Preisunterschied zwischen Global und Non-global
- Link:
cloud.google.com/model-garden/pricing -
Beschreibung: Referenz für regionale Angebote der Enterprise-Cloud-Plattform
-
Artificial Analysis: Unabhängige Bewertung der vier Denkmodi von Hydrogen
- Link:
artificialanalysis.ai/models/gemini-4-hydrogen -
Beschreibung: Intelligenzindex, Laufzeit und Kosten der Benchmark-Aufgaben je Stufe
-
Google Antigravity Blog: Multi-Modell-Orchestrierung mit Orchestrator
- Link:
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity - Beschreibung: Offizielle Daten zur Arbeitsteilung zwischen Carbon und Hydrogen
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com