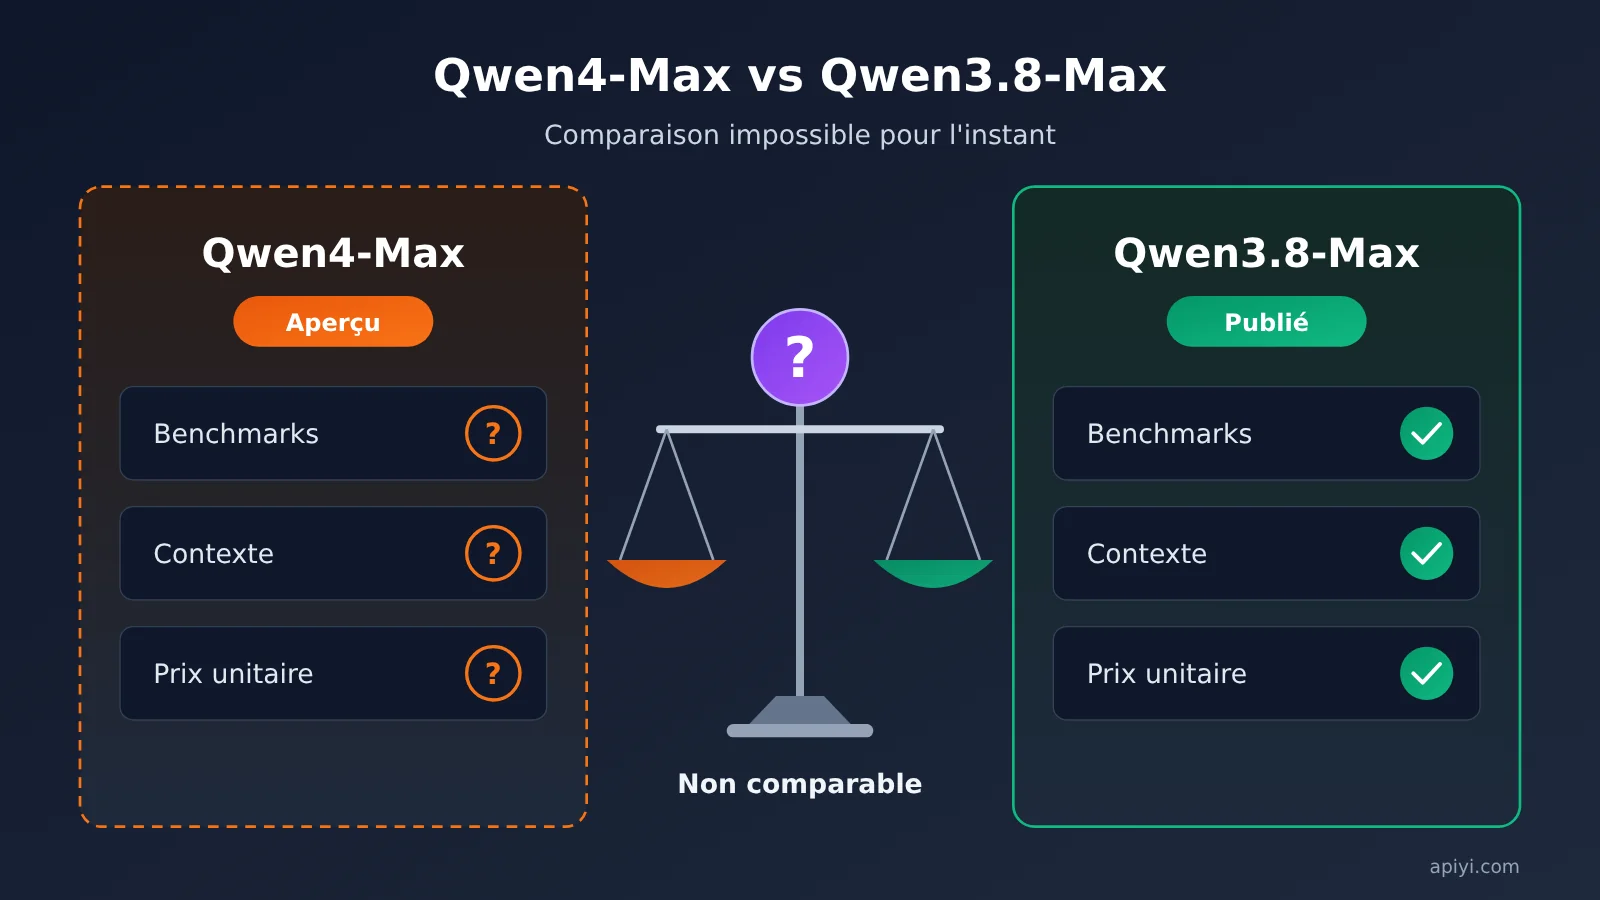
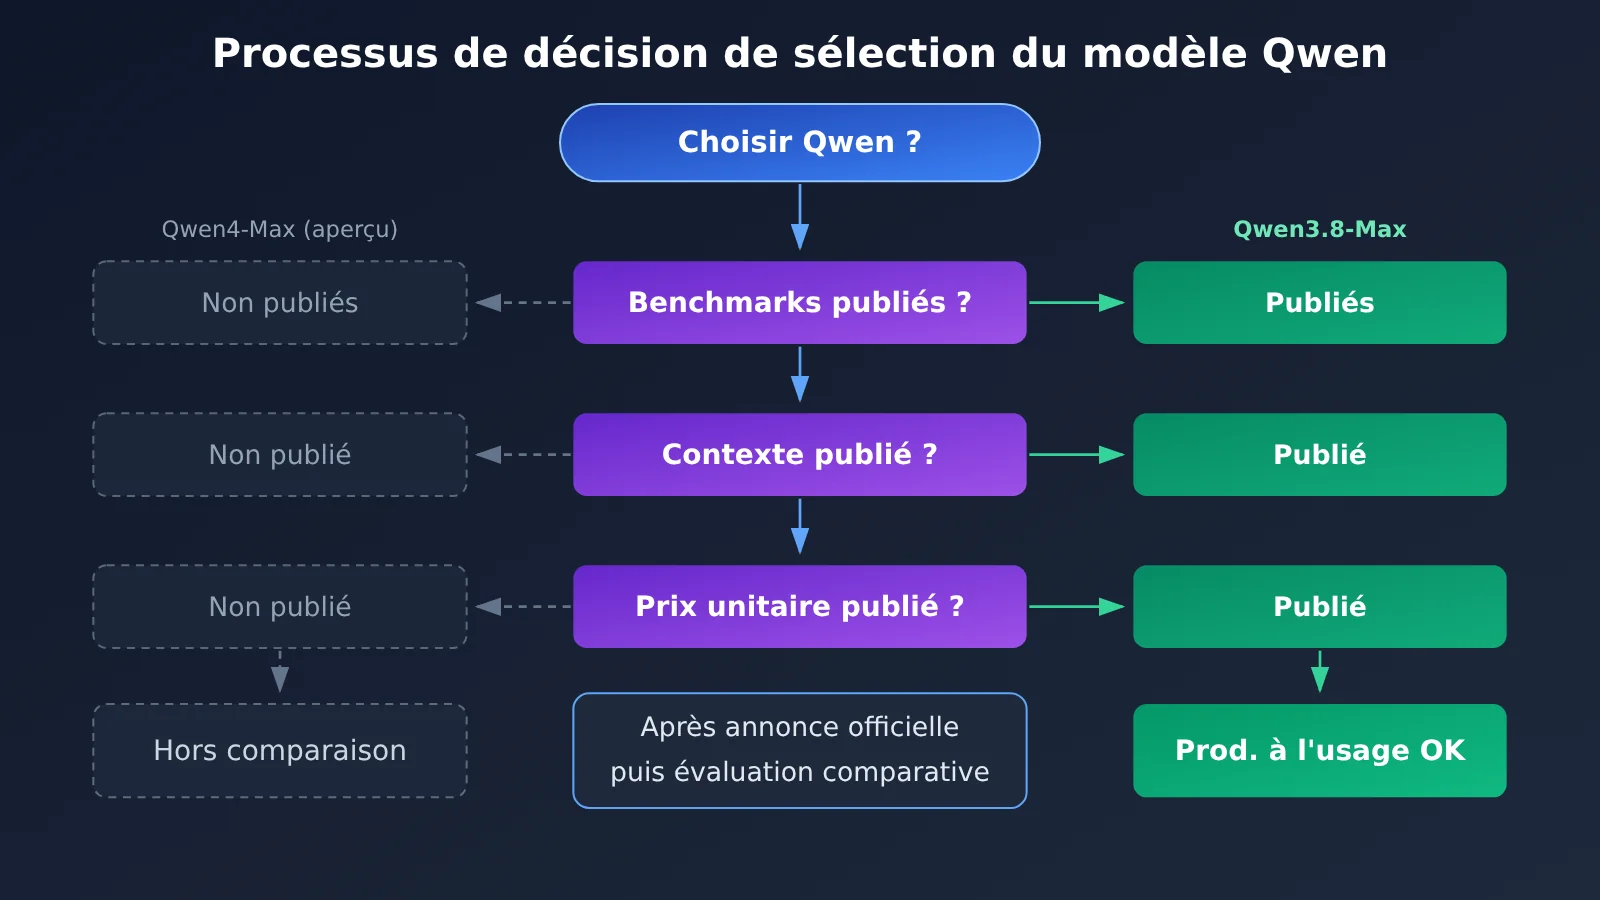
Note de l’auteur : Qwen4-Max est encore en phase d’aperçu. Il n’a pour l’instant ni scores de benchmark publics, ni longueur de contexte annoncée, ni prix unitaire par token. Impossible donc de le comparer point par point avec Qwen3.8-Max. Aujourd’hui, le modèle réellement disponible à l’usage facturé est toujours qwen3.8-max.
Dès que l’aperçu de Qwen4-Max est sorti, la première question des développeurs qui utilisent Qwen a été : faut-il changer ? Est-il meilleur que Qwen3.8-Max, et de combien ? Plus cher, et de combien ? Pour l’instant, ces questions n’ont aucune réponse comparable, car il manque trois informations publiques indispensables à toute comparaison.
Il ne s’agit pas de dénigrer Qwen4-Max. Nous ne portons aucun jugement sur ses capacités, nous constatons seulement un fait : au 12/11/2026, l’aperçu de Qwen4-Max n’a ni scores de benchmark publics, ni longueur de contexte annoncée, ni prix unitaire par token, alors que Qwen3.8-Max est déjà publié et utilisable en facturation à l’usage. D’après la liste des modèles d’APIYI (apiyi.com) à cette même date, le modèle que l’on peut brancher directement est qwen3.8-max.
L’essentiel : en 3 minutes, vous saurez quels points on ne peut pas encore comparer entre l’aperçu de Qwen4-Max et Qwen3.8-Max, et comment organiser vos projets en attendant les informations officielles.
Qwen4-Max et Qwen3.8 : l’essentiel en un coup d’œil
Commençons par rassembler ce qu’on peut réellement confirmer des deux côtés. Le tableau ci-dessous ne reprend que ce que les sources permettent d’établir ; tout ce qui n’a pas été rendu public est simplement indiqué comme « non communiqué », sans aucune extrapolation.
| Élément | Qwen4-Max (préversion) | Qwen3.8-Max |
|---|---|---|
| Statut de publication | Phase de préversion | Modèle publié |
| Scores de benchmark publics | Non communiqués | Modèle publié, documentation officielle consultable |
| Longueur de contexte | Non communiquée | Selon la documentation officielle et la fiche du modèle |
| Tarif par token | Non communiqué | Entrée 1,65 $ / sortie 4,95 $ / lecture du cache 0,20625 $ (par 1M de tokens) |
| Facturation à l’usage | Absent de la liste des modèles au 2026-11-12 | Disponible, ID du modèle qwen3.8-max |
| Plateformes disponibles | Selon les prochaines annonces officielles | APIYI et d’autres plateformes |
« Non communiqué » apparaît trois fois dans le tableau : pour les scores, le contexte et le tarif. Ce sont pourtant les trois critères de comparaison les plus utilisés au moment de choisir un modèle, et il suffit qu’un seul manque pour que toute comparaison directe perde sa base. Un article précédent a déjà présenté l’ouverture de la préversion ; ici, on se concentre sur la raison pour laquelle ces trois points rendent toute comparaison forcée peu fiable.
Ce que change l’absence de ces trois informations pour Qwen4-Max en préversion
Les scores de benchmark servent à juger les capacités. Sans notes de référence publiées officiellement, impossible de mesurer de façon homogène où se situe Qwen4-Max par rapport à Qwen3.8-Max en raisonnement, en code ou en traitement de textes longs. Des captures d’écran qui circulent dans la communauté ou quelques impressions tirées de conversations isolées ne remplacent pas de vrais résultats : jeux de test, invites et paramètres d’échantillonnage diffèrent à chaque fois.
La longueur de contexte conditionne l’architecture. La taille des chunks en RAG, la stratégie de troncature de l’historique de conversation, le choix entre une saisie unique ou un traitement par segments pour les longs documents : tout dépend d’une limite de fenêtre de contexte précise. Tant que ce chiffre n’est pas fixé, impossible de savoir si une migration permettrait de supprimer la logique de découpage actuelle, ni si l’on risque des erreurs de dépassement.
Le tarif par token détermine le modèle de coûts. Budget, tarification, politique de limitation de débit : tout repose sur le prix unitaire. Même si la préversion est testable, cela ne veut pas dire qu’il existe un prix à inscrire dans un tableau de coûts. Comparer un tarif encore inconnu avec celui, bien réel, de qwen3.8-max n’aboutit à aucune conclusion valable.
Qwen3.8-Max : tarifs et accès à l’invocation à l’usage
Comme les conditions d’une comparaison ne sont pas encore réunies, mieux vaut se baser sur les modèles déjà publiés pour vos projets en cours. Le tableau ci-dessous reprend les prix de qwen3.8-max dans la liste des modèles du 2026-11-12, en dollars par million de tokens.
| Poste de facturation | Prix unitaire (par 1M tokens) | Remarque |
|---|---|---|
| Entrée | $1.65 | Partie de l’invite qui ne passe pas par le cache |
| Sortie | $4.95 | Contenu généré par le modèle, soit 3 fois le prix de l’entrée |
| Lecture du cache | $0.20625 | Partie de l’entrée servie par le cache, soit 1/8 du prix de l’entrée |
Côté structure, le prix de la sortie vaut 3 fois celui de l’entrée, et la lecture du cache ne coûte que 12,5 % du prix de l’entrée. Maîtriser la longueur des sorties et augmenter le taux de réussite du cache (cache hit) sont donc les deux leviers les plus directs pour réduire le coût de qwen3.8-max. Si votre invite système est longue ou si le préfixe de vos conversations multi-tours reste stable, le gain apporté par le cache sera encore plus net.
Exemples d’estimation du coût avec Qwen3.8-Max
À partir des prix ci-dessus, on peut calculer le coût de quelques requêtes types. Tous les chiffres ci-dessous découlent directement des tarifs publics, ce qui vous permet de les transposer facilement à votre propre volume d’activité.
| Scénario | Tokens d’entrée | Dont tokens servis par le cache | Tokens de sortie | Coût par requête |
|---|---|---|---|---|
| Requête classique | 10,000 | 0 | 2,000 | $0.0264 |
| Même requête, préfixe en cache | 10,000 | 8,000 | 2,000 | $0.01485 |
| Traitement par lots de 1M d’entrée | 1,000,000 | 0 | 200,000 | $2.64 |
La deuxième ligne a les mêmes volumes d’entrée et de sortie que la première ; seuls 8 000 tokens d’entrée sont servis par le cache, et le coût par requête passe de $0.0264 à environ $0.0149, soit une baisse de plus de 40 %. C’est un calcul que Qwen4-Max en préversion ne permet pas encore, puisque son prix n’a pas été annoncé.
Comment accéder à qwen3.8-max
APIYI propose une interface compatible OpenAI : vous pouvez vous connecter directement avec le SDK OpenAI ou n’importe quel client compatible, en modifiant simplement trois paramètres :
base_url:https://api.apiyi.com/v1(l’interface unifiée d’APIYI)api_key: la clé API créée dans la console APIYImodel:qwen3.8-max
L’appel fonctionne comme avec Chat Completions : il suffit d’organiser le tableau messages selon l’ordre des rôles system, user, assistant. Si votre projet est déjà branché sur un point d’accès compatible OpenAI, il suffit généralement de remplacer la base_url et l’ID du modèle, sans toucher au code métier.
🚀 Pour démarrer : inscrivez-vous sur APIYI (apiyi.com) pour obtenir un crédit de test gratuit, puis faites tourner vos propres invites métier avec
qwen3.8-max. Notez les volumes réels d’entrée, de sortie et le taux de réussite du cache : quand Qwen4-Max sera officiellement ouvert, vous aurez déjà des données de référence pour comparer.
Impact de l’aperçu de Qwen4-Max sur les projets Qwen existants
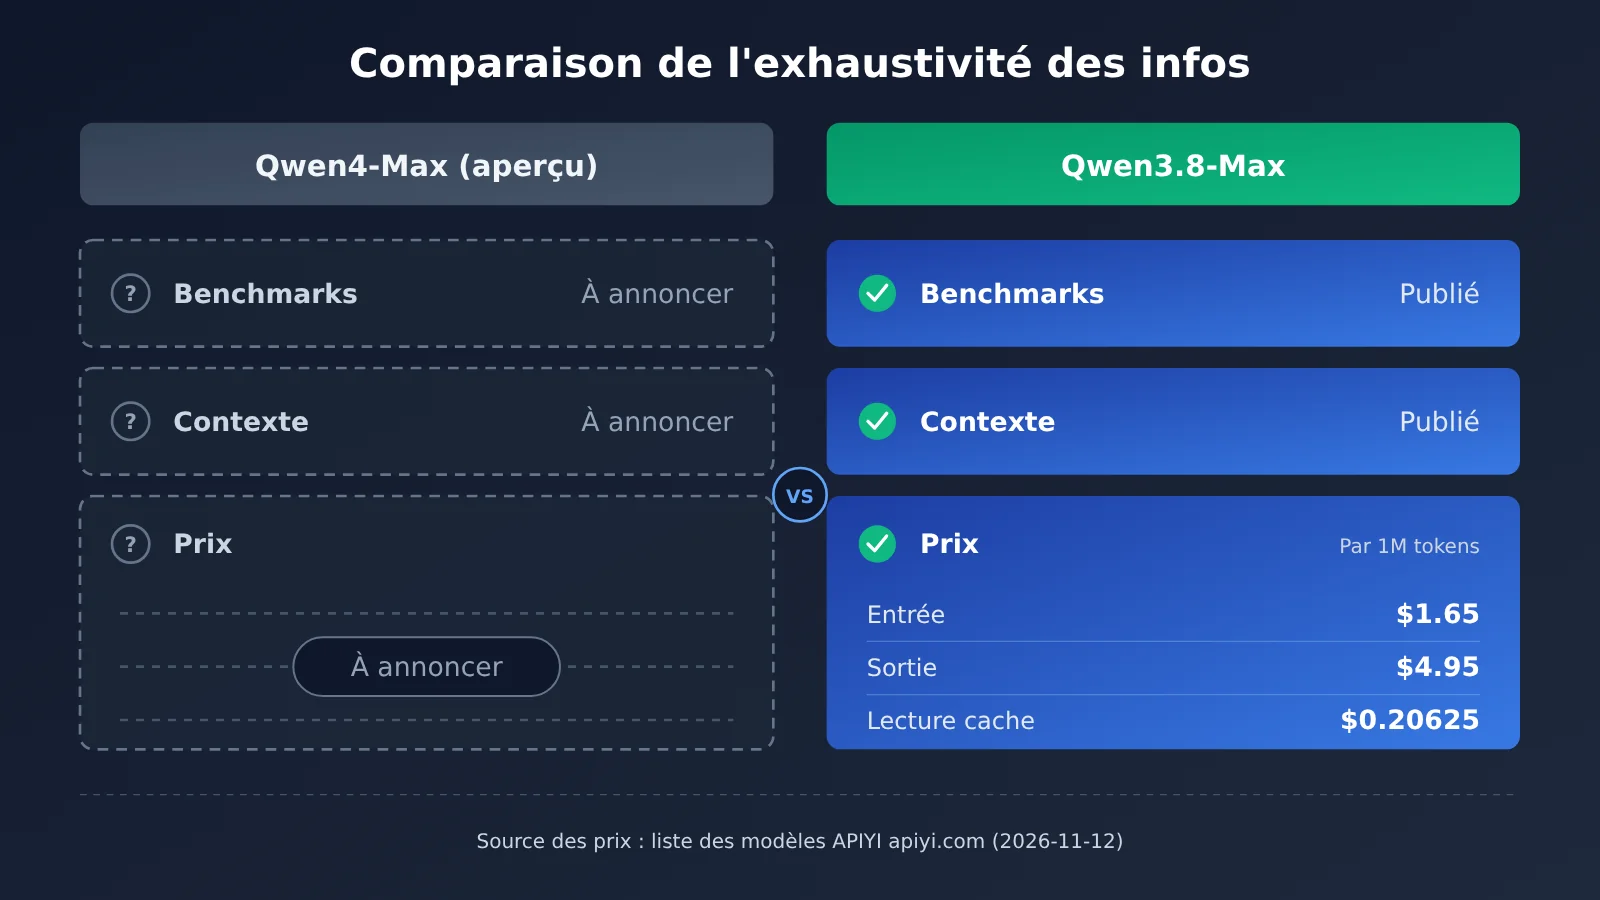
Le schéma ci-dessus met côte à côte le niveau d’information disponible des deux côtés : d’un côté, trois cases vides en attente de publication ; de l’autre, des données que l’on peut consulter directement. Dans cet état, toute comparaison du type « combien de fois plus puissant » ou « combien plus cher » manque de fondement. Vous pouvez vérifier les prix dans la liste des modèles d’APIYI (apiyi.com).
Ce que ça change pour les développeurs qui utilisent déjà Qwen
- Rien à toucher en production : l’aperçu de Qwen4-Max ne modifie ni la disponibilité ni le prix de qwen3.8-max, vos appels existants continuent de fonctionner normalement.
- Vous pouvez déjà préparer l’évaluation : constituez un jeu d’invites représentatif de votre activité, ainsi qu’une grille de notation, pour comparer directement les deux modèles dès que les informations officielles seront publiées.
- Le budget reste basé sur qwen3.8-max : en phase d’aperçu, il n’y a pas de tarif unitaire, donc mieux vaut ne pas intégrer Qwen4-Max dans votre prochain budget ou devis.
- Reportez les refontes liées au contexte : tant que la longueur de contexte de Qwen4-Max n’est pas annoncée, il n’est pas conseillé d’ajuster votre logique de découpage ou de troncature en vue de ce modèle.
Nos recommandations selon votre rôle
| Rôle | Ce que vous pouvez faire dès maintenant | Ce qu’il vaut mieux faire une fois les infos officielles publiées |
|---|---|---|
| Développeur d’applications | Continuer avec qwen3.8-max et enrichir votre jeu d’évaluation métier |
Comparer les deux modèles avec le même jeu d’évaluation |
| Responsable d’architecture | Concevoir la stratégie de contexte selon la limite réelle de qwen3.8-max | Évaluer, selon la longueur de contexte de Qwen4-Max, si le découpage peut être simplifié |
| Responsable des coûts | Établir le budget sur la base de 1,65 $ en entrée et 4,95 $ en sortie par million de tokens | Recalculer le coût de migration une fois le tarif de Qwen4-Max connu |
| Chef de produit | Continuer à communiquer sur les capacités des modèles déjà publiés | Décider d’annoncer ou non une montée en gamme d’après les benchmarks publics |
Ce que ça nous apprend sur le processus de choix d’un modèle
Avec une préversion, le piège le plus courant consiste à prendre « ça a l’air plus récent » pour « c’est déjà meilleur ». Un processus de sélection rigoureux demande au minimum trois types de données publiques : la performance (benchmarks), la capacité (contexte) et le coût (tarif unitaire). Tant que ces trois éléments ne sont pas réunis, un nouveau modèle a sa place dans une liste de veille, pas dans une solution de production.
Gérer l’invocation du modèle via une interface unifiée présente aussi un avantage : le jour où Qwen4-Max sera ouvert à la facturation à l’usage, il suffira de modifier le paramètre model pour faire un test A/B, sans avoir à intégrer un nouveau SDK.
💡 Notre conseil : tant que les trois informations clés de Qwen4-Max ne sont pas publiées, gardez qwen3.8-max comme modèle principal en production. En passant par l’interface unifiée d’APIYI (apiyi.com), vous pourrez, à la sortie du nouveau modèle, basculer et comparer rapidement avec le même code.
FAQ : questions fréquentes
Q1 : Peut-on déjà comparer Qwen4-Max (préversion) à Qwen3.8-Max ?
Pas sur les benchmarks, la longueur de contexte ni le prix unitaire par token. Qwen4-Max est encore en préversion et aucune de ces trois données n’est publique, donc il n’y a pas de base de comparaison commune. Seul le statut de publication est établi : Qwen3.8-Max est sorti et peut être appelé à l’usage, tandis que Qwen4-Max reste en préversion.
Q2 : Qwen4-Max surpasse-t-il déjà Qwen3.8-Max sur tous les plans ?
Aucune donnée publique ne permet de l’affirmer. Un numéro de version plus élevé ne signifie ni que le modèle est meilleur sur toutes les tâches, ni que son prix sera plus avantageux. Pour savoir s’il fait mieux, et sur quelles tâches, il faut attendre la publication officielle des benchmarks, puis idéalement vérifier avec votre propre jeu d’évaluation métier.
Q3 : Quel est le tarif actuel de Qwen3.8-Max ?
D’après la liste des modèles du 2026-11-12, qwen3.8-max coûte, par million de tokens, 1,65 $ en entrée, 4,95 $ en sortie et 0,20625 $ pour la lecture du cache. Le tarif de lecture du cache ne représente que 1/8 de celui de l’entrée : si le préfixe de vos invites reste stable, vous pouvez réduire nettement les coûts.
Q4 : Comment appeler rapidement Qwen3.8-Max via l’API ?
Le plus simple est de passer par une plateforme d’agrégation d’API compatible avec plusieurs modèles :
1. Rendez-vous sur APIYI (apiyi.com), créez un compte, puis récupérez votre clé API et le crédit de test gratuit
2. Définissez `base_url` sur `https://api.apiyi.com/v1`
3. Renseignez `qwen3.8-max` comme ID de modèle et appelez-le au format Chat Completions compatible OpenAI
Q5 : Une fois Qwen4-Max ouvert officiellement, la migration sera-t-elle coûteuse ?
Côté interface, tout dépend de votre mode d’intégration. Si vous gérez vos modèles via une interface compatible OpenAI, il suffit généralement de changer l’ID du modèle ; ce qu’il faudra vraiment évaluer, ce sont les écarts de qualité et de coût. Nous vous conseillons de commencer dès maintenant à accumuler des données d’évaluation avec qwen3.8-max sur APIYI (apiyi.com), pour pouvoir les comparer directement le moment venu.
Q6 : Quelles limites faut-il garder en tête pendant la préversion ?
En préversion, tous les paramètres clés peuvent encore changer. Sans benchmarks publics, impossible de cerner les capacités du modèle ; sans longueur de contexte connue, impossible de figer une solution pour les longs textes ; sans tarif, impossible de budgéter. Nous déconseillons donc d’utiliser un modèle en préversion pour une production soumise à des exigences de stabilité et de coût.
Qwen4-Max et Qwen3.8-Max : les points essentiels (Key Takeaways)
- Statut de publication différent : Qwen4-Max n’est encore qu’en préversion, alors que Qwen3.8-Max est un modèle déjà publié, utilisable à la consommation.
- Trois comparaisons impossibles pour l’instant : ni les scores de benchmark, ni la longueur de contexte, ni le prix unitaire par token de Qwen4-Max ne sont publics.
- Pas de conclusion hâtive : sans données publiques, impossible d’affirmer que Qwen4-Max surpasse Qwen3.8-Max sur tous les plans.
- Tarifs actuels consultables : qwen3.8-max coûte 1,65 $ par million de tokens en entrée, 4,95 $ en sortie et 0,20625 $ pour la lecture du cache.
- Le cache, levier d’économie : le tarif de lecture du cache ne représente qu’1/8 du prix d’entrée, ce qui rapporte gros dans les scénarios à préfixe stable.
- En production, on s’appuie sur qwen3.8-max : intégrez-le via l’interface unifiée d’APIYI ; pour changer de modèle plus tard, il suffira de modifier l’ID du modèle.
Conclusion
Voici l’essentiel à retenir sur la relation entre la préversion de Qwen4-Max et Qwen3.8-Max :
- Les conditions d’une comparaison ne sont pas réunies : la préversion de Qwen4-Max ne fournit ni scores de benchmark, ni longueur de contexte, ni prix par token. Impossible donc de la mettre en balance avec Qwen3.8-Max sur ces trois points.
- Le modèle disponible aujourd’hui, c’est qwen3.8-max : ses tarifs sont clairs, avec 1,65 $ en entrée, 4,95 $ en sortie et 0,20625 $ pour la lecture du cache (par million de tokens).
- Préparez-vous dès maintenant, comparez après l’annonce officielle : constituez dès à présent un jeu d’évaluation propre à votre activité et des données de coûts, puis décidez d’une éventuelle migration quand toutes les informations seront disponibles.
D’ici la publication officielle de Qwen4-Max, le plus raisonnable est de continuer à faire tourner vos applications sur qwen3.8-max, tout en préparant vos évaluations et votre référence de coûts. Nous vous conseillons d’accéder à qwen3.8-max via APIYI (apiyi.com) : la plateforme propose une interface unifiée compatible OpenAI et un crédit de test gratuit. Quand le nouveau modèle sortira, vous pourrez le comparer directement avec le même code.
📚 Références
- Liste des modèles et des tarifs d’APIYI : vérification des modèles disponibles au 2026-11-12
- Lien :
api.apiyi.com/api/pricing -
Description : sert à confirmer les modèles Qwen actuellement disponibles à la facturation à l’usage
-
Documentation des modèles d’APIYI : détails de facturation de qwen3.8-max
- Lien :
docs.apiyi.com/models - Description : contient les tarifs unitaires de qwen3.8-max pour l’entrée, la sortie et la lecture du cache
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site d’APIYI. Vous trouverez d’autres ressources sur l’intégration de modèles dans le centre de documentation d’APIYI.