Note de l’auteur : un modèle qui « devient moins performant » n’a pas forcément été remplacé. À partir des derniers travaux d’Anthropic sur la preuve d’inférence avec FlashProve, cet article propose un ordre de vérification, du côté de l’appelant jusqu’au serveur, pour comprendre ce qui peut affecter les résultats d’un appel API.
« Le site officiel résout ce problème, mais l’appel API bloque sur la même question », « le modèle est clairement devenu moins bon ce mois-ci » : presque tous les développeurs qui intègrent un grand modèle de langage par API ont déjà entendu ce genre de plainte. Et souvent, leur première réaction est : est-ce que le modèle a été remplacé en coulisses ?
Anthropic a récemment publié FlashProve, un prototype de recherche open source qui utilise des preuves cryptographiques pour vérifier si « cette réponse provient bien d’un ensemble de poids donné ». Pour la première fois, la question d’un éventuel remplacement du modèle peut ainsi être abordée par une vérification mathématique.
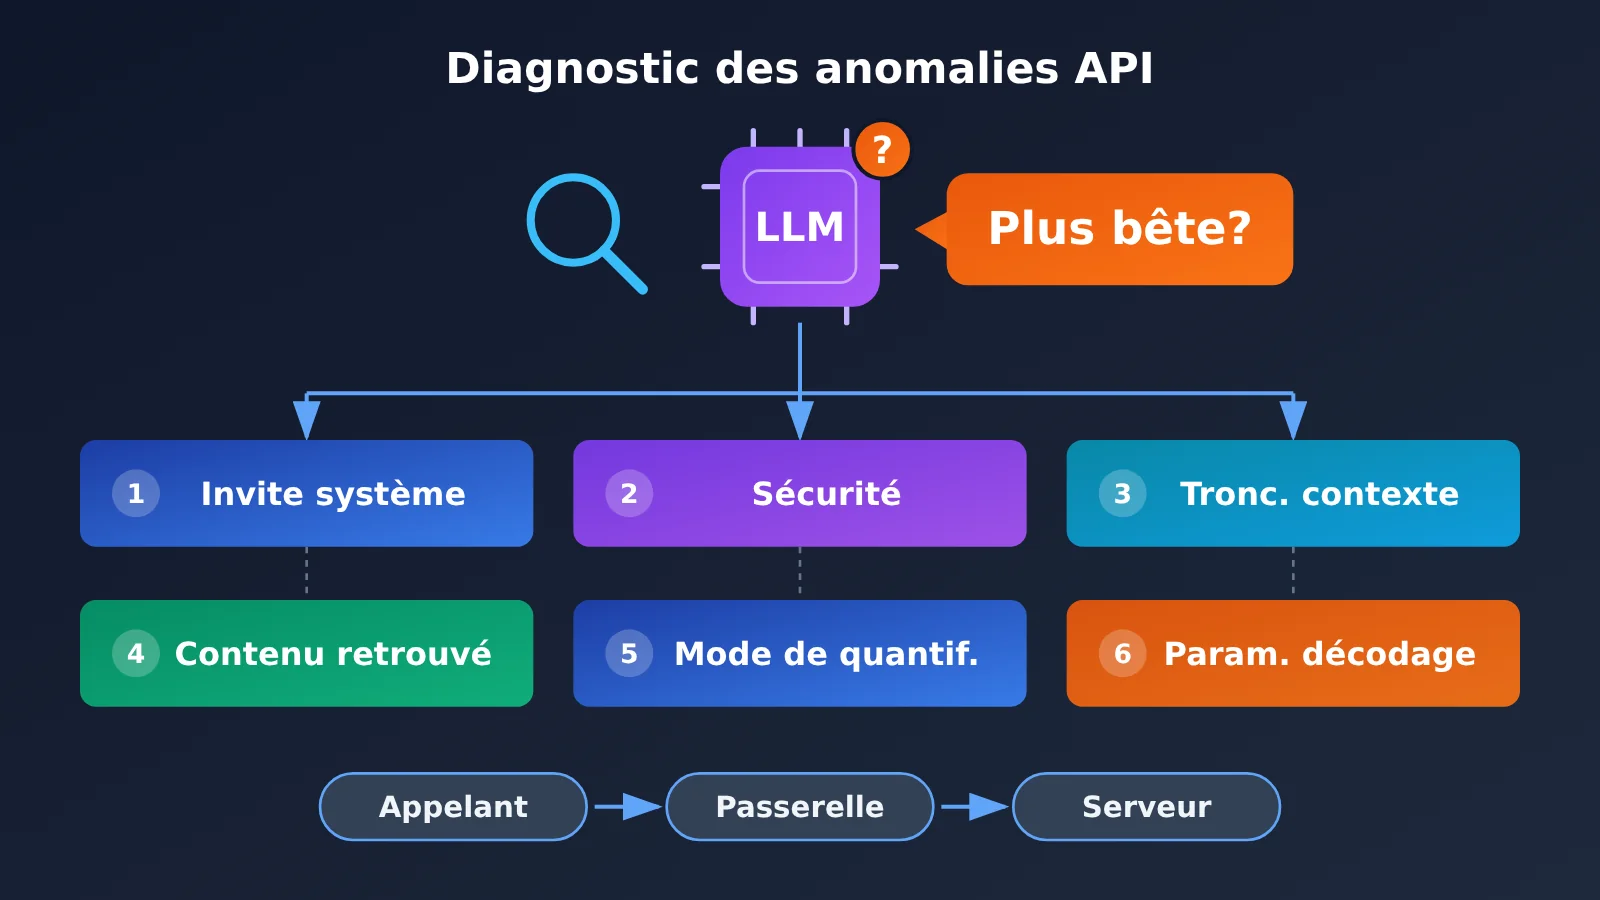
Mais cela ne suffit pas à expliquer pourquoi un modèle semble moins performant. Les travaux le précisent : même une fois l’identité des poids confirmée, l’invite système, les politiques de sécurité, la troncature du contexte, les contenus récupérés, la méthode de quantification et les paramètres de décodage peuvent tous influencer le résultat final. L’expérience de l’équipe Kimi montre aussi qu’une part importante des anomalies dans les scores de référence vient en réalité d’une mauvaise utilisation des paramètres de décodage.
À retenir : à la fin de cet article, vous disposerez d’une liste de vérifications à suivre lorsqu’un modèle semble moins performant. Vous saurez quels problèmes examiner vous-même, lesquels nécessitent l’aide du fournisseur et pourquoi « poser quelques questions pour identifier le modèle » n’est pas une méthode fiable.
Le modèle est devenu moins performant : l’essentiel pour mener l’enquête
Commençons par situer le contexte. La discussion est née d’une recherche d’Anthropic sur le « raisonnement vérifiable ». Elle soulève une question centrale dans la communauté : quand un modèle devient moins performant, à qui la faute ?
| Élément | Détails |
|---|---|
| Publication | Équipe de recherche d’Anthropic, avec le code, le rapport technique et la preuve formelle Lean |
| Principe | FlashProve : des preuves cryptographiques de l’inférence du modèle, fondées sur les preuves à divulgation nulle de connaissance zkSNARK |
| Problème résolu | Vérifier qu’une sortie provient bien des poids annoncés, sans les divulguer ni obliger l’utilisateur à réexécuter le modèle |
| Limites | Les changements au niveau du produit : invite système, politiques de sécurité, contexte, paramètres de décodage, etc. |
| À retenir pour les développeurs | En cas de résultats inhabituels, examiner chaque niveau du service plutôt que de se concentrer uniquement sur un éventuel « remplacement » du modèle |
Comment FlashProve vérifie l’identité du modèle
FlashProve fonctionne en deux étapes. Le fournisseur génère d’abord un « engagement » sur les poids du modèle : une sorte d’empreinte cryptographique qui identifie les poids de façon unique, sans les révéler. Il produit ensuite une preuve pour une entrée et une sortie données. Avec cet engagement, l’invite, la réponse et le fichier de preuve, l’utilisateur peut vérifier sur son ordinateur que la sortie a bien été calculée à partir des poids identifiés.
La conception à divulgation nulle de connaissance garantit que la personne qui vérifie n’obtient ni les poids ni les valeurs intermédiaires du calcul. Elle ne voit pas non plus quels experts ont été sollicités à chaque couche d’un modèle MoE. C’est bien plus fiable que de « demander au modèle de s’identifier » : le nom du modèle indiqué dans sa réponse ne sert plus de preuve d’identité. Ce qui est vérifié, c’est la relation de calcul entre la sortie et les poids.
Anthropic a mené ses expériences avec Llama 4 Maverick, dont les poids 4 bits sont publics. Ce modèle à mélange d’experts compte environ 400 milliards de paramètres, dont environ 17 milliards sont activés pour chaque token. Voici les principaux résultats publiés :
| Indicateur | Résultat expérimental | Précision |
|---|---|---|
| Débit de génération des preuves | Environ 110 tokens/seconde sur une seule H100 | Il s’agit de la vitesse de génération des preuves, pas de celle des réponses |
| Taille du fichier de preuve | Environ 19 Mo par requête de 1 024 tokens | Le fichier doit être transmis avec la réponse |
| Temps de vérification | Environ 17 secondes sur un CPU à 24 threads | Pas besoin de GPU : un ordinateur portable suffit |
| Génération de l’engagement sur les poids | Environ 39 minutes | Une seule génération est nécessaire |
| Coût supplémentaire | Temps GPU environ 70 à 95 fois supérieur à celui d’une inférence vLLM ordinaire | Une adoption à grande échelle reste encore lointaine |
Pourquoi le modèle peut devenir moins performant même si les poids sont confirmés
FlashProve repose sur une condition essentielle : l’utilisateur doit connaître à l’avance l’engagement correspondant au « véritable modèle ». Si le fournisseur peut seulement prouver que la réponse provient d’un modèle qu’il a lui-même choisi, mais que l’utilisateur ne peut pas confirmer qu’il s’agit bien de celui qu’il a acheté, la preuve ne résout toujours pas le problème d’identité. Dans l’idéal, le fabricant du modèle ou un organisme de confiance publierait cet engagement, et l’utilisateur vérifierait systématiquement cette empreinte.
Plus important encore : des poids inchangés ne signifient pas que le service est resté identique. Une preuve liée aux poids ne permet pas, à elle seule, de savoir si l’invite système a été modifiée, si le contexte a été tronqué ou si les paramètres de décodage sont restés les mêmes. C’est pour cela que les plaintes sur la baisse de performance des modèles persistent : elles résultent souvent de plusieurs facteurs combinés.
Les 6 causes fréquentes d’une baisse apparente des performances d’un modèle
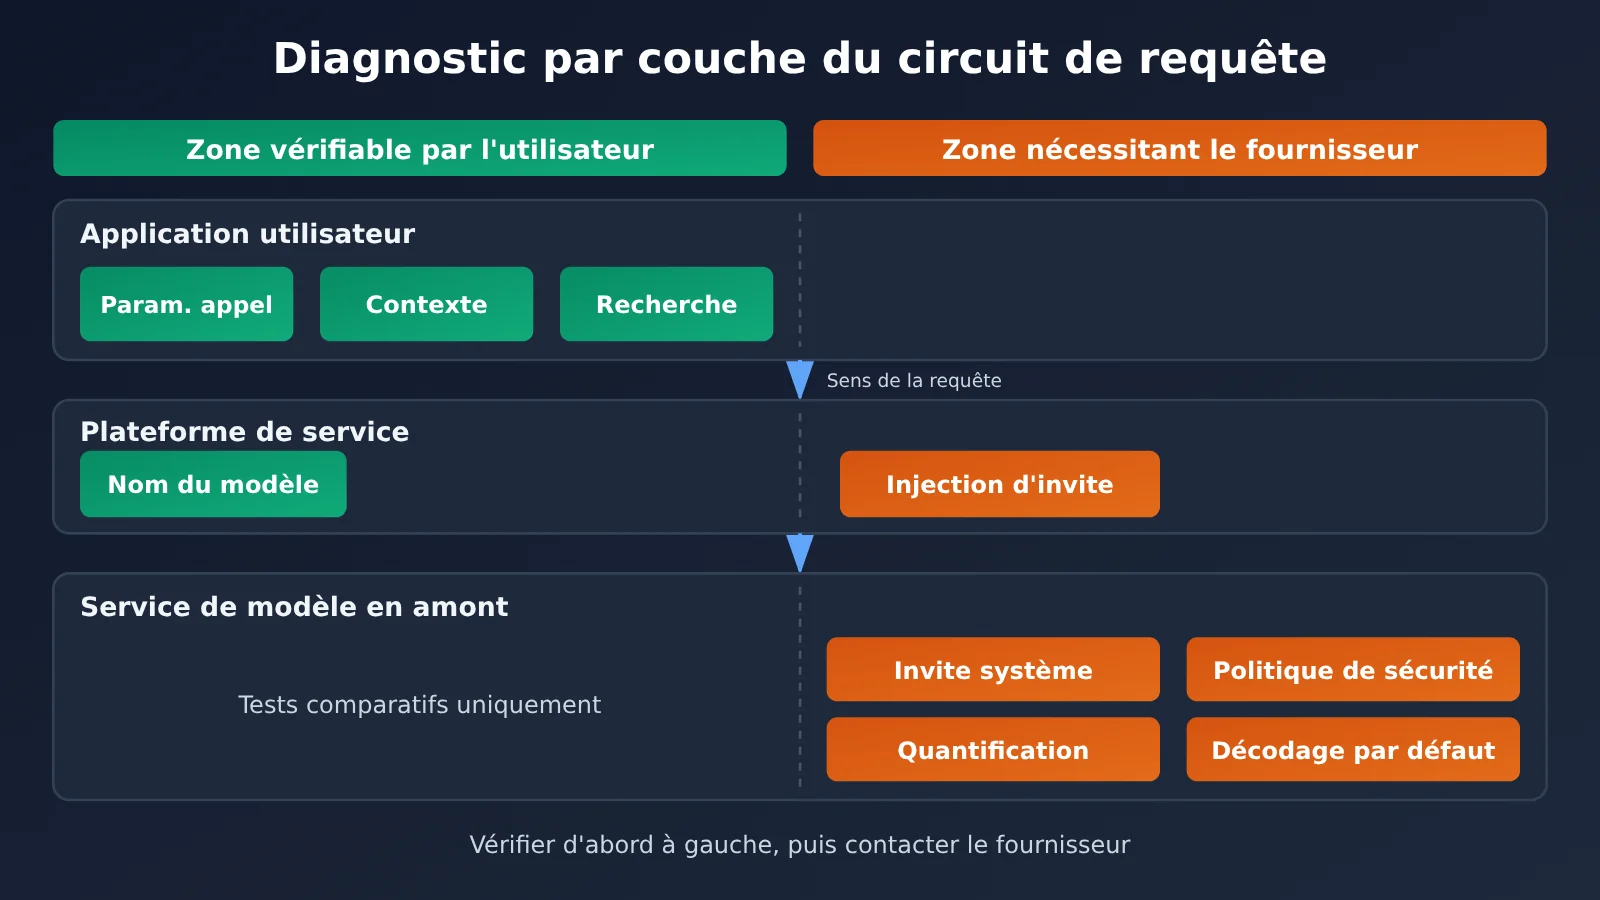
En examinant les facteurs recensés dans l’étude de référence et en les classant selon l’endroit où le problème peut survenir, on constate qu’une bonne partie dépend en fait de l’application qui appelle le modèle.
| Facteur | Symptômes typiques | Origine possible | Vérification par l’utilisateur |
|---|---|---|---|
| Paramètres de décodage | Réponses qui partent dans tous les sens ou se répètent, scores plus faibles en mode raisonnement | Principalement côté appelant, mais le serveur peut aussi définir des valeurs par défaut | Oui, en vérifiant les paramètres de la requête |
| Troncature du contexte | « Oubli » des échanges précédents, réponses incomplètes, instructions ignorées | Côté appelant ou serveur | En partie, en vérifiant le nombre de tokens utilisés |
| Invite système | Changement de style, refus plus fréquents, format incorrect | Injectée côté appelant ou serveur | Vérifiable côté appelant, mais pas côté serveur |
| Politique de sécurité | Certaines questions sont soudainement refusées ou reçoivent des réponses plus prudentes | Principalement côté serveur | Difficile, nécessite des explications du fournisseur |
| Contenu récupéré | Qualité des réponses variable dans un système RAG | Chaîne de récupération côté appelant | Oui, en examinant les contenus récupérés |
| Méthode de quantification | Légère baisse des capacités générales, davantage d’erreurs dans les raisonnements longs | Déploiement côté serveur | Non, nécessite la coopération du fournisseur |
Paramètres de décodage mal utilisés : une cause facile à négliger
Lors de la présentation de Kimi Vendor Verifier, l’équipe Kimi a partagé une observation révélatrice : après la sortie de K2 Thinking, elle a reçu de nombreux signalements de scores anormaux de la part de la communauté. Son enquête a confirmé qu’une part importante provenait d’une mauvaise utilisation des paramètres de décodage. L’équipe a ensuite imposé des contraintes sur ces paramètres en mode Thinking et vérifié que le contenu du raisonnement était correctement renvoyé.
La leçon pour les développeurs est simple : si temperature, top_p, max_tokens ou l’activation du mode raisonnement ne correspondent pas aux recommandations officielles, les performances du modèle peuvent s’écarter nettement des attentes. C’est particulièrement vrai pour les modèles de raisonnement : chaque fournisseur a ses propres exigences concernant les paramètres d’échantillonnage, le budget de raisonnement et la manière de renvoyer le contenu du raisonnement dans les conversations à plusieurs tours. Pour les valeurs précises, consultez la documentation officielle de chaque modèle plutôt que de réutiliser les réglages habituels d’un modèle conversationnel classique.
Contexte incomplet : quand le modèle semble « oublier »
Le contexte est une autre source fréquente de problèmes. Dans une conversation à plusieurs tours, si seule la dernière phrase est transmise, le modèle ne peut naturellement pas « se souvenir » des échanges précédents. Dans un workflow, si l’historique des messages dépasse la fenêtre de contexte du modèle, les premières instructions système sont souvent les premières à être tronquées. Le modèle peut alors cesser soudainement de respecter le format demandé. Par ailleurs, une valeur max_tokens trop faible peut couper la réponse en cours de route : le modèle « s’arrête au milieu de sa réponse ».
Tous ces problèmes peuvent donner l’impression que le modèle est devenu moins performant. Pourtant, en vérifiant le corps de la requête et la raison de fin indiquée dans la réponse, on peut la plupart du temps en trouver la cause immédiatement.
Votre modèle semble moins performant ? Vérifiez ces 3 points dans l’ordre
Les causes possibles se situent à différents niveaux de la chaîne d’appel. Commencez donc par les vérifications les moins coûteuses et les plus faciles à maîtriser :
- Vérifiez d’abord votre configuration : contrôlez le nom du modèle, les paramètres de décodage,
max_tokens, l’invite système, la liste complète des messages et les contenus récupérés par le RAG. - Faites ensuite un test comparatif : gardez les mêmes paramètres et la même invite, puis comparez les résultats avec ceux du canal officiel ou avec les performances décrites dans la documentation officielle. Répétez le test pour observer la distribution des résultats plutôt que de vous fier à une seule réponse.
- Examinez enfin le service : si votre configuration est correcte et que l’écart observé reste stable et reproductible, contactez le fournisseur avec les journaux de requêtes et les résultats de vos tests.
Exemple minimaliste : un appel reproductible avec des paramètres fixes
Pour commencer, le plus pratique est de définir explicitement tous les paramètres, sans dépendre des valeurs par défaut, puis d’afficher la raison de fin et le nombre de tokens utilisés :
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Remplacez par le nom du modèle à examiner
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
Si finish_reason vaut length, la réponse a été tronquée par max_tokens. Dans ce cas, si elle est incomplète, ce n’est pas que le modèle est devenu moins performant : c’est un problème de paramétrage. Le nombre de tokens d’entrée dans usage permet aussi de vérifier si tout le contexte a bien été transmis.
Voir le script complet de test comparatif
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Pour changer de modèle, il suffit de modifier le paramètre model
)

# Définir explicitement tous les paramètres pour éviter de dépendre des valeurs par défaut
PARAMS = {
    "temperature": 0.2,   # Pour les modèles de raisonnement, utilisez la valeur recommandée dans la documentation officielle
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """Exécuter plusieurs fois le même cas et relever le taux de réussite, les troncatures et l'utilisation des tokens."""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # Remplacez par le modèle à examiner
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
L’intérêt de ce script ne tient pas tant aux questions de test qu’à trois points : tous les paramètres sont fixes et inclus dans le rapport, chaque cas est exécuté plusieurs fois pour mesurer le taux de réussite, et finish_reason ainsi que prompt_tokens sont relevés pour écarter les problèmes de troncature et de contexte. Ce n’est qu’une fois ces trois points vérifiés qu’il devient pertinent de se demander si quelque chose a changé côté serveur.
🚀 Conseil de diagnostic : APIYI apiyi.com utilise une interface compatible avec OpenAI. Pour changer de modèle, il suffit de modifier le paramètre
model, ce qui permet de comparer plusieurs modèles avec le même script de test. La plateforme propose des journaux d’appels et des statistiques d’utilisation pour examiner la consommation des requêtes et le nombre de tokens utilisés, et ainsi aider à vérifier si le contexte a été transmis en entier. Pour connaître les champs effectivement affichés dans les journaux, consultez la console de la plateforme.
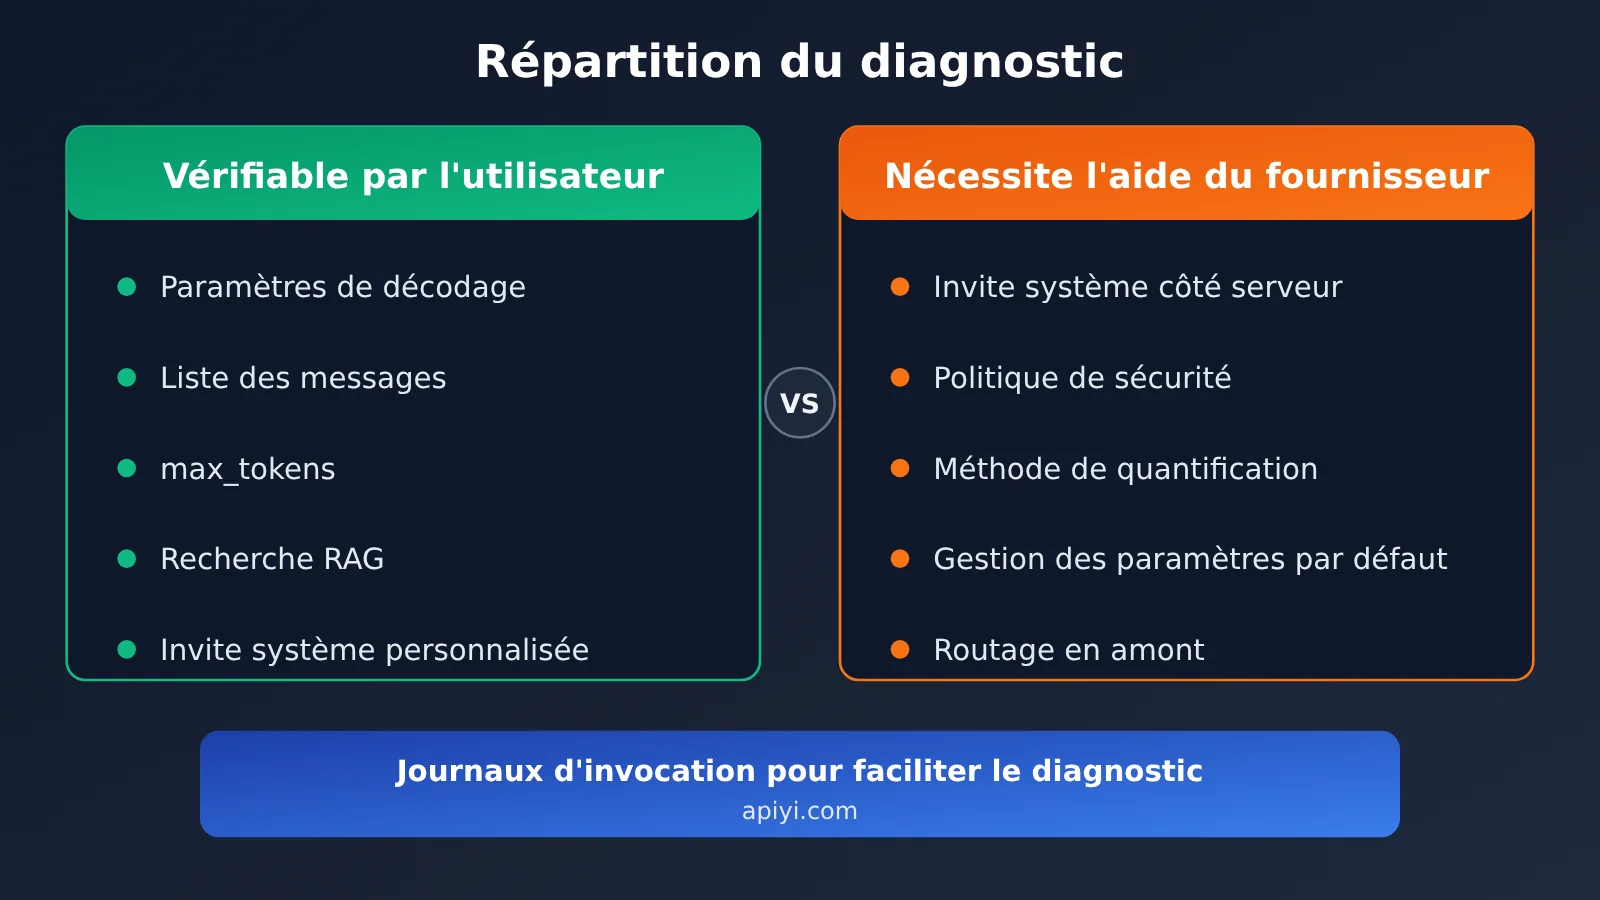
Répartition des vérifications entre l’utilisateur et le fournisseur
| Point à vérifier | Vérification par l’utilisateur | Informations à demander au fournisseur |
|---|---|---|
| Paramètres de décodage | Afficher le corps complet de la requête et le comparer à la documentation officielle | La plateforme modifie-t-elle les paramètres ou leur attribue-t-elle des valeurs par défaut ? |
| Intégrité du contexte | Vérifier la liste des messages et prompt_tokens | Y a-t-il une troncature côté serveur ou une limite de fenêtre de contexte ? |
| Mode de raisonnement | Vérifier l’activation du raisonnement et la façon dont son contenu est renvoyé | Le service en amont prend-il en charge les paramètres correspondants ? |
| Quantification et déploiement | Impossible à vérifier soi-même | Précision du déploiement et détails sur le canal en amont |
| Politiques de sécurité | Comparer le résultat d’une même requête via le canal officiel | Des règles de modération supplémentaires sont-elles appliquées ? |
Pour contacter le fournisseur, préparez un exemple de requête avec des paramètres fixes, les statistiques de plusieurs exécutions et des données de comparaison. Les échanges seront bien plus efficaces. Dire simplement « le modèle est devenu moins performant » ne l’aidera pas beaucoup à localiser le problème.
Pourquoi quelques questions ne suffisent pas à déterminer si un modèle est devenu moins performant
Dans la communauté, une méthode populaire consiste à poser au modèle une question dont seule la nouvelle version connaît la réponse. S’il échoue, on conclut que le modèle a été remplacé. Le problème, c’est qu’une réponse isolée comporte une part d’aléatoire : une erreur ponctuelle, des paramètres différents, un contexte incomplet ou une différence de routage interne chez le fournisseur peuvent tous donner la même impression : « Ce n’est pas le modèle que je voulais. »
Le projet de recherche Model Equality Testing, mené à l’université Stanford, propose une approche plus rigoureuse. Les chercheurs ont testé 31 points d’accès API commerciaux pour quatre modèles Llama de 2024. Ils ont constaté que, pour 11 de ces points d’accès, la distribution des réponses présentait un écart statistique par rapport à la distribution de référence obtenue à partir des poids publiés par Meta. Ici, la méthode compare des « distributions » de réponses, et non la justesse d’une ou deux réponses.
Pour les développeurs, l’idée à retenir est statistique : utiliser des paramètres fixes, plusieurs cas de test et plusieurs exécutions pour repérer des écarts persistants. C’est aussi pourquoi le script de comparaison présenté plus haut utilise un « taux de réussite » plutôt qu’un « résultat unique ».
Analyse des conséquences d’une baisse de performance du modèle
Pour les développeurs
- Commencer le diagnostic plus tôt : en cas de résultat anormal, vérifiez d’abord le corps de votre requête. Une mauvaise utilisation des paramètres ou un contexte incomplet sont les pistes les moins coûteuses et les plus susceptibles d’aboutir.
- Définir explicitement les paramètres : en production, ne dépendez d’aucune valeur par défaut. Configurez particulièrement les modèles de raisonnement selon la documentation officielle et intégrez les paramètres au contrôle de version.
- Créer un jeu de tests de régression : exécutez régulièrement un ensemble de cas fixes pour disposer de données, plutôt que d’une simple impression, si le modèle semble moins performant.
- Conserver les journaux d’invocation : les paramètres de requête, le nombre de tokens consommés et le motif de fin sont des éléments essentiels pour échanger avec le fournisseur.
Pour le secteur
- Passer de l’impression à la preuve : FlashProve montre qu’il est possible de vérifier l’identité des poids. À l’avenir, les fournisseurs de modèles, les organismes d’évaluation et les autorités de régulation pourraient s’en servir pour confirmer quel modèle est réellement utilisé par un service.
- Élargir les exigences de transparence : au-delà des poids, la cohérence des invites système, des stratégies de décodage et des configurations de déploiement pourrait devenir le prochain sujet central.
- Une adoption qui prendra du temps : le coût de la preuve représente plusieurs dizaines de fois celui d’une inférence ordinaire. Il faut aussi prendre en charge des contextes plus longs et disposer d’un mécanisme fiable de publication des engagements. Une couverture des invocations courantes reste donc peu probable à court terme.
Questions fréquentes (FAQ)
Q1 : Si un modèle semble moins performant, que faut-il vérifier en premier ?
Commencez par vérifier votre requête : le nom du modèle est-il correct ? Les paramètres de décodage, comme temperature, respectent-ils les recommandations officielles ? La valeur de max_tokens est-elle trop faible ? L’historique complet est-il bien transmis dans les conversations à plusieurs tours ? D’après l’expérience de l’équipe Kimi, une part importante des anomalies dans les scores provient d’une mauvaise utilisation des paramètres de décodage. C’est donc souvent la première vérification utile.
Q2 : FlashProve peut-il mettre fin au débat sur la baisse de performance des modèles ?
Non. Il peut vérifier qu’une sortie provient des poids indiqués, à condition de disposer d’un engagement fiable sur le modèle pour servir de référence. Une preuve des poids ne couvre pas automatiquement les invites système, les politiques de sécurité, la troncature du contexte, la méthode de quantification ou les paramètres de décodage.
Q3 : Comment réaliser un test comparatif fiable ?
Fixez tous les paramètres et les invites, préparez plusieurs cas de test avec des réponses clairement établies, puis exécutez chaque cas plusieurs fois pour calculer le taux de réussite. Consignez aussi finish_reason et la consommation de tokens. Avec APIYI apiyi.com, vous pouvez comparer plusieurs modèles à l’aide du même code compatible OpenAI. Les nouveaux utilisateurs disposent d’un crédit de test gratuit pour ce type de vérification.
Q4 : Pourquoi un modèle de raisonnement peut-il être moins performant via l’API que sur la version Web ?
Parmi les causes courantes : le mode de réflexion n’est pas activé, le budget de réflexion est différent, les paramètres d’échantillonnage ne suivent pas les recommandations officielles, le contenu de réflexion n’est pas correctement retransmis dans les conversations à plusieurs tours, ou encore les invites système et les outils intégrés à la version Web ne sont pas présents dans l’API. Vérifiez chaque point dans la documentation API officielle du modèle.
Q5 : Une fois les vérifications effectuées, comment communiquer avec le fournisseur ?
Préparez des exemples de requêtes aux paramètres fixes, les résultats statistiques de plusieurs exécutions, des données de comparaison avec les canaux officiels et les périodes pendant lesquelles les anomalies se sont produites. Dans la console APIYI apiyi.com, vous pouvez consulter les journaux d’invocation et les statistiques d’utilisation. Fournir aussi les enregistrements correspondants peut réduire nettement le temps nécessaire pour cerner le problème.
Points clés pour diagnostiquer un modèle qui semble moins performant
- Une baisse de performance ne signifie pas forcément que le modèle a été remplacé : l’invite système, le contexte et les paramètres de décodage peuvent aussi modifier les résultats.
- Les erreurs de paramétrage sont fréquentes : l’équipe Kimi a confirmé qu’une part importante des résultats anormaux aux tests provenait d’une mauvaise utilisation des paramètres de décodage.
- Le diagnostic doit se faire par étapes : vérifiez d’abord la configuration côté client, puis effectuez des tests comparatifs avant d’examiner un éventuel problème côté serveur.
- Une seule question ne suffit pas pour trancher : comparez la distribution des résultats sur plusieurs exécutions plutôt que de juger sur une ou deux réponses.
- La preuve des poids a ses limites : FlashProve vérifie uniquement l’identité des poids, pas les changements de configuration au niveau du produit.
- Les outils de test doivent être uniformisés : l’interface compatible et les journaux d’APIYI apiyi.com peuvent faciliter les comparaisons entre modèles.
Conclusion
Jusqu’ici, les discussions sur les modèles qui semblaient moins performants reposaient surtout sur des captures d’écran et des impressions. FlashProve d’Anthropic offre une piste vérifiable pour déterminer si un modèle a été remplacé. Mais il nous rappelle aussi qu’au-delà des poids, toute une couche de configuration peut influencer les résultats.
- Vérifiez d’abord votre configuration : les paramètres de décodage, max_tokens, la liste des messages et les contenus récupérés par le RAG sont les points de départ les plus simples à examiner.
- Comparez ensuite les résultats : utilisez des paramètres fixes, plusieurs cas de test et plusieurs exécutions pour comparer vos résultats aux performances officielles. Appuyez-vous sur les données plutôt que sur vos impressions.
- Contactez enfin le fournisseur : une fois la configuration côté client vérifiée, transmettez-lui les journaux de requêtes et les résultats statistiques pour l’aider à cerner un éventuel problème côté serveur.
Intégrez le script comparatif de cet article à vos tests de régression habituels. APIYI apiyi.com permet de vérifier rapidement les performances de plusieurs modèles avec le même code, grâce à une interface unifiée compatible avec OpenAI et à un crédit gratuit pour les tests.
📚 Références
- 36氪 / APPSO – Analyse de la recherche d’Anthropic sur l’inférence vérifiable : principes de FlashProve, données expérimentales et discussion des causes de la dégradation des performances
- Lien :
36kr.com/p/4056019887510401 -
Description : principale source des faits et données de cet article, avec une présentation de Kimi Vendor Verifier et de Model Equality Testing
-
Anthropic Research – Provable Inference : page officielle de recherche sur FlashProve
- Lien :
anthropic.com/research/provable-inference - Description : accès au rapport technique, au code open source et aux preuves formelles
Auteur : équipe technique APIYI
Échanges techniques : si vous rencontrez des difficultés pour diagnostiquer des résultats inhabituels lors de vos appels, contactez-nous depuis la page d’accueil du site APIYI apiyi.com. Pour en savoir plus sur l’intégration, consultez le centre de documentation docs.apiyi.com.