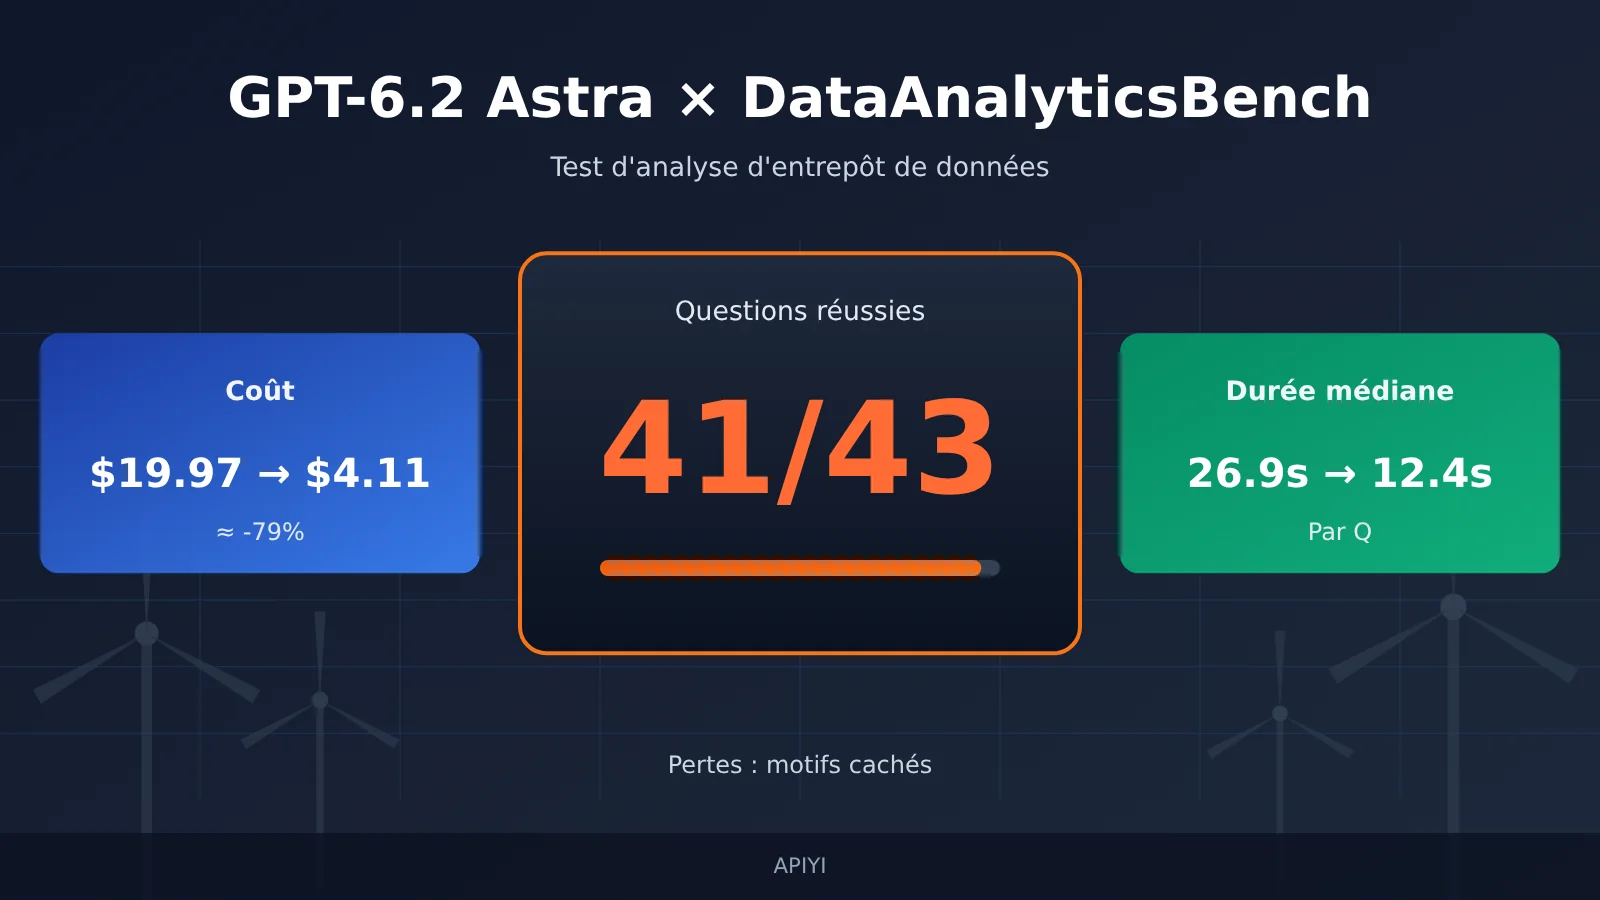
Conclusion principale : Lors du test DataAnalyticsBench mené par Plotly, GPT-6.2 Astra réussit 41 exercices sur les 43 exercices d’analyse de données. Le score de la génération précédente, GPT-6 Astra, était de 43/43. Les deux échecs portent tous deux sur les questions à régularités cachées ; les cinq autres catégories de questions ont toutes été réussies. En parallèle, le coût de la session complète est passé de $19.97 à $4.11, et le temps médian par question de 26.9 secondes à 12.4 secondes. La nouvelle génération d’Astra échange ainsi deux questions contre un coût inférieur au quart de celui de la génération précédente et un temps d’attente inférieur à la moitié. Mais savoir si elle a réellement régressé dans la recherche proactive d’anomalies reste une question ouverte : avec une seule série de données, il faudra refaire le test avec vos propres données.
Ce que vous apprendrez en lisant cet article :
- Ce que mesure DataAnalyticsBench, comment le score est attribué et où se situent les limites d’un score de 41/43.
- Le score détaillé par catégorie pour les six types de questions, et comment les deux questions concernées ont été manquées.
- Les deux sources de la baisse d’environ 79 % des coûts — réduction des tarifs et baisse de la charge de travail — et la part qui revient à chacune.
- Les compromis entre GPT-6.2 Astra et GPT-6 Astra, GPT-6.1 Sol et GPT-6.2 Sol en matière de score, de coût et de latence.
- Une méthode de re-test directement adaptable, avec du code Python, pour vérifier ces conclusions sur votre propre entrepôt de données.
Sommaire : Le tableau To Know explique les concepts propres à l’évaluation, tandis que l’aperçu des impacts résume, par public, ce que cette actualité signifie. La partie « Faits objectifs » présente successivement l’environnement de test et les règles d’attribution des scores, les résultats des six catégories de questions, les données de coût et de durée, ainsi que l’identité officielle du modèle et la base tarifaire officielle d’OpenAI. La partie « Analyse et interprétation » décrypte la signification du 41/43, avance des hypothèses pour expliquer les échecs sur les questions de régularités cachées, décompose les sources de la baisse des coûts, puis propose des recommandations de choix de modèle et le code de re-test.
Concepts à connaître avant d’aborder GPT-6.2 Astra DataAnalyticsBench
| Concept | Explication brève |
|---|---|
| DataAnalyticsBench | 43 questions d’analyse d’entrepôt de données conçues par des chercheurs de Plotly et de Mila, qui évaluent la capacité d’analyse d’un modèle sur des données simulées d’exploitation d’un parc éolien |
| Environnement d’exécution du test | Système d’évaluation qui fournit à chaque modèle le même entrepôt de données, ainsi que des outils en lecture seule : interrogation, tracé de graphiques, affichage de tableaux, etc. |
| Règles de notation | Pour chaque question, on définit ce qui constitue une réponse satisfaisante ; la notation est binaire (réussite ou échec), sans points partiels |
| Problèmes de qualité des données | Problèmes dans les données d’entrée (enregistrements manquants, doublons, valeurs aberrantes) qui faussent les conclusions de l’analyse ; ils sont volontairement implantés dans les questions |
| Pièges statistiques | Questions où un algorithme intuitif ou un mode d’agrégation apparemment évident peut conduire à une conclusion erronée |
| Régularités cachées | Schémas anormaux ou causes qu’un énoncé ne signale pas et que le modèle doit aller débusquer de lui-même |
| Temps médian par question | Valeur centrale obtenue après tri des temps réellement écoulés sur les 43 questions ; ce classement inclut le temps des requêtes d’outils |
| Coût de la série complète | Somme des coûts d’appel d’un même modèle pour réaliser l’ensemble des 43 questions |
| Hits de cache | Partie des tokens d’entrée constituée de préfixes répétés mis en cache côté serveur et facturés à un tarif unitaire réduit |
Aperçu de l’impact des scores GPT-6.2 Astra DataAnalyticsBench selon les profils
- Ceux qui choisissent les API : le coût unitaire et la vitesse de réponse de GPT-6.2 Astra se sont nettement améliorés, on peut donc le privilégier pour des tâches comme les rapports standard ou la clarification des définitions. En revanche, pour les tâches de diagnostic d’anomalies, mieux vaut ne pas reprendre directement les conclusions du classement.
- Développeurs de produits data : pour des produits comme le « questionnement en langage naturel » ou les assistants BI, diviser par deux la latence médiane change beaucoup l’expérience d’interaction. Il faut toutefois évaluer séparément la « patience » du modèle sur les explorations multi-tours et, si nécessaire, imposer des étapes de vérification supplémentaires dans l’invite ou le flux de travail.
- Équipes d’analyse : on peut considérer le modèle comme un analyste de premier jet plus rapide, mais les conclusions issues d’enquêtes sur les causes racines nécessitent encore une vérification humaine. Avec des interfaces agrégées compatibles OpenAI comme APIYI apiyi.com, on peut basculer entre quatre modèles dans le même code pour des tests comparatifs.
Les faits objectifs sur GPT-6.2 Astra DataAnalyticsBench
Scénarios de test et règles de notation de GPT-6.2 Astra
DataAnalyticsBench, conçu par des chercheurs de Plotly et de Mila, repose sur un entrepôt de données simulé pour l’exploitation éolienne. Cet entrepôt contient 44 tables, environ 19,9 millions de lignes et 554 colonnes, couvrant la télémétrie des équipements, les alarmes, les tickets de travail, les inspections et la météo. Chaque question s’exécute dans Plotly Studio Embedded, avec un appel au modèle via OpenRouter. Le modèle ne dispose que de quatre outils, tous en lecture seule : lister les jeux de données, exécuter du SQL, tracer un graphique et afficher une table.
Le modèle décide lui-même de son parcours de requête et du moment où il répond ; l’équipe de test ne planifie pas les étapes à sa place. L’évaluation ne porte donc pas uniquement sur la rédaction du SQL, mais aussi sur le jugement consistant à savoir « jusqu’où aller dans les requêtes avant de répondre ».
Pour la notation, chaque question est jugée conforme ou non au corrigé et aux règles de notation, sans points partiels. Le modèle-juge est Claude Sonnet 5, avec une température fixée à 0. Les organisateurs génèrent les réponses de manière indépendante en SQL, pandas et Polars, puis les recoupent ; ils examinent aussi manuellement les trajectoires échouées et auditent les résultats parfaits. Deux catégories de questions particulières ont des critères de réussite explicites :
- Question ambiguë : le modèle réussit s’il demande une clarification, ou s’il explicite ses hypothèses et propose une solution alternative.
- Question à laquelle les données ne permettent pas de répondre : il suffit d’indiquer précisément les limites des données disponibles.
Le corpus a également des frontières bien définies : un seul domaine métier (l’exploitation éolienne), l’anglais, un même environnement de test, et une seule passe par modèle. Les questions, les données et les corrigés sont conservés par les organisateurs et ne sont pas rendus publics.
Source : Plotly, Introducing DataAnalyticsBench, publié le 2026-10-14, mis à jour le 2026-11-19, plotly.com/blog/introducing-dataanalyticsbench/
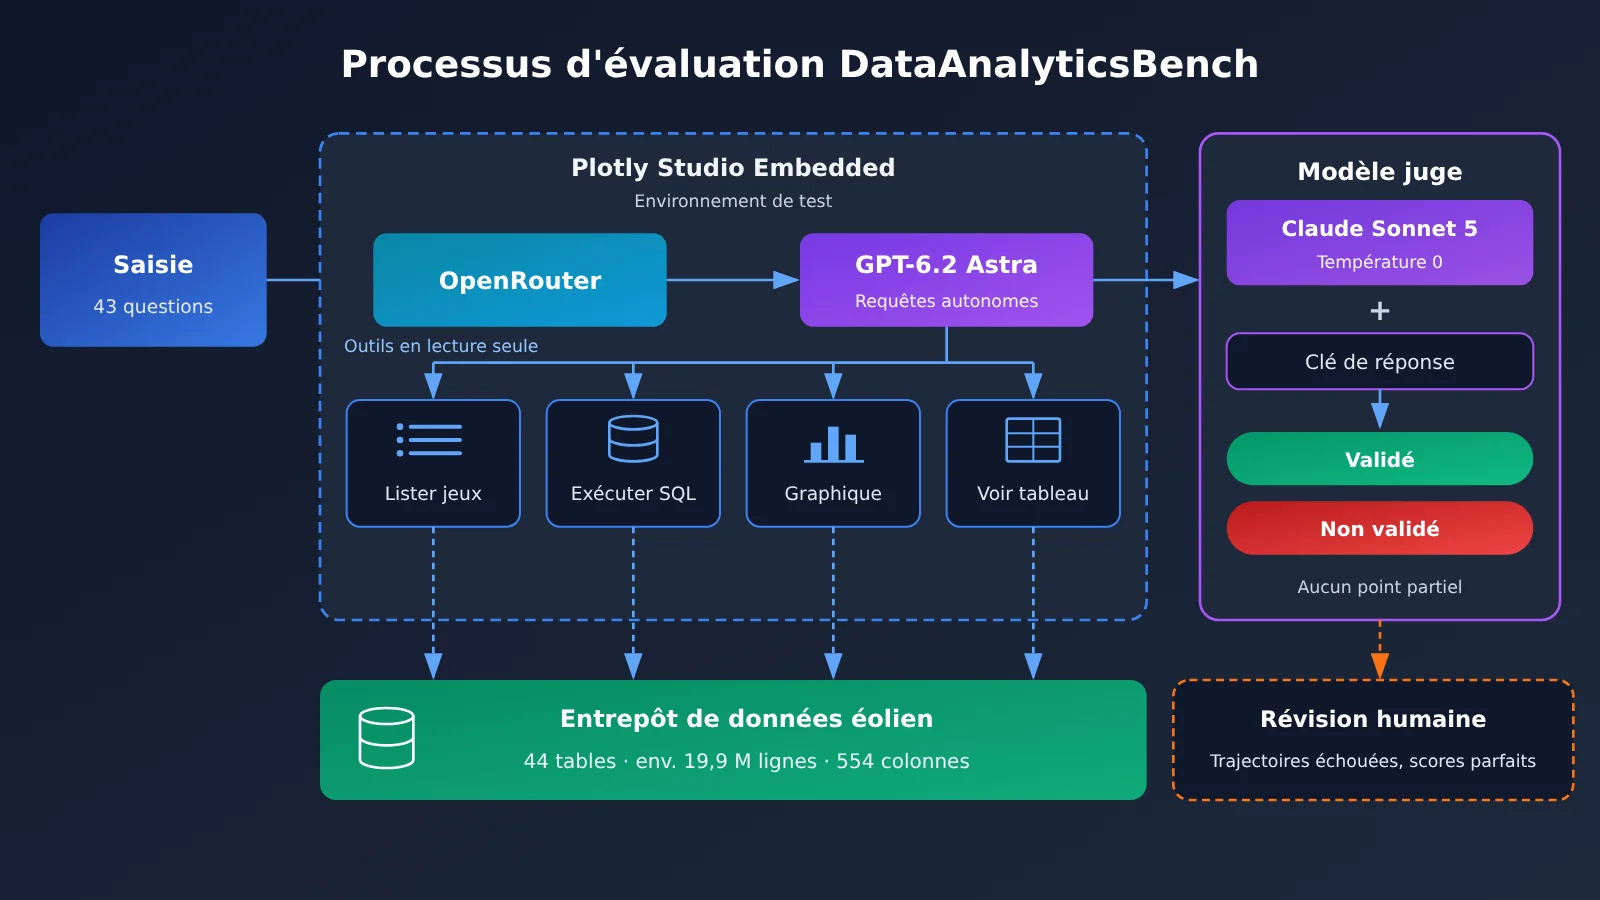
Note sur le schéma : cette structure — planification autonome des requêtes par le modèle, outils en lecture seule, validation binaire question par question — peut être reproduite approximativement dans votre propre environnement avec l’interface compatible OpenAI d’APIYI apiyi.com, pour des tests comparatifs internes.
Scores de GPT-6.2 Astra sur six catégories de questions : les pertes se concentrent sur les régularités cachées
Le rapport spécial Astra publié par Plotly le 17 novembre 2026 donne les scores par catégorie :
| Catégorie de question | GPT-6.2 Astra | GPT-6 Astra | Point évalué |
|---|---|---|---|
| Analyse standard | 20/20 | 20/20 | SQL multi-étapes, jointures de tables et intervalles temporels |
| Jugement d’ambiguïté | 5/5 | 5/5 | Clarifier les définitions ou expliciter des hypothèses raisonnables |
| Données non répondables | 5/5 | 5/5 | Identifier, à partir des données existantes, les questions sans réponse possible |
| Qualité des données | 3/3 | 3/3 | Détecter les problèmes de qualité introduits |
| Pièges statistiques | 5/5 | 5/5 | Repérer les inductions en erreur que peuvent provoquer des algorithmes intuitifs |
| Régularités cachées | 3/5 | 5/5 | Rechercher activement des régularités anormales non explicitées |
| Total | 41/43 | 43/43 | Chaque question a le même poids, validation question par question |
Les cinq premières catégories totalisent 38/38, les deux générations affichant des performances parfaitement identiques. L’écart provient entièrement des questions de régularités cachées : 3/5 pour la nouvelle génération, 5/5 pour la précédente.
Les deux questions perdues ont toutes deux été revues manuellement par Plotly, avec des modes d’échec différents :
- Dans l’une, le modèle n’est jamais parvenu à localiser la régularité introduite.
- Dans l’autre, le modèle a trouvé le bon endroit à investiguer, mais a écarté la véritable cause.
Le rapport fournit aussi une donnée de processus : sur les questions de régularités cachées, GPT-6.2 Astra exécute en moyenne environ 9 requêtes de base de données par question, contre environ 15 pour GPT-6 Astra.
Source : Plotly, GPT-6.2 Astra Benchmark Results for Data Analysis, 2026-11-17, plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra : coût et temps d’exécution — comparaison entre générations et au sein d’une même gamme
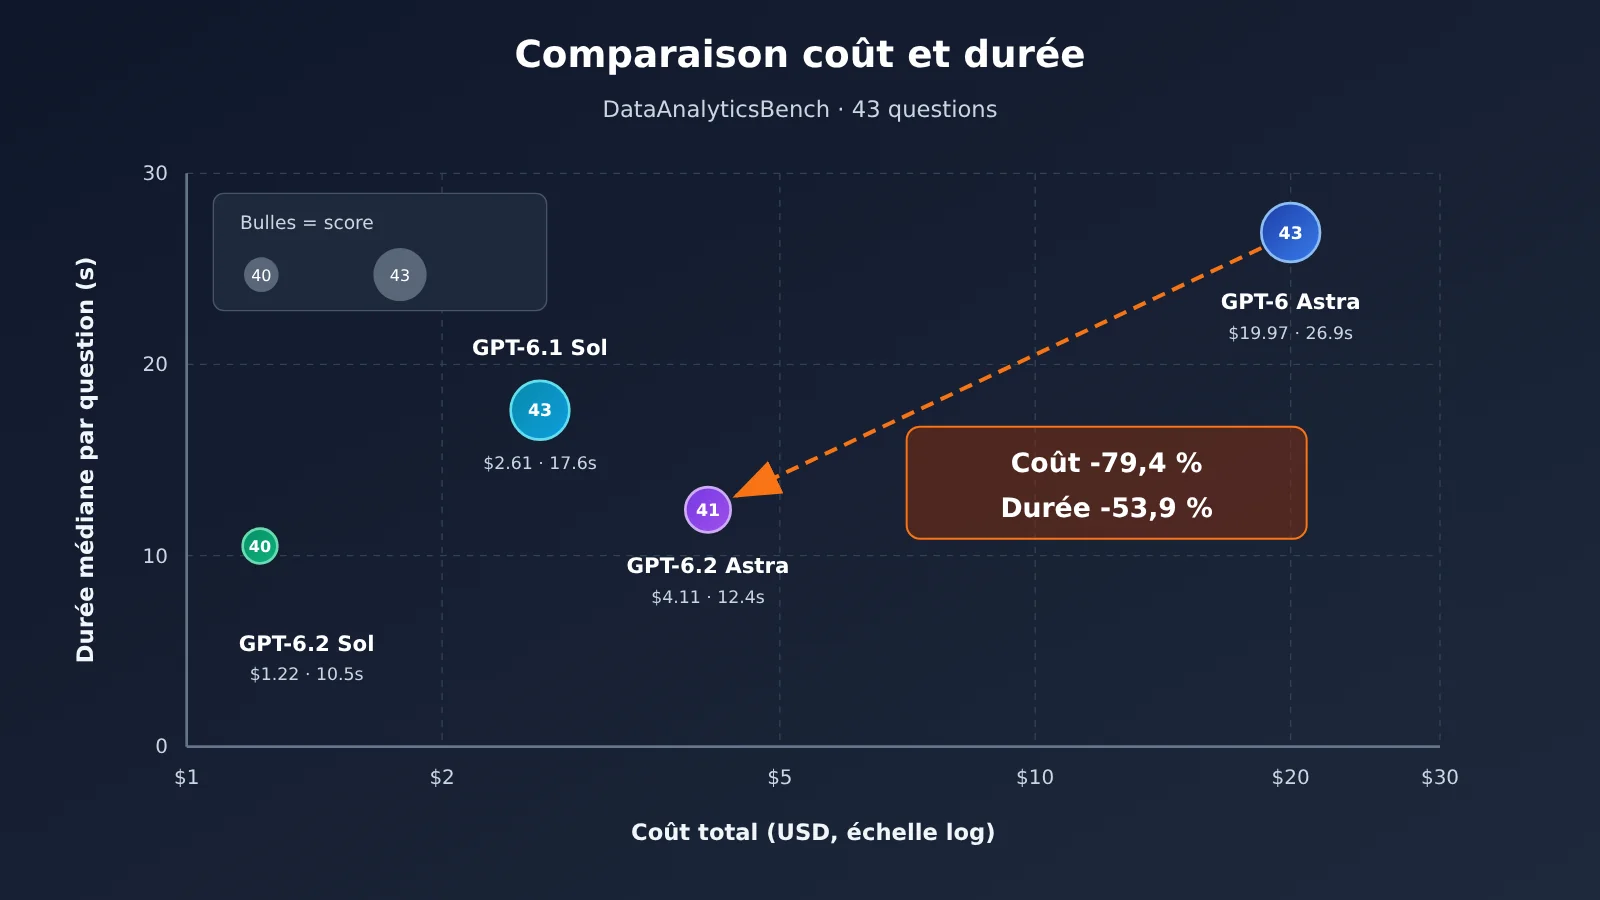
| Modèle | Score | Coût d’une exécution complète | Temps médian par question |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | 4,11 $ | 12,4 s |
| GPT-6 Astra | 43/43 | 19,97 $ | 26,9 s |
| GPT-6.1 Sol | 43/43 | 2,61 $ | 17,6 s |
| GPT-6.2 Sol | 40/43 | 1,22 $ | 10,5 s |
D’après le tableau ci-dessus, le coût d’une exécution complète de GPT-6.2 Astra baisse d’environ 79,4 % par rapport à la génération précédente, et le temps médian par question diminue d’environ 53,9 %. Dans les tests de l’auteur, une exécution complète de 6.2 Astra prend environ 13 minutes, contre environ 32 minutes pour la génération précédente. Le temps indiqué ici est le temps réel écoulé, requêtes d’outils comprises, et non le seul temps d’inférence du modèle.
Le coût par question se lit de deux façons qu’il faut bien distinguer : 4,11 $ ÷ 43 donne environ 0,096 $ par question en moyenne ; le classement général mis à jour affiche en revanche 0,066 $ comme médiane du coût par question pour cette exécution. La moyenne étant supérieure à la médiane, cela signifie que quelques questions coûtent nettement plus cher et tirent la moyenne vers le haut.
Plotly fournit aussi le détail de la charge de travail pour les deux exécutions originales :
| Indicateur de charge | GPT-6 Astra (génération précédente) | GPT-6.2 Astra |
|---|---|---|
| Appels d’outils | 266 | 148 |
| Appels au modèle | 249 | 171 |
| Tokens d’entrée | environ 9,1 millions | environ 4,4 millions |
| Tokens de sortie | environ 78 000 | environ 34 000 |
| Part des entrées servies par le cache | 93 % | 98 % |
En recalculant la consommation identique de la génération précédente aux nouveaux tarifs, Plotly estime un coût d’environ 11 $. À noter : ces coûts proviennent des tarifs OpenRouter en vigueur au moment des tests de Plotly, et non d’une conversion directe depuis la grille tarifaire officielle d’OpenAI.
Source : le rapport dédié de Plotly sur Astra plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/ ; le classement général de Plotly plotly.com/blog/introducing-dataanalyticsbench/#full-results
Identité du modèle GPT-6.2 Astra et référentiel tarifaire officiel
OpenAI a lancé GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Astra est destiné au raisonnement complexe, au codage et aux tâches professionnelles, et son ID de modèle API est gpt-6.2-astra. Les évaluations figurant dans l’annonce d’OpenAI relèvent du référentiel du fournisseur ; le DataAnalyticsBench de Plotly est un autre ensemble d’évaluations, réalisé par un tiers, et les deux ne doivent pas être mélangés.
D’après la fiche modèle, Astra accepte du texte et des images en entrée et produit du texte, avec une fenêtre de contexte de 1 050 000 tokens, un maximum de 922 000 tokens en entrée et de 128 000 tokens en sortie. Il prend en charge à la fois l’API Responses et l’API Chat Completions ; les capacités telles que les outils intégrés, le multi-agent et la fenêtre de complétion en arrière-plan sont définies par l’API Responses. La fiche modèle précise aussi que les requêtes dont reasoning.effort est défini sur none sont rejetées.
Le tarif standard d’OpenAI pour du texte pur en contexte court (par million de tokens) est le suivant : entrée normale 8 $, entrée avec cache hit 0,40 $, sortie 40 $. L’entreprise indique que, par rapport à la génération précédente, le prix unitaire de l’entrée normale et de la sortie baisse de 20 %, et celui de l’entrée avec cache hit de 60 %.
Sources : annonce de lancement OpenAI openai.com/index/introducing-gpt-6-2-astra-sol/ ; fiche modèle developers.openai.com/api/docs/models/gpt-6.2-astra ; journal des modifications de l’API developers.openai.com/api/docs/changelog ; grille tarifaire developers.openai.com/api/docs/pricing
Analyse et évaluation de GPT-6.2 Astra sur DataAnalyticsBench
Comment interpréter 41/43 : pas un « affaiblissement global »
Si l’on décompose le score de 41/43, GPT-6.2 Astra ne perd aucun point sur les cinq catégories suivantes : analyse standard, ambiguïté, questions sans réponse possible, qualité des données et pièges statistiques. Ces cinq catégories couvrent la majeure partie des scénarios de reporting quotidien et de vérification des définitions et périmètres. Si l’activité porte principalement sur ce type de questions, les données de cette série suggèrent que la qualité de la nouvelle génération d’Astra est équivalente à celle de la précédente, avec des coûts et une vitesse nettement meilleurs.
L’écart de deux questions doit lui aussi être replacé dans la marge de fluctuation. Plotly indique que, lors de nouvelles exécutions sur d’autres modèles, des variations allant jusqu’à trois questions ont été observées. Ainsi, 41 contre 43 doit plutôt être considéré comme « une observation de cette série » que comme un écart de capacité stable. Une formulation plus juste serait : un signal méritant d’être suivi est apparu dans la catégorie des règles cachées, mais les données d’une seule série ne suffisent pas à confirmer une régression.
Pourquoi les questions à motif caché méritent une revalidation : hypothèse explicative sur la profondeur d’exploration
Ce qui suit est une hypothèse explicative fondée sur les données du rapport, et non une conclusion de Plotly. Sur les questions à motif caché, la nouvelle génération effectue en moyenne environ 9 requêtes par question, contre environ 15 pour la génération précédente. Les deux questions ratées illustrent deux cas de figure : l’une « n’a pas trouvé », l’autre « a trouvé l’emplacement mais a écarté la vraie cause ». Les deux donnent l’impression d’un arrêt prématuré faute d’avoir creusé assez loin : dans le premier cas, l’exploration n’a pas couvert un périmètre suffisant ; dans le second, le modèle a tiré une conclusion négative trop tôt, au stade de la vérification.
Cela pourrait venir du même changement de comportement que la baisse des coûts et de la latence : le modèle tend à répondre après moins de requêtes. Sur les questions classiques, cette tendance se traduit directement en efficacité ; sur les questions de cause racine, qui exigent des hypothèses et des vérifications répétées, elle peut devenir un risque. Pour valider cette hypothèse, il faut comparer, sur ses propres données, la relation entre le nombre de requêtes et le taux de réussite, plutôt que de se contenter du score total.
Pourquoi le coût et la vitesse de GPT-6.2 Astra baissent en même temps
La baisse de $19.97 à $4.11 peut se décomposer en deux étapes, d’après les données recalculées par Plotly :
- Le facteur tarifaire : les volumes d’usage de la génération précédente, recalculés aux nouveaux tarifs, donnent environ $11. Autrement dit, la seule baisse des prix fait passer le coût d’environ $19.97 à $11, soit une diminution d’environ 45 %. Le prix unitaire officiel des entrées en cache a baissé de 60 %, et cet effet est particulièrement sensible dans des scénarios où le taux de réussite du cache atteint 93 à 98 %.
- Le facteur volume de travail : le passage d’environ $11 à $4.11 tient à la réduction du travail. Les appels d’outils sont passés de 266 à 148, les tokens d’entrée d’environ 9,1 millions à environ 4,4 millions, les tokens de sortie ont diminué de plus de moitié, et la part de cache est passée de 93 % à 98 %.
Un calcul approximatif des volumes de la nouvelle génération avec les tarifs officiels donne aussi le même ordre de grandeur que $4.11 : sur environ 4,4 millions de tokens d’entrée, 98 % passent au tarif cache, le reste au tarif d’entrée normal, auxquels s’ajoutent environ 34 000 tokens de sortie. Cela montre que, dans des scénarios comme l’analyse de données, à contexte long et à appels d’outils multiples, le taux de réussite du cache et le nombre de tours d’appel pèsent probablement plus sur le coût que le prix unitaire lui-même. Le gain de vitesse suit la même logique : moins de requêtes, moins d’appels au modèle, et le temps écoulé se raccourcit naturellement.
💰 Conseil coût : pour évaluer le coût de ce genre de tâches d’agent, il faut enregistrer les tokens qui touchent le cache et le nombre de tours d’appel d’outils, et ne pas se contenter du tableau des prix unitaires. Lors d’appels à la consommation via APIYI apiyi.com, on peut comparer la facture et le champ usage des journaux pour vérifier que le cache a bien pris effet.
GPT-6.2 Astra face à GPT-6.1 Sol et GPT-6.2 Sol : comment choisir
Les quatre modèles n’occupent pas le même créneau :
- GPT-6.1 Sol : avec ce paramétrage, obtient 43/43 pour 2,61 $, soit l’option « la moins chère parmi celles qui atteignent le score parfait » de ce tour ; en contrepartie, la durée médiane est de 17,6 s, plus lent que GPT-6.2 Astra.
- GPT-6.2 Astra : 41/43, 4,11 $, 12,4 s. Son avantage apparaît lorsqu’on compare le score et la vitesse ensemble. Si l’on ne regarde que le coût et le score, il n’est pas avantagé.
- GPT-6.2 Sol : 1,22 $, 10,5 s, le moins cher et le plus rapide, mais avec le score le plus bas : 40/43.
- GPT-6 Astra : score parfait, mais coût et latence nettement plus élevés ; dans cette comparaison, il est désormais difficile de lui trouver une raison de le choisir en priorité.
Les écarts entre ces modèles restent dans la marge de fluctuation maximale de trois questions mentionnée par Plotly. Autrement dit, le score total seul ne permet pas d’établir un classement fiable ; les dimensions réellement discriminantes sont le coût et la latence. En pratique, les produits interactifs d’interrogation de données étant sensibles à la latence, on pourra comparer en priorité 6.2 Astra et 6.2 Sol ; pour l’analyse par lots hors ligne, moins sensible à la latence, le rapport qualité-prix de 6.1 Sol mérite davantage l’attention.
Comment retester GPT-6.2 Astra avec vos propres données
La méthode de retest ci-dessous est une recommandation de la rédaction. DataAnalyticsBench ne couvre que l’exploitation éolienne, en anglais et dans un seul environnement, ce qui est très éloigné des entrepôts de données réels de la plupart des équipes. L’approche la plus prudente consiste à construire un petit jeu de questions avec vos propres données, en figeant les données, les outils et les invites, puis à lancer plusieurs séries et à mesurer séparément les performances par type de tâche.
| Sous-ensemble | Nombre de questions conseillé | Points à consigner | Usage de l’évaluation |
|---|---|---|---|
| Rapports courants | 15-20 questions | Taux de réussite, latence médiane | Peut-on confier sans risque les questions de données du quotidien au modèle ? |
| Définitions ambiguës | Environ 5 questions | Clarifie-t-il spontanément ou explicite-t-il ses hypothèses ? | Éviter qu’il « choisisse discrètement une convention de calcul » |
| Biais statistiques | Environ 5 questions | Repère-t-il des pièges comme le paradoxe de Simpson ? | Fiabilité des conclusions |
| Causes racines des anomalies | 5-8 questions | Taux de réussite, nombre de requêtes, latence P90 | Vérifier les signaux de perte de points sur les questions à motif caché |
| Toutes les questions | — | Coût total par série, taux de succès du cache | Budget de coût |
Chaque modèle devrait être lancé au moins 3 fois, avec la moyenne et la variabilité consignées. La latence de queue (P90) doit être enregistrée séparément : une médiane flatteuse ne garantit pas que les quelques questions les plus lentes soient acceptables.
Voici l’exemple d’appel minimal. L’ID de modèle retenu est gpt-6.2-astra, publié par OpenAI ; les modèles disponibles sont ceux de la liste de la plateforme :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # La fiche du modèle indique que les requêtes avec effort défini sur none seront rejetées
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
Voir le script de retest complet : taux de réussite, coûts et latences P50/P90 par sous-ensemble
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# Jeu de questions maison : category correspond au sous-ensemble du tableau de re-test, checker est implémenté par vous selon la clé de réponse
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# Prix unitaire en accès direct officiel (USD par million de tokens), uniquement pour une estimation grossière ; la facturation réelle de la plateforme fait foi
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
Ce script ne fait qu’un seul tour de questions-réponses. Pour se rapprocher de la configuration de DataAnalyticsBench, il faut encore intégrer un outil SQL en lecture seule, laisser le modèle enchaîner lui-même plusieurs tours de requêtes, et consigner en plus le nombre d’appels d’outils par question, histoire de vérifier l’hypothèse évoquée plus haut sur le lien entre « nombre de requêtes » et « points perdus ».
🎯 Conseil pour le re-test : les quatre modèles utilisent tous le protocole compatible OpenAI. Via APIYI apiyi.com, une seule et même clé API suffit pour passer de l’un à l’autre, et le quota d’essai gratuit offert aux nouveaux utilisateurs permet largement de lancer un premier tour sur un petit jeu de questions avant de décider d’élargir l’échelle.
Le classement donne une direction. Mais dès qu’on en vient à son propre entrepôt de données, à ses propres types d’anomalies, la réponse ne peut sortir que de ses propres essais. Lu You écrivait dans Enseignements à mon fils, un soir d’hiver passé à lire : « Ce qu’on apprend dans les livres paraît toujours superficiel ; pour connaître vraiment une chose, il faut la pratiquer soi-même. »
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; pour aller plus loin, le centre de documentation docs.apiyi.com regroupe l’essentiel des ressources d’intégration.