Note de l’auteur : cet article explique comment Flint-interactive s’appuie sur les « événements sémantiques + opérations de mise à jour » pour réduire le coût et les erreurs liés à la génération de graphiques interactifs par un agent. Il présente aussi trois façons de l’intégrer.
Si vous développez un agent IA pour l’analyse de données ou la création de rapports, vous avez peut-être déjà rencontré ce problème : l’agent crée rapidement un graphique statique, mais dès qu’on ajoute un filtre au clic ou une sélection par zone synchronisée, il faut souvent plusieurs allers-retours pour obtenir le bon résultat. Tantôt la mise en page se décale, tantôt la mise en surbrillance ne fonctionne plus. On corrige un problème et un autre apparaît : les tokens et le temps passent dans le débogage.
Microsoft Research a publié Flint-interactive le 22 octobre 2026. Il s’agit d’un langage de visualisation interactive de données construit sur Flint. Cet article ne recommande pas une nouvelle bibliothèque de graphiques : il prend Flint-interactive comme cas d’étude pour voir comment concevoir des spécifications de sortie de haut niveau pour les agents, afin qu’ils écrivent moins de code de rendu bas niveau.
Ce que vous allez en retirer : vous comprendrez les limites de coût et de fiabilité que rencontrent les agents lorsqu’ils génèrent des graphiques interactifs. Vous découvrirez aussi le principe qui consiste à « confier la logique visuelle au compilateur et décrire la logique d’interaction à l’aide d’événements sémantiques », ainsi que les cas d’usage adaptés à chacune des trois approches : dans une conversation, dans une application ou avec des interactions personnalisées.
Pourquoi il coûte cher de laisser un agent écrire du code interactif sans Flint-interactive
Laisser un agent écrire directement le code d’un graphique interactif semble être l’option la plus flexible. Mais, comme le souligne le billet de recherche, même avec des modèles de pointe très performants, deux obstacles restent évidents en pratique.
Le premier est le coût de génération élevé. Un agent produit rarement un graphique interactif satisfaisant dès le premier essai. Il faut généralement plusieurs cycles de raisonnement, de programmation et de débogage, chacun consommant des tokens et du temps. Le second est le manque de fiabilité. Les visualisations interactives sont complexes par nature : plus un graphique offre de possibilités d’interaction, plus il risque de présenter des problèmes de mise en page ou des interactions défaillantes. Et les corrections peuvent à leur tour introduire de nouveaux problèmes.
Alors, peut-on simplement utiliser les interactions intégrées aux bibliothèques de graphiques ? Selon le billet, certaines de ces bibliothèques n’offrent pas assez de possibilités pour créer facilement des graphiques interactifs personnalisés. Au fond, il manque un langage de description des interactions « à la fois expressif et suffisamment abstrait ».
| Approche | Ce que l’agent doit produire | Problème principal | Pertinence |
|---|---|---|---|
| Écrire directement le code de rendu de bas niveau | Écouteurs d’événements, détection des éléments ciblés, logique de redessin | Plusieurs cycles de débogage, consommation élevée de tokens, risque d’introduire de nouveaux bugs | Très expressif, mais peu fiable |
| Utiliser uniquement les interactions intégrées à la bibliothèque de graphiques | Activer ou désactiver quelques options de configuration | Types d’interactions limités, personnalisation difficile | Stable, mais peu expressif |
| Spécification Flint-interactive | Correspondance entre événements sémantiques et opérations de mise à jour | Nécessite d’apprendre un nouveau système de spécification | Allie expressivité et fiabilité |
Si vous devez régulièrement changer le modèle utilisé par votre agent pour ce type de tâche de génération en plusieurs étapes, vous pouvez accéder à plusieurs modèles courants via l’interface unifiée d’APIYI apiyi.com. Un même code d’invocation permet de comparer le nombre de cycles et la consommation des différents modèles, afin d’évaluer le coût réel de l’écriture de code de bas niveau dans votre contexte.
Les points clés de Flint-interactive
| Point clé | Description | Intérêt pour les développeurs |
|---|---|---|
| Événements sémantiques | Le compilateur interprète les actions brutes, comme les clics, les glissements et les frappes clavier, pour déterminer quels éléments du graphique et quelles données ont été sélectionnés | L’agent n’a pas à gérer les coordonnées en pixels ni la détection des éléments ciblés |
| Opérations de mise à jour | Des opérations de haut niveau comme set-style, set-annotation et set-viewport décrivent les changements à l’écran | Pas besoin de manipuler des éléments graphiques propres à chaque moteur de rendu |
| Machine à états Flint Canvas | Elle suit les interactions de l’utilisateur sur le canevas et gère l’état du rendu | Le framework prend en charge l’exécution et réduit les incohérences d’état |
| Composabilité | La génération d’événements et les mises à jour visuelles peuvent être combinées et reliées à des tableaux, du texte ou des composants | On peut créer des récits de données et des tableaux de bord interactifs |
Événements sémantiques : Flint-interactive s’intéresse aux données sélectionnées
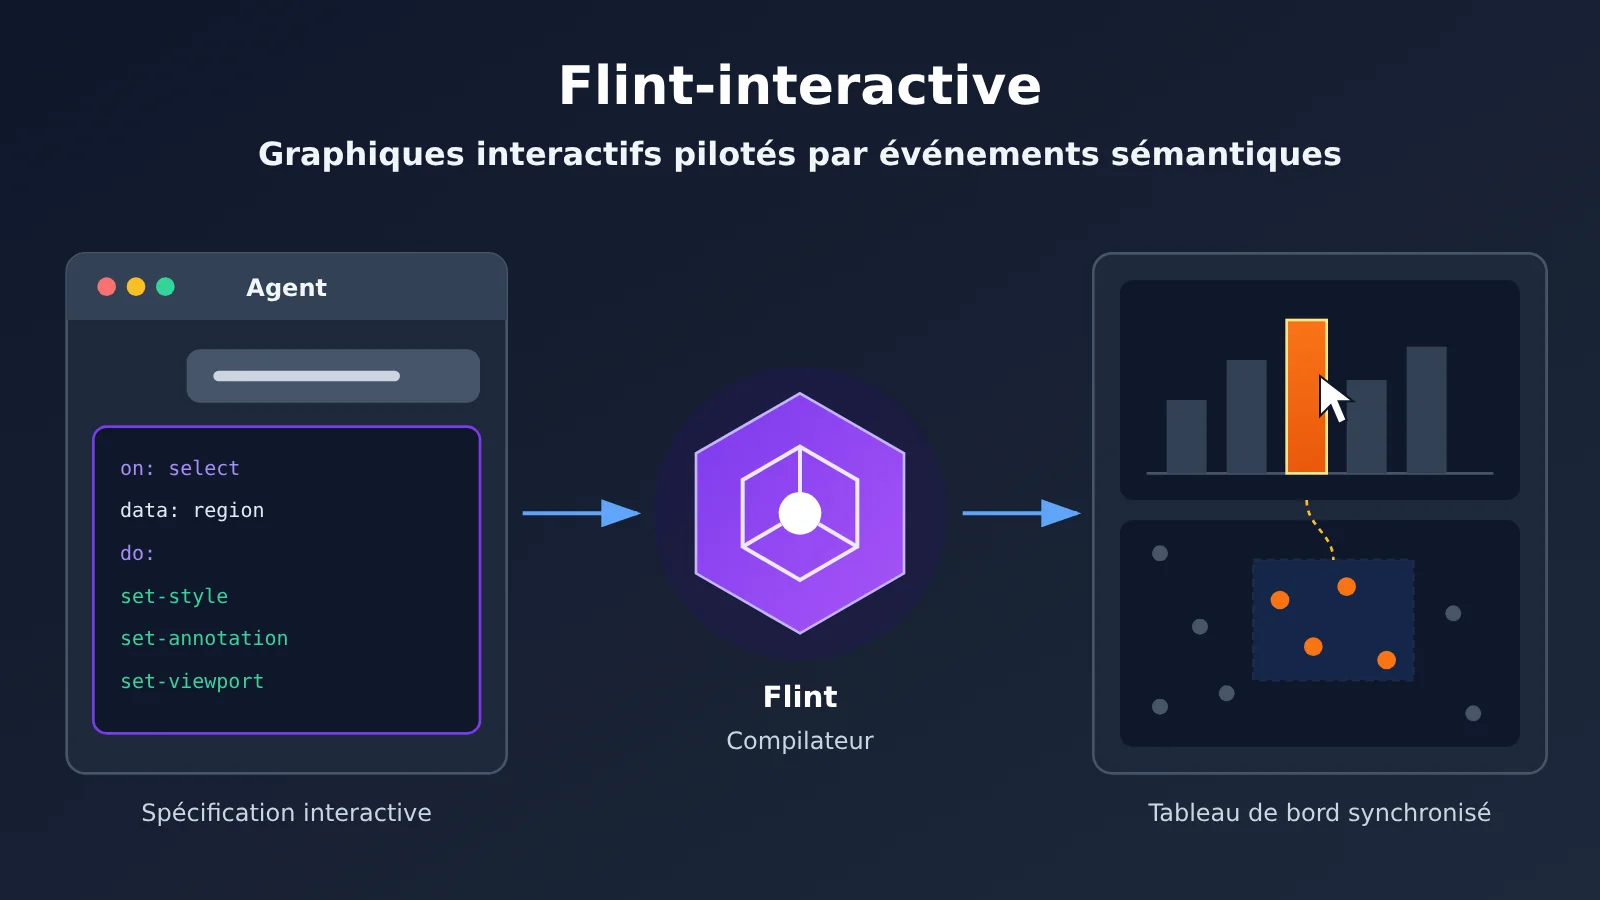
Les événements sémantiques sont le concept central de Flint-interactive. Avec une approche classique, l’agent doit gérer des informations comme « la souris a été enfoncée aux coordonnées (x, y), puis déplacée vers tel endroit », avant de calculer lui-même quels points de données se trouvent dans la zone. Dans Flint, le compilateur s’en charge et produit directement un événement porteur de sens, par exemple : « l’utilisateur a sélectionné ces groupes de pays dans un rectangle ».
On peut comparer cela à la différence entre les événements DOM natifs et les événements métier en développement front-end. Quand vous écrivez de la logique métier, les coordonnées d’un mousedown vous importent peu : vous voulez savoir que « l’utilisateur a sélectionné la commande A ». Les événements sémantiques apportent la même abstraction à la visualisation, avec un compilateur qui en garantit la justesse.
Opérations de mise à jour : Flint-interactive privilégie un résultat déclaratif au redessin impératif
Une fois l’événement sémantique reçu, la logique d’interaction n’a qu’à répondre à une question : à quoi doit ressembler l’écran ? Les opérations de mise à jour présentées dans le billet comprennent set style pour mettre des données en évidence, set annotation pour ajouter une étiquette à un point et set viewport pour déplacer ou zoomer la vue.
C’est un peu comme la différence entre SQL et une boucle écrite à la main. Avec SQL, vous décrivez le résultat voulu et la base de données décide comment l’obtenir. Avec Flint, vous indiquez quelles données mettre en évidence, et le compilateur traduit cette intention en changements concrets sur le canevas, notamment la détection des éléments ciblés et les mises à jour visuelles de bas niveau.
Machine à états : Flint Canvas prend en charge l’exécution des interactions
Flint Canvas est essentiellement une machine à états : il suit en continu les interactions de l’utilisateur sur le canevas et gère l’état du rendu. Pour l’agent, cela signifie qu’il n’a pas à maintenir lui-même des états intermédiaires sujets aux erreurs, comme « quel élément est sélectionné » ou « la mise en évidence précédente a-t-elle été effacée ».
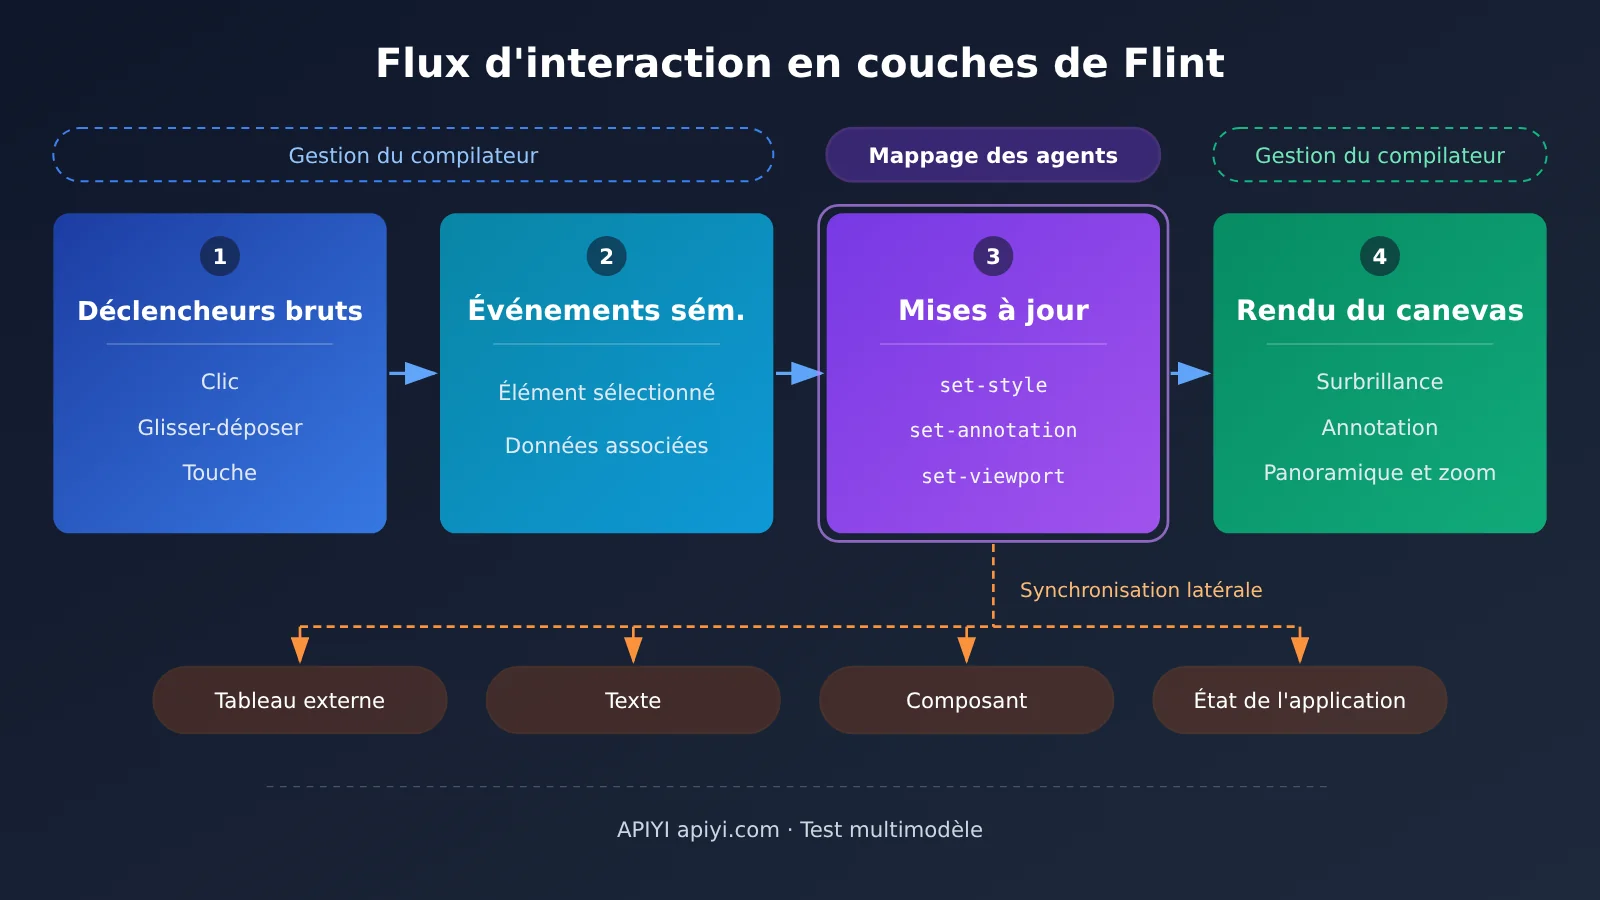
Le schéma illustre la répartition centrale présentée dans le billet : le compilateur gère la logique visuelle, tandis que l’utilisateur décrit la logique d’interaction au niveau sémantique. L’agent ne s’occupe que de la couche intermédiaire, qui associe chaque événement à une mise à jour ; les deux extrémités sont confiées au framework.
Le principe applicable au-delà de Flint-interactive : définir des spécifications de sortie de haut niveau pour les agents
Au-delà de Flint-interactive, c’est surtout son choix d’ingénierie qui mérite d’être retenu : ne demandez pas à un agent de produire la couche où il risque le plus de se tromper. Le code de rendu de bas niveau comporte des dépendances complexes et les retours arrivent tard. Les essais successifs de l’agent à ce niveau coûtent donc naturellement cher.
Flint transforme ainsi un problème de programmation ouvert en un problème de « mise en correspondance dans un vocabulaire limité ». L’espace de sortie de l’agent se réduit, sa structure devient plus régulière et les résultats sont plus faciles à valider. Cette approche s’applique aussi à l’orchestration de workflows, à la génération de formulaires ou à la mise en page de rapports.
| Critère | À confier à l’agent | À confier au compilateur ou à l’environnement d’exécution |
|---|---|---|
| Exprime une intention métier | Oui, par exemple « mettre en évidence les éléments du même groupe après la sélection d’un pays » | Non, par exemple la conversion des coordonnées en pixels |
| Dépend de nombreux états implicites | Peu de dépendances, une seule mise en correspondance suffit | Nombreuses dépendances, suivi continu nécessaire |
| Facile à diagnostiquer en cas d’erreur | Spécification clairement structurée, facile à valider | Détails de rendu dispersés, difficiles à examiner |
| Réutilisable | Peut devenir un préréglage, comme linked-brush | Infrastructure générique à implémenter une seule fois |
Pour concevoir le format de sortie de votre propre agent, vous pouvez passer chaque critère de ce tableau en revue. Si une couche exprime une intention, dépend de peu d’états et se valide facilement, elle se prête à une sortie produite par l’agent. Dans le cas contraire, mieux vaut la confier à du code déterministe ou à un compilateur.
À noter : le billet de recherche ne fournit aucune donnée chiffrée sur la réduction de la consommation de tokens ou l’amélioration du taux de réussite. Mieux vaut donc mesurer les bénéfices de ce principe sur vos propres tâches plutôt que d’en reprendre les conclusions telles quelles.
Prise en main de Flint-interactive : 3 façons de l’intégrer
Le blog présente trois approches destinées aux utilisateurs de graphiques, aux développeurs d’applications et aux concepteurs d’interactions. Voici comment les utiliser, de la plus simple à la plus avancée.
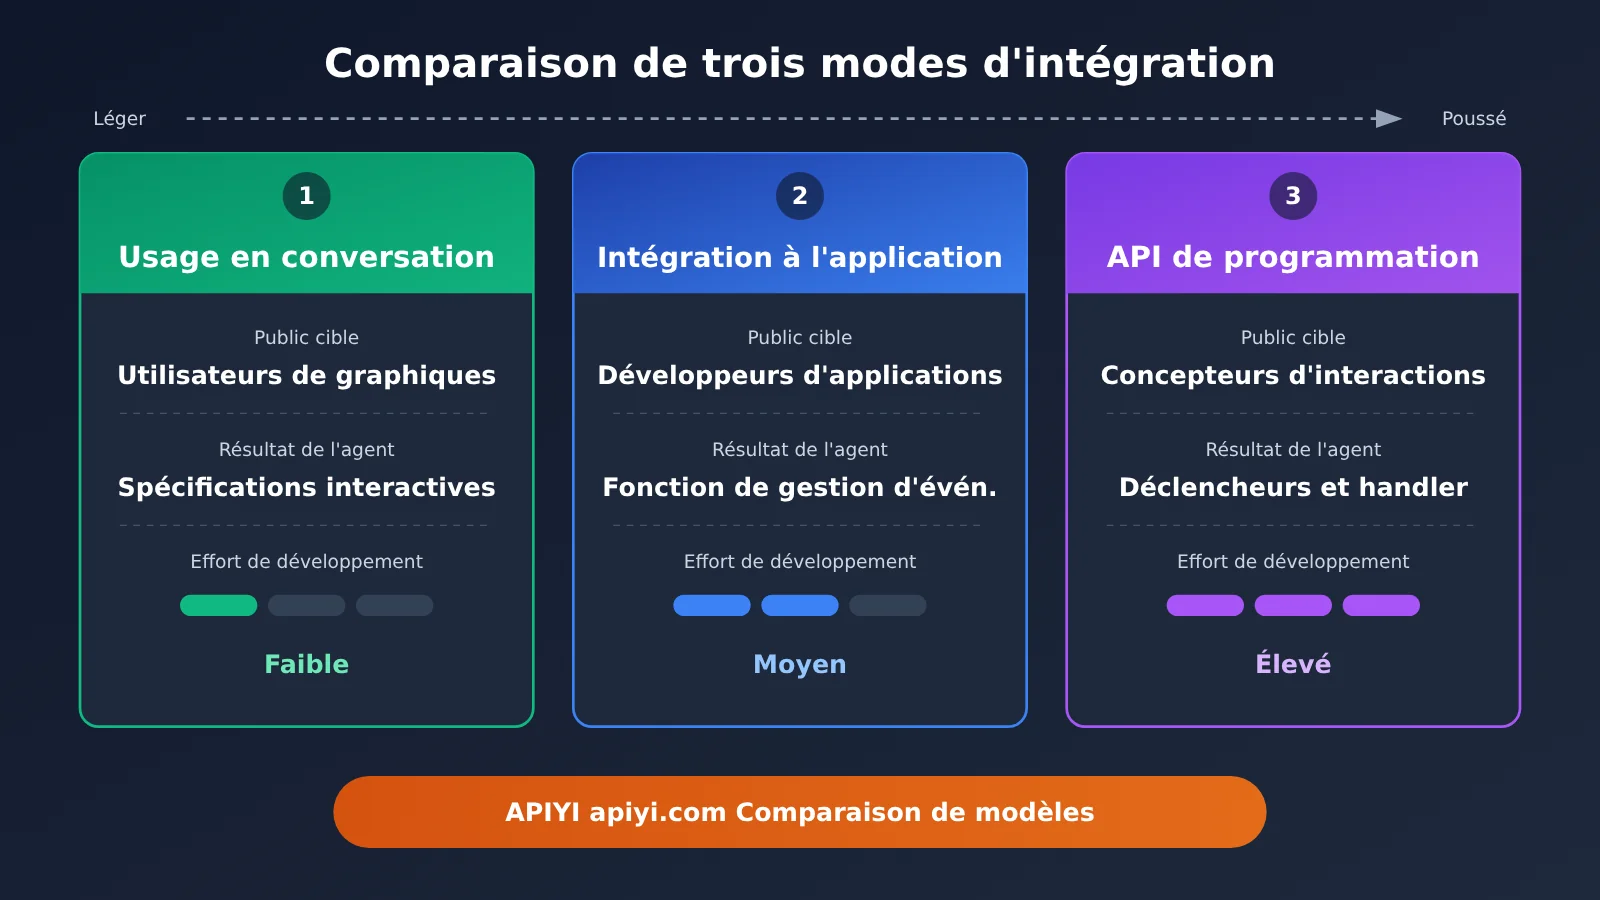
| Approche | Public cible | Que produit l’agent ou l’application ? | Cas d’usage typique |
|---|---|---|---|
| Utilisation dans une conversation (Flint-MCP + MCP Apps) | Utilisateurs de graphiques | Spécification du graphique Flint + interaction_spec |
Explorer des données dans une conversation et utiliser la sélection dans une question de suivi |
| Intégration dans une application (Flint Interactive Canvas) | Développeurs d’applications | Fonctions de traitement des événements sémantiques + opérations de mise à jour envoyées à Canvas | Tableaux de bord, récits fondés sur les données, interactions entre graphiques et tableaux |
| Interactions personnalisées (API de programmation) | Concepteurs d’interactions | Déclencheur trigger + fonction handle personnalisée | Interactions sur mesure qui vont au-delà des fonctions prédéfinies, comme DimpVis |
Approche 1 : utiliser Flint-interactive dans une conversation (MCP)
C’est l’approche la plus légère. Avec Flint-MCP et MCP Apps, vous pouvez utiliser Flint Interactive directement dans une conversation ou un environnement de type canevas. Pour la configuration, suivez le guide officiel de mise en place MCP. Une fois l’intégration terminée, le processus ressemble à ceci :
- Suivez le guide officiel de configuration MCP pour connecter Flint-MCP à un environnement de conversation ou de type canevas compatible avec MCP Apps ;
- Indiquez à l’agent le graphique à créer et les interactions souhaitées, par exemple « permettre une sélection par zone et mettre en évidence les pays du même groupe » ;
- En plus de la spécification du graphique Flint, l’agent génère un
interaction_specet affiche un graphique interactif dans la conversation ; - Faites une sélection dans le graphique : les éléments sélectionnés peuvent servir de contexte aux échanges suivants.
L’étape 4 est particulièrement utile. Après avoir sélectionné une zone contenant des données inhabituelles, l’utilisateur peut demander directement : « Pourquoi ces quelques points sont-ils plus élevés ? » L’agent reçoit alors un résultat de sélection structuré, plutôt qu’une vague description textuelle.
Option 2 : intégrer Flint-interactive Canvas à votre application
Pour utiliser Flint Interactive Canvas dans votre propre tableau de bord ou récit de données, le flux de données fonctionne dans les deux sens :
- Graphique → application : Flint Canvas émet des événements sémantiques que votre application reçoit via des fonctions de gestion. Elle peut ainsi filtrer un tableau, mettre à jour un autre graphique ou modifier son état ;
- Application → graphique : lorsqu’un composant de l’application doit modifier le graphique, il lui suffit d’envoyer une opération de mise à jour à Flint Canvas.
L’exemple du blog montre cette interaction bidirectionnelle entre un graphique et un tableau : cliquer sur une ligne du tableau met en évidence le point correspondant dans le graphique, et inversement. Pour les produits de reporting, c’est la base d’une expérience où graphiques et données restent synchronisés. Le blog indique aussi que vous pouvez partager la compétence interaction-author avec votre agent de programmation pour qu’il vous aide à ajouter des interactions prédéfinies à votre application.
Option 3 : créer des interactions Flint-interactive personnalisées avec l’API de programmation
Lorsque les interactions prédéfinies, comme la sélection liée linked-brush, ne suffisent pas, l’API de programmation permet de définir un déclencheur trigger et une fonction handle personnalisée pour associer les événements sémantiques à une série de mises à jour du graphique.
Dans l’exemple du blog, un clic sur un pays le met en évidence et lui ajoute une étiquette avec son nom. Ce gestionnaire combine les opérations set-style et set-annotation, sans avoir à manipuler les éléments graphiques propres au moteur de rendu. Dans un exemple DimpVis plus complexe, l’utilisateur peut faire glisser un point le long d’une trajectoire temporelle pour observer l’évolution des températures et des précipitations dans toutes les villes.
🚀 Pour commencer : utilisez d’abord l’option 1 dans une conversation pour vérifier si vos données se prêtent à une interaction, puis décidez si vous souhaitez investir dans l’option 2 ou 3. APIYI apiyi.com permet d’accéder aux modèles qui pilotent l’agent via une interface unifiée : vous pouvez ainsi essayer plusieurs modèles courants avec le même code et voir lequel produit le plus régulièrement un
interaction_specvalide.
Évaluer la fiabilité des spécifications Flint-interactive générées par un agent
Le blog ne précise pas quels modèles ou agents génèrent les meilleures spécifications Flint. Avant la mise en production, mieux vaut donc mettre en place un processus d’évaluation simple. Voici les indicateurs à suivre :
| Indicateur | Méthode d’observation | Explication |
|---|---|---|
| Taux de réussite au premier essai | Mesurer la proportion de résultats correctement rendus et interactifs dès la première génération | Reflète directement le coût de génération |
| Nombre moyen de corrections | Compter les tours de dialogue nécessaires entre la première génération et un résultat utilisable | Reflète la consommation de tokens et le temps nécessaire |
| Respect de l’intention d’interaction | Vérifier manuellement que les interactions répondent aux besoins | Une spécification valide ne garantit pas que l’intention est respectée |
| Stabilité après modification | Vérifier que les autres interactions fonctionnent toujours après en avoir modifié une | Correspond au problème de fiabilité mentionné dans le blog |
Vous pouvez préparer un jeu de test composé d’exigences d’interaction fixes, puis utiliser les mêmes invites pour comparer deux approches : « écrire directement le code de rendu » et « produire une spécification Flint ». Avec une interface qui regroupe plusieurs modèles, comme APIYI, vous pouvez comparer plusieurs modèles dans un seul script, sans devoir intégrer séparément le SDK de chaque fournisseur.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que Flint-interactive ?
Flint-interactive est un langage de visualisation de données interactive développé par Microsoft Research à partir de Flint. Son compilateur traduit les interactions utilisateur en événements sémantiques, puis modifie les graphiques à l’aide d’opérations de mise à jour de haut niveau. Les utilisateurs et les agents peuvent ainsi décrire dans des spécifications concises des interactions comme le clic, le filtrage, le zoom, la mise en évidence et la synchronisation entre graphiques.
Q2 : En quoi Flint-interactive diffère-t-il du code d’interaction de graphique écrit directement par un agent ?
Quand il écrit directement le code, l’agent doit gérer à la fois les événements, la détection des éléments ciblés et le redessin. Cette approche est expressive, mais le débogage sur plusieurs cycles coûte plus cher et les erreurs sont plus fréquentes. Flint-interactive confie la logique visuelle au compilateur : l’agent décrit seulement « quel événement sémantique déclenche quelle mise à jour ». Le résultat est plus court et sa structure plus facile à vérifier.
Q3 : Quand Flint-interactive a-t-il été publié ?
Microsoft Research a présenté cette recherche sur son blog le 22 octobre 2026. Les documents de référence ne précisent pas la licence open source, le niveau de maturité ni les conditions d’utilisation en production. Avant de l’intégrer à un projet, consultez les informations les plus récentes du dépôt officiel.
Q4 : À quels cas d’utilisation Flint-interactive convient-il le mieux ?
– **Analyse conversationnelle des données** : sélectionner des points de données dans un graphique et utiliser cette sélection dans une question de suivi ;
– **Rapports et tableaux de bord** : synchroniser plusieurs graphiques et cliquer sur un graphique pour filtrer un tableau de détails ;
– **Récits de données** : mettre en évidence dans les deux sens des éléments d’un graphique et des passages du texte, comme dans les récits interactifs du journalisme de données.
Q5 : Comment préparer l’invocation du modèle pour un agent utilisant Flint-interactive ?
Flint détermine « quoi produire », mais il faut toujours connecter un modèle séparément. Une solution pratique consiste à accéder à plusieurs modèles courants via APIYI, sur apiyi.com. Une interface unifiée permet de tester les mêmes besoins d’interaction, puis de comparer le taux de spécifications utilisables dès le premier essai et le nombre de cycles de correction avant de choisir un modèle pour la production.
Q6 : Comment un responsable produit peut-il décider si son équipe doit adopter Flint-interactive ?
Commencez par répondre à deux questions : vos utilisateurs ont-ils vraiment besoin d’explorer les données dans les graphiques ? Et le taux de retouche des graphiques interactifs générés par votre agent est-il élevé ? Si les deux réponses sont positives, l’approche 1 mérite d’être testée à petite échelle. Pendant les tests, la plateforme APIYI permet de changer rapidement de modèle et de limiter les coûts de validation.
Q7 : Quelles sont les limites connues de Flint-interactive et les questions encore ouvertes ?
– **Manque de données chiffrées** : le blog ne publie aucun chiffre précis sur les économies de tokens ou l’amélioration du taux de réussite ;
– **Compatibilité avec les modèles inconnue** : aucun modèle n’est identifié comme étant le plus performant pour générer des spécifications Flint ;
– **Vocabulaire d’interactions limité** : les interactions qui sortent des préréglages doivent être implémentées avec l’API de programmation. L’équipe encourage les contributions de nouveaux préréglages sur GitHub pour enrichir ce vocabulaire.
Points clés de Flint-interactive
- Origine du coût : quand un agent écrit directement le code d’interaction, plusieurs cycles de débogage sont nécessaires. Ils consomment beaucoup de tokens et risquent d’introduire de nouveaux bugs ;
- Événements sémantiques : le compilateur traduit les actions brutes, comme les clics et les glissements, en informations telles que « quelles données ont été sélectionnées » ;
- Opérations de mise à jour : set-style, set-annotation et set-viewport déclarent les changements à l’écran, sans toucher au rendu sous-jacent ;
- Séparation des responsabilités : le compilateur prend en charge la logique visuelle, la logique d’interaction est décrite au niveau sémantique et la machine à états de Canvas est gérée à l’exécution ;
- Trois approches : MCP dans une conversation, Canvas dans une application et l’API de programmation pour les interactions personnalisées ;
- Principe réutilisable : concevoir des spécifications de sortie de haut niveau pour les agents et confier la couche la plus sujette aux erreurs à un système déterministe ;
- Validation pratique : utiliser l’interface unifiée d’APIYI pour comparer plusieurs modèles et tester la stabilité de la génération des spécifications.
Conclusion
L’approche de Flint-interactive fondée sur les événements sémantiques se résume en trois points :
- Un problème bien identifié : si les graphiques interactifs sont difficiles à générer, ce n’est pas parce que les modèles manquent de puissance, mais parce qu’il manque un langage d’interaction à la fois expressif et suffisamment abstrait ;
- Des responsabilités bien réparties : le compilateur analyse les événements et met à jour l’affichage, tandis que l’agent décrit uniquement la correspondance « événement → mise à jour » ;
- Une intégration progressive : de l’essai dans une conversation à l’intégration dans une application, puis aux interactions personnalisées, l’investissement peut se faire selon les besoins.
Pour les équipes qui développent des agents de création de rapports ou d’analyse de données, ces principes de conception peuvent aussi servir à repenser le format de sortie de leurs agents, même sans adopter Flint dans l’immédiat.
Pour les tests, vous pouvez utiliser APIYI sur apiyi.com afin d’accéder à plusieurs modèles courants via une interface unifiée. Comparez leurs résultats sur une même série de besoins d’interaction pour trouver rapidement la combinaison de modèle et de spécification adaptée à votre activité.
📚 Références
- Microsoft Research Blog – Flint-interactive : billet de recherche officiel sur Flint-interactive
- Lien :
microsoft.com/en-us/research/blog/flint-interactive-a-language-for-creating-interactive-data-visualizations - Présentation : explique les événements sémantiques, les opérations de mise à jour, la machine à états Canvas et les trois modes d’utilisation : MCP, Canvas et API de programmation. Le billet donne aussi accès à un guide de configuration MCP, à une bibliothèque d’exemples interactifs et à l’API de programmation.
Auteur : équipe technique APIYI
Échanges techniques : rendez-vous sur APIYI, apiyi.com, pour échanger avec nous sur les pratiques liées aux agents et à l’intégration de plusieurs modèles. Pour en savoir plus, consultez le centre de documentation docs.apiyi.com.