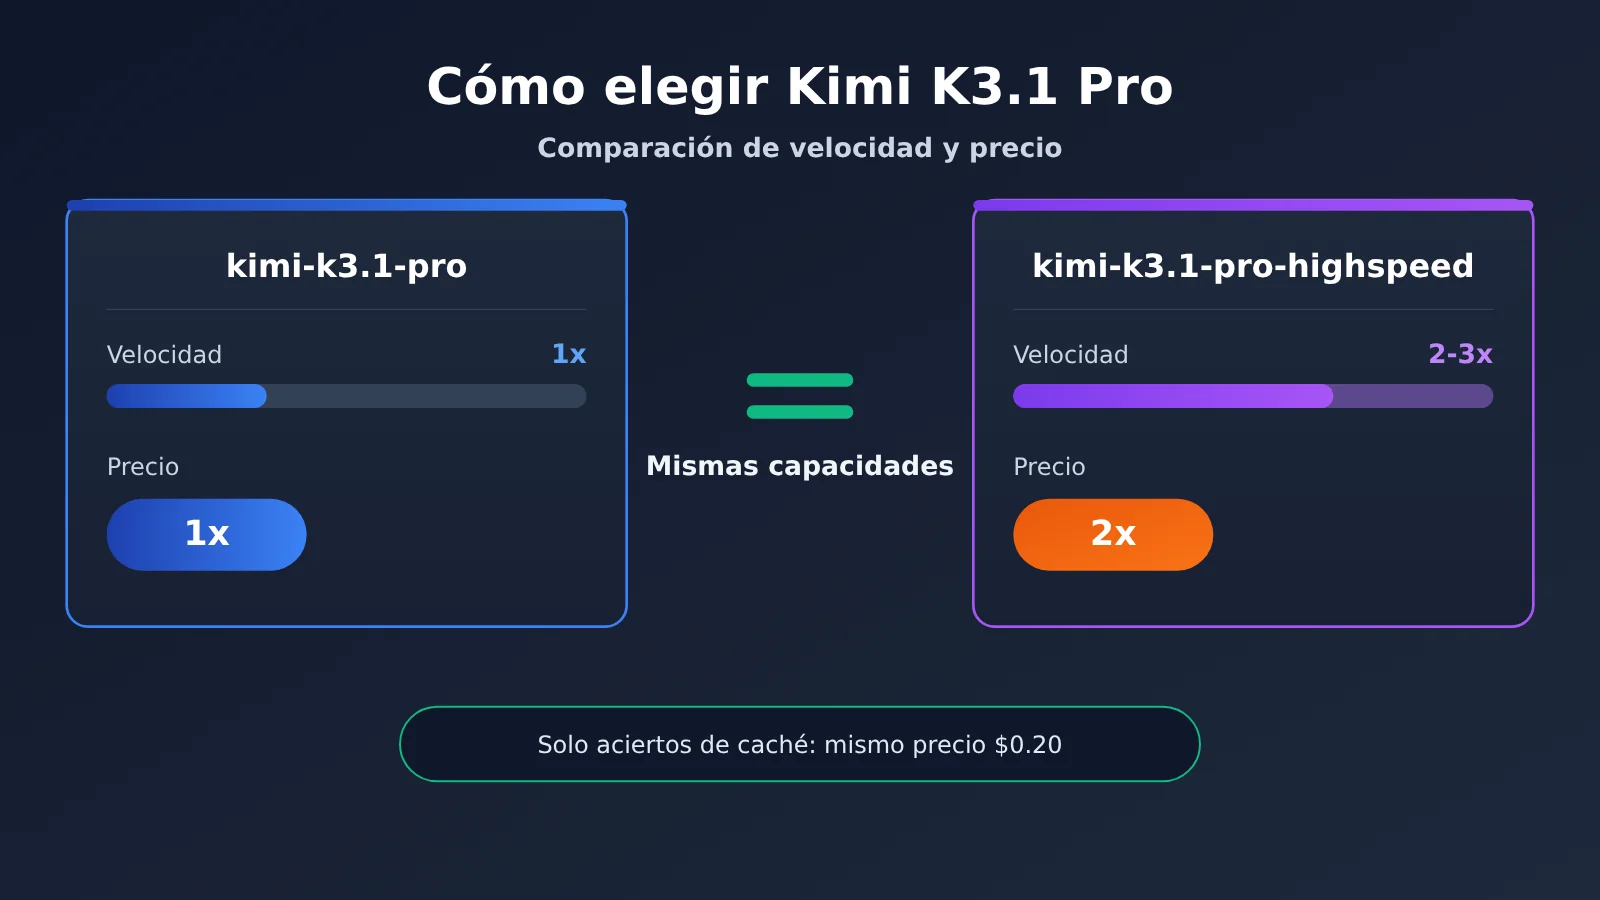
Kimi K3.1 Pro y la versión Highspeed tienen las mismas capacidades; lo único que añade Highspeed es velocidad. Según la información oficial, es entre 2 y 3 veces más rápido. A cambio, el precio prácticamente se duplica en todas las categorías. La única excepción es el precio por acierto de caché, que se mantiene en $0.20 para ambas versiones. Por eso, si vas a esperar frente a la pantalla a que aparezca el resultado, puede convenirte Highspeed; para ejecutar tareas en lote en segundo plano, la versión estándar.
Esta conclusión se basa en tres fuentes: el blog oficial de Moonshot indica que los dos modelos tienen «las mismas capacidades»; la página oficial de precios muestra cinco tarifas; y la documentación oficial de Kimi Code señala que Highspeed consume aproximadamente el doble de cuota. A continuación, etiquetamos cada dato según su fuente: «declaración oficial», «terceros» o «sin verificar». Cuando no hay datos, lo indicamos directamente, sin presentar estimaciones como si fueran resultados medidos.
Este artículo no compara cuál de los dos modelos es más inteligente. Como ambos tienen las mismas capacidades, la única pregunta es de números: ¿vale la pena pagar el doble para obtener resultados de la misma calidad más rápido?
Qué encontrarás aquí: una tabla con las cinco tarifas, una forma de convertir el tiempo de espera en dinero, dos cálculos que puedes comprobar por tu cuenta y una tabla con recomendaciones para seis tipos de situaciones.
1. Diferencias clave entre Kimi K3.1 Pro y Highspeed: mismas capacidades, solo cambian la velocidad y el precio
Empecemos por el panorama general. La siguiente tabla reúne todos los aspectos que se pueden comparar entre los dos modelos; la última columna indica el tipo de fuente de cada dato. El contexto se refiere a la cantidad total de texto que el modelo puede «ver» de una sola vez y se mide en tokens. Un token es la unidad básica de facturación y procesamiento del modelo; para entenderlo de forma aproximada, basta con pensar en «fragmentos de palabras».
| Aspecto | kimi-k3.1-pro (versión estándar) | kimi-k3.1-pro-highspeed | Nivel de la fuente |
|---|---|---|---|
| Capacidades del modelo | Referencia | Iguales que las de la versión estándar | Declaración oficial |
| Longitud del contexto | 1,048,576 tokens | 1,048,576 tokens | Declaración oficial |
| Velocidad de generación | Referencia | La empresa afirma que es entre 2 y 3 veces más rápido | Declaración oficial, sin datos detallados |
| Precio unitario | Referencia | El doble, excepto cuando hay aciertos de caché | Precio oficial |
| Requisito de membresía para usar Kimi Code | Membresía Plus o superior (para un contexto de 1M, se necesita Pro o superior) | Membresía Pro o superior | Documentación oficial |
| Consumo de cuota en Kimi Code | Referencia | Aproximadamente el doble | Documentación oficial |
| Canales oficiales disponibles | kimi.ai, Kimi Work, Kimi Code, Kimi API | Los mismos | Blog oficial |
La tabla deja algo claro: aparte de la velocidad, el precio y los requisitos de membresía, los dos modelos no presentan ninguna otra diferencia. Si eliges el modelo equivocado, no perderás «calidad»; solo gastarás más dinero o tiempo.
1.1 Comparativa de precios de Kimi K3.1 Pro y Highspeed (las cinco categorías)
Los siguientes precios se recopilaron el 24-10-2026 y están expresados en dólares por millón de tokens, sin impuestos. La fuente es la tarifa oficial. Primero, veamos qué significa cada concepto de facturación. «Entrada» es el contenido que envías al modelo; «salida», el contenido que genera el modelo. La «caché» permite que la plataforma almacene temporalmente un prefijo de contenido —por ejemplo, el código de un proyecto que adjuntas repetidamente— y lo reutilice cuando vuelve a aparecer en una solicitud posterior. Esto se conoce como «acierto de caché» y se factura a un precio reducido. La primera vez que se guarda el contenido en la caché se cobra una tarifa de «escritura», con dos opciones de retención: 5 minutos y 1 hora.
| Concepto de facturación | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | Multiplicador |
|---|---|---|---|
| Entrada (sin acierto de caché) | $2.00 | $4.00 | 2 veces |
| Salida | $10.00 | $20.00 | 2 veces |
| Entrada con acierto de caché | $0.20 | $0.20 | Igual, el único precio que no sube |
| Escritura en caché (5 minutos) | $2.00 | $4.00 | 2 veces |
| Escritura en caché (1 hora) | $4.00 | $8.00 | 2 veces |
Los registros públicos del desarrollador externo Simon Willison también lo confirman: Highspeed cuesta el doble, pero el precio de la entrada con acierto de caché es el mismo que el de la versión estándar. Este detalle influye en los cálculos que veremos más adelante. Si la mayoría de las entradas de tus solicitudes tienen acierto de caché, el coste total real de Highspeed será inferior al doble, porque el componente de entrada más importante no sube de precio.
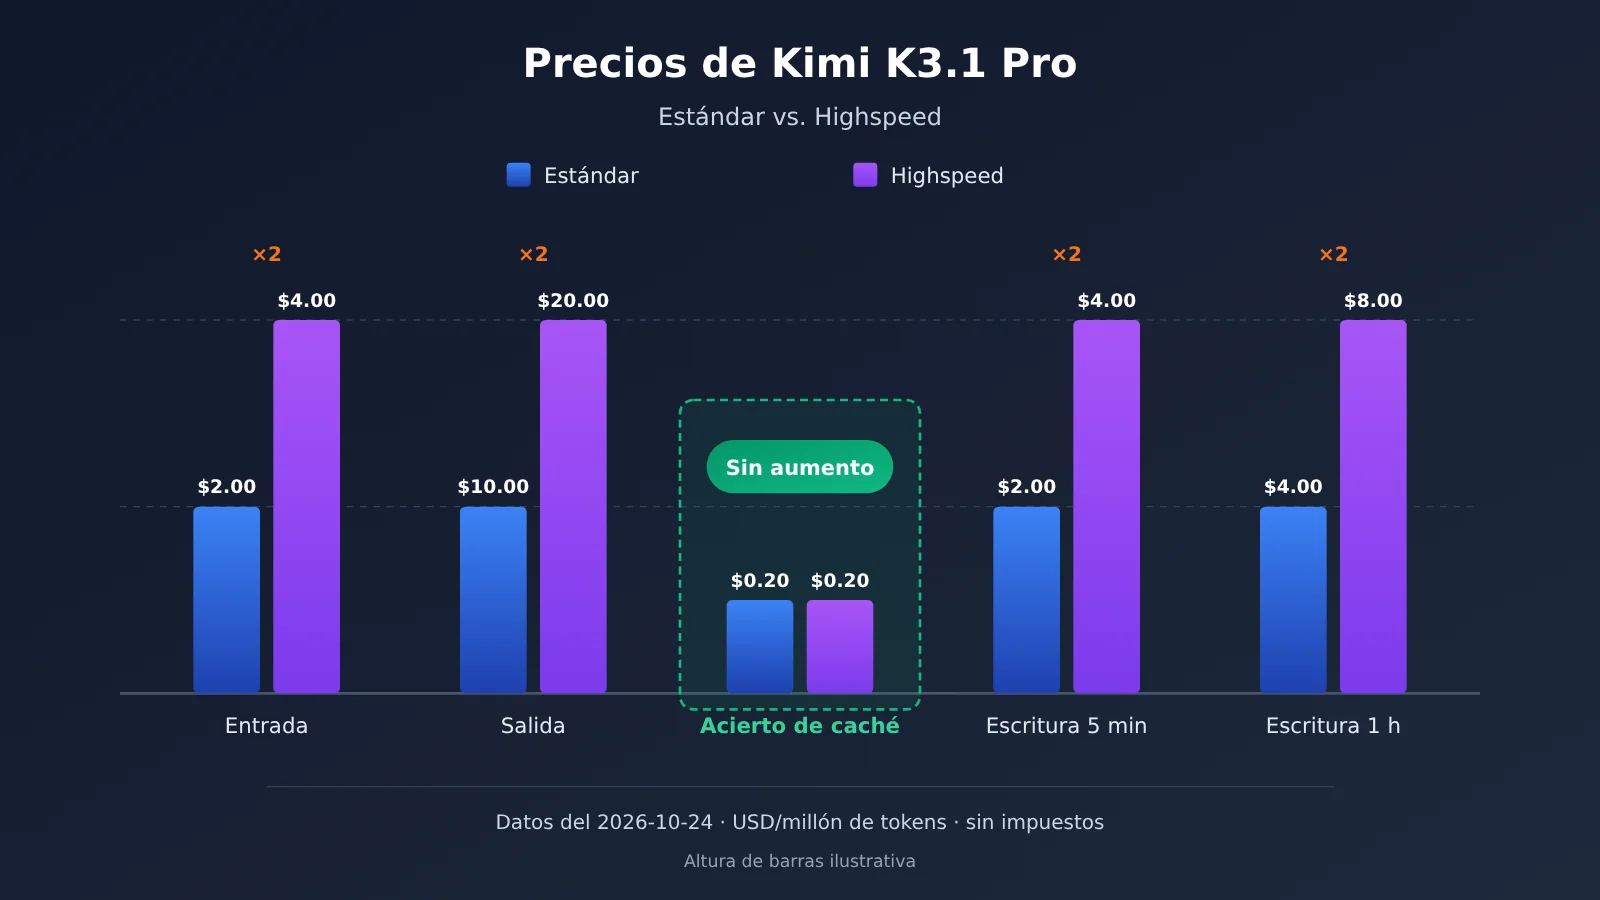
Nota sobre los precios: los valores del gráfico y de la tabla son los oficiales. Si haces la invocación a través de APIYI apiyi.com, consulta la lista de modelos de la plataforma para ver los nombres y precios vigentes. Estos dos modelos todavía están en proceso de integración; los ofreceremos lo antes posible.
2. ¿Qué diferencia de velocidad hay realmente con Kimi K3.1 Pro Highspeed?
Hablemos con franqueza: por ahora hay muy pocos datos de velocidad disponibles. La información oficial solo indica un rango de multiplicación, y las pruebas de terceros se han hecho únicamente con la versión estándar. No hay ningún benchmark público que haya medido los tokens por segundo concretos de Highspeed. Los tokens por segundo indican cuántos tokens genera el modelo cada segundo. Cuanto mayor sea la cifra, menos tardarás en ver la respuesta completa.
| Dato | Valor | Nivel de la fuente | Nota |
|---|---|---|---|
| Velocidad de Highspeed frente a la versión estándar | 2-3 veces la de la versión estándar | Dato publicado por el fabricante | No se han publicado las condiciones de las pruebas ni datos detallados |
| Velocidad de generación de la versión estándar | 80.7 tokens/s | Tercero (Artificial Analysis) | Corresponde al nivel 2 de una escala de 4 |
| Velocidad de generación de Highspeed | Sin datos | No verificado | Ningún tercero la ha medido por separado |
| Promedio de tokens generados por tarea de la versión estándar | Aproximadamente 55K tokens | Tercero (Artificial Analysis) | Se refiere a las tareas de prueba de su Intelligence Index |
| Costo por tarea de la versión estándar | Aproximadamente $1.98 (la página del modelo muestra $2.11) | Tercero (Artificial Analysis) | Ídem |
Así que, por ahora, no hay una respuesta fiable a la pregunta «¿cuántos tokens por segundo genera Highspeed?». Los artículos que dan una cifra concreta o bien presentan sus propias pruebas manuales (en cuyo caso hay que revisar las condiciones) o bien calculan el resultado multiplicando 80.7 por 2 o por 3. No vamos a dar una cifra de ese tipo; en su lugar, te proponemos un método para decidir que no depende de los datos de los benchmarks.
2.1 Cómo elegir entre Kimi K3.1 Pro: convierte el tiempo de espera en dinero
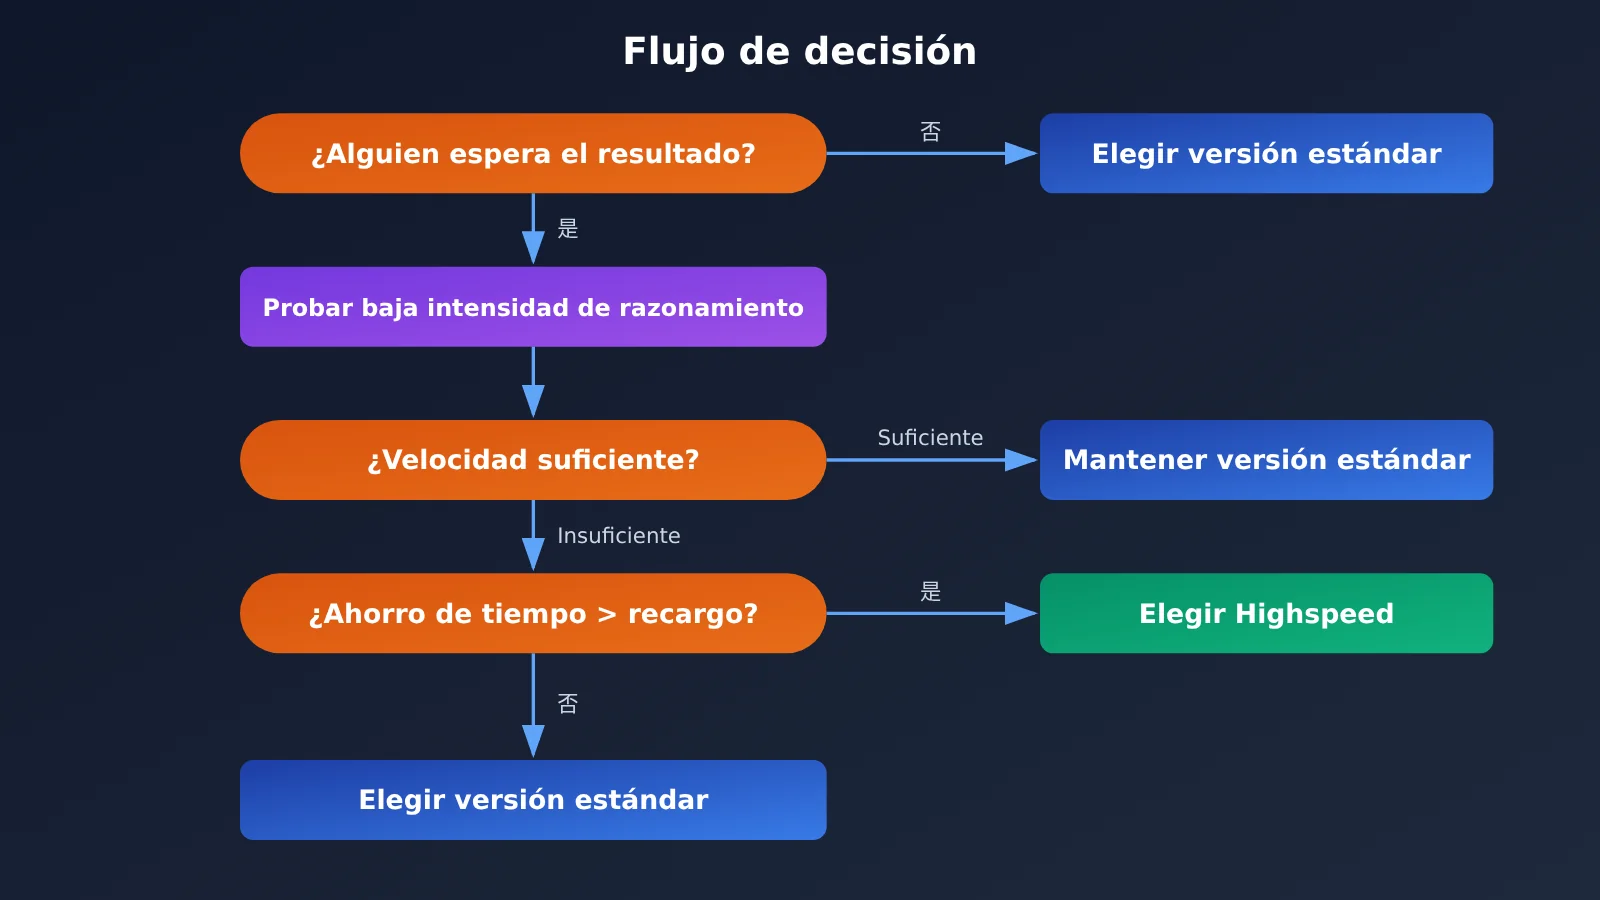
La velocidad no tiene valor por sí sola; lo que importa es «cuánto tiempo menos tiene que esperar alguien». Si nadie está esperando, da igual cuánto más rápido sea. Para decidir, sigue estos cuatro pasos:
- Calcula el tiempo de espera de cada solicitud: tokens generados ÷ velocidad. Por ejemplo, con la versión estándar a 80.7 tokens/s, generar 1,500 tokens debería tardar unos 19 segundos en mostrarse. Ten en cuenta que ambos modelos mantienen activado el modo de razonamiento, que también lleva tiempo. La espera real será mayor y dependerá de la tarea.
- Calcula cuánto tiempo ahorraría Highspeed: según el multiplicador oficial de 2-3 veces, la misma respuesta tardaría unos 6-10 segundos, es decir, se ahorrarían unos 10 segundos por solicitud. Es una estimación, no un resultado medido; tendrás que comprobarlo con tus propias solicitudes.
- Multiplica por el número de solicitudes y el costo por hora: si hay 100 interacciones al día y se ahorran 10 segundos en cada una, se recuperan unos 17 minutos. Multiplica esos 17 minutos por el costo del tiempo de tu equipo o el tuyo.
- Compáralo con el costo adicional: usa el método de la sección 3 para calcular cuánto más cuesta Highspeed al día. Si el valor del tiempo ahorrado supera el costo adicional, vale la pena.
Hay un error común que conviene evitar: que la velocidad se triplique no significa que la productividad se triplique. La respuesta del modelo es solo una parte del flujo de trabajo; el tiempo que dedicas a leer el código, pensar, hacer cambios y ejecutar pruebas no se reduce por ello. Lo único que ahorras es «esos segundos de espera mientras responde el modelo». Por eso, en el paso 3 debes usar el tiempo de espera real, no multiplicar directamente la productividad por el factor de velocidad.
3. Cuentas de Kimi K3.1 Pro y Highspeed
Los dos cálculos siguientes usan los precios oficiales. Incluimos todas las operaciones para que puedas repetirlas con tu propio número de tokens.
3.1 Escenario A: 20 sesiones interactivas de edición de código
Supongamos que cada solicitud incluye 30.000 tokens de entrada: 25.000 tokens de contexto del repositorio que se reutilizan y 5.000 tokens de contenido nuevo. Cada respuesta tiene 1.500 tokens. Se realizan 20 solicitudes seguidas, con menos de 5 minutos entre cada una, así que la caché permanece activa.
Versión estándar:
- Primera solicitud: entrada
30000 × $2 / 1 millón = $0.06; de esos tokens, 25.000 se escriben en la caché. La parte que se escribe cuesta25000 × $2 / 1 millón = $0.05. - Cada acierto de caché posterior:
25000 × $0.2 / 1 millón = $0.005 - Contenido nuevo en cada solicitud:
5000 × $2 / 1 millón = $0.01 - Salida de cada solicitud:
1500 × $10 / 1 millón = $0.015 - Total por solicitud:
$0.005 + $0.01 + $0.015 = $0.03
Highspeed:
- El precio por acierto de caché no cambia: sigue siendo
$0.005. - El contenido nuevo cuesta el doble:
5000 × $4 / 1 millón = $0.02 - La salida cuesta el doble:
1500 × $20 / 1 millón = $0.03 - Total por solicitud:
$0.005 + $0.02 + $0.03 = $0.055, unos $0.06.
Si se suma el costo inicial de escribir en la caché, el total de las 20 solicitudes es de unos $0.66 con la versión estándar y de unos $1.26 con Highspeed. Si nos fijamos estrictamente en el costo por solicitud, Highspeed cuesta alrededor de 1,8 veces más que la versión estándar, no llega a duplicarlo, precisamente porque el precio de los aciertos de caché no aumenta. Conclusión: cuesta aproximadamente el doble, pero, según el multiplicador oficial, permite reducir el tiempo de espera en más de la mitad. Los $0.6 adicionales compran unos minutos de espera menos en 20 solicitudes, algo que para la mayoría de los desarrolladores vale la pena.
3.2 Escenario B: procesamiento por lotes de 1.000 solicitudes sin conexión
Supongamos que cada solicitud tiene 8.000 tokens de entrada y 600 tokens de salida. Se ejecutan 1.000 solicitudes sin prefijos reutilizables entre ellas, así que no se puede aprovechar la caché.
- Costo por solicitud con la versión estándar:
(8000 × $2 + 600 × $10) / 1 millón = $0.016 + $0.006 = $0.022; 1.000 solicitudes cuestan$22. - Costo por solicitud con Highspeed:
(8000 × $4 + 600 × $20) / 1 millón = $0.032 + $0.012 = $0.044; 1.000 solicitudes cuestan$44.
Conclusión: es perder dinero sin obtener nada a cambio. Nadie está esperando el resultado de cada solicitud y el tiempo total suele depender de la concurrencia y de las colas. Pagar $22 más no aporta ningún beneficio perceptible.
| Concepto | Escenario A: edición interactiva de código | Escenario B: procesamiento por lotes sin conexión |
|---|---|---|
| Número de solicitudes | 20 | 1.000 |
| ¿Se puede aprovechar la caché? | Sí, se reutilizan 25.000 tokens | No |
| Costo total con la versión estándar | Unos $0.66 | $22 |
| Costo total con Highspeed | Unos $1.26 | $44 |
| Multiplicador de precio real | Unas 1,8-1,9 veces | 2 veces |
| ¿Hay alguien esperando? | Sí | No |
| Conclusión | Cuesta casi el doble, pero reduce la espera en más de la mitad; vale la pena | No compensa: elige la versión estándar |
4. Cómo elegir entre Kimi K3.1 Pro y Highspeed según el caso de uso
Si aplicamos los criterios anteriores a situaciones habituales, obtenemos esta tabla. La decisión depende de dos cosas: si alguien está esperando y si se puede aprovechar la caché.
| Caso de uso | Recomendación | Motivo |
|---|---|---|
| Programación interactiva | Highspeed | Hay alguien esperando frente a la pantalla, los cambios y el contexto del repositorio pueden aprovechar la caché, y el sobrecoste real es inferior al doble |
| Agentes conversacionales | Highspeed | Las solicitudes breves en varias rondas y las cadenas de llamadas a herramientas hacen que el tiempo de espera de cada ronda se acumule y se note |
| Demostraciones y transmisiones en directo | Highspeed | El público está mirando; las respuestas lentas afectan directamente a la experiencia. La diferencia de coste en unas decenas de llamadas es insignificante |
| Limpieza de datos por lotes | Versión estándar | Nadie espera el resultado de cada elemento, la velocidad no aporta valor adicional y pagar el doble solo aumenta el coste |
| Evaluaciones sin conexión | Versión estándar | La evaluación solo tiene en cuenta la calidad del resultado. Como ambas versiones tienen las mismas capacidades, la velocidad no cambia la puntuación |
| Tareas programadas | Versión estándar | Se ejecutan por la noche o en segundo plano; terminar unos minutos antes no supone ninguna diferencia. El coste es un factor importante |
Si un producto abarca ambos tipos de casos de uso, también se pueden combinar: las solicitudes de interacción directa con los usuarios pasan por kimi-k3.1-pro-highspeed, mientras que los resúmenes, el archivado y el procesamiento por lotes en segundo plano usan kimi-k3.1-pro. Ambos modelos tienen las mismas capacidades, así que cambiar el nombre del modelo no requiere modificar la indicación.
5. La tercera variable para acelerar Kimi K3.1 Pro: reasoning_effort y la cuota de Kimi Code
Antes de pagar más, vale la pena probar una opción gratuita para acelerar las respuestas. Ambos modelos «siempre piensan»: es decir, antes de responder, dedican un tiempo a razonar internamente. El parámetro reasoning_effort controla cuánto dura ese razonamiento; puedes entenderlo como «cuánto quieres que profundice el modelo». Cuanto más bajo sea el nivel, menos tiempo dedicará a pensar y más rápido responderá. Esto es lo que indica la documentación oficial:
reasoning_effort: admite tres niveles,low,highymax; el valor predeterminado esmax.- Si quieres más velocidad, prueba primero a bajar el modelo estándar a
low. Si la velocidad es suficiente y la calidad te convence, no hace falta pagar el doble por Highspeed. - Bajar el nivel puede reducir la profundidad de razonamiento en tareas complejas: cambias calidad por velocidad. Con Highspeed, en cambio, pagas para ganar velocidad sin afectar a la calidad. El coste de cada opción es distinto.
- También puedes combinar ambas opciones: Highspeed con
lowes adecuado para tareas poco complejas en las que la latencia importa mucho.
Otro detalle que es fácil pasar por alto tiene que ver con Kimi Code. Kimi Code es la herramienta de programación de Moonshot y mide el uso según la cuota de la membresía. Según la documentación oficial de Kimi Code:
k3.1-prorequiere una membresía Plus o superior; para usar una ventana de contexto de 1 M, necesitas una membresía Pro o superior.k3.1-pro-highspeedrequiere una membresía Pro o superior.- La versión Highspeed consume aproximadamente el doble de cuota. Con la misma cuota de membresía, podrás hacer más o menos la mitad de trabajo con Highspeed.
Al invocar la API, ten en cuenta que hay varios parámetros fijos que, según los requisitos oficiales, debes omitir de la solicitud; no los envíes manualmente:
temperatureestá fijado en1.0.top_pestá fijado en0.95.nestá fijado en1.presence_penaltyyfrequency_penaltyestán fijados en0.max_completion_tokenses131072de forma predeterminada y admite un máximo de1048576.
6. Cómo usar Kimi K3.1 Pro de forma más cómoda sin depender del canal oficial: intégralo a través de APIYI
La API oficial es compatible con los formatos de OpenAI y Anthropic, e incluye las interfaces Chat Completions, Responses y Messages. «Compatible con OpenAI» significa que, en general, no tienes que modificar el código que ya usa el SDK de OpenAI: basta con cambiar la URL y la clave, y ajustar el nombre del modelo.
Los desarrolladores de China pueden usar APIYI (apiyi.com) para invocar varios modelos con una sola clave API y pagar según el uso. Las cuentas nuevas reciben un crédito gratuito para hacer pruebas. La integración se configura así:
- Formato de OpenAI: establece
base_urlenhttps://api.apiyi.com/v1 - Formato de Anthropic: establece la dirección base en
https://api.apiyi.com - En
model, indica el nombre correspondiente en la lista de modelos de la plataforma
Ten en cuenta que, según la verificación realizada el 24 de octubre de 2026, la lista de modelos de APIYI ya incluye varios modelos de la serie Kimi, como kimi-k2.5, kimi-k2.6, kimi-k2.7-code y kimi-k3. Por ahora, kimi-k3.1-pro y kimi-k3.1-pro-highspeed aún no están disponibles. Consulta la lista de modelos de la plataforma para conocer los nombres y precios cuando se publiquen. Mientras tanto, puedes usar los modelos Kimi disponibles para probar el flujo de invocación y la estrategia de caché. Cuando se añadan los nuevos modelos, solo tendrás que cambiar el nombre.
7. Recomendaciones para elegir entre Kimi K3.1 Pro y Highspeed
Recomendación: primero pregúntate: «¿Hay alguien esperando?». Si no hay nadie esperando, elige la versión estándar. Si sí lo hay, prueba primero a bajar
reasoning_effortalow; si sigue pareciendo lento, cambia a Highspeed. Para decidir si vale la pena, convierte el tiempo de espera que ahorras en dinero con el método de la sección 2 y compáralo con la diferencia de precio calculada en la sección 3. Te recomendamos hacer una comparación a pequeña escala con tus propias solicitudes reales en APIYI apiyi.com. Los modelos disponibles y sus precios en la serie K3.1 Pro dependerán de la lista de modelos de la plataforma una vez que se publiquen. Incorporaremos este modelo lo antes posible.
Algunas pautas que puedes aplicar directamente:
- Usa la versión estándar por defecto y activa Highspeed solo cuando lo necesites, en lugar de configurarlo como opción predeterminada.
- Cuanto más reutilices los prefijos, más rentable será Highspeed, porque el precio de las solicitudes que aciertan en caché no se duplica.
- Si el equipo usa ambas versiones, distribuye las solicitudes según el punto de entrada: Highspeed para las interacciones en primer plano y la versión estándar para las tareas en segundo plano.
- Si usas Highspeed en Kimi Code, ten en cuenta la cuota: consume aproximadamente el doble.
Preguntas frecuentes
Q1: ¿Qué es Kimi K3.1 Pro Highspeed?
Es una versión de alta velocidad que Moonshot lanzó junto con Kimi K3.1 Pro. Su nombre de modelo es `kimi-k3.1-pro-highspeed`. Según la información oficial, es entre 2 y 3 veces más rápido que K3.1 Pro, ofrece las mismas capacidades y tiene una ventana de contexto de 1.048.576 tokens.
Q2: ¿La versión Highspeed ofrece peores resultados que la estándar o mejores?
Según la información oficial, ambas tienen las mismas capacidades. Por tanto, no es cierto que «por ser más rápido, sea menos inteligente» ni que «por ser más caro, sea más inteligente». Lo que realmente influye en la calidad de las respuestas es el nivel de `reasoning_effort`, no la versión que elijas.
Q3: ¿Cuánto más rápida es exactamente la versión Highspeed? ¿Hay datos concretos en tokens por segundo?
La información oficial solo indica que es entre 2 y 3 veces más rápida; no ha publicado cifras detalladas. Artificial Analysis, un tercero, midió una velocidad de generación de 80,7 tokens por segundo para la versión estándar, pero no ha medido Highspeed por separado. Por ahora, la cifra concreta de Highspeed no está verificada. Te recomendamos medirla con tus propias solicitudes.
Q4: ¿Por qué se dice que Highspeed no necesariamente cuesta el doble en la práctica?
Porque el precio de entrada con aciertos de caché es de 0,20 USD por millón de tokens en ambas versiones. Si una gran parte de la entrada de una solicitud consiste en prefijos repetidos que pueden aprovechar la caché, esa parte no tiene un recargo y el costo total será menos del doble. En el escenario A de este artículo, el costo por solicitud es aproximadamente 1,8 veces el de la versión estándar.
Q5: ¿Cómo se puede invocar Kimi K3.1 Pro y Highspeed desde China?
Puedes usar la API oficial de Kimi o llamar a los modelos a través de la interfaz compatible con OpenAI de APIYI apiyi.com. Solo tienes que cambiar `base_url` por `https://api.apiyi.com/v1`. Los nombres y precios de ambos modelos en APIYI dependen de la lista de modelos de la plataforma. La integración aún está en curso y esperamos ofrecer estos modelos pronto.
Q6: ¿Qué limitaciones conocidas tiene la serie Kimi K3.1 Pro?
– Ambos modelos mantienen el modo de razonamiento activado en todo momento. No es posible desactivarlo por completo; solo se puede ajustar con `reasoning_effort`.
– Parámetros como `temperature` y `top_p` tienen valores fijos. Debes omitirlos de las solicitudes, así que no puedes controlar el estilo ajustando los parámetros de muestreo.
– En Kimi Code, Highspeed requiere una suscripción Pro o superior y consume aproximadamente el doble de cuota.
– Según la información oficial, los pesos completos se publicarán antes del 4 de noviembre de 2026. Por ahora, aún no se han publicado.
Puntos clave para elegir entre Kimi K3.1 Pro y Highspeed
- Mismas capacidades: Highspeed solo ofrece más velocidad, no respuestas de mayor calidad
- El precio se duplica: el precio de entrada, el de salida y los de los dos niveles de escritura en caché se duplican; solo se mantiene en $0.20 el precio de las coincidencias de caché
- Hay pocos datos de velocidad: oficialmente solo se afirma que es entre 2 y 3 veces más rápido; las pruebas de terceros solo midieron la versión estándar, que alcanzó 80.7 tokens por segundo
- La decisión depende del tiempo de espera: calcula cuánto cuesta el tiempo de espera de las personas y compáralo con la diferencia de precio. No confundas multiplicar la velocidad por un factor con multiplicar la eficiencia por el mismo factor
- Highspeed para interacciones: es adecuado para programación interactiva, agentes conversacionales y demostraciones en directo
- La versión estándar para procesos por lotes: usar Highspeed para limpieza de datos por lotes, evaluaciones sin conexión y tareas programadas es pagar de más
- Primero baja el nivel antes de pagar más: reducir
reasoning_effortalowes una opción gratuita para acelerar el proceso
Resumen
Para elegir entre Kimi K3.1 Pro y Highspeed, hay tres puntos clave:
- Ambas versiones tienen las mismas capacidades: elegir una u otra no afecta a la calidad de las respuestas; la diferencia está en la velocidad, el precio y los requisitos de suscripción
- Hay una excepción en el recargo: de los cinco niveles de precios, cuatro se duplican. El precio de las coincidencias de caché no cambia, así que cuanto más reutilices los prefijos, menor será el recargo efectivo de Highspeed
- Solo vale la pena si alguien está esperando: en situaciones interactivas, Highspeed permite reducir a más de la mitad el tiempo de espera a cambio de pagar aproximadamente el doble; en procesos por lotes, solo supone pagar más
En la práctica, recomendamos probar primero la versión estándar con reasoning_effort=low. Si la velocidad sigue sin ser suficiente, cambia a Highspeed y comprueba el costo con tus propios datos de tokens usando la fórmula de la sección 3. Si te conectas mediante APIYI apiyi.com, consulta la lista de modelos de la plataforma para ver los modelos y precios disponibles de la serie K3.1 Pro. Añadiremos este modelo a la plataforma lo antes posible.
Referencias
- Portal oficial y blog de Kimi: anuncio del lanzamiento de K3.1 Pro y Highspeed, descripción de sus capacidades y canales
- Enlace:
kimi.ai -
Nota: fuente de la afirmación oficial «entre 2 y 3 veces más rápido, con las mismas capacidades»
-
Artificial Analysis: mediciones de terceros sobre la velocidad y el costo de los modelos
- Enlace:
artificialanalysis.ai -
Nota: fuente de los datos de la versión estándar: 80,7 tokens por segundo, cantidad de salida por tarea y costos
-
Blog de Simon Willison: registro público de un desarrollador
- Enlace:
simonwillison.net -
Nota: confirma que Highspeed cuesta el doble y que el precio por aciertos de caché es el mismo que el de la versión estándar
-
Lista de modelos de APIYI: modelos disponibles y precios de la plataforma
- Enlace:
docs.apiyi.com/models - Nota: verificación, el 24 de octubre de 2026, de la disponibilidad de la serie Kimi en la plataforma
Autor: equipo técnico de APIYI
Consultas técnicas: Para obtener más información sobre la integración, visita el centro de documentación en docs.apiyi.com. Los modelos de la serie Kimi K3.1 Pro disponibles en la plataforma y sus precios pueden consultarse en la lista de modelos. Añadiremos este modelo a la plataforma lo antes posible.