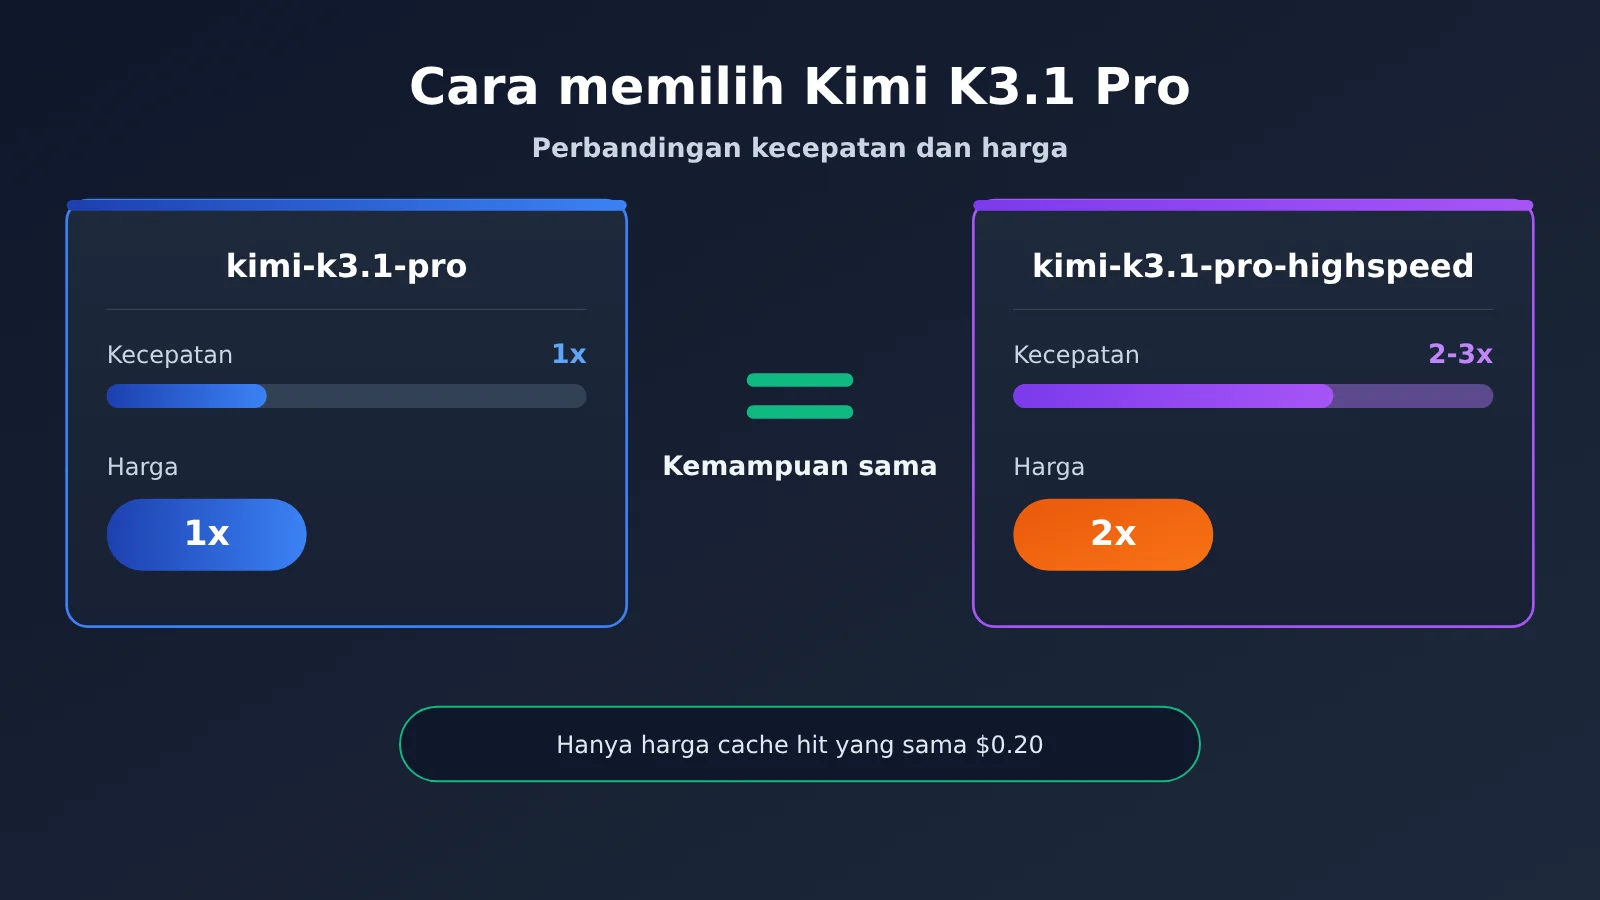
Kemampuan model Kimi K3.1 Pro dan Highspeed sama. Satu-satunya kelebihan Highspeed adalah kecepatannya—menurut keterangan resmi, 2–3 kali lebih cepat. Namun, harganya hampir dua kali lipat di semua kategori. Hanya harga saat cache hit yang tidak berubah: keduanya sama-sama $0.20. Jadi, pilih Highspeed jika Anda menunggu hasilnya di depan layar, dan pilih versi standar jika menjalankan banyak tugas di latar belakang.
Kesimpulan di atas didasarkan pada tiga sumber: blog resmi Moonshot menyebutkan bahwa kedua model memiliki “same capabilities”, halaman harga resmi mencantumkan lima tarif, dan dokumentasi resmi Kimi Code menyatakan bahwa Highspeed menggunakan sekitar dua kali lipat kuota. Di bawah ini, setiap fakta diberi label berdasarkan sumbernya: “klaim resmi”, “pihak ketiga”, atau “belum terverifikasi”. Jika tidak ada datanya, saya akan menyatakannya apa adanya—tanpa membuat perkiraan seolah-olah itu hasil pengujian.
Artikel ini bukan untuk membandingkan model mana yang lebih pintar. Kemampuan kedua versi sama. Pertanyaannya hanya soal biaya: apakah membayar dua kali lipat sepadan demi mendapatkan hasil dengan kualitas yang sama, tetapi lebih cepat?
Yang akan Anda dapatkan setelah membaca: tabel harga dengan lima kategori, cara menimbang waktu tunggu dengan biaya, dua contoh perhitungan yang bisa Anda periksa sendiri, serta tabel rekomendasi langsung untuk enam jenis skenario.
1. Perbedaan utama Kimi K3.1 Pro dan Highspeed: kemampuan sama, hanya berbeda kecepatan dan harga
Mari lihat gambaran besarnya. Tabel berikut merangkum semua aspek yang bisa dibandingkan dari kedua model. Kolom terakhir menunjukkan tingkat sumber informasinya. Konteks mengacu pada jumlah teks yang bisa “dilihat” model sekaligus, dihitung dalam token. Token adalah satuan dasar untuk penagihan dan komputasi model. Sederhananya, token bisa dipahami sebagai “potongan kata”.
| Aspek perbandingan | kimi-k3.1-pro (versi standar) | kimi-k3.1-pro-highspeed | Tingkat sumber |
|---|---|---|---|
| Kemampuan model | Patokan | Sama dengan versi standar | Klaim resmi |
| Panjang konteks | 1,048,576 tokens | 1,048,576 tokens | Klaim resmi |
| Kecepatan generasi | Patokan | Menurut klaim resmi, 2–3 kali lebih cepat | Klaim resmi, tanpa data terperinci |
| Harga satuan | Patokan | 2 kali lipat, kecuali untuk input yang cocok dengan cache | Harga resmi |
| Persyaratan penggunaan Kimi Code | Keanggotaan Plus atau lebih tinggi (konteks 1M memerlukan Pro atau lebih tinggi) | Keanggotaan Pro atau lebih tinggi | Dokumentasi resmi |
| Konsumsi kuota Kimi Code | Patokan | Sekitar 2 kali lipat | Dokumentasi resmi |
| Kanal resmi yang tersedia | kimi.ai, Kimi Work, Kimi Code, Kimi API | Sama seperti di kiri | Blog resmi |
Tabel ini menunjukkan hal yang sederhana: selain kecepatan, harga, dan persyaratan keanggotaan, kedua model tidak memiliki perbedaan lain. Kalau salah memilih, kamu tidak akan kehilangan “kualitas hasil”—yang berkurang hanya uang atau waktu.
1.1 Perbandingan harga Kimi K3.1 Pro dan Highspeed (kelima kategori ditampilkan)
Harga berikut diambil pada 2026-10-24, dalam dolar AS per satu juta token, belum termasuk pajak. Sumbernya adalah daftar harga resmi. Mari bahas beberapa komponen penagihan terlebih dahulu. “Input” adalah konten yang kamu kirim ke model, sedangkan “output” adalah konten yang dihasilkan model. “Cache” berarti platform menyimpan sementara suatu awalan konten yang sama, misalnya kode proyek yang terus disertakan. Jika awalan yang sama muncul di permintaan berikutnya, platform bisa langsung menggunakannya kembali. Ini disebut “cache hit” dan dikenai tarif lebih rendah. Saat pertama kali memasukkan konten ke cache, kamu dikenai biaya “penulisan”. Ada dua pilihan masa penyimpanan: 5 menit dan 1 jam.
| Komponen penagihan | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | Kelipatan |
|---|---|---|---|
| Input (cache miss) | $2.00 | $4.00 | 2 kali |
| Output | $10.00 | $20.00 | 2 kali |
| Input cache hit | $0.20 | $0.20 | Sama, satu-satunya yang tidak naik harga |
| Penulisan cache (5 menit) | $2.00 | $4.00 | 2 kali |
| Penulisan cache (1 jam) | $4.00 | $8.00 | 2 kali |
Catatan publik dari Simon Willison, pengembang pihak ketiga, juga mengonfirmasi hal ini: harga Highspeed naik dua kali lipat, tetapi tarif input yang cocok dengan cache tetap sama dengan versi standar. Detail ini akan berpengaruh saat menghitung biaya nanti. Jika sebagian besar input dalam permintaanmu cocok dengan cache, total biaya Highspeed sebenarnya tidak akan mencapai dua kali lipat penuh, karena komponen input terbesar tidak mengalami kenaikan harga.
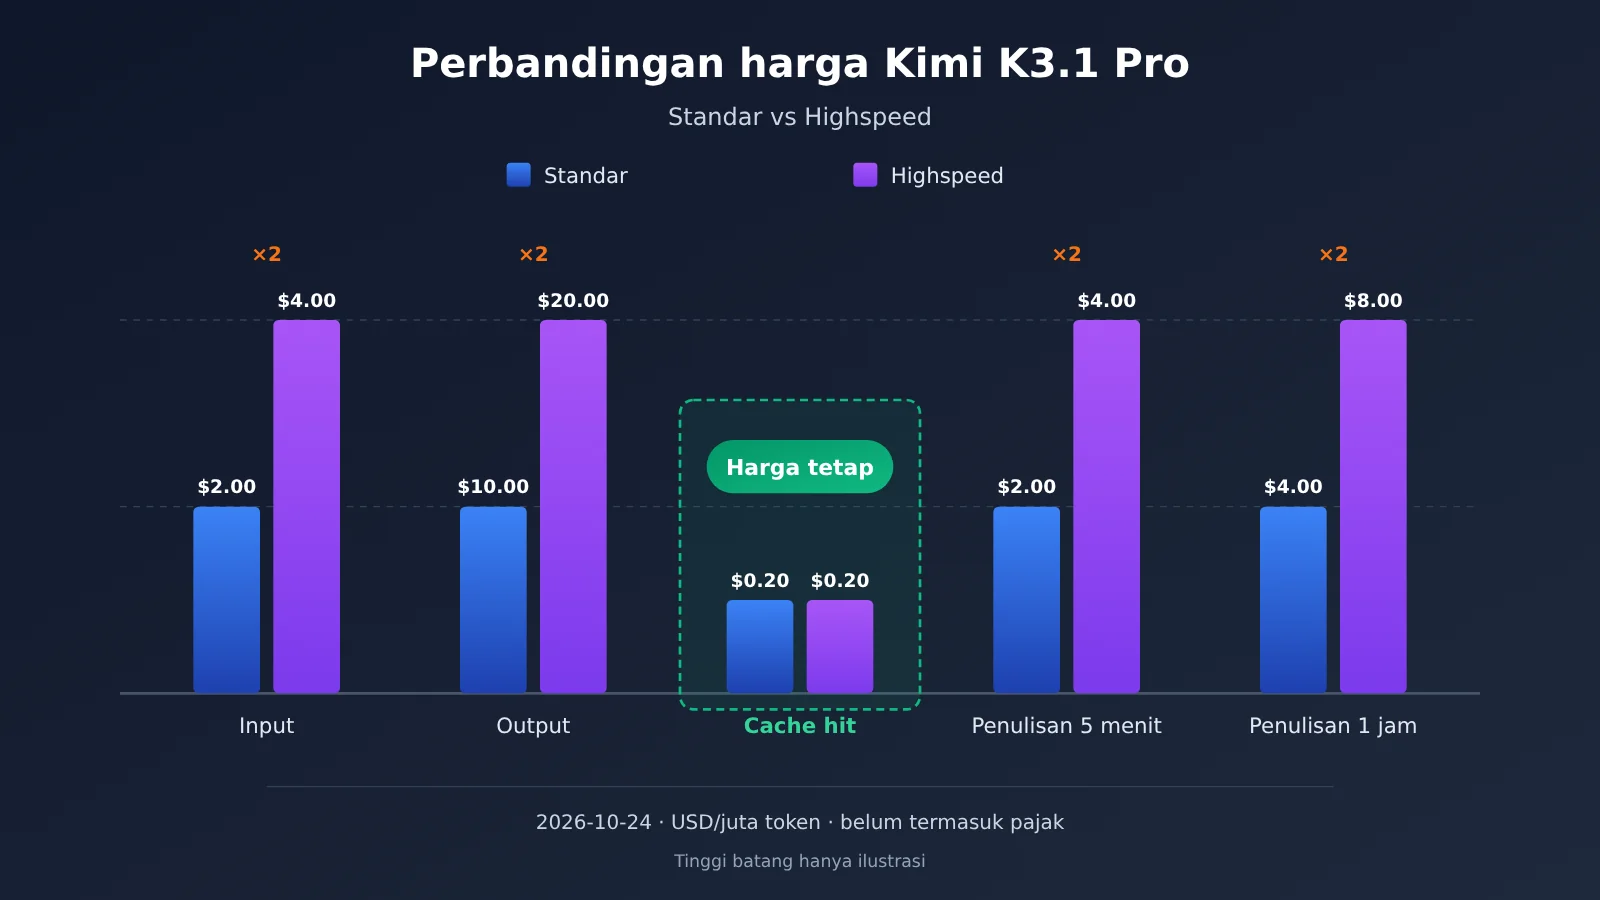
Catatan harga: harga pada diagram dan tabel di atas sama-sama mengacu pada daftar harga resmi. Jika kamu melakukan pemanggilan melalui APIYI apiyi.com, nama model dan harga di platform mengikuti daftar model yang tersedia di platform. Kedua model ini masih dalam proses integrasi. Kami akan segera menghadirkannya.
2. Seberapa besar sebenarnya perbedaan kecepatan Kimi K3.1 Pro Highspeed?
Di bagian ini, kita perlu berterus terang: saat ini, data kecepatan yang tersedia sangat terbatas. Pihak resmi hanya memberikan kisaran perbandingan, sementara pengujian pihak ketiga hanya mengukur versi standar. Belum ada benchmark publik yang mengukur kecepatan spesifik Highspeed dalam tokens/detik. Tokens/detik menunjukkan jumlah token yang dapat dihasilkan model per detik. Semakin tinggi angkanya, semakin cepat jawaban selesai ditampilkan.
| Data | Nilai | Tingkat sumber | Keterangan |
|---|---|---|---|
| Kecepatan Highspeed dibandingkan versi standar | 2–3 kali versi standar | Klaim resmi | Kondisi pengujian dan data terperinci tidak dipublikasikan |
| Kecepatan output versi standar | 80,7 tokens/detik | Pihak ketiga (Artificial Analysis) | Termasuk tingkat 2 dari 4 kategori penilaian |
| Kecepatan output Highspeed | Tidak tersedia | Belum terverifikasi | Pihak ketiga belum mengukurnya secara terpisah |
| Rata-rata output per tugas versi standar | Sekitar 55K tokens | Pihak ketiga (Artificial Analysis) | Merujuk pada tugas pengujian Intelligence Index |
| Biaya per tugas versi standar | Sekitar $1,98 (halaman model menampilkan $2,11) | Pihak ketiga (Artificial Analysis) | Sama seperti di atas |
Jadi, untuk pertanyaan “berapa tokens per detik yang dihasilkan Highspeed?”, saat ini belum ada jawaban yang bisa diandalkan. Artikel yang mencantumkan angka spesifik mungkin menggunakan pengujian sendiri—jadi periksa kondisi pengujiannya—atau sekadar mengalikan 80,7 dengan 2 atau 3. Kami tidak akan memberikan angka seperti itu. Sebagai gantinya, kami akan memberikan cara menilai yang tidak bergantung pada data benchmark.
2.1 Cara memilih Kimi K3.1 Pro: hitung nilai waktu tunggu pengguna dalam bentuk uang
Kecepatan itu sendiri tidak terlalu bernilai. Yang bernilai adalah “berapa lama waktu tunggu seseorang bisa dikurangi”. Kalau tidak ada yang menunggu, peningkatan kecepatan tidak berarti apa-apa. Berikut cara menilainya dalam empat langkah:
- Perkirakan waktu tunggu untuk satu permintaan: jumlah tokens output ÷ kecepatan. Sebagai contoh, dengan versi standar yang menghasilkan 80,7 tokens/detik dan output sebanyak 1.500 tokens, konten yang terlihat akan selesai dalam sekitar 19 detik. Perlu diingat, kedua model selalu menggunakan mode berpikir, yang juga memerlukan waktu. Jadi, waktu tunggu sebenarnya akan lebih lama, bergantung pada tugasnya.
- Perkirakan waktu yang dihemat dengan Highspeed: berdasarkan klaim resmi, yaitu 2–3 kali lebih cepat, waktu tunggu untuk output yang sama kira-kira menjadi 6–10 detik. Artinya, setiap permintaan menghemat sekitar 10 detik. Ini hanya perkiraan, bukan hasil pengujian. Verifikasi dengan permintaan Anda sendiri.
- Kalikan dengan jumlah penggunaan dan biaya waktu: jika Anda berinteraksi 100 kali sehari dan menghemat 10 detik setiap kali, totalnya sekitar 17 menit. Kalikan 17 menit itu dengan nilai waktu Anda atau tim.
- Bandingkan dengan biaya tambahan: gunakan metode di bagian 3 untuk menghitung biaya tambahan Highspeed per hari. Jika nilai waktu yang dihemat lebih besar daripada biaya tambahannya, berarti Highspeed layak dipilih.
Ada satu kesalahpahaman umum yang perlu dihindari: kecepatan 3 kali lipat bukan berarti efisiensi kerja meningkat 3 kali lipat. Output model hanya satu bagian dari alur kerja. Waktu untuk membaca kode, berpikir, mengedit, dan menjalankan pengujian tidak akan berkurang karenanya. Yang dihemat hanya waktu “menunggu model beberapa detik”. Karena itu, di langkah ketiga, gunakan waktu tunggu yang benar-benar dihemat, jangan langsung mengalikan hasil kerja dengan faktor kecepatan.
3. Perhitungan Biaya Kimi K3.1 Pro dan Highspeed
Dua perhitungan berikut menggunakan harga resmi. Rumusnya ditulis lengkap, jadi Anda bisa mengganti jumlah token sesuai kebutuhan dan menghitungnya kembali.
3.1 Skenario A: Mengedit kode secara interaktif sebanyak 20 kali
Asumsi: Setiap permintaan berisi 30.000 token input, dengan 25.000 token konteks repositori yang disertakan berulang kali dan 5.000 token konten baru; setiap permintaan menghasilkan 1.500 token output. Permintaan dilakukan 20 kali berturut-turut dengan jeda kurang dari 5 menit, sehingga cache tetap aktif.
Versi standar:
- Permintaan pertama: input
30000 × $2 / 1 juta = $0.06, dengan 25.000 token dimasukkan ke cache. Biaya bagian yang disimpan di cache adalah25000 × $2 / 1 juta = $0.05 - Untuk setiap permintaan berikutnya yang menggunakan cache:
25000 × $0.2 / 1 juta = $0.005 - Konten baru per permintaan:
5000 × $2 / 1 juta = $0.01 - Output per permintaan:
1500 × $10 / 1 juta = $0.015 - Total per permintaan:
$0.005 + $0.01 + $0.015 = $0.03
Highspeed:
- Harga untuk penggunaan cache tetap sama, yaitu
$0.005 - Biaya konten baru menjadi dua kali lipat:
5000 × $4 / 1 juta = $0.02 - Biaya output menjadi dua kali lipat:
1500 × $20 / 1 juta = $0.03 - Total per permintaan:
$0.005 + $0.02 + $0.03 = $0.055, atau sekitar $0.06
Termasuk biaya satu kali untuk menyimpan cache pada permintaan pertama, total biaya untuk 20 permintaan adalah sekitar $0.66 untuk versi standar dan $1.26 untuk Highspeed. Jika dihitung per permintaan, biaya Highspeed sekitar 1,8 kali versi standar, tidak sampai tepat 2 kali lipat karena biaya penggunaan cache tidak naik. Kesimpulannya: biayanya kira-kira dua kali lipat, tetapi waktu tunggu bisa berkurang lebih dari setengah sesuai klaim resmi. Tambahan biaya sekitar $0.6 ditukar dengan waktu tunggu beberapa menit yang dihemat dari 20 permintaan. Bagi kebanyakan developer, ini sepadan.
3.2 Skenario B: Pemrosesan batch offline sebanyak 1.000 kali
Asumsi: Setiap permintaan berisi 8.000 token input dan menghasilkan 600 token output. Proses dijalankan 1.000 kali tanpa awalan yang bisa digunakan ulang, sehingga cache tidak bisa dimanfaatkan.
- Biaya per permintaan versi standar:
(8000 × $2 + 600 × $10) / 1 juta = $0.016 + $0.006 = $0.022; untuk 1.000 kali, totalnya$22 - Biaya per permintaan Highspeed:
(8000 × $4 + 600 × $20) / 1 juta = $0.032 + $0.012 = $0.044; untuk 1.000 kali, totalnya$44
Kesimpulan: rugi saja. Tidak ada orang yang menunggu setiap hasil. Total waktu penyelesaian tugas biasanya ditentukan oleh jumlah permintaan yang berjalan bersamaan dan antrean, jadi biaya tambahan $22 tidak memberikan manfaat yang terasa.
| Komponen perhitungan | Skenario A: Mengedit kode secara interaktif | Skenario B: Pemrosesan batch offline |
|---|---|---|
| Jumlah permintaan | 20 kali | 1.000 kali |
| Bisa menggunakan cache? | Bisa, 25.000 token digunakan ulang | Tidak bisa |
| Total biaya versi standar | Sekitar $0.66 | $22 |
| Total biaya Highspeed | Sekitar $1.26 | $44 |
| Kelipatan biaya aktual | Sekitar 1,8–1,9 kali | 2 kali |
| Ada yang menunggu? | Ada | Tidak ada |
| Kesimpulan | Biayanya kira-kira dua kali lipat, tetapi waktu tunggu berkurang lebih dari setengah. Layak dipilih. | Rugi saja. Pilih versi standar. |
4. Memilih Kimi K3.1 Pro atau Highspeed sesuai skenario
Dengan menerapkan panduan di atas pada skenario umum, kita bisa langsung melihat rekomendasinya di tabel berikut. Dasar pertimbangannya hanya dua: apakah ada orang yang menunggu, dan apakah cache bisa dimanfaatkan.
| Skenario | Rekomendasi | Alasan |
|---|---|---|
| Pemrograman interaktif | Highspeed | Pengguna menunggu di depan layar sementara perubahan dikerjakan. Konteks repositori bisa memanfaatkan cache, sehingga biaya tambahannya secara nyata tidak sampai 2 kali lipat |
| Agent percakapan | Highspeed | Permintaan singkat berulang dan rangkaian pemanggilan alat membuat waktu tunggu di setiap putaran menumpuk dan terasa jelas |
| Demo dan siaran langsung | Highspeed | Penonton sedang menyimak. Jawaban yang lambat bisa langsung mengurangi kualitas acara, sementara selisih biaya untuk puluhan pemanggilan bisa diabaikan |
| Pembersihan data massal | Versi standar | Tidak ada yang menunggu hasil satu per satu. Kecepatan tidak memberi nilai tambah, jadi harga dua kali lipat hanya menambah biaya |
| Evaluasi offline | Versi standar | Evaluasi hanya memperhatikan kualitas hasil. Kemampuan kedua versi sama, dan skor tidak berubah karena kecepatan |
| Tugas terjadwal | Versi standar | Tugas berjalan pada malam hari atau di latar belakang. Selesai beberapa menit lebih cepat tidak ada bedanya, jadi biaya lebih penting |
Jika sebuah produk mencakup kedua jenis skenario, keduanya juga bisa digunakan sekaligus: permintaan yang berinteraksi langsung dengan pengguna di sisi depan diarahkan ke kimi-k3.1-pro-highspeed, sedangkan peringkasan, pengarsipan, dan pemrosesan massal di sisi belakang diarahkan ke kimi-k3.1-pro. Kemampuan kedua model sama, jadi mengganti nama model tidak memerlukan perubahan pada petunjuk.
5. Variabel ketiga untuk mempercepat Kimi K3.1 Pro: reasoning_effort dan kuota Kimi Code
Sebelum memutuskan untuk membayar lebih, ada opsi gratis untuk mempercepat model yang layak dicoba terlebih dahulu. Kedua model ini selalu berpikir, artinya model akan melakukan penalaran internal sebelum menjawab. Lama waktu penalaran dikendalikan oleh parameter reasoning_effort, yang bisa dipahami sebagai “seberapa dalam model diminta untuk berpikir”. Semakin rendah levelnya, semakin singkat waktu berpikir dan semakin cepat hasilnya keluar. Berikut penjelasan dari dokumentasi resmi:
reasoning_effort: mendukung tiga level, yaitulow/high/max, dengan nilai defaultmax- Jika ingin respons lebih cepat, coba turunkan versi standar ke
lowterlebih dahulu. Jika kecepatannya sudah cukup dan kualitasnya masih bisa diterima, Anda tidak perlu membayar dua kali lipat untuk Highspeed - Menurunkan level dapat mengurangi kedalaman penalaran untuk tugas yang kompleks. Artinya, Anda menukar kualitas dengan kecepatan. Sementara itu, Highspeed menukar biaya dengan kecepatan tanpa mengurangi kualitas. Konsekuensinya berbeda
- Keduanya juga bisa digabungkan: Highspeed dengan
lowcocok untuk situasi yang sangat sensitif terhadap latensi dan tugasnya tidak terlalu rumit
Hal lain yang mudah terlewat adalah kuota di Kimi Code. Kimi Code adalah alat pemrograman dari Moonshot yang penggunaan layanannya dihitung berdasarkan kuota keanggotaan. Menurut dokumentasi resmi Kimi Code:
k3.1-promemerlukan keanggotaan Plus atau lebih tinggi. Untuk menggunakan jendela konteks 1M, diperlukan keanggotaan Pro atau lebih tinggik3.1-pro-highspeedmemerlukan keanggotaan Pro atau lebih tinggi- Versi Highspeed menghabiskan sekitar dua kali lipat kuota. Dengan kuota keanggotaan yang sama, penggunaan Highspeed hanya memungkinkan Anda menyelesaikan kira-kira separuh pekerjaan
Saat memanggil API, perhatikan juga beberapa parameter tetap berikut. Dokumentasi resmi mengharuskan Anda untuk langsung menghilangkannya dari permintaan, bukan mengirimkannya secara manual:
temperatureditetapkan pada1.0top_pditetapkan pada0.95nditetapkan pada1presence_penaltydanfrequency_penaltyditetapkan pada0max_completion_tokensbernilai default131072, dengan nilai maksimum1048576
6. Selain lewat kanal resmi, cara lebih praktis menggunakan Kimi K3.1 Pro: integrasi melalui APIYI
API resmi mendukung format OpenAI dan Anthropic, termasuk antarmuka Chat Completions, Responses, dan Messages. “Kompatibel dengan OpenAI” berarti kode yang sudah menggunakan OpenAI SDK pada dasarnya tidak perlu diubah. Anda hanya perlu mengganti alamat dan kunci API, lalu menyesuaikan nama model.
Developer di Indonesia dapat menggunakan APIYI apiyi.com untuk memanggil berbagai model melalui satu kunci API dengan skema bayar sesuai pemakaian. Pengguna baru juga mendapat kuota gratis untuk pengujian. Berikut cara integrasinya:
- Format OpenAI: atur
base_urlkehttps://api.apiyi.com/v1 - Format Anthropic: atur alamat dasar ke
https://api.apiyi.com - Isi
modeldengan nama model yang sesuai di daftar model platform
Perlu diketahui, berdasarkan pengecekan pada 2026-10-24, daftar model Kimi di APIYI sudah mencakup kimi-k2.5, kimi-k2.6, kimi-k2.7-code, kimi-k3, dan beberapa model lainnya. Namun, kimi-k3.1-pro dan kimi-k3.1-pro-highspeed belum tersedia. Nama model dan harga kedua model tersebut di platform akan mengikuti daftar model yang tersedia. Kami akan segera menghadirkan model ini. Sambil menunggu, Anda bisa menggunakan model Kimi yang sudah tersedia untuk menguji alur pemanggilan dan strategi cache. Setelah model baru tersedia, Anda hanya perlu mengganti nama modelnya.
7. Rekomendasi Memilih Kimi K3.1 Pro atau Highspeed
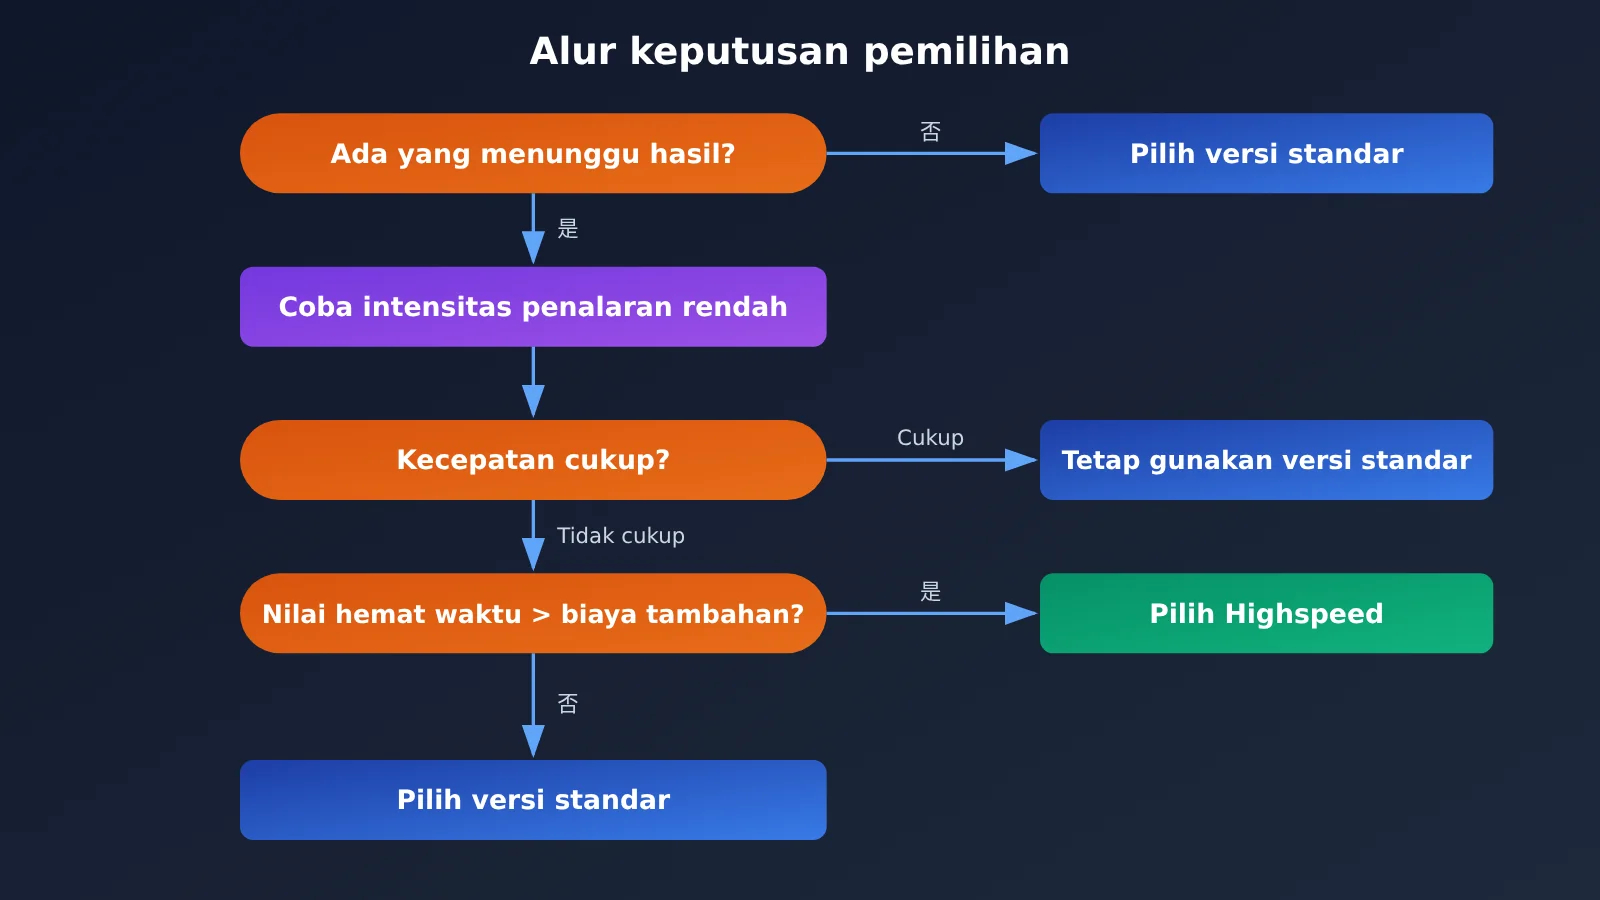
Rekomendasi: Mulailah dengan bertanya, “Apakah ada orang yang sedang menunggu?” Jika tidak ada, pilih versi standar. Jika ada, turunkan
reasoning_effortkelowdan coba sekali. Jika masih terasa lambat, beralihlah ke Highspeed. Untuk menentukan apakah biaya tambahannya sepadan, gunakan metode di Bagian 2 untuk mengonversi waktu tunggu yang dihemat menjadi nilai uang, lalu bandingkan dengan selisih harga yang dihitung di Bagian 3. Sebaiknya lakukan perbandingan kecil menggunakan permintaan nyata Anda sendiri di APIYI apiyi.com. Model dan harga K3.1 Pro Series setelah tersedia akan mengikuti daftar model di platform. Kami akan segera menghadirkan model ini.
Beberapa prinsip yang bisa langsung diterapkan:
- Gunakan versi standar sebagai pilihan default. Anggap Highspeed sebagai opsi sesuai kebutuhan, bukan konfigurasi default.
- Semakin banyak prefiks yang digunakan ulang, semakin menguntungkan Highspeed, karena harga input yang mengenai cache tidak naik dua kali lipat.
- Jika tim menggunakan kedua versi, pisahkan berdasarkan jalur penggunaan: gunakan Highspeed untuk interaksi langsung dan versi standar untuk tugas latar belakang.
- Perhitungkan kuota jika menggunakan Highspeed di Kimi Code karena konsumsi kuotanya sekitar 2 kali lipat.
FAQ
Q1: Apa itu Kimi K3.1 Pro Highspeed?
Ini adalah versi berkecepatan tinggi yang dirilis Moonshot bersamaan dengan Kimi K3.1 Pro, dengan nama model `kimi-k3.1-pro-highspeed`. Menurut keterangan resmi, kecepatannya 2–3 kali K3.1 Pro, dengan kemampuan model yang sama dan jendela konteks 1.048.576 tokens.
Q2: Apakah hasil Highspeed lebih buruk atau lebih baik daripada versi standar?
Menurut keterangan resmi, kemampuan keduanya sama. Jadi, “lebih cepat berarti lebih bodoh” atau “lebih mahal berarti lebih pintar” tidak berlaku di sini. Kualitas jawaban sebenarnya dipengaruhi oleh tingkat `reasoning_effort`, bukan versi yang dipilih.
Q3: Seberapa cepat Highspeed? Apakah ada angka tokens/detik yang spesifik?
Pihak resmi hanya menyebut kisaran “2–3 kali lebih cepat” tanpa merilis data terperinci. Artificial Analysis, pihak ketiga, mengukur kecepatan output versi standar sebesar 80.7 tokens/detik, tetapi belum mengukur Highspeed secara terpisah. Angka pasti Highspeed saat ini belum terverifikasi, jadi sebaiknya uji sendiri menggunakan permintaan Anda.
Q4: Mengapa biaya Highspeed belum tentu tepat 2 kali lebih mahal?
Karena harga input yang mengenai cache untuk kedua versi sama-sama $0.20 per juta tokens. Jika sebagian besar input dalam permintaan berupa prefiks berulang yang mengenai cache, bagian tersebut tidak dikenai biaya tambahan. Akibatnya, rasio total biaya akan kurang dari 2 kali. Dalam skenario A di artikel ini, biaya per permintaan sekitar 1,8 kali biaya versi standar.
Q5: Bagaimana cara menggunakan Kimi K3.1 Pro dan Highspeed dari dalam negeri?
Anda dapat menggunakan Kimi API resmi atau memanggilnya melalui antarmuka yang kompatibel dengan OpenAI dari APIYI apiyi.com. Ubah `base_url` menjadi `https://api.apiyi.com/v1`. Nama model dan harga kedua versi di APIYI akan mengikuti daftar model di platform. Keduanya masih dalam proses integrasi, dan kami akan segera menghadirkan model ini.
Q6: Apa saja batasan Kimi K3.1 Pro Series yang sudah diketahui?
– Kedua model selalu menggunakan mode berpikir. Penalaran tidak dapat dinonaktifkan sepenuhnya, tetapi tingkatnya bisa diatur melalui `reasoning_effort`.
– Parameter seperti `temperature` dan `top_p` ditetapkan, jadi tidak perlu disertakan dalam permintaan. Gaya output tidak dapat dikontrol dengan mengatur parameter sampling.
– Di Kimi Code, Highspeed memerlukan keanggotaan Pro atau yang lebih tinggi dan menggunakan sekitar 2 kali kuota.
– Pihak resmi menyatakan bahwa bobot model lengkap akan dirilis sebelum 2026-11-04, tetapi hingga kini belum dirilis.
Poin Penting Memilih Kimi K3.1 Pro atau Highspeed
- Kemampuannya sama: Highspeed hanya menawarkan kecepatan, bukan kualitas jawaban yang lebih baik
- Harga dua kali lipat: Harga input, output, dan dua tingkat penulisan cache semuanya menjadi 2 kali lipat. Hanya harga cache hit yang tetap sama, yaitu $0.20
- Data kecepatan terbatas: Pihak resmi hanya menyebut 2–3 kali lebih cepat, sementara pengujian pihak ketiga hanya mengukur versi standar dengan kecepatan 80.7 token/detik
- Pertimbangkan waktu tunggu: Hitung waktu tunggu pengguna sebagai biaya, lalu bandingkan dengan selisih harga. Jangan samakan kelipatan kecepatan dengan kelipatan efisiensi
- Pilih Highspeed untuk interaksi: Cocok untuk pemrograman interaktif, Agent percakapan, dan siaran langsung demo
- Pilih versi standar untuk pemrosesan batch: Menggunakan Highspeed untuk pembersihan data batch, evaluasi offline, dan tugas terjadwal hanya akan menambah biaya
- Turunkan pengaturan sebelum membayar lebih: Mengatur
reasoning_effortkelowadalah cara gratis untuk meningkatkan kecepatan
Kesimpulan
Ada tiga hal utama yang perlu dipertimbangkan saat memilih Kimi K3.1 Pro atau Highspeed:
- Kemampuan kedua versi sama: Pilihan Anda tidak memengaruhi kualitas jawaban. Perbedaannya hanya pada kecepatan, harga, dan persyaratan keanggotaan
- Ada pengecualian pada kenaikan harga: Dari lima tingkatan harga, empat di antaranya menjadi dua kali lipat. Harga cache hit tidak berubah. Semakin banyak prefiks yang digunakan ulang, semakin kecil kenaikan biaya aktual Highspeed
- Highspeed sepadan jika ada orang yang menunggu: Untuk skenario interaktif, Highspeed menukar waktu tunggu yang berkurang lebih dari setengah dengan biaya sekitar dua kali lipat. Untuk pemrosesan batch, Anda hanya akan membayar lebih
Dalam praktiknya, sebaiknya mulai dengan menguji versi standar menggunakan reasoning_effort=low. Jika kecepatannya masih belum memadai, beralihlah ke Highspeed. Gunakan jumlah token Anda sendiri dalam rumus di Bagian 3 untuk memeriksa kembali biayanya. Saat menggunakan APIYI apiyi.com untuk mengakses model ini, nama model dan harga seri K3.1 Pro mengikuti daftar model di platform. Kami akan segera menyediakan model ini.
Referensi
- Situs resmi dan blog Kimi: Informasi peluncuran K3.1 Pro dan Highspeed, kemampuan, serta ketersediaan
- Tautan:
kimi.ai -
Keterangan: Sumber pernyataan resmi “kecepatan 2–3 kali lebih tinggi, kemampuan sama”
-
Artificial Analysis: Pengukuran kecepatan dan biaya model oleh pihak ketiga
- Tautan:
artificialanalysis.ai -
Keterangan: Sumber data kecepatan versi standar sebesar 80,7 token/detik, jumlah output per tugas, dan biaya
-
Blog Simon Willison: Catatan publik dari pengembang
- Tautan:
simonwillison.net -
Keterangan: Mengonfirmasi bahwa harga Highspeed dua kali lipat, sedangkan harga saat cache digunakan sama dengan versi standar
-
Daftar model APIYI: Model dan harga yang tersedia di platform
- Tautan:
docs.apiyi.com/models - Keterangan: Ketersediaan model seri Kimi di platform, diverifikasi pada 2026-10-24
Penulis: Tim teknis APIYI
Diskusi teknis: Untuk informasi integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com. Model seri Kimi K3.1 Pro dan harganya mengikuti daftar model di platform. Kami akan segera menghadirkan model ini.