Nota del autor: hasta el 8 de noviembre de 2026, Gemini 4 Flash sigue sin tener un ID de modelo oficial. En este artículo analizamos el origen de las pistas sobre los nombres en clave Hydrogen y Hyperion, aclaramos su relación con Gemini 4 Argon y Gemini 3.8 Flash, y repasamos cómo elegir un modelo y prepararse antes del lanzamiento.
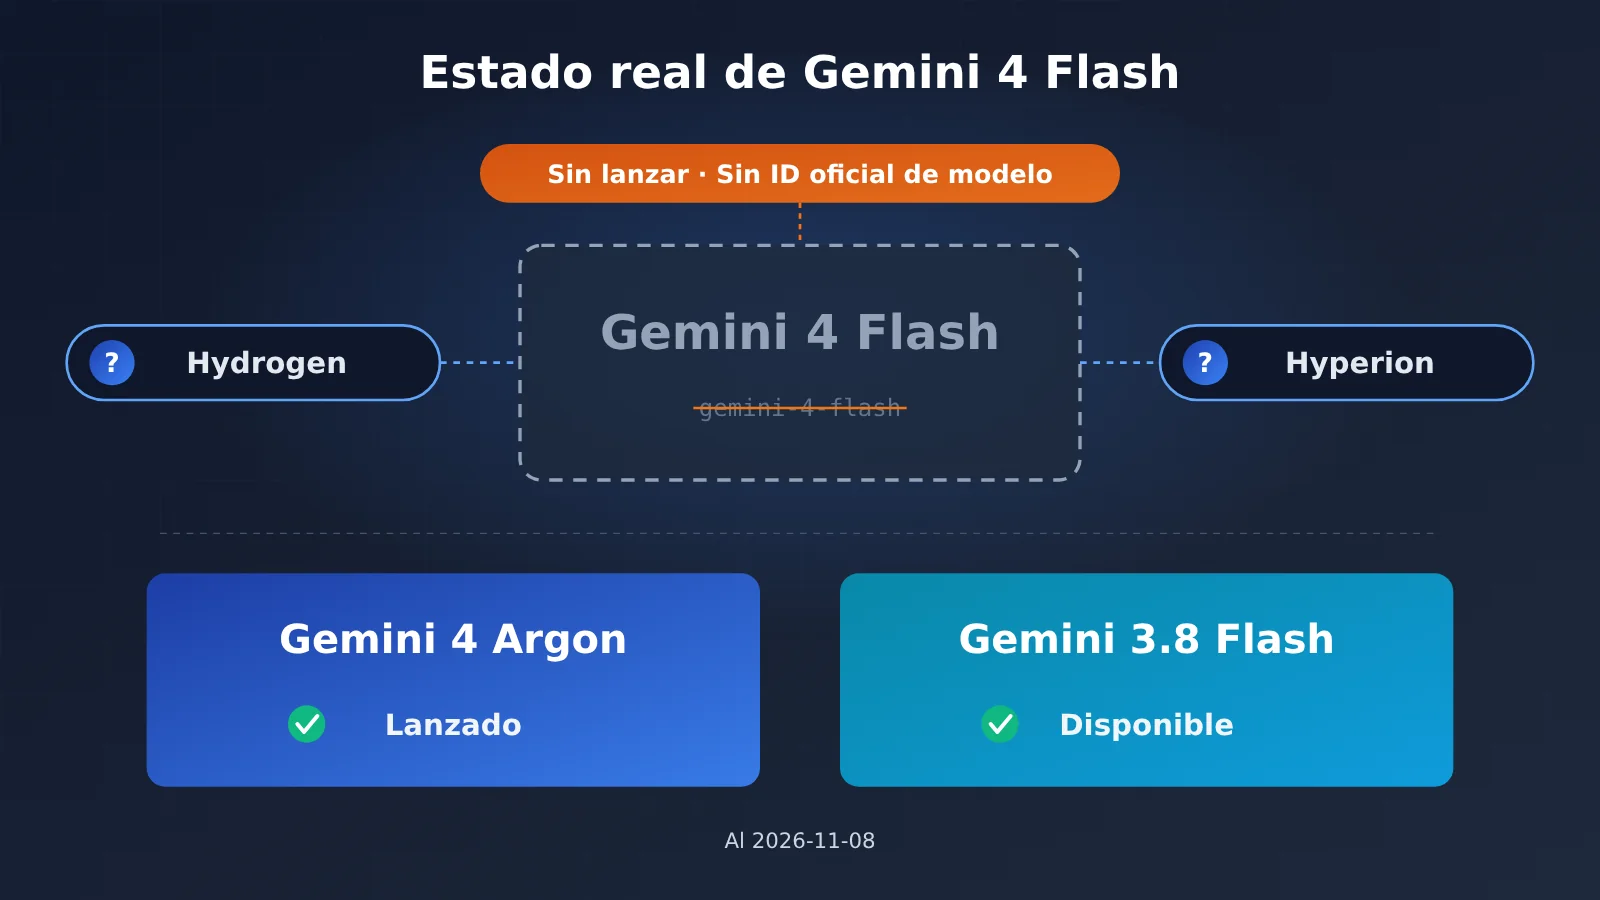
Empecemos por la conclusión: Gemini 4 Flash aún no se ha lanzado. Hasta el 8 de noviembre de 2026, Google no ha publicado un ID de modelo oficial para Gemini 4 Flash, gemini-4-flash tampoco aparece en la referencia de modelos de la API de Gemini y no existe una fecha de lanzamiento oficial. Si tu equipo está pensando en pausar su planificación porque «Flash llega la semana que viene», mejor no lo hagas todavía.
Por ahora hay dos modelos que sí se pueden usar. Si necesitas capacidades de primer nivel y un contexto largo, usa gemini-4-argon; si buscas alta concurrencia, baja latencia y costos controlados, usa Gemini 3.8 Flash. Vale la pena seguir de cerca los nombres en clave Hydrogen y Hyperion, pero por el momento son solo pistas filtradas, no señales de lanzamiento.
No se trata de desmerecer el nuevo modelo. Simplemente separamos los «hechos confirmados», las «pistas filtradas» y los «rumores» para que puedas planificar basándote en información verificable.
Lo esencial: en 3 minutos conocerás el estado real de Gemini 4 Flash y tendrás una guía para decidir qué puedes usar ahora y qué preparar antes de su lanzamiento.
¿Se ha lanzado Gemini 4 Flash? Primero, un criterio claro
Antes de hablar de rumores sobre el lanzamiento de un modelo, conviene que todo el equipo use el mismo criterio. De lo contrario, un responsable de producto puede ver una filtración, un ingeniero una captura de pantalla y cada uno acabará entendiendo algo distinto por «lanzamiento». Recomendamos usar los canales de publicación de Google como única fuente y exigir que se cumplan varias condiciones a la vez.
| Criterio | Requisito concreto | Estado actual de Gemini 4 Flash |
|---|---|---|
| ID oficial del modelo | Aparece en la página de referencia de modelos de la documentación de Gemini API | ❌ No aparece, solo figura gemini-4-argon |
| Página de precios | La página de precios de Gemini API incluye el precio del modelo | ❌ No |
| Disponible en AI Studio | Se puede seleccionar directamente en el menú de modelos de AI Studio | ❌ No hay ninguna opción oficial |
| Anuncio oficial | Google lo ha anunciado en su blog o en una cuenta oficial | ❌ No |
La regla es sencilla: las tres primeras condiciones deben cumplirse a la vez para considerar que el modelo se ha lanzado. Un anuncio oficial suma, pero si no hay ID del modelo ni precios, los desarrolladores siguen sin poder integrarlo en producción. Con este criterio, Gemini 4 Flash no cumple ninguna de las cuatro condiciones, así que la conclusión no deja lugar a dudas.
Este criterio tiene otra ventaja: se puede incorporar directamente al proceso del equipo para aprobar nuevos modelos. En adelante, tanto si se trata de Gemini, Claude o un modelo de otro proveedor, primero se puede comprobar si supera este filtro y luego decidir si vale la pena destinar recursos a evaluarlo.
💡 Criterio recomendado: además de la documentación oficial, la lista de modelos de la plataforma de acceso es otro punto de comprobación útil. Por ejemplo, en APIYI apiyi.com, la disponibilidad de un modelo para su invocación se determina por la lista de modelos de la consola. Un modelo del que solo hay rumores no aparecerá en ella por mucho revuelo que cause una filtración.
Gemini 4 Flash: comparación de hechos, filtraciones y rumores
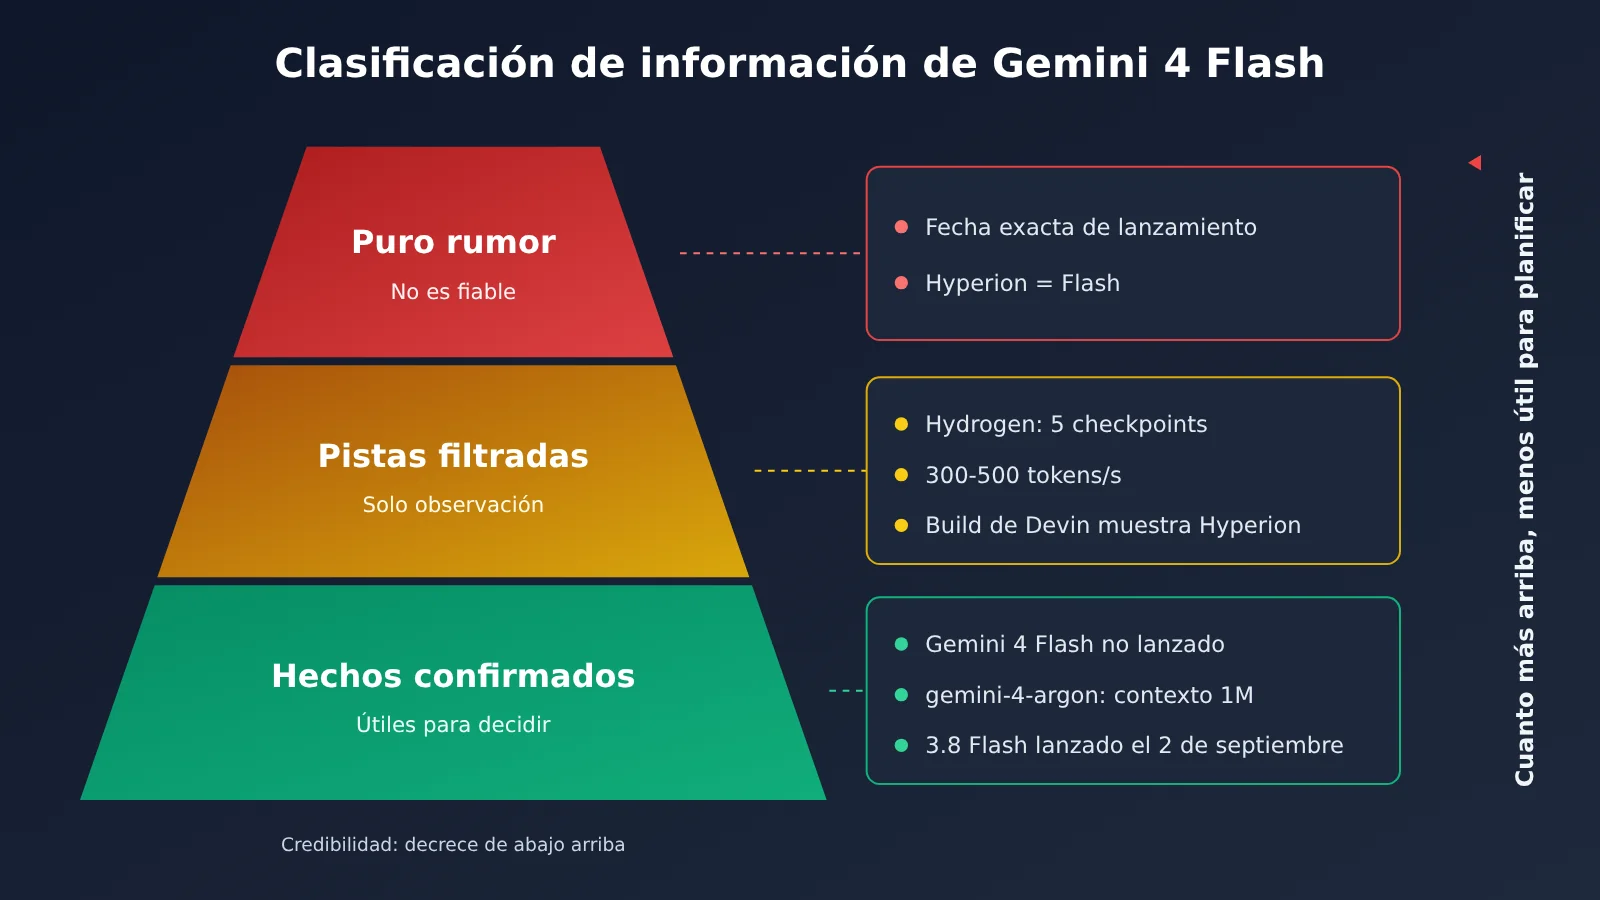
Clasificar la información que circula según su fiabilidad es más útil que debatir cada dato por separado. Esta tabla resume los criterios principales del artículo:
| Información | Categoría | Fuente | ¿Sirve para tomar decisiones? |
|---|---|---|---|
| Gemini 4 Flash no se ha lanzado y no tiene un ID de modelo oficial | Hecho confirmado | Referencia de modelos de la API de Gemini | ✅ Sí |
gemini-4-argon se ha lanzado, tiene una ventana de contexto de 1M y está disponible mediante API |
Hecho confirmado | Documentación de la API de Gemini | ✅ Sí |
| Gemini 3.8 Flash es la versión Flash más reciente y se lanzó el 2 de septiembre de 2026 | Hecho confirmado | Anuncio oficial de Google | ✅ Sí |
| El nombre interno de Gemini 4 Flash es Hydrogen y tiene cinco checkpoints | Indicio filtrado | Filtración de una cuenta de X | ⚠️ Solo para seguimiento |
| La velocidad de salida de Hydrogen es de 300-500 tokens/s | Indicio filtrado | Filtración de una cuenta de X | ⚠️ No sirve para planificar la capacidad |
| Pruebas A/B en LMArena y AI Studio a partir de finales de octubre | Indicio filtrado | Filtración de una cuenta de X | ⚠️ Solo para seguimiento |
| La familia de modelos Hyperion aparece en una compilación de Devin | Indicio filtrado | Compilación de Devin de Cognition | ⚠️ Sin confirmación del proveedor |
| «Hyperion es Gemini 4 Flash» | Pura especulación | Asociación hecha por la comunidad | ❌ No |
| «Gemini 4 Flash se lanzará en una fecha concreta» | Puro rumor | Sin fuente oficial | ❌ No |
Gemini 4 Flash, con nombre en clave Hydrogen: hasta dónde llegan las filtraciones
Hydrogen es el nombre en clave que más se relaciona actualmente con Gemini 4 Flash. Según filtraciones publicadas en X, Gemini 4 Flash recibe internamente el nombre de Hydrogen y ya ha pasado por cinco checkpoints. Las publicaciones también afirman que su velocidad de salida está entre 300-500 tokens/s y que participa en pruebas A/B en LMArena y AI Studio desde finales de octubre.
Estos datos parecen muy concretos, pero conviene tener en cuenta su procedencia. Todas las afirmaciones sobre Hydrogen vienen de cuentas de X, no de documentación oficial, blogs ni fichas de modelos de Google. Los cinco checkpoints indican que «sigue en fase de iteración interna», no que esté «a punto de finalizarse».
Qué significan las pistas sobre Hydrogen para los desarrolladores
Incluso si damos por ciertas todas las filtraciones, las conclusiones que podemos sacar son muy limitadas. Una prueba A/B implica que el modelo podría aparecer de forma anónima en plataformas de evaluación: los usuarios no pueden seleccionarlo directamente ni obtener un ID de modelo estable. El rango de 300-500 tokens/s es muy amplio y no se indican las condiciones de la prueba, por lo que no sirve para estimar la latencia ni la capacidad de concurrencia de tu servicio.
La lectura más útil para los desarrolladores es que Hydrogen apunta a que Google probablemente está trabajando en un modelo de nivel Flash para la familia Gemini 4, pero todavía no hay nada definitivo sobre fechas, precios o límites de capacidad. Puedes añadirlo a tu «lista de seguimiento», pero no deberías incluirlo como una «dependencia en la planificación».
- Qué puedes hacer: seguir las páginas de referencia de modelos y de precios de la documentación de Gemini API, y estar atento a cambios en el menú de selección de modelos de AI Studio.
- Qué no deberías hacer: ajustar por adelantado los parámetros de tiempo de espera en producción basándote en los 300-500 tokens/s, ni retrasar el lanzamiento de una función para esperar a Hydrogen.
Nombre en clave Hyperion: su relación con Gemini 4 Argon
El origen de Hyperion es distinto al de Hydrogen. Apareció en una compilación de Devin, de Cognition, como nombre de una familia de modelos, situada en la lista antes de Gemini 4 Argon. Esa posición llevó a la comunidad a especular sobre una posible relación con la serie Gemini 4.
Pero hay dos hechos importantes que conviene aclarar. Primero, el fabricante no ha confirmado qué es Hyperion: podría ser un modelo de Google o simplemente un nombre en clave que Cognition usa internamente para una versión preliminar. Segundo, incluso si Hyperion fuera un modelo de Google, no hay pruebas de que pertenezca a la categoría Flash.
Por qué no se puede equiparar Hyperion con Gemini 4 Flash
Los nombres de modelos en productos de terceros suelen diferir de los nombres oficiales del fabricante. Es habitual que los desarrolladores de herramientas asignen nombres en clave a modelos preliminares para realizar pruebas internas, desplegarlos de forma gradual o mantener la confidencialidad. El orden de una lista también puede responder a criterios alfabéticos, fechas de lanzamiento o prioridades internas, por lo que no permite deducir directamente las especificaciones de un modelo.
Por tanto, lo que sabemos sobre Hyperion tiene un alcance muy limitado: indica que una familia de modelos aún no anunciada públicamente apareció en una compilación de un tercero, y nada más. Combinarlo con Hydrogen para concluir que «Gemini 4 Flash ya se usa en Devin» es un ejemplo claro de cómo se pueden malinterpretar varias pistas al juntarlas.
Gemini 4 Argon y Gemini 3.8 Flash: los dos modelos que ya puedes usar
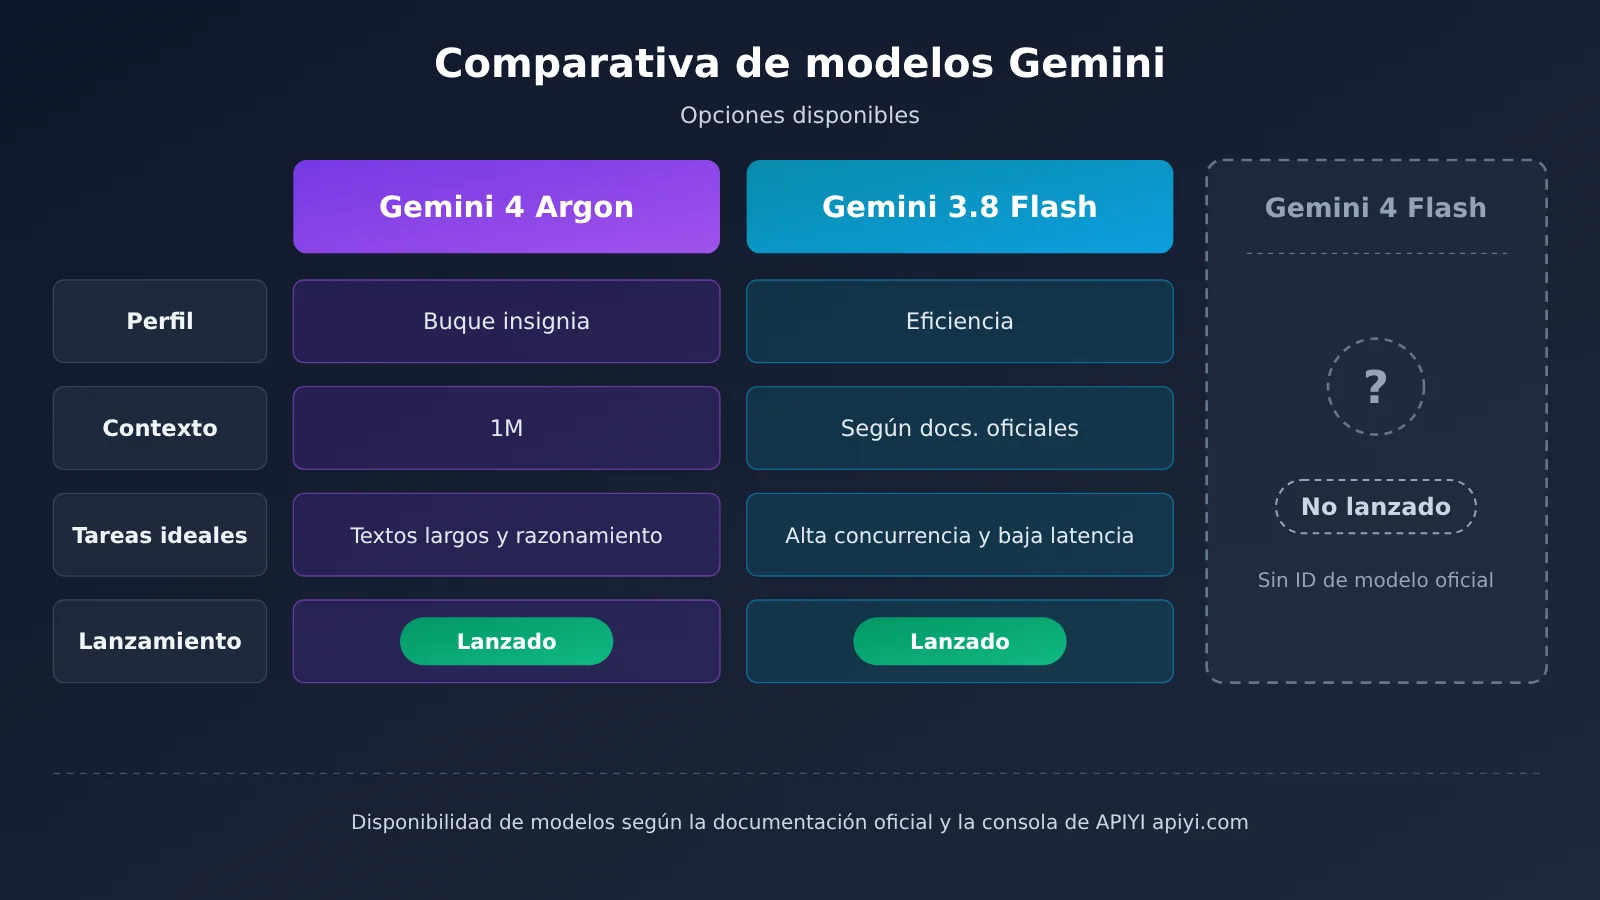
Hasta que llegue Gemini 4 Flash, estos son los dos principales modelos Gemini disponibles para desarrolladores. Cada uno tiene un propósito claro: priorizar la capacidad o priorizar la eficiencia.
Gemini 4 Argon: el modelo insignia ya disponible de la familia Gemini 4
gemini-4-argon es el primer modelo insignia de la familia Gemini 4 y, por ahora, el único modelo Gemini 4 que figura en la referencia de modelos de la API de Gemini. Admite una ventana de contexto de 1M y ya está disponible en la API oficial. Es adecuado para analizar documentos extensos, comprender grandes bases de código, razonar a partir de varios archivos y realizar tareas en las que la calidad de la respuesta importa más que la velocidad.
Argon y Gemini 4 Flash pertenecen a la misma generación, pero a distintas categorías. La existencia de Argon no significa que Flash vaya a llegar de inmediato: no hay información oficial sobre el calendario de lanzamiento de ambos.
Gemini 3.8 Flash: la opción Flash más reciente
Gemini 3.8 Flash se lanzó el 2 de septiembre de 2026 y es el modelo Flash más reciente de Google. Está pensado para tareas con alta concurrencia, baja latencia y sensibilidad al costo, como la clasificación por lotes, la extracción de información, las primeras respuestas de atención al cliente, el autocompletado en tiempo real y las invocaciones ligeras de herramientas en agentes.
Hasta que se lance Gemini 4 Flash, 3.8 Flash es la opción más viable de esta categoría. En lugar de esperar a la próxima generación, conviene medir desde ahora su rendimiento y costo. Esos datos servirán como referencia para evaluar Gemini 4 Flash más adelante.
| Modelo | ID oficial del modelo / estado | Características principales | Casos de uso | Plataformas disponibles |
|---|---|---|---|---|
| Gemini 4 Argon | gemini-4-argon, lanzado |
Primer modelo insignia de Gemini 4, ventana de contexto de 1M | Contexto extenso, razonamiento complejo, respuestas de alta calidad | API oficial de Google, APIYI apiyi.com |
| Gemini 3.8 Flash | Lanzado (2026-09-02) | Flash más reciente, baja latencia | Alta concurrencia, respuesta en tiempo real, tareas sensibles al costo | API oficial de Google, APIYI |
| Gemini 4 Flash | Sin ID oficial del modelo | No lanzado | Todavía no se puede planificar su uso | Consultar la documentación oficial y la lista de la consola |
Cómo elegir antes del lanzamiento de Gemini 4 Flash: una estrategia que combina Argon y 3.8 Flash
La mayoría de los sistemas en producción no necesitan apostar por un solo modelo. Una opción más segura es organizar las tareas por niveles: dejar que Argon y 3.8 Flash se encarguen cada uno de lo que mejor hacen y, cuando sea necesario, usar modelos de otros proveedores como alternativa o punto de comparación.
- Tareas complejas para Argon: asigna a
gemini-4-argonlas tareas donde la calidad es clave, como la búsqueda en contextos largos, los resúmenes entre documentos y la revisión de código. - Tareas frecuentes para 3.8 Flash: usa Gemini 3.8 Flash para tareas con un alto volumen de invocaciones y un valor bajo por operación, como clasificación, extracción, reformulación y reconocimiento de intención.
- Enrutamiento en cascada: procesa primero con 3.8 Flash y pasa a Argon cuando la confianza sea insuficiente o la entrada sea demasiado larga. Así equilibras costo y calidad.
- Comparación entre proveedores: mantén un modelo de Claude u OpenAI como alternativa para los procesos críticos, de modo que las fluctuaciones de un solo proveedor no afecten al negocio.
Esta arquitectura por niveles tiene otra ventaja: cuando Gemini 4 Flash se lance, solo tendrás que sustituir el modelo de la «capa de tareas frecuentes» para hacer un despliegue gradual, con un alcance controlado. Si ahora programas todas las invocaciones para usar un único modelo, el costo de cambiar después será mayor.
🎯 Recomendación: lo más engorroso de combinar varios modelos es gestionar distintas claves y sistemas de facturación. Con APIYI apiyi.com puedes invocar Gemini 4 Argon, Gemini 3.8 Flash y modelos de Claude, OpenAI y otros proveedores con una sola clave API. La interfaz es compatible con el formato de OpenAI, así que para cambiar de modelo solo necesitas modificar el parámetro
model. Esto facilita el enrutamiento por niveles descrito arriba.
Cómo prepararse antes del lanzamiento de Gemini 4 Flash: cuatro tareas de ingeniería
No hace falta cambiar el calendario por rumores, pero eso no significa quedarse de brazos cruzados. Lo profesional es preparar de antemano la integración de nuevos modelos para que, cuando se lance Gemini 4 Flash, puedas evaluarlo en unas horas en lugar de tardar semanas.
| Tarea | Acción concreta | Ventaja cuando se lance el nuevo modelo |
|---|---|---|
| Conjunto de evaluación | Seleccionar muestras representativas de casos reales y fijar las entradas y los criterios de evaluación | Permite evaluar el nuevo modelo de inmediato, sin depender de impresiones |
| Mapeo de modelos | Usar solo nombres lógicos en el código de la aplicación, como fast-tier, y asociarlos mediante la configuración al ID de cada modelo |
Para sustituir un modelo, basta con cambiar la configuración, sin tocar el código |
| Referencia de costos | Registrar el consumo actual de tokens, el costo por solicitud y la distribución de latencia de Argon y 3.8 Flash | Permite calcular si el nuevo modelo realmente ahorra dinero y es más rápido |
| Reversión y despliegue gradual | Cambiar el modelo según el porcentaje de tráfico y conservar una opción para volver al anterior con un clic | Permite reaccionar rápido si el nuevo modelo no cumple las expectativas |
Mapeo de modelos y conjunto de evaluación: cambiar de modelo con una configuración
El mapeo de modelos es la tarea que más fácilmente se pasa por alto de las cuatro, aunque también es una de las que más conviene preparar. La recomendación es mantener en el centro de configuración una tabla de correspondencias entre «nivel lógico → ID de modelo»: por ejemplo, quality-tier para gemini-4-argon y fast-tier para Gemini 3.8 Flash. Si usas APIYI en la capa de integración, todos los modelos comparten la misma base_url: https://api.apiyi.com/v1. Así, en la tabla solo tienes que mantener los nombres de los modelos, sin gestionar una dirección ni una clave por separado para cada uno.
Para el conjunto de evaluación, conviene incluir tres tipos de muestras: solicitudes típicas, casos difíciles poco frecuentes y casos que hayan causado problemas en el pasado. No hace falta que el conjunto sea muy grande; lo importante es mantenerlo fijo y poder ejecutarlo de forma repetible. Cuando Gemini 4 Flash tenga un ID de modelo oficial, podrás ejecutar el mismo conjunto y compararlo directamente con 3.8 Flash.
Referencia de costos y registros de uso: datos en lugar de suposiciones
Para establecer una referencia de costos necesitas datos reales de invocación, no multiplicar los precios publicados en la web oficial por una estimación de uso. Conviene registrar, al menos durante una semana y hasta un mes, el consumo de tokens y el número de solicitudes por modelo y por línea de negocio, además de las latencias P50 y P95. Así, cuando se anuncie que un nuevo modelo es «más rápido y más barato», podrás comprobarlo con los datos de tu propia aplicación.
📊 Consejo sobre datos: APIYI apiyi.com ofrece facturación y registros de uso unificados, con las invocaciones de distintos modelos en un solo lugar. Esto facilita la creación de una referencia de costos para Argon y 3.8 Flash. Consulta los precios y la disponibilidad en la consola y la documentación.
Preguntas frecuentes sobre Gemini 4 Flash
P1: ¿Ya se puede invocar Gemini 4 Flash?
No. Hasta el 8 de noviembre de 2026, Google no ha lanzado Gemini 4 Flash. La documentación de Gemini API no incluye el ID de modelo `gemini-4-flash` y tampoco hay una fecha oficial. El único modelo Gemini 4 disponible actualmente es `gemini-4-argon`.
P2: ¿Hydrogen y Hyperion son el mismo modelo?
No hay pruebas que lo respalden. Hydrogen aparece en una filtración de una cuenta de X sobre el nombre interno de Gemini 4 Flash; Hyperion proviene de una compilación de Devin, de Cognition. El proveedor no lo ha confirmado: podría ser un modelo de Google o un nombre que Cognition haya dado a una versión preliminar. Las fuentes son distintas, así que no se pueden interpretar como una sola ni considerar información oficial.
P3: ¿Conviene esperar a Gemini 4 Flash o usar Gemini 3.8 Flash desde ahora?
Conviene empezar con Gemini 3.8 Flash. Es el modelo Flash más reciente y resulta adecuado para tareas con alta concurrencia, baja latencia o sensibles al costo. Los datos de evaluación y costos que recopiles ahora servirán como referencia para evaluar Gemini 4 Flash en el futuro. Con APIYI apiyi.com puedes invocar tanto 3.8 Flash como Argon con la misma clave, lo que facilita probar una estrategia por niveles.
P4: ¿Cómo confirmar en cuanto se lance Gemini 4 Flash que está disponible?
Comprueba los criterios de este artículo: el ID oficial del modelo debe aparecer en la documentación de Gemini API, debe haber un precio en la página de tarifas y debe poder seleccionarse en AI Studio. Solo cuando se cumplan los tres se considerará lanzado. Para confirmar si está disponible a través de APIYI apiyi.com, consulta la lista de modelos de su consola. Cuando aparezca el modelo correspondiente, valídalo con el conjunto de evaluación que hayas preparado.
Puntos clave de Gemini 4 Flash y lista de verificación de rumores
Puntos clave:
- Estado de lanzamiento: Gemini 4 Flash no se había lanzado hasta el 8 de noviembre; no hay ID de modelo ni fecha oficiales.
- Hydrogen: nombre en clave interno filtrado por una cuenta de X. Ni los cinco checkpoints ni los 300-500 tokens/s están confirmados oficialmente.
- Hyperion: aparece en una compilación de Devin, antes que Argon. El proveedor no lo ha confirmado y no se puede deducir que sea Flash.
- Gemini 4 Argon: el primer modelo insignia de Gemini 4 ya está disponible, con una ventana de contexto de 1M y acceso por API.
- Gemini 3.8 Flash: lanzado el 2 de septiembre de 2026, es la opción de nivel Flash más realista por ahora.
- Recomendación: no detengas el calendario; prepara un conjunto de evaluación, el mapeo de modelos, una línea base de costos y un mecanismo de reversión.
Lista de verificación de rumores sobre Gemini 4 Flash
La próxima vez que veas una noticia que diga «Gemini 4 Flash ya está disponible», puedes comprobarla con esta lista:
| Punto de verificación | Cómo comprobarlo | Criterio de confirmación |
|---|---|---|
| ID oficial del modelo | Consulta la página de referencia de modelos de Gemini API | Aparece un ID explícito para Gemini 4 Flash |
| Precios | Consulta la página de precios de Gemini API | Se indican los precios de entrada y salida |
| AI Studio | Abre el selector de modelos de AI Studio | Se puede seleccionar directamente, no solo mediante pruebas A/B anónimas |
| Anuncio oficial | Consulta el blog o las cuentas oficiales de Google | Hay un artículo de lanzamiento oficial |
| Fuente de la información | Rastrea el origen de la noticia | Proviene de una fuente oficial, no de una cuenta de X o una compilación de terceros |
| Correspondencia del nombre en clave | Busca una explicación oficial que vincule el nombre en clave con el nombre definitivo | Hay confirmación oficial, no solo especulaciones de la comunidad |
| Disponibilidad de acceso | Revisa la lista de modelos en la consola de la plataforma que utilizas | El modelo aparece en la lista y se puede invocar |
Solo se puede considerar lanzado si se cumplen los tres primeros puntos a la vez. Los cuatro restantes sirven para evaluar la credibilidad de la noticia. Si no se cumple el primero, por muy detallada que sea la filtración, conviene clasificarla como «seguimiento» y no como base para una «decisión».
Resumen
El estado de Gemini 4 Flash se puede resumir en tres frases:
- Aún no se ha lanzado: no hay ID de modelo, precios ni fecha oficiales; Hydrogen y Hyperion son solo pistas.
- Ya hay alternativas disponibles:
gemini-4-argoncubre las necesidades de un modelo insignia y de contexto largo, mientras que Gemini 3.8 Flash se ocupa de la alta concurrencia y la baja latencia. - Prepararse es más importante que esperar: si preparas de antemano el conjunto de evaluación, el mapeo de modelos, la línea base de costos y los mecanismos de despliegue gradual y reversión, podrás cambiar rápidamente cuando se lance el nuevo modelo.
Para los desarrolladores y los equipos de producto, lo mejor es seguir adelante con el calendario actual y convertir la integración de nuevos modelos en un proceso técnico reproducible. Una opción recomendada es usar una sola clave en APIYI apiyi.com para probar primero una solución que combine Argon y 3.8 Flash, y establecer una línea base de costos a partir de los registros de uso. Cuando Gemini 4 Flash esté disponible oficialmente, se podrá comparar mediante un despliegue gradual.
Referencias
- Referencia de modelos de Gemini API: ID oficiales de modelos y especificaciones de contexto
- Enlace:
ai.google.dev/gemini-api/docs/models -
Descripción: primera fuente para comprobar si Gemini 4 Flash se ha lanzado
-
Página de precios de Gemini API: precios oficiales de los modelos
- Enlace:
ai.google.dev/gemini-api/docs/pricing -
Descripción: aquí se publican los precios de los nuevos modelos tras su lanzamiento oficial
-
Google AI Studio: acceso oficial para probar modelos
- Enlace:
aistudio.google.com - Descripción: permite comprobar si el modelo se puede seleccionar directamente
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio oficial de APIYI. Encontrarás más información sobre la integración de modelos en el centro de documentación de docs.apiyi.com