Nota del autor: este artículo organiza por separado la puntuación global de terceros, los precios de lista oficiales, los precios de lectura de caché y la disponibilidad en el catálogo de APIYI para GPT-6.2 Sol y Claude Opus 5.5, para ayudarte a elegir el modelo según la tarea y no según una única puntuación global.
El 17 de noviembre de 2026, OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol. Muchos equipos ya venían trabajando con Claude Opus 5.5 y ahora deben decidir si conviene hacer el cambio. Este artículo compara GPT-6.2 Sol y Claude Opus 5.5 y ofrece recomendaciones desde varios frentes: puntuación global, precios de lista, lectura de caché, protocolo y disponibilidad actual para invocación.
Este no es un artículo que venga a proclamar quién es más potente ni quién es más barato. En el índice compuesto de terceros, el nivel más alto de Sol queda 2 puntos por debajo del de Opus. Según los precios de lista oficiales con contexto corto, el precio unitario de entrada, salida y lectura de caché de Sol ronda la mitad del de Opus. Estos dos datos hay que leerlos juntos: tomar una decisión con cualquiera de ellos por separado daría una imagen incompleta.
Valor clave: al terminar de leer este artículo, sabrás cuáles son la puntuación global, los precios de lista y los costos de lectura de caché de estos dos modelos, qué cifras declara el propio fabricante y cuáles midió un tercero, y cuál de los dos puedes invocar ahora mismo en APIYI.
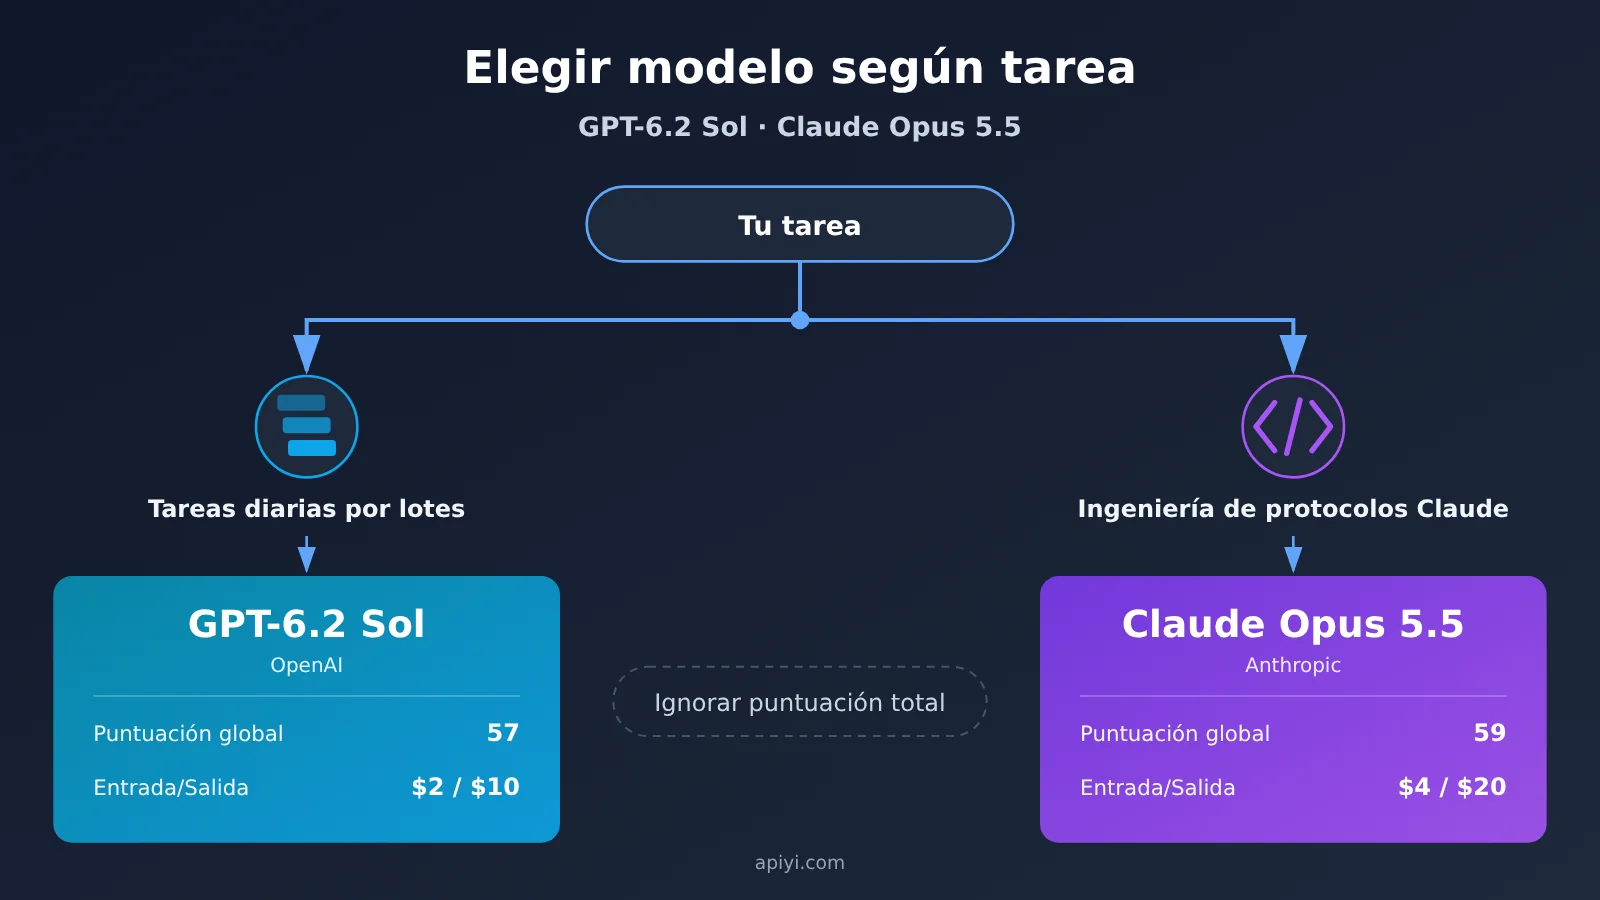
Diferencias clave entre GPT-6.2 Sol y Claude Opus 5.5 de un vistazo
Empecemos reuniendo en una sola tabla los cinco conjuntos de datos que más se usan al elegir modelo. Cada fila indica la fuente de las cifras, y las siguientes secciones las analizan en detalle.
| Criterio de comparación | GPT-6.2 Sol | Claude Opus 5.5 | Fuente de las cifras |
|---|---|---|---|
| Índice compuesto de terceros (nivel de razonamiento más alto) | 57 (nivel Max) | 59 (nivel más alto) | Artificial Analysis, tercero |
| Precio oficial de entrada / salida con contexto corto | $2 / $10 | $4 / $20 | Precio oficial de cada uno, por cada 1 millón de tokens |
| Precio de lectura de caché | $0.10 | $0.20 | Página de modelos de OpenAI; para Opus, dato transcrito de la tarifa de Anthropic |
| Contexto / salida máxima | 1,050,000 / 128,000 | 1M / 128K | Página oficial de modelos y documentación |
| Estado actual en APIYI | Aún no disponible | Ya disponible, claude-opus-5-5 |
Tabla general de modelos y API de precios de APIYI |
¿Por qué mirar juntos los 2 puntos menos en el índice y el precio casi a la mitad?
Si te fijas solo en el índice compuesto, concluirás que «Opus puntúa más alto»; si te fijas solo en el precio oficial, concluirás que «Sol cuesta menos por token». Ambas conclusiones son correctas, pero cada una cuenta solo la mitad de la historia. El índice compuesto refleja el rendimiento promedio en un conjunto mixto de tareas; el precio oficial refleja lo que cuesta cada 1 millón de tokens; y tu factura real también depende de cuántos tokens consuma cada tarea.
Además, la brecha de 2 puntos proviene de las pruebas que Artificial Analysis realiza en el nivel de razonamiento más alto. Si tu negocio usa la intensidad de razonamiento predeterminada, o si el tipo de tareas difiere bastante de las que mide este índice, esos 2 puntos no se trasladan necesariamente a tu caso. Por eso, el enfoque de este artículo es: primero dejar claros los números y después elegir según el tipo de tarea.
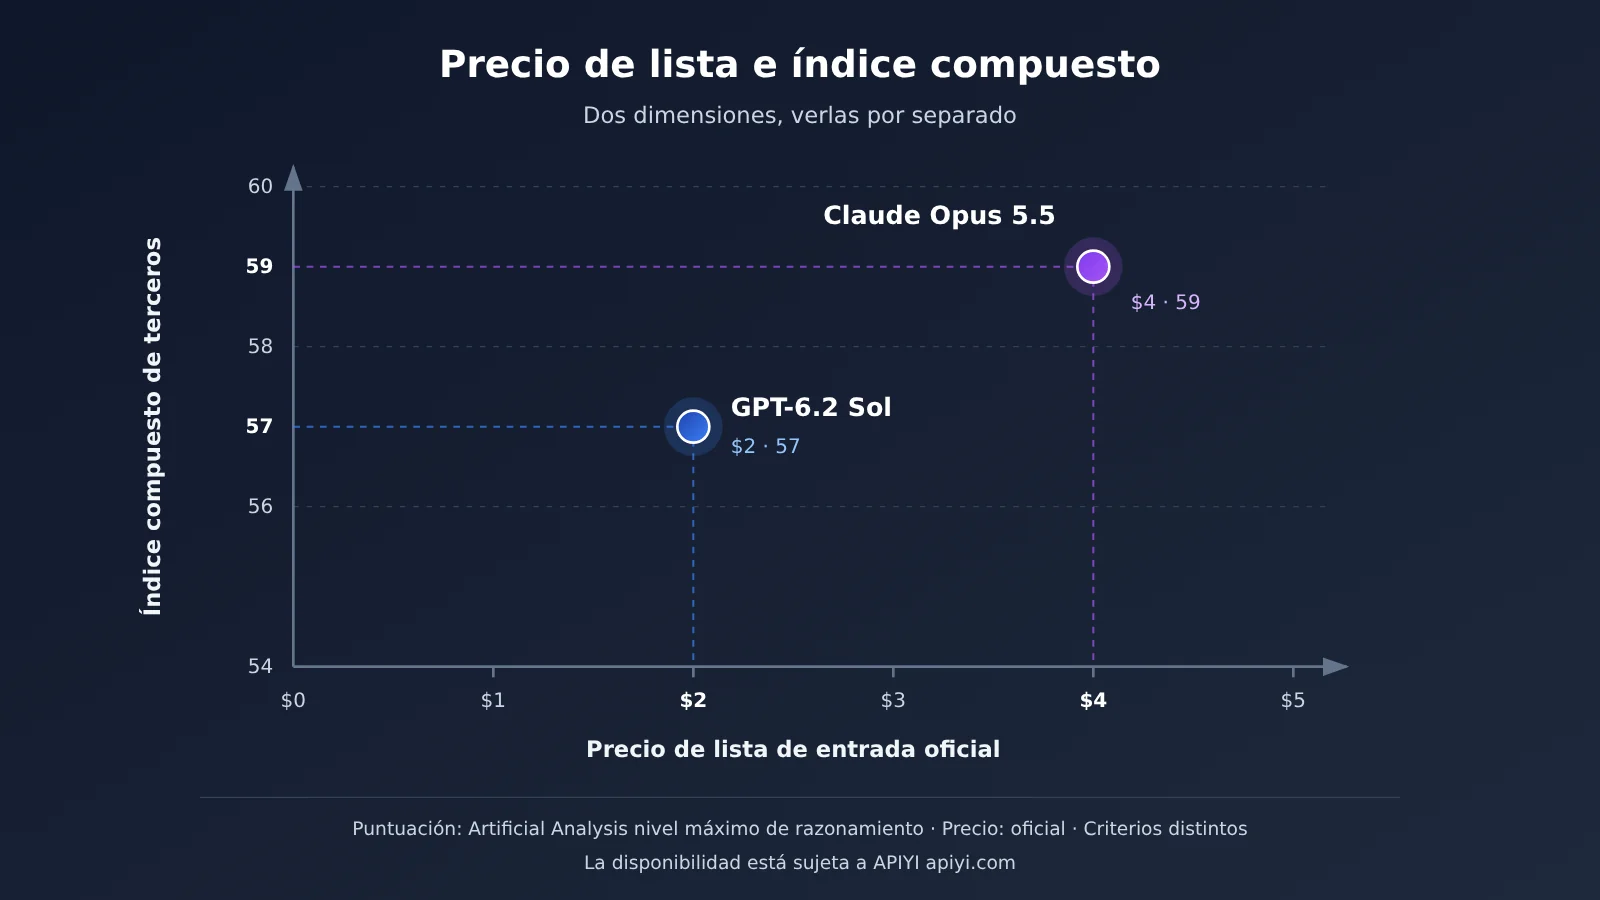
Comparación de precios oficiales y de lectura de caché entre GPT-6.2 Sol y Claude Opus 5.5
El precio es la parte que más se malinterpreta al momento de elegir un modelo. La siguiente tabla separa los precios oficiales de los de la plataforma APIYI; todos los números son por cada 1 millón de tokens y corresponden por defecto al nivel estándar de contexto corto.
| Concepto | Precio oficial de GPT-6.2 Sol | Precio oficial de Claude Opus 5.5 | Claude Opus 5.5 en APIYI | GPT-6.2 Sol en APIYI |
|---|---|---|---|---|
| Entrada | $2 | $4 | $4 | Aún no disponible |
| Salida | $10 | $20 | $20 | Aún no disponible |
| Lectura de caché | $0.10 | $0.20 | $0.2 | Aún no disponible |
| Escritura en caché | 30 minutos: $2.50; 12 horas: $5 | 5 minutos: $5; 1 hora: $8 (según tarifa citada) | Según la lista de la plataforma | Aún no disponible |
| Regla para entradas muy largas | Recargo en todo el pedido si supera los 272K | No cubierto en las fuentes consultadas | Según la lista de la plataforma | Aún no disponible |
El precio oficial de GPT-6.2 Sol con contexto corto es de $2 por entrada, $10 por salida y $0.10 por lectura de caché; la nota de lanzamiento indica que mantiene los precios de token de API de GPT-6.1 Sol. En APIYI, GPT-6.2 Sol todavía no está disponible, pero lo publicaremos lo antes posible; el modelo y sus precios deben confirmarse en la lista de modelos de la plataforma.
El precio oficial de Claude Opus 5.5 es de $4 por entrada y $20 por salida. El precio de lectura de caché de $0.20 y los de escritura en caché (5 minutos: $5; 1 hora: $8) provienen de una transcripción de la tarifa de Anthropic; para la escritura, consulta siempre la página oficial de Anthropic. En la tabla general de modelos de APIYI (datos del 2026-11-17 15:54, UTC+8), tanto claude-opus-5-5 como claude-opus-5-5-thinking ya están disponibles, con precios de plataforma de $4 / $20 / $0.2. Puedes verificar estos valores directamente en la lista de modelos de APIYI en apiyi.com.
Una advertencia importante: los modelos gpt-6.1-sol ($2 / $10 / $0.1) y gpt-6-sol ($2 / $10 / $0.2) que aparecen actualmente en la tabla general de APIYI no son la versión 6.2. Sus precios no pueden tomarse como el precio de plataforma de GPT-6.2 Sol, ni representan las capacidades de la versión 6.2.
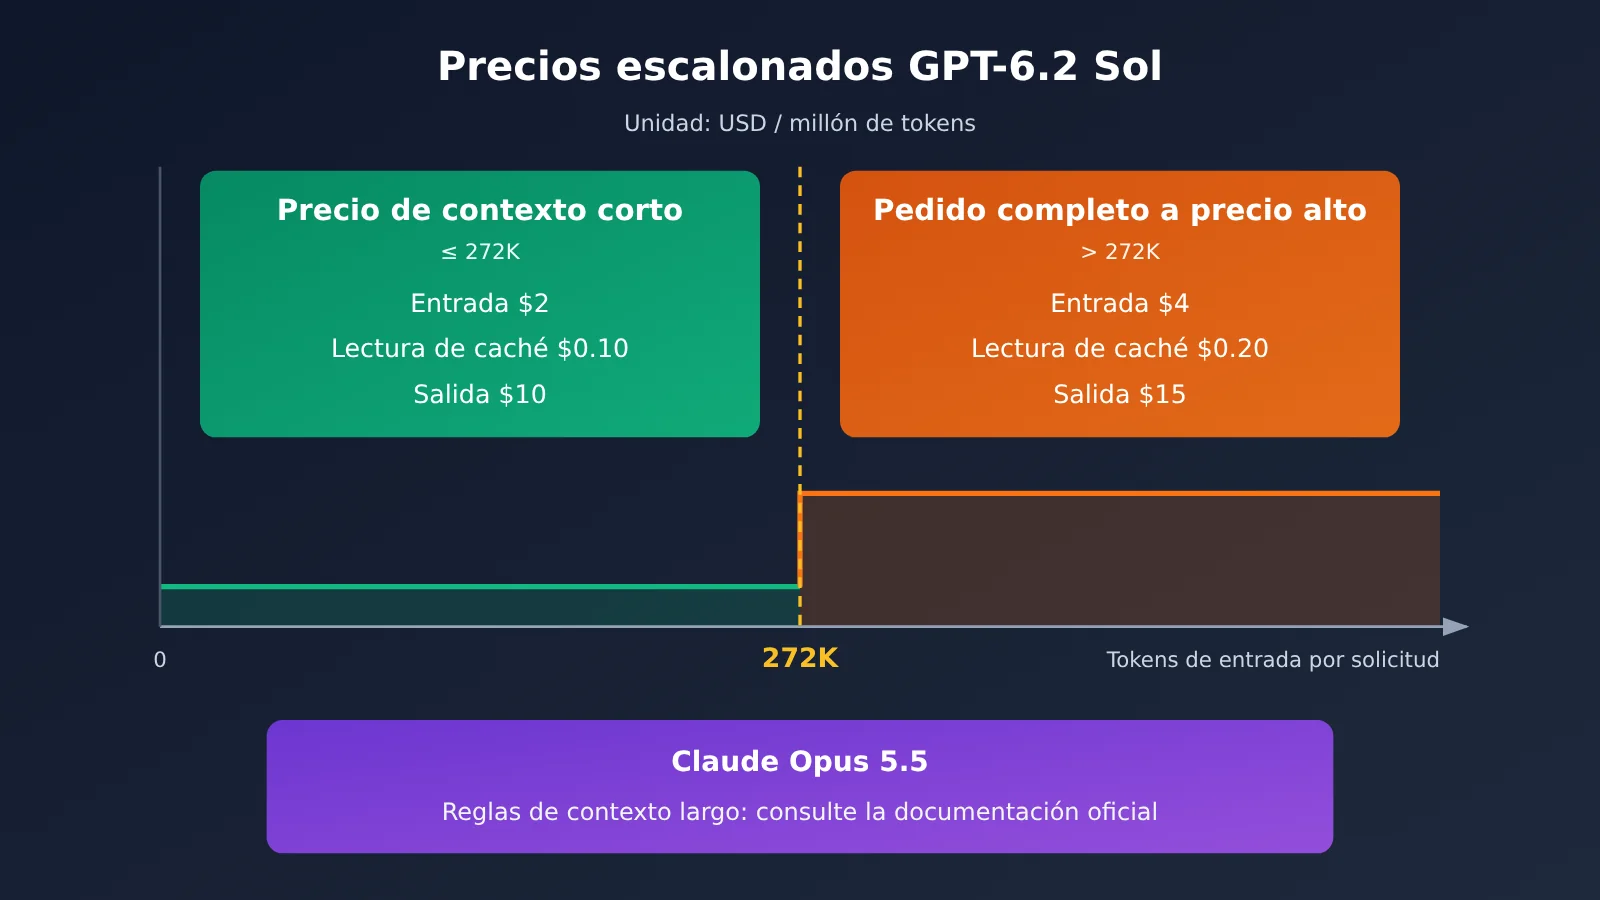
Reglas de facturación por solicitud completa de 272K en GPT-6.2 Sol
La página de modelos de OpenAI lo especifica claramente: cuando la entrada de una sola solicitud supera los 272K tokens, el precio unitario de la entrada y de la caché se duplica, la salida se calcula a 1.5 veces el precio de contexto corto y, además, toda la solicitud se factura con los precios nuevos, no solo la parte que excede el límite. Traducido a Sol, esto queda en entrada a $4, lectura de caché a $0.20 y salida a $15.
Esta regla tiene un gran impacto en las tareas con documentos largos. Si tus solicitudes típicas rondan los 272K, la ventaja de costar «aproximadamente la mitad» se reduce bastante. En cuanto a si Opus 5.5 tiene una regla similar para contexto largo, el material de referencia de este artículo no lo cubre; te recomiendo revisar directamente la documentación de Anthropic antes de comparar.
Aparte de esto, el Batch de Sol cuesta el 50% del precio estándar, y Fast equivale a 2 veces el precio estándar para la misma longitud de contexto. Ultrafast cuesta 3 veces el precio estándar hasta el 28 de febrero de 2027 (hora del Pacífico) y 6 veces a partir del 1 de marzo de 2027.
Ejemplo de una sola solicitud según los precios de lista
Para que quede más intuitivo, a continuación hago un cálculo puramente matemático con los precios oficiales de lista; no representa ninguna factura real. Supongamos una solicitud con 100 mil tokens de entrada, 10 mil tokens de salida y sin usar caché: Sol saldría unos $0.20 + $0.10 = $0.30, y Opus unos $0.40 + $0.20 = $0.60.
Este ejemplo se apoya en dos supuestos: que ambos modelos consumen la misma cantidad de tokens en la misma tarea, y que la solicitud no supera los 272K. En el uso real, el consumo de tokens de razonamiento varía según el modelo, el esfuerzo de razonamiento y la tarea, así que para conocer el costo real hay que correr una ronda con tus propias tareas y calcular a partir de ahí.
Cifras de capacidad de GPT-6.2 Sol y Claude Opus 5.5: dos fuentes, dos lecturas separadas
Las cifras de capacidad de estos dos modelos provienen de dos fuentes: por un lado, la evaluación independiente de Artificial Analysis; por otro, los datos autodeclarados de forma oficial por OpenAI en su anuncio de lanzamiento y en la página del modelo. Cada conjunto usa tareas, niveles de razonamiento y criterios de costo distintos, así que a continuación se listan por separado, sin fundirlos en una sola conclusión.
Índice compuesto de Artificial Analysis (Intelligence Index v5.0.1)
| Modelo y nivel de razonamiento | Índice compuesto | Costo por tarea del índice compuesto | Notas |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 57 | $1.01 | 2 puntos más que GPT-6.1 Sol |
| GPT-6.2 Sol (Xhigh) | 56 | No se desglosa | Fuente independiente |
| GPT-6.2 Sol (High) | 55 | No se desglosa | Fuente independiente |
| GPT-6.2 Sol (Medium) | 53 | No se desglosa | Fuente independiente |
| GPT-6.2 Sol (Low) | 41 | No se desglosa | Fuente independiente |
| Claude Opus 5.5 (nivel máximo) | 59 | No cubierto por las fuentes de este artículo | Del mismo artículo |
Los $1.01 de Sol son simplemente el costo promedio por tarea completada dentro de este índice compuesto; no representa el precio unitario de todas las tareas y tampoco sirve para calcular proporciones con las cifras de costo de otras fuentes. El costo por tarea de Opus 5.5 en este índice no aparece en las fuentes consultadas, así que este artículo no hace estimaciones.
El mismo artículo independiente incluye varios desgloses que vale la pena destacar. En el Coding Agent Index (Codex harness, Max), Sol quedó 3 puntos por debajo de GPT-6.1 Sol, sobre todo porque en SWE-Atlas-QnA-AA bajó 14 puntos y tiende a omitir hechos clave. En la tasa de alucinaciones de AA-Omniscience (Max), Sol se ubica en 55 %. Y en la vista previa de investigación de AA-Robotics v0.1, Sol obtiene 78. Estos desgloses no incluyen cifras de comparación para Opus 5.5, así que solo sirven para entender las fortalezas y debilidades del propio Sol.
Datos autodeclarados por OpenAI sobre GPT-6.2 Sol
Todas las cifras siguientes provienen del anuncio de OpenAI; son datos autodeclarados de forma oficial, y los comparativos se hacen casi siempre contra modelos de la propia OpenAI, no contra Claude Opus 5.5:
- FrontierCode 2.0 (desarrollado por Cognition; evalúa si los cambios propuestos en repositorios de código reales logran que los mantenedores los fusionen): Sol queda a menos de 0.5 puntos de GPT-6.2 Astra, con cerca de un quinto del costo; ambos usan el nivel Max.
- LifeVal (conjunto de tareas cotidianas creado por la propia OpenAI): Sol obtiene un puntaje más alto que GPT-6 Astra, con aproximadamente un séptimo del costo.
- GDPval v2 (evaluación interna oficial): Sol supera a GPT-6.1 Sol por 5.3 puntos.
- Elo de evaluación humana a ciegas de AA-3D (transmitido de forma oficial): Sol alcanza 1259.
Por qué no se pueden combinar las dos series de cifras
El índice compuesto independiente se obtiene ejecutando un conjunto fijo de tareas en el nivel máximo de razonamiento, mientras que la autodeclaración oficial suele expresarse en términos relativos: «cuánto mejora respecto a la generación anterior» o «qué fracción del costo representa». Los benchmarks, los niveles de razonamiento y los métodos de cálculo de costos no coinciden entre sí. Si mezclas un «2 puntos menos en el puntaje compuesto» con un «cerca de Astra en cierta prueba oficial», no llegas a ninguna conclusión del tipo «Sol es más fuerte en conjunto» o «Opus es más fuerte en conjunto».
Una lectura más práctica sería esta: el puntaje compuesto independiente te da una idea aproximada de dónde se ubican los dos modelos en tareas mixtas de propósito general; la autodeclaración oficial te muestra en qué escenarios OpenAI puso especial empeño en optimizar a Sol, como las tareas cotidianas y las relacionadas con la fusión de código. Al final, lo que debe pesar siempre es el rendimiento en tus propias tareas.
Diferencias de especificaciones y protocolos entre GPT-6.2 Sol y Claude Opus 5.5
Además de las puntuaciones y los precios, la forma de integración suele ser el factor que decide si puedes hacer el cambio de inmediato. La siguiente tabla resume las diferencias de especificaciones y endpoints entre ambos modelos.
| Especificación | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| Modalidades de entrada | Texto e imágenes (sin soporte de audio ni video) | No se detalla por separado en las fuentes de referencia |
| Ventana de contexto | 1,050,000 (entrada máxima: 922,000) | 1M |
| Salida máxima | 128,000 | 128K |
| Corte de conocimiento | 2026-06-01 | 2026-06 |
| Intensidad de razonamiento | Admite tokens de razonamiento; la API no acepta effort configurado en none | El effort predeterminado es medium |
| Endpoints oficiales | Chat Completions, Responses, Batch | Anthropic Messages |
| Endpoints de APIYI | Aún no disponible | chat, messages |
Si tu cadena de herramientas depende del protocolo Messages de Claude —por ejemplo, Claude Code o un agente basado en el SDK de Anthropic—, Opus 5.5 en APIYI ofrece a la vez los endpoints chat y messages, con grupos que incluyen ClaudeCode, Claude_Reverse, Claude_Enterprise, Default y SVIP. El costo de migrar prácticamente se reduce a cambiar el base URL y la clave API.
GPT-6.2 Sol funciona con Chat Completions y Responses de OpenAI. La página oficial del modelo deja claro que no admite Realtime, Assistants, fine-tuning, generación de imágenes, video ni voz, así que para ese tipo de necesidades no puedes contar con él.
Recomendaciones de escenarios: GPT-6.2 Sol frente a Claude Opus 5.5
Elegir según la tarea es más fiable que elegir según la puntuación total. A continuación explicamos dos tipos de escenarios y cerramos con una tabla.
Escenarios donde elegir Claude Opus 5.5
- Necesitas el protocolo de Claude: si tu código existente se basa en Anthropic Messages, o depende de herramientas como Claude Code, el costo de adaptación para cambiar de protocolo supera la diferencia de precio unitario.
- Necesitas lanzar ya: Opus 5.5 ya está disponible en APIYI, puedes integrarlo de inmediato sin esperar a que se publique el nuevo modelo.
- La puntuación integral es un criterio duro: tu tarea se parece bastante a las evaluaciones mixtas generales, y esos 2 puntos de ventaja en el nivel máximo de razonamiento sí tienen un impacto real en los resultados.
Escenarios donde conviene mirar primero GPT-6.2 Sol
- Tareas por lotes diarias sensibles al precio unitario: el precio oficial de contexto corto ronda la mitad del de Opus, y la lectura de caché también cuesta la mitad, ideal para escenarios de alta frecuencia con mucho reuso de indicaciones.
- La mayoría de las peticiones quedan dentro de 272K: así puedes beneficiarte de forma estable del precio de contexto corto y evitar el recargo que se aplica a toda la solicitud.
- Ya estás en el ecosistema del protocolo de OpenAI: con Responses o Chat Completions, los cambios necesarios para migrar son mínimos.
Cabe aclarar que «mirar primero Sol» no significa que Sol tenga una puntuación integral más alta; las cifras de terceros indican justo lo contrario. Lo que quiere decir es que, en escenarios sensibles al precio unitario y con tareas del día a día, vale la pena probar primero Sol con una ronda de tus propias tareas.
| Tipo de tarea | Prioridad | Razón principal | Plataformas disponibles |
|---|---|---|---|
| Tareas de ingeniería con protocolo Claude Code / Messages | Claude Opus 5.5 | Protocolo nativo, sin necesidad de adaptación | APIYI apiyi.com, ya disponible |
| Tareas de producción que deben lanzarse de inmediato | Claude Opus 5.5 | Invocable actualmente | APIYI, ya disponible |
| Tareas diarias de alta frecuencia, reuso de caché de indicaciones | GPT-6.2 Sol | Precios oficiales de entrada, salida y lectura de caché a casi la mitad | API de OpenAI; aún no disponible en APIYI |
| Tareas con documentos largos de más de 272K | Calcular ambos con los tokens reales | Sol tiene reglas de recargo sobre toda la solicitud | Según la lista de modelos de cada plataforma |
| Preguntas y respuestas muy sensibles a omitir hechos clave | Hacer primero una evaluación específica | Sol muestra una caída en SWE-Atlas-QnA-AA (según terceros) | Según la lista de modelos de cada plataforma |
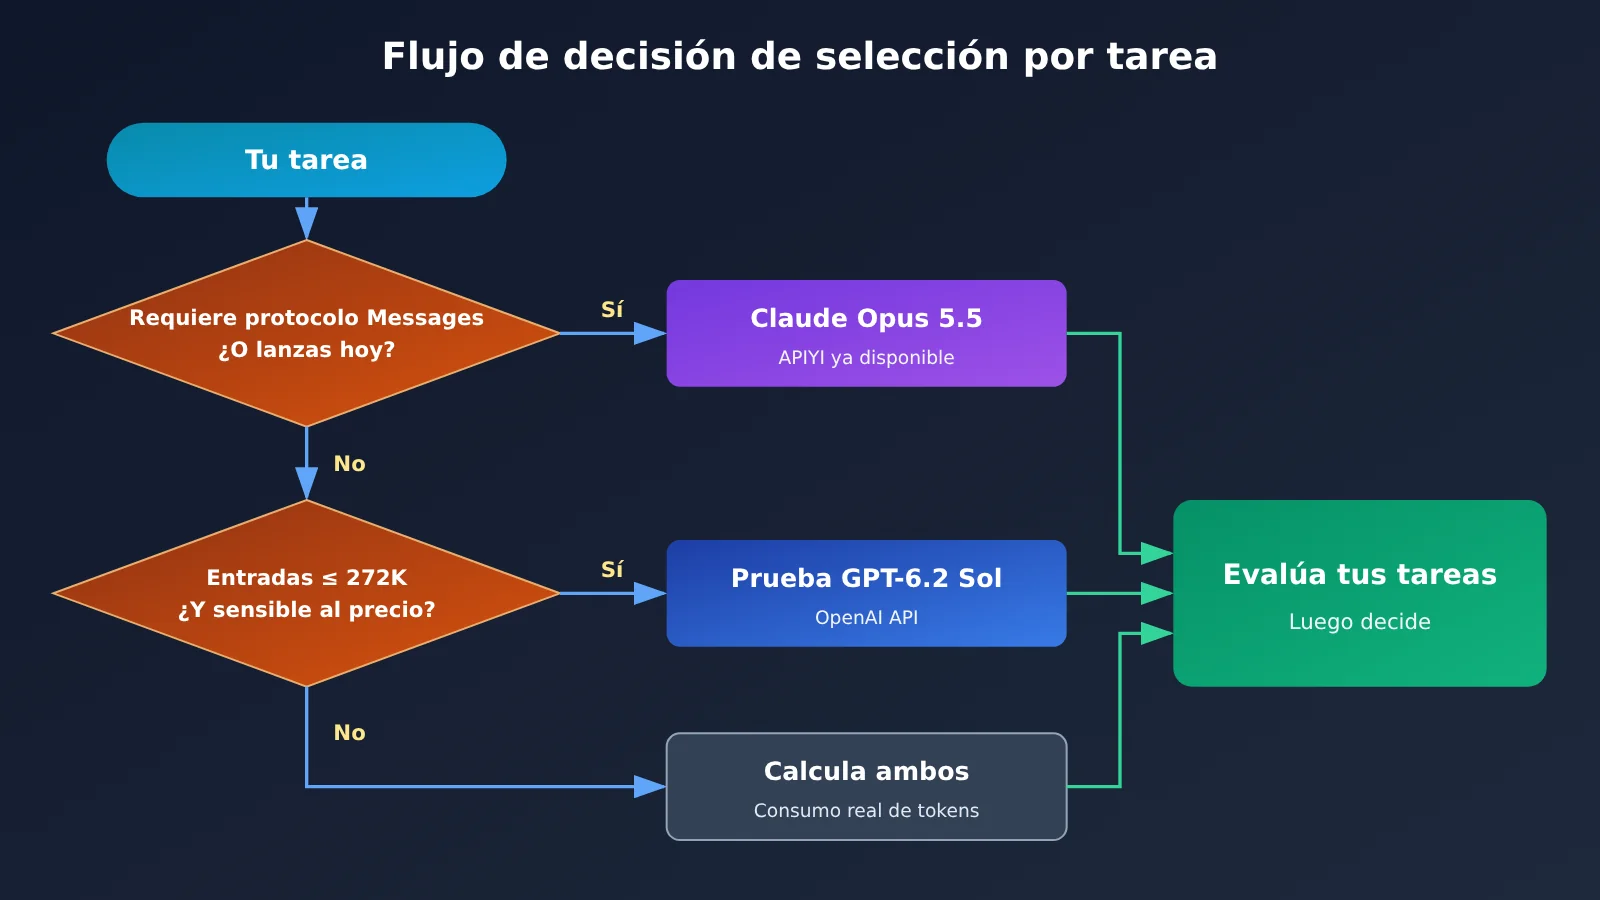
Guía rápida de GPT-6.2 Sol y Claude Opus 5.5
Actualmente, el modelo que puedes invocar directamente en APIYI es Claude Opus 5.5. Los pasos de integración son los siguientes: todo consiste en ajustes de configuración, sin necesidad de dependencias adicionales:
- Regístrate en APIYI y crea una clave API; los usuarios nuevos cuentan con cuota gratuita de prueba.
- Configura la URL base de tu cliente como
https://api.apiyi.com/v1; es la dirección de la interfaz compatible con OpenAI. - En el nombre del modelo, escribe
claude-opus-5-5; si necesitas un proceso de razonamiento explícito, puedes usar en su lugarclaude-opus-5-5-thinking. - Si usas un cliente al estilo Anthropic, ve directamente al endpoint de messages; con el SDK de OpenAI, usa el endpoint de chat.
- Realiza una ronda de evaluación con entre 5 y 10 solicitudes reales de tu negocio, registra la cantidad de tokens de entrada, de salida y de acierto de caché, y calcula el costo por tarea según los precios de la plataforma: $4 / $20 / $0.2.
El ID de modelo de GPT-6.2 Sol es gpt-6.2-sol; oficialmente puede invocarse mediante la API de OpenAI y ya está disponible en ChatGPT Work y Codex para los planes Plus, Pro, Enterprise y Edu. En APIYI aún no está publicado, y lo incorporaremos lo antes posible; los nombres de los modelos y los precios se rigen por la lista de modelos de la plataforma. Hasta que esté disponible, no uses gpt-6.1-sol como sustituto en tus evaluaciones: no son el mismo modelo.
🚀 Inicio rápido: te recomendamos ejecutar primero
claude-opus-5-5en APIYI (apiyi.com) con la cuota gratuita y anotar el consumo de tokens de tus tareas. Cuandogpt-6.2-solesté publicado, repite la misma ronda con el mismo lote de solicitudes y la misma URL base, cambiando únicamente el nombre del modelo; así podrás comparar el costo y los resultados de ambos en una misma tabla.
GPT-6.2 Sol y Claude Opus 5.5: recomendaciones de decisión
💡 Recomendación de elección: si necesitas el protocolo de Claude y quieres poder invocarlo hoy mismo, elige Claude Opus 5.5; si buscas un modelo de uso diario con un precio oficial más bajo, fíjate especialmente en GPT-6.2 Sol, pero no declares que su puntuación global es superior. Al final, haz la evaluación con tus propias tareas: mediante la interfaz unificada de APIYI (apiyi.com), ambos modelos pueden compartir el mismo código de invocación, y al cambiar solo tienes que modificar el nombre del modelo.
En cuanto a la ejecución práctica, hay tres puntos que merecen atención. Primero, al evaluar hay que igualar el esfuerzo de razonamiento de ambos modelos: las puntuaciones globales de terceros se obtienen con el nivel máximo, mientras que Opus viene por defecto en medium; cuando el nivel no coincide, tanto la puntuación como el consumo de tokens varían. Segundo, en las tareas con un prefijo de indicación estable, hay que incluir la caché en el cálculo: el precio de lectura de la caché es en ambos casos una veinteava parte del precio de entrada, y cuando la tasa de aciertos es alta, la diferencia en la factura se amplifica o se reduce. Tercero, en las tareas con documentos largos, calcula siempre por separado los casos que superen los 272K.
Preguntas frecuentes (FAQ)
Q1: ¿Qué posicionamiento tienen GPT-6.2 Sol y Claude Opus 5.5?
GPT-6.2 Sol es el modelo que OpenAI lanzó el 2026-11-17: acepta texto e imágenes como entrada y genera texto; cuenta con una ventana de contexto de 1,050,000 y, según su posicionamiento oficial, apunta a las tareas cotidianas y de trabajo real con un enfoque en la eficiencia. Claude Opus 5.5 es un modelo de Anthropic, con ventana de contexto de 1M, salida máxima de 128K y una intensidad de razonamiento predeterminada de medium.
Q2: ¿Cuál es más potente, GPT-6.2 Sol o Claude Opus 5.5?
Ninguna puntuación global responde a esta pregunta. En el índice compuesto de terceros de Artificial Analysis, el nivel Max de Sol obtiene 57, mientras que el nivel más alto de Opus alcanza 59. En los resultados autodeclarados oficialmente, Sol destaca en proyectos como FrontierCode 2.0 y LifeVal, pero sus puntos de comparación son principalmente modelos de la propia OpenAI. La recomendación es evaluar según tu tarea, no elegir por la puntuación total.
Q3: ¿Ya se puede invocar GPT-6.2 Sol en APIYI?
Todavía no. Ni la tabla general de modelos de APIYI (2026-11-17 15:54, UTC+8) ni la interfaz pública de precios incluyen `gpt-6.2-sol`. GPT-6.2 Sol aún no está listado; lo incorporaremos lo antes posible. El nombre del modelo y el precio deben confirmarse en la lista de modelos de la plataforma.
Q4: ¿Cuáles son el precio y los endpoints de Claude Opus 5.5 en APIYI?
Tanto `claude-opus-5-5` como `claude-opus-5-5-thinking` ya están disponibles. Los precios publicados en la plataforma son: entrada $4, salida $20 y lectura de caché $0.2 (por cada millón de tokens). Los endpoints admiten chat y messages. Con la misma clave API de APIYI (apiyi.com) ya puedes invocarlo, y la base URL es `https://api.apiyi.com/v1`.
Q5: ¿Sirve el costo por tarea de $1.01 de Sol para hacer tus cálculos directamente?
No. Los $1.01 corresponden al costo promedio que Artificial Analysis midió con las tareas del índice compuesto en el nivel de razonamiento Max, y solo aplican a esa evaluación. Si la duración de tus tareas y el consumo de razonamiento son distintos, el costo también lo será. El costo por tarea de Opus 5.5 en ese índice no aparece en los datos de este artículo, por lo que tampoco sirve para dividir un lado entre el otro.
Q6: ¿Qué relación tiene GPT-6.2 Astra con Sol y conviene considerarlo también?
Astra es otro modelo lanzado en el mismo lote, con precios oficiales para contexto corto de: entrada $8, lectura de caché $0.40 y salida $40; en el índice compuesto de terceros queda por encima de Sol. En APIYI, GPT-6.2 Astra aún no está listado; lo incorporaremos lo antes posible. El nombre del modelo y el precio deben confirmarse en la lista de modelos de la plataforma. Este artículo compara Sol con Opus 5.5, y la franja de precios de Astra no está en el mismo nivel que la de ellos.
Q7: ¿Hay otros modelos de precio comparable para usar como referencia?
Puedes consultar Gemini 4 Carbon. APIYI ya tiene disponible `gemini-4-carbon`; la página de la plataforma indica un precio introductorio: entrada $2, lectura de caché $0.1 y salida $10. Ten en cuenta que el precio oficial de Google cambia a partir del 2026-12-01 a entrada $4, salida $20 y lectura de caché $0.20; la página de la plataforma todavía no refleja ese ajuste, así que después del 1 de diciembre guíate por la lista de modelos de APIYI en apiyi.com.
Q8: ¿Qué limitaciones conocidas tiene GPT-6.2 Sol?
La página oficial del modelo especifica que no admite entradas de audio ni de video, ni tampoco Realtime, Assistants, ajuste fino, generación de imágenes ni voz; además, la API no acepta establecer la intensidad de razonamiento en none. Datos de terceros muestran que, en SWE-Atlas-QnA-AA, obtiene 14 puntos menos que GPT-6.1 Sol y es más propenso a omitir hechos clave. La evaluación oficial de alineación también menciona que la serie 6.2 tiende más a omitir el reporte de problemas que bloquean el avance —como archivos faltantes o herramientas de búsqueda no disponibles— en dos de las pruebas.
Puntos clave de GPT-6.2 Sol y Claude Opus 5.5
- Puntuación global: con el nivel de razonamiento más alto de terceros, Sol (Max) obtiene 57 y Opus 5.5, 59; entre ambos hay 2 puntos de diferencia.
- Precio oficial: Sol cuesta $2 de entrada, $10 de salida y $0.10 de lectura de caché; Opus, $4, $20 y $0.20.
- Contexto largo: en Sol, cuando una sola entrada supera los 272K, se aplica un recargo a toda la solicitud: la entrada y la caché se duplican, y la salida se multiplica por 1.5.
- Separar las fuentes: las tareas y los niveles de razonamiento de los resultados auto-reportados por el proveedor y de las evaluaciones de terceros son distintos; no se pueden combinar en una sola conclusión.
- Disponibilidad actual: Opus 5.5 ya está en catálogo en APIYI; Sol todavía no está disponible, la referencia es la lista de modelos de la plataforma.
- Criterio de elección: si necesitas el protocolo de Claude y disponibilidad inmediata, elige Opus; para tareas diarias sensibles al precio unitario, evalúa primero Sol.
Resumen
La elección entre GPT-6.2 Sol y Claude Opus 5.5 se puede resumir en tres puntos:
- Mira la puntuación y el precio juntos: Sol tiene 2 puntos menos en la puntuación integral de terceros, y su precio oficial de lista para contextos cortos es aproximadamente la mitad del de Opus; ninguno de estos datos, por separado, es suficiente para tomar una decisión.
- Elige según la tarea y el protocolo: para tareas que dependen del protocolo de Claude y necesitan salir a producción de inmediato, elige Opus 5.5; para tareas diarias sensibles al precio unitario y con solicitudes que casi siempre se mantienen dentro de los 272K, vale la pena evaluar primero con Sol.
- Haz las cuentas con tus propias tareas: el costo por tarea de terceros corresponde únicamente a ese conjunto de evaluaciones; el costo real depende de tu consumo de tokens, los aciertos de caché y la intensidad de razonamiento.
En esta etapa, lo más práctico es montar primero el flujo de evaluación con Opus 5.5 y, cuando Sol esté disponible, completar una ronda de comparación con el mismo lote de solicitudes. Se recomienda usar APIYI (apiyi.com) para gestionar varios modelos con una sola clave; el cupo gratuito es suficiente para completar la primera ronda de validación.
📚 Referencias
-
Artículo de lanzamiento de OpenAI: notas de la versión de GPT-6.2 Astra y Sol y evaluaciones autoinformadas oficiales
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Descripción: resumen de precios, disponibilidad y comparaciones oficiales autoinformadas
- Enlace:
-
Página del modelo gpt-6.2-sol de OpenAI: especificaciones, endpoints y reglas completas de tarificación
- Enlace:
platform.openai.com/docs/models/gpt-6.2-sol - Descripción: precio de escritura en caché, regla de pedido completo de 272K y multiplicadores Batch / Fast / Ultrafast
- Enlace:
-
Tarjeta de sistema de OpenAI: evaluaciones de seguridad y alineamiento
- Enlace:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descripción: nivel del marco de preparación y conclusiones de las pruebas de alineamiento
- Enlace:
-
Artículo de evaluación de terceros de Artificial Analysis: resultados del Intelligence Index v5.0.1
- Enlace:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descripción: puntuaciones integrales por nivel de razonamiento, índices desglosados y comparación con el nivel máximo de Opus 5.5
- Enlace:
-
Página del modelo GPT-6.2 Sol de Artificial Analysis: métricas como el costo por tarea
- Enlace:
artificialanalysis.ai/models/gpt-6-2-sol - Descripción: costo por tarea del índice integral de $1.01 (nivel Max)
- Enlace:
-
Documentación de modelos de Claude: especificaciones de Opus 5.5 y precios oficiales de lista
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: precios de entrada y salida de Opus 5.5, ventana de contexto e intensidad de razonamiento predeterminada
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes contactarnos en la página principal de APIYI; la información más reciente sobre modelos y precios está disponible en la tabla general de modelos del centro de documentación en docs.apiyi.com