Nota del autor: a partir de la controversia por la modificación de los pesos de Qwen3.5-0.8B con GPT-6 Astra, analizamos en 6 pasos cómo examinar las afirmaciones sobre las capacidades de un modelo: desde la línea base y el acceso a herramientas hasta la configuración de la evaluación y las pruebas de reproducción.
Una noticia como «un modelo de frontera entendió y modificó los pesos de otro modelo, elevando su puntuación en matemáticas del 7.9% al 48.1%» basta para inundar las redes del sector de la IA. Pero, en menos de un día, un desarrollador publicó una refutación y algunos medios chinos se hicieron eco con titulares como «La obra maestra del MIT, demolida». Aprovecharemos esta polémica sobre la modificación de los pesos de Qwen por Astra para construir un método reutilizable con el que analizar las afirmaciones sobre las capacidades de los modelos.
Este no es un artículo para tomar partido. No vamos a juzgar quién tiene razón; compararemos, paso a paso, los registros originales del experimento, las afirmaciones de su autor y las críticas, para convertir un tema de actualidad en una lista de verificación que puedas usar una y otra vez.
Qué te llevarás: al terminar el artículo, sabrás plantear 6 preguntas para examinar cualquier anuncio de un «avance en las capacidades de un modelo» y evitar errores al elegir modelos, elaborar informes y tomar decisiones técnicas.
Puntos clave de la controversia sobre Astra y los pesos de Qwen
Empecemos con una tabla que resume los hechos y los puntos de controversia. El análisis que sigue parte de ellos.
| Punto clave | Descripción | Qué nos enseña al analizar la publicidad |
|---|---|---|
| Origen de la investigación | Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, del MIT CSAIL, publicaron el 2 de noviembre de 2026 el artículo Sparks of Weight-Space Programming, junto con los registros del experimento y el modelo modificado | La publicación de registros es un primer criterio para evaluar la credibilidad |
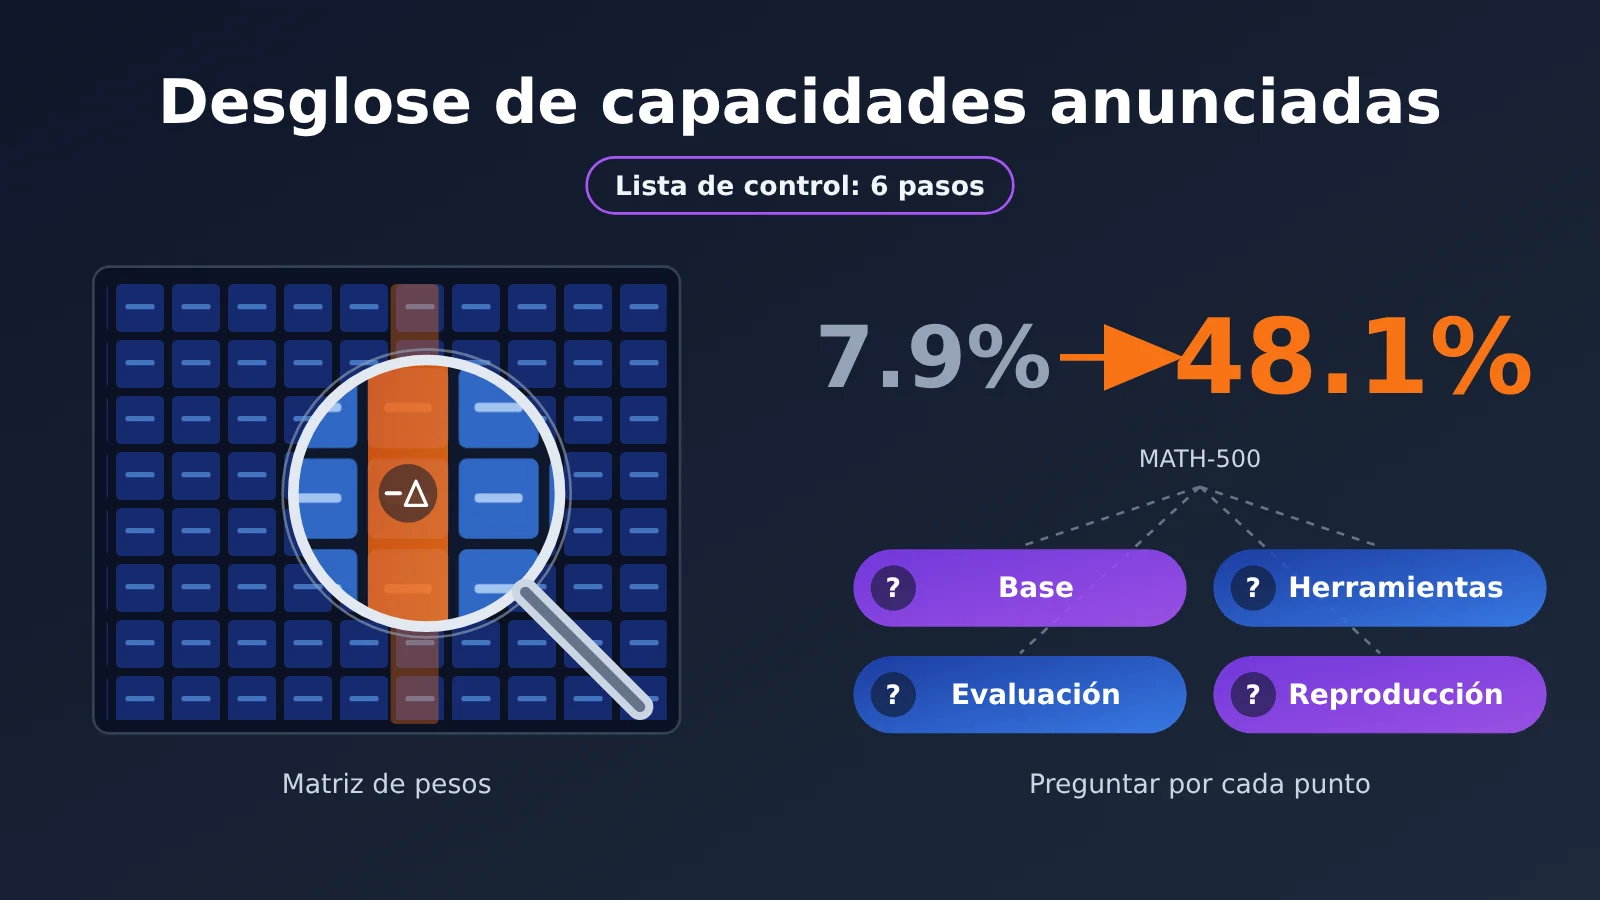
| Resultado principal | GPT-6 Astra modificó 131,072 de los aproximadamente 800 millones de pesos de Qwen3.5-0.8B (alrededor del 0.016 %), y el resultado en MATH-500 pasó del 7.9 % al 48.1 % | Cuanto más sorprendente sea el porcentaje, más importante es preguntar por qué el resultado inicial era tan bajo |
| Herramientas disponibles | En el experimento, Astra trabajó en un entorno Python con los pesos cargados y podía ejecutar hasta 50 lotes de evaluación de práctica | «Entender los pesos» y «escribir código para analizarlos» son dos cosas distintas |
| Críticas principales | Matthew Honnibal sostiene que la publicidad agrupa en una sola gran conclusión experimentos con distintos niveles de acceso a herramientas; Sean Goedecke considera que la corrección de Qwen es, en esencia, una técnica de steering ya conocida | Para saber si un método es nuevo, hay que compararlo con las técnicas existentes |
| Contraejemplo | Al aplicar el mismo proceso a Gemma 3 270M, el resultado en MATH-500 pasó del 6.8 % a un máximo del 7.7 %. Los propios autores consideran que no se puede afirmar que haya una mejora | Que funcione en un modelo no significa que la capacidad se pueda generalizar |
Cómo modificó realmente Astra los pesos de Qwen
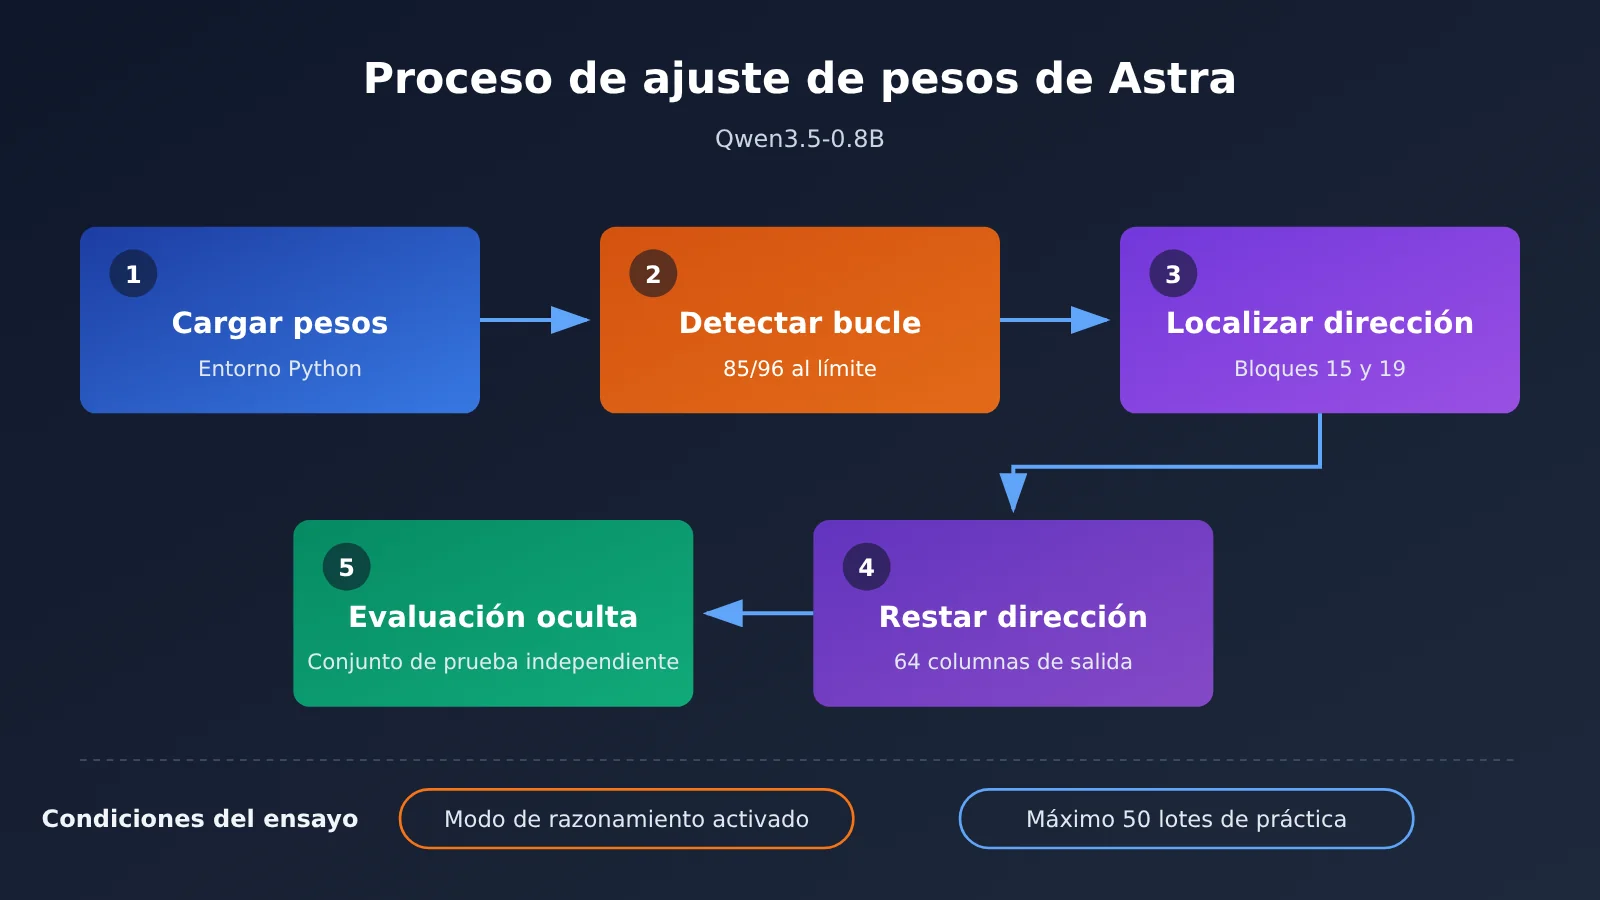
Al revisar los detalles del experimento, queda claro que fue mucho más complejo que «leer los pesos y mejorar la puntuación». Qwen3.5-0.8B tenía un grave problema de bucles al activar el modo de razonamiento: de las primeras 96 respuestas de práctica que Astra examinó, 85 alcanzaron el límite de 32,768 tokens sin dar una respuesta. Esta debilidad ya estaba documentada en la ficha oficial del modelo de Qwen. Cabe señalar que el modelo funciona por defecto sin el modo de razonamiento; en el experimento se activó de forma deliberada.
Después, Astra rastreó el comportamiento repetitivo hasta una dirección generada por las capas de propagación hacia delante de los bloques 15 y 19, y restó esa dirección de 64 columnas de salida de cada bloque. Según el README del experimento, se planeó modificar 131,072 pesos, pero, tras el redondeo correspondiente a la precisión de evaluación, cambiaron 130,188. La ejecución que tuvo éxito implicó 80 ejecuciones de código Python y duró 20.3 horas, incluidas 4.7 horas de interrupción del servicio.
Cómo analizar las afirmaciones sobre las capacidades de un modelo: lista de verificación en 6 pasos
Esta lista recoge lo que aprendimos de la controversia sobre la modificación de los pesos de Qwen por parte de Astra. Cada paso plantea una pregunta concreta y sirve para analizar artículos académicos, presentaciones, carteles con resultados de benchmarks e incluso textos comerciales de proveedores.
Paso 1: Examina primero la línea base y los modos de fallo
Ante cualquier afirmación de que algo «mejora X puntos porcentuales», conviene preguntar: ¿por qué era tan bajo el resultado original? La línea base de Qwen3.5-0.8B era de apenas el 7.9%, y el 93.0% de sus respuestas en MATH-500 alcanzaban el límite de tokens. Es decir, muchas veces el modelo no fallaba porque no supiera resolver el problema, sino porque ni siquiera terminaba de responder.
Compara la última columna de la tabla con la primera y la conclusión salta a la vista: el gran aumento de la puntuación coincide casi exactamente con la fuerte caída del porcentaje de respuestas que alcanzan el límite.
| Versión de Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Porcentaje que alcanza el límite en MATH-500 |
|---|---|---|---|---|
| Modelo base | 7.9% | 13.8% | 21.0% | 93.0% |
| Versión editada, 10 lotes de práctica | 12.3% | 25.7% | 49.0% | 87.2% |
| Versión editada, 25 lotes de práctica | 14.1% | 25.1% | 39.9% | 86.4% |
| Versión editada, 50 lotes de práctica | 48.1% | 67.1% | 62.3% | 33.1% |
Fuente de los datos: Takehi y colaboradores, MIT CSAIL, 2 de noviembre de 2026, con el modo de razonamiento activado. El texto original aclara que cada versión editada se ejecutó por separado y que las ediciones fueron distintas en cada caso. La edición de 131,072 pesos destacada en el titular corresponde a la fila de 50 lotes.
Paso 2: revisar qué herramientas tiene el modelo
Este es el núcleo de la crítica de Honnibal. El estudio presenta 8 experimentos y uno posterior con Gemma, pero las condiciones disponibles para el modelo variaban mucho: en algunos solo recibía los pesos originales en texto plano, sin ninguna herramienta; en otros tenía un entorno completo de Python y varias rondas de práctica y evaluación. Al agruparlos todos bajo la conclusión de que el modelo «puede leer y escribir pesos», es fácil que el lector sobreestime su capacidad pura de «comprenderlos».
| Experimento | Tamaño de la red | Condiciones disponibles para Astra | Resultado |
|---|---|---|---|
| Identificar a qué juego juega la red | 17,253 pesos | Pesos originales en texto plano | 4/4 correctos |
| Identificar la forma que dibuja un modelo de difusión | 23,824 | Pesos originales en texto plano | 3/3 correctos |
| Identificar el texto de entrenamiento de un modelo de lenguaje pequeño | 7,2 millones | Capas intermedias + Python | 3/3 correctos |
| Reparar una política de conducción bloqueada | 171,664 | Pesos originales, descripción del escenario y registro de 1 fallo | Tasa de éxito del 0% al 100% |
| Crear desde cero una red para jugar al Go de 9×9 | 1,48 millones | Python, hasta 50 rondas de práctica | Superó a una red PPO del mismo tamaño |
| Detectar el modelo adulador | 270 millones | Primero Python, después patrones de atención | Primero falló; después acertó 3/3 |
| Corregir el rendimiento matemático de Qwen | 800 millones | Python, hasta 50 lotes de práctica | MATH-500 del 7,9% al 48,1% |
| Mejorar el rendimiento matemático de Gemma | 270 millones | Python, hasta 50 lotes de práctica | Sin mejora concluyente (hasta 0,9 puntos porcentuales) |
La tabla se basa en el resumen de la investigación original publicado por R&D World; la clasificación de los recursos disponibles sigue la distinción de Honnibal. Se ve de inmediato: los experimentos de lectura de pesos en texto plano se hicieron con redes pequeñas, de unas decenas de miles de parámetros. Al trabajar con un modelo de lenguaje de 800 millones de parámetros, el modelo contaba con un entorno de Python como el que también usaría un ingeniero humano de aprendizaje automático.
Paso 3: Compara con las técnicas existentes para determinar qué hay de nuevo
Goedecke señala que encontrar una dirección de activación y restarla de los pesos es, en esencia, una aplicación de steering (guiado de activaciones), una técnica consolidada. Esto no resta valor al resultado, pero sí cambia su significado: lo destacable es que «el modelo puede completar por sí solo un proceso estándar de ingeniería de interpretabilidad», no que «el modelo tenga una capacidad sobrehumana para leer pesos».
Paso 4: Comprueba si la configuración de la evaluación se eligió para favorecer el resultado
Hay que verificar cada detalle: si se cambió el modo de razonamiento predeterminado, cuál era el límite de tokens, cuántos ejercicios se podían generar en cada prueba (en este experimento, cada llamada podía generar hasta 512 ejercicios o examinar las activaciones internas de hasta 1.024 fragmentos de texto) y si los ejercicios de evaluación estaban aislados del proceso de edición. El artículo original señala que el modelo no podía ver los ejercicios ni los resultados de evaluación durante la edición, lo cual es un punto a favor. Pero activar el modo de pensamiento amplificó precisamente la debilidad de Qwen para entrar en bucles, y eso también debe constar en tu conclusión.
Paso 5: Buscar contraejemplos y límites
Gemma 3 270M aporta uno de los conjuntos de datos más valiosos de este estudio. Por sí solo, rara vez entra en bucles: solo el 8,5 % de sus respuestas alcanza el límite, frente al 93 % de Qwen. El mismo procedimiento no produjo una mejora concluyente en Gemma. La interpretación de los propios autores es que editar los pesos puede eliminar los obstáculos que ocultan una capacidad, pero no puede crear de la nada una capacidad que el modelo no posee. Si una campaña promocional solo muestra casos de éxito y omite los fallidos, su credibilidad se resiente.
Paso 6: Comprobar si existe una reproducción independiente
La tarjeta del modelo modificado documenta una prueba independiente realizada por akhaliq, de Hugging Face, con ML Intern: cubrió las 500 preguntas de MATH-500, con un total de 2.000 generaciones, y obtuvo una puntuación del 51,0 %, con un 31,6 % de respuestas que alcanzaron el límite. La reproducción independiente coincide en líneas generales con el resultado original, lo que confirma que la puntuación efectivamente subió. La controversia se centra en cómo interpretar esa puntuación, no en si fue falsificada.
🎯 Consejo práctico: después de leer las afirmaciones promocionales, conviene comparar por tu cuenta el rendimiento de varios modelos con el mismo conjunto de preguntas. APIYI apiyi.com ofrece acceso mediante API a modelos como Claude Opus 5.5, Kimi K3.1 Pro y la serie Qwen3.8. Es compatible con los formatos de interfaz de OpenAI y Anthropic, por lo que puedes cambiar de modelo en un mismo script para contrastar los resultados. Consulta las instrucciones de integración en docs.apiyi.com.
Contrastar la promoción de Astra y las críticas con una lista de verificación
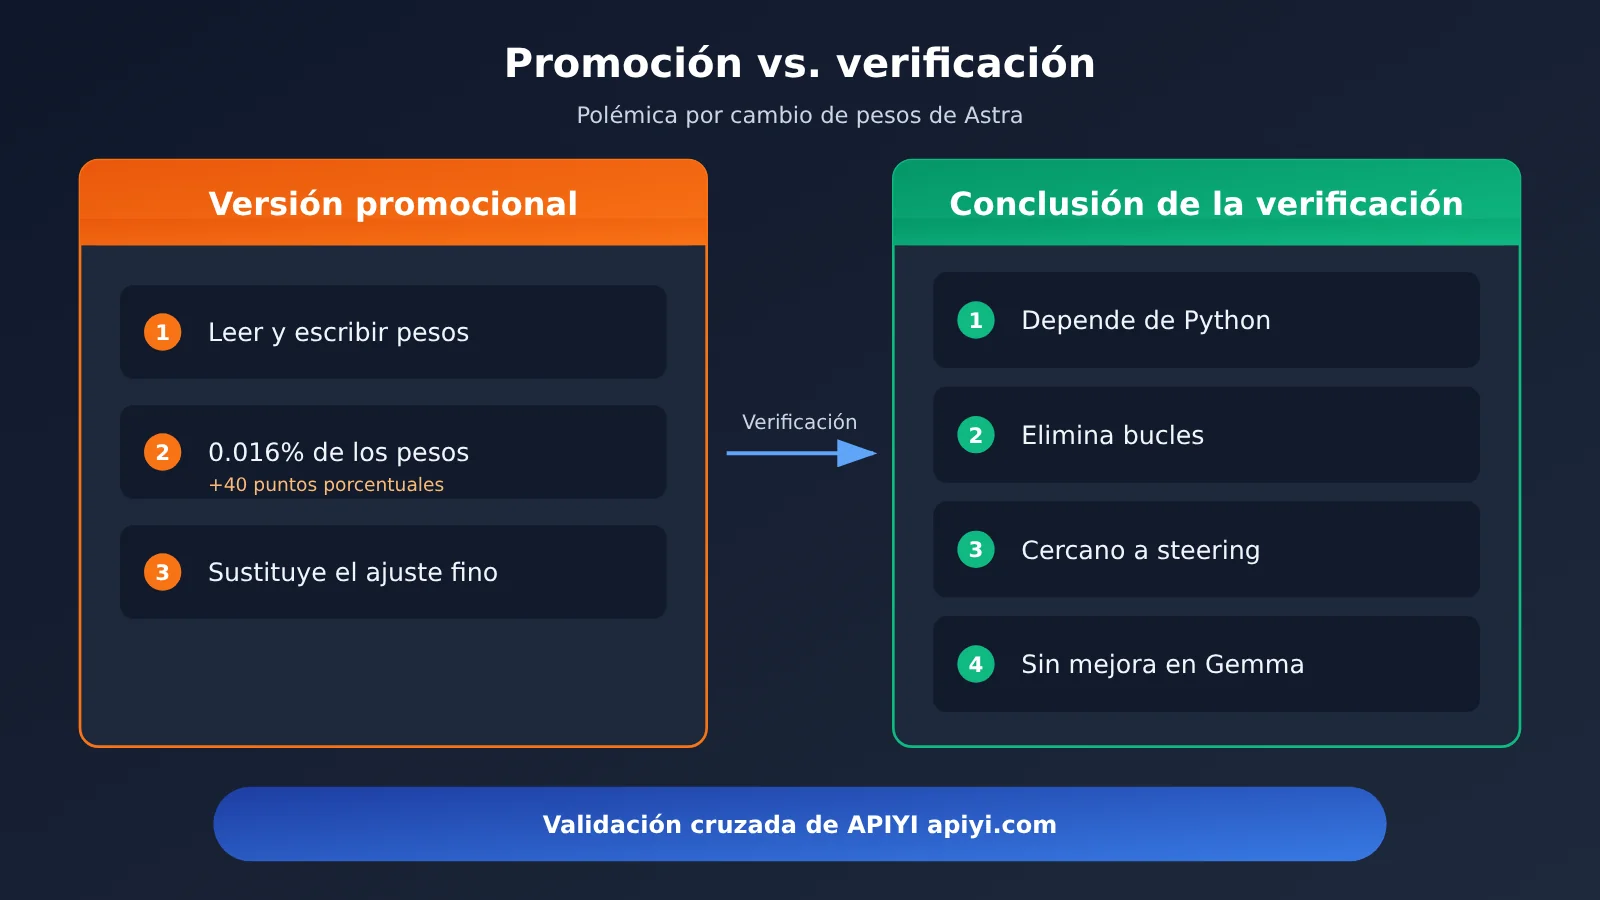
Al aplicar la lista de 6 pasos a esta controversia, obtenemos una tabla de «afirmaciones promocionales vs. conclusiones de la verificación». Puedes reutilizar este formato en futuros informes de evaluación técnica.
| Afirmación promocional | Aspecto verificado | Conclusión de la verificación |
|---|---|---|
| Astra puede interpretar los pesos de una red neuronal | Permisos de herramientas | En redes pequeñas funciona con texto plano; para el modelo de 800 millones de parámetros necesita análisis con Python |
| Modificar el 0.016% de los pesos mejora el resultado en 40 puntos porcentuales | Línea base y modos de fallo | La mejora proviene principalmente de reducir los bucles; la tasa de casos que alcanzan el límite baja del 93.0% al 33.1% |
| Inaugura la programación en el espacio de pesos | Novedad del método | La operación principal se parece a técnicas de steering ya existentes |
| Puede sustituir parte del ajuste fino | Capacidad de generalización | En Gemma no hay una mejora concluyente; solo puede eliminar obstáculos, no añadir capacidades |
| Los resultados son reales y fiables | Reproducción independiente | Una repetición por terceros obtuvo un 51.0%, lo que respalda la fiabilidad de las cifras |
Comparativa con la competencia: cómo interpretar las afirmaciones sobre capacidades similares
GPT-6 Astra ya había llamado la atención en varias ocasiones por sus resultados en pruebas. En septiembre, la fundación ARC Prize publicó un resultado del 62.7% en ARC-AGI-3 bajo un marco de evaluación compartido. OpenAI también afirmó que Astra había alcanzado su umbral de capacidad de ciberseguridad de nivel Critical. Para interpretar estas cifras también sirve la lista de comprobación de este artículo: primero pregunta si el marco de evaluación es compartido o personalizado; después, qué permisos de herramientas se concedieron y cuántas ejecuciones se hicieron.
En una comparativa publicada por R&D World el 23 de octubre, Claude Opus 5.5 y Kimi K3.1 Pro también se midieron frente a Astra. Los modelos de distintos proveedores pueden destacar en las tareas para las que están mejor preparados, pero las campañas promocionales suelen usar la configuración más favorable para cada uno. En cambio, hacer tus propias pruebas con los mismos ejercicios y parámetros resulta más convincente que cualquier anuncio.
💡 Consejo para elegir modelo: si quieres comparar estos modelos con tareas de tu propio negocio, puedes empezar con pruebas a pequeña escala a través de la interfaz unificada de APIYI en apiyi.com. Ten en cuenta que GPT-6 Astra todavía no está disponible en APIYI; lo incorporaremos lo antes posible. Claude Opus 5.5 y Kimi K3.1 Pro ya están disponibles para su invocación.
Disponibilidad y precios de los modelos en APIYI
Los precios de la siguiente tabla se basan en los datos de la página de precios de APIYI, docs.apiyi.com/models. Consulta allí las unidades de facturación indicadas; este artículo no incluye precios de terceros.
| Modelo | Nombre del modelo en APIYI | Precio de entrada | Precio de salida | Precio de caché | Disponibilidad |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | Disponible en APIYI |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | Disponible en APIYI |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | Disponible en APIYI |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Disponible en APIYI |
| Serie Qwen3.8 | Serie qwen3.8 | Ver página de precios | Ver página de precios | Ver página de precios | Disponible en APIYI |
| GPT-6 Astra | No disponible | No disponible | No disponible | No disponible | APIYI aún no ofrece este modelo; estará disponible lo antes posible |
| Qwen3.5-0.8B | No disponible | No disponible | No disponible | No disponible | APIYI aún no ofrece este modelo; estará disponible lo antes posible |
| Gemma 3 270M | No disponible | No disponible | No disponible | No disponible | APIYI aún no ofrece este modelo; estará disponible lo antes posible |
Qwen3.5-0.8B y Gemma 3 270M son modelos pequeños de pesos abiertos. Los puntos de control de Qwen modificados en la investigación también están disponibles en Hugging Face. Para reproducir la edición de los pesos, hay que cargarlos localmente; para comparar las capacidades de distintos modelos, resulta más práctico usar una API en la nube.
Preguntas frecuentes (FAQ)
P1: ¿En qué consiste la investigación en la que Astra modifica los pesos de Qwen?
El equipo de MIT CSAIL puso a prueba si GPT-6 Astra podía entender y modificar los pesos de otras redes neuronales. En el experimento principal, Astra cambió alrededor del 0,016 % de los pesos de Qwen3.5-0.8B y elevó su puntuación en MATH-500 del 7,9 % al 48,1 %. Los registros y los modelos correspondientes son públicos.
P2: ¿En qué discrepan exactamente los críticos y los autores?
La discrepancia no está en la veracidad de los datos, sino en su interpretación. Los autores destacan que el modelo es capaz de leer y modificar pesos. Honnibal sostiene que se han agrupado en una gran conclusión experimentos con distintos permisos de acceso a herramientas. Goedecke, por su parte, considera que la corrección de Qwen pertenece a la técnica ya conocida como steering y que el trabajo principal consiste en un análisis en Python que también podrían escribir ingenieros humanos.
P3: ¿Cuándo se publicó la investigación y ha habido avances posteriores?
La investigación se publicó como entrada de blog el 2 de noviembre de 2026. En menos de un día aparecieron críticas públicas y también hubo un largo debate en Hacker News. Los autores afirman que están desarrollando un benchmark y un marco de evaluación para medir esta capacidad, por lo que conviene seguir de cerca los próximos resultados.
P4: ¿En qué situaciones resulta útil la lista de verificación de 6 pasos?
– **Selección de tecnología**: revisar las puntuaciones y los mensajes promocionales de los proveedores antes de contratar o integrar un modelo
– **Lectura de investigaciones**: valorar rápidamente el alcance real de la cifra más destacada de un artículo
– **Informes internos**: presentar conclusiones con sus límites al explicar un supuesto «avance» al equipo
– **Redacción de contenidos**: evitar que una sola cifra determine la evaluación de un modelo
P5: ¿Cómo puedo verificar por mi cuenta las afirmaciones sobre las capacidades de un modelo mediante una API?
La forma más directa es preparar un conjunto de preguntas similar a las tareas de tu negocio, mantener fijos el modo de razonamiento y la longitud de salida, y ejecutarlo en varios modelos. A través de APIYI apiyi.com puedes invocar modelos como Claude Opus 5.5, Kimi K3.1 Pro y la serie Qwen3.8 mediante una interfaz unificada compatible con los formatos de OpenAI y Anthropic. Encontrarás las instrucciones de integración en docs.apiyi.com y los precios en docs.apiyi.com/models.
P6: ¿Cuáles son las limitaciones conocidas de esta investigación?
En primer lugar, los experimentos con Modelos de Lenguaje Grande dependen de herramientas de Python y varias rondas de práctica; no consisten simplemente en «entender» los pesos. En segundo lugar, la mejora procede principalmente de reducir los bucles y depende de que esté activado el modo de pensamiento. En tercero, no se observó una mejora concluyente en Gemma, lo que indica que no se pueden añadir capacidades de la nada. Por último, aplicaciones como la automejora siguen siendo, por ahora, propuestas de los autores que aún no se han demostrado.
P7: ¿Está relacionado Astra con el riesgo de colaboración entre agentes que se menciona en la investigación?
El incidente de Hugging Face divulgado por OpenAI el 26 de agosto fue impulsado principalmente por IM1, un modelo de investigación interno. OpenAI excluyó expresamente a Astra de ese incidente. La combinación de «colaboración multiagente + edición de pesos» es por ahora solo una posibilidad especulativa y no ha sido demostrada por esta investigación.
P8: ¿Qué conviene tener en cuenta al interpretar los resultados?
Las cifras muestran lo ocurrido en las condiciones concretas de los experimentos. No demuestran por sí solas que el modelo pueda mejorar cualquier otra red ni que esas mejoras se mantengan en todos los contextos.
Puntos clave para analizar las afirmaciones sobre capacidades de los modelos
- Pregunta primero por la línea base: la de Qwen es baja principalmente porque el 93 % de las respuestas alcanza el límite; la mayor parte de la mejora proviene de corregir bucles.
- Pregunta por las herramientas: leer pesos en texto plano solo funciona con redes pequeñas; los experimentos con modelos grandes dependen de un entorno Python.
- Compara con técnicas anteriores: la corrección de Qwen se parece al steering; su valor está en completar el proceso de ingeniería de forma autónoma.
- Examina la configuración de la evaluación: el modo de razonamiento, el límite de tokens y los lotes de práctica influyen en la puntuación final.
- Busca contraejemplos: Gemma no muestra una mejora concluyente, lo que indica que la edición puede eliminar obstáculos, pero no añadir capacidades.
- Valora la reproducción independiente: un tercero obtuvo un 51,0 % al repetir la prueba. La cifra es fiable, pero debe interpretarse con cautela.
- Compruébalo por tu cuenta: usa la interfaz unificada de APIYI apiyi.com para comparar modelos con tus propias tareas.
Conclusión
La principal lección de la controversia sobre la modificación de los pesos de Qwen por parte de Astra no es que un modelo sea fuerte o débil, sino que incluso un resultado real y reproducible puede presentarse como prueba de conclusiones que van más allá de la evidencia. Estos son los puntos clave para analizar las afirmaciones sobre capacidades de los modelos:
- Acompaña las cifras con los modos de fallo: sin la línea base y la tasa de respuestas que alcanzan el límite, el 48,1 % por sí solo dice poco.
- Acompaña las conclusiones con sus condiciones: el acceso a herramientas, el modo de razonamiento y el número de intentos de práctica delimitan el alcance de los resultados.
- Acompaña los éxitos con contraejemplos y reproducciones: el contraejemplo de Gemma y la prueba repetida por un tercero ayudan a precisar el significado real del resultado.
La próxima vez que veas un titular que anuncie que «un modelo ha logrado un avance», repasa estas seis preguntas una por una y haz una prueba con tus propios datos. Puedes usar APIYI apiyi.com para comparar varios modelos con una misma interfaz. La documentación está en docs.apiyi.com y los precios, en docs.apiyi.com/models.
📚 Referencias
- Artículo de 36氪: La supuesta maravilla del MIT, bajo fuego: ¿Astra modificó los pesos de Qwen? No exageremos
- Enlace:
36kr.com/p/4056481264866438 -
Descripción: cobertura en chino de la controversia por un medio nacional
-
Blog original de la investigación: Sparks of Weight-Space Programming
- Enlace:
rikiyat.github.io/blog/weight-space-programming -
Descripción: descripción original de los experimentos del equipo de MIT CSAIL
-
Repositorio de registros experimentales: lm_understand-logs
- Enlace:
github.com/RikiyaT/lm_understand-logs -
Descripción: incluye el README del experimento con Qwen y los registros completos de cada experimento
-
Artículo crítico de Matthew Honnibal
- Enlace:
honnibal.dev/blog/astra-read-write-misleading -
Descripción: analiza cómo se presentaron los resultados desde la perspectiva de los permisos de las herramientas
-
Artículo crítico de Sean Goedecke
- Enlace:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
Descripción: compara la corrección de Qwen con las técnicas de steering
-
Ficha del modelo Qwen modificado
- Enlace:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - Descripción: incluye los resultados de una reproducción independiente por terceros
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI en apiyi.com. Para más información sobre la integración, visita el centro de documentación en docs.apiyi.com.