Anmerkung des Autors: Beide Modelle kosten zu Spitzenzeiten gleich viel, haben aber unterschiedliche Stärken. Vier Tabellen zu Parametern, Preisen, Benchmarks und Aufgabenverteilung zeigen, welches Modell sich für welche Aufgabe eignet.
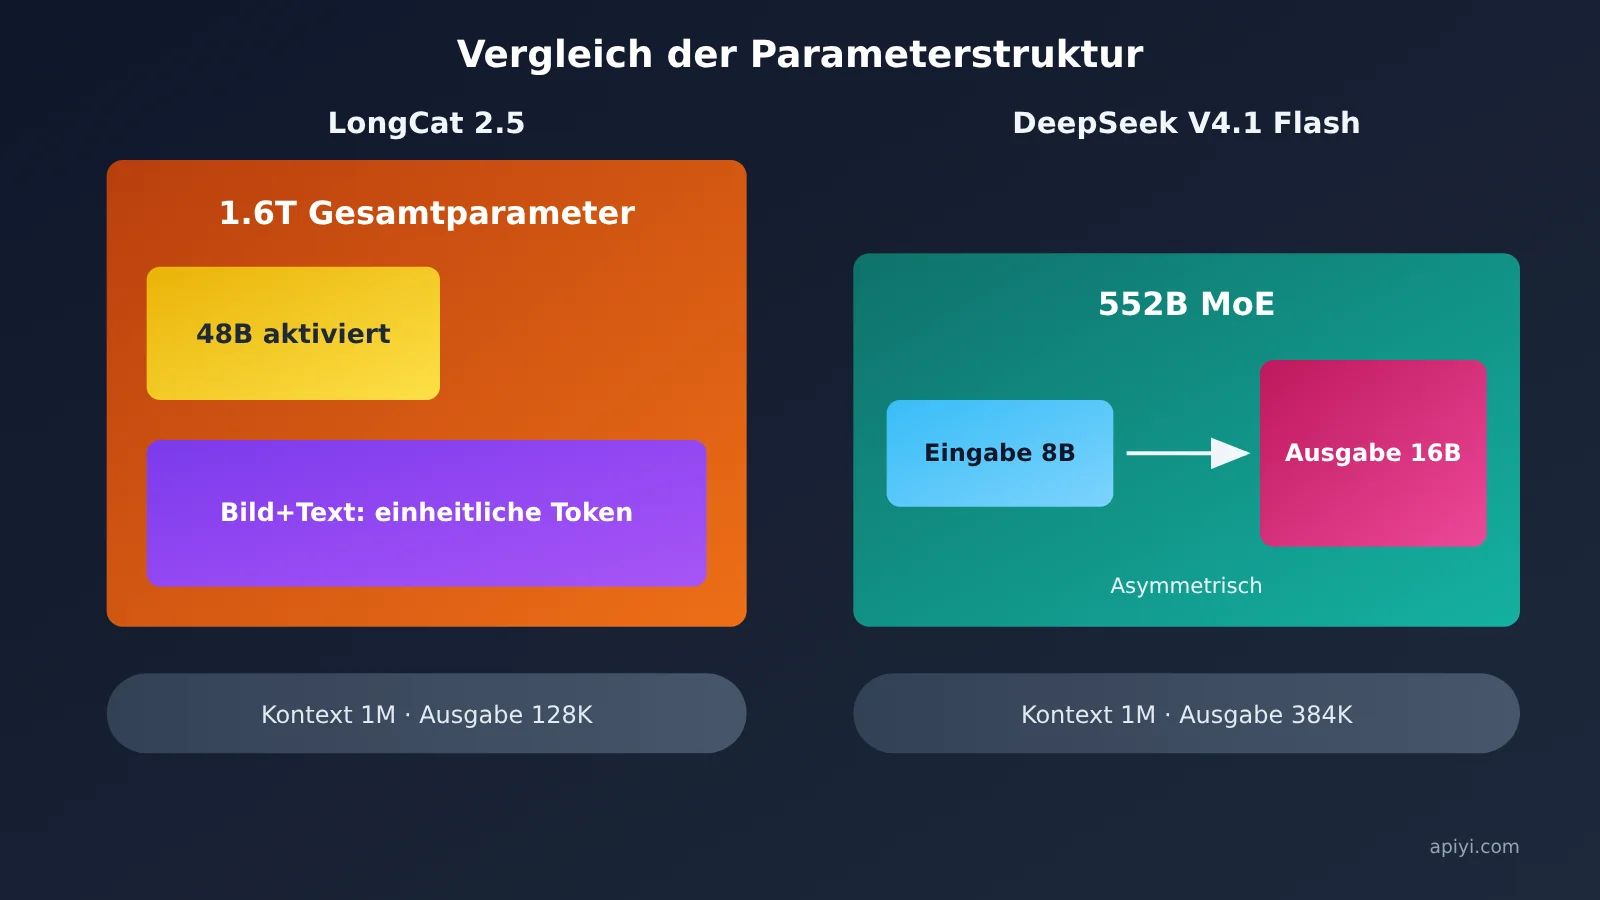
Zu Spitzenzeiten sind die Preise identisch: Eingabe $0.30, Cache $0.006 und Ausgabe $1.20 (jeweils pro 1 Million Token). Der Unterschied liegt in den Stärken der Modelle – die Wahl hängt also davon ab, welche Aufgaben Sie erledigen möchten. LongCat 2.5 ist ein nativ multimodales Modell mit insgesamt 1,6 Billionen Parametern, von denen pro Token etwa 48 Milliarden aktiviert werden. DeepSeek V4.1 Flash ist ein asymmetrisches MoE-Modell mit 552 Milliarden Parametern: Bei der Eingabe werden 8 Milliarden, bei der Ausgabe 16 Milliarden aktiviert. Die Modellgewichte sind bereits quelloffen.
Dies ist kein ausweichender Vergleich nach dem Motto „beide haben ihre Stärken“. Alle folgenden Zahlen stammen aus den offiziellen Blogs, technischen Berichten und Preisübersichten der beiden Anbieter. Die Benchmark-Ergebnisse beruhen jeweils auf eigenen Tests der Anbieter. Dieser Artikel nutzt sie nur zum Vergleich auf gleicher Ebene, erstellt keine Gesamtrangliste und behauptet keine Praxistests, die nicht durchgeführt wurden.
Der Nutzen auf einen Blick: Nach der Lektüre können Sie die Aufgaben Ihres Projekts einzeln abgleichen, ein Hauptmodell und ein ergänzendes Modell auswählen und ausrechnen, wie viel Sie sparen, wenn Sie Stapelverarbeitungsaufgaben in Zeiten geringerer Auslastung verschieben.
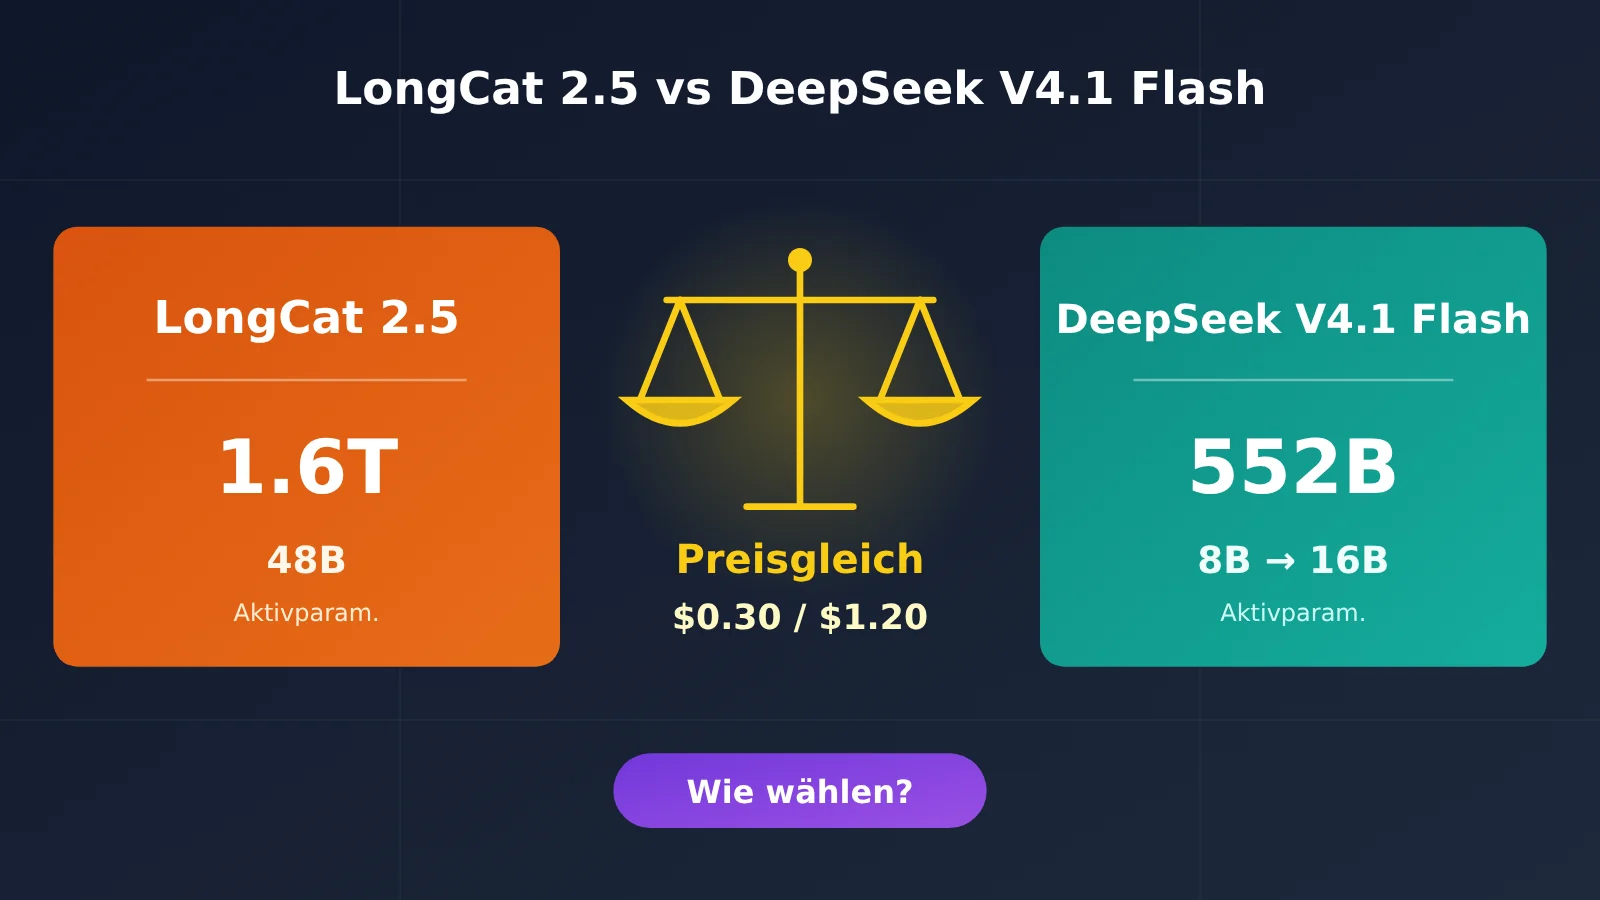
LongCat 2.5 im Vergleich zu DeepSeek V4.1 Flash: zwei Modelle im Überblick
Das Wichtigste vorweg: LongCat 2.5 hat mehr Parameter und aktiviert pro Durchlauf auch mehr davon. DeepSeek V4.1 Flash ist kleiner, kommt mit weniger aktivierten Parametern aus, erlaubt längere Ausgaben und stellt seine Gewichte direkt zum Download bereit. Beide haben ein Kontextfenster von 1M. Für die Auswahl sind vor allem drei Punkte entscheidend: die maximale Ausgabelänge von 128K gegenüber 384K, die Verfügbarkeit der Gewichte und die Zahl der aktivierten Parameter.
| Merkmal | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Parameter insgesamt | 1.6T (1,6 Billionen) | 552B |
| Aktivierte Parameter | Rund 48B pro Token | 8B für die Eingabe, 16B für die Ausgabe |
| Architektur | Nativ multimodales Modell für KI-Agenten, das visuelle und textuelle Inhalte mit einheitlichen Tokens verarbeitet | MoE mit asymmetrischer Causal-Encoder-Decoder-Architektur |
| Kontextfenster | 1M | 1M |
| Maximale Ausgabelänge | 128K | 384K |
| Native visuelle Verarbeitung | Unterstützt; visuelle Signale werden als diskrete Tokens auf mehreren Ebenen dargestellt | Unterstützt (Vision) |
| Offene Gewichte | Noch nicht veröffentlicht; auf GitHub und Hugging Face als „demnächst verfügbar“ markiert | Veröffentlicht; Gewichte und technischer Bericht sind auf Hugging Face verfügbar |
| Thinking-Modus | Die offiziellen Bewertungsergebnisse wurden mit aktiviertem Thinking-Modus erzielt | Standardmässig aktiviert, über reasoning_effort einstellbar |
LongCat 2.5: Die wichtigsten Architekturmerkmale
LongCat 2.5 ist klar für langfristige Agentenaufgaben ausgelegt. Gegenüber Version 2.0 wurden vor allem das native visuelle Verständnis und die Programmierung durch Agenten verbessert. Bilder werden bei ihrer nativen Auflösung diskretisiert (SAE+RVQ), zunächst offline zu visuellen Token vorverarbeitet und dann gemeinsam mit dem Hauptmodell trainiert. Das Hauptmodell verarbeitet visuelle und Text-Token mit demselben System – daher die Bezeichnung nativ multimodal.
Für das Training setzt LongCat 2.5 umfangreich auf langfristige Trajektoriendaten und Reinforcement Learning (RL) für lange Aufgabenabläufe. Der offizielle Blog nennt einige Details: Fehlgeschlagene Abläufe realer Agenten werden in überprüfbare Aufgaben umgewandelt. Asynchrones RL nutzt partielle Rollouts und filtert Stichprobengruppen heraus, in denen alle Ergebnisse richtig oder alle falsch sind und die daher einen Gradienten von null erzeugen. Wiederholtes Nachdenken und wiederholte Tool-Aufrufe werden zudem durch Strafwerte belegt. Das ist gerade für die Agentenentwicklung wichtig: Das Modell bleibt seltener in Tool-Schleifen hängen und verschwendet dadurch weniger Token.
Bei der Inferenz bietet W4A4 gegenüber W8A8 INT8 folgende Verbesserungen: Der Prefill-Durchsatz steigt um 43,3 %, der Decode-Durchsatz um 42,77 %, die TTFT sinkt um 15,91 % und die TPOT um 19,72 %. Auf Trainingsseite erhöht FSDP mit zweifachem Sharding den SFT-Durchsatz pro GPU bei langen Sequenzen gegenüber der DDP-Baseline um 86 %. Diese Zahlen zeigen, dass das 1,6T-Modell für den Serverbetrieb gezielt komprimiert wurde. Offizielle Angaben zu Rate-Limits gibt es allerdings nicht.
DeepSeek V4.1 Flash: Die wichtigsten Architekturmerkmale
DeepSeek V4.1 Flash ist das kleinste Modell der neuen Architekturfamilie. Sein besonderes Merkmal ist die asymmetrische Verarbeitung von Ein- und Ausgabe: Beim Lesen der Eingabe werden nur 8B Parameter aktiviert, bei der Generierung der Ausgabe 16B. In Agent-Szenarien ist die Eingabe oft deutlich umfangreicher als die Ausgabe – etwa beim Lesen von Repositories, Logs oder Tool-Ergebnissen. Dieses Design senkt gezielt den Rechenaufwand für die Eingabeverarbeitung.
Noch deutlicher fallen die Veränderungen bei den Kosten aus. Der KV-Cache der neuen Generation ist erheblich kleiner: Der HBM-Bedarf sinkt gegenüber der Vorgängergeneration auf ein Viertel, der SSD-Bedarf auf ein Achtel. Im Vergleich zum Modell der ersten Generation ist der KV-Cache insgesamt um den Faktor 437 geschrumpft. Eine weitere Änderung ist wichtig: Ab dem 14.09.2026 um 12:00 Uhr werden Anfragen an deepseek-v4-pro zu V4.1 Flash weitergeleitet und zum Flash-Preis abgerechnet. Das gilt bis zur Veröffentlichung von V4.1 Pro. Projekte, die noch den alten Modellnamen verwenden, rufen damit tatsächlich Flash auf.
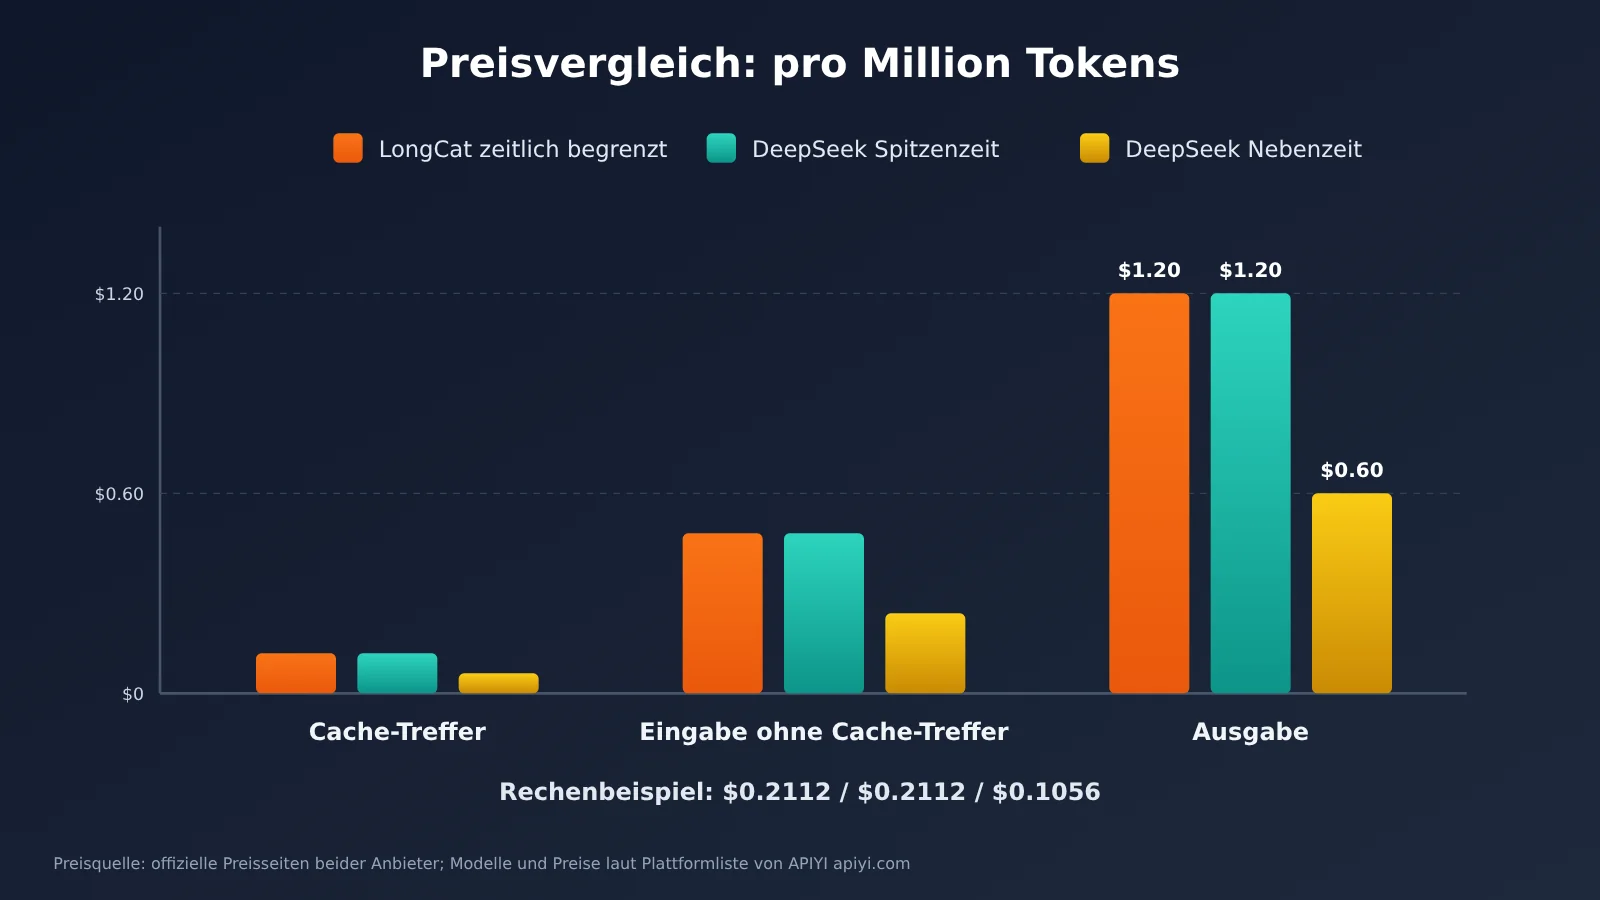
LongCat 2.5 und DeepSeek V4.1 Flash im Preisvergleich: Gleich teuer nur zu Spitzenzeiten
Das Fazit: Der zeitlich begrenzte Rabattpreis von LongCat 2.5 entspricht in allen Kategorien dem Spitzenzeittarif von DeepSeek V4.1 Flash. Außerhalb der Spitzenzeiten kostet DeepSeek dagegen nur die Hälfte. Von gleichen Preisen kann also nur tagsüber an Arbeitstagen die Rede sein.
| Pro 1 Million Tokens (US-Dollar) | LongCat 2.5 (zeitlich begrenzter Rabatt) | DeepSeek Spitzenzeit | DeepSeek Nebenzeit |
|---|---|---|---|
| Eingabe mit Cache-Treffer | $0.006 | $0.006 | $0.003 |
| Eingabe ohne Cache-Treffer | $0.30 | $0.30 | $0.15 |
| Ausgabe | $1.20 | $1.20 | $0.60 |
Ein Rechenbeispiel: Angenommen, eine Agent-Aufgabe verbraucht 500.000 Eingabe-Tokens (davon 300.000 ohne und 200.000 mit Cache-Treffer) sowie 100.000 Ausgabe-Tokens:
- LongCat 2.5 (zeitlich begrenzter Rabatt): 0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek Spitzenzeit: gleiche Berechnung, $0.2112
- DeepSeek Nebenzeit: 0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
Pro Aufgabe beträgt der Unterschied rund 10 Cent – das klingt zunächst wenig. Bei 1.000 Aufgaben gleicher Größe pro Tag kosten LongCat und DeepSeek zur Spitzenzeit jeweils $211.2, DeepSeek zur Nebenzeit dagegen $105.6. Für Teams, die Aufgaben in großen Mengen verarbeiten, summiert sich die Differenz über einen Monat erheblich.
Die Spitzenzeiten von DeepSeek liegen an Arbeitstagen zwischen 09:00 und 12:00 Uhr sowie zwischen 14:00 und 18:00 Uhr Pekinger Zeit. Das entspricht Montag bis Freitag 01:00–04:00 Uhr und 06:00–10:00 Uhr UTC; gesetzliche Feiertage in China sind ausgenommen. Zu allen anderen Zeiten gilt der halbe Preis: werktags mittags, abends und nachts sowie an Wochenenden und gesetzlichen Feiertagen ganztägig. Anders gesagt: Von den 168 Stunden einer Woche entfallen nur sieben Stunden pro Arbeitstag auf die Spitzenzeit.
Bei der Abrechnung von LongCat 2.5 sind außerdem einige Details wichtig:
- Nur bei HTTP 200 fallen Kosten an; 401, 403, 429 und 500 werden nicht berechnet. Fehlgeschlagene erneute Versuche kosten also nichts.
- Guthabenpakete sind täglich um 10:00, 16:00, 21:00 und 23:00 Uhr Pekinger Zeit in begrenzter Menge im Blitzverkauf erhältlich. Sie sind 30 Tage gültig; nicht verbrauchtes Guthaben kann vollständig erstattet werden. Cache-Treffer verbrauchen keine Tokens aus dem Guthabenpaket.
- Geschenktes Guthaben: Neue Nutzer erhalten 10M Tokens, bestehende Nutzer 5M Tokens. Die Gutschrift erfolgt automatisch; Cache-Treffer verbrauchen davon nichts.
- Die Preise sind als zeitlich begrenzter Rabatt gekennzeichnet. Für spätere Änderungen ist die offizielle Preisseite maßgeblich.
Bei DeepSeek werden Websuche und das Abrufen von Webseiten als separate APIs abgerechnet. Beide kosten jeweils $0.75 pro 1.000 erfolgreiche Anfragen. Wenn dein Agent häufig auf das Web zugreift, solltest du diese Kosten gesondert einplanen.
💰 Kostenhinweis: Wenn Sie DeepSeek V4.1 Flash über APIYI apiyi.com aufrufen, richtet sich die Abrechnung nach der Modellliste der Plattform. Die Preise müssen nicht den offiziellen Haupt- und Nebenzeittarifen entsprechen. Am besten führen Sie zunächst einige Testaufgaben über die Plattformkonsole aus und prüfen die Abrechnung, bevor Sie größere Mengen planen.
LongCat 2.5 und DeepSeek V4.1 Flash im offiziellen Benchmark-Vergleich
Das Fazit: Bei den meisten Agent-Benchmarks liegen die beiden Modelle weniger als drei Punkte auseinander und damit ungefähr auf demselben Niveau. LongCat 2.5 liegt bei Terminal Bench v4.0, Program Bench, JobBench und der 3D-Generierung vorn. DeepSeek V4.1 Flash führt bei DeepSWE, NL2Repo und AutomationBench – und zwar mit einem größeren Vorsprung.
| Benchmark | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(Text to 3D) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
Wichtig zur Einordnung: Die Zahlen beider Anbieter stammen aus offiziellen eigenen Tests. LongCat 2.5 wurde mit dem eigenen Test-Harness bei aktiviertem Thinking, temperature=1.0 und top_p=0.95 getestet. Die Werte für DeepSeek stammen überwiegend aus dessen öffentlichem technischen Bericht; verwendet wurden das DeepSeek-eigene Test-Harness und die Inferenzstufe Max. Da sich Test-Harness, Testdatum und Inferenzstufe unterscheiden, dient die Tabelle nur zur groben Einordnung vergleichbarer Modelle – nicht als Rangliste.
Wie sind die Benchmark-Ergebnisse zu lesen?
Die beiden grössten Unterschiede gehen in entgegengesetzte Richtungen. Beim Terminal Bench v4.0 liegt LongCat 2.5 um 7,3 Punkte vor DeepSeek (38,5 gegenüber 31,2); beim DeepSWE v1.1 liegt DeepSeek um 9,6 Punkte vor LongCat (74,2 gegenüber 64,6). Der erste Benchmark prüft schwierigere, längere Terminal-Aufgaben, der zweite die Fehlerbehebung in echten Code-Repositories. Hier zeigen sich unterschiedliche Stärken: Das eine Modell beherrscht längere Abläufe im Terminal, das andere nimmt präzise Änderungen an bestehenden Codebasen vor.
Bei der älteren Version Terminal Bench v2.1 liegt dagegen DeepSeek um 2,2 Punkte vorn. LongCats Vorteil zeigt sich also erst bei höherem Schwierigkeitsgrad. Beim Program Bench führt LongCat mit 5,2 Punkten, beim NL2Repo DeepSeek mit 4,9 Punkten. NL2Repo testet die Erstellung eines kompletten Repositories aus einer Beschreibung in natürlicher Sprache und kommt damit der Fähigkeit näher, ein Projekt von Grund auf aufzubauen.
Bei den visuellen Benchmarks sind die Unterschiede gering. Beim Vision2Web liegt DeepSeek um 0,6 Punkte vorn, beim 3DCodeBench LongCat um 2,1 Punkte. In der offiziellen Tabelle erreicht LongCat bei CharXiv-RQ w/tools 90,2 gegenüber 87,7 Punkten; bei MathVision w/tools führt DeepSeek mit 97,4 gegenüber 96,5 Punkten. Beim reinen visuellen Verständnis sind beide etwa gleichauf. LongCats Stärke liegt vor allem darin, visuelles Verständnis mit der Erstellung von 3D-Inhalten und interaktiven Webseiten zu verbinden. Die acht offiziellen Demos umfassen unter anderem eine Flüssigkeitssimulation in Echtzeit, eine interaktive 3D-Präsentation von Kulturobjekten, ein Stadtmodell und Assets für Miniaturszenen. Die Richtung ist klar erkennbar.
Bei BrowseComp, HLE w/tools und MCP Atlas liegen die Ergebnisse jeweils höchstens 1,3 Punkte auseinander. Bei allgemeinen Agentenfähigkeiten wie der Online-Recherche und dem Aufruf von MCP-Tools kann man die Modelle daher als gleichauf betrachten.
DeepSeeks Reasoning-Stufe als Kostenhebel
Abschnitt 5.3.3 des technischen Berichts von DeepSeek enthält einige praktische Zahlen. Steigt der Reasoning-Aufwand von 25 auf 100, erhöht sich der durchschnittliche Pass@1-Wert über acht Reasoning-Benchmarks von 67,1 % auf 76,3 %. Bei DeepSWE v1.1 steigt der Wert von 66,0 auf 74,2. Dafür werden allerdings rund 2,5-mal so viele Ausgabe-Token benötigt. Die Stufen 60 bis 80 erreichen bereits nahezu die Genauigkeit der Maximalstufe und verbrauchen dabei weniger als die Hälfte des Token-Budgets. Beim letzten Schritt auf Stufe 100 wächst die Länge der Agenten-Trajektorien nochmals um den Faktor 1,6 bis 1,8 – für einen vergleichsweise kleinen Zugewinn.
Wichtig ist auch: Bei der DeepSeek-API steht reasoning_effort standardmäßig auf high, während die offiziellen Ergebnisse auf der Stufe max erzielt wurden. Wer die Werte aus der DeepSeek-Spalte der Tabelle oben reproduzieren möchte, muss den Parameter ausdrücklich auf max setzen. Für alltägliche Aufgaben reicht eine mittlere Stufe; die höchste Stufe bleibt den schwierigsten Aufgaben vorbehalten. Ausgabe-Token sind bei beiden Anbietern der teuerste Rechnungsposten ($1.20). Die gewählte Stufe entscheidet also direkt darüber, wofür das Geld ausgegeben wird.
LongCat 2.5 im Vergleich zu DeepSeek V4.1 Flash: Welches Modell für welche Aufgabe?
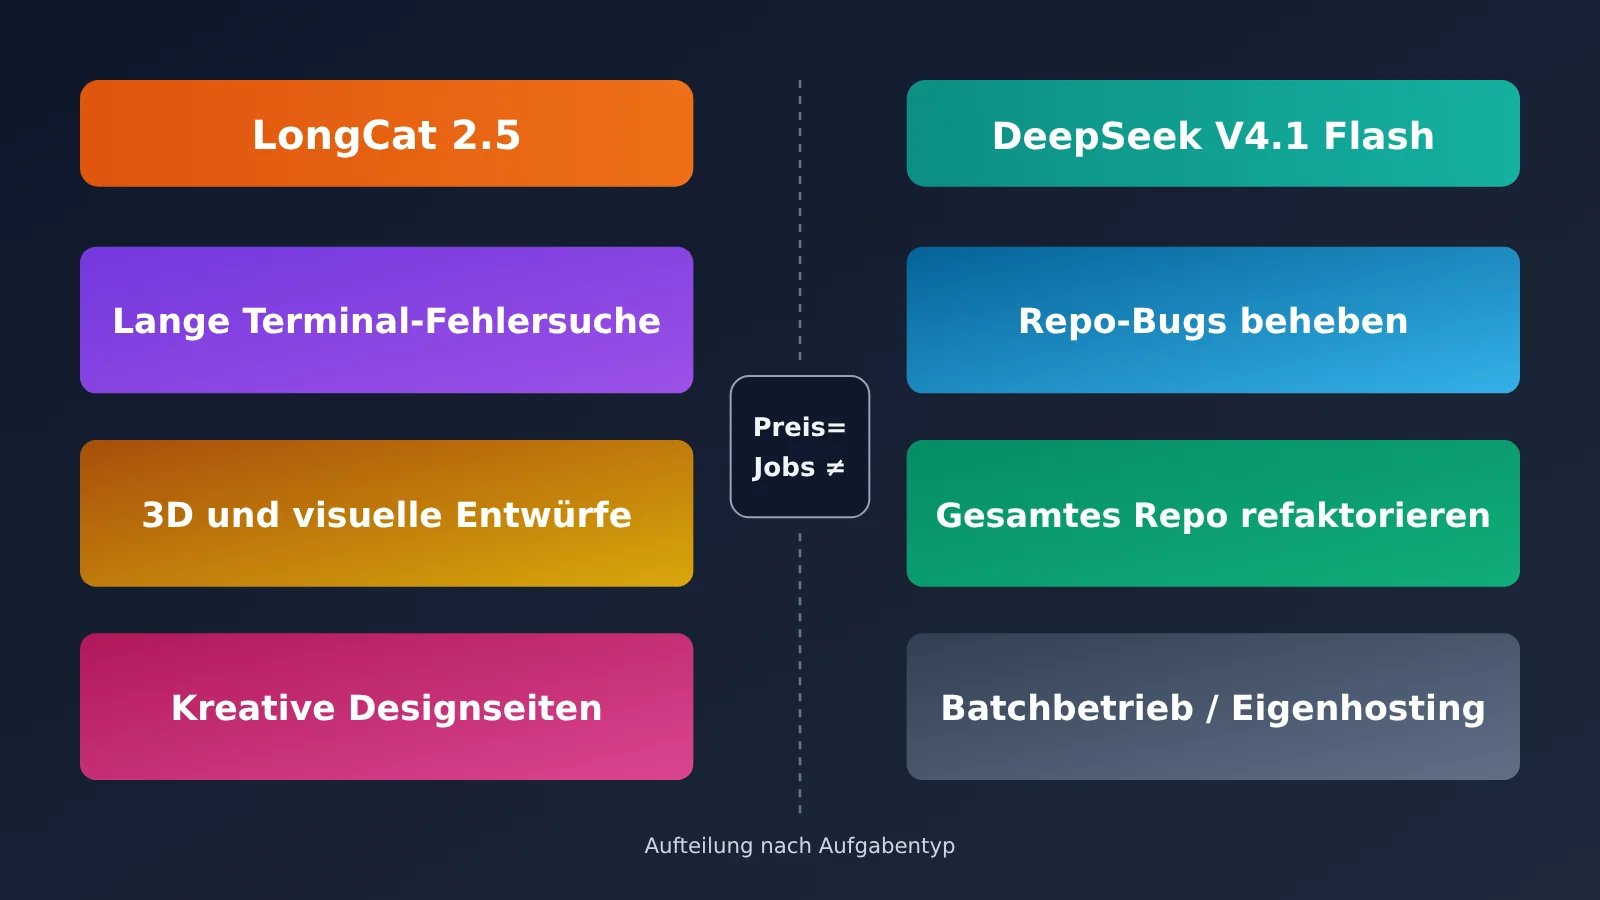
Das Fazit: gleicher Preis, unterschiedliche Stärken. Langlaufende Terminal-Aufgaben, visuelle und 3D-Arbeiten sowie kreative Designseiten sind bei LongCat 2.5 gut aufgehoben. Für Codeänderungen in echten Repositories, die Behebung von Softwarefehlern, automatisierte Pipelines und den Eigenbetrieb eignet sich DeepSeek V4.1 Flash besser.
| Besser geeignet für LongCat 2.5 | Besser geeignet für DeepSeek V4.1 Flash |
|---|---|
| Langlaufende Terminal-Fehlersuche: in mehreren Schritten am Server anmelden, Logs prüfen, Konfiguration ändern und den Neustart überprüfen (7,3 Punkte mehr bei Terminal Bench v4.0) | Bugs in echten Repositories beheben: Issue lesen, Datei finden, Änderungen vornehmen und Tests bestehen (9,6 Punkte mehr bei DeepSWE) |
| 3D-Assets und visuelle Entwürfe: 3D-Szenen aus Text erzeugen, interaktive Präsentationsseiten erstellen (3DCodeBench: 55,4) | Vollständige Repositories refaktorieren oder von Grund auf erstellen: Projekte mit mehreren Dateien anhand einer Anforderungsbeschreibung erzeugen (4,9 Punkte mehr bei NL2Repo) |
| Kreative Designseiten: Veranstaltungseinladungen, stilisierte Farbseiten und Datenvisualisierungsberichte (Beispiele aus offiziellen Demos) | Automatisierte Pipelines und Stapelverarbeitung: nächtliche Batch-Jobs, Datenbereinigung und Berichterstellung (3,0 Punkte mehr bei AutomationBench, halber Preis in Nebenzeiten) |
| Programmieraufgaben und berufsbezogene Aufgaben (führend bei Program Bench und JobBench) | Eigenbetrieb oder private Bereitstellung: Die Gewichte sind auf HuggingFace als Open Source verfügbar; lange Einzelausgaben bis 384K |
Gründe für LongCat 2.5
Die überzeugendsten Zahlen für LongCat 2.5 liefert Terminal Bench: Bei v2.1 lag es noch 2,2 Punkte zurück, bei v4.0 liegt es dagegen 7,3 Punkte vorn. Das deutet darauf hin, dass sein relativer Vorteil bei längeren und schwierigeren Aufgaben wächst. Dazu passt, dass beim Training viele lange Aufgabenverläufe verwendet und wiederholte Tool-Aufrufe mit einer Strafbewertung belegt wurden. Wenn dein Agent im Terminal häufig Dutzende Schritte hintereinander ausführen muss, solltest du LongCat 2.5 zuerst testen.
Ein zweiter Grund sind Aufgaben, die visuelle Verarbeitung und Generierung verbinden. Dank nativer Multimodalität und Trainingsschwerpunkten auf 3D und interaktiven Webseiten eignet sich das Modell besser für Aufgaben wie „Entwurf aus einem Bild“ oder „3D aus Text“. Neue Nutzer erhalten ausserdem 10 Millionen Token als Guthaben. Cache-Treffer werden nicht davon abgezogen, sodass sich das Modell kostengünstig testen lässt.
Gründe für DeepSeek V4.1 Flash
Die stärkste Kennzahl von DeepSeek V4.1 Flash ist der DeepSWE-Wert von 74,2 – hier ist der Abstand zwischen den beiden Modellen am grössten. Im Entwicklungsalltag geht es oft darum, Änderungen an einem bestehenden Repository vorzunehmen. Genau das ist eine Stärke des Modells. Seine maximale Ausgabelänge von 384K ist dreimal so hoch wie die von LongCat. Dadurch werden lange Dateien oder umfangreiche Patches seltener abgeschnitten.
Ein dritter Grund ist die Kostenstruktur. In Nebenzeiten gilt der halbe Preis, und zusätzlich lässt sich die Reasoning-Stufe anpassen. Zusammen bieten diese beiden Stellschrauben bei Batch-Aufgaben deutlich mehr Flexibilität als der feste, zeitlich begrenzte Preis von LongCat. Auch das Nebenläufigkeitslimit von 2.500 ist in der offiziellen Dokumentation angegeben und liefert damit eine klare Grundlage für die Durchsatzplanung. Teams, die eine private Bereitstellung benötigen, können die Modellgewichte direkt herunterladen. Laut offiziellen Angaben braucht eine Bereitstellung in grossem Massstab allerdings Ressourcen in der Grössenordnung von 2.000 GPUs. Kleine Teams sollten daher vor einem Self-Hosting ihren Hardwarebedarf prüfen.
💡 Empfehlung zur Auswahl: Eine Tabelle hilft nur dabei, die Auswahl einzugrenzen. Entscheidend sind deine eigenen Aufgaben. Wähle 10–20 repräsentative Aufgaben aus deinem Projekt, lass beide Modelle daran arbeiten und vergleiche Erfolgsquote und Token-Verbrauch. DeepSeek V4.1 Flash kannst du zunächst über APIYI apiyi.com anbinden und testen – so sparst du dir die separate Kontoeröffnung.
So bindest du LongCat 2.5 und DeepSeek V4.1 Flash ein
Das Wichtigste vorweg: Beide Anbieter unterstützen das OpenAI- und das Anthropic-Schnittstellenformat. Für Claude Code musst du nur einige Umgebungsvariablen in ~/.claude/settings.json ändern. DeepSeek unterstützt zusätzlich die Responses API.
LongCat 2.5 einbinden
- OpenAI-Format (beliebiges OpenAI SDK): Setze base_url auf
https://api.longcat.ai/openaiund den Modellnamen aufLongCat-2.5. - Anthropic-Format (Anthropic SDK): Setze base_url auf
https://api.longcat.ai/anthropic. - Claude Code (das env-Feld in
~/.claude/settings.jsonbearbeiten): Alle vier Variablen müssen gesetzt sein: ANTHROPIC_AUTH_TOKENauf deinen LongCat-Schlüssel setzenANTHROPIC_BASE_URLaufhttps://api.longcat.ai/anthropicsetzenANTHROPIC_MODELaufLongCat-2.5setzenCLAUDE_CODE_MAX_OUTPUT_TOKENSauf131072setzen- Umgang mit Rate-Limits (in deinem eigenen Aufrufcode): Bei Überschreitung wird 429 zurückgegeben (rate_limit_exceeded, retry_after 60). Der Anbieter empfiehlt exponentielles Backoff. RPM- und TPM-Werte sind in der Dokumentation nicht veröffentlicht; für 429-Antworten fallen keine Kosten an.
DeepSeek V4.1 Flash einbinden
- OpenAI-Format (beliebiges OpenAI SDK): Setze den Modellnamen auf
deepseek-flash. Die alten Namendeepseek-v4-flashunddeepseek-v4-flash-vision-expfunktionieren weiterhin. Anfragen werden an V4.1-Flash-1017 weitergeleitet und zum Flash-Preis abgerechnet. - Claude Code (das env-Feld in
~/.claude/settings.jsonbearbeiten): ANTHROPIC_AUTH_TOKENauf deinen DeepSeek-Schlüssel setzenANTHROPIC_BASE_URLaufhttps://api.deepseek.com/anthropicsetzenANTHROPIC_MODELaufdeepseek-flashsetzen- Reasoning-Stufe (Anfrageparameter im OpenAI SDK): Setze
reasoning_effortfür alltägliche Aufgaben auf die mittlere Stufe und für schwierige Aufgaben aufmax. - Fertige Tools: WorkBuddy (einschliesslich CodeBuddy) und OpenCode sind offizielle Partner-Tools und bereits vollständig integriert.
Einheitlicher Modellaufruf über APIYI
Wenn du mehrere Modelle gleichzeitig vergleichen möchtest, kannst du bei APIYI mit einem Konto und einem API-Schlüssel zwischen ihnen wechseln. Du musst nicht bei jedem Anbieter ein separates Konto eröffnen.
- OpenAI-SDK-Konfiguration (in deinem Projektcode): Setze base_url auf
https://api.apiyi.com/v1und api_key auf den in der APIYI-Konsole erzeugten API-Schlüssel. - Modellname (im selben Anfrageparameter wechseln): Verwende für DeepSeek V4.1 Flash
deepseek-v4.1-flashoderdeepseek-v4.1-flash-1017. Die Abrechnung erfolgt gemäss der Modellliste der Plattform. - Vergleichstests (mit demselben Code): Ändere nur den Parameter model, um dieselben Aufgaben parallel mit anderen Modellen auf der Plattform auszuführen. base_url bleibt
https://api.apiyi.com/v1.
Massgeblich für Modelle und Preise ist die Modellliste der Plattform. LongCat-2.5 ist bei APIYI derzeit noch nicht verfügbar, soll aber bald hinzukommen. Bis dahin kannst du LongCat 2.5 über den offiziellen Endpunkt nutzen und DeepSeek zentral über APIYI auf apiyi.com verwalten.
🚀 Schnellstart: Neue Nutzer erhalten bei der Registrierung auf APIYI apiyi.com ein kostenloses Testguthaben. Binde DeepSeek V4.1 Flash in dein bestehendes OpenAI-SDK-Projekt ein – dafür musst du nur die base_url ändern.
Häufige Fragen: LongCat 2.5 im Vergleich zu DeepSeek V4.1 Flash
F1: Sind die Preise der beiden Anbieter wirklich gleich?
Nur während der DeepSeek-Spitzenzeiten. Der zeitlich begrenzte Rabattpreis von LongCat 2.5 beträgt $0.30 / $0.006 / $1.20 und entspricht damit in jeder Position dem DeepSeek-Preis zu Spitzenzeiten. Außerhalb der Spitzenzeiten sind bei DeepSeek alle Preise halbiert. Das gilt für alle Zeiten außerhalb von werktags 09:00–12:00 und 14:00–18:00. Der LongCat-Preis ist zudem ein befristeter Rabattpreis und kann später angepasst werden.
F2: Zeigen die Benchmark-Ergebnisse, welches Modell stärker ist?
Eine direkte Rangfolge lässt sich daraus nicht ableiten. Beide Anbieter haben die Tests selbst durchgeführt, und Testumgebung, Datum und Inferenzstufe unterscheiden sich. Die DeepSeek-Ergebnisse stammen zudem aus der Max-Stufe. Am besten betrachtet man die Einzeltests mit grossen Abständen: Bei Terminal Bench v4.0 liegt LongCat 7,3 Punkte vorn, bei DeepSWE führt DeepSeek mit 9,6 Punkten. Ergebnisse mit einem Abstand von höchstens 1–2 Punkten kann man als gleichauf betrachten.
F3: Wann wird LongCat 2.5 als Open Source veröffentlicht?
Offiziell gibt es keinen Zeitplan. Auf GitHub und HuggingFace steht derzeit lediglich „Coming soon“; Modellgewichte wurden noch nicht veröffentlicht. Für Projekte, die das Modell selbst betreiben müssen, bleibt aktuell nur DeepSeek V4.1 Flash. Dessen Modellgewichte und technischer Bericht sind bereits öffentlich verfügbar.
F4: Kann ich über APIYI beide Modelle aufrufen?
Derzeit lässt sich nur DeepSeek V4.1 Flash aufrufen, unter den Modellbezeichnungen `deepseek-v4.1-flash` und `deepseek-v4.1-flash-1017`. Die Abrechnung erfolgt gemäss der Modellliste der Plattform. LongCat-2.5 ist bei APIYI noch nicht verfügbar, soll aber schnellstmöglich angeboten werden. Massgeblich für Modellbezeichnungen und Preise ist die Modellliste auf apiyi.com.
F5: Wie lassen sich die Kosten für Batch-Aufgaben senken?
Bei DeepSeek helfen zwei Stellschrauben: Erstens Aufgaben ausserhalb der Spitzenzeiten ausführen, um den Stückpreis zu halbieren. Zweitens `reasoning_effort` auf eine mittlere Stufe setzen. Laut Bericht erreichen die Stufen 60–80 bereits eine Genauigkeit nahe der Maximalstufe und benötigen weniger als die Hälfte von deren Token-Budget. Ein Cache-Treffer kostet nur 1/50 eines Cache-Misses. Wer feste Systemanweisungen und Tool-Definitionen an den Anfang der Anfrage stellt, kann die Trefferquote erhöhen.
Fazit: LongCat 2.5 oder DeepSeek V4.1 Flash – welches Modell passt?
Das Fazit ist klar: ähnlicher Preis, unterschiedliche Stärken. Wählen Sie nach Aufgabe und legen Sie Batch-Aufträge in die Nebenzeiten.
- Größe: LongCat hat 1,6 Billionen Parameter, davon sind 48 Milliarden aktiv. DeepSeek hat 552 Milliarden Parameter, davon sind bei der Eingabe 8 Milliarden und bei der Ausgabe 16 Milliarden aktiv. Beide bieten ein Kontextfenster von 1 Million Token.
- Maximale Ausgabe: LongCat erlaubt 128K, DeepSeek 384K. Für lange Ausgaben ist DeepSeek die bessere Wahl.
- Preis: Der zeitlich begrenzte LongCat-Preis entspricht dem DeepSeek-Preis zur Hauptzeit. In der Nebenzeit kostet DeepSeek die Hälfte: Im Rechenbeispiel stehen $0,2112 gegenüber $0,1056.
- Benchmarks: Bei längeren Terminal-Aufgaben liegt LongCat 7,3 Punkte vorn, beim Beheben von Fehlern in Code-Repositories DeepSeek 9,6 Punkte. In den meisten anderen Disziplinen liegen beide gleichauf.
- Open Source: DeepSeek ist bereits Open Source, LongCat hat seine Modellgewichte noch nicht veröffentlicht.
- Anbindung: Beide unterstützen die Formate von OpenAI und Anthropic. In Claude Code genügt es, die Umgebungsvariablen zu ändern, um zu wechseln.
Die Kurzfassung: Wählen Sie anhand der Aufgabenverteilung ein Modell für den Haupteinsatz und nutzen Sie das andere als Ergänzung. Batch-Aufträge sollten möglichst in der Nebenzeit laufen. DeepSeek V4.1 Flash lässt sich über APIYI (apiyi.com) zunächst im kleinen Maßstab über eine einheitliche Schnittstelle testen, bevor Sie sich für eine Hauptlösung entscheiden.
📚 Quellen
- Offizieller LongCat-2.5-Blog: Einordnung des Modells, Architektur, Training und technische Details
- Link:
longcat.ai/blog/longcat-2.5 -
Inhalt: Parameterumfang, visuelles Token-Konzept, W4A4-Inferenzdaten und offizielle Benchmark-Tabelle
-
Dokumentation der offenen LongCat-Plattform: Preise, Endpunkte und Anbindung an Claude Code
- Link:
longcat.ai/platform/docs -
Inhalt: Zeitlich begrenzte Rabatte, Umgang mit 429-Fehlern, Kontingentpakete und Regeln für Gratisguthaben
-
Ankündigung von DeepSeek V4.1 Flash: Architektur, Open Source und API-Änderungen
- Link:
deepseek.com/news/deepseek-v4-1-flash -
Inhalt: Asymmetrisches MoE, KV-Cache-Komprimierung und Hinweise zur Migration des Modellnamens
-
DeepSeek-API-Preisseite: Preise für Spitzen- und Nebenzeiten sowie Parallelitätslimits
- Link:
api-docs.deepseek.com/quick_start/pricing -
Inhalt: Definition der Spitzen- und Nebenzeiten, 2.500 gleichzeitige Anfragen und separate Abrechnung für Suche und Abruf
-
Repository der DeepSeek-V4.1-Flash-Modellgewichte: Open-Source-Gewichte und technischer Bericht
- Link:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - Inhalt: Benchmark-Ergebnisse in Tabelle 3 und Analyse der Inferenzstufen in Abschnitt 5.3.3
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Startseite apiyi.com. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.