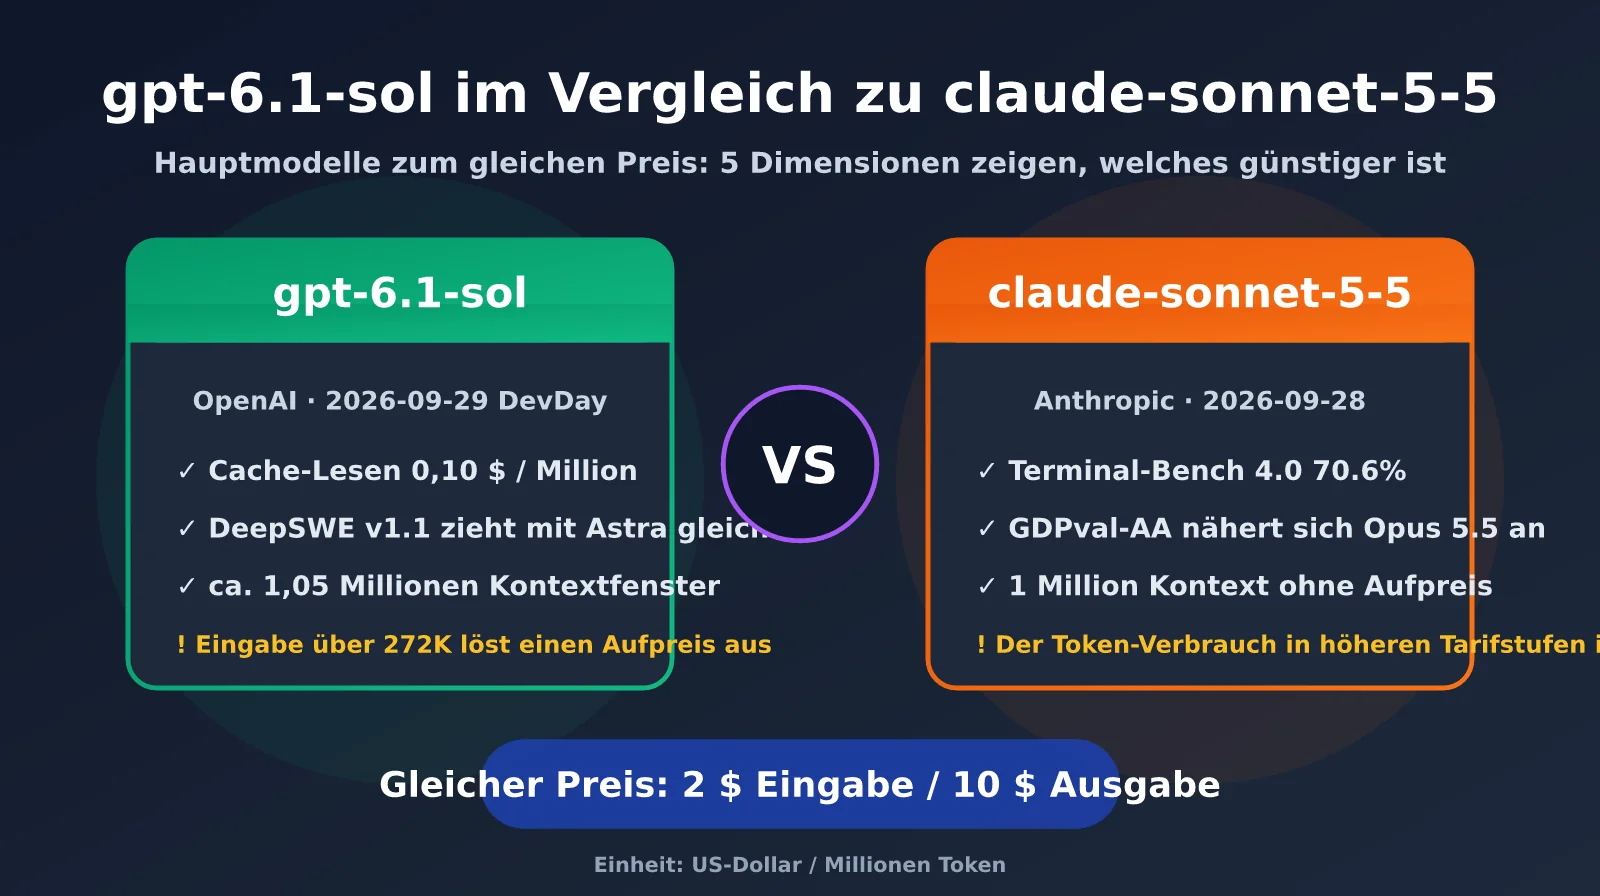
Am 28. September veröffentlichte Anthropic claude-sonnet-5-5, einen Tag später stellte OpenAI auf der DevDay gpt-6.1-sol vor. Die neuen Kernmodelle beider Anbieter gingen nahezu gleichzeitig an den Start – und tragen exakt denselben Preis: 2 $ für Eingabe- und 10 $ für Ausgabe-Token pro einer Million Token. Viele Entwickler denken zunächst: „Beide sind günstiger, also kann ich beliebig eines auswählen.“ Doch im produktiven Einsatz sind die Unterschiede bei Kosten pro Aufgabe, Abrechnung langer Kontexte und Agentenleistung deutlich größer, als es die Preistabelle vermuten lässt. Dieser Artikel analysiert die tatsächlichen Unterschiede zwischen gpt-6.1-sol und claude-sonnet-5-5 anhand von fünf Dimensionen. So treffen Sie je nach Einsatzszenario eine rationale Wahl – statt sich von Markenpräferenzen oder der Verfügbarkeit eines Kontos leiten zu lassen.
Kernnutzen: Nach diesem Artikel wissen Sie genau, wann Sie bei Programmieragenten, Office-Dokumenten, der Suche in langen Kontexten und Batch-Verarbeitung mit hoher Parallelität gpt-6.1-sol oder claude-sonnet-5-5 wählen und wie Sie beide kombinieren sollten.
Die wichtigsten Parameter von gpt-6.1-sol und claude-sonnet-5-5 im Überblick
Zunächst ein häufiges Missverständnis: Streng genommen wurden die Listenpreise beider Modelle nicht gesenkt. claude-sonnet-5-5 übernimmt die Preisstruktur von Sonnet 5 mit 2 $/10 $, und auch gpt-6.1-sol kostet auf Listenpreisbasis genauso viel wie sein Vorgänger gpt-6-sol. Die vermeintliche „Preissenkung“ zeigt sich auf zwei Ebenen: Erstens sind Fähigkeiten auf Flaggschiffniveau nun zum Preis der Kernmodelle verfügbar. gpt-6.1-sol kostet nur ein Fünftel von gpt-6-astra, claude-sonnet-5-5 nur die Hälfte von Opus 5.5. Zweitens sinken die indirekten Kosten: Bei gpt-6.1-sol wurde der Preis für Cache-Eingaben von 0,20 $ auf 0,10 $ halbiert; claude-sonnet-5-5 kann durch weniger Tool-Aufrufe die Kosten pro Aufgabe um bis zu rund 30 % senken.
| Parameter | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| Veröffentlichungsdatum | 29.09.2026 (DevDay) | 28.09.2026 |
| Modell-ID | gpt-6.1-sol |
claude-sonnet-5-5 |
| Kontextfenster | ca. 1,05 Mio. Token | 1 Mio. Token |
| Maximale Ausgabe | 128K | 128K (in der Batch-Betaversion bis zu 300K) |
| Reasoning-Stufen | low / medium (Standard) / high / xhigh / max | low / medium / high (API-Standard) / xhigh / max |
| Denkmodus | Je nach Stufe steuerbar | Adaptives Reasoning, nicht deaktivierbar |
| Flaggschiffmodell derselben Familie | gpt-6-astra (10 $/50 $) | Claude Opus 5.5 (4 $/20 $) |
| Verfügbare Plattformen | APIYI apiyi.com, offizielle OpenAI-API | APIYI apiyi.com, offizielle Anthropic-API |
Die Tabelle zeigt einen entscheidenden Unterschied: Die standardmäßige Reasoning-Stufe ist nicht gleich. gpt-6.1-sol verwendet standardmäßig medium, während die API von claude-sonnet-5-5 standardmäßig high nutzt. Wenn Sie beide Modelle direkt mit den Standardeinstellungen vergleichen, darf Sonnet effektiv eine Stufe mehr „nachdenken“. Token-Verbrauch und Latenz starten dann zwangsläufig nicht unter denselben Bedingungen. Für einen fairen Vergleich sollten Sie auf beiden Seiten reasoning_effort ausdrücklich festlegen.
🎯 Testempfehlung: Verwenden Sie beim Vergleich beider Modelle unbedingt dieselbe Reasoning-Stufe und dieselbe Eingabeaufforderung. Über APIYI apiyi.com können Sie mit einem einzigen API-Schlüssel gleichzeitig gpt-6.1-sol und claude-sonnet-5-5 aufrufen. Für einen A/B-Test müssen Sie lediglich den Parameter
modeländern – so vermeiden Sie Störfaktoren durch unterschiedliche Konten oder Netzwerkbedingungen.
5 zentrale Unterschiede zwischen gpt-6.1-sol und claude-sonnet-5-5
Unterschied 1: Bei Coding-Agenten führt claude-sonnet-5-5 bei terminalbasierten Aufgaben
Programmierung ist das umkämpfteste Feld für beide Modelle. Die veröffentlichten Benchmarks überschneiden sich jedoch nicht vollständig und sollten daher getrennt betrachtet werden. claude-sonnet-5-5 erreicht im Terminal-Bench 4.0 offiziell 70,6 % – ein massiver Sprung gegenüber den 10,3 % von Sonnet 5. Damit übertrifft es sogar Opus 5.5 mit 66,4 %. Eine unabhängige Nachmessung von Artificial Analysis kommt auf 64 %, ebenfalls mehr als bei Opus 5.5 und gpt-6-astra mit jeweils 60 %. Im SWE-Bench Pro erzielt das Modell 81,3 %, im CursorBench 4.0 55,5 % und liegt damit nur hinter Opus 5.5.
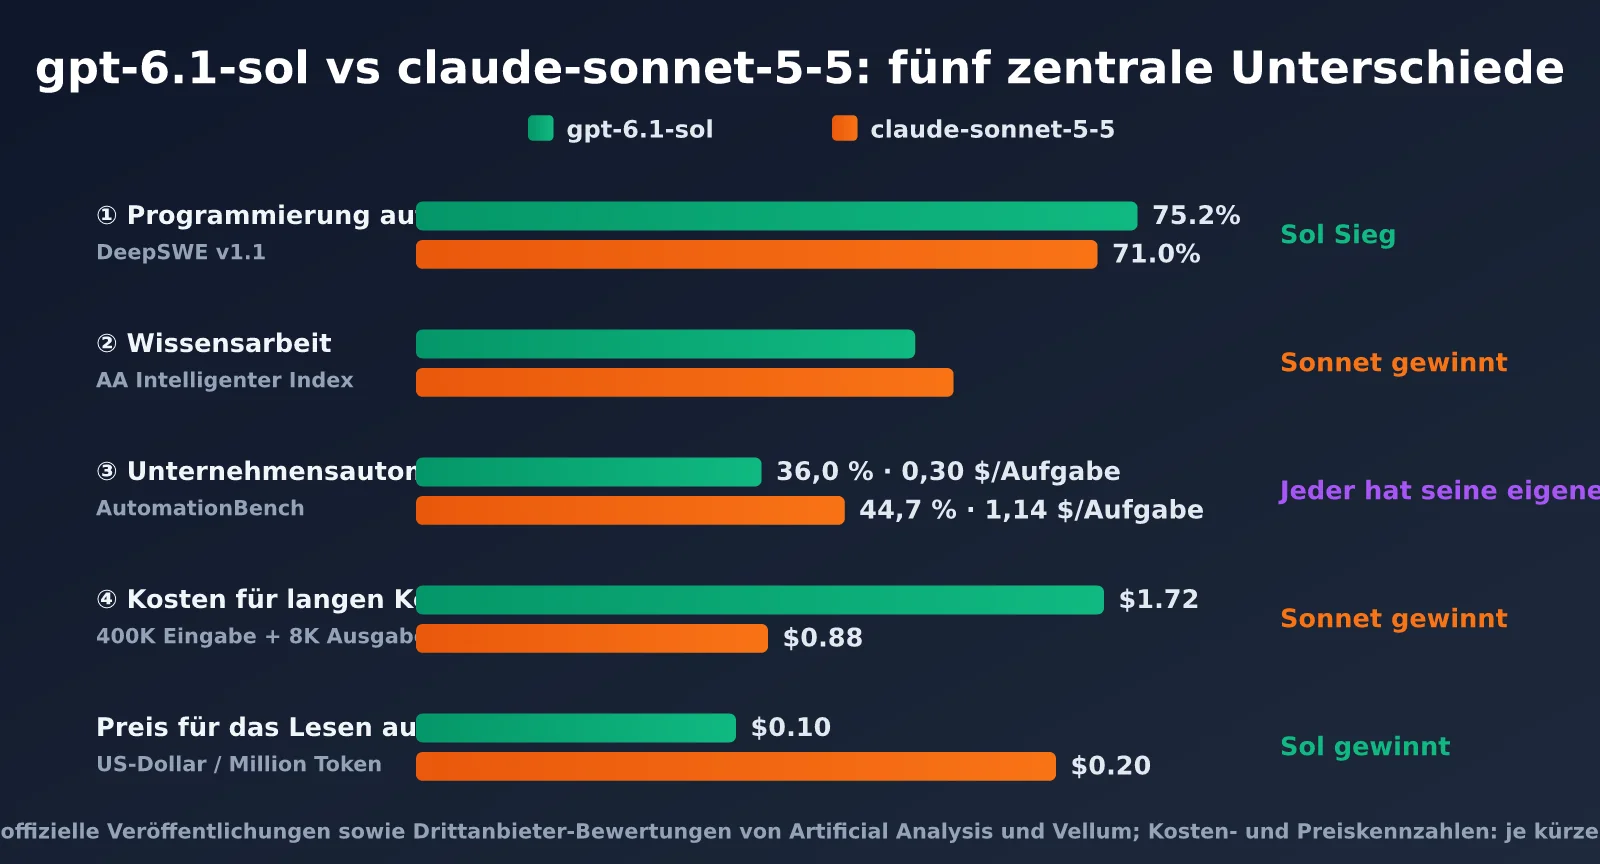
Bei gpt-6.1-sol stellt OpenAI vor allem DeepSWE v1.1 heraus: gpt-6.1-sol erreicht 75,2 % und liegt damit knapp über gpt-6-astra mit 74,8 %. Gleichzeitig kostet jede Aufgabe nur etwa 1,50 US-Dollar – weniger als ein Fünftel der Astra-Kosten. In Zusammenstellungen von Drittanbietern kommt claude-sonnet-5-5 in diesem Benchmark auf 71,0 %. Anders gesagt: Für terminalgesteuerte agentische Programmierung ist die Evidenz für claude-sonnet-5-5 stärker, bei Software-Engineering-Aufgaben auf Repository-Ebene bietet gpt-6.1-sol das bessere Preis-Leistungs-Verhältnis.
Unterschied 2: Bei Wissensarbeit nähert sich claude-sonnet-5-5 Opus an
Bei Büro- und Wissensarbeit liefert claude-sonnet-5-5 besonders überzeugende Ergebnisse. Im GDPval-AA v2.1 erreicht es 1844 Punkte und liegt damit praktisch gleichauf mit Opus 5.5 mit 1846 Punkten. Im AA-Briefcase erzielt es 1811 Punkte und bleibt ebenfalls dicht an Opus. Im Artificial-Analysis-Intelligenzindex belegt claude-sonnet-5-5 mit 56 Punkten den zweiten Platz, nur 2 Punkte hinter Opus 5.5. gpt-6.1-sol (max) kommt auf 52 Punkte.
gpt-6.1-sol hat dagegen eigene Stärken bei der Dokumentenanalyse. Im GDP.pdf-Benchmark erreicht es 32,0 % und liegt damit fast auf dem Niveau von gpt-6-astra mit 32,2 %, aber vor Opus 5.5 mit 28,8 %. Die Kosten pro Aufgabe betragen etwa 0,38 US-Dollar. Beim AutomationBench für die Automatisierung von Unternehmensprozessen führt claude-sonnet-5-5 mit 44,7 % gegenüber 36,0 % für gpt-6.1-sol. Allerdings kostet eine Aufgabe beim ersten Modell etwa 1,14 US-Dollar, beim zweiten lediglich 0,30 US-Dollar.
Unterschied 3: Computerbedienung – beide Modelle sind praxistauglich
Bei der Computerbedienung (Computer Use) erreicht gpt-6.1-sol im OSWorld 2.0 71,4 %. Damit liegt es nur 2,1 Prozentpunkte hinter gpt-6-astra mit 73,5 %. Pro Aufgabe fallen rund 1,30 US-Dollar an. claude-sonnet-5-5 erzielt im OSWorld 2.1 80,1 % und nähert sich damit Opus 5.5 mit 81,8 % an.
Wichtig: Die Testdatensätze der beiden OSWorld-Versionen unterscheiden sich, daher lassen sich die Werte nicht direkt vergleichen. Klar ist jedoch, dass beide Modelle inzwischen Desktop-Anwendungen zuverlässig bedienen können.
Unterschied 4: Langkontext-Abrechnung – gpt-6.1-sol hat eine versteckte Schwelle
Dieser Punkt wird leicht übersehen, kann aber die Rechnung deutlich beeinflussen. gpt-6.1-sol unterstützt zwar ein Kontextfenster von etwa 1,05 Millionen Token, doch sobald die Eingabe einer einzelnen Anfrage 272.000 Token überschreitet, werden Eingabe und Cache für die gesamte Anfrage zum doppelten Preis und die Ausgabe zum 1,5-fachen Preis abgerechnet.
Das Kontextfenster von einer Million Token bei claude-sonnet-5-5 hat dagegen keinen Langkontext-Aufschlag: Es gilt durchgehend der Standardpreis. Wenn Ihr Anwendungsfall regelmäßig ganze Handbücher oder vollständige Code-Repositories in den Kontext lädt, kann dieser Unterschied die Modellauswahl entscheidend verändern.
Unterschied 5: Token-Effizienz und Caching – gpt-6.1-sol ist sparsamer
Der Preis für Cache-Lesezugriffe bei gpt-6.1-sol beträgt 0,10 US-Dollar und ist damit nur halb so hoch wie bei claude-sonnet-5-5 mit 0,20 US-Dollar. Das ist besonders vorteilhaft bei Agentenschleifen, in denen Präfixe häufig wiederholt werden.
Andererseits ist der Token-Verbrauch von claude-sonnet-5-5 bei hohen Reasoning-Stufen vergleichsweise groß: Artificial Analysis hat für die Stufe „max“ durchschnittlich rund 193.000 ausgegebene Token pro Aufgabe gemessen – der bisher höchste gemessene Wert. Unabhängige Tests zeigen zudem, dass die API-Standardstufe „high“ gegenüber „medium“ fast doppelt so viele Ausgabe-Token verbraucht, ohne dass sich die Qualität spürbar verbessert.
| Benchmark / Kennzahl | gpt-6.1-sol | claude-sonnet-5-5 | Gewinner |
|---|---|---|---|
| Terminal-Bench 4.0 (offiziell) | Nicht veröffentlicht | 70,6 % | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75,2 % | 71,0 % | gpt-6.1-sol |
| GDPval-AA v2.1 | Nicht veröffentlicht (Vorgänger gpt-6-sol: 1487) | 1844 | claude-sonnet-5-5 |
| GDP.pdf-Dokumentenanalyse | 32,0 % | Nicht veröffentlicht | gpt-6.1-sol |
| AutomationBench | 36,0 % (ca. 0,30 US-Dollar/Aufgabe) | 44,7 % (ca. 1,14 US-Dollar/Aufgabe) | Qualität: Sonnet, Kosten: Sol |
| AA-Intelligenzindex | 52 | 56 | claude-sonnet-5-5 |
| Preis für Cache-Lesezugriffe | 0,10 US-Dollar / Million | 0,20 US-Dollar / Million | gpt-6.1-sol |
💡 Hinweis zu den Daten: Die Benchmarks stammen aus offiziellen Veröffentlichungen von OpenAI und Anthropic sowie aus Bewertungen von Drittanbietern wie Artificial Analysis und Vellum. Testversionen und Reasoning-Stufen unterscheiden sich je nach Anbieter. Am aussagekräftigsten ist deshalb ein Vergleichstest mit Ihren eigenen realen Arbeitsproben.
Realer Kostenvergleich: gpt-6.1-sol vs. claude-sonnet-5-5
Gleiche Listenpreise bedeuten nicht automatisch gleiche Rechnungen. Die folgenden drei typischen Lastszenarien schätzen die Kosten pro Anfrage (ohne Cache-Schreibvorgänge, auf Basis der offiziellen Listenpreise). So wird direkt sichtbar, woher die Unterschiede kommen.
| Lastszenario | Zusammensetzung der Anfrage | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| Agenten-Schleife (hoher Cache-Anteil) | 100K Input (90 % Cache-Treffer) + 5K Output | ca. 0,079 $ | ca. 0,088 $ |
| Regulärer Chat | 5K Input + 1K Output | ca. 0,020 $ | ca. 0,020 $ |
| Abruf mit extrem langem Kontext | 400K Input (ohne Cache) + 8K Output | ca. 1,72 $ (Preisaufschlag) | ca. 0,88 $ |
| Stapelverarbeitung (Batch) | 50 % des Listenpreises | 1 $ / 5 $ | 1 $ / 5 $ |
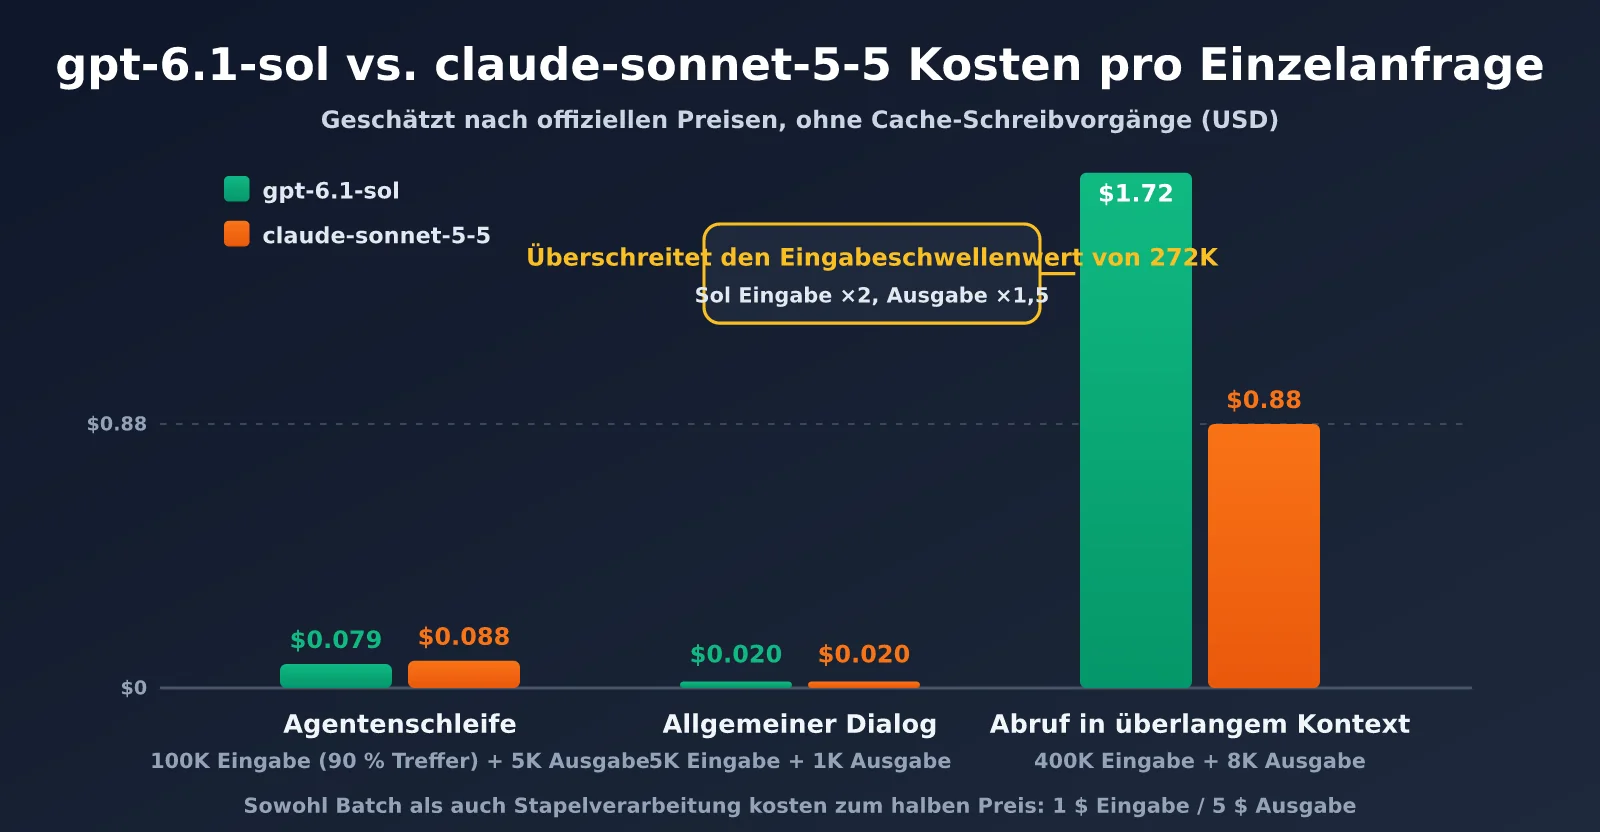
Das Fazit ist klar: In Agenten-Schleifen mit stark wiederholten Präfixen liegt gpt-6.1-sol dank günstigerer Cache-Lesezugriffe um rund 10 % vorn. Bei regulären Chats sind beide nahezu gleich teuer. Sobald ein einzelner Input 272K Token übersteigt, kostet claude-sonnet-5-5 nur etwa die Hälfte von gpt-6.1-sol.
Hinzu kommt die Token-Effizienz: Läuft claude-sonnet-5-5 mit der Stufe high oder max, kann sich die tatsächliche Anzahl der Output-Token verdoppeln. Das kann seinen Kostenvorteil bei langen Kontexten wieder aufzehren. Die Reasoning-Stufe gezielt zu begrenzen, ist daher entscheidend für den effizienten Einsatz von Sonnet.
Beide Modelle schnell mit demselben Code vergleichen
Über eine OpenAI-kompatible Schnittstelle genügt es, den Parameter model umzuschalten, um beide Modelle direkt gegeneinander zu testen. Hier ein minimalistisches Beispiel:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle, beide Modelle verwenden denselben Key
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # Dieselbe Stufe festlegen, um einen fairen Vergleich sicherzustellen
        messages=[{"role": "user", "content": "Ergänze Unit-Tests für diese Funktion:def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
Aufklappen: vollständiges Vergleichsskript mit Laufzeit- und Kostenstatistik
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

# Preise pro einer Million Token: Input, Cache-Lesezugriffe, Output
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "Implementiere in Python einen LRU-Cache mit Ablaufzeit und schreibe Tests dafür",
    "Lies die folgenden Anforderungen und erstelle ein Datenbankschema samt Indexempfehlungen: Bestellungen, Nutzer, Gutscheine",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 Schnellstart: Falls Sie noch kein Anthropic-Konto haben oder an ausländischen Zahlungsmethoden beziehungsweise der Telefonnummernverifizierung scheitern, können Sie sich direkt bei APIYI unter apiyi.com registrieren und Testguthaben erhalten. Mit einem einzigen Key lassen sich gpt-6.1-sol und claude-sonnet-5-5 aufrufen – ohne separate offizielle Konten bei beiden Anbietern einrichten zu müssen.
Szenarioempfehlungen für gpt-6.1-sol und claude-sonnet-5-5
Die Gewichtung von Qualität, Kosten und Latenz unterscheidet sich je nach Anwendungsfall. Im Folgenden finden Sie Empfehlungen für typische Szenarien.
| Geschäftsszenario | Empfohlenes Modell | Hauptgrund |
|---|---|---|
| Terminalgestützte Programmieragenten (ähnlich Claude Code) | claude-sonnet-5-5 | Führend bei Terminal-Bench 4.0, benötigt weniger Tool-Aufrufe |
| Code-Reparaturen auf Repository-Ebene, Codex-Workflows | gpt-6.1-sol | Gleichauf mit Astra bei DeepSWE, Kosten pro Aufgabe bei rund 1,50 $ |
| Analyse sehr langer Dokumente / ganzer Codebasen (>272 K) | claude-sonnet-5-5 | Kein Aufpreis für lange Kontexte, Kosten bei etwa der Hälfte von Sol |
| Kundenservice mit hoher Parallelität, RAG-Frage-Antwort-Systeme (hoher Cache-Anteil) | gpt-6.1-sol | Cache-Lesezugriffe kosten 0,10 $, und je stärker Präfixe wiederverwendet werden, desto günstiger wird es |
| Berichtserstellung, Tabellen und wissensbasierte Büroarbeit | claude-sonnet-5-5 | Bei GDPval-AA nahezu gleichauf mit Opus 5.5 |
| PDF-Dokumentenanalyse und Informationsextraktion | gpt-6.1-sol | Gleichauf mit Astra bei GDP.pdf, etwa 0,38 $ pro Aufgabe |
| Sicherheitsforschung und Unterstützung bei Penetrationstests | gpt-6.1-sol | Sonnet 5.5 verfügt über integrierte Cybersicherheits-Schutzmechanismen, wodurch die Ablehnungsrate steigt |
Typische Einsatzszenarien für gpt-6.1-sol
gpt-6.1-sol eignet sich besonders für Anwendungen, die kostensensitiv sind, ein hohes Anfragevolumen haben und viele wiederkehrende Präfixe nutzen. Dazu gehören etwa intelligente Kundenservices, Frage-Antwort-Systeme für Wissensdatenbanken und die Stapelverarbeitung zur Datenbereinigung. Wenn System-Eingabeaufforderungen und abgerufene Kontexte stark wiederverwendet werden, vergrößert der Preis von 0,10 $ für Cache-Lesezugriffe den Kostenvorteil kontinuierlich.
Auch die Halluzinationsrate wurde deutlich verbessert: Bei niedriger Reasoning-Stufe sank die Rate faktischer Fehler von 11,4 % in der Vorgängergeneration auf 7,7 %. Damit eignet sich das Modell gut, um große Mengen leichter Aufgaben mit der Stufe low oder medium zu verarbeiten. Darüber hinaus wird OpenAI für gpt-6.1-sol voraussichtlich eine Ultrafast-Stufe einführen: mit einer Generierungsgeschwindigkeit von bis zu rund 300 Token pro Sekunde und einem Preis, der dem Sechsfachen der Standardstufe entspricht. Für Produkte mit Echtzeitinteraktion kann das eine sinnvolle Option sein.
Typische Einsatzszenarien für claude-sonnet-5-5
claude-sonnet-5-5 ist besser geeignet für Anwendungen mit komplexen Aufgaben, extrem langen Kontexten und hohen Anforderungen an die Erfolgsquote beim ersten Versuch. Bei Agentenaufgaben reichen typischerweise etwa drei Tool-Aufrufe aus, um Arbeiten zu erledigen, für die Sonnet 5 noch 12 bis 13 Aufrufe benötigt. Auch die Ausgabegeschwindigkeit liegt mehr als 30 % über der Vorgängergeneration.
Für juristische Prüfungen, Migrationen von Codebasen oder das Schreiben langer Berichte, bei denen umfangreiche Materialien auf einmal in den Kontext geladen werden müssen, ist das Kontextfenster von einer Million Token ohne Aufpreis besonders attraktiv.
Beachten Sie jedoch, dass claude-sonnet-5-5 gegenüber Sonnet 5 einige Breaking Changes in der Schnittstelle enthält: Der Denkmodus lässt sich nicht mehr deaktivieren, und die erzwungene Tool-Auswahl über tool_choice: "tool" wurde entfernt. Wenn Ihr bestehender Code von diesem Verhalten abhängt, sollten Sie vor der Migration unbedingt Regressionstests durchführen.
🎯 Architektur-Empfehlung: Die beiden Modelle schließen sich nicht gegenseitig aus. Wir empfehlen, über APIYI apiyi.com ein einfaches Modellrouting einzurichten: Kurze Anfragen und Traffic mit hohem Cache-Anteil gehen an gpt-6.1-sol, extrem lange Kontexte und komplexe Programmieraufgaben an claude-sonnet-5-5. Über dieselbe OpenAI-kompatible Schnittstelle können Sie dann je nach Bedarf wechseln.
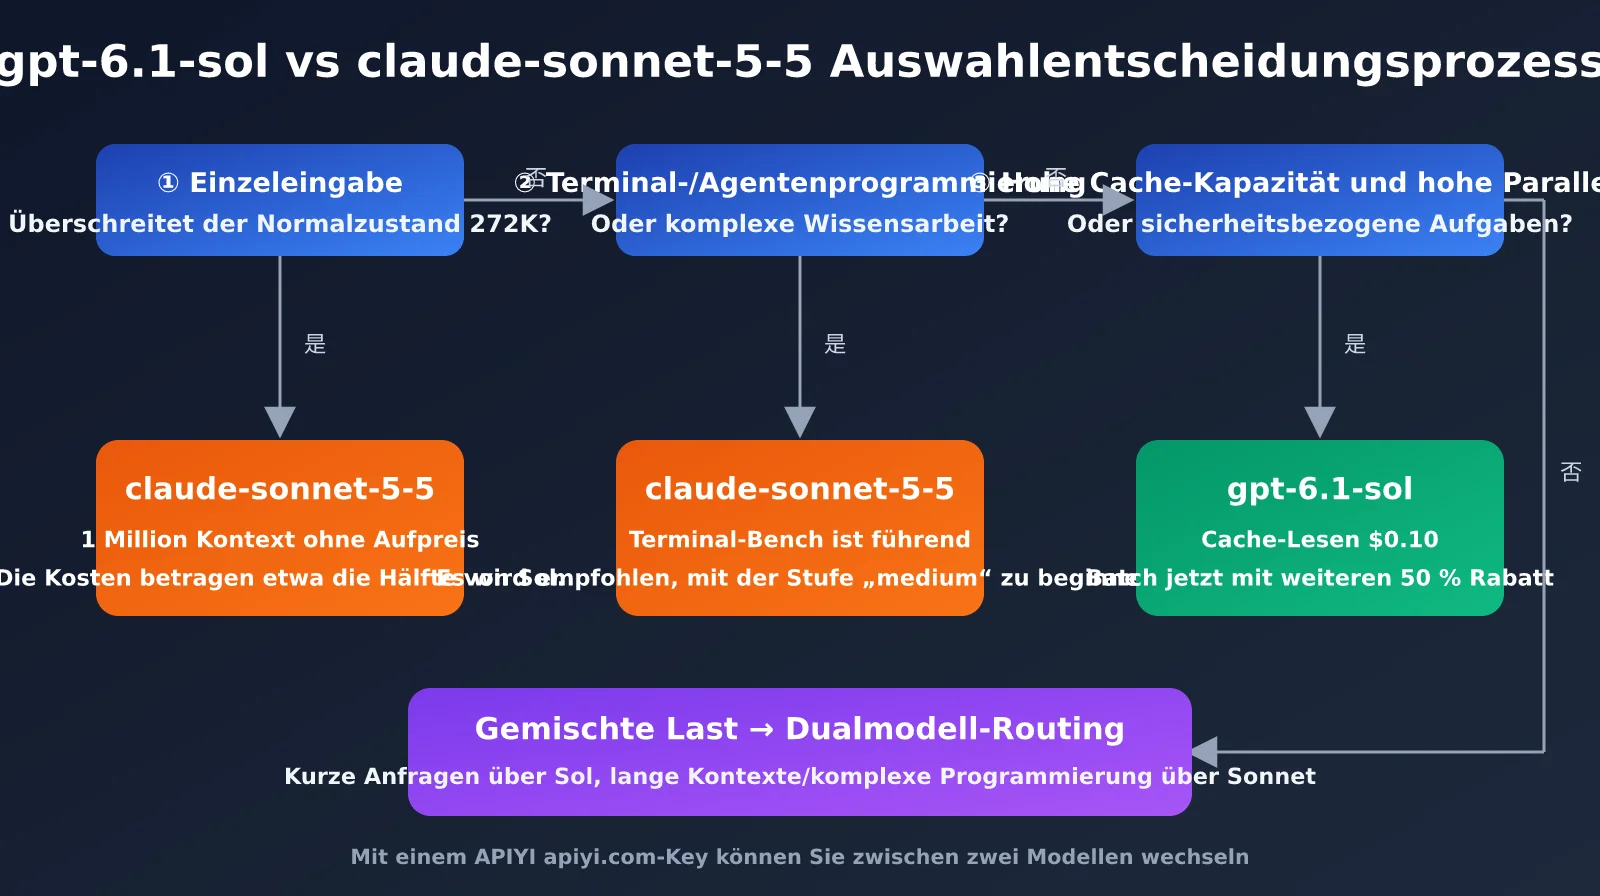
Entscheidungsempfehlung: gpt-6.1-sol im Vergleich zu claude-sonnet-5-5
Die vorherige Analyse lässt sich zu einem umsetzbaren Entscheidungsprozess verdichten:
- Zuerst die Eingabelänge prüfen: Wenn typische Anfragen mehr als 272K Token umfassen, hat claude-sonnet-5-5 Vorrang. Andernfalls weiter zum nächsten Schritt.
- Dann den Aufgabentyp bewerten: Für Terminal-/Agentenprogrammierung und komplexe Wissensarbeit eignet sich eher claude-sonnet-5-5; für repositoryweite Code-Reparaturen und PDF-Parsing eher gpt-6.1-sol.
- Anschließend die Traffic-Struktur betrachten: Bei hoher Cache-Trefferquote und großer Parallelität wächst der Kostenvorteil von gpt-6.1-sol mit dem Volumen.
- Zum Schluss die Reasoning-Stufe optimieren: Unabhängig vom gewählten Modell sollten Tests mit medium beginnen. Bei claude-sonnet-5-5 sollte insbesondere die API-Standardstufe high nicht direkt verwendet werden, da sich der Token-Verbrauch sonst möglicherweise verdoppelt.
| Deine Priorität | Erste Wahl | Alternative Strategie |
|---|---|---|
| Qualität hat Priorität, Budget ist ausreichend | claude-sonnet-5-5 (medium/high) | Schwierige Aufgaben bei Bedarf auf Opus 5.5 hochstufen |
| Kosten haben Priorität, sehr hohes Anfragevolumen | gpt-6.1-sol (low/medium) | Nicht zeitkritische Aufgaben über Batch mit 50 % Rabatt ausführen |
| Geschwindigkeit hat Priorität, Echtzeitinteraktion | gpt-6.1-sol (nach Verfügbarkeit von Ultrafast) | claude-sonnet-5-5 mit Stufe low |
| Stabilität hat Priorität, kein Single Point of Failure | Routing über beide Modelle | Bei Rate Limits eines Anbieters automatisch zum anderen wechseln |
Markenpräferenzen und Verfügbarkeit sollten hingegen keine entscheidenden Faktoren bei der technischen Auswahl sein. Offizielle Claude-Konten stellen höhere Anforderungen an Region, Zahlungsmethode und andere Voraussetzungen. Das erhöht zwar die Einstiegshürde, ist aber ein Problem der Integrationsebene und nicht der Modellfähigkeit. Wenn die Integration über eine einheitliche API-Plattform abgewickelt wird, kann die Auswahl vollständig nach Aufgabenleistung und Kosten erfolgen.
Häufige Fragen
Q1: Sind gpt-6.1-sol und claude-sonnet-5-5 wirklich beide günstiger geworden?
An den Listenpreisen hat sich nichts geändert: Beide bleiben bei $2/$10. Die tatsächliche „Preissenkung“ besteht darin, dass gpt-6.1-sol für ein Fünftel des Preises eine Leistung nahe gpt-6-astra bietet und das Lesen aus dem Cache von $0.20 auf $0.10 gesunken ist. claude-sonnet-5-5 bietet wiederum zu halben Opus-Kosten eine Leistung nahe Opus 5.5 und kann durch weniger Tool-Aufrufe die Kosten pro Aufgabe um bis zu etwa 30 % senken. Beim Vergleich sollte deshalb nicht der Stückpreis, sondern der Gesamtpreis pro Aufgabe ausschlaggebend sein.
Q2: Wie kann ich claude-sonnet-5-5 ohne Anthropic-Konto aufrufen?
Für offizielle Anthropic-Konten gelten Anforderungen an Registrierungsregion, Telefonnummer und Zahlungsmethode. Gerade Einzelentwickler und Teams in China scheitern häufig bereits an diesem Schritt. Eine einfache Lösung ist der Aufruf über APIYI apiyi.com. Die Plattform bietet eine OpenAI-kompatible Schnittstelle: Ändern Sie base_url in https://api.apiyi.com/v1 und setzen Sie model auf claude-sonnet-5-5. Weitere Änderungen am bestehenden Anwendungscode sind nicht nötig.
Q3: Kann ich die 1,05 Millionen Token Kontext von gpt-6.1-sol bedenkenlos vollständig ausnutzen?
Ja, allerdings sollte die Abrechnung beachtet werden. Überschreitet eine einzelne Eingabe 272K Token, verdoppeln sich die Preise für Eingabe und Cache, während der Ausgabepreis um das 1,5-Fache steigt. Falls das Geschäftsszenario tatsächlich extrem lange Kontexte erfordert, empfiehlt sich zunächst eine Komprimierung per Retrieval. Alternativ können diese Anfragen an claude-sonnet-5-5 geroutet werden, das keinen Aufpreis für lange Kontexte berechnet.
Q4: Warum ist claude-sonnet-5-5 manchmal teurer als erwartet?
Der Hauptgrund ist die Reasoning-Stufe. Die API verwendet standardmäßig high, während sich der Denkmodus nicht deaktivieren lässt. Bei einfachen Aufgaben können dadurch viele unnötige Thinking-Token entstehen. Unabhängige Tests zeigen, dass die Token-Nutzung bei medium auf dem Niveau von Sonnet 5 liegt, die Ergebnisse jedoch besser sind. Für alltägliche Aufgaben sollte daher medium explizit eingestellt werden.
Q5: Welches Modell sollte ich für Programmieraufgaben wählen?
Wenn Sie überwiegend Terminal-basierte Agenten wie Claude Code für mehrstufige Entwicklungsaufgaben nutzen, sind die Terminal-Bench-Ergebnisse von claude-sonnet-5-5 überzeugender. Liegt der Schwerpunkt auf repositoryweiten Fehlerbehebungen oder Codex-Workflows, erreicht gpt-6.1-sol gpt-6-astra bei niedrigeren Kosten pro Aufgabe. Falls die Teamvoraussetzungen es erlauben, ist die stabilste Lösung, beide Modelle anzubinden und Anfragen je nach Aufgabentyp zu verteilen.
Fazit
Im Vergleich zwischen gpt-6.1-sol und claude-sonnet-5-5 gibt es keinen eindeutigen Sieger. claude-sonnet-5-5 ist stärker bei agentischem Programmieren, Wissensarbeit und im Intelligence Index und bietet ein Kontextfenster von 1 Million Tokens ohne Aufpreis. gpt-6.1-sol punktet dagegen bei Cache-Preisen, repositoryweiten Code-Reparaturen, Dokumentenverarbeitung und den Kosten einzelner Aufgaben. Damit eignet es sich besonders für Produktions-Workloads in großem Umfang mit hoher Wiederverwendung. Beide Modelle haben denselben Listenpreis – die tatsächlichen Kostenunterschiede entstehen vor allem durch drei Faktoren: Eingabelänge, Cache-Trefferquote und gewählte Reasoning-Stufe.
In der Praxis empfiehlt sich ein Vorgehen in drei Schritten: Bestimmen Sie zunächst mit dem Entscheidungsprozess dieses Artikels Ihr primäres Modell. Führen Sie anschließend mit dem Vergleichsskript einen A/B-Test auf echten Aufgaben durch und verwenden Sie dabei für beide Modelle dieselbe Reasoning-Stufe. Richten Sie zum Schluss ein Dual-Model-Routing nach Aufgabentyp ein, damit jede Anfrage beim Modell mit dem besten Preis-Leistungs-Verhältnis landet.
Wenn Sie die Einrichtung separater offizieller Konten bei Anthropic und OpenAI umgehen möchten, können Sie gpt-6.1-sol und claude-sonnet-5-5 einheitlich über APIYI apiyi.com aufrufen. Die Schnittstelle der Plattform ist mit dem offiziellen OpenAI-Format kompatibel; mit einem einzigen API-Schlüssel können Sie frei zwischen beiden Modellen wechseln. Das ist besonders praktisch für Evaluierungen und Multi-Model-Routing in Produktionsumgebungen.
Quellen:
– Offizielle OpenAI-Veröffentlichung: Einführung in GPT-6.1 Sol – openai.com/index/introducing-gpt-6-1-sol
– Offizielle Anthropic-Veröffentlichung: Einführung in Claude Sonnet 5.5 – anthropic.com/claude-sonnet-5-5
– Bewertung des Artificial Analysis Intelligence Index: artificialanalysis.ai
– Einordnung der GPT-6.1-Sol-Benchmarks von Vellum: vellum.ai/blog
– Bericht von The Decoder zu Claude Sonnet 5.5: the-decoder.com
Über die Autoren: Das APIYI-Technikteam konzentriert sich auf die API-Integration Großer Sprachmodelle und deren professionelle Umsetzung. Tauschen Sie sich gern über APIYI apiyi.com zu Modellauswahl und Kostenoptimierung für gpt-6.1-sol und claude-sonnet-5-5 aus.