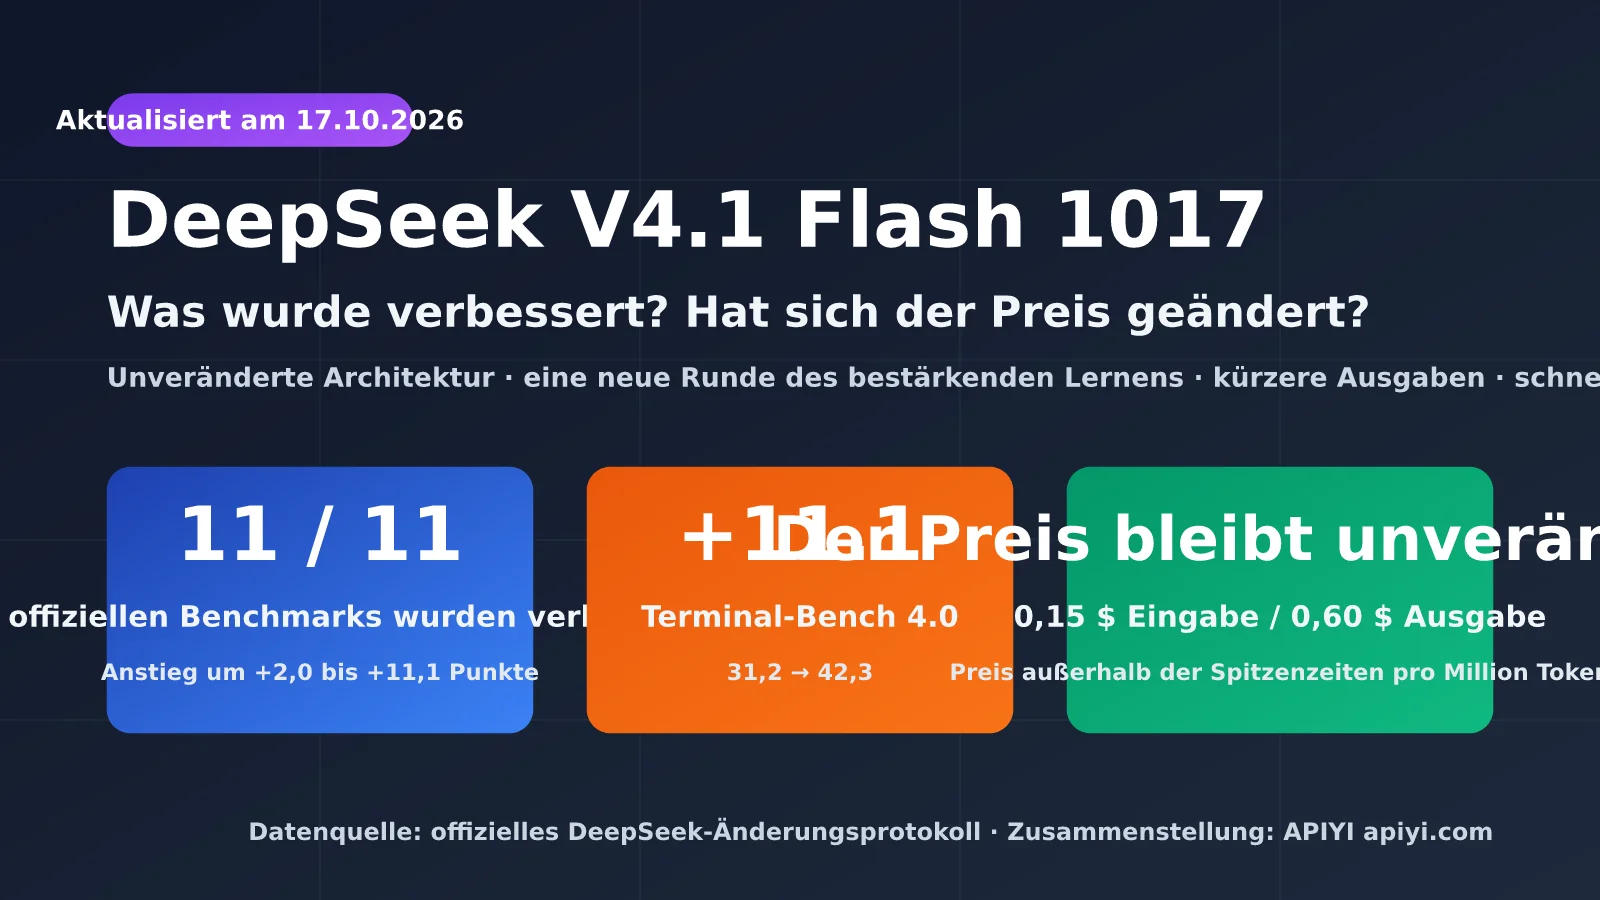
Am 17. Oktober 2026 hat DeepSeek V4.1 Flash still und leise auf DeepSeek-V4.1-Flash-1017 aktualisiert. Offiziell handelt es sich um ein kleines Versionsupdate. Die veröffentlichten Daten zeichnen jedoch ein anderes Bild: Alle 11 aufgeführten Benchmarks haben sich verbessert, und beim Terminal-Bench 4.0 gab es einen Sprung um 11,1 Punkte – das ist deutlich mehr als eine kleine Korrektur.
Viele Entwickler wollen vor allem zwei Dinge wissen: Was hat sich bei DeepSeek V4.1 Flash 1017 tatsächlich verbessert? Und hat sich der Preis geändert? Dieser Artikel stützt sich ausschließlich auf Daten aus dem offiziellen DeepSeek-Änderungsprotokoll, der Preisseite und der Modellkarte auf Hugging Face. Angaben von Drittanbietern werden gesondert gekennzeichnet.
Das Wichtigste: Nach der Lektüre wissen Sie, wie groß die tatsächlichen Verbesserungen von Version 1017 sind, warum „unveränderter Preis“ in der Praxis trotzdem günstiger bedeutet und wie Sie die Kosten für die DeepSeek-API mit einer geschickten Nutzung von Nebenzeiten noch einmal halbieren können.
Was ist DeepSeek V4.1 Flash 1017? Ein kleines Update ohne Architekturwechsel
DeepSeek V4.1 Flash ist das kleinste Modell der neuen Architekturfamilie, die am 10. September 2026 veröffentlicht wurde, und unterstützt nativ das Verständnis von Bildern. 1017 ist das erste Update, etwa einen Monat nach der Veröffentlichung. Das offizielle Änderungsprotokoll fasst es knapp zusammen: Das Modell wurde auf DeepSeek-V4.1-Flash-1017 aktualisiert, die Webversion und die App wurden ebenfalls angepasst, und weder die API-Aufrufe noch die Preise haben sich geändert.
Den technischen Angaben auf Hugging Face zufolge nutzt 1017 weiterhin dieselbe Architektur: 552 Milliarden Hauptparameter, rund 8 Milliarden aktive Parameter pro Token in der Prefill-Phase und rund 16 Milliarden in der Decodierungsphase. Hinzu kommt ein bedingter Engram-Speicher mit 196 Milliarden Parametern. Analysen in der englischsprachigen Community gehen davon aus, dass die Änderungen auf eine neue Runde des Reinforcement-Learning-Post-Trainings zurückzuführen sind. Konfigurationsdateien, Tokenizer und Kodierung der Eingabeaufforderungen blieben demnach unverändert. Bestehender Code muss also nicht angepasst werden.
| Punkt | DeepSeek V4.1 Flash 1017 | Erläuterung |
|---|---|---|
| Veröffentlichungsdatum | 2026-10-17 | Erstes Update seit dem Start am 10. September |
| API-Modellname | deepseek-flash |
Der Alias verweist automatisch auf die neueste Version |
| Alter Modellname | deepseek-v4-flash usw. |
Weiterhin aufrufbar; wird auf 1017 geroutet und zum Flash-Preis abgerechnet |
| Architektur | MoE, 552B Hauptparameter, 8B/16B aktiv | Unverändert gegenüber der ersten Version |
| Kontext / maximale Ausgabe | 1M / 384K | Angaben laut offizieller Preisseite |
| Denkmodus | Mit Denken (Standard) und ohne Denken | Beide Modi sind verfügbar |
| Multimodalität | Bildinput wird unterstützt | Die Pro-Version unterstützt derzeit keine visuellen Eingaben |
| Open-Source-Lizenz | MIT | Gewichte auf Hugging Face und ModelScope veröffentlicht |
| Parallelitätslimit | 2.500 | Bei der Pro-Version sind es 500 |
Bemerkenswert ist auch ein Punkt, den DeepSeek ausdrücklich hervorhebt: 1017 wurde für DeepSeek Harness, Tencent CodeBuddy und WorkBuddy optimiert. Empfohlen wird DeepSeek Harness ab Version 0.2.1-rc.1. Das deutet darauf hin, dass der Schwerpunkt des Trainings auf Agenten für Programmieraufgaben lag. Wenn Sie eine eigene Agenten-Schleife verwenden, könnte der praktische Nutzen daher geringer ausfallen als die offiziellen Zahlen vermuten lassen.
🎯 Technischer Tipp: Der Modellalias verweist automatisch auf die neue Version. Testen Sie sie daher vor der Umstellung des Produktivbetriebs mit eigenen Geschäftsdaten. Über APIYI (apiyi.com) können Sie mit demselben Schlüssel DeepSeek und andere führende Modelle aufrufen und sie so mit denselben Evaluierungsskripten direkt vergleichen.
Was hat sich bei DeepSeek V4.1 Flash 1017 verbessert? Ein Vergleich von 11 Benchmarks
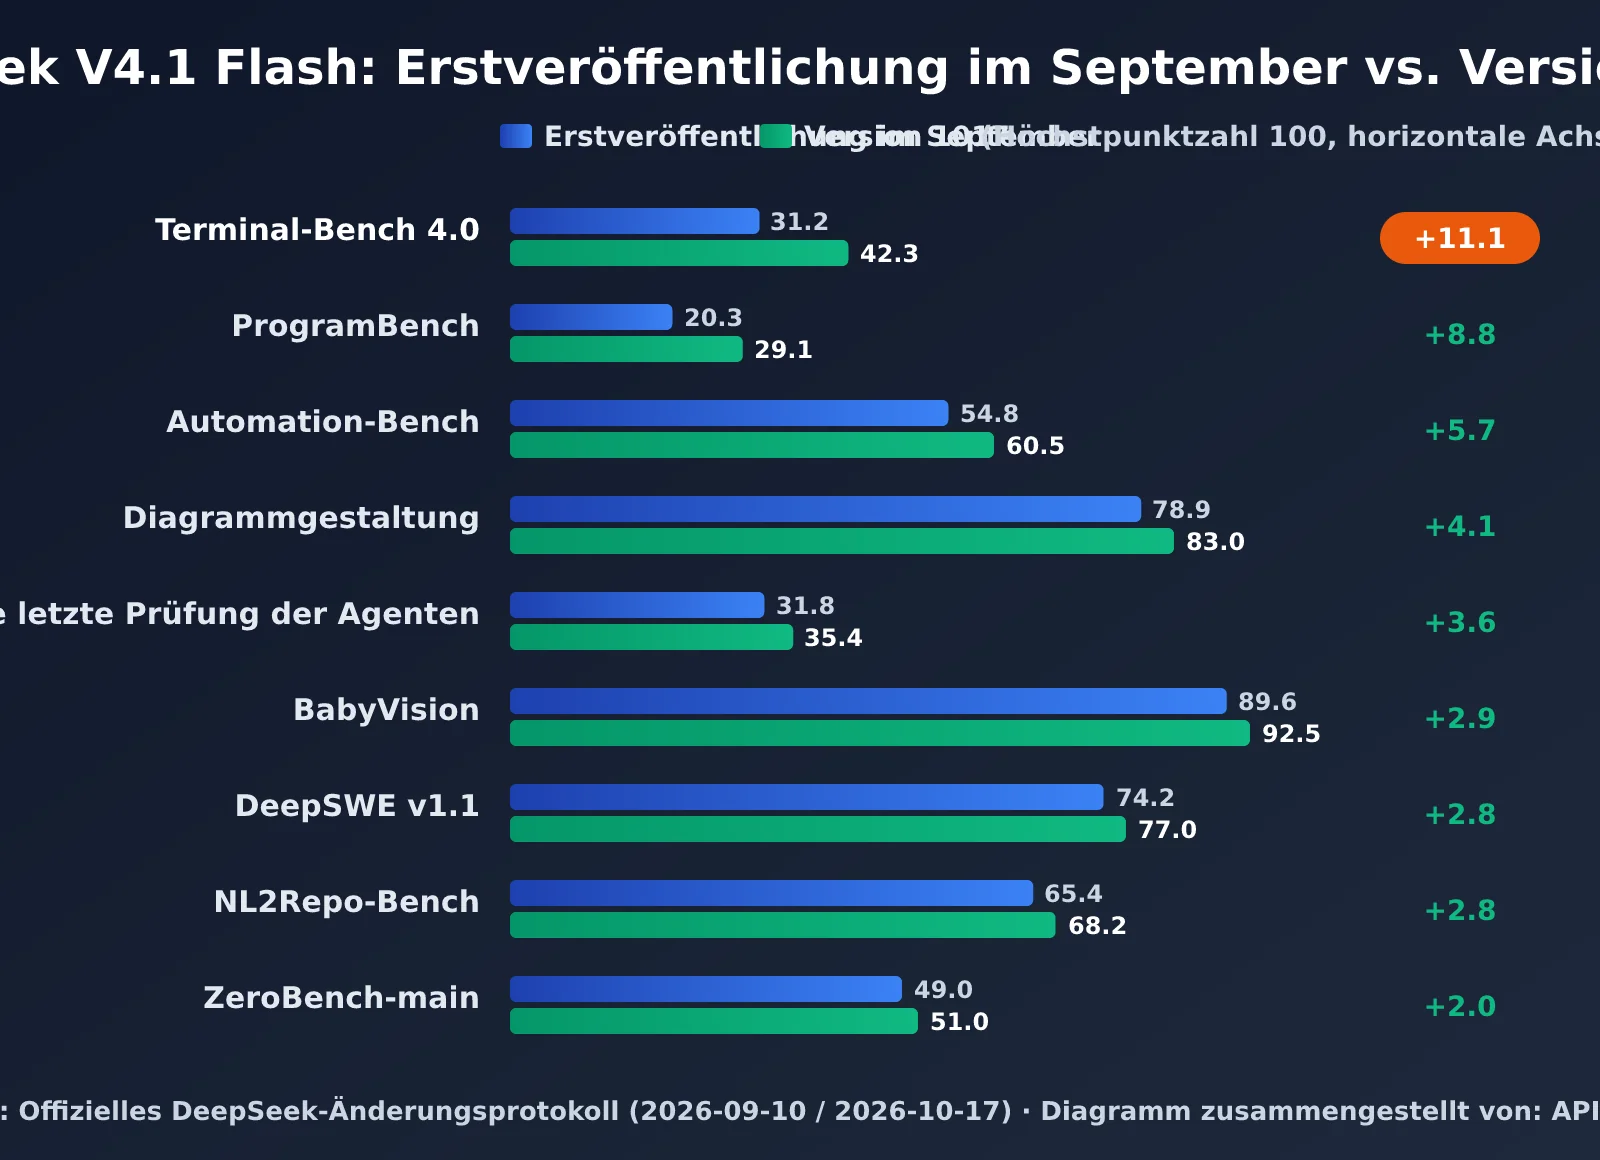
Am direktesten lässt sich die Frage „Was hat sich verbessert?“ beantworten, wenn man die Ergebnisse der offiziellen September-Version und der Version 1017 aus dem Oktober nebeneinanderstellt. Alle Daten in der folgenden Tabelle stammen aus dem offiziellen DeepSeek-Änderungsprotokoll. Der alte Wert für Apex Bench ist dort nicht aufgeführt und wurde einer Zusammenstellung aus der englischsprachigen Community entnommen – er dient daher nur als Referenz.
| Benchmark | Bewertete Fähigkeit | September-Version | Version 1017 | Verbesserung |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Terminal-Agent-Aufgaben | 31.2 | 42.3 | +11.1 |
| ProgramBench | Codegenerierung | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | Allgemeines Schlussfolgern (alter Wert aus Drittquelle) | 64.6 | 72.1 | +7.5 |
| HLE (ohne Tools) | Anspruchsvolles Schlussfolgern über Wissen | 36.8 | 42.6 | +5.8 |
| Automation-Bench | Automatisierte Workflows | 54.8 | 60.5 | +5.7 |
| Chartography (mit Tools) | Diagrammverständnis | 78.9 | 83.0 | +4.1 |
| Agents‘ Last Exam | Allgemeiner Agent | 31.8 | 35.4 | +3.6 |
| BabyVision (mit Tools) | Visuelles Verständnis | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | Softwareentwicklung | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | Generierung von Repositorys aus natürlicher Sprache | 65.4 | 68.2 | +2.8 |
| ZeroBench-main (mit Tools) | Visuelles Schlussfolgern | 49.0 | 51.0 | +2.0 |
Aus der Tabelle lassen sich drei Erkenntnisse ableiten. Erstens fallen die größten Zuwächse bei Agenten- und Programmieraufgaben an. Bei Terminal-Bench 4.0 und ProgramBench liegen die relativen Steigerungen jeweils bei über 35 Prozent. Das passt zu DeepSeeks Aussage, das Modell für Harness und CodeBuddy optimiert zu haben. Zweitens verbessern sich auch die visuellen Benchmarks konstant um 2 bis 4 Punkte. Das deutet darauf hin, dass das Nachtraining die multimodalen Fähigkeiten nicht beeinträchtigt hat. Drittens unterscheiden sich die Testbedingungen bei einigen Benchmarks zwischen den Versionen. So ist die neue Automation-Bench-Version als v1.0.6 gekennzeichnet, während bei der September-Version von HLE nicht angegeben ist, ob Tools zum Einsatz kamen. Einzelne Werte sollte man daher mit Vorsicht interpretieren.
Effizienzverbesserungen bei DeepSeek V4.1 Flash 1017: kürzere Ausgaben, schnellere Aufgaben
Neben den Ergebnissen hebt DeepSeek auch eine leicht zu übersehende Veränderung hervor: Version 1017 erledigt Aufgaben schneller und gibt weniger Text aus. Bei APIs mit Token-Abrechnung ist das genauso wichtig wie die Punktzahl: Gibt das Modell bei derselben Aufgabe weniger Token aus, sinken die Kosten direkt.
Zu beachten ist, dass DeepSeek nicht veröffentlicht hat, um wie viel Prozent die Ausgaben kürzer oder die Aufgaben schneller geworden sind. Auch aus der englischsprachigen Community liegen bislang keine verlässlichen Vergleichsmessungen vor. Am sinnvollsten ist es daher, die Veränderung von usage.completion_tokens anhand eigener Geschäftsdaten zu erfassen und die tatsächliche Kostenersparnis auf dieser Grundlage zu berechnen.
In der englischsprachigen Community wird der Trainingsansatz als „Wish-Driven Programming“ („programmieren nach Wunsch“) beschrieben: Das Modell setzt zunächst ein Projekt von Anfang bis Ende um, bewertet anschließend selbst, wie gut das Ergebnis dem Ziel entspricht, und verbessert es in weiteren Durchläufen. Zu den von DeepSeek vorgestellten Beispielen gehören eine 3D-Rekonstruktion der Verbotenen Stadt, ein Rennspiel im Browser und eine Nachbildung von Portal 2 mit Godot. Solche Projekte mit langen Aufgabenketten ähneln den Anforderungen von Benchmarks wie Terminal-Bench und ProgramBench. Das erklärt auch, warum die Ergebnisse bei Agent-Aufgaben besonders stark gestiegen sind.
Hat sich der Preis von DeepSeek V4.1 Flash 1017 geändert? Abrechnung zu Neben- und Spitzenzeiten im Detail
Das Wichtigste zuerst: Der API-Preis von DeepSeek V4.1 Flash 1017 hat sich nicht geändert und entspricht genau dem Preis der ersten Version vom September. Das bedeutet allerdings nicht, dass sich die Preise nie geändert haben: Schon zum Start im September wurden sie einmal gesenkt. Außerdem rechnet DeepSeek derzeit mit zwei Tarifen ab – einem für Nebenzeiten und einem für Spitzenzeiten. Je nach Tageszeit kann der tatsächliche Preis doppelt so hoch sein.
| Abrechnungsposten (pro 1 Mio. Token) | Flash: Nebenzeiten | Flash: Spitzenzeiten | V4 Pro: Nebenzeiten | V4 Pro: Spitzenzeiten |
|---|---|---|---|---|
| Eingabe (Cache-Treffer) | $0.003 | $0.006 | $0.022 | $0.044 |
| Eingabe (Cache-Fehlzugriff) | $0.15 | $0.30 | $0.66 | $1.32 |
| Ausgabe | $0.60 | $1.20 | $1.98 | $3.96 |
Laut offizieller Definition gelten folgende Zeiträume als Spitzenzeiten: Montag bis Freitag von 01:00 bis 04:00 Uhr und von 06:00 bis 10:00 Uhr UTC. Umgerechnet auf die Pekinger Zeit entspricht das werktags 09:00–12:00 Uhr und 14:00–18:00 Uhr. Gesetzliche Feiertage in China zählen nicht als Spitzenzeiten. Zu allen übrigen Zeiten – also nachts, in der Mittagspause, am Wochenende und ganztägig an Feiertagen – gilt der Nebenzeitenpreis. Er beträgt die Hälfte des Preises zu Spitzenzeiten.
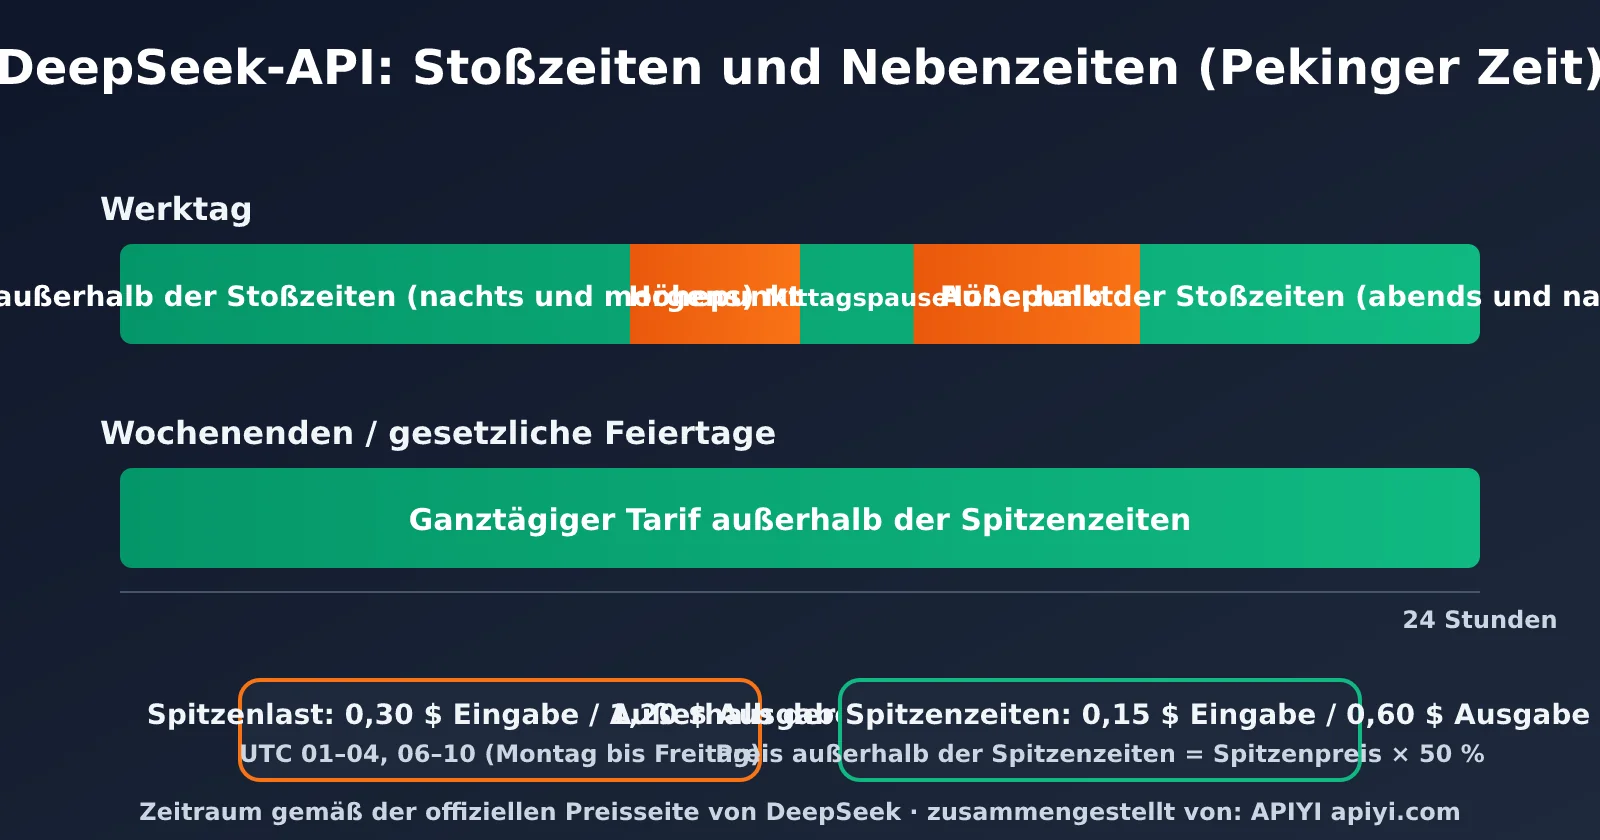
Diese Tarifstruktur wirkt sich unmittelbar auf Teams in China aus: Die Spitzenzeiten fallen fast vollständig in die reguläre Arbeitszeit. Wenn Aufgaben wie Stapelübersetzungen, Offline-Datenannotation oder das Scannen von Code-Repositories nicht sofort erledigt werden müssen, können Sie sie auf die Zeit nach 18 Uhr oder aufs Wochenende verschieben. Dann halbiert sich der Preis sofort – direkter lässt sich kaum sparen, auch nicht mit einer noch so guten Optimierung der Eingabeaufforderung.
Zeitlicher Verlauf der Preise für DeepSeek V4.1 Flash
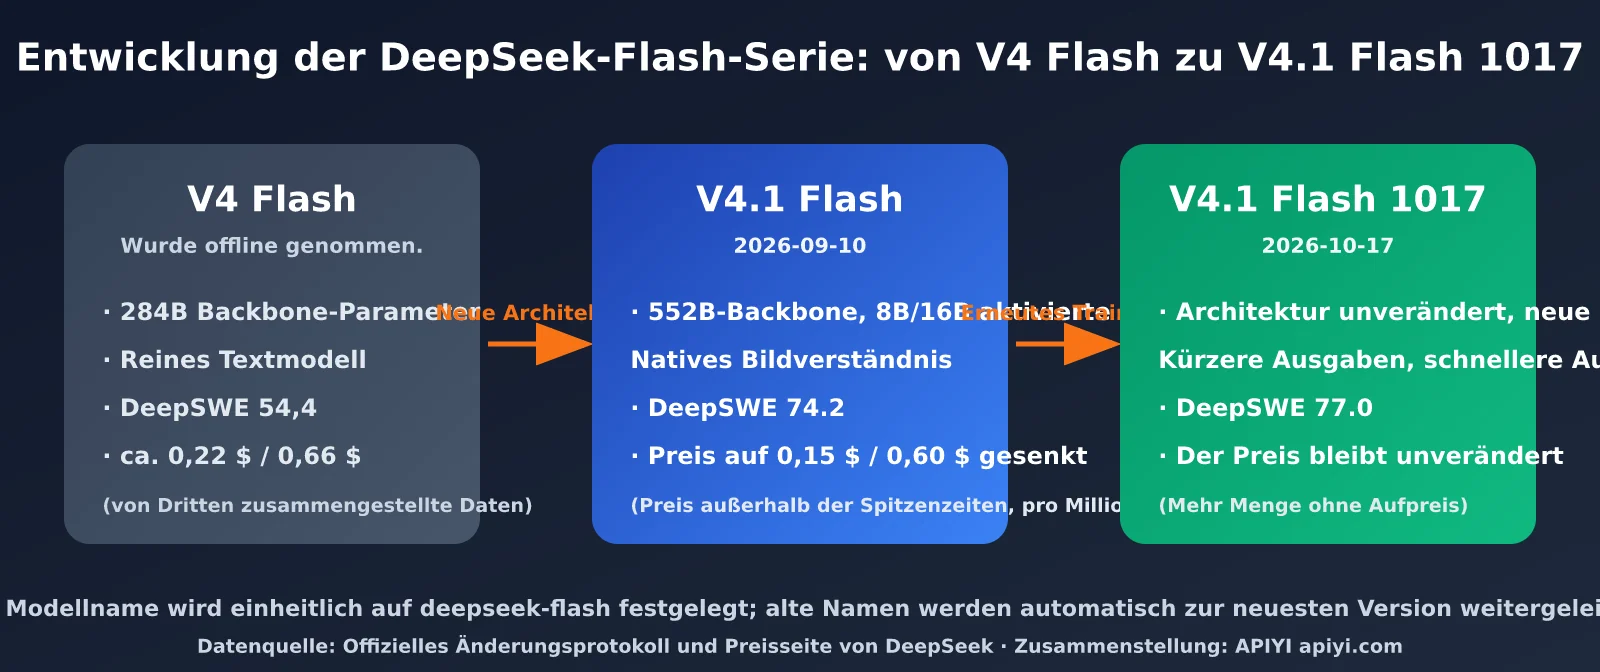
Betrachtet man einen längeren Zeitraum, hat die Flash-Serie innerhalb von zwei Monaten zunächst eine Preissenkung und danach eine Leistungssteigerung ohne Aufpreis erlebt. Die Preise für die V4-Flash-Ära stammen aus einer Zusammenstellung der englischsprachigen Community und dienen nur als Richtwert. Die Angaben für September und Oktober stammen aus offiziellen Quellen.
| Version | Veröffentlichungsdatum | Eingabe (Cache-Fehlzugriff) | Eingabe (Cache-Treffer) | Ausgabe | Änderung |
|---|---|---|---|---|---|
| V4 Flash | Vor September 2026 | ca. $0.22 | ca. $0.007 | ca. $0.66 | Nicht mehr verfügbar |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | Offizielle Preissenkung |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | Preis unverändert, Leistung verbessert |
Für die V4.1-Modelle gelten die Preise zu Nebenzeiten. Während der Spitzenzeiten verdoppeln sie sich.
Warum „unveränderter Preis“ in der Praxis trotzdem eine Preissenkung bedeutet
Der Stückpreis ist zwar gleich geblieben, aber die Gesamtkosten pro Aufgabe hängen von „Preis × Token-Anzahl“ ab. Laut offizieller Bestätigung erzeugt 1017 kürzere Ausgaben. Dadurch werden für dieselbe Aufgabe weniger Ausgabe-Token benötigt. Da der Preis für Ausgaben viermal so hoch ist wie der für Eingaben, spart eine kürzere Ausgabe mehr als eine kürzere Eingabe.
Ein Beispiel zur Veranschaulichung: Ein Agent-Aufruf benötigt zu Nebenzeiten 1 Million Eingabe-Token ohne Cache-Treffer und 200.000 Ausgabe-Token. Die Kosten betragen dann etwa $0.15 + $0.12 = $0.27. Sinkt die Ausgabemenge um 20 % – eine reine Annahme, der tatsächliche Wert hängt von Ihren Messungen ab –, reduzieren sich die Ausgabekosten von $0.12 auf etwa $0.096. Wenn sich lange Kontexte dank des Cache-Trefferpreises von $0.003 wiederverwenden lassen, sinken die tatsächlichen Kosten noch weiter.
💰 Kosten optimieren: Bei umfangreichen Aufrufen und budgetkritischen Projekten können Sie nicht zeitkritische Aufgaben in die Nebenzeiten legen und feste System-Eingabeaufforderungen möglichst oft wiederverwenden, um die Cache-Trefferquote zu erhöhen. Wenn Sie die API über APIYI (apiyi.com) nutzen, können Sie außerdem die Nutzungsdetails verschiedener Modelle zentral einsehen und so die tatsächlichen Kosten der einzelnen Aufgabentypen leichter berechnen.
Search- und Fetch-API: Neue Abrechnungsposten, die mit 1017 eingeführt wurden
Mit 1017 gab DeepSeek eine weitere Neuerung bekannt: Die hauseigenen Funktionen Search (Websuche) und Fetch (Abruf von Webseiten) sind nun auch für externe Entwickler verfügbar. Beide Dienste werden separat pro Anfrage abgerechnet: je $0.75 pro 1.000 erfolgreiche Anfragen. Die Kosten kommen zusätzlich zu den Token-Gebühren des Modells hinzu.
Laut offizieller Preisseite gilt zunächst eine Übergangsfrist: Anfragen dieser Art, die über DeepSeek Harness, Claude Code oder Codex gestartet werden, sind derzeit kostenlos. Ab dem 1. November 2026 um 0:00 Uhr Pekinger Zeit wird pro Anfrage abgerechnet. Wenn Ihr Agent-Workflow intensiv auf Websuche angewiesen ist, sollten Sie die Zahl der Aufrufe vor November erfassen und die zusätzlichen Kosten rechtzeitig einschätzen.
Schnellstart mit DeepSeek V4.1 Flash 1017: API-Aufrufbeispiele
Da 1017 weiterhin den Modellnamen deepseek-flash verwendet, nutzen bestehende Programme die neue Version automatisch – ohne dass Änderungen nötig sind. Hier ein minimales Aufrufbeispiel mit dem OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche API von APIYI verwenden
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # Den tatsächlich verfügbaren Modellnamen der Modellliste der Plattform entnehmen
    messages=[{"role": "user", "content": "用 Python 写一个读取 CSV 并按列求和的函数"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # Token-Verbrauch protokollieren, um die Ausgabelänge der alten und neuen Version zu vergleichen
Vollständiger Code: Skript zum Vergleich der Ausgabelänge alter und neuer Versionen
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche API von APIYI: Mit einem Schlüssel mehrere Modelle aufrufen
)

PROMPTS = [
    "解释 Python 中生成器和迭代器的区别,并给出示例",
    "写一个带重试和指数退避的 HTTP 请求函数",
    "把下面的 SQL 改写成 pandas 代码:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # Vergleiche completion_tokens aus den bisherigen Aufzeichnungen mit den aktuellen Ergebnissen, um die Verkürzung der Ausgabe durch 1017 abzuschätzen
    print(run("deepseek-flash", PROMPTS))
Mit diesen Praxistipps kommst du schneller ans Ziel:
- Denkmodus:
deepseek-flashaktiviert standardmäßig den Denkmodus. Bei einfachen Fragen und Antworten oder Formatumwandlungen kannst du in den Modus ohne Denken wechseln und so weitere Ausgabe-Token sparen. Die genaue Schreibweise der Parameter findest du in der offiziellen Dokumentation. - Sampling-Parameter: Die Modellkarte auf Hugging Face empfiehlt
temperature=1.0undtop_p=0.95. Falls du die Temperatur für eine ältere Version angepasst hast, solltest du sie erneut testen. - Alter Modellname:
deepseek-v4-flashist weiterhin verfügbar, wird aber bereits an 1017 weitergeleitet. Wir empfehlen, aufdeepseek-flashumzusteigen, damit es später keine Probleme gibt, falls der Alias eingestellt wird. - Regressionstests: Kürzere Ausgaben können sich auf nachgelagerte Parser auswirken, die ein festes Format oder eine bestimmte Länge voraussetzen. Teste daher vor dem Wechsel reale Beispiele.
🚀 Schnellstart: Mit der Plattform APIYI apiyi.com kannst du schnell einen Prototyp erstellen. Die OpenAI-kompatible Schnittstelle funktioniert sofort. So bindest du DeepSeek V4.1 Flash 1017 in wenigen Minuten in ein bestehendes Projekt ein und kannst es im A/B-Vergleich mit anderen Modellen testen.
Für welche Anwendungsfälle eignet sich DeepSeek V4.1 Flash 1017? Vergleich mit V4 Pro
Nach dem Update auf 1017 stellt sich die praktische Frage: Lohnt sich das teurere V4 Pro noch? Laut offizieller Preisseite punktet Flash bei Preis, Parallelität und visuellen Fähigkeiten. Pro bleibt dennoch das größere Modell, das DeepSeek derzeit öffentlich anbietet.
| Vergleichskriterium | deepseek-flash (V4.1 Flash 1017) | deepseek-v4-pro (V4 Pro 0813) | Empfehlung |
|---|---|---|---|
| Preis für Ausgaben (Nebenzeiten) | $0.60 / Million Token | $1.98 / Million Token | Flash kostet etwa 30 % des Pro-Preises |
| Kontext / maximale Ausgabe | 1M / 384K | 1M / 384K | Gleichauf |
| Visuelles Verständnis | Unterstützt | Nicht unterstützt | Bei Bildeingaben Flash wählen |
| Maximale Parallelität | 2,500 | 500 | Für Batch-Verarbeitung mit hoher Parallelität Flash wählen |
| Optimierung für agentisches Programmieren | Speziell für Harness und CodeBuddy optimiert | Allgemein | Für Programmier-Agenten zuerst Flash testen |
| Verfügbare Plattformen | Offizielle DeepSeek-Plattform, APIYI apiyi.com usw. | Dieselben | Eine einheitliche Schnittstelle erleichtert den Wechsel |
Aus diesen Informationen lassen sich je nach Anwendungsfall einige Auswahlkriterien ableiten:
- Programmier-Agenten und Terminalautomatisierung: Flash 1017 ist die erste Wahl. Hier liegt der Schwerpunkt der Verbesserungen, und der Preis beträgt nur etwa ein Drittel des Pro-Preises.
- Verständnis von Diagrammen, Screenshots und Dokumenten: Hier kommt nur Flash infrage, denn Pro unterstützt derzeit keine visuellen Eingaben.
- Große Mengen an Offline-Aufgaben: Mit einer maximalen Parallelität von 2.500 und dem Nebenzeitenpreis bietet Flash das beste Preis-Leistungs-Verhältnis.
- Höchste Anforderungen an die Qualität einzelner Antworten bei komplexen Schlussfolgerungen: Vergleiche Flash und Pro zunächst anhand derselben Beispieldaten. Verlass dich nicht allein auf Benchmark-Ergebnisse.
💡 Empfehlung: Welches Modell am besten passt, hängt vor allem von der Art deiner Aufgaben und den Qualitätsanforderungen ab. Teste Flash und Pro mit denselben realen Beispielen über die Plattform APIYI apiyi.com. Dank der einheitlichen Schnittstelle reicht zum Wechsel ein anderer Modellname – so kommst du schnell zu einem aussagekräftigen Ergebnis.
Häufige Fragen
Q1: Muss ich für DeepSeek V4.1 Flash 1017 meinen Code ändern?
Nein. Laut offizieller Bestätigung bleibt die API-Aufrufmethode unverändert. deepseek-flash verweist automatisch auf Version 1017, und auch der alte Name deepseek-v4-flash wird auf die neue Version weitergeleitet. Empfehlenswert ist lediglich ein Regressionstest, um sicherzustellen, dass die nachgelagerte Verarbeitung auch mit den kürzeren Ausgaben weiterhin funktioniert. Über die Plattform APIYI apiyi.com kannst du Testkontingente erhalten und schnell prüfen, wie sich die neue Version in deinem Anwendungsfall schlägt.
Q2: Hat sich der Preis von DeepSeek V4.1 Flash 1017 nun geändert oder nicht?
Die Preise pro Einheit sind unverändert: In Nebenzeiten kostet eine Cache-Fehlzuordnung bei der Eingabe $0.15, ein Cache-Treffer $0.003 und die Ausgabe $0.60 (jeweils pro Million Token). Zu Spitzenzeiten verdoppeln sich die Preise. Da Version 1017 jedoch kürzere Ausgaben erzeugt, sinken die Gesamtkosten für dieselbe Aufgabe in der Regel. Neu hinzugekommen sind lediglich die nutzungsbasierten Gebühren für die Search- und Fetch-API: jeweils $0.75 pro 1.000 erfolgreiche Anfragen.
Q3: Wann sind die Spitzenzeiten nach Pekinger Zeit?
An Werktagen von 09:00 bis 12:00 Uhr und von 14:00 bis 18:00 Uhr Pekinger Zeit. Das entspricht 01:00 bis 04:00 Uhr und 06:00 bis 10:00 Uhr UTC. Chinesische gesetzliche Feiertage gelten nicht als Spitzenzeiten. Zu allen übrigen Zeiten gelten die Nebenzeitpreise, also die Hälfte der Spitzenzeitpreise.
Q4: Sind die Verbesserungen in den Benchmarks für Version 1017 verlässlich?
Die Ergebnisse stammen aus einer Veröffentlichung von DeepSeek; unabhängige Reproduktionen durch Dritte laufen noch. Einige Benchmarks hängen von bestimmten Frameworks ab: Terminal-Bench 4.0 verwendet beispielsweise das Claude-Code-Framework, DeepSWE das Mini-SWE-V2-Framework. Bei einem Wechsel zu einem selbst entwickelten Agenten-Loop können die Ergebnisse daher abweichen. Am verlässlichsten ist es, eigene Beispiele und das eigene Framework zu testen und erst danach über einen Wechsel zu entscheiden.
Q5: Kann ich DeepSeek V4.1 Flash 1017 lokal bereitstellen?
Ja. Die Gewichte stehen unter MIT-Lizenz auf Hugging Face und ModelScope zur Verfügung. Unterstützt werden Inferenz-Frameworks wie vLLM, SGLang und Transformers. Das Backbone mit 552B Parametern stellt jedoch hohe Anforderungen an den Grafikspeicher. Für kleine und mittlere Teams ist es daher meist günstiger, direkt die API aufzurufen.
Wichtigste Erkenntnisse
- Was wurde verbessert? Die Architektur ist unverändert, aber es gab eine neue Runde Reinforcement Learning. In allen elf offiziellen Benchmarks wurden bessere Ergebnisse erzielt; Terminal-Bench 4.0 stieg von 31.2 auf 42.3.
- Änderungen bei der Effizienz: Aufgaben werden schneller abgeschlossen und die Ausgaben sind kürzer. Bei der Abrechnung pro Token sinken dadurch direkt die Kosten pro Aufgabe.
- Hat sich der Preis geändert? Die Preise pro Einheit sind unverändert: In Nebenzeiten $0.15 für Eingaben und $0.60 für Ausgaben; zu Spitzenzeiten verdoppeln sie sich. Spitzenzeiten sind an Werktagen von 9 bis 12 Uhr und von 14 bis 18 Uhr Pekinger Zeit.
- Neue Gebühren: Für die Search- und Fetch-API fallen jeweils $0.75 pro 1.000 Anfragen an. Ab dem 1. November werden Aufrufe über Harness, Claude Code und Codex kostenpflichtig.
- Integration: Nutze weiterhin
deepseek-flash; Codeänderungen sind nicht erforderlich. Vor dem Wechsel genügt ein Regressionstest.
Zusammenfassung
Zurück zu den beiden Fragen aus der Überschrift: Die Antwort lässt sich auf drei Punkte bringen:
- Was wurde verbessert? DeepSeek V4.1 Flash 1017 ist ein Retraining auf derselben Architektur. Am deutlichsten verbessert wurden die Fähigkeiten beim agentischen Programmieren. Auch das visuelle Verständnis hat sich leicht verbessert. Gleichzeitig sind die Ausgaben kürzer und die Antwortgeschwindigkeit höher.
- Hat sich der Preis geändert? Nein. Er bleibt auf dem Niveau nach der Preissenkung im September. Durch die kürzeren Ausgaben sinken die tatsächlichen Kosten; in Nebenzeiten wird es nochmals um die Hälfte günstiger.
- Was ist zu tun? Am Code muss nichts geändert werden. Es empfiehlt sich jedoch, einen Regressionstest durchzuführen und die Auswirkungen der nutzungsbasierten Abrechnung für Search/Fetch ab November auf Agent-Workflows zu prüfen.
Für Teams, die DeepSeek bereits für Programmier-Agenten, die Stapelverarbeitung oder das Verständnis von Diagrammen einsetzen oder dies planen, ist Version 1017 ein Update mit mehr Leistung zum gleichen Preis. Es lohnt sich, zeitnah zu wechseln und die Ergebnisse zu überprüfen. Über APIYI (apiyi.com) können Sie die Leistung schnell testen: Vergleichen Sie DeepSeek V4.1 Flash 1017 über eine einheitliche Schnittstelle anhand derselben Testbeispiele mit anderen führenden Modellen und entscheiden Sie anschließend, wie Sie den Produktions-Traffic verteilen.
Weiterführende Artikel
Wenn Sie sich für die DeepSeek-Modellreihe interessieren, empfehlen wir Ihnen diese Artikel:
- 📘 DeepSeek V4.1 Flash im Überblick: neue Architektur und native multimodale Fähigkeiten – Erfahren Sie mehr über die Architekturänderungen der im September veröffentlichten Version.
- 📊 Leitfaden zur Kostenoptimierung der DeepSeek API: Cache-Treffer und zeitgesteuerte Auslastung – Lernen Sie praktische Möglichkeiten kennen, um die Token-Kosten zu senken.
- 🚀 Den passenden Modelltyp für Programmier-Agenten auswählen: Flash, Pro und führende proprietäre Modelle im Vergleich – Entdecken Sie die optimale Kombination für verschiedene Einsatzbereiche.
Referenzen
- DeepSeek-API-Änderungsprotokoll: Offizielle Release-Informationen und Benchmark-Daten zu V4.1 Flash und Version 1017
- Link:
api-docs.deepseek.com/updates -
Hinweis: Die wichtigste Quelle für die Benchmark-Ergebnisse und Versionsangaben in diesem Artikel
-
DeepSeek-Modelle und Preise: Offizielle Preise sowie Abrechnungsregeln für Stoßzeiten, Search und Fetch
- Link:
api-docs.deepseek.com/quick_start/pricing -
Hinweis: Maßgeblich sind die aktuellen Angaben auf der offiziellen Seite
-
Hugging-Face-Modellkarte: Architektur, Parameter und empfohlene Sampling-Parameter von DeepSeek-V4.1-Flash
- Link:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
Hinweis: Referenz für die lokale Bereitstellung und die Konfiguration der Parameter
-
Vergleichsartikel von Regolo: Preis- und Benchmark-Vergleich zwischen V4 Flash und V4.1 Flash
- Link:
regolo.ai - Hinweis: Der im Artikel angegebene frühere Preis von V4 Flash stammt aus dieser Zusammenstellung eines Drittanbieters
Autor: Technisches Team von APIYI
Technischer Austausch: Diskutieren Sie gern in den Kommentaren. Weitere Informationen finden Sie im Dokumentationszentrum von APIYI unter docs.apiyi.com.