Anmerkung des Autors: Wenn Smartphones und Browser Sprache inzwischen lokal synthetisieren können – braucht es dann noch eine Cloud-Sprach-API? Dieser Beitrag liefert eine Einschätzung entlang von vier Dimensionen: Offlinefähigkeit, Datenschutz, Klangqualität und lange Texte, festgelegtes Modell und einheitliche Abrechnung.
Immer mehr Smartphone-Betriebssysteme und Browser können Text direkt auf dem Gerät vorlesen. Für Teams, die Sprachprodukte bauen, stellt sich deshalb unweigerlich die Frage: Ist Sprachausgabe auf dem Gerät erst einmal da, brauche ich dann noch eine Cloud-Sprach-API? Die einen wollen komplett auf lokale Sprachausgabe umstellen, um sich die Aufrufkosten zu sparen. Die anderen befürchten, dass lokale Stimmen für ein ernstzunehmendes Produkt nicht ausreichen.
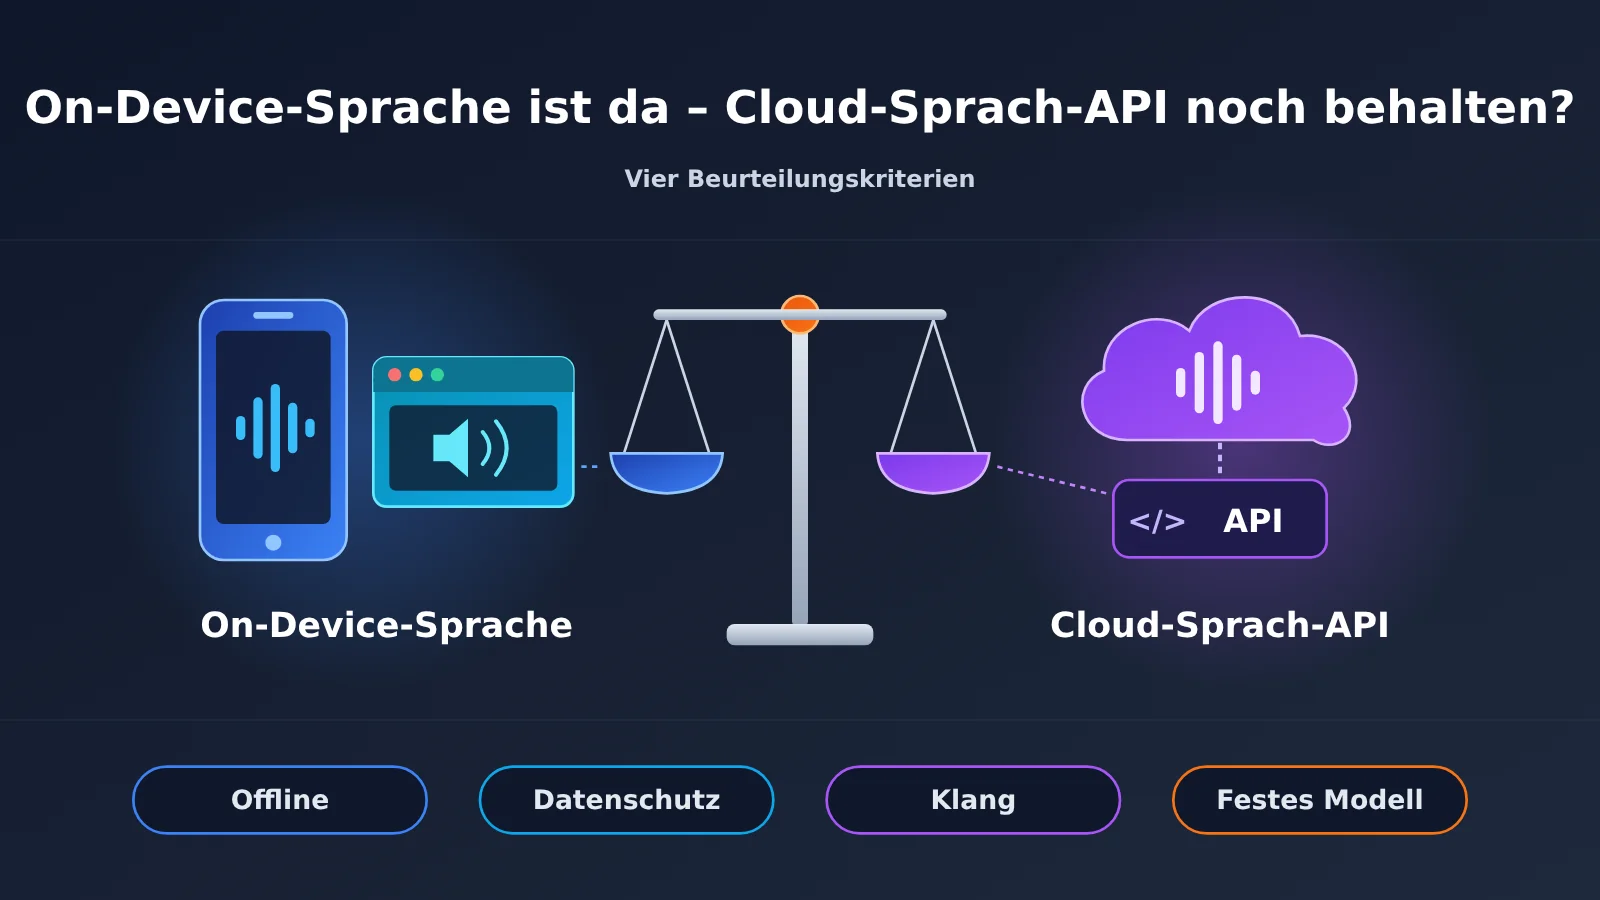
Es ist keine Entweder-oder-Frage. Sprachausgabe auf dem Gerät und in der Cloud haben jeweils ihre Grenzen. Entscheidend ist, ob Ihr Produkt offline funktionieren muss, wie sensibel Ihre Daten sind, wie hoch die Ansprüche an Klangqualität und lange Texte sind und ob Sie zwingend ein bestimmtes Modell festlegen müssen.
Nutzen für Sie: Nach der Lektüre können Sie anhand von vier Dimensionen Punkt für Punkt entscheiden, wie Sie Gerät und Cloud in Ihrem Produkt aufteilen – ganz ohne Pauschallösung.
Sprachausgabe direkt auf dem Gerät: die wichtigsten Infos im Überblick
Zuerst trennen wir, was sich bestätigen lässt, von dem, was noch unklar ist. Der Trend zur Sprachausgabe auf dem Gerät ist eindeutig. Zu Latenz und Klangqualität einzelner lokaler Modelle gibt es aber keine ausreichenden, öffentlich vergleichbaren Zahlen. Dieser Beitrag spekuliert deshalb nicht und führt solche Werte durchgehend als unbekannt.
| Punkt | Details |
|---|---|
| Änderung | Smartphone-Betriebssysteme und Browser können Text lokal in Sprache umwandeln, ganz ohne Internetverbindung |
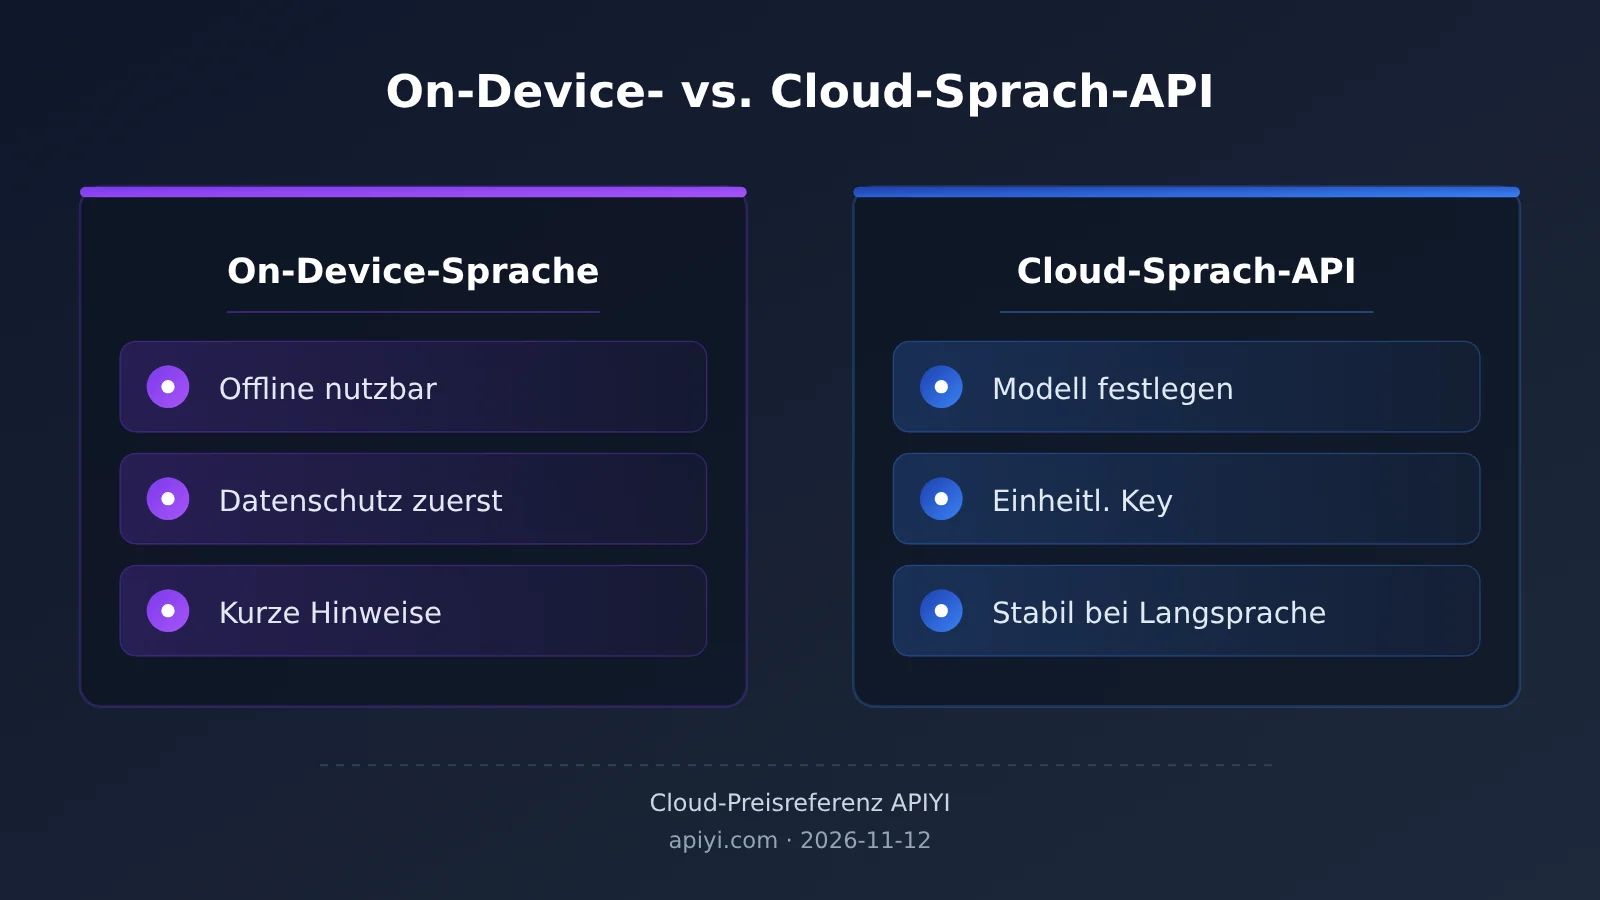
| Stärken auf dem Gerät | Offline nutzbar, Daten bleiben auf dem Gerät, gut geeignet für kurze Ansagen |
| Unbekannte Punkte auf dem Gerät | Für Latenz und Klangqualität der einzelnen Lösungen gibt es keine einheitlichen öffentlichen Daten, daher gelten sie als unbekannt |
| Stärken der Cloud | Konkrete Modelle wählbar, ein gemeinsamer API-Schlüssel mit den Textmodellen, stabilere Ergebnisse bei langen Texten |
| Verfügbare Cloud-Modelle | Stand 12.11.2026 stehen in der APIYI-Preisliste weiterhin tts-1, tts-1-hd, gpt-realtime-2.1 und gpt-realtime-2.1-mini |
| Betroffene | Produktteams, die Sprachansagen, Sprachassistenten oder Echtzeit-Sprachdialoge entwickeln |
Was Sprachausgabe auf dem Gerät leisten kann – und was sie nicht garantiert
Der größte Vorteil liegt auf der Hand: Die Stimme funktioniert auch ohne Netz. Bei Navigationshinweisen, Lesehilfen oder kurzen Signaltönen in einer App sind die Sätze kurz und die Aufrufe häufig. Hier reicht lokale Synthese völlig aus, und man spart sich außerdem einen Netzwerk-Roundtrip. Weil die Daten auf dem Gerät bleiben, sinkt zudem der Compliance-Druck deutlich, vor allem bei Produkten, die mit sensiblen Texten aus den Bereichen Gesundheit oder Finanzen arbeiten.
Welche Stimmen und welche Qualität möglich sind, hängt aber vom Gerät der Nutzer ab. Dasselbe Produkt kann auf Smartphones verschiedener Hersteller und mit unterschiedlichen Systemversionen völlig anders klingen. Eine einheitliche Nutzererfahrung lässt sich daher kaum garantieren. Wie viel langsamer oder klanglich schwächer ein bestimmtes lokales Modell gegenüber der Cloud ist, dazu gibt es derzeit keine verlässlichen öffentlichen Zahlen. Verlassen Sie sich bei der Entscheidung lieber auf Stichproben mit den echten Geräten Ihrer Zielgruppe.
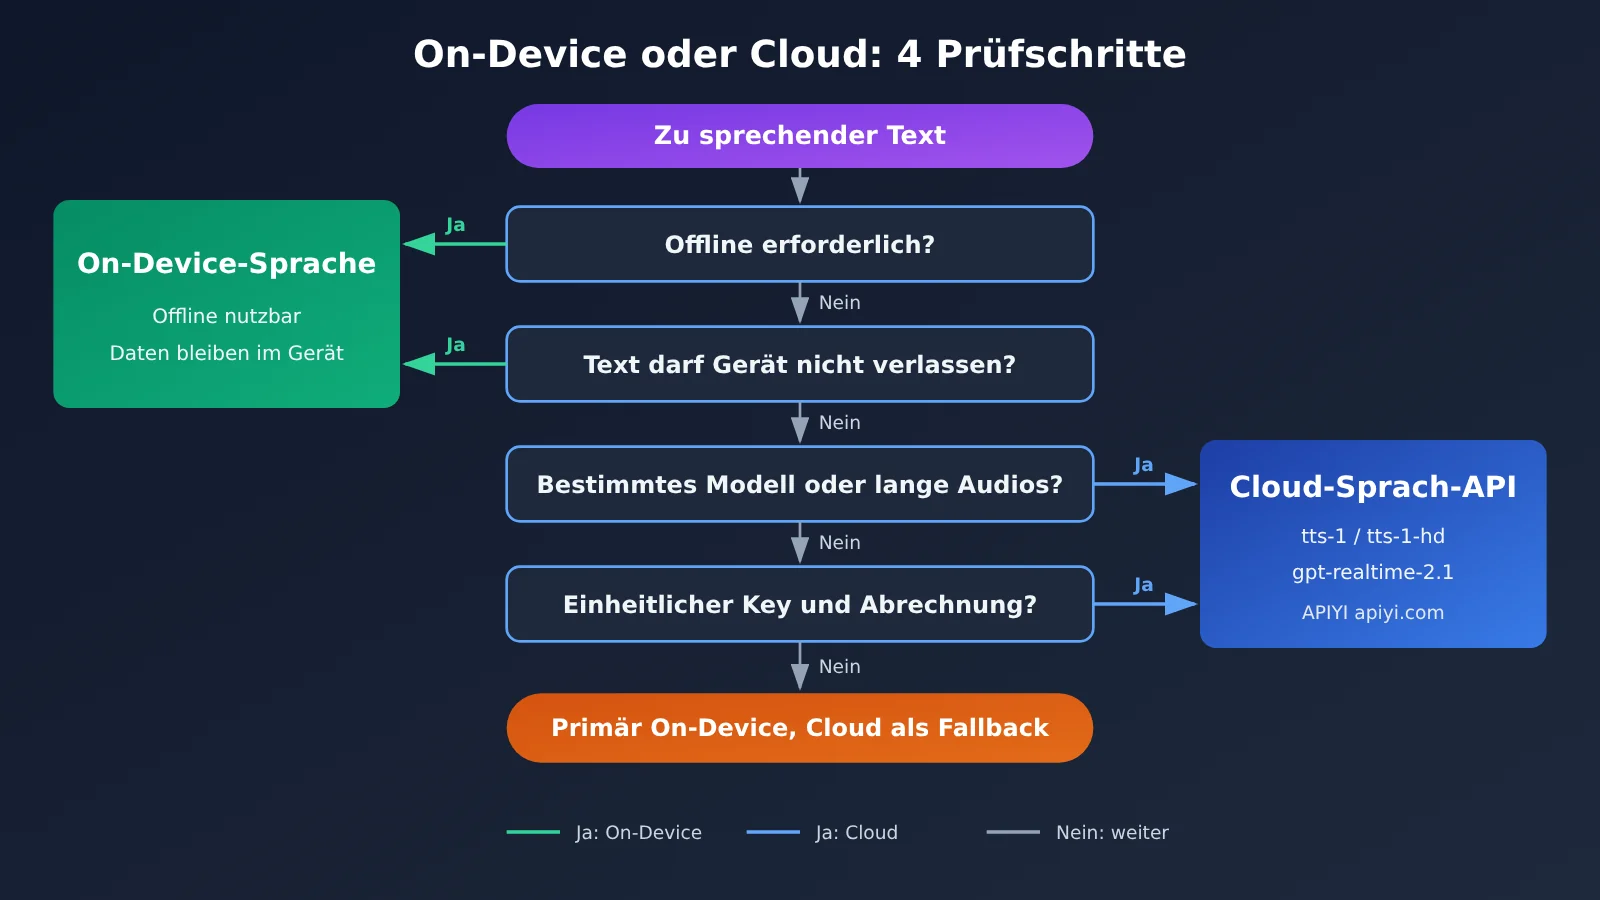
Wie sich Geräte-Sprachausgabe und Cloud-Sprach-API die Arbeit teilen
Statt darüber zu streiten, ob die Cloud bleiben soll, hilft es mehr, die Frage in vier Dimensionen zu zerlegen. Die folgende Tabelle zeigt, welche Seite in welcher Dimension besser passt und welche Fragen Sie sich bei der Entscheidung stellen sollten.
| Dimension | Besser für Geräte-Sprachausgabe | Besser für Cloud-Sprach-API | Fragen für die Entscheidung |
|---|---|---|---|
| Offline | Ohne Netz oder bei schwacher Verbindung muss trotzdem gesprochen werden | Nutzer sind überwiegend online | Muss das Produkt auch ohne Netz weiter vorlesen? |
| Datenschutz | Sensible Texte, die das Gerät nicht verlassen dürfen | Texte dürfen zur Verarbeitung hochgeladen werden | Verbieten Compliance-Vorgaben, dass Daten das Endgerät verlassen? |
| Klangqualität und lange Texte | Kurze Sätze, Hinweistöne, geringe Ansprüche an die Stimme | Langes Vorlesen, hohe Ansprüche an eine einheitliche Stimme | Ist es akzeptabel, wenn verschiedene Geräte unterschiedlich klingen? |
| Festes Modell und einheitliche Abrechnung | Kein Bedarf | Modell muss festgelegt sein, derselbe Schlüssel wie beim Textmodell | Brauchen Sie ein bestimmtes Modell wie tts-1-hd oder gpt-realtime-2.1? |
Offline und Datenschutz: das Heimspiel der Geräte-Sprachausgabe
Wird Ihr Produkt häufig in der U-Bahn, in den Bergen oder im Flugzeug genutzt, ist Offline-Fähigkeit eine harte Anforderung, und die Geräte-Sprachausgabe sollte den Großteil der Ansagen übernehmen. Ebenso gilt: Wenn Texte der Nutzer laut Vorgabe nicht hochgeladen werden dürfen, ist die Geräte-Sprachausgabe fast die einzige Option. In diesen beiden Dimensionen ist die Cloud-Sprach-API eher eine Verbesserung für den Fall, dass eine Verbindung besteht, und nicht die Hauptlösung.
Klangqualität, lange Texte und festes Modell: das Heimspiel der Cloud-Sprach-API
Sobald Ihr Produkt eine einheitliche Markenstimme braucht, lange Artikel zuverlässig vorlesen soll oder Echtzeit-Sprachdialoge führt, lässt sich die Cloud kaum ersetzen. Dort können Sie das Modell gezielt festlegen: etwa tts-1 für normale Ansagen, tts-1-hd für höhere Klangqualität und gpt-realtime-2.1 oder gpt-realtime-2.1-mini für Echtzeit-Dialoge. So hören alle Nutzer die Ausgabe desselben Modells.
Ein weiterer Punkt, der oft übersehen wird, sind Abrechnung und Schlüsselverwaltung. Neben der Sprache rufen die meisten Produkte auch ein Großes Sprachmodell für Textverständnis, Zusammenfassungen oder Dialoggenerierung auf. Laufen Sprache und Text über denselben API-Schlüssel und dieselbe Abrechnung, wird der Betrieb deutlich einfacher, und auch der Abgleich der Kosten fällt leichter.
Cloud-Sprach-API einbinden: einen stabilen Kanal als Reserve behalten
Auch wenn Sie hauptsächlich auf On-Device-Verarbeitung setzen, empfiehlt es sich, einen Cloud-Kanal als Fallback und zur Qualitätssteigerung beizubehalten. APIYI nutzt eine OpenAI-kompatible Schnittstelle. Die Anbindung läuft also fast genauso wie mit dem offiziellen SDK – Sie müssen lediglich die base_url austauschen.
Die Einrichtung lässt sich in vier Schritten zusammenfassen:
- Client initialisieren:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Sprachsynthese aufrufen:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - Für bessere Klangqualität tauschen Sie das Modell gegen
tts-1-hdaus, alle übrigen Parameter bleiben unverändert - Auch Textmodelle zeigen auf
https://api.apiyi.com/v1; Sprache und Text verwenden denselben Schlüssel
Die Verbindung für Echtzeit-Sprachdialoge (Serie gpt-realtime-2.1) funktioniert anders als eine gewöhnliche HTTP-Anfrage. Die genauen Parameter für die Anbindung entnehmen Sie bitte der Dokumentation im APIYI-Hilfecenter.
| Modell | Typ | Typischer Einsatz | Verfügbare Plattform |
|---|---|---|---|
| tts-1 | Text-zu-Sprache | Standardansagen, Vorlesen von Benachrichtigungen | APIYI apiyi.com |
| tts-1-hd | Text-zu-Sprache (hohe Qualität) | Vorlesen langer Texte, Markenstimmen | APIYI |
| gpt-realtime-2.1 | Echtzeit-Sprachdialog | Sprachassistenten, Echtzeit-Interaktion | APIYI |
| gpt-realtime-2.1-mini | Echtzeit-Sprachdialog (leichtgewichtig) | Echtzeit-Szenarien mit höherer Kostensensibilität | APIYI |
🚀 Schnellstart: Wenn Sie gerade prüfen, ob sich ein Cloud-Sprachdienst für Sie lohnt, registrieren Sie sich am besten zunächst bei APIYI (apiyi.com). Mit dem kostenlosen Testguthaben für Neukunden lassen Sie denselben Text einmal von tts-1 und einmal von tts-1-hd sprechen und vergleichen beides mit der lokalen Vorlesefunktion Ihres Geräts. So sehen Sie, ob sich der Qualitätsunterschied die Kosten wert ist.
Auswirkungen von On-Device-Sprache
Auswirkungen auf Entwickler
- Die Architektur wird vom Entweder-oder zum Hybrid: Das Sprachmodul braucht eine Routing-Schicht, die nach Netzwerkstatus, Sensibilität und Länge des Textes entscheidet, ob lokal oder in der Cloud verarbeitet wird
- Der Testaufwand steigt: Die Qualität auf dem Gerät hängt vom Endgerät des Nutzers ab. Man muss also stichprobenartig verschiedene Gerätemodelle und Browser prüfen, während die Cloud-Ausgabe vergleichsweise einheitlich bleibt
- Fallback-Logik wird unverzichtbar: Schlägt die Cloud fehl, fällt man auf das Gerät zurück. Ist On-Device nicht verfügbar, geht es zurück in die Cloud. Beide Pfade sichern sich gegenseitig ab
Auswirkungen auf die Produktarchitektur
Am häufigsten setzt man eine Hybridarchitektur so um, dass jede Art von Sprachaufgabe einen Standardkanal und einen Ausweichkanal bekommt. Die folgende Tabelle eignet sich direkt als Ausgangspunkt für den Entwurf.
| Sprachaufgabe | Standardkanal | Ausweichkanal | Begründung |
|---|---|---|---|
| Kurze Hinweise, Navigationsansagen | On-Device-Sprache | Cloud tts-1 | Kurze Sätze lassen sich lokal erledigen, Offline-Betrieb muss funktionieren |
| Vorlesen sensibler Texte | On-Device-Sprache | Kein Fallback in die Cloud | Die Daten dürfen das Gerät nicht verlassen |
| Lange Artikel, Audioinhalte | Cloud tts-1-hd | On-Device-Sprache | Einheitliche Stimme, lange Sprachausgaben laufen stabiler |
| Echtzeit-Sprachdialog | Cloud gpt-realtime-2.1 | gpt-realtime-2.1-mini | Modell muss explizit angegeben werden, Echtzeitinteraktion hängt von der Cloud ab |
Auswirkungen auf die Kostenrechnung
On-Device-Sprache wird nicht pro Aufruf abgerechnet. Das ist für viele Teams der Grund, die gesamte Sprachausgabe lokal laufen lassen zu wollen. Man sollte aber bedenken, dass die eingesparten Aufrufkosten sich in Anpassungs- und Testaufwand verwandeln können. Dazu kommt der Verlust von Nutzern, die auf schwächeren Geräten eine schlechtere Erfahrung haben. Sinnvoller ist es, nur häufige kurze Sätze auf das Gerät zu verlagern und qualitätskritische Aufgaben in der Cloud zu belassen. So sinkt das Cloud-Aufrufvolumen von selbst, ohne dass die entscheidenden Erlebnisse leiden.
Häufige Fragen (FAQ)
Q1: Wenn Sprachfunktionen jetzt auf dem Gerät laufen, kann ich dann die Cloud-Sprach-API einfach abschalten?
Für die meisten Produkte würden wir davon abraten. Die Verarbeitung auf dem Gerät löst Offline-Nutzung und Datenschutz, aber bei der Wahl bestimmter Modelle, der Stabilität bei langen Sprachausgaben und der Stimmkonsistenz bleibt man weiterhin auf die Cloud angewiesen. Sicherer ist es, das Gerät als Hauptlösung zu nutzen und die Cloud als Fallback und für Zusatzfunktionen zu behalten.
Q2: Wie groß sind die Unterschiede bei Klangqualität und Latenz zwischen Sprachausgabe auf dem Gerät und der Cloud-Sprach-API?
Aktuell gibt es keine einheitlichen, öffentlich zitierbaren Messwerte. Auch die Leistung der einzelnen On-Device-Lösungen hängt stark vom jeweiligen Gerät ab, deshalb behandeln wir die Frage hier als offen. Wir empfehlen, auf einigen der bei Ihren Zielnutzern gängigen Geräte Stichproben anzuhören und mit der Ausgabe der Cloud-Modelle tts-1 und tts-1-hd zu vergleichen.
Q3: Welche Sprachmodelle lassen sich aktuell in der Cloud aufrufen?
Stand 12.11.2026 bietet die APIYI-Preisliste weiterhin tts-1 und tts-1-hd sowie für Echtzeit-Sprache gpt-realtime-2.1 und gpt-realtime-2.1-mini an. Die Modellliste kann sich jederzeit ändern – maßgeblich ist die aktuelle Preisliste auf der Plattform.
Q4: Wie rufe ich Sprach- und Textmodelle mit nur einem Schlüssel auf?
Beantragen Sie über APIYI (apiyi.com) einen API-Schlüssel und setzen Sie die base_url auf `https://api.apiyi.com/v1`. Sprachsynthese, Echtzeit-Sprache und Textmodelle wie GPT, Claude oder Gemini laufen dann über denselben Zugang. Die Abrechnung wird ebenfalls zusammengeführt, sodass sich der nutzungsbasierte Verbrauch bequem abgleichen lässt.
Q5: Was tun, wenn in der Hybrid-Architektur ein Cloud-Aufruf fehlschlägt?
Bauen Sie in der Routing-Schicht für Sprache eine Rückfallstufe ein: Läuft eine Cloud-Anfrage in einen Timeout oder liefert einen Fehler, können nicht sensible, kurze Sätze auf dem Gerät vorgelesen werden. Bei langen Sprachausgaben können Sie Nutzer bitten, es später noch einmal zu versuchen. In Echtzeit-Dialogszenarien lässt sich zwischen gpt-realtime-2.1 und gpt-realtime-2.1-mini umschalten.
Kernaussagen: Sprachausgabe auf dem Gerät vs. Cloud-Sprach-API
- Kein Entweder-oder: Sprachausgabe auf dem Gerät und Cloud-Sprach-APIs ergänzen sich – Aufgaben werden je nach Kanal verteilt
- Auf dem Gerät: Offline und Datenschutz: Funktioniert ohne Netz, die Daten bleiben auf dem Gerät – ideal für kurze Sätze und Hinweistöne
- In der Cloud: Qualität und Konsistenz: Für lange Sprachausgaben, Markenstimmen und Echtzeit-Dialoge braucht es weiterhin Cloud-Modelle
- Bestimmte Modelle gibt es nur in der Cloud: Wer tts-1-hd oder gpt-realtime-2.1 gezielt festlegen will, muss die API nutzen
- Leistungsdaten fürs Gerät unbekannt: Wo es keine öffentlichen Zahlen gibt, zählen Stichproben auf den eigenen Geräten
- Ein einheitlicher Schlüssel spart Betriebsaufwand: Über APIYI (apiyi.com) teilen sich Sprach- und Textmodelle einen API-Schlüssel und eine Abrechnung
Fazit
Wenn die Sprachausgabe auf dem Gerät läuft: Braucht man dann überhaupt noch eine Cloud-Sprach-API? Das hängt von vier Kriterien ab:
- Offline: Aufgaben, die ohne Netzverbindung funktionieren müssen, übernimmt die Sprachausgabe auf dem Gerät
- Datenschutz: Aufgaben, bei denen Text das Gerät nicht verlassen darf, laufen ausschließlich auf dem Gerät
- Klangqualität und lange Sprachausgaben: Aufgaben mit hohen Ansprüchen an Konsistenz und Stabilität bleiben in der Cloud
- Bestimmte Modelle und gemeinsame Abrechnung: Wer ein konkretes Modell festlegen oder mit den Textmodellen einen gemeinsamen API-Schlüssel nutzen möchte, setzt weiter auf die Cloud-API
Das Ergebnis ist eindeutig: Das Gerät löst Offline und Datenschutz, bestimmte Modelle und eine gemeinsame Abrechnung bleiben Sache der Cloud. Am besten verlagern Sie zuerst die besonders häufig genutzten kurzen Sätze auf das Gerät und lassen lange Sprachausgaben sowie Echtzeit-Dialoge in der Cloud. Über APIYI (apiyi.com) rufen Sie tts-1, tts-1-hd und die gpt-realtime-2.1-Reihe einheitlich auf. Mit dem kostenlosen Testguthaben prüfen Sie die Wirkung, bevor Sie das Verhältnis der einzelnen Kanäle festlegen.
📚 Referenzen
- APIYI-Dokumentationszentrum: Hinweise zu Sprachsynthese und Echtzeit-Spracheinbindung
- Link:
docs.apiyi.com -
Beschreibung: Aufrufparameter und Einbindung von Modellen wie tts-1 und gpt-realtime-2.1
-
APIYI-Hilfezentrum: Anleitungen zur Plattform und häufige Fragen
- Link:
help.apiyi.com - Beschreibung: Praktisch für den ersten Einstieg, etwa zu API-Schlüssel-Beantragung, Abrechnung und Modellliste
Autor: APIYI-Technikteam
Fachaustausch: Schreiben Sie uns gern über die Startseite von APIYI (apiyi.com). Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com