Nota del autor: cuando los móviles y los navegadores ya pueden sintetizar voz en local, ¿sigue haciendo falta una API de voz en la nube? Este artículo te da un criterio desde 4 dimensiones: uso sin conexión, privacidad, calidad de audio y voz larga, y modelo específico con facturación unificada.
Cada vez más sistemas móviles y navegadores pueden leer texto en voz alta directamente en local. Con la voz en el dispositivo ya disponible, ¿hace falta conservar la API de voz en la nube? Es una pregunta que ningún equipo que desarrolle productos de voz puede esquivar. Unos defienden pasarlo todo a local para ahorrarse el coste de las llamadas; otros temen que las voces locales no den la talla para un producto en producción.
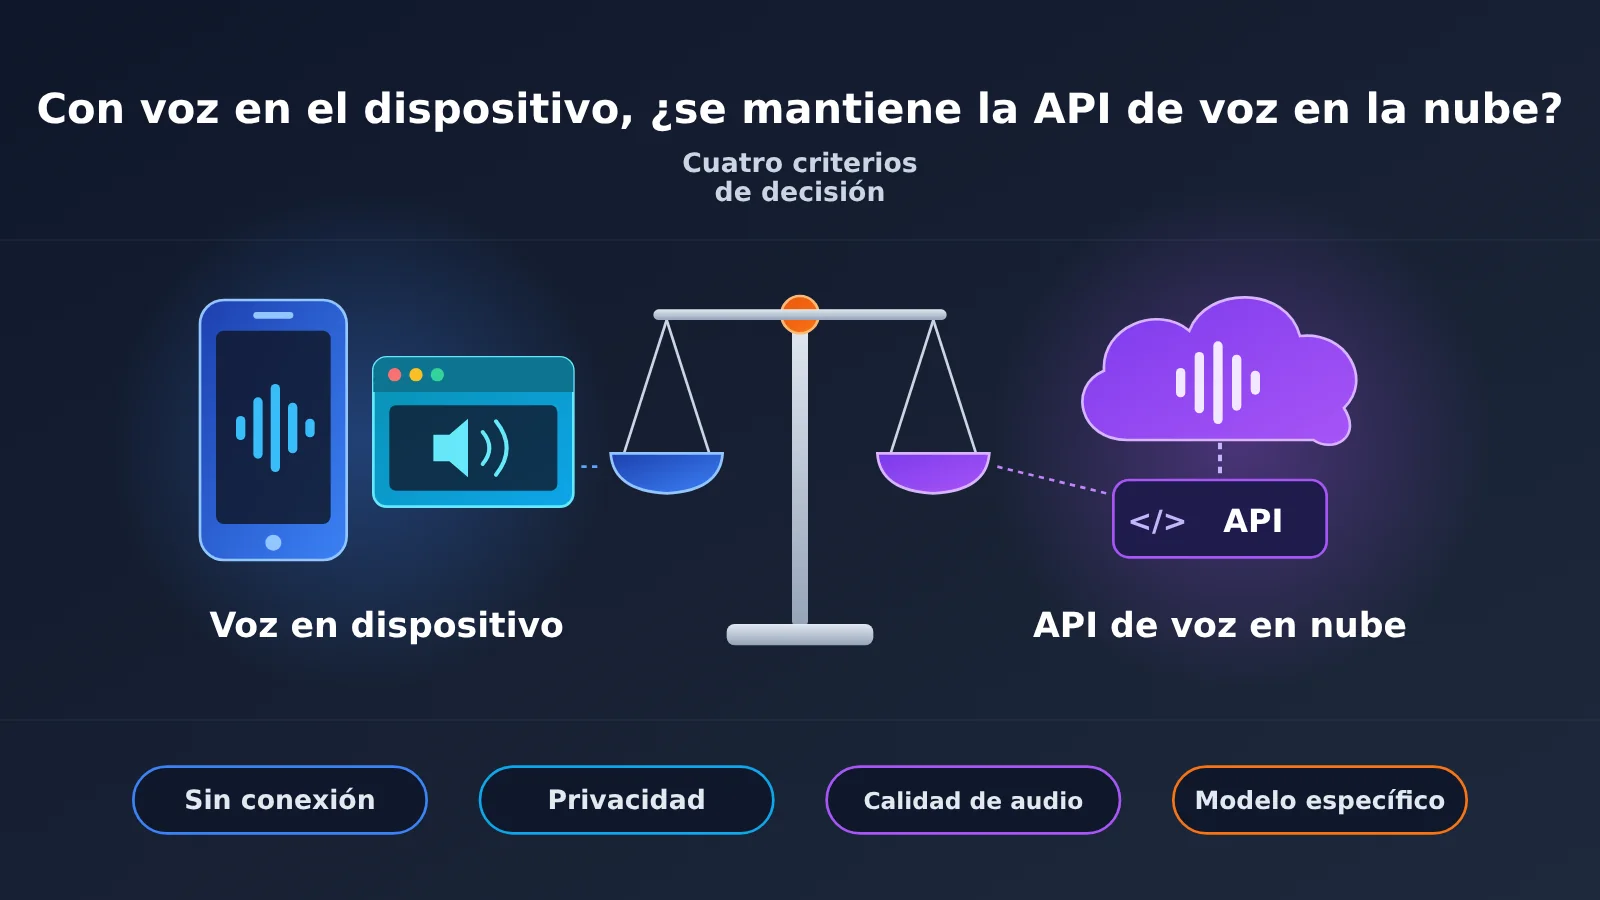
No es una elección de blanco o negro. El dispositivo y la nube tienen cada uno sus límites, y la decisión depende de si tu producto necesita funcionar sin conexión, de lo sensible que sea en materia de privacidad, de lo exigente que seas con la calidad de audio y la voz larga, y de si estás obligado a usar un modelo concreto.
Valor central: al terminar el artículo podrás evaluar, dimensión por dimensión (son 4), cómo repartir el trabajo entre el dispositivo y la nube en tu producto, sin tener que tomar una decisión radical.
El TTS en el dispositivo ya está aquí: resumen de lo esencial
Primero separemos lo que podemos confirmar de lo que todavía no está claro. La tendencia del TTS en el dispositivo es evidente, pero en cuanto a latencia y calidad de audio de cada modelo local concreto, no hay cifras públicas comparables en cantidad suficiente. Este artículo no especula: todo eso se marca como desconocido.
| Elemento | Detalle |
|---|---|
| Cambio | El sistema del móvil y el navegador pueden hacer la conversión de texto a voz en local, sin conexión a internet |
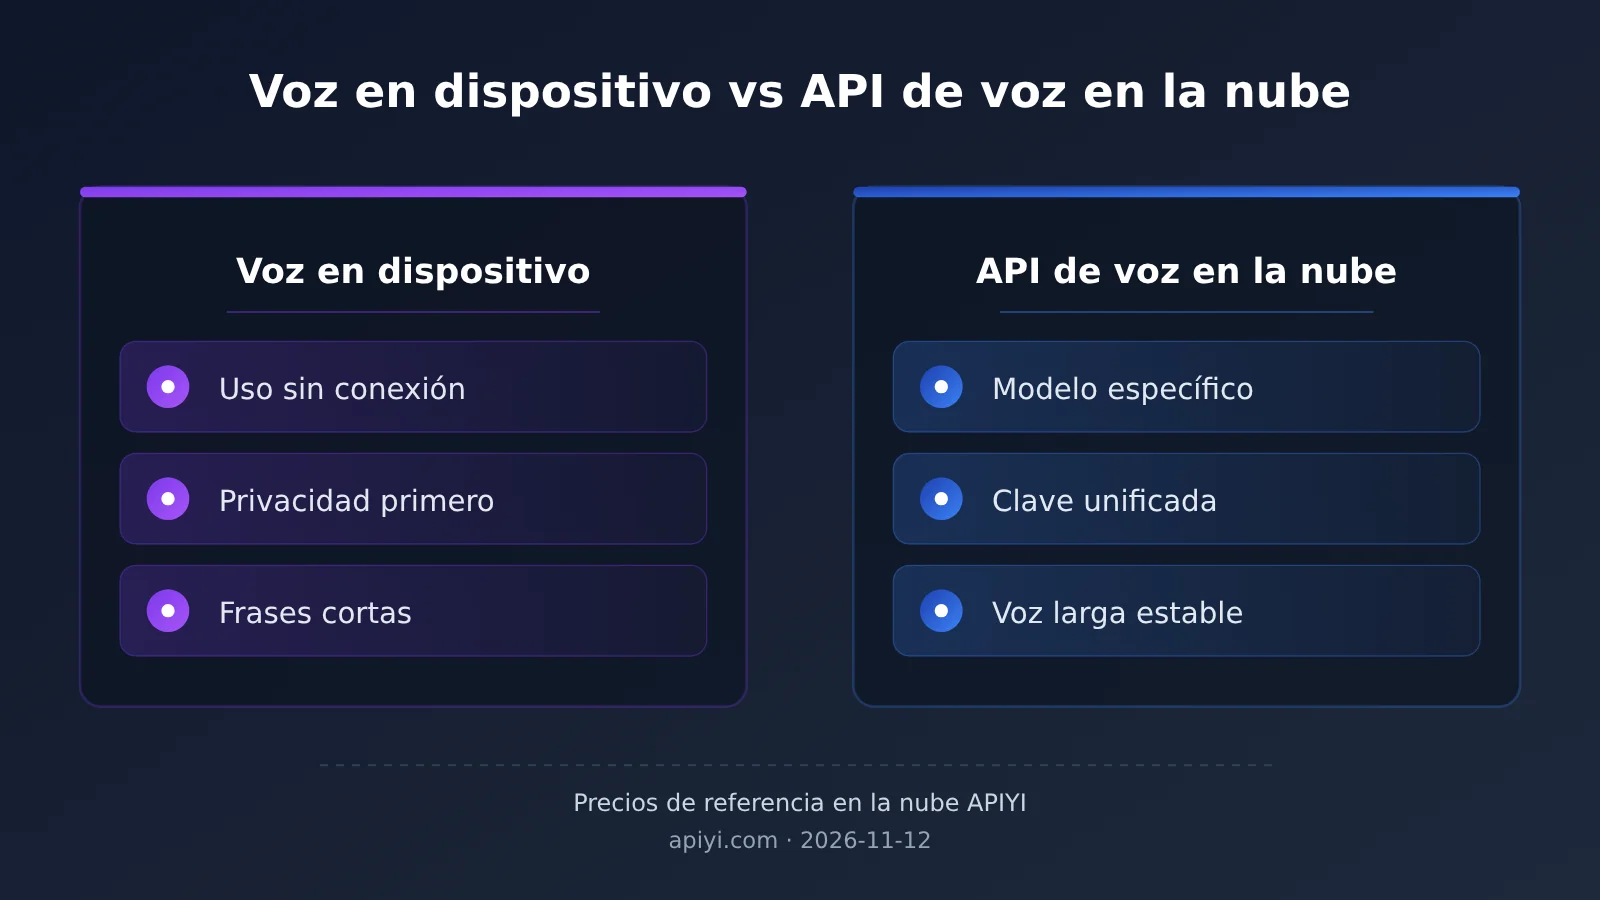
| Puntos fuertes del dispositivo | Funciona sin conexión, los datos no salen del dispositivo, ideal para frases cortas |
| Incógnitas del dispositivo | No hay datos públicos unificados de latencia ni de puntuación de calidad de audio para las distintas soluciones locales; se tratan como desconocidos |
| Puntos fuertes de la nube | Permite elegir un modelo concreto, comparte una misma clave con los modelos de texto y es más estable con audios largos |
| Modelos disponibles en la nube | A fecha de 2026-11-12, en la lista de precios de APIYI siguen estando tts-1, tts-1-hd, gpt-realtime-2.1 y gpt-realtime-2.1-mini |
| A quién afecta | Equipos de producto que trabajan con locución, asistentes de voz y conversación de voz en tiempo real |
Qué puede hacer el TTS en el dispositivo y qué no puede garantizar
La ventaja más directa del TTS en el dispositivo es que «suena aunque no haya red». En escenarios como avisos de navegación, ayudas de lectura o sonidos breves dentro de una app, las frases son cortas y se repiten mucho, así que la síntesis local basta y además te ahorras un viaje de ida y vuelta por la red. Como los datos se quedan en el dispositivo, en productos que manejan textos sensibles (salud, finanzas, etc.) la presión de cumplimiento normativo también baja bastante.
Eso sí, las voces y la calidad que puede ofrecer el TTS en el dispositivo dependen del propio equipo del usuario. Un mismo producto puede sonar completamente distinto en móviles de distintas marcas y con distintas versiones del sistema, y al desarrollador le cuesta garantizar una experiencia uniforme. En cuanto a cuánto más lento es un modelo local concreto frente a la nube, o cuánto peor suena, ahora mismo no hay cifras públicas fiables; para decidir, lo mejor es hacer un muestreo con los dispositivos reales de tu propio producto.
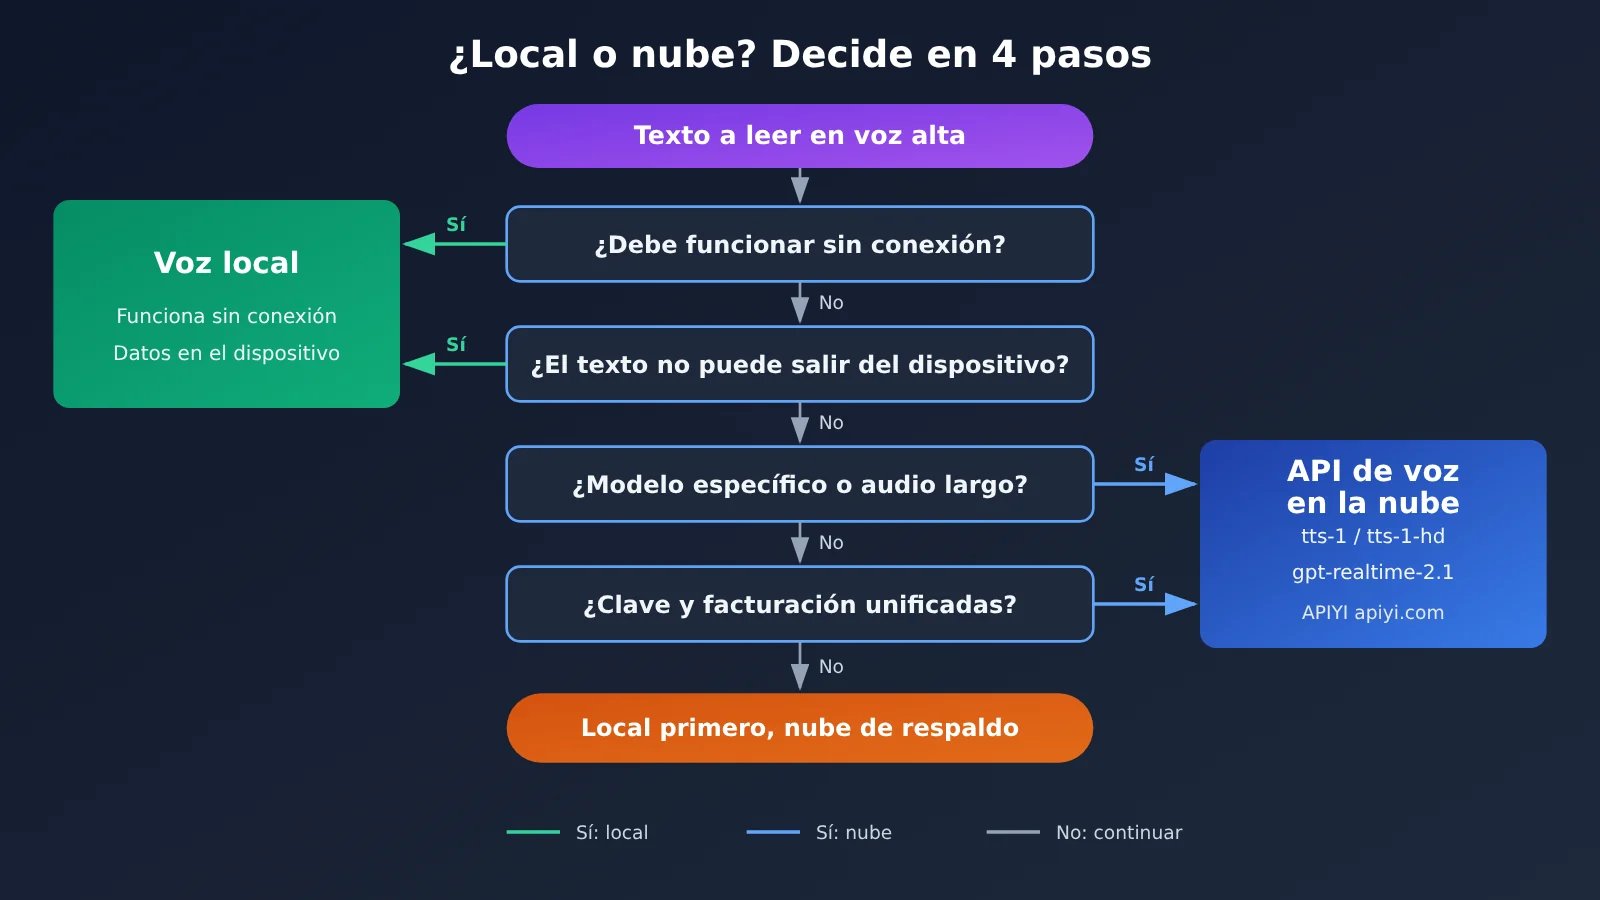
Cómo repartir el trabajo entre la voz en el dispositivo y la API de voz en la nube
Dividir el problema en 4 dimensiones funciona mejor que discutir si «hay que quedarse con la nube o no». La siguiente tabla muestra qué lado encaja mejor en cada dimensión y qué preguntas conviene hacerse para decidir.
| Dimensión | Más adecuada la voz en el dispositivo | Más adecuada la API de voz en la nube | Pregunta que conviene hacerse |
|---|---|---|---|
| Sin conexión | Debe hablar aunque no haya red o esta sea débil | El usuario casi siempre está en línea | ¿El producto tiene que seguir locutando cuando se corta la red? |
| Privacidad | Texto sensible, no puede salir del dispositivo | El texto se puede subir para procesarlo | ¿La normativa prohíbe que los datos salgan del terminal? |
| Calidad de audio y voz larga | Frases cortas, tonos de aviso, sin grandes exigencias de timbre | Lectura de textos largos, alta exigencia de consistencia de timbre | ¿Es aceptable que cada dispositivo lea con una voz distinta? |
| Modelo específico y facturación unificada | No hay esta necesidad | Hay que fijar el modelo y usar la misma clave que el modelo de texto | ¿Necesitas fijar un modelo concreto como tts-1-hd o gpt-realtime-2.1? |
Sin conexión y privacidad: el terreno de la voz en el dispositivo
Si tu producto se usa a menudo en el metro, en zonas de montaña o en un avión, funcionar sin conexión es un requisito imprescindible, y la voz en el dispositivo debería encargarse de la mayor parte de las locuciones. Del mismo modo, si la normativa del negocio establece que el texto introducido por el usuario no se puede subir, la voz en el dispositivo es prácticamente la única opción. En estas dos dimensiones, la API de voz en la nube funciona más como un «refuerzo cuando hay red» que como la pieza principal.
Calidad de audio, voz larga y modelo específico: el terreno de la API de voz en la nube
En cuanto el producto necesita un timbre de marca unificado, leer artículos largos de forma estable o mantener conversaciones de voz en tiempo real, la nube es muy difícil de sustituir. En la nube puedes indicar el modelo de forma explícita: por ejemplo, tts-1 para las locuciones habituales, tts-1-hd cuando buscas mayor calidad de audio, y gpt-realtime-2.1 o gpt-realtime-2.1-mini para la conversación en tiempo real. Así, todos los usuarios escuchan la salida del mismo modelo.
Otro punto que se suele pasar por alto es la facturación y la gestión de claves. Además de la voz, la mayoría de los productos también invocan Modelos de Lenguaje Grande de texto para comprender, resumir o generar diálogos. Si la voz y el texto usan la misma clave y la misma factura, la operación y la conciliación de cuentas se vuelven mucho más sencillas.
Cómo integrar la API de voz en la nube: mantén un canal estable
Aunque decidas apostar principalmente por el procesamiento en el dispositivo, conviene conservar un canal en la nube como respaldo y refuerzo. APIYI usa una interfaz compatible con OpenAI, así que la integración es prácticamente igual a llamar al SDK oficial: solo hay que cambiar el base_url.
Los pasos de integración se resumen así:
- Inicializar el cliente:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Llamar a la síntesis de voz:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - Si necesitas mayor calidad de audio, cambia el modelo a
tts-1-hdy deja el resto de parámetros igual - Los modelos de texto también apuntan a
https://api.apiyi.com/v1, de modo que voz y texto comparten la misma clave
La conexión para el diálogo de voz en tiempo real (serie gpt-realtime-2.1) funciona distinto a una petición HTTP normal; para los parámetros concretos de integración, consulta lo que indica el centro de documentación de APIYI.
| Modelo | Tipo | Uso típico | Plataforma disponible |
|---|---|---|---|
| tts-1 | Texto a voz | Locución habitual, lectura de notificaciones | APIYI apiyi.com |
| tts-1-hd | Texto a voz (alta calidad) | Lectura de textos largos, voces de marca | APIYI |
| gpt-realtime-2.1 | Diálogo de voz en tiempo real | Asistentes de voz, interacción en tiempo real | APIYI |
| gpt-realtime-2.1-mini | Diálogo de voz en tiempo real (ligero) | Escenarios en tiempo real más sensibles al costo | APIYI |
🚀 Primeros pasos: si estás evaluando si te conviene mantener la voz en la nube, regístrate primero en APIYI apiyi.com y usa el crédito de prueba gratuito para nuevos usuarios: pasa el mismo texto por tts-1 y por tts-1-hd, compáralos con la lectura local del dispositivo y decide si la diferencia justifica pagar.
Impacto del lanzamiento de la voz en el dispositivo
Impacto para los desarrolladores
- La arquitectura pasa de una sola opción a un modelo híbrido: el módulo de voz necesita una capa de enrutamiento que decida si la tarea se procesa en el dispositivo o en la nube según el estado de la red, la sensibilidad del texto y su longitud.
- Los costes de pruebas aumentan: el resultado en el dispositivo depende del equipo del usuario, así que hay que muestrear distintos modelos de móvil y navegadores, mientras que la salida en la nube es relativamente uniforme.
- La lógica de respaldo se vuelve imprescindible: si la nube falla, se degrada al dispositivo; si el dispositivo no está disponible, se vuelve a la nube. Los dos caminos se respaldan mutuamente.
Impacto en la arquitectura del producto
La forma más habitual de implantar una arquitectura híbrida es asignar a cada tipo de tarea de voz un canal por defecto y un canal de respaldo. La siguiente tabla puede servirte directamente como punto de partida para el diseño.
| Tarea de voz | Canal por defecto | Canal de respaldo | Motivo |
|---|---|---|---|
| Avisos cortos, indicaciones de navegación | Voz en el dispositivo | tts-1 en la nube | Las frases cortas se resuelven en local y debe funcionar sin conexión |
| Lectura de texto sensible | Voz en el dispositivo | No se degrada a la nube | Los datos no pueden salir del dispositivo |
| Artículos largos, contenido en audio | tts-1-hd en la nube | Voz en el dispositivo | Timbre consistente y mayor estabilidad en audios largos |
| Conversación de voz en tiempo real | gpt-realtime-2.1 en la nube | gpt-realtime-2.1-mini | Requiere un modelo concreto y la interacción en tiempo real depende de la nube |
Impacto en el cálculo de costes
La voz en el dispositivo no se factura por invocación, y esa es la razón por la que muchos equipos quieren migrar toda la voz a local. Pero ojo: lo que ahorras en llamadas puede convertirse en costes de adaptación y de pruebas, además de en usuarios que se van porque la experiencia empeora en dispositivos de gama baja. Lo más razonable es migrar al dispositivo solo las frases cortas de alta frecuencia y dejar en la nube las tareas sensibles a la calidad. Así el volumen de llamadas a la nube baja de forma natural, sin afectar a las experiencias clave.
Preguntas frecuentes (FAQ)
P1: Si ya tengo voz en el dispositivo, ¿puedo apagar directamente la API de voz en la nube?
En la mayoría de los productos no lo recomendamos. La voz en el dispositivo resuelve el uso sin conexión y la privacidad, pero si necesitas un modelo concreto, estabilidad con audios largos o consistencia de timbre, todavía dependes de la nube. Lo más sensato es usar el dispositivo como opción principal y la nube como respaldo y refuerzo.
P2: ¿Cuánta diferencia hay en calidad de audio y latencia entre la voz en el dispositivo y la API de voz en la nube?
Por ahora no hay cifras de evaluación públicas y unificadas que se puedan citar, y el rendimiento de cada solución en el dispositivo depende del equipo concreto, así que lo tratamos como desconocido. Te sugerimos hacer pruebas de escucha con una muestra de los dispositivos que más usan tus usuarios y compararlas con la salida de tts-1 y tts-1-hd en la nube.
P3: A día de hoy, ¿qué modelos de voz en la nube se pueden invocar?
A fecha de 2026-11-12, en la lista de precios de APIYI siguen disponibles tts-1 y tts-1-hd, además de gpt-realtime-2.1 y gpt-realtime-2.1-mini para voz en tiempo real. La lista de modelos puede cambiar en cualquier momento, así que consulta siempre los precios en vivo de la plataforma.
P4: ¿Cómo uso una sola clave para invocar modelos de voz y de texto a la vez?
Solicita una clave API en APIYI (apiyi.com) y configura base_url como `https://api.apiyi.com/v1`. La síntesis de voz, la voz en tiempo real y los modelos de texto como GPT, Claude o Gemini pasan por el mismo punto de entrada, y la facturación también se unifica, lo que facilita conciliar el consumo por uso.
P5: En una arquitectura híbrida, ¿qué hago si falla la llamada a la nube?
Añade una capa de degradación en el enrutador de voz: si la petición a la nube agota el tiempo o devuelve un error, las frases cortas no sensibles pueden recurrir a la lectura en el dispositivo, y en los audios largos puedes pedir al usuario que lo intente de nuevo más tarde. En escenarios de conversación en tiempo real, puedes alternar entre gpt-realtime-2.1 y gpt-realtime-2.1-mini.
Puntos clave: voz en el dispositivo vs. API de voz en la nube (Key Takeaways)
- No es una u otra: la voz en el dispositivo y la API de voz en la nube se reparten el trabajo; cada tarea va por el canal que le toca.
- El dispositivo se encarga del modo offline y la privacidad: funciona sin red y los datos no salen del equipo, ideal para frases cortas y avisos sonoros.
- La nube se encarga de la calidad y la coherencia: la voz larga, los timbres de marca y las conversaciones en tiempo real siguen necesitando modelos en la nube.
- Si necesitas un modelo concreto, solo la nube sirve: para fijar tts-1-hd o gpt-realtime-2.1 hay que pasar por la API.
- Se desconoce el rendimiento en el dispositivo: donde no hay cifras públicas, lo mejor es medir con muestras en tus propios equipos.
- Una sola clave reduce el mantenimiento: con APIYI (apiyi.com), los modelos de voz y de texto comparten la misma clave y la misma facturación.
Conclusión
Ya tienes voz en el dispositivo, pero ¿merece la pena conservar la API de voz en la nube? La respuesta depende de 4 dimensiones:
- Offline: las tareas que deben funcionar sin conexión se las dejas a la voz en el dispositivo.
- Privacidad: las tareas cuyo texto no puede salir del equipo van solo por el dispositivo.
- Calidad de audio y voz larga: las tareas que exigen coherencia y estabilidad se quedan en la nube.
- Modelo concreto y facturación unificada: las tareas que requieren fijar un modelo específico y compartir una sola clave con los modelos de texto siguen usando la API en la nube.
La conclusión es clara: el dispositivo resuelve el modo offline y la privacidad, mientras que la nube sigue encargándose del modelo específico y de la facturación unificada. Te recomendamos migrar primero las frases cortas más frecuentes al dispositivo y dejar en la nube la voz larga y las conversaciones en tiempo real. Con APIYI (apiyi.com) puedes invocar de forma unificada tts-1, tts-1-hd y la serie gpt-realtime-2.1; prueba el resultado con el crédito de prueba gratuito y, después, decide qué proporción asignar a cada canal.
📚 Referencias
- Centro de documentación de APIYI: guía de síntesis de voz y acceso a voz en tiempo real
- Enlace:
docs.apiyi.com -
Descripción: consulta los parámetros de invocación y las formas de integración de modelos como tts-1 y gpt-realtime-2.1
-
Centro de ayuda de APIYI: tutoriales de uso de la plataforma y preguntas frecuentes
- Enlace:
help.apiyi.com - Descripción: ideal para consultar en tu primera integración cómo solicitar la clave API, la facturación y la lista de modelos
Autor: equipo técnico de APIYI
Intercambio técnico: te invitamos a contactarnos desde la página principal de apiyi.com. Encontrarás más materiales en el centro de documentación docs.apiyi.com