作者注:手机和浏览器能在本地合成语音之后,云端语音 API 还要不要留?本文从离线、隐私、音质与长语音、指定模型与统一账单 4 个维度给出判断。
越来越多的手机系统和浏览器可以直接在本地把文字读出来,端侧语音上了,云端语音 API 还要留吗,成了做语音产品的团队绕不开的问题。有人主张全部切到本地省掉调用费,也有人担心本地音色撑不起正式产品。
这不是一道非此即彼的选择题。端侧和云端各有边界,取决于你的产品要不要离线、对隐私有多敏感、对音质和长语音有多高要求,以及是否必须指定某个具体模型。
核心价值:读完本文,你可以按 4 个维度逐项判断自己的产品该怎么分配端侧和云端,不用一刀切。
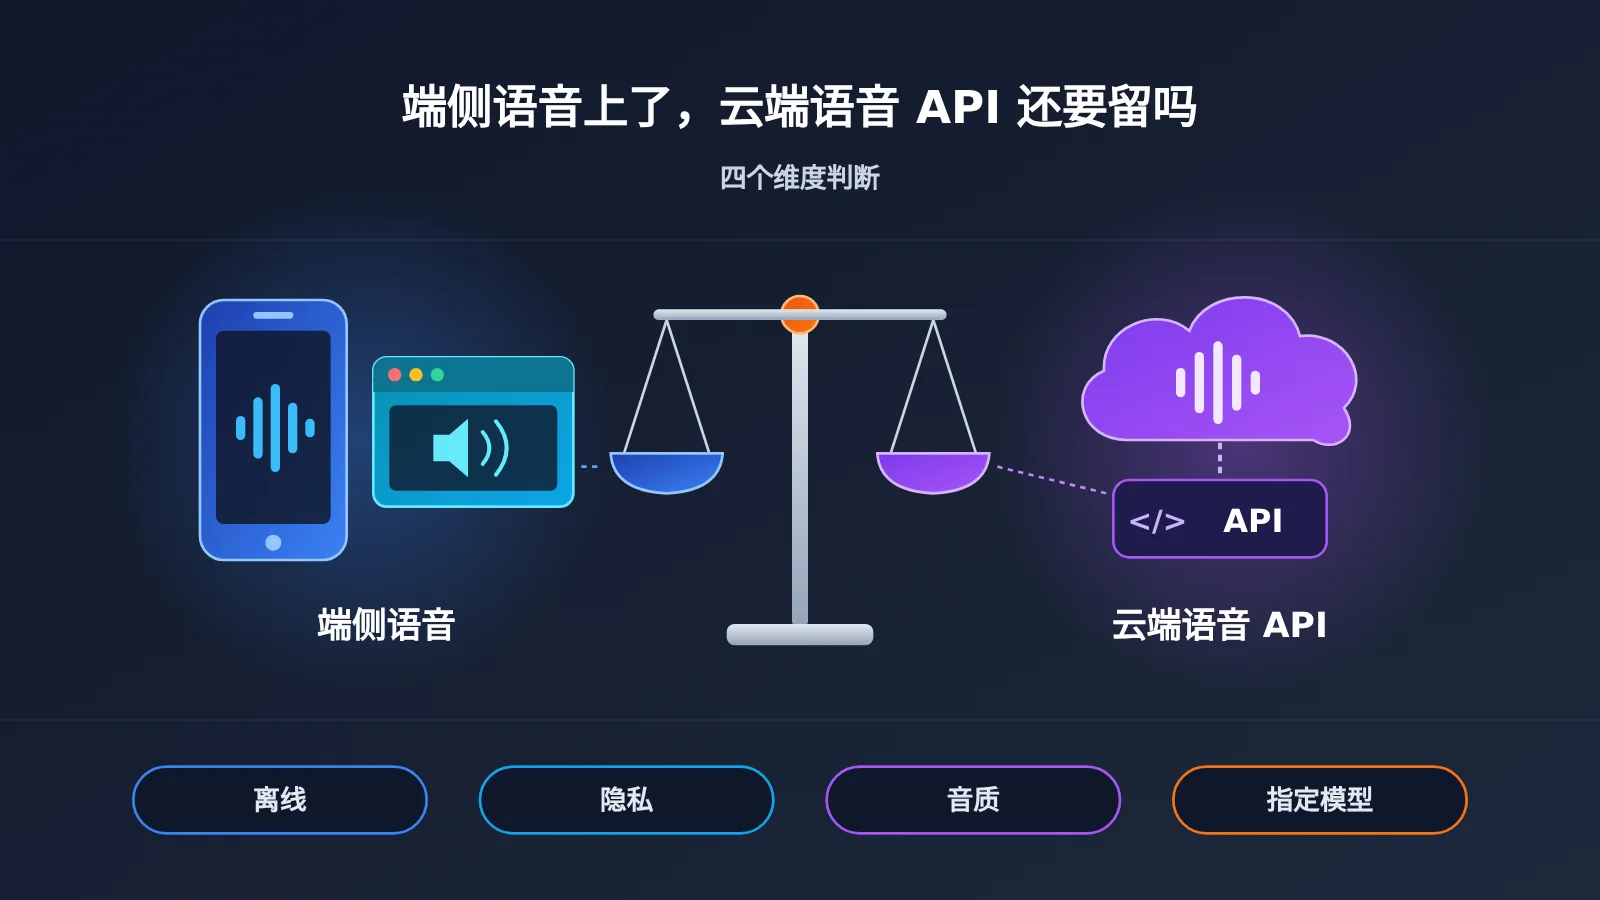
端侧语音上了:核心信息速览
先把目前能确认的信息和尚不清楚的信息分开。端侧语音的大方向很明确,但具体到某个本地模型的延迟和音质,公开可比的数字并不充分,本文不做猜测,统一标为未知。
| 信息项 | 详情 |
|---|---|
| 变化 | 手机系统和浏览器可在本地完成文字转语音,无需联网 |
| 端侧强项 | 离线可用、数据不出设备、适合短句播报 |
| 端侧未知项 | 各端侧方案的延迟、音质评分没有统一公开数据,按未知处理 |
| 云端强项 | 可指定具体模型、与文本模型共用一套 Key、长语音更稳定 |
| 云端可选模型 | 截至 2026-11-12,API易价目中仍有 tts-1、tts-1-hd、gpt-realtime-2.1、gpt-realtime-2.1-mini |
| 影响对象 | 做语音播报、语音助手、实时语音对话的产品团队 |
端侧语音能做什么、不能保证什么
端侧语音最直接的收益是“没网也能出声”。导航提示、阅读辅助、App 内的短提示音这类场景,句子短、频次高,本地合成就能满足,还能省掉一次网络往返。数据留在设备上,对于涉及健康、金融等敏感文本的产品,合规压力也会小很多。
但端侧语音能提供的音色和效果,取决于用户设备本身。同一个产品,在不同品牌、不同系统版本的手机上,可能读出完全不同的声音,开发者很难保证一致体验。至于某个端侧模型具体比云端慢多少、音质差多少,目前没有可靠的公开数字,判断时应以自己产品的真实设备抽样为准。
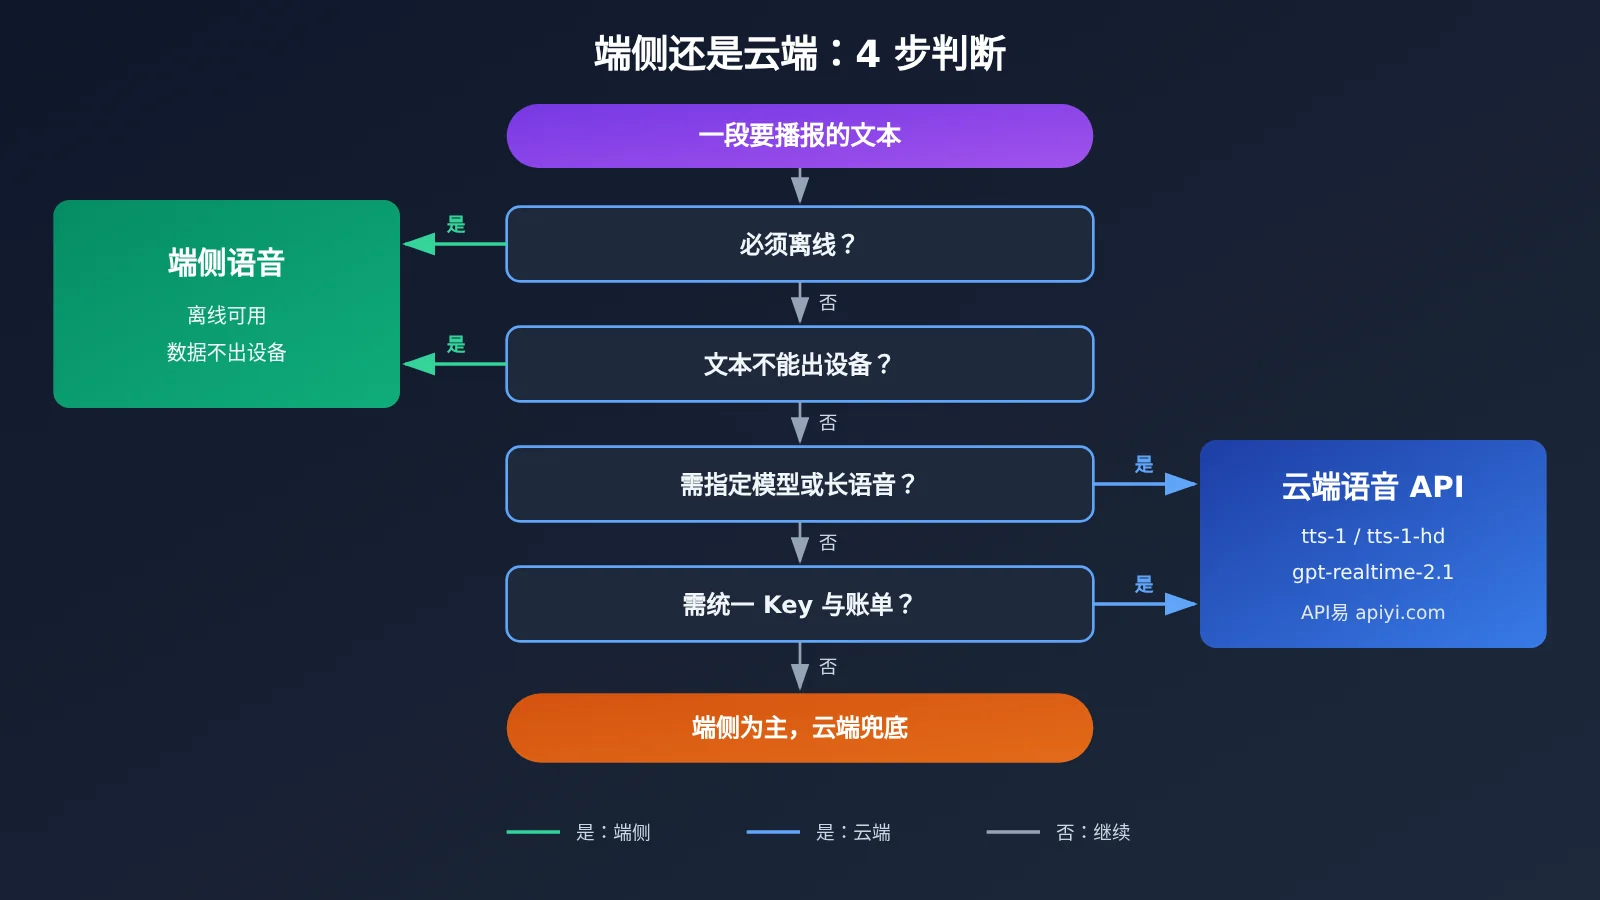
端侧语音与云端语音 API 怎么分工
把问题拆成 4 个维度,比争论“要不要留云端”更有效。下表给出每个维度上更合适的一侧,以及判断时要问自己的问题。
| 判断维度 | 更适合端侧语音 | 更适合云端语音 API | 判断时要问的问题 |
|---|---|---|---|
| 离线 | 无网、弱网环境必须出声 | 用户基本在线 | 断网时产品是否必须继续播报? |
| 隐私 | 文本敏感、不允许出设备 | 文本可上传处理 | 合规要求是否禁止数据离开终端? |
| 音质与长语音 | 短句、提示音、对音色要求不高 | 长文朗读、对音色一致性要求高 | 不同设备读出不同声音能否接受? |
| 指定模型与统一账单 | 无此需求 | 必须锁定模型、与文本模型同一套 Key | 是否需要固定 tts-1-hd 或 gpt-realtime-2.1 这类具体模型? |
离线与隐私:端侧语音的主场
如果你的产品经常在地铁、山区、飞机上被使用,离线就是硬需求,端侧语音应该承担主要播报。同理,如果业务规定用户输入的文本不能上传,端侧语音几乎是唯一选择。这两个维度上,云端语音 API 的作用更多是“有网时的增强”,而不是主力。
音质、长语音与指定模型:云端语音 API 的主场
一旦产品需要统一的品牌音色、稳定地朗读长文章,或者要做实时语音对话,云端就很难被替代。云端可以明确指定模型,例如用 tts-1 做常规播报、用 tts-1-hd 追求更高音质、用 gpt-realtime-2.1 或 gpt-realtime-2.1-mini 承担实时对话,所有用户听到的都是同一个模型的输出。
另一个常被忽略的点是账单和密钥管理。语音之外,大多数产品还在调用文本大模型做理解、摘要或对话生成,如果语音和文本走同一套 Key、同一个账单,运维和对账都会简单很多。
云端语音 API 如何接入:保留一条稳定通道
即使决定以端侧为主,也建议保留一条云端通道做兜底和增强。API易 采用 OpenAI 兼容接口,接入方式和调用官方 SDK 基本一致,只需要替换 base_url。
接入步骤可以概括为:
- 初始化客户端:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - 调用语音合成:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - 需要更高音质时,把 model 换成
tts-1-hd,其余参数保持不变 - 文本模型同样指向
https://api.apiyi.com/v1,语音与文本共用同一个 Key
实时语音对话(gpt-realtime-2.1 系列)的连接方式与普通 HTTP 请求不同,具体接入参数以 API易 文档中心的说明为准。
| 模型 | 类型 | 典型用途 | 可用平台 |
|---|---|---|---|
| tts-1 | 文字转语音 | 常规播报、通知朗读 | API易 apiyi.com |
| tts-1-hd | 文字转语音(高质量) | 长文朗读、品牌音色 | API易 |
| gpt-realtime-2.1 | 实时语音对话 | 语音助手、实时交互 | API易 |
| gpt-realtime-2.1-mini | 实时语音对话(轻量) | 对成本更敏感的实时场景 | API易 |
🚀 快速开始:如果你正在评估要不要保留云端语音,可以先在 API易 apiyi.com 注册,用新用户免费测试额度把同一段文本分别交给 tts-1 和 tts-1-hd,再和设备本地朗读放在一起对比,判断差距是否值得为之付费。
端侧语音上了之后的影响分析
对开发者的影响
- 架构从单选变成混合:语音模块需要一层路由,按网络状态、文本敏感度、文本长度决定走端侧还是云端
- 测试成本上升:端侧效果依赖用户设备,需要抽样不同机型和浏览器,而云端输出相对一致
- 兜底逻辑变得必要:云端失败时降级到端侧,端侧不可用时回退到云端,两条链路互为备份
对产品架构的影响
混合架构最常见的落地方式,是给每类语音任务定一个默认通道和一个降级通道。下面这张表可以直接作为设计起点。
| 语音任务 | 默认通道 | 降级通道 | 理由 |
|---|---|---|---|
| 短句提示、导航播报 | 端侧语音 | 云端 tts-1 | 短句本地即可,离线必须可用 |
| 敏感文本朗读 | 端侧语音 | 不降级到云端 | 数据不得出设备 |
| 长文章、有声内容 | 云端 tts-1-hd | 端侧语音 | 音色一致、长语音更稳定 |
| 实时语音对话 | 云端 gpt-realtime-2.1 | gpt-realtime-2.1-mini | 需指定模型,实时交互依赖云端 |
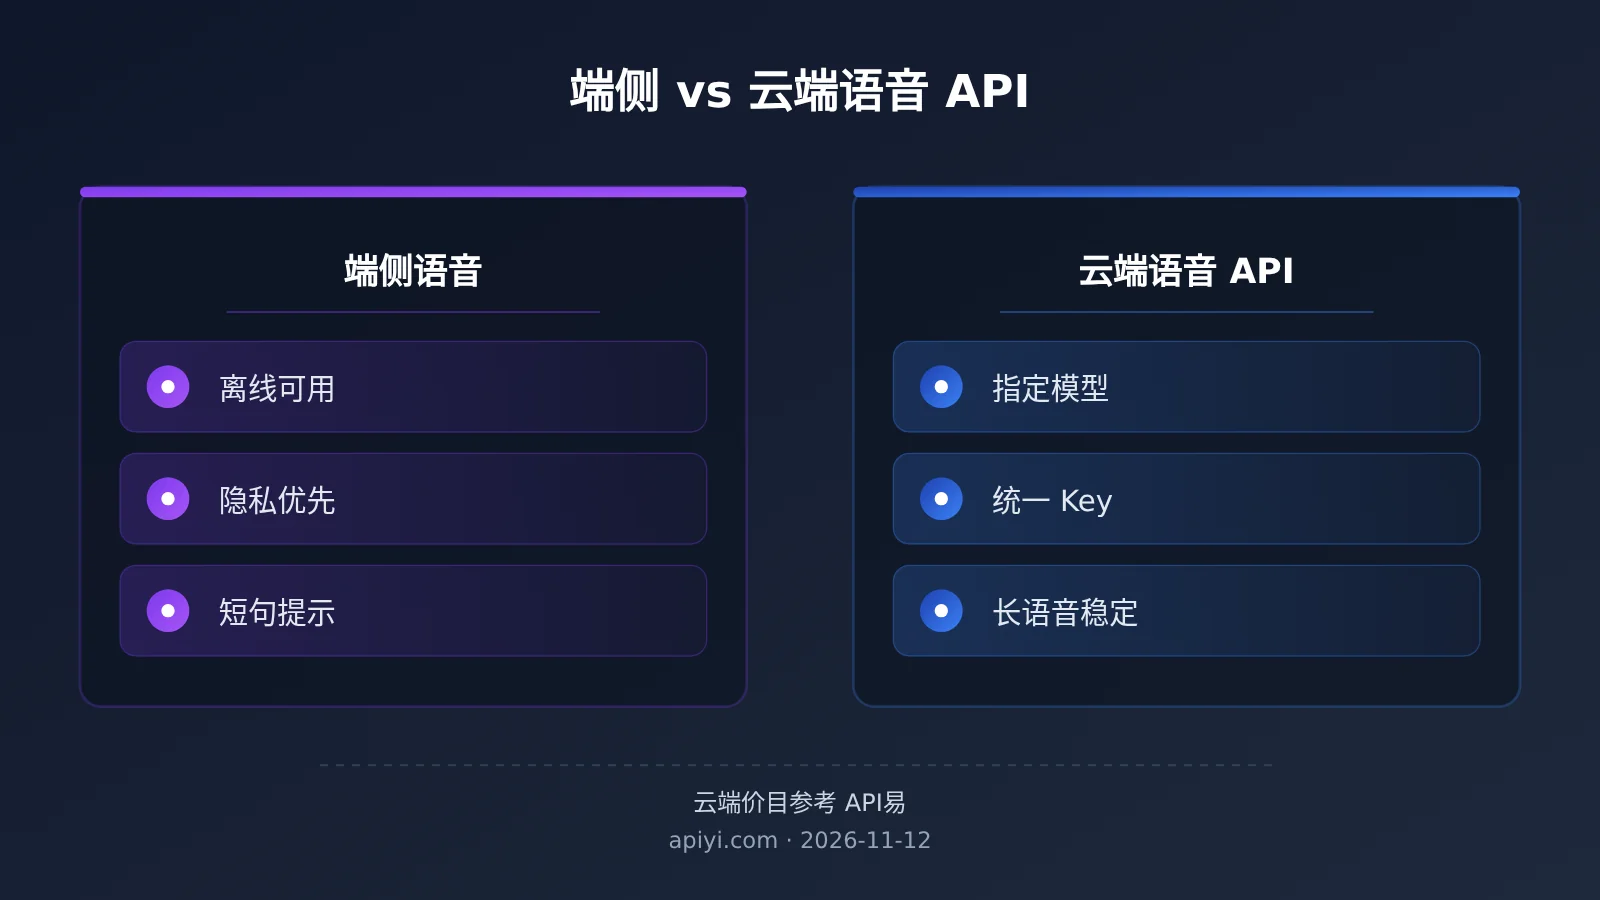
对成本核算的影响
端侧语音不按调用计费,这是很多团队想把语音全部迁到本地的原因。但要注意,省下的调用费可能转化为适配和测试成本,以及用户在低端设备上体验下降带来的流失。比较合理的做法是只把高频短句迁到端侧,把对质量敏感的任务留给云端,这样云端调用量自然下降,而关键体验不受影响。
常见问题 FAQ
Q1:端侧语音上了,云端语音 API 是不是可以直接停掉?
多数产品不建议直接停掉。端侧解决离线和隐私,但指定模型、长语音稳定性和音色一致性仍依赖云端。更稳妥的做法是端侧做主力、云端做兜底与增强。
Q2:端侧语音和云端语音 API 在音质、延迟上差多少?
目前没有统一的公开评测数字可以引用,各端侧方案的表现也依赖具体设备,因此这里按未知处理。建议在目标用户常用的几款设备上抽样试听,再和云端 tts-1、tts-1-hd 的输出做对比。
Q3:截至现在,云端还有哪些语音模型可以调用?
截至 2026-11-12,API易 价目中仍提供 tts-1、tts-1-hd,以及实时语音的 gpt-realtime-2.1 与 gpt-realtime-2.1-mini。模型列表可能随时调整,以平台实时价目为准。
Q4:如何用一套 Key 同时调用语音和文本模型?
通过 API易 apiyi.com 申请一个 API Key,把 base_url 设为 `https://api.apiyi.com/v1`,语音合成、实时语音和 GPT、Claude、Gemini 等文本模型都走同一个入口,账单也合并在一起,方便按量对账。
Q5:混合架构下,云端调用失败怎么办?
在语音路由层加一层降级:云端请求超时或报错时,非敏感短句可回退到端侧朗读,长语音可提示用户稍后重试。实时对话场景可以在 gpt-realtime-2.1 与 gpt-realtime-2.1-mini 之间切换。
端侧语音与云端语音 API 核心要点 Key Takeaways
- 不是二选一:端侧语音和云端语音 API 是分工关系,按任务分配通道
- 端侧管离线与隐私:无网可用、数据不出设备,适合短句和提示音
- 云端管质量与一致:长语音、品牌音色、实时对话仍需云端模型
- 指定模型只能靠云端:要锁定 tts-1-hd 或 gpt-realtime-2.1,必须走 API
- 端侧性能数据未知:没有公开数字的地方,以自己的设备抽样为准
- 统一 Key 降低运维:通过 API易 apiyi.com 让语音与文本模型共用一套 Key 和账单
总结
端侧语音上了,云端语音 API 还要不要留,答案取决于 4 个维度:
- 离线:必须断网可用的任务,交给端侧语音
- 隐私:文本不能出设备的任务,只走端侧
- 音质与长语音:对一致性和稳定性有要求的任务,留在云端
- 指定模型与统一账单:需要锁定具体模型、与文本模型共用一套 Key 的任务,继续用云端 API
结论很明确:端侧解决离线和隐私,指定模型和统一账单仍然交给云端。建议先把高频短句迁到端侧,再把长语音和实时对话保留在云端,通过 API易 apiyi.com 统一调用 tts-1、tts-1-hd 与 gpt-realtime-2.1 系列,用免费测试额度验证效果后再决定各通道的比例。
📚 参考资料
- API易 文档中心:语音合成与实时语音接入说明
- 链接:
docs.apiyi.com -
说明: 查看 tts-1、gpt-realtime-2.1 等模型的调用参数与接入方式
-
API易 帮助中心:平台使用教程与常见问题
- 链接:
help.apiyi.com - 说明: 适合首次接入时查阅 Key 申请、计费与模型列表
作者:API易 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心