作者注:スマートフォンやブラウザがローカルで音声合成できるようになった今、クラウドの音声 API は残すべきなのでしょうか。本記事では、オフライン、プライバシー、音質と長尺音声、モデル指定と請求の一本化という 4 つの観点から判断の軸を整理します。
スマートフォンの OS やブラウザが、テキストをそのまま端末上で読み上げられるようになってきました。端末側の音声が使えるなら、クラウドの音声 API は残すべきかという問いは、音声プロダクトを作るチームにとって避けて通れないものになっています。「すべてローカルに切り替えて呼び出しコストを削る」という意見もあれば、「ローカルの音色では正式なプロダクトには力不足では」と心配する声もあります。
これは二者択一の問題ではありません。端末側とクラウドにはそれぞれ得意な範囲があり、プロダクトにオフライン対応が必要か、プライバシーにどこまで敏感か、音質や長尺音声にどの程度のクオリティを求めるか、特定のモデルを指定する必要があるか、によって答えが変わります。
この記事で得られること:4 つの観点を順番にチェックしていくことで、自分のプロダクトで端末側とクラウドをどう振り分けるべきかを判断できるようになります。一律に切り替える必要はありません。
オンデバイス音声の登場:要点まとめ
まずは、現時点で確認できていることと、まだ分からないことを分けて整理します。オンデバイス音声が広がっていく大きな流れははっきりしています。ただ、個々のローカルモデルの遅延や音質について、比較に使える公開数値は十分にありません。本記事では推測を避け、該当する項目はすべて「不明」としています。
| 項目 | 内容 |
|---|---|
| 変化 | スマートフォンのOSやブラウザが、ネットに接続せずローカルでテキスト読み上げを行えるようになった |
| オンデバイスの強み | オフラインで使える、データが端末の外に出ない、短い文の読み上げに向いている |
| オンデバイスの不明点 | 各方式の遅延や音質評価について、統一された公開データがないため「不明」として扱う |
| クラウドの強み | 特定のモデルを指定できる、テキストモデルと同じAPIキーで使える、長い音声でも安定しやすい |
| クラウドで選べるモデル | 2026-11-12 時点で、APIYIの料金表には tts-1、tts-1-hd、gpt-realtime-2.1、gpt-realtime-2.1-mini が引き続き掲載されている |
| 影響を受ける人 | 音声読み上げ、音声アシスタント、リアルタイム音声対話を手がけるプロダクトチーム |
オンデバイス音声にできること、保証できないこと
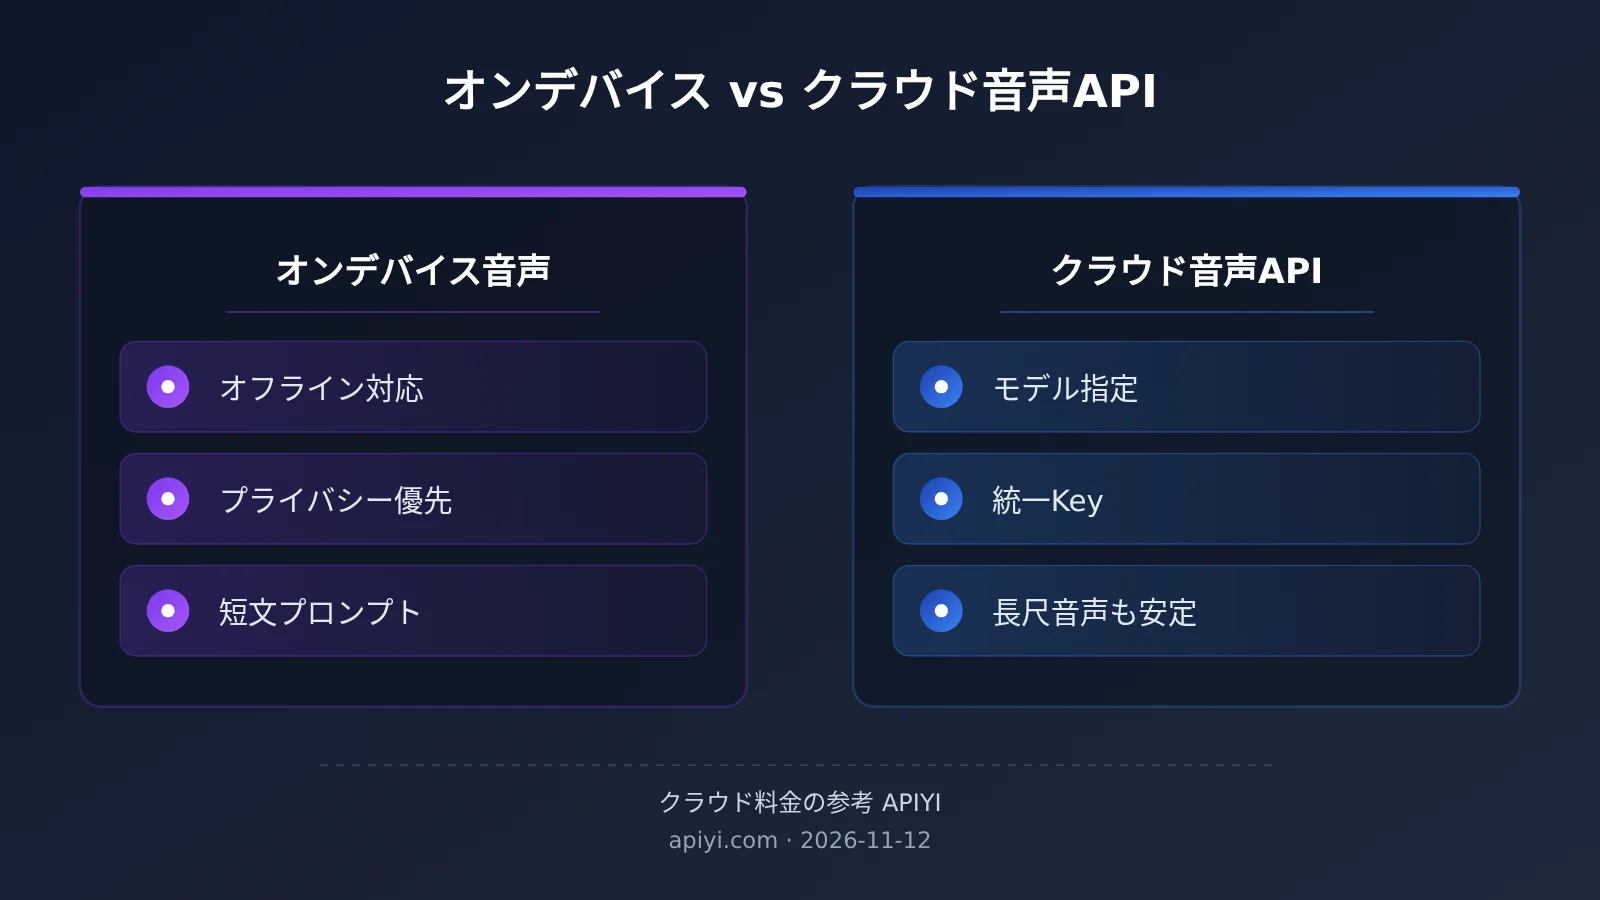
オンデバイス音声のいちばん分かりやすいメリットは、「ネットがなくても声が出る」ことです。ナビの案内、読書支援、アプリ内の短い通知音のようなシーンは、文が短く頻度が高いため、ローカル合成で十分まかなえます。ネットワークの往復を1回省けるのも利点です。データが端末内にとどまるので、健康や金融といった機微なテキストを扱うプロダクトでは、コンプライアンス面の負担もかなり軽くなります。
一方で、オンデバイス音声で得られる声質や品質は、ユーザーの端末次第です。同じプロダクトでも、メーカーやOSのバージョンが違うスマートフォンでは、まったく異なる声で読み上げられることがあります。開発者が体験を統一して保証するのは簡単ではありません。特定のオンデバイスモデルがクラウドと比べてどれだけ遅いのか、音質がどれだけ劣るのかについては、現時点で信頼できる公開数値がありません。判断の際は、自社プロダクトで実際に使う端末をサンプリングして確かめるのが確実です。
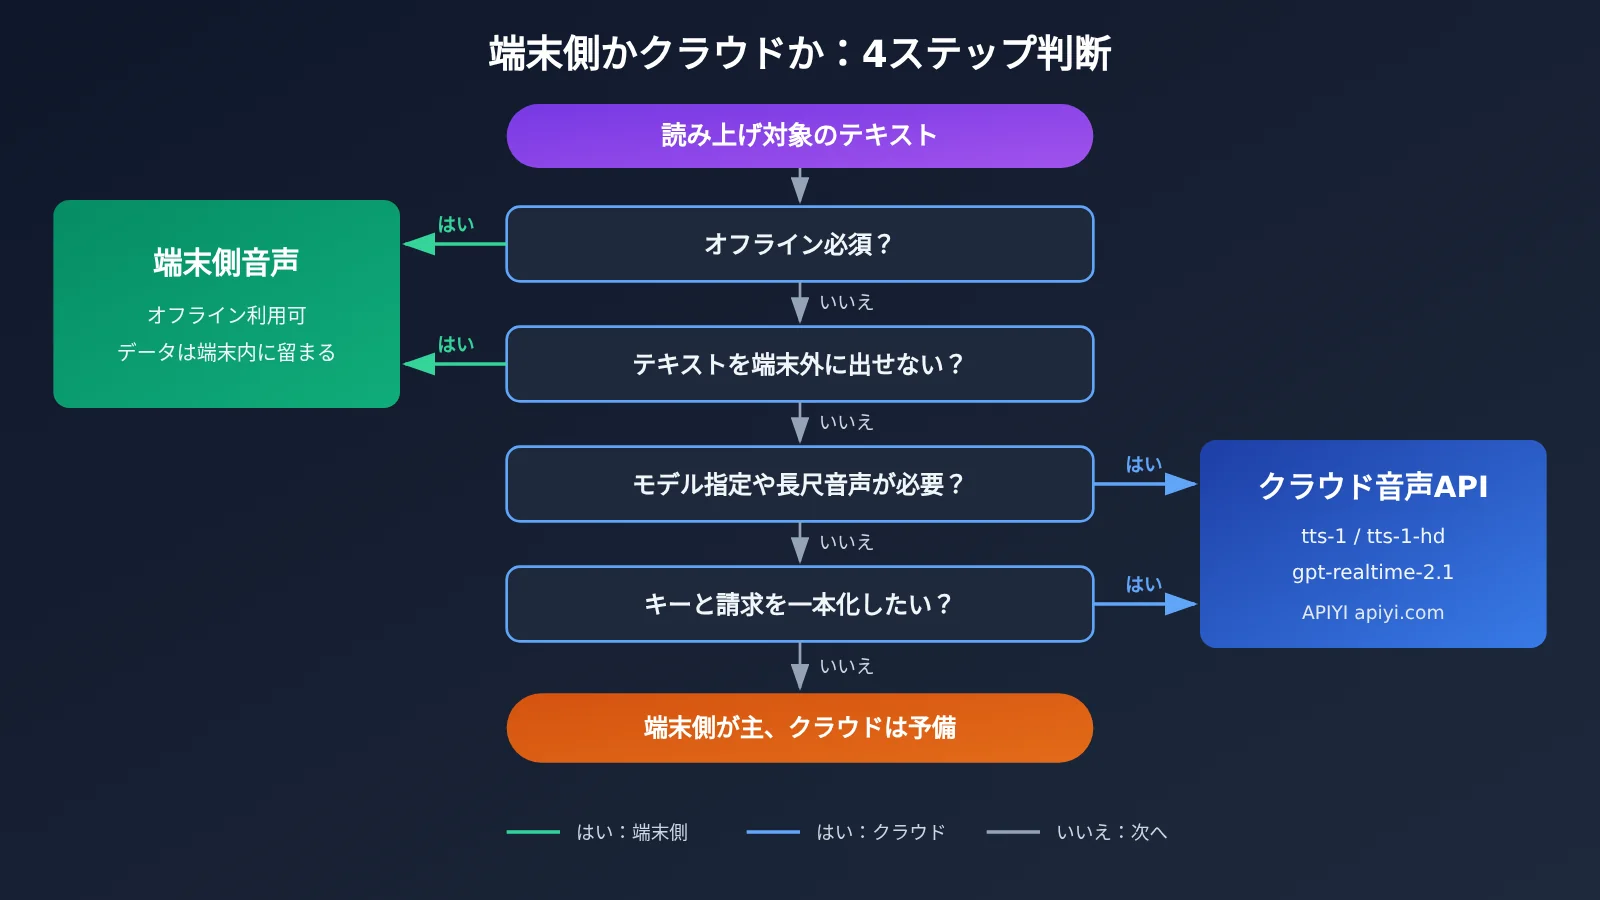
端末側の音声とクラウド音声 API をどう使い分けるか
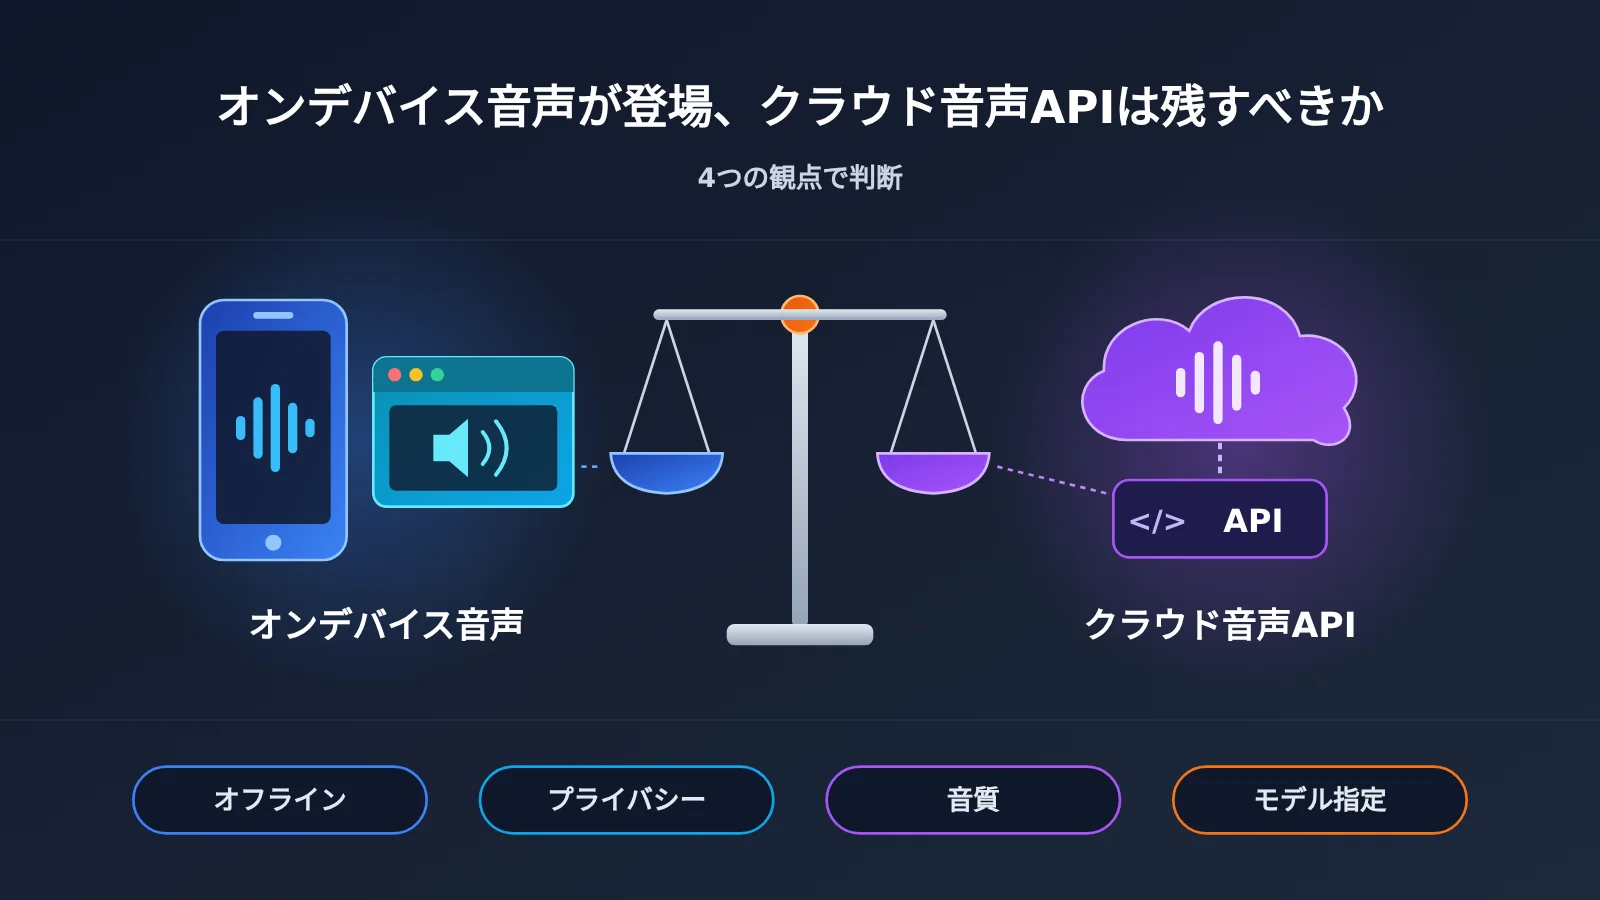
「クラウドを残すかどうか」を議論するよりも、問題を 4 つの観点に分けて考えるほうが効果的です。下の表では、観点ごとにどちらが向いているかと、判断するときに自問すべきことをまとめました。
| 判断の観点 | 端末側の音声が向いているケース | クラウド音声 API が向いているケース | 判断時に自問すること |
|---|---|---|---|
| オフライン | 圏外や電波の弱い環境でも音声を出す必要がある | ユーザーがほぼオンラインで利用する | ネットワークが切れても読み上げを続ける必要があるか? |
| プライバシー | テキストが機密で、端末の外に出せない | テキストをアップロードして処理してよい | コンプライアンス上、データを端末の外に出すことが禁止されていないか? |
| 音質と長文音声 | 短い文、通知音、音色へのこだわりが低い | 長文の読み上げ、音色の一貫性が重要 | 端末ごとに違う声で読み上げられても許容できるか? |
| モデル指定と請求の一本化 | このようなニーズはない | モデルを固定したい、テキストモデルと同じ Key で管理したい | tts-1-hd や gpt-realtime-2.1 のような特定のモデルを固定する必要があるか? |
オフラインとプライバシー:端末側の音声が得意な領域
地下鉄や山間部、飛行機の中で使われることが多いプロダクトなら、オフライン対応は必須要件です。読み上げの主役は端末側の音声にすべきでしょう。同様に、ユーザーが入力したテキストをアップロードしてはならないという業務ルールがある場合も、端末側の音声がほぼ唯一の選択肢になります。この 2 つの観点では、クラウド音声 API の役割は「オンライン時の機能強化」にとどまり、主力にはなりません。
音質、長文音声、モデル指定:クラウド音声 API が得意な領域
ブランド共通の音色を使いたい、長い文章を安定して読み上げたい、あるいはリアルタイムの音声対話を実現したい、といった要件があるなら、クラウドの代わりを務めるのは難しくなります。クラウドならモデルを明示的に指定できます。たとえば、通常の読み上げには tts-1、より高い音質を求めるなら tts-1-hd、リアルタイム対話には gpt-realtime-2.1 や gpt-realtime-2.1-mini を使えば、すべてのユーザーが同じモデルの出力を聞くことになります。
もうひとつ見落とされがちなのが、請求とキーの管理です。音声以外にも、多くのプロダクトは理解、要約、対話生成のためにテキストの大規模言語モデルを呼び出しています。音声とテキストで同じ Key、同じ請求書にまとめられれば、運用も突合作業もずっと楽になります。
クラウド音声APIの接続方法:安定した経路を1本残しておく
端末側(オンデバイス)での処理を中心にすると決めた場合でも、クラウド側の経路を1本残しておくことをおすすめします。フォールバック(代替手段)としても、機能拡張としても役立つからです。APIYIはOpenAI互換のインターフェースを採用しているため、接続方法は公式SDKの呼び出しとほぼ同じです。変更が必要なのは base_url だけです。
接続の手順は、次のように整理できます。
- クライアントを初期化する:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - 音声合成を呼び出す:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - より高い音質が必要な場合は、model を
tts-1-hdに変更します。ほかのパラメータはそのままで構いません - テキストモデルも同じく
https://api.apiyi.com/v1を指定します。音声とテキストで同じキーを共用できます
リアルタイム音声対話(gpt-realtime-2.1 シリーズ)は、通常のHTTPリクエストとは接続方式が異なります。具体的な接続パラメータについては、APIYIのドキュメントセンターの説明をご確認ください。
| モデル | タイプ | 主な用途 | 利用可能なプラットフォーム |
|---|---|---|---|
| tts-1 | テキスト読み上げ | 通常のアナウンス、通知の読み上げ | APIYI apiyi.com |
| tts-1-hd | テキスト読み上げ(高品質) | 長文の読み上げ、ブランド固有の音声 | APIYI |
| gpt-realtime-2.1 | リアルタイム音声対話 | 音声アシスタント、リアルタイムのやり取り | APIYI |
| gpt-realtime-2.1-mini | リアルタイム音声対話(軽量) | コストをより重視するリアルタイム用途 | APIYI |
🚀 クイックスタート:クラウド音声を残すべきか検討中なら、まず APIYI apiyi.com に登録して、新規ユーザー向けの無料テストクレジットを使ってみましょう。同じテキストを tts-1 と tts-1-hd の両方で音声化し、端末のローカル読み上げと聞き比べれば、その差が料金を払う価値のあるものかどうか判断できます。
端末側音声の導入による影響分析
開発者への影響
- アーキテクチャが「どちらか一方」から「ハイブリッド」へ:音声モジュールにルーティング層が必要になり、ネットワーク状態、テキストの機密性、テキストの長さに応じて、端末側で処理するかクラウドで処理するかを決めます
- テストコストが増える:端末側の品質はユーザーのデバイスに左右されるため、さまざまな機種やブラウザでサンプリングして確認する必要があります。一方、クラウドの出力は比較的安定しています
- フォールバックの仕組みが必須に:クラウドが失敗したら端末側に切り替え、端末側が使えなければクラウドに戻すという、2つの経路が互いのバックアップになります
プロダクトアーキテクチャへの影響
ハイブリッド構成で最もよくある導入方法は、音声タスクの種類ごとに、デフォルトの経路と降格(フォールバック)用の経路を1つずつ決めておくことです。次の表は、そのまま設計のたたき台として使えます。
| 音声タスク | デフォルト経路 | フォールバック経路 | 理由 |
|---|---|---|---|
| 短い文のお知らせ、ナビ音声 | 端末側音声 | クラウド tts-1 | 短い文ならローカルで十分で、オフラインでも使える必要がある |
| 機密テキストの読み上げ | 端末側音声 | クラウドへはフォールバックしない | データをデバイスの外に出してはいけない |
| 長文記事、音声コンテンツ | クラウド tts-1-hd | 端末側音声 | 音色が一貫しており、長尺の音声でも安定している |
| リアルタイム音声対話 | クラウド gpt-realtime-2.1 | gpt-realtime-2.1-mini | モデルの指定が必要で、リアルタイムのやり取りはクラウドに依存する |
コスト計算への影響
端末側音声は呼び出しごとの課金がありません。これが、多くのチームが音声処理をすべてローカルに移したいと考える理由です。ただし、節約できた呼び出し料金が、対応作業やテストのコストに形を変えることもありますし、低スペック端末で体験が落ちてユーザーが離れてしまう可能性もあります。現実的なのは、頻度の高い短い文だけを端末側に移し、品質が重要なタスクはクラウドに残す方法です。こうすればクラウドの呼び出し量は自然に減り、肝心の体験も損なわれません。
よくある質問 FAQ
Q1:オンデバイス音声を導入したら、クラウドの音声 API は止めてしまってもいいですか?
多くのプロダクトでは、すぐに止めることはおすすめしません。オンデバイスはオフライン対応とプライバシー保護には強いものの、モデルの指定、長い音声での安定性、声質の一貫性といった面では、依然としてクラウドに頼る部分があります。オンデバイスをメインに据えつつ、クラウドをフォールバックと機能強化に使う構成のほうが安心です。
Q2:オンデバイス音声とクラウド音声 API では、音質や遅延にどのくらい差がありますか?
現時点では、引用できる統一的な公開評価の数値はありません。オンデバイス方式の性能も端末ごとに変わるため、ここでは不明として扱います。ターゲットユーザーがよく使う端末を何機種か選んで試聴し、クラウドの tts-1 や tts-1-hd の出力と聞き比べてみることをおすすめします。
Q3:現時点で、クラウドで呼び出せる音声モデルにはどんなものがありますか?
2026-11-12 時点で、APIYI の料金表には tts-1 と tts-1-hd、さらにリアルタイム音声用の gpt-realtime-2.1 と gpt-realtime-2.1-mini が掲載されています。モデル一覧は随時変更される可能性があるため、最新情報はプラットフォームのリアルタイム料金表でご確認ください。
Q4:1つのキーで、音声モデルとテキストモデルを一緒に呼び出すにはどうすればいいですか?
APIYI(apiyi.com)で API Key を1つ取得し、base_url を `https://api.apiyi.com/v1` に設定します。すると、音声合成、リアルタイム音声、さらに GPT・Claude・Gemini などのテキストモデルまで、すべて同じ入口から呼び出せます。請求も1つにまとまるので、従量課金の照合も楽になります。
Q5:ハイブリッド構成で、クラウド呼び出しが失敗したらどうすればいいですか?
音声のルーティング層にフォールバックの仕組みを加えましょう。クラウドへのリクエストがタイムアウトしたりエラーになったりした場合、機密性のない短い文はオンデバイスの読み上げに切り替え、長い音声はユーザーに少し待ってから再試行してもらうよう案内できます。リアルタイム対話の場面では、gpt-realtime-2.1 と gpt-realtime-2.1-mini を切り替えて対応することも可能です。
端末側音声とクラウド音声APIの核心ポイント Key Takeaways
- 二者択一ではない:端末側音声とクラウド音声APIは役割分担の関係です。タスクごとに使うチャネルを振り分けましょう
- 端末側はオフラインとプライバシーを担当:ネットワークがなくても使え、データが端末の外に出ないため、短いフレーズや通知音に向いています
- クラウドは品質と一貫性を担当:長い音声、ブランド固有の音色、リアルタイム対話には、引き続きクラウドのモデルが必要です
- モデルを指定したいならクラウド一択:tts-1-hd や gpt-realtime-2.1 を固定して使うには、API経由で呼び出す必要があります
- 端末側の性能データは未公開:公開された数値がない部分は、自分のデバイスでサンプリングして確認してください
- 統一Keyで運用負担を軽減:APIYI(apiyi.com)を使えば、音声モデルとテキストモデルで1つのKeyと請求書を共用できます
まとめ
端末側音声を導入したあとも、クラウド音声APIを残すべきかどうか。その答えは、次の4つの観点で決まります。
- オフライン:ネットワークなしで使える必要があるタスクは、端末側音声に任せます
- プライバシー:テキストを端末の外に出せないタスクは、端末側だけで処理します
- 音質と長い音声:一貫性や安定性が求められるタスクは、クラウドに残します
- モデル指定と請求の一本化:特定のモデルを固定したい場合や、テキストモデルと1つのKeyを共用したい場合は、引き続きクラウドAPIを使います
結論はシンプルです。オフラインとプライバシーは端末側で解決し、モデルの指定と請求の一本化はクラウドに任せましょう。まずは利用頻度の高い短いフレーズを端末側に移し、長い音声とリアルタイム対話はクラウドに残すのがおすすめです。APIYI(apiyi.com)なら tts-1、tts-1-hd、gpt-realtime-2.1 シリーズをまとめて呼び出せるので、無料のテスト枠で効果を確かめてから、各チャネルの比率を決めるとよいでしょう。
📚 参考資料
- APIYI ドキュメントセンター:音声合成とリアルタイム音声の接続ガイド
- リンク:
docs.apiyi.com -
説明: tts-1、gpt-realtime-2.1 などのモデルの呼び出しパラメータや接続方法を確認できます
-
APIYI ヘルプセンター:プラットフォームの使い方とよくある質問
- リンク:
help.apiyi.com - 説明: 初めて接続する際に、キーの申請、課金、モデル一覧を調べるのに便利です
著者:APIYI 技術チーム
技術交流:APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターでもご覧いただけます