Anmerkung des Autors: Wer ein Großes Sprachmodell über eine Drittanbieter-API aufruft, kann allein an der Antwortqualität nicht erkennen, welches Modell tatsächlich läuft. Dieser Artikel erklärt FlashProve, das Open-Source-Projekt von Anthropic. Er zeigt, wie es per zkSNARK ein Inferenzergebnis an bestimmte Gewichte bindet, was das kostet, was sich damit beweisen lässt und was nicht, und wie weit es noch von alltäglichen API-Aufrufen entfernt ist.
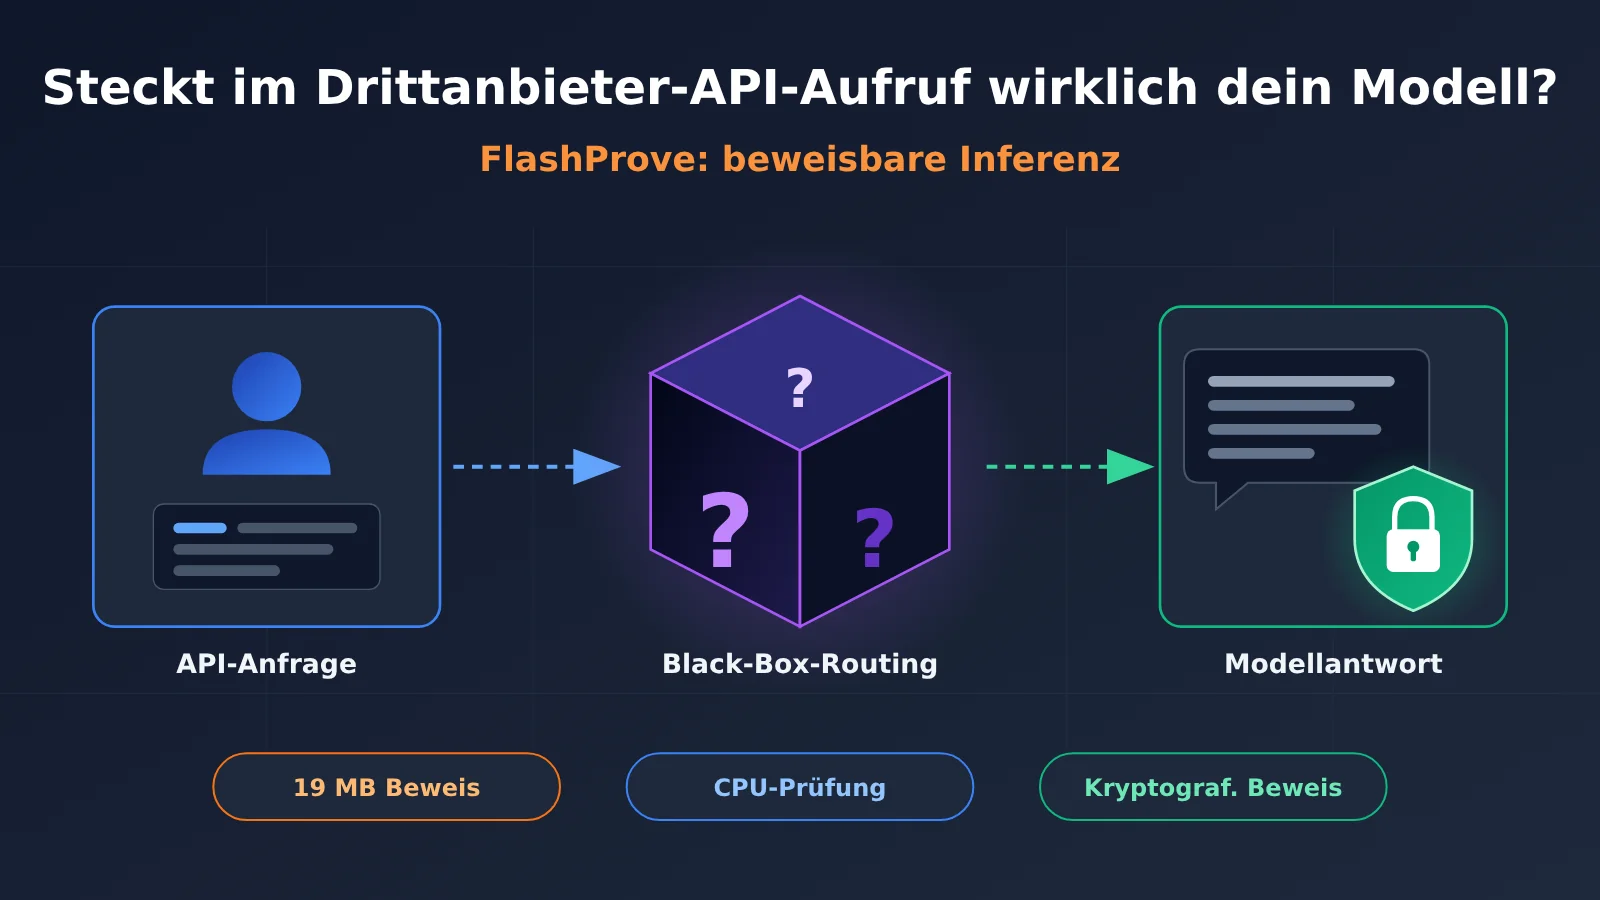
Am 2. November 2026 veröffentlichte das Frontier Red Team von Anthropic gemeinsam mit Forschenden der EPFL, des MIT und weiterer Institutionen FlashProve, einen Open-Source-Prototyp für beweisbare Inferenz bei Großen Sprachmodellen. Bei Llama 4 Maverick mit 400 Mrd. Parametern erzeugt es den Beweis auf einer einzelnen H100. Ein Beweis ist rund 19 MB groß und lässt sich auf einer gewöhnlichen CPU in etwa einem Dutzend Sekunden verifizieren.
Das ist keine Konzeptdemo und kein Folienprodukt. Anthropic hat zugleich einen technischen Bericht, die Protokollspezifikation, einen lauffähigen Prover, zwei Verifier-Implementierungen und einen formalen Beweis in Lean veröffentlicht, alles unter der Apache-2.0-Lizenz. Das Team betont aber ausdrücklich, dass es sich um einen Zwischenstand der Forschung handelt und bis zum vollständigen Forschungsziel noch ein gutes Stück Weg liegt.
Der Nutzen für Sie: Nach diesem Artikel wissen Sie, warum sich die „Modellidentität“ bei Drittanbieter-API-Aufrufen so schwer überprüfen lässt, mit welchem Mechanismus FlashProve das Problem angeht, wo die tatsächlichen Kosten und Grenzen liegen und was Sie als API-Nutzer schon heute tun können.
Warum Modellidentität bei Drittanbieter-APIs ein Vertrauensproblem ist
Wenn Sie eine Anfrage über irgendeine API senden, bekommen Sie nur einen Text und ein Feld mit dem Modellnamen zurück. Anthropic stellt in seinem Forschungsblog unumwunden fest: Nutzer können heute nicht überprüfen, ob eine Antwort tatsächlich von dem Modell stammt, das der Anbieter angibt. Ein Routing-Dienst könnte es aus Kostengründen stillschweigend austauschen, oder Angreifer könnten den Token-Strom manipulieren.
Entscheidend ist: Hohe Ausgabequalität bedeutet nicht, dass die Modellidentität echt ist. Auch ein günstiges Modell kann bei manchen Fragen sehr gut abschneiden, und eine heruntergestufte Version fällt mit bloßem Auge nicht unbedingt auf. Selbst wenn man den kompletten Chatverlauf offenlegt, lässt er sich theoretisch mit einem billigeren Modell fälschen. Solche Belege haben daher keine absolute Beweiskraft.
Auch eine grundlegende Verifikation ist schwierig. Die Gewichte der Spitzenmodelle sind meist nicht öffentlich. Und selbst mit Zugriff auf die Gewichte läge der Rechenaufwand, um die Inferenz noch einmal nachzurechnen, weit jenseits dessen, was normale Nutzer oder sogar Evaluierungsstellen stemmen können. Anthropic hat mehrere typische Szenarien für dieses Vertrauensproblem zusammengetragen:
- Routing-Dienste von Drittanbietern: Kunden möchten sicherstellen, dass die erhaltenen Token von dem Modell stammen, für das sie bezahlt haben.
- Unabhängige Evaluierung: Evaluierungsstellen müssen bestätigen, dass sie vor und nach der Veröffentlichung genau das Modell testen, das tatsächlich live im Einsatz ist.
- Erkennung von Manipulation: Wird ein Inferenzserver kompromittiert, könnten Angreifer schädliche Antworten einschleusen oder sogar Schadsoftware auf Nutzerrechner ausliefern.
- Regulierung und Compliance: Aufsichtsbehörden könnten verlangen, dass nur sicherheitsgeprüfte Modelle eingesetzt werden, oder bestätigt haben wollen, dass die Hardware wirklich Inferenz ausführt und nicht heimlich trainiert.
Das Ziel von Provable Inference (nachweisbarer Inferenz) ist, dass ein Nutzer mit begrenzter Rechenleistung und ohne Kenntnis der Gewichte überprüfen kann, ob eine Antwort tatsächlich vom angefragten Modell stammt.
FlashProve im Überblick
| Punkt | Details |
|---|---|
| Veröffentlichung | 2. November 2026 |
| Herausgeber | Anthropic Frontier Red Team, gemeinsam mit Forschenden von EPFL, MIT, StarkWare, Succinct und weiteren Institutionen |
| Kerntechnologie | zkSNARK (Zero-Knowledge Succinct Non-Interactive Argument of Knowledge), auf Hashfunktionen aufgebaut und damit post-quantensicher |
| Getestetes Modell | Llama 4 Maverick, 400B Parameter, MoE-Architektur, pro Token werden etwa 17B Parameter aktiviert, öffentlich verfügbare 4-Bit-quantisierte Gewichte |
| Veröffentlichte Inhalte | Forschungsblog, technischer Bericht, von Claude verfasste Protokollspezifikation, Beweiser-Code (Prover) sowie zwei Verifizierer in C++ und Lean, Lean-Beweise und Visualisierungswerkzeuge |
| Open-Source-Lizenz | Apache 2.0 |
| Aktueller Status | Forschungsprototyp, der Zwischenstände teilt; Verbesserungsvorschläge von außen sind willkommen |
Bemerkenswert: Laut Anthropic wurde ein Großteil der Optimierungsarbeit im System von Claude erledigt. Weil KI in großen, komplexen Systemen mitunter „schwer zu beurteilende Entscheidungen“ trifft, hat das Team als Absicherung die oberste Sicherheitsaussage in Lean formuliert, sodass sie sich prüfen lässt.
Wie FlashProve belegt, dass eine Inferenz vom angegebenen Modell stammt
FlashProve kennt nur zwei Rollen: Der Modellanbieter ist der Beweisführer (Prover), der Nutzer der Prüfer (Verifier). Der Ablauf besteht aus einer Offline- und einer Online-Phase, dazu kommt die Prüfung auf Verifizierer-Seite.
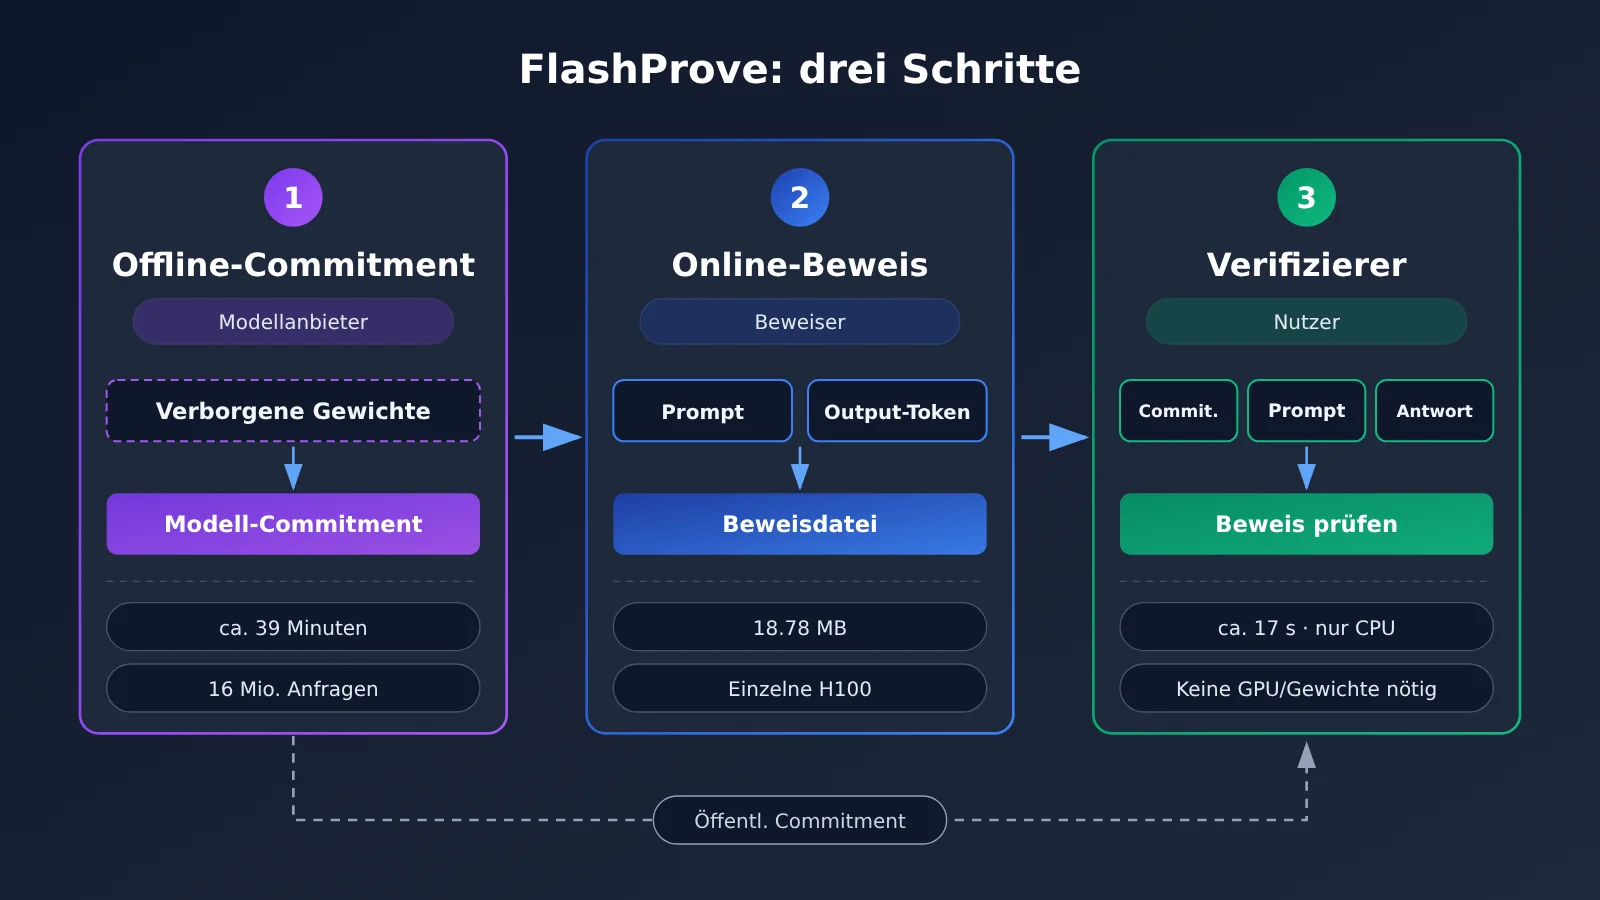
Der dreistufige Mechanismus von FlashProve
- Offline-Modellverpflichtung (Model Commitment): Der Beweisführer veröffentlicht eine Verpflichtung auf die Modellgewichte, man kann sie sich als einen sehr kurzen „Fingerabdruck“ vorstellen. Sie legt einen exakten Satz von Gewichten fest, ohne die Gewichte selbst preiszugeben. Im Test ist dieser Schritt pro Modell nur einmal nötig und dauert etwa 39 Minuten. Die erzeugte Verpflichtung trägt rund 16 Millionen Anfragen, danach muss neu verpflichtet werden.
- Beweiserzeugung im Online-Betrieb: Sobald die Anfrage des Prüfers (Prompt und zugehörige Ausgabe-Token) eintrifft, erzeugt der Beweisführer eine Beweisdatei. Sie belegt die Aussage: „Das verpflichtete Modell erzeugt bei der Ausführung genau diese Ausgabe-Token.“
- Prüfung auf Verifizierer-Seite: Wer Verpflichtung, Prompt und Antwort besitzt, kann den Beweis prüfen. Dafür braucht es weder die Gewichte noch viel Rechenleistung, und man kann sicher sein, dass die verpflichteten Gewichte bei diesem Prompt genau diese Token erzeugt haben.
Die vier Sicherheitseigenschaften von FlashProve
Die ersten beiden Eigenschaften (Vollständigkeit und Korrektheit) könnte ein Prüfer, der die Gewichte kennt und genug Rechenleistung hat, auch selbst durch Nachrechnen erreichen. Sinnvoll wird das System erst durch die beiden anderen:
- Vollständigkeit (Completeness): Ein von einem ehrlichen Beweisführer erzeugter Beweis wird immer akzeptiert.
- Korrektheit (Soundness): Einen gültigen Beweis für eine falsche Aussage zu fälschen, ist so schwer wie der Bruch weithin anerkannter kryptografischer Annahmen. Der Prüfer muss dem Beweisführer daher nicht vertrauen.
- Zero Knowledge: Der Prüfer erfährt weder die Gewichte noch Zwischenwerte der Berechnung. Auch welche Experten in welcher Schicht aktiviert wurden, bleibt ihm verborgen. Die Modellarchitektur selbst wird allerdings nicht verheimlicht.
- Prägnanz (Succinctness): Bewiesen wird ein Lauf eines quantisierten Modells von rund 232 GB, der Prüfer erhält aber nur eine Datei von etwa 19 MB, die sich auf einer 24-Kern-CPU in wenigen Sekunden prüfen lässt.
Wie die MoE-Architektur den Beweisaufwand senkt
Die Beschleunigung von FlashProve nutzt zu großen Teilen die Struktur von MoE (Mixture of Experts). Bei Llama 4 Maverick kommen pro Token nur etwa 17B der 400B Parameter zum Einsatz, und der Aufwand des Beweisführers ist ebenfalls nur proportional zu diesen rund 17B. Trotzdem bleibt verborgen, welche Experten konkret ausgewählt wurden.
Zwei weitere technische Entwürfe sind ebenso wichtig. Erstens der nachträgliche Batch-Beweis: Der Beweisführer liest den fertigen Text wie beim Prefill in einem Durchgang parallel ein und öffnet die Gewichtsverpflichtung pro Batch nur einmal. Zweitens die Anpassung an eine einzelne GPU: Die Gewichte werden schichtweise in Segmente zerlegt und Segment für Segment bewiesen, wobei sie aus dem normalen Arbeitsspeicher gestreamt werden. Eine 80-GB-GPU mit etwa 290 GB Host-Speicher genügt dafür.
FlashProve: Gemessene Kosten für die Beweiserzeugung
Die Kosten entscheiden maßgeblich darüber, ob sich nachweisbare Inferenz in der Praxis einsetzen lässt. Anthropic hat unter diesen Bedingungen getestet: Auf der Beweisseite läuft eine einzelne H100 mit 24 CPU-Kernen, die Verifizierungsseite kommt komplett mit der CPU aus, und jede Anfrage besteht aus einem Fenster mit 1024 Token.
| Phase | Kennzahl | Gemessener Wert |
|---|---|---|
| Offline-Commitment | Dauer / Gültigkeit | ca. 39 Minuten / ca. 16 Millionen Anfragen |
| Online-Beweis | Dauer für einen Batch mit 24 Anfragen | ca. 223 Sekunden |
| Online-Beweis | Verarbeitungsdurchsatz | ca. 110 Tokens/s |
| Beweisdatei | Größe pro Beweis | 18,78 MB |
| Download auf der Verifizierungsseite | Größe des Gewichts-Commitments | ca. 6,5 MB |
| Verifizierungsdauer | 24 Threads / 1 Thread | 17 s / 21 s (inkl. Prüfung der Offline-Phase) |
| Vergleich mit vLLM | GPU-Zeit-Faktor pro GPU | ca. 72-fach (66- bis 77-fach), bei Höchstlast ca. 94-fach |
Als Vergleichsbasis dient dasselbe Modell in der FP8-Variante, das mit vLLM auf 8 H100 läuft. Anders gesagt: Die GPU-Zeit für den Beweis eines Batches liegt etwa beim 70- bis 95-Fachen dessen, was normale Inferenz für denselben Batch braucht. Das sind rund zwei Größenordnungen Mehraufwand.
110 Tokens/s heißt nicht, dass vollständige Antworten in Echtzeit bewiesen werden
Hier wird FlashProve am leichtesten falsch verstanden. Der technische Bericht stellt ausdrücklich klar: Jeder Beweis prüft tatsächlich nur ein einziges Token nach dem Prompt. Die 110 Tokens/s beschreiben den Durchsatz, mit dem die Beweisseite die Anfragefenster verarbeitet, und nicht die Geschwindigkeit, mit der eine vollständige Antwort Token für Token verifiziert wird.
| Messgrundlage | Durchsatz | Erläuterung |
|---|---|---|
| Batch mit 24 Anfragen, gerechnet nach verarbeiteter Fenstergröße | ca. 110 Tokens/s | Die Zahl aus der Blog-Überschrift; jeder Beweis prüft ein Token |
| Jedes Token der Antwort prüfen, gerechnet nach geprüften Tokens | 39,1 Tokens/s | Kommt dem Szenario „gesamte Antwort verifizieren“ näher |
| Einzelne Anfrage separat beweisen | 17,6 Tokens/s | Ein Beweis dauert etwa 58 Sekunden, der Batch-Vorteil entfällt |
Die Aussage „FlashProve kann bereits vollständige Antworten in Echtzeit beweisen“ stimmt also nicht. Genauer lässt es sich so sagen: Unter den Bedingungen von Batch-Verarbeitung, kurzem Kontext und nachträglichem Beweis senkt FlashProve die Kosten nachweisbarer Inferenz auf ein Niveau, das bisher kaum vorstellbar war.
FlashProve im Vergleich zu bestehenden Ansätzen für beweisbare Inferenz
In der Forschung heißt beweisbare Inferenz meist zkML. Anthropic hat den Stand der Entwicklung in einem Blogbeitrag aufgearbeitet, und der Zahlenvergleich ist ziemlich anschaulich.
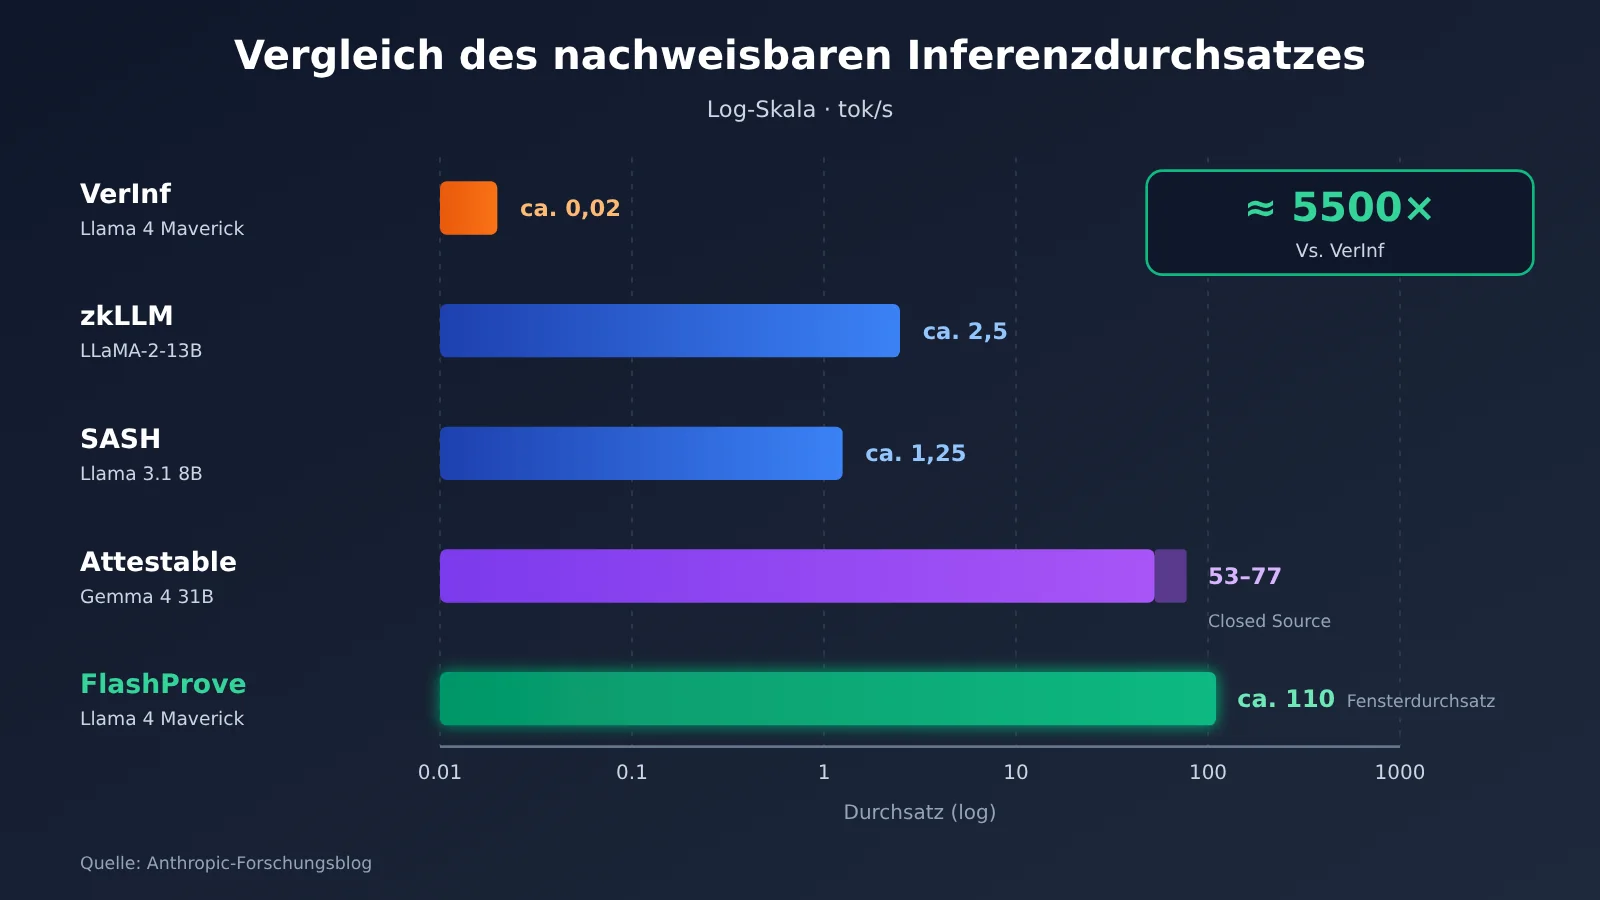
| Ansatz | Bewiesenes Modell | Durchsatz / Dauer | Anmerkung |
|---|---|---|---|
| VerInf | Llama 4 Maverick (400B MoE) | ca. 0,02 tok/s, 14,3 Stunden für 1000 Token | Beweis 93,6 GB, Verifikation dauert fast einen Tag |
| zkLLM (2024) | LLaMA-2-13B | ca. 2,5 tok/s im Batch-Betrieb | Einzelne A100 |
| SASH (2026) | Llama 3.1 8B | ca. 1,25 tok/s | Einzelne H100 |
| Attestable | Gemma 4 31B (Dense-Modell) | 53–77 tok/s | Kommerzielle Lösung, bislang nicht quelloffen |
| FlashProve | Llama 4 Maverick (400B MoE) | ca. 110 tok/s | Beweis ca. 19 MB, Verifikation in Sekunden, Open Source |
Vergleich mit VerInf: VerInf ist der bisher einzige bekannte Ansatz, der dasselbe Modell beweisen konnte. Allerdings umfasst der Beweis 93,6 GB, und die Verifikation dauert fast einen Tag, was den praktischen Einsatz kaum möglich macht. FlashProve drückt die Beweisgröße dagegen auf etwa 19 MB und verkürzt die Verifikation auf rund zehn Sekunden. Damit werden Audits durch Dritte erstmals auch auf gewöhnlichen CPUs machbar.
Vergleich mit Attestable: Attestable erreicht bei Dense-Modellen beeindruckende kommerzielle Zahlen, hatte aber zum Zeitpunkt des Blogbeitrags noch keine passende Open-Source-Bibliothek veröffentlicht. Der Vorteil von FlashProve: Code, Lean-Beweise und Dokumentation sind vollständig offen, sodass jeder die Ergebnisse nachvollziehen und weiterentwickeln kann. Der Preis dafür ist, dass der Ansatz derzeit stark von der MoE-Architektur abhängt.
Was FlashProve beweisen kann – und was nicht
Für Nutzer von Drittanbieter-APIs ist es genauso wichtig, die Grenzen zu verstehen wie die Fähigkeiten. Die folgende Tabelle fasst die zentralen Einschränkungen aus dem Forschungsblog und dem technischen Bericht zusammen:
| Dimension | Was FlashProve leistet | Was FlashProve derzeit nicht leistet |
|---|---|---|
| Modellidentität | Beweist die Bindung an eine konkrete Gewichtsverpflichtung (Commitment) und bestätigt, dass es sich um „das zugesagte Modell“ handelt | Kann nicht belegen, dass das Commitment tatsächlich einem Modell mit einem bestimmten Handelsnamen entspricht; dafür braucht es ein separat veröffentlichtes Commitment |
| Korrektheit der Ausgabe | Beweist, dass die geprüften Token das Ergebnis der Greedy-Dekodierung des ganzzahlig quantisierten Modells sind | Deckt Gleitkomma-Implementierungen und zufälliges Sampling (Temperature größer als 0) nicht direkt ab |
| Datenschutz | Der Beweis selbst gibt keine Gewichte preis | Verbirgt die Modellarchitektur nicht; Seitenkanalangriffe wie die Auswertung der Generierungsdauer liegen außerhalb des Umfangs |
| Kontextlänge | Unterstützt Kontexte bis zu 1024 Token | Deutlich kürzer als die in Chat-Szenarien üblichen mehreren Hunderttausend bis über eine Million Token |
| Zeitpunkt des Schutzes | Erkennt Integritätsprobleme im Nachhinein | Kann nicht verhindern, dass eine manipulierte Antwort den Nutzer zuerst erreicht |
| Modellarchitektur | Geeignet für MoE-Modelle | Dichte Modelle und andere Architekturen erfordern weitere Forschung |
Erkennungsgrenzen des nachträglichen Beweises bei FlashProve
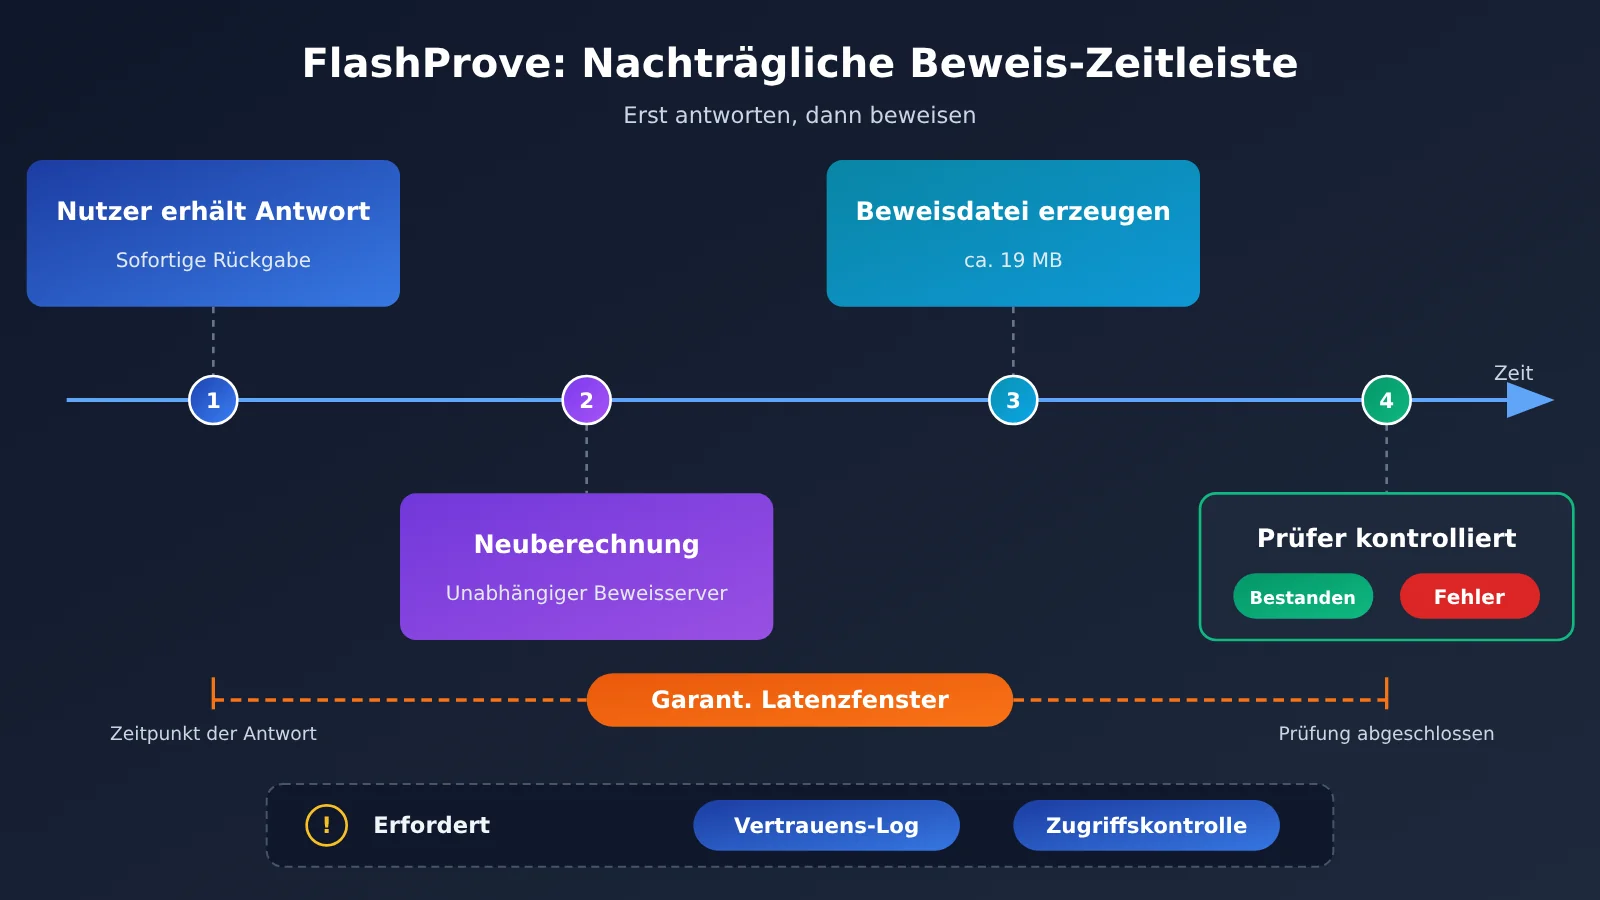
FlashProve setzt auf nachträgliches Beweisen (Post-hoc Proving): Der Nutzer erhält zuerst die Antwort, anschließend berechnet ein unabhängiger Beweisserver sie neu und erzeugt einen Beweis, den zuletzt ein Verifizierer prüft. Dadurch darf das Beweisen langsamer sein, und man muss bei Sicherheit und Effizienz keine Kompromisse eingehen. Der Preis dafür: Die Garantie kommt verzögert. Ein fehlgeschlagener Beweis deckt ein Problem lediglich auf, schützt den Nutzer aber nicht schon vor dem Erhalt der Antwort.
Der technische Bericht weist außerdem darauf hin: Steht das Logsystem selbst unter der Kontrolle eines Angreifers, könnte dieser dem Nutzer manipulierte Inhalte schicken und gleichzeitig dafür sorgen, dass im Log nur das korrekte Ergebnis steht. FlashProve muss daher mit vertrauenswürdigem Logging, Zugriffskontrolle und weiteren Sicherheitsmaßnahmen kombiniert werden.
Was bei der formalen Verifikation von FlashProve noch fehlt
„Mit Lean formal bewiesen“ wird leicht so verstanden, als sei das gesamte System nachweislich korrekt. Das stimmt aber nicht. Der technische Bericht nennt folgende Grenzen:
- Der Lean-Beweis der Zero-Knowledge-Eigenschaft deckt derzeit nur Beweise für einzelne Anfragen ab, noch nicht Batch-Beweise.
- Der Code der GPU-Beweisseite wurde von einer KI anhand der Lean-Darstellung erzeugt; seine Äquivalenz zur Lean-Darstellung ist bislang nicht bewiesen.
- Auch die im Alltag genutzte schnelle C++-Verifizierungsseite stammt von einer KI und hat keine formale Garantie. In Tests stimmten ihre Ergebnisse lediglich durchgehend mit denen des Lean-Verifizierers überein.
- Das längere Dokument zur Protokollspezifikation wurde von einer KI erstellt und von den Autoren nicht im Detail geprüft. Man sollte es deshalb vom technischen Bericht unterscheiden, den die Autoren selbst verfasst haben.
Diese Einschränkungen machen die Forschung nicht wertlos. Sie zeigen vielmehr, dass sich die formale Verifikation derzeit auf die mathematischen Eigenschaften der Protokollebene konzentriert. Die Lücke zwischen ausführbarem Code und Protokoll muss weiterhin durch manuelle oder agentenbasierte Audits geschlossen werden.
Auswirkungsanalyse: Wie weit ist FlashProve vom alltäglichen Einsatz bei Drittanbieter-APIs entfernt?
Folgen für Entwickler und API-Nutzer
- Kurzfristig nicht im Alltagsbetrieb zu erwarten: Der GPU-Mehraufwand von etwa zwei Größenordnungen, rund 19 MB Beweisdatei pro Anfrage und die Kontextgrenze von 1024 Token machen einen direkten Einsatz bei hochfrequenten Dialog-APIs unrealistisch.
- Eingeschränkter Anwendungsbereich: Das System setzt eine MoE-Architektur, ein auf ganze Zahlen quantisiertes Modell und Greedy-Decoding voraus. Die meisten Produktionsaufrufe nutzen dagegen zufälliges Sampling und Gleitkomma-Inferenz, sodass sich der Ansatz nicht einfach übertragen lässt.
- Der größere Wert liegt im Bewusstsein: Erstmals wird aus „Modellidentität prüfen“ von einem unmöglichen Vorhaben ein Ingenieurproblem. Entwickler sollten sich klarmachen: Das zurückgegebene Feld mit dem Modellnamen, die Modell-ID oder gewöhnliche Anfrage-Logs sind keine kryptografischen Beweise.
💡 Empfehlung: Solange beweisbare Inferenz noch nicht ausgereift ist, lohnt es sich bei der Wahl eines Drittanbieters vor allem auf drei Dinge zu achten: Transparenz bei der Abrechnung, Nachvollziehbarkeit der Aufruf-Logs und Konsistenz bei eigenen Tests. Wenn Sie über eine Aggregationsplattform wie APIYI (apiyi.com) arbeiten, können Sie mehrere Modelle parallel anfragen und die vollständigen Aufrufprotokolle behalten. So lassen sich Quervergleiche und Audits selbst durchführen.
Folgen für Branche und Regulierung
- Ein zusätzliches Werkzeug für Evaluation und Compliance: Aufsichtsstellen könnten Anbieter verpflichten, Inferenzanfragen über einen bestimmten Zeitraum mit einem Beweis zu versehen. So lässt sich bestätigen, dass die Hardware tatsächlich das angegebene Modell bedient, ohne dass proprietäre Gewichte offengelegt werden. Anthropic räumt allerdings ein, dass sich damit nicht beweisen lässt, dass die Hardware nicht nebenbei für Training genutzt wird.
- Softwarelösung und vertrauenswürdige Hardware ergänzen sich: Trusted Execution Environments verlassen sich auf manipulationssichere Hardware der Hersteller. zkSNARKs stützen sich auf die Schwierigkeit bestimmter Rechenprobleme, sodass sich Beweise selbst dann nicht fälschen lassen, wenn Hardware und Betriebssystem kompromittiert sind. Beide Ansätze werden in unterschiedlichen Szenarien ihre Stärken ausspielen.
- Anthropic verfolgt für den Produktivbetrieb einen anderen Weg: In der am 19. Oktober 2026 aktualisierten Frontier Safety Roadmap schreibt Anthropic, dass das Projekt zur Inferenzverifikation bereits an echtem Produktions-Inferenztraffic prototypisch aufgebaut wurde. Dabei wird der interne Token-Verkehr signiert, und die Inferenz wird auf vertrauenswürdigen Servern erneut berechnet. Dabei wurde auch eine äußerst seltene, nicht böswillige Integritätsanomalie entdeckt. Das Projekt heißt inzwischen „inference verification“ und ist ein eigenständiges Projekt, das mit FlashProve zwar verwandt ist, aber nicht mit ihm gleichgesetzt werden darf.
Was Entwickler bei Drittanbieter-APIs jetzt tun können: eigene Audit-Protokolle für Aufrufe
Kryptografische Beweise sind vorerst noch nicht praxistauglich. Entwickler können aber schon jetzt dafür sorgen, dass sich Aufrufe nachvollziehen lassen. Das folgende Beispiel setzt bei jedem Aufruf temperature=0 und schreibt Anfragezeitpunkt, Anfrage-ID, das zurückgegebene Modellfeld und einen Hash der Antwort in ein lokales Log. So lassen sich später Konsistenztests wiederholen. Wichtig: Das ist lediglich ein Audit-Protokoll auf Engineering-Ebene und kein kryptografischer Beweis für die Identität des Modells.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI: OpenAI-kompatible Schnittstelle
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
Vollständigen Code für das Audit-Log anzeigen
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Ein Schlüssel für Modelle mehrerer Anbieter
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """Ruft das Modell auf und protokolliert nachvollziehbare Informationen (kein kryptografischer Beweis)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # Nur ein vom Server angegebenes Feld
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# Eine feste Reihe von Probe-Prompts definieren, regelmäßig erneut testen und Ausgabe-Hashes sowie Latenzverteilung vergleichen
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 Schnellstart: Über APIYI (apiyi.com) bekommen Sie ein kostenloses Testkontingent. Damit können Sie mit dem Probe-Skript oben mehrere Modelle regelmäßig erneut testen. Solche Methoden verbessern allerdings nur die Nachvollziehbarkeit und ersetzen keine Beweise auf Gewichtsebene, wie FlashProve sie liefert.
Dazu passen ein paar praktische Maßnahmen:
- Verwenden Sie feste Modell-IDs statt unscharfer Aliase.
- Halten Sie einen Satz Probe-Prompts bereit, um Ausgaben und Latenz langfristig zu beobachten.
- Fragen Sie bei kritischen Anwendungen mehrere Modelle an und gleichen Sie die Ergebnisse ab.
- Verfolgen Sie, ob Anbieter Zusagen zu ihren Gewichten machen oder überprüfbare Mechanismen einführen.
Häufig gestellte Fragen (FAQ)
Q1: Was ist FlashProve?
FlashProve ist ein Forschungsprototyp für nachweisbare Inferenz, den Anthropic im November 2026 als Open Source veröffentlicht hat. Er basiert auf zkSNARKs: Der Modellanbieter legt sich zunächst per Commitment auf die Gewichte fest und erzeugt dann für jedes Inferenzergebnis einen Beweis. Nutzer benötigen weder die Gewichte noch eine GPU – ein CPU reicht aus, um zu prüfen, ob eine Antwort tatsächlich von dem festgelegten Modell stammt.
Q2: Worin unterscheidet sich FlashProve von Anthropics Projekt zur Inferenzverifikation (Inference Verification)?
Beide verfolgen ähnliche Ziele, setzen sie aber unterschiedlich um. Das Projekt zur Inferenzverifikation wurde bereits als Prototyp mit Produktionstraffic aufgebaut: Es arbeitet mit signiertem internem Token-Traffic, der auf einem vertrauenswürdigen Server neu berechnet wird. FlashProve ist dagegen ein rein softwarebasierter kryptografischer Beweisansatz und bislang nur ein Forschungsprototyp. Man sollte die beiden nicht verwechseln.
Q3: Bedeuten die 110 Tokens/s von FlashProve, dass sich eine vollständige Antwort in Echtzeit beweisen lässt?
Nein. Die 110 Tokens/s sind der Durchsatz bei der Verarbeitung von Fenstern im Batch-Betrieb, wobei jeder Beweis nur ein einzelnes Token abdeckt. Wird jedes Token einer Antwort geprüft, liegt der Durchsatz bei 39,1 Tokens/s. Bei einem Beweis für eine Einzelanfrage sinkt er auf 17,6 Tokens/s. Außerdem erfolgt der gesamte Vorgang nachträglich (Post-hoc-Beweis).
Q4: Liefert APIYI bereits für jede Antwort einen FlashProve-Beweis?
Nein. Es gibt derzeit keine Belege dafür, dass APIYI (apiyi.com) FlashProve einsetzt oder kryptografische Beweise auf Gewichtsebene anbietet. Auch der von der Plattform zurückgegebene Modellname und die Aufruf-Logs sind kein kryptografischer Beweis. Pragmatischer ist es derzeit, die einheitliche Schnittstelle und die Aufrufprotokolle der Plattform für eigene Wiederholungstests und Kreuzvergleiche zu nutzen.
Q5: Wie lassen sich per API schnell Konsistenztests über mehrere Modelle hinweg durchführen?
Empfehlenswert ist eine Aggregationsplattform, die mehrere Modelle unterstützt:
1. Registrieren Sie sich auf apiyi.com bei APIYI und holen Sie sich Ihren API-Schlüssel samt kostenlosem Testkontingent
2. Setzen Sie in dem Code aus diesem Artikel die `base_url` auf `https://api.apiyi.com/v1`
3. Fixieren Sie `temperature=0`, testen Sie regelmäßig mit Test-Eingabeaufforderungen (Probes) und protokollieren Sie die Hashes der Ausgaben
Mit diesem Vorgehen lassen sich auffällige Schwankungen leichter erkennen. Es ist aber eine technische Prüfung und kein Nachweis der Modellidentität.
Q6: Welche bekannten Einschränkungen hat FlashProve?
Die wichtigsten: Der GPU-Aufwand liegt etwa beim 70- bis 95-Fachen einer normalen Inferenz. Das Kontextfenster ist auf 1024 Tokens begrenzt. Das Verfahren setzt eine MoE-Architektur, ein auf Ganzzahlen umgestelltes Modell und Greedy Decoding voraus. Die Modellarchitektur wird nicht verborgen, und Seitenkanalangriffe fallen nicht in den Geltungsbereich. Ein nachträglicher Beweis kann nicht verhindern, dass manipulierte Inhalte zuerst beim Nutzer ankommen. Außerdem fehlt bislang ein formaler Äquivalenznachweis zwischen dem ausführbaren Code und dem Lean-Protokoll.
FlashProve: Die wichtigsten Punkte (Key Takeaways)
- Die Vertrauenslücke ist real: Bei Aufrufen über Drittanbieter-APIs beweist eine qualitativ hochwertige Antwort nicht, dass tatsächlich das angegebene Modell dahintersteckt.
- Kernmechanismus: Eine Offline-Gewichtsverpflichtung (Weight Commitment) kombiniert mit einem Online-zkSNARK-Beweis – Nutzer können das Ergebnis allein mit einer CPU überprüfen.
- Deutlich geringere Kosten: Der Durchsatz pro H100-Fenster liegt bei etwa 110 Tokens/s, der Beweis ist rund 19 MB groß, die Verifikation dauert etwa 17 Sekunden.
- Kennzahlen sauber trennen: Bei der Token-für-Token-Prüfung liegt der Durchsatz bei 39,1 Tokens/s, bei einer Einzelanfrage nur bei 17,6 Tokens/s.
- Klare Grenzen: Es funktioniert nur mit MoE, ganzzahlig quantisierter Greedy-Dekodierung, 1024 Token Kontext und nachträglicher Erkennung.
- So steigen Sie ein: Aktuell können Sie über die einheitliche Multimodell-Schnittstelle von APIYI (apiyi.com) eigene Nachtests und Audits durchführen.
Fazit
Die Bedeutung von FlashProve lässt sich in drei Punkten zusammenfassen:
- Aus der Modell-Identitätsprüfung wird ein Engineering-Problem: Früher brauchte man für den Nachweis, dass dasselbe Modell läuft, über zehn Stunden und fast 100 GB an Beweisdaten. Heute sind es im Batch-Betrieb Größenordnungen von hundert Tokens/s und ein Beweis von 19 MB.
- Bis zur Produktionsreife ist es noch ein Stück: Der Mehraufwand von zwei Größenordnungen, der kurze Kontext, die Einschränkungen bei Architektur und Dekodierung sowie die unvollständige formale Verifikation machen FlashProve vorerst zu einem Forschungsprototyp.
- Es braucht das Zusammenspiel mit anderen Sicherheitsmechanismen: Ein nachträglicher Beweis kann Manipulationen nur erkennen, nicht verhindern. Deshalb braucht es zusätzlich vertrauenswürdige Logs und Zugriffskontrolle.
Für alle, die heute Drittanbieter-APIs nutzen, ist die pragmatischste Haltung: Das Feld mit dem Modellnamen sollten Sie nicht als Beweis behandeln, müssen deswegen aber auch nicht in Panik verfallen. Sorgen Sie zuerst für saubere Aufrufprotokolle, wiederholte Stichproben-Tests (Probes) und Quervergleiche zwischen mehreren Modellen, und behalten Sie parallel im Blick, wie weit beweisbare Inferenz in der Praxis reift. Mit APIYI (apiyi.com) können Sie mit einem einzigen Schlüssel mehrere Modelle vergleichen und auf Ihren eigenen Geschäftsdaten eine nachvollziehbare Qualitätsbasis aufbauen.
📚 Referenzen
- Anthropic Research Blog – Progress on provable inference for large language models: Der ursprüngliche Veröffentlichungsartikel zu FlashProve
- Link:
anthropic.com/research/provable-inference -
Beschreibung: Enthält Systemdesign, Messdaten, einen Vergleich mit bestehenden Ansätzen und Hinweise zu den Einschränkungen
-
FlashProve Technical Report: Die vollständigen technischen Details zum Forschungsblog
- Link:
anthropic.com/research/provable-inference(auf der Seite über den Einstieg „Read the technical report“) -
Beschreibung: Enthält wichtige Einschränkungen, etwa zur Berechnung des Durchsatzes, zu den Grenzen nachträglicher Beweise (Post-hoc-Beweise) und zum Umfang der formalen Verifikation
-
Anthropic Frontier Safety Roadmap: Fortschrittsbericht zum Projekt der Inferenzverifikation
- Link:
anthropic.com - Beschreibung: Erklärt den Unterschied zwischen Inference Verification und FlashProve
Autor: APIYI-Technikteam
Austausch: Melden Sie sich gern über die Startseite von APIYI bei uns. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com