Hinweis des Autors: Verglichen werden zwei Wege, KI-generierte Videos mit Untertiteln zu versehen: Untertitel per Seedance-Eingabeaufforderung ins Bild einbrennen oder die Tonspur des fertigen Videos transkribieren. Der Artikel zeigt, welche Untertitel sich nachträglich bearbeiten und übersetzen lassen und welchen Teil der Kosten ein Wechsel des Videomodells tatsächlich spart.
Viele haben die Video-Schnittstelle auf APIYI bereits zum Laufen gebracht und hängen dann nicht an der Bildqualität, sondern an den Untertiteln im fertigen Video. Die typische Überlegung: Seedance ist pro Clip zu teuer, also wechselt man zu Grok, Hailuo oder Wan und sucht gleich ein Modell, das „die Untertitel direkt mitliefert“. Vorab die Kurzfassung zum Mitnehmen: Bearbeitbare Untertitel kommen nicht direkt aus dem Videomodell. Wer Untertitel braucht, die sich ändern und übersetzen lassen, transkribiert die Tonspur des fertigen Videos.
Von den aktuell verfügbaren Videomodellen liefert keines eine bearbeitbare Untertiteldatei als Ausgabe. Seedance kann Text laut dem Leitfaden „Seedance 2.0 Series Prompt Guide“ von Volcano Engine (火山引擎) in die Bildpixel einbrennen. Derselbe Leitfaden räumt aber ein, dass im fertigen Video auch dann Untertitel auftauchen können, wenn die Eingabeaufforderung keine verlangt, und dass sich das nicht zu 100 % unterdrücken lässt. Die Produktseiten von Wan3.0, Wan2.7, HappyHorse, MiniMax H3, Oxygen und Grok Imagine erwähnen höchstens Tonspur oder audiogesteuerte Erzeugung, aber keinen einzigen Untertitelparameter. Ein teureres Videomodell löst das Untertitelproblem also nicht.
Das ist keine Abwägung nach dem Motto „jeder Ansatz hat seine Stärken“. Dieser Artikel vergleicht nur zwei Wege: Einbrennen per Eingabeaufforderung und nachträgliche Transkription. Für drei typische Szenarien gibt er jeweils eine klare Empfehlung. Alle erwähnten Videomodelle lassen sich über APIYI (apiyi.com) aufrufen. Modellbezeichnungen und Preise richten sich nach der Modellliste der Plattform.
Kernnutzen: Nach der Lektüre können Sie zwei Entscheidungen treffen. Erstens: Soll die Eingabeaufforderung für diesen Clip eingebrannte Untertitel verlangen? Zweitens: Auf welche Modellstufe wechseln Sie, wenn Sie Kosten sparen wollen?
KI-generierte Videos mit Untertiteln: Tonspur ist nicht gleich Untertitel
Bevor wir über Untertitel bei KI-generierten Videos sprechen, müssen wir „Ton“ und „Untertitel“ sauber voneinander trennen. Videomodelle erzeugen Dialoge, Soundeffekte und Bild in einem Rutsch – heraus kommt eine Tonspur, die fest im fertigen Video steckt. Dass in dieser Tonspur Dialog vorkommt, heißt aber nicht, dass das Video auch Untertitel hat. Und selbst wenn im Bild Schrift auftaucht: Ist sie in die Pixel eingebrannt, gehört sie zum Bild und ist kein Untertitel.
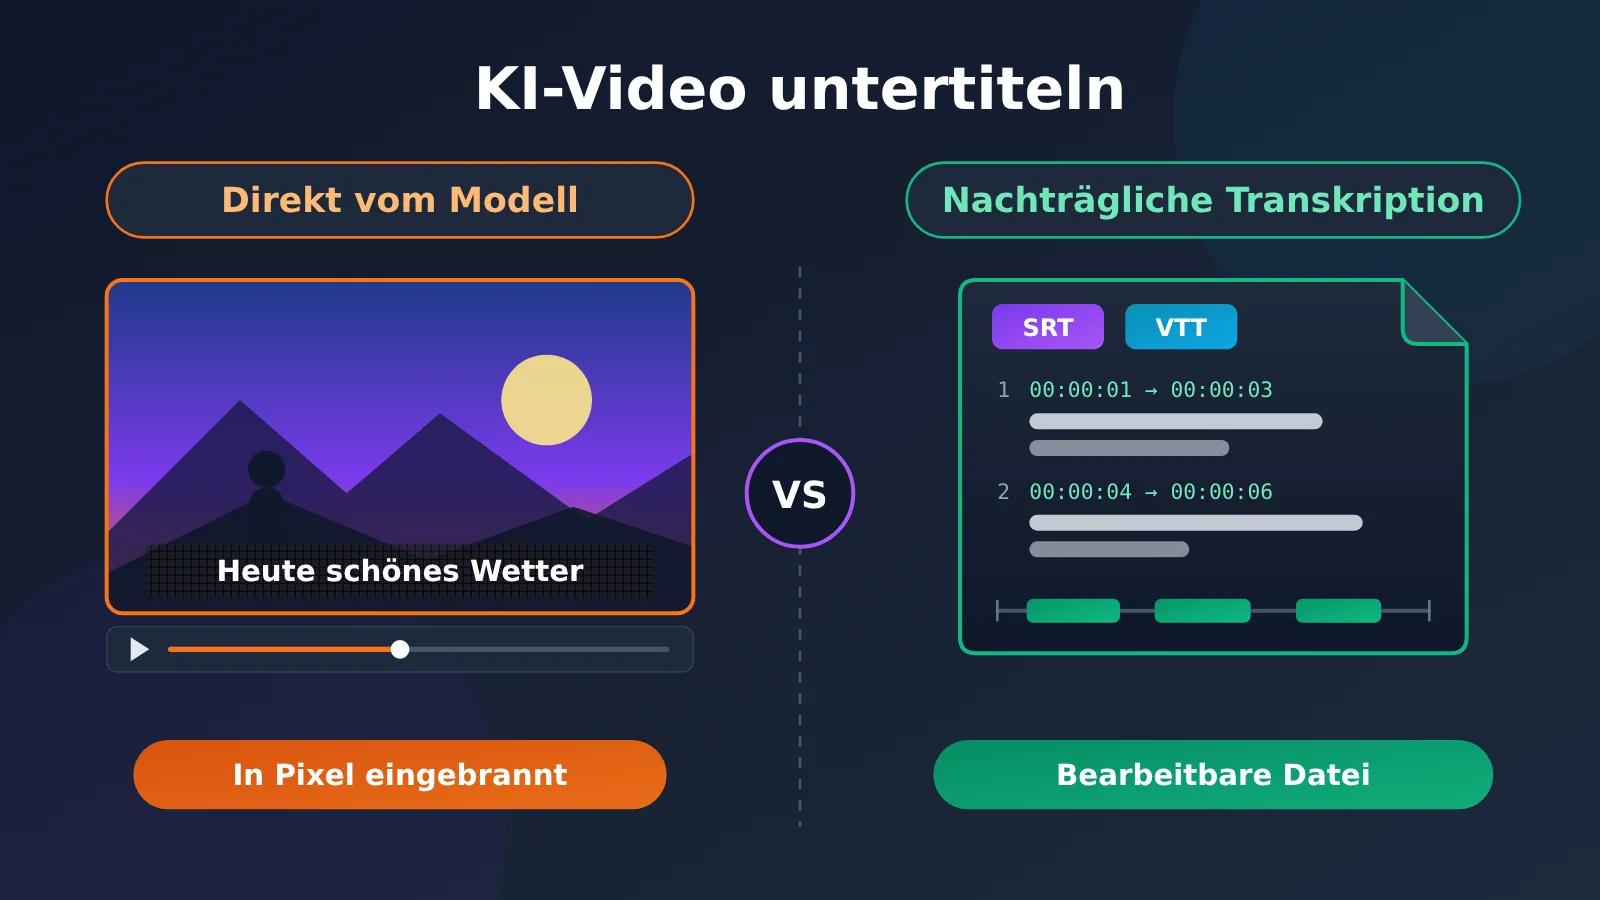
Von „brauchbaren Untertiteln“ spreche ich in diesem Artikel nur, wenn drei Bedingungen gleichzeitig erfüllt sind. Erstens: Der Text stimmt – keine Tippfehler, keine ausgelassenen Wörter und kein Zeichenchaos bei seltenen Schriftzeichen. Zweitens: Der Zeitpunkt des Einblendens passt zum gesprochenen Dialog. Drittens: Man kann den Text nachträglich bearbeiten und in andere Sprachen übersetzen. Schrift, die in die Pixel eingebrannt ist, schafft bestenfalls die ersten beiden Punkte, den dritten nie: Für jeden korrigierten Tippfehler müssen Sie das ganze Video neu generieren lassen, und für eine englische Version ebenfalls.
Auch der Leitfaden für Eingabeaufforderungen von Volcano Engine (火山引擎) sieht das so: Dort zählt der „Untertitel“ zu den Bildtexten und steht im selben Abschnitt wie Werbeslogans und Sprechblasen. Von SRT, VTT oder einer separaten Untertitelspur ist im Leitfaden keine Rede. Wer das verstanden hat, kann die Frage „Welches Videomodell macht die besseren Untertitel?“ anders stellen: Wollen Sie Schrift im Bild – oder eine editierbare Untertiteldatei?
2 Wege, AI-generierte Videos mit Untertiteln zu versehen: die wichtigsten Unterschiede
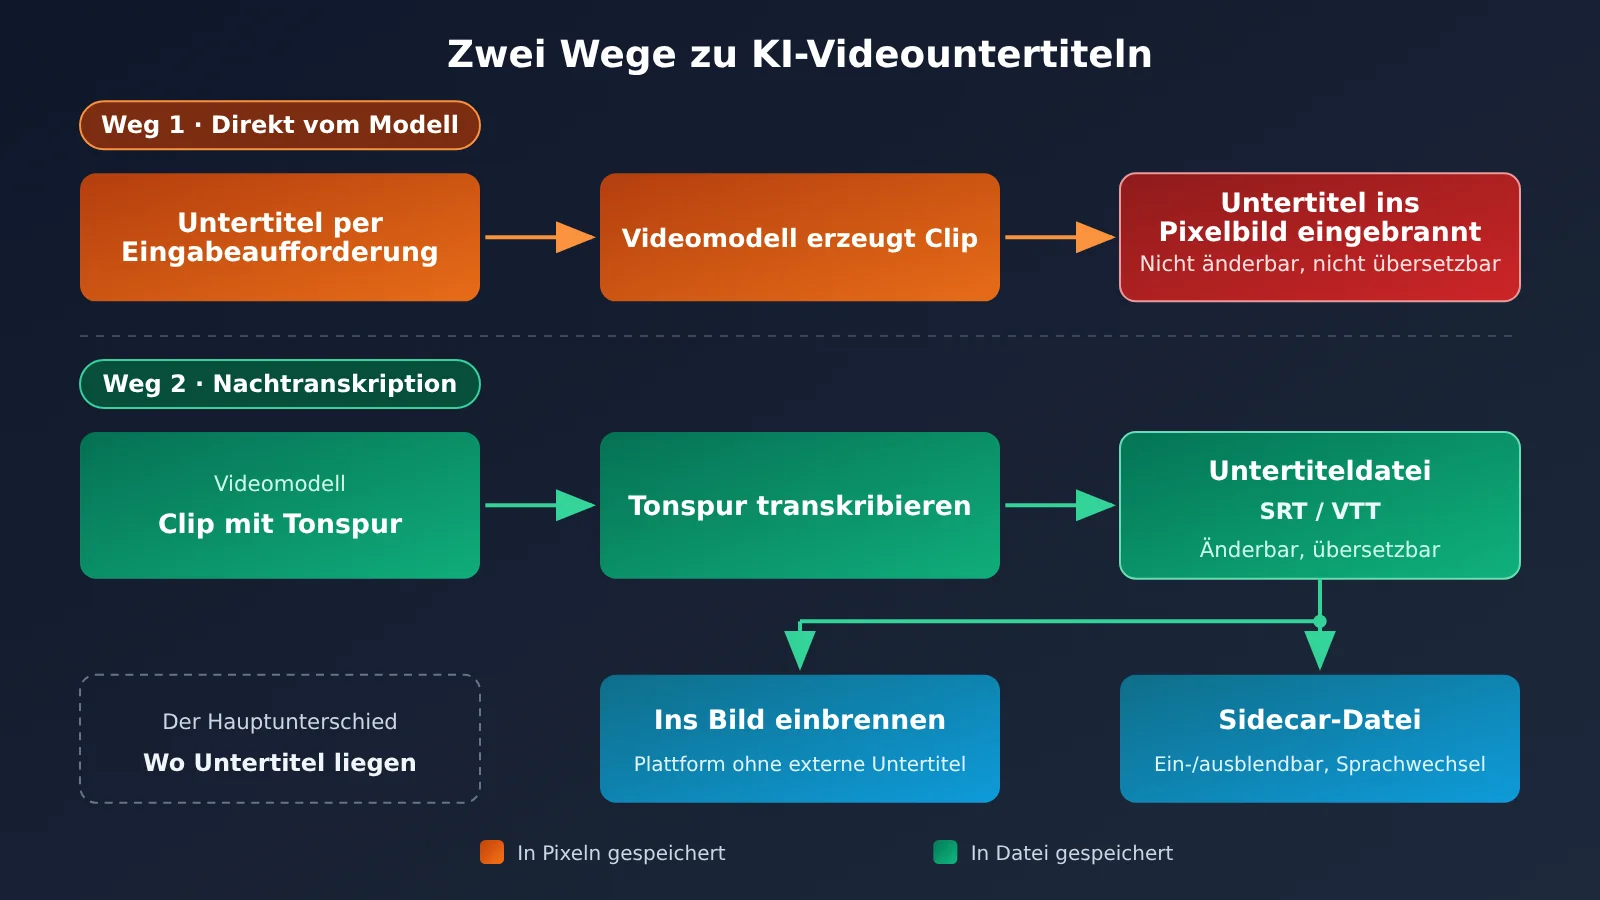
Der Unterschied zwischen den beiden Wegen liegt weder in der Bildqualität noch in der Modellklasse, sondern darin, wo der Untertitel am Ende gespeichert wird. Weg 1 speichert die Untertitel in den Pixeln, Weg 2 in einer separaten Datei. Die folgende Tabelle vergleicht beide Wege anhand der drei Kriterien für „brauchbare Untertitel“.
| Vergleichskriterium | Weg 1: Untertitel per Eingabeaufforderung einbrennen | Weg 2: Untertitel aus der Tonspur des fertigen Videos transkribieren | Sieger |
|---|---|---|---|
| Sind die Schriftzeichen korrekt? | Hängt von der Modellgenerierung ab; der Leitfaden empfiehlt, gebräuchliche Zeichen zu bevorzugen und seltene Zeichen sowie Sonderzeichen zu vermeiden | Stammt aus der Spracherkennung der Tonspur und kann manuell korrigiert werden | Weg 2 |
| Abgleich mit dem Dialog | In der Eingabeaufforderung lässt sich „vollständig synchron zum Audiorhythmus“ festhalten, das Ergebnis ist aber Glückssache | Wird über Transkriptions-Zeitstempel oder Schnittsoftware ausgerichtet und lässt sich fein nachjustieren | Weg 2 |
| Nachträglich Text ändern/übersetzen | Nicht möglich, für Textänderungen muss das ganze Video neu generiert werden | Möglich, es genügt, die Datei zu ändern; auch mehrsprachige Versionen sind machbar | Weg 2 |
| Geeignete Modelle | Nur im offiziellen Leitfaden von Seedance ist diese Fähigkeit beschrieben | Jedes fertige Video mit Tonspur funktioniert | Weg 2 |
| Zusätzlicher Arbeitsschritt | Keiner, das Video kommt direkt mit Untertiteln | Erfordert einen Transkriptionsdienst oder Schnittsoftware | Weg 1 |
| Wenn man die Untertitel loswerden will | Laut offizieller Angabe lässt sich ungewollt eingeblendeter Text nicht zu 100 % vermeiden | Dieses Problem gibt es nicht | Weg 2 |
Weg 1: Untertitel per Seedance-Eingabeaufforderung direkt ins KI-Video einbrennen
Seedance ist die einzige Modellreihe der Familie, deren offizieller Leitfaden für Eingabeaufforderungen gleichzeitig sagt, dass das Modell „Untertitel kann“ und dass es „Untertitel auch ungewollt einblendet“. Im Abschnitt zur Texterzeugung heißt es, das Modell könne gängige Schriftzeichen erzeugen. Farbe, Stil, Art des Erscheinens, Zeitpunkt und Position lassen sich vorgeben. Typische Einsatzfälle sind Werbeslogans, Untertitel und Sprechblasen. Wichtig: Der Leitfaden trägt den Titel „Serie 2.0“ und nennt nirgends einen abweichenden Untertitel-Funktionsumfang für 2.5. Das Einbrennen von Untertiteln sollte man daher nicht als Alleinstellungsmerkmal von 2.5 darstellen.
Die folgende Tabelle fasst die untertitelrelevanten Formulierungen aus dem offiziellen Leitfaden zusammen. Sie lassen sich direkt als Vorlage für eigene Eingabeaufforderungen nutzen:
| Zweck | Formulierung laut offiziellem Leitfaden | Hinweise |
|---|---|---|
| Untertitelinhalt festlegen | 「画面底部出现字幕,字幕内容为「……」,字幕需与音频节奏完全同步。」 | Für den Untertiteltext möglichst gängige Zeichen verwenden |
| Untertitel nach Dialog | 「画面底部按照台词出现字幕」「画面底部出现对应台词字幕」 | Die Ausgabe bleibt Text aus Pixeln, es gibt keine Zeitleisten-Datei |
| Keine Untertitel | 「保持无字幕」「避免生成任何文字或字幕」 | Laut offizieller Angabe lässt sich das derzeit nicht zu 100 % vermeiden |
| Textstil | Farbe, Stil, Art des Erscheinens, Zeitpunkt und Position sind festlegbar | Seltene Zeichen und Sonderzeichen vermeiden |
Der Vorteil dieses Wegs: Es gibt keinen zusätzlichen Arbeitsschritt. Das Video kommt direkt mit Untertiteln heraus, ideal für kurze Hochformat-Clips auf Kurzvideo-Plattformen. Der Nachteil liegt ebenso auf der Hand: Ist ein Zeichen falsch, hilft nur ein neuer Durchlauf, und bis das Ergebnis passt, zahlt man jedes Mal für das Video. Auch für eine andere Sprachversion muss man alles von vorn erzeugen.
Beim Aufruf gibt es außerdem ein paar typische Stolperfallen. Wenn Sie in der Konsole von APIYI (apiyi.com) ein Token anlegen, wählen Sie die Gruppe SeeDance2 (Multiplikator 0.18x). Als Abrechnungsmodus muss „Nutzungsbasiert zuerst“ oder „Nutzungsbasiert“ gesetzt sein. Der Endpunkt lautet /seedance/api/v3/..., nicht /v1/videos. Auf der Produktseite steht, dass der generische Endpunkt die Auflösung falsch übergibt, die Abrechnung aber trotzdem nach dem tatsächlich erzeugten Video erfolgt. Zudem ist generate_audio standardmäßig true. Wer ein stummes Video möchte, muss ausdrücklich false übergeben.
Weg 2: Untertitel für KI-generierte Videos aus der Tonspur des fertigen Videos transkribieren
Bei der Nachbearbeitung ist die Aufgabenteilung klar: Das Videomodell liefert nur ein fertiges Video mit Tonspur, die Untertitel übernimmt ein separater Transkriptionsdienst oder eine Schnittsoftware. Aus der Transkription entsteht eine Untertiteldatei mit Zeitachse, die sich auf zwei Arten nutzen lässt. Erstens kann man die Untertitel fest ins Bild einbrennen, für Plattformen, die keine externen Untertitel unterstützen. Zweitens kann man sie als Sidecar-Datei zusammen mit dem Video ausliefern. Der Player kann sie dann ein- und ausschalten, und auch das Umschalten der Sprache ist möglich.
Bei der Wahl des Transkriptionsdienstes lohnt ein Blick auf den aktuellen Stand. Der OpenAI-Leitfaden zu Speech-to-Text empfiehlt derzeit gpt-transcribe für die Transkription von Dateien. Die Schnittstelle ist POST /v1/audio/transcriptions; sie liefert den Text und die erkannte Sprache zurück, pro Datei sind maximal 25 MB erlaubt. Die Beispiele für Zeitstempel auf Wort- oder Satzebene verweisen aber weiterhin auf den Parameter timestamp_granularities von whisper-1, und dieser Parameter wird nur von whisper-1 unterstützt. Modelle wie whisper-1, gpt-4o-transcribe und gpt-4o-mini-transcribe sind als veraltet markiert, das Abschaltdatum ist der 26.02.2027.
Außerdem gilt: In der APIYI-Modellübersicht vom 10.11.2026, 15:40 Uhr, taucht weder whisper-1 noch gpt-transcribe auf. Dieser Nachbearbeitungsschritt gehört nicht zur aktuellen Liste der Videomodelle, deshalb braucht man dafür einen separaten Transkriptionsdienst oder die eingebaute Spracherkennung der Schnittsoftware. Auch die Ausrichtung auf der Zeitachse kann man der Schnittsoftware überlassen. Die Transkription muss dann nur noch den Text zuverlässig erkennen.
Übersicht: Fähigkeiten zur KI-generierten Videountertitelung bei den bereitgestellten Videomodellen
Die folgende Tabelle fasst zusammen, wie die einzelnen Modellseiten Ton und Untertitel beschreiben. Die Spalte „Untertitel-Parameter“ ist das Ergebnis einer Volltextsuche über alle Modellseiten am 2026-11-11. Gesucht wurde nach „字幕“ (Untertitel), SRT, eingebrannten Untertiteln und Untertitelspuren.
| Serie | Modell-ID | Ton (laut Modellseite) | Untertitel-Parameter | Wichtige Hinweise zum Aufruf |
|---|---|---|---|---|
| Seedance | doubao-seedance-2-5-260628, doubao-seedance-2-0-260128, doubao-seedance-2-0-fast-260128, doubao-seedance-2-0-mini-260615 |
generate_audio ist standardmäßig aktiviert |
Keine Untertiteldatei; Einbrennen per Eingabeaufforderung nach dem Volcengine-Leitfaden möglich | Gruppe SeeDance2, läuft über /seedance/api/v3/... |
| Wan3.0 | wan3.0-video, wan3.0-video-prime |
audio ist standardmäßig true, die Ausgabe enthält eine eigene Tonspur |
Keine | Einreichung an /wan/api/v1/services/aigc/video-generation/video-synthesis, mit Header X-DashScope-Async: enable |
| Wan2.7 | wan2.7-t2v, wan2.7-i2v, wan2.7-r2v, wan2.7-videoedit |
Nur wan2.7-i2v unterstützt driving_audio für Lippensynchronisation |
Keine | Nur 720P / 1080P, Dauer 2–15 Sekunden |
| HappyHorse 1.1 | happyhorse-1.1-t2v, happyhorse-1.1-i2v, happyhorse-1.1-r2v, happyhorse-1.0-video-edit |
Bild-zu-Video unterstützt kein driving_audio, Standarddialog ist auf der Modellseite nicht angegeben |
Keine | Dauer 2–15 Sekunden; für Lippensynchronisation auf Wan2.7 ausweichen |
| MiniMax H3 | MiniMax-H3 |
Eigene Stereo-Tonspur, lässt sich nicht abschalten | Keine | Nur 768P verfügbar, läuft über /hailuo/v2/video_generation |
| Oxygen | oxygen-1.0 |
Fertiges Video enthält eine eigene Tonspur | Keine | OpenAI-Videos-kompatibel, POST /v1/videos |
| Grok Imagine | grok-imagine-video, grok-imagine-video-1.5, grok-imagine-video-1.5-lite |
Standardmäßig mit eigener Tonspur, Abschalten des Audios senkt den Preis nicht | Keine | Gruppe GrokOfficial muss freigeschaltet sein |
Die wichtigste Aussage dieser Tabelle: Abgesehen von Seedance enthält keine der Modellseiten Angaben zu Untertiteln. Man kann also nicht davon ausgehen, dass die anderen Modelle Untertitel ebenfalls per Eingabeaufforderung erzeugen können. Alle genannten Modelle lassen sich bei APIYI (apiyi.com) mit demselben Konto aufrufen. Welche Modellvarianten und Gruppen tatsächlich verfügbar sind, entnehmen Sie bitte der Modellliste der Plattform.
Ein paar Details verdienen eine gesonderte Erwähnung. driving_audio bei Wan2.7 sorgt dafür, dass die Mundbewegungen dem Audio folgen. Das ist eine Lippensynchronisations-Funktion und hat mit Untertiteln nichts zu tun. Die Empfehlung der Modellseite selbst lautet: Wenn Sie audiogesteuerte Lippensynchronisation brauchen, nehmen Sie 2.7; wenn Sie eine Standard-Tonspur, längere Laufzeiten und einen niedrigeren Preis wollen, nehmen Sie Wan3.0. MiniMax H3 läuft bei APIYI als selbst gehostetes Open-Weights-Modell und nicht als Weiterleitung der Original-API. Die Tonspur lässt sich nicht abschalten: Wer generate_audio=false übergibt, erhält einen 400-Fehler mit dem Fehlerfeld unsupported field generate_audio. Auch eine 2K-Auflösung wird abgelehnt.
Bei den drei Grok-Imagine-Modellen liegt der Fall etwas anders: Die Modellseite nennt Preise, aber in der Modellübersicht vom 2026-11-10 um 15:40 fehlen diese drei Zeilen. Das heißt nicht, dass sie nicht verfügbar wären. Vor dem Aufruf sollten Sie in der Konsole prüfen, ob die Gruppe GrokOfficial freigeschaltet ist.
KI-generierte Videountertitel und Produktionskosten: Was ein Modellwechsel wirklich spart
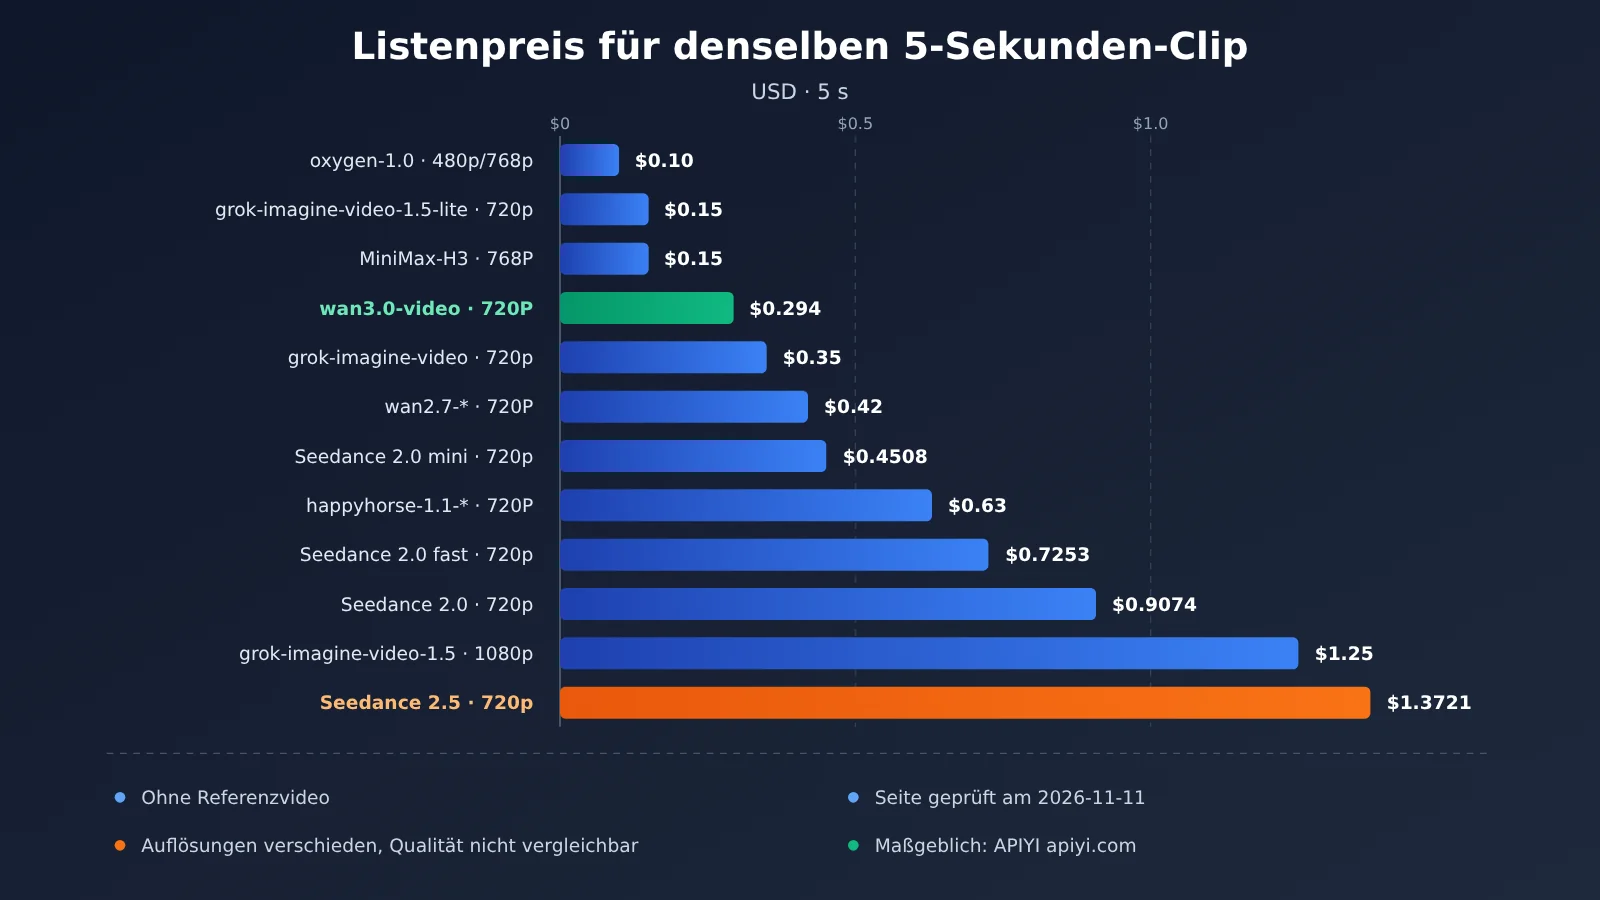
Die Untertitel hängen nicht vom Videomodell ab. Ein Modellwechsel kann also nur bei den Kosten für den fertigen Clip etwas sparen. Zum Vergleich dient unten der Dokumentationspreis für denselben 5-Sekunden-Clip. Vorab ein wichtiger Hinweis: Die Zeilen haben unterschiedliche Auflösungen. Die Tabelle taugt deshalb nur für den Kostenvergleich, nicht als Bildqualitätsvergleich desselben Clips.
| Modell-ID | Auflösung | Dauer | Referenzvideo | Dokumentationspreis | Preisquelle | Datenstand |
|---|---|---|---|---|---|---|
oxygen-1.0 |
480p oder 768p (gleicher Preis) | 5 s | Nicht enthalten | $0.10 | Sekundenpreis der Produktseite × 5 | Produktseite, geprüft am 2026-11-11 |
grok-imagine-video-1.5-lite |
480p / 720p | 5 s | Nicht enthalten (Eingabebild wird nicht berechnet) | $0.10 / $0.15 | Sekundenpreis der Produktseite × 5 | Produktseite, geprüft am 2026-11-11 |
wan3.0-video |
480P / 720P / 1080P | 5 s | Nicht enthalten | $0.147 / $0.294 / $0.588 | 5-Sekunden-Gesamtpreis der Produktseite | Produktseite, geprüft am 2026-11-11 |
MiniMax-H3 |
768P | 5 s | Nicht enthalten | $0.15 | Produktseite | Produktseite, geprüft am 2026-11-11 |
grok-imagine-video |
480p / 720p | 5 s | Nicht enthalten (Eingabebild wird nicht berechnet) | $0.25 / $0.35 | Sekundenpreis der Produktseite × 5 | Produktseite, geprüft am 2026-11-11 |
wan2.7-* |
720P / 1080P | 5 s | Nicht enthalten | $0.42 / $0.70 | 5-Sekunden-Gesamtpreis der Produktseite | Produktseite, geprüft am 2026-11-11 |
doubao-seedance-2-0-mini-260615 |
720p | 5 s | Nicht enthalten | $0.4508 | Preisliste der Produktseite | Produktseite, geprüft am 2026-11-11 |
happyhorse-1.1-* |
720P / 1080P | 5 s | Nicht enthalten | $0.63 / $1.12 | 5-Sekunden-Gesamtpreis der Produktseite | Produktseite, geprüft am 2026-11-11 |
doubao-seedance-2-0-fast-260128 |
720p | 5 s | Nicht enthalten | $0.7253 | Preisliste der Produktseite | Produktseite, geprüft am 2026-11-11 |
doubao-seedance-2-0-260128 |
720p | 5 s | Nicht enthalten | $0.9074 | Preisliste der Produktseite | Produktseite, geprüft am 2026-11-11 |
grok-imagine-video-1.5 |
1080p | 5 s | Nicht enthalten (Eingabebild wird nicht berechnet) | $1.25 | Sekundenpreis der Produktseite × 5 | Produktseite, geprüft am 2026-11-11 |
doubao-seedance-2-5-260628 |
720p | 5 s | Nicht enthalten | $1.3721 | Preisliste der Produktseite (Abrechnung nach Fläche × Dauer, Abweichungen von ±5 % sind normal) | Produktseite, geprüft am 2026-11-11 |
Bei gleichen Eckdaten (720p, 5 Sekunden, ohne Referenzvideo, laut Detailseite geprüft am 11.11.2026) kostet Seedance 2.5 mit $1,3721 etwa das 4,7-Fache von wan3.0-video ($0,294) und etwa das 3,0-Fache von mini ($0,4508). Dieser Faktor sagt nur etwas über die Kosten pro Video aus, nicht darüber, ob die Untertitel besser sind. Außerdem weicht ein FAQ-Eintrag auf der Detailseite beim Preis von 2.5 leicht von der Preisliste ab. In diesem Artikel gilt die Preisliste.
Beim Blick auf die Gesamttabelle gibt es ein paar Felder, die man leicht falsch liest. Die Seedance-Felder zeigen den Basispreis pro Million Token, bevor der Gruppenmultiplikator von 0,18 angewendet wird. Es ist also nicht der Preis in Dollar für ein Video. Bei wan3.0-video steht in der Gesamttabelle nur ein einziger Preis pro Sekunde, und der gilt für 480P, nicht für alle Auflösungen. Bei HappyHorse steht in der Gesamttabelle der Basispreis für nutzungsbasierte Abrechnung, nicht der Preis pro Sekunde. Wer sekundengenau rechnen will, muss auf die Detailseite schauen. Für den Preisvergleich empfehle ich die Modellliste auf APIYI (apiyi.com) zusammen mit den gestaffelten Preisen auf den Detailseiten der einzelnen Modelle.
Empfehlungen für Untertitel bei KI-generierten Videos
Szenario 1: KI-Videos mit Untertiteln, die sich ändern und übersetzen lassen
Dazu gehören Tutorials, Produktdemos und alle Inhalte, die in mehreren Sprachen erscheinen sollen. Untertitel in solchen Videos müssen früher oder später angepasst werden: Der Kunde findet einen Tippfehler, die Terminologie soll vereinheitlicht werden, der Markt verlangt eine englische Version. Der einzig verlässliche Weg ist die Transkription in der Nachbearbeitung. Das Videomodell liefert dabei nur das fertige Video mit Tonspur.
In diesem Szenario wählen Sie das Videomodell nach Bildanforderungen und Budget aus. Untertitel spielen für die Auswahl keine Rolle. Wichtig ist aber, dass im fertigen Video nicht schon wirre Untertitel eingebrannt sind, sonst überlagern sich später die nachträglichen Untertitel mit dem Text im Bild. Bei Seedance sollten Sie deshalb in der Eingabeaufforderung eine Vorgabe „keine Untertitel“ ergänzen. Bei anderen Modellreihen steht auf der Detailseite zwar nichts zur Untertitelfähigkeit, trotzdem sollten Sie das Bild nach der Generierung prüfen.
Szenario 2: Kurzvideos, die nur Dialogtext am unteren Rand brauchen und bei denen ein erneutes Generieren in Ordnung ist
Wenn Sie nur kurze Hochformatvideos für Plattformen produzieren, reicht eine Dialogzeile am unteren Bildrand. Wenn gelegentliche Fehler und ein erneuter Versuch für Sie akzeptabel sind, können Sie allein mit Seedance eingebrannte Untertitel nach der Volcengine-Vorlage erzeugen. Schreiben Sie in der Eingabeaufforderung genau, welcher Untertiteltext erscheinen soll, und verlangen Sie, dass er zum Rhythmus des Audios passt. Bleiben Sie außerdem bei gebräuchlichen Schriftzeichen und vermeiden Sie seltene Zeichen und Sonderzeichen.
Beachten Sie, dass das keine zuverlässige Lieferung ist. Bei einem falschen Schriftzeichen kostet jeder neue Versuch eine weitere Videogenerierung. Testen Sie die Eingabeaufforderung daher zuerst mit mini oder fast. Erst wenn die Untertitel-Formulierung stabil funktioniert, lohnt sich ein höheres Modell. Gehen Sie wegen der Untertitel nicht direkt auf 2.5.
Szenario 3: Im fertigen Video darf kein Untertitel auftauchen
Markenfilme, Material für den weiteren Schnitt und Rohmaterial, das später mehrsprachige Untertitel bekommt, brauchen alle ein sauberes Bild. Bei Seedance müssen Sie in der Eingabeaufforderung ausdrücklich schreiben: „Keine Untertitel beibehalten“ und „Keinen Text und keine Untertitel generieren“. Entfernen Sie außerdem vorab Text aus Referenzbildern und Referenzvideos und erzeugen Sie möglichst Querformat. Laut offizieller Anleitung erscheinen im Querformat deutlich seltener ungewollte Untertitel als im Hochformat. Im Hochformat lässt sich das notfalls durch Zuschneiden im Schnitt beheben.
Selbst wenn Sie alle drei Punkte umsetzen, lässt sich laut offizieller Aussage nicht zu 100 % ausschließen, dass Untertitel auftauchen. Deshalb müssen Sie das fertige Video immer von Hand prüfen. Bei Projekten mit höchsten Anforderungen an ein sauberes Bild können Sie im Bildaufbau Spielraum für das Zuschneiden einplanen.
Entscheidungshilfe: Untertitel bei KI-generierten Videos
Hier die bisherigen Inhalte als Entscheidungstabelle, an der Sie sich bei jedem konkreten Video orientieren können:
| Ihr Bedarf | Welcher Weg | Richtung beim Videomodell | Das sollten Sie nicht tun |
|---|---|---|---|
| Untertitel müssen editierbar, übersetzbar und zeitlich synchron sein | Weg 2: nachträgliche Transkription | Nach Bild und Budget wählen, Hauptsache mit Tonspur | Von irgendeinem Videomodell eine Untertiteldatei erwarten |
| Kurzvideo mit Dialogtext am unteren Rand, Neugenerieren ist okay | Weg 1: Einbrennen per Seedance | Prompts zuerst mit mini / fast abstimmen | Wegen des Untertiteleffekts auf 2.5 upgraden |
| Das fertige Video darf keine Untertitel enthalten | Weg 2, oder Seedance mit Einschränkung „keine Untertitel“ | Querformat bevorzugen, Referenzmaterial vorher von Text befreien | Darauf vertrauen, dass die Einschränkung zu 100 % wirkt |
| Lippensynchronität nötig | Weg 2 mit Untertiteln | wan2.7-i2v mit driving_audio |
HappyHorse Bild-zu-Video für Lippensynchronität nutzen |
| Standard-Tonspur und niedriger Preis | Weg 2 mit Untertiteln | Oxygen, Wan3.0 480P, Grok 1.5-lite, MiniMax H3 | Annehmen, dass günstige Stufen keine Untertitel können |
Die beiden Wege lassen sich in einem Satz gegenüberstellen: Das Einbrennen per Eingabeaufforderung punktet damit, dass das Video sofort mit Text kommt und kein zusätzlicher Schritt nötig ist. Die Schrift steckt aber in den Pixeln, lässt sich weder ändern noch übersetzen, und wenn man sie loswerden will, bleiben Reste. Die nachträgliche Transkription kostet einen Arbeitsschritt mehr, liegt dafür aber bei Untertitelgenauigkeit, zeitlicher Synchronisation und Wiederverwendung in mehreren Sprachen klar vorn – und eignet sich für alle Videos, die Sie tatsächlich ausliefern müssen.
Damit ergibt sich auch, wie Sie bei den Testkosten sparen. Reichen 15 Sekunden und 720p, schauen Sie sich zuerst Seedance mini oder die Standardversion von Wan3.0 an. Brauchen Sie eine Standard-Tonspur zum kleinen Preis, kommen Oxygen, Wan3.0 480P, Grok 1.5-lite und MiniMax H3 infrage. Zu den Unterschieden zwischen Grok, Hailuo und Seedance gibt es auf der Fachseite keinen Untertitelvergleich mit identischer Aufgabe. Die Frage, welcher Anbieter die besseren Untertitel liefert, ist deshalb kein Grund, das Modell zu wechseln.
💡 Empfehlung: Entscheiden Sie zuerst das Untertitelkonzept, wählen Sie das Videomodell erst danach. Am besten lassen Sie auf APIYI (apiyi.com) mit demselben Schlüssel zwei, drei Modellstufen dieselbe Aufgabe als Beispielclip erzeugen und vergleichen nur Bild und Tonspur. Die Untertitel übernimmt einheitlich die Nachbearbeitung. So vergleichen Sie genau den Teil, für den Sie wirklich bezahlen.
Zwei Kanäle gehören nicht zu den Empfehlungen. Laut einer Ankündigung von APIYI vom 09.11.2026 hat Google am 22.10.2026 veo-3.1-generate-preview und veo-3.1-fast-generate-preview eingestellt. Damit ist auch der offizielle VEO-3.1-Weiterleitungskanal von APIYI abgeschaltet, und derzeit gibt es keinen Videokanal aus dem Google-Umfeld. Laut derselben Mitteilung sind auch die Kanäle rund um Sora 2 offline.
FAQ: Häufige Fragen zu Untertiteln in KI-generierten Videos
Q1: Was sind „brauchbare Untertitel“ bei KI-generierten Videos?
Brauchbare Untertitel müssen drei Bedingungen gleichzeitig erfüllen: Der Text ist korrekt, Timing und gesprochener Text passen zusammen, und man kann den Text nachträglich noch ändern oder übersetzen. Videomodelle erzeugen eine Tonspur. Schrift, die fest in die Pixel eingebrannt ist, lässt sich nicht separat bearbeiten und zählt deshalb nicht als brauchbarer Untertitel.
Q2: Welcher Anbieter liefert fertige Untertitel – Grok, Hailuo oder Wanxiang?
Keiner. Auf den Produktseiten von Wan3.0, Wan2.7, HappyHorse, MiniMax H3, Oxygen und Grok Imagine ist nur von Tonspur oder audiogesteuerter Erzeugung die Rede. Es gibt keinen Untertitel-Parameter, und einen Vergleichstest mit identischer Aufgabenstellung zu Untertiteln gab es auch nicht. Ein Modellwechsel spart höchstens Kosten bei der Videoerzeugung. Die Untertitel müssen weiterhin per Transkription in der Nachbearbeitung entstehen.
Q3: Sind eingebrannte Untertitel bei Seedance 2.5 besser als bei 2.0?
Dafür gibt es keine Belege. Der Leitfaden zu Eingabeaufforderungen von Volcengine trägt den Titel „2.0-Serie“ und nennt keine abweichende Untertitel-Fähigkeit für 2.5. Die Stärken von 2.5 liegen bei der Dauer von 4–30 Sekunden, mehr Referenzbildern und der mov-Ausgabe – nicht bei Untertiteln.
Q4: In der Modellübersicht taucht Grok Imagine nicht auf – ist es nicht verfügbar?
Doch, es ist verfügbar. Die drei Grok-Imagine-Modelle haben auf ihren Produktseiten Preise, nur fehlen diese drei Zeilen in der Modellübersicht vom 10.11.2026, 15:40 Uhr. Prüfen Sie vor dem Aufruf in der Konsole von APIYI (apiyi.com), ob die Gruppe `GrokOfficial` freigeschaltet ist. Außerdem gilt: Wenn Sie das Audio abschalten, wird es nicht günstiger.
Q5: Wie rufe ich diese Videomodelle schnell per API auf?
Registrieren Sie sich bei APIYI und holen Sie sich Ihren API-Schlüssel (Neukunden erhalten ein kostenloses Testkontingent). Rufen Sie dann die Endpunkte gemäß den jeweiligen Produktseiten auf:
– Die OpenAI-kompatible base_url lautet `https://api.apiyi.com/v1`; Oxygen nutzt darunter `POST /v1/videos`
– Seedance läuft über `/seedance/api/v3/…`; wählen Sie für das Token die Gruppe `SeeDance2`
– Wan3.0 wird an `/wan/api/v1/services/aigc/video-generation/video-synthesis` gesendet, zusammen mit dem Header `X-DashScope-Async: enable`
– MiniMax H3 läuft über `/hailuo/v2/video_generation`
Verwenden Sie `/v1/videos` weder für Seedance noch für Wan3.0.
Q6: Welchen Dienst nutze ich für die Transkription in der Nachbearbeitung?
In der aktuellen Modellübersicht von APIYI gibt es weder `whisper-1` noch `gpt-transcribe`. Für die Transkription brauchen Sie also einen separaten Dienst oder eine Schnittsoftware. OpenAI empfiehlt aktuell `gpt-transcribe` für die Texterzeugung; das Beispiel für Zeitstempel auf Wortebene in der Dokumentation verweist aber weiterhin auf `whisper-1`, das am 26.02.2027 abgeschaltet wird. Pro Datei gilt ein Limit von 25 MB. Bei langen Videos extrahieren Sie am besten zuerst die Tonspur und transkribieren dann.
Q7: Welche bekannten Einschränkungen gibt es beim Einbrennen von Untertiteln per Eingabeaufforderung?
– Die Untertitel stecken in den Pixeln: Für Textkorrekturen oder Übersetzungen muss das gesamte Video neu erzeugt werden
– Auch ohne Untertitel-Vorgabe können ungewollt Untertitel erscheinen; laut offizieller Angabe lässt sich das nicht zu 100 % vermeiden
– Im Hochformat tauchen ungewollte Untertitel häufiger auf als im Querformat, und Schrift im Referenzmaterial erhöht das Risiko
– Seltene Schriftzeichen und Sonderzeichen werden leicht fehlerhaft dargestellt, greifen Sie daher bevorzugt zu gebräuchlichen Zeichen
Die wichtigsten Erkenntnisse zu Untertiteln bei KI-generierten Videos (Key Takeaways)
- Tonspur ist nicht gleich Untertitel: Videomodelle liefern Audio, das fest im fertigen Clip eingebettet ist – keine Untertiteldatei
- Nur Seedance beschreibt das Einbrennen: Der Volcengine-Leitfaden unterstützt das Einbrennen von Untertiteln in die Pixel, bietet aber keine Untertiteldatei
- Untertitel entfernen klappt nicht zu 100 %: Nötig sind Einschränkungs-Begriffe plus Referenzmaterial ohne Text; Querformat hat Vorrang
- Andere Serien ohne Untertitel-Parameter: Die Einzelseiten zu Wan, HappyHorse, MiniMax H3, Oxygen und Grok erwähnen nur die Tonspur
- Editierbare Untertitel entstehen in der Nachbearbeitung: Die Tonspur des fertigen Videos transkribieren, dann ins Bild einbrennen oder als Sidecar-Datei ablegen
- Ein Modellwechsel spart nur Generierungskosten: Wechseln Sie nicht auf 2.5 wegen der Untertitel, sondern schauen Sie zuerst auf günstigere Stufen wie mini oder Wan3.0
- So starten Sie: Mit einem einzigen Schlüssel bei APIYI mehrere Stufen als Testclips durchlaufen lassen; maßgeblich sind die Preise in der Modellliste der Plattform
Fazit
Wenn es darum geht, wie man KI-generierten Videos Untertitel hinzufügt, laufen die Kernpunkte auf drei Aussagen hinaus:
- Editierbare Untertitel kommen nicht direkt aus dem Modell: Kein einziges Videomodell gibt eine Untertiteldatei als Ausgabe aus. Wer Untertitel bearbeiten oder übersetzen will, muss in der Nachbearbeitung transkribieren.
- Das Einbrennen bei Seedance ist nur eine Notlösung: Laut dem Volcengine-Leitfaden zur Eingabeaufforderung lässt sich Text ins Bild einbrennen. Das passt für kurze Videos, bei denen ein erneutes Generieren okay ist, ist aber keine stabile Lösung für die Auslieferung – und wer Untertitel wieder loswerden will, wird sie nicht sauber los.
- Sparen heißt, die Stufe beim Rendern zu wechseln – nicht, Untertiteln hinterherzujagen: Bei gleichen Bedingungen (720p, 5 Sekunden, ohne Referenzvideo; Stand der Einzelseiten: 2026-11-11) kostet 2.5 etwa das 4,7-Fache der Wan3.0-Standardversion. Für diesen Aufpreis bekommen Sie keine besseren Untertitel.
Als Nächstes empfiehlt es sich, zuerst das Untertitel-Konzept festzulegen und erst dann das Videomodell auszuwählen. Nutzen Sie am besten das kostenlose Testkontingent von APIYI (apiyi.com) und lassen Sie zunächst Testclips mit günstigen Stufen wie mini, Wan3.0 oder Oxygen laufen, um Bild und Tonspur zu prüfen. Die Untertitel übernimmt dann durchgehend die Nachbearbeitung.
📚 Referenzen
- Volcengine „Doubao Seedance 2.0 Serie – Leitfaden für Eingabeaufforderungen“: Hinweise zu Texterzeugung und Untertitel-Formulierungen, zur Untertitelfreiheit als Vorgabe und zum Umgang mit ungewollt auftauchenden Untertiteln
- Link:
docs.volcengine.com/docs/ark/seedance-2-0-prompt-guide -
Anmerkung: Die Untertitel-Vorlage aus Weg 1 und die Aussage, dass sich Untertitel „nicht zu 100 % vermeiden lassen“, stammen aus diesem Leitfaden (abgerufen am 11.11.2026)
-
OpenAI-Leitfaden zu Speech-to-Text: Beschreibung der Transkriptionsschnittstelle
gpt-transcribeund der Zeitstempel-Parameter - Link:
platform.openai.com/docs/guides/speech-to-text -
Anmerkung: Quelle für Schnittstelle, Dateigrößenlimit und Abschalttermine veralteter Modelle im Nachbearbeitungs-Ansatz (abgerufen am 11.11.2026)
-
APIYI-Dokumentationszentrum · Seiten zu Videomodellen: Parameter und gestaffelte Preise für Seedance, Wan3.0, Wan2.7, HappyHorse, MiniMax H3, Oxygen und Grok Imagine
- Link:
docs.apiyi.com/api-capabilities/ - Anmerkung: Quelle für Modellbezeichnungen, Endpunkte, Gruppierung und die 5-Sekunden-Dokumentationspreise; die Abschaltankündigung für VEO 3.1 findet sich auf derselben Seite unter
/live/2026-11/veo-3-1-official-offline
Autor: APIYI-Technikteam
Austausch: Schreiben Sie uns gerne über die Startseite von APIYI. Weitere Modellparameter und Hinweise zum Modellaufruf finden Sie im Dokumentationszentrum unter docs.apiyi.com