Hinweis des Autors: Dieser Beitrag vergleicht die gestaffelten Eingabepreise von GPT-6.2 Sol und 6.1 Sol bei APIYI. Anhand eines Rechenbeispiels für ein langes Dokument mit 300.000 Token zeigt er, wie sich die Eingabekosten oberhalb der Schwelle unterscheiden, und liefert eine Checkliste zur Rechnungsprüfung.
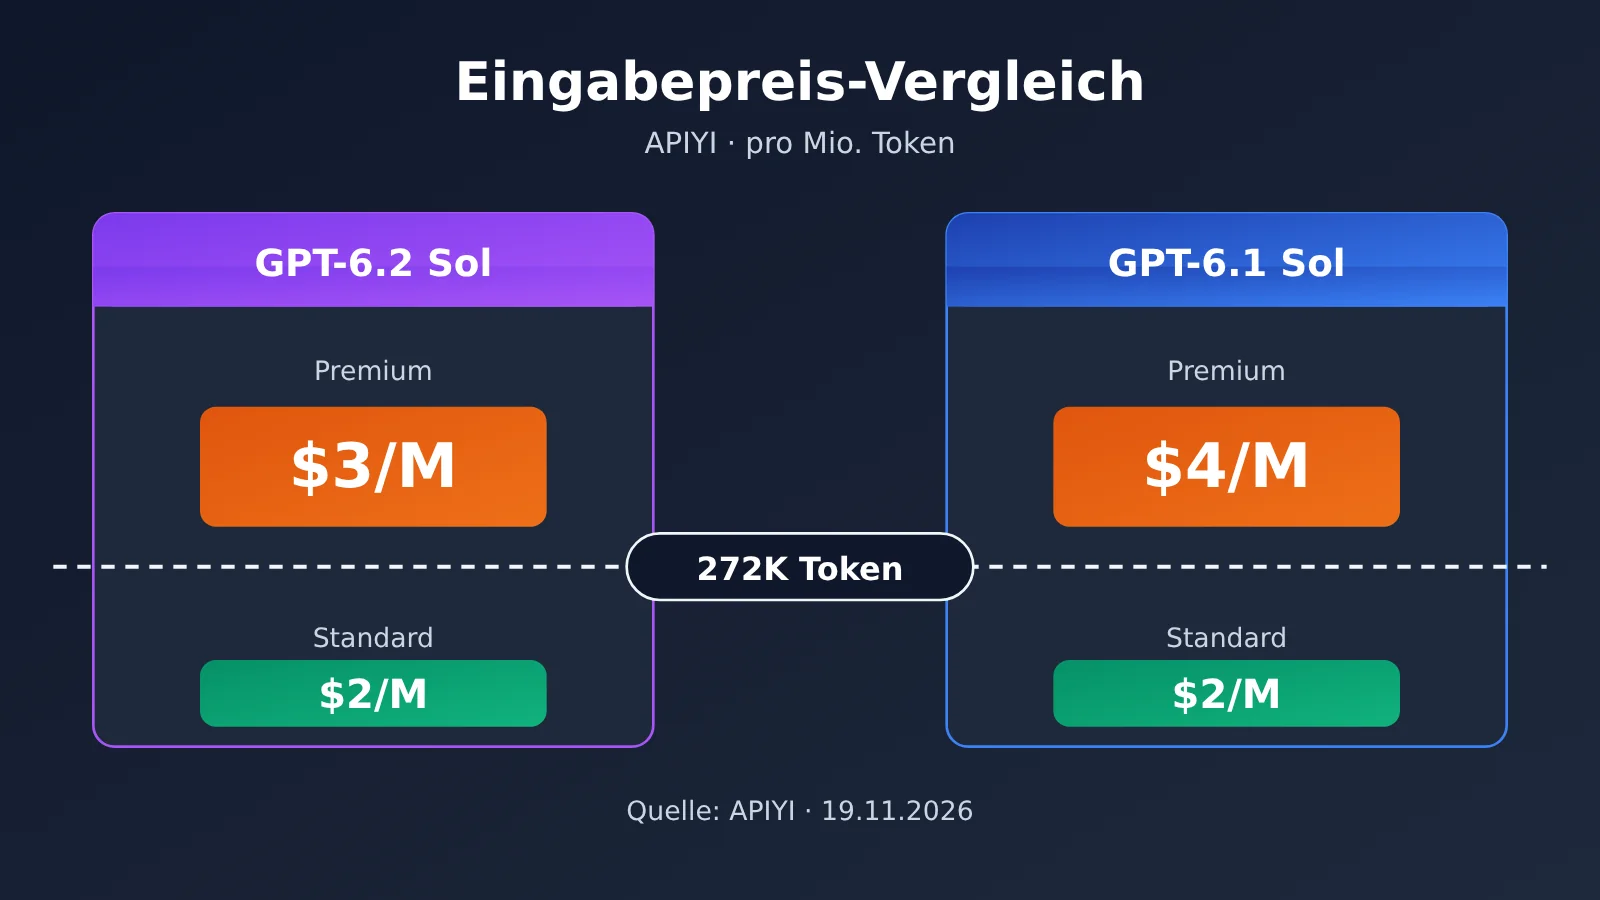
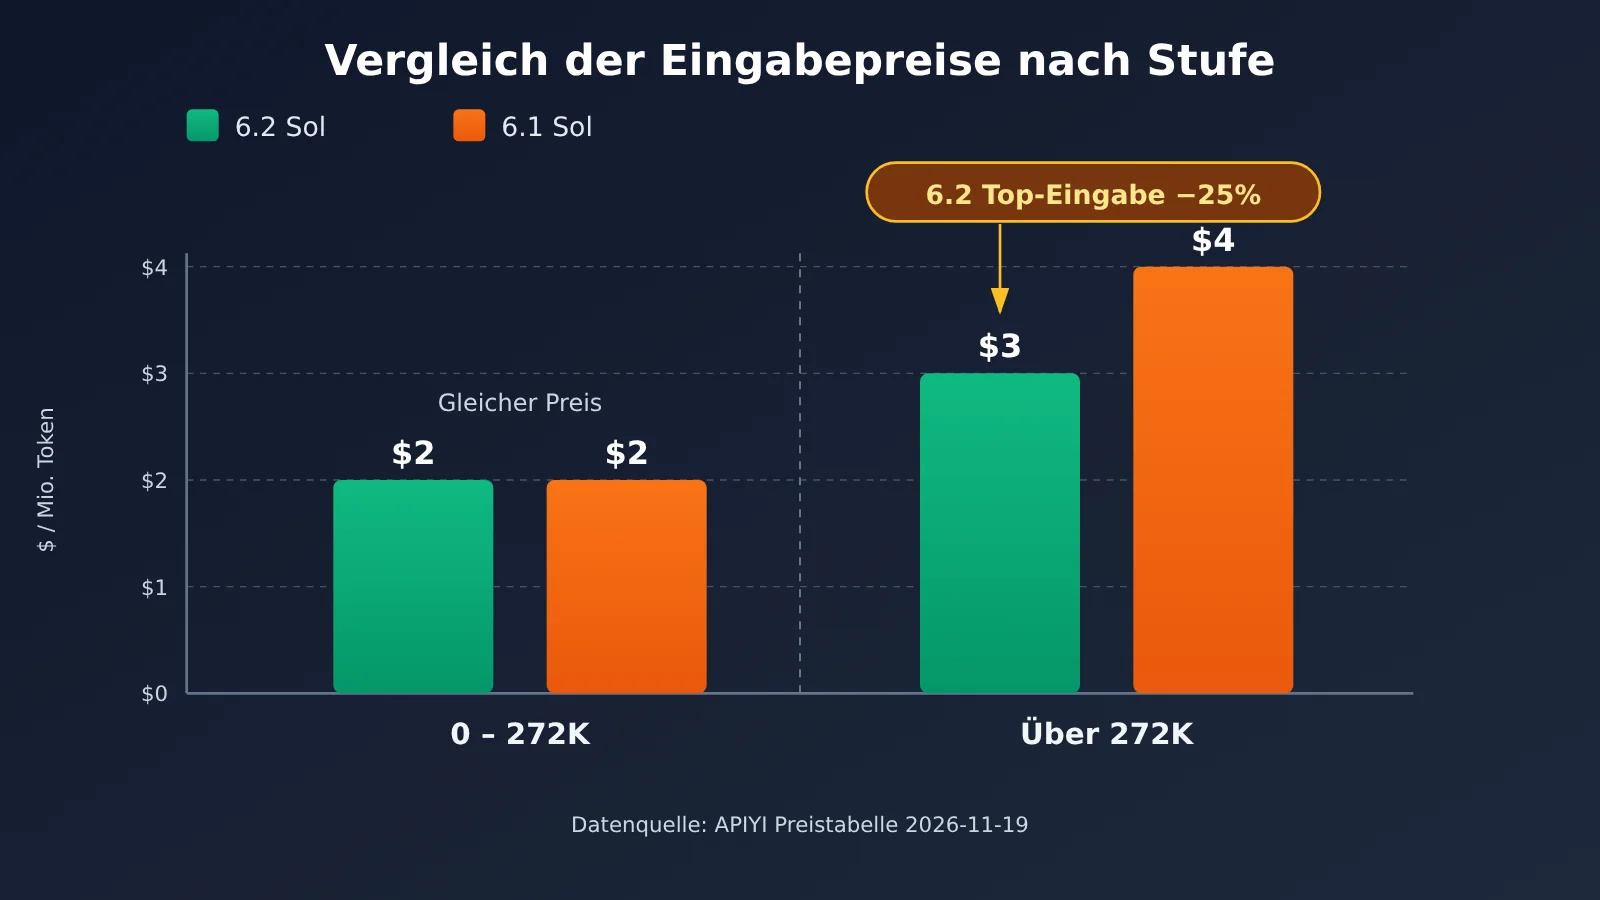
Vorab das Fazit: Bis zu 272.000 Token pro Eingabe kostet der Eingabepreis bei APIYI sowohl für GPT-6.2 Sol als auch für 6.1 Sol $2 pro Million Token. Bei diesem Tarif spart keine der beiden Varianten. Der Unterschied zeigt sich erst in der höheren Preisstufe über 272.000 Token. Die in der APIYI-Preisübersicht aufgeführten Eingabepreise für diese Stufe liegen bei $3 für 6.2 Sol und $4 für 6.1 Sol (pro Million Token). Damit ist der Listenpreis von 6.2 Sol in der höheren Stufe 25 % niedriger.
Dies ist keine auf einer realen Messung basierende Rechnung. Alle Zahlen in diesem Artikel stammen aus der Modellpreisübersicht von APIYI auf apiyi.com, abgerufen am 2026-11-19. Das Rechenbeispiel mit 300.000 Token ist lediglich eine unter bestimmten Abrechnungsannahmen berechnete Beispielrechnung für Eingabekosten. Es steht nicht für die Gesamtkosten einer Rechnung und enthält weder Ausgabe- noch Cache-Anteile.
Der praktische Nutzen: Nach dem Lesen dieses Artikels können Sie einschätzen, ob Ihre Aufgabe mit langen Dokumenten in die höhere Preisstufe fällt, den Unterschied bei den Eingabekosten von GPT-6.2 Sol gegenüber 6.1 Sol berechnen und wissen, welche Rechnungsposten Sie vor dem Livegang prüfen sollten.
GPT-6.2 Sol im Vergleich zu 6.1 Sol: zentrale Unterschiede bei den gestaffelten Eingabepreisen
Beide Modelle verwenden bei APIYI eine gestaffelte Preisgestaltung; die Grenze liegt bei 272.000 Token. Die folgende Tabelle stellt die Eingabepreise innerhalb und außerhalb dieses Schwellenwerts gegenüber. Die Daten stammen aus den Erläuterungen zur gestaffelten Preisgestaltung in der APIYI-Modellpreisübersicht; Stand: 2026-11-19.
| Eingabebereich | gpt-6.2-sol Eingabepreis | gpt-6.1-sol Eingabepreis | Unterschied | Datenquelle |
|---|---|---|---|---|
| 0 – 272.000 Token | $2 / Million Token | $2 / Million Token | gleich | APIYI apiyi.com Preisübersicht |
| Über 272.000 Token | $3 / Million Token | $4 / Million Token | 6.2 um 25 % niedriger | APIYI Preisübersicht |
Zu beachten ist, dass diese Tabelle nur die Eingabetarife abdeckt. Die öffentliche Preisübersicht von APIYI bestätigt auf dieser Grundlage nicht, dass alle Gruppen den höheren Tarif auf die gesamte Abrechnung anwenden; ebenso wenig werden in dieser Erläuterung die höheren Tarife für Ausgabe und Caching angegeben. Aus „6.2 Sol ist bei Eingaben im höheren Tarif 25 % günstiger“ folgt daher nicht direkt „die gesamte Abrechnung ist 25 % günstiger“. Letzteres muss mit der tatsächlichen Rechnung Ihrer Gruppe abgeglichen werden.
Darüber hinaus enthält die offizielle Modellkarte von OpenAI für gpt-6.2-sol eigene Angaben zu den Tarifstufen. Die offiziellen Regeln des Anbieters und die Plattformpreise von APIYI sind zwei verschiedene Grundlagen; in diesem Artikel werden sie nicht vermischt, und alle Zahlen sind Plattformpreise von APIYI. Wenn Sie die Regeln des Anbieters verstehen möchten, lesen Sie bitte separat die offizielle Modellkarte.
GPT-6.2 Sol vs. 6.1 Sol: Rechenbeispiel für die Eingabegebühr bei 300.000 Token
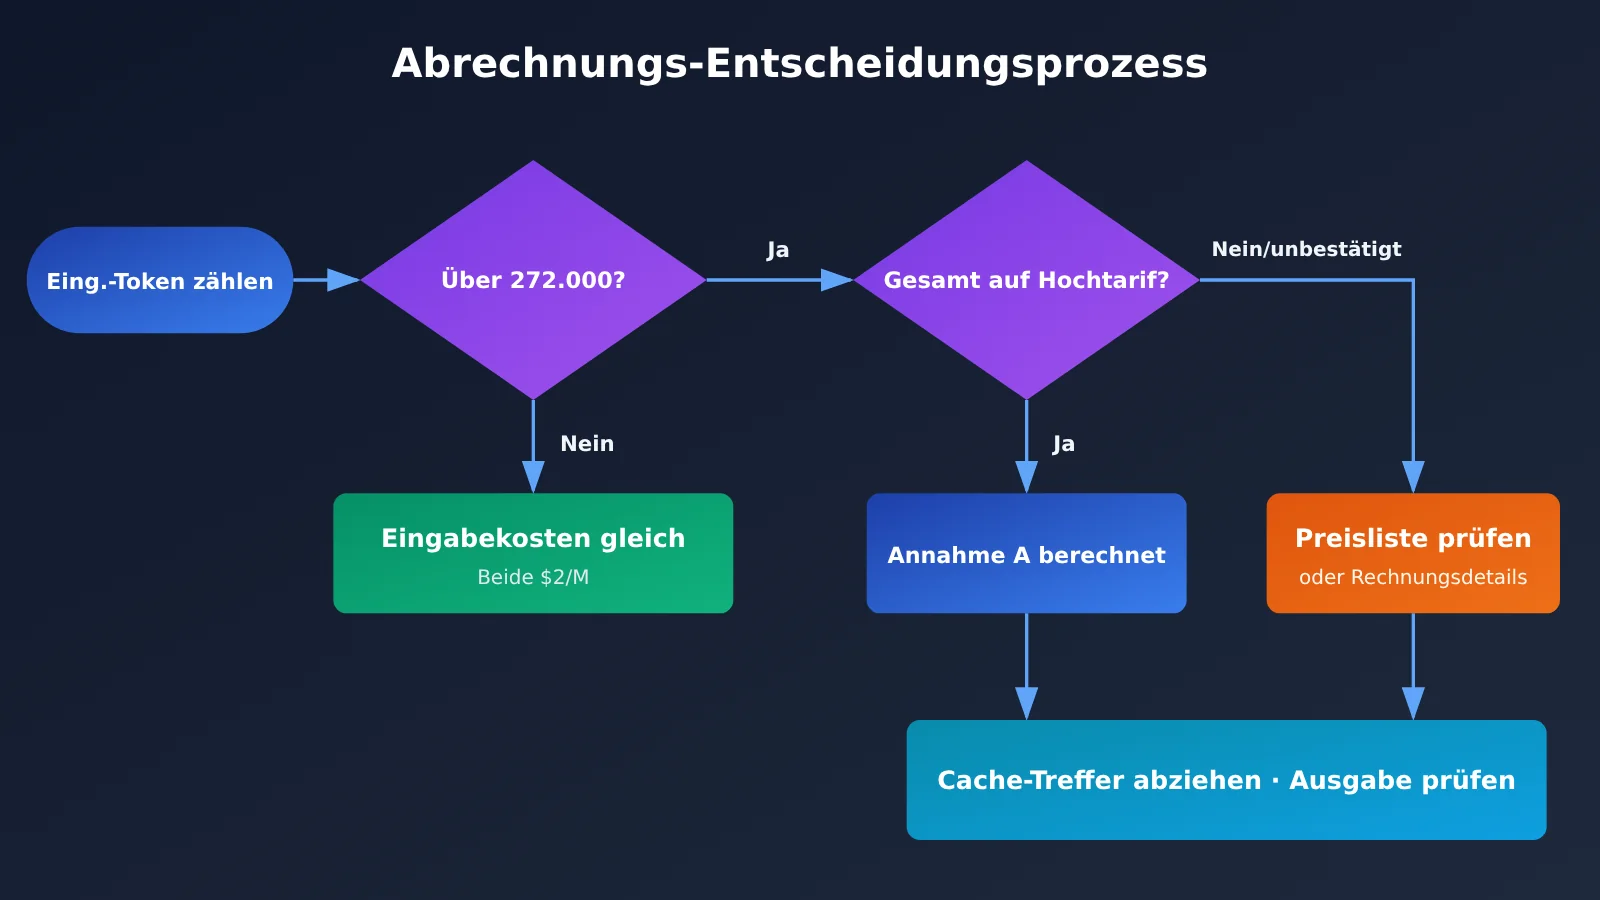
Angenommen, eine Anfrage hat 300.000 Token Eingabe und kein einziger davon trifft den Cache. Damit liegt sie bereits über der Schwelle von 272.000 – entscheidend ist nun, wie die Plattform den höheren Tarif auf diese Anfrage anwendet. Für die Staffelpreisberechnung gibt es zwei gängige Auslegungen; die folgende Tabelle zeigt jeweils das Ergebnis.
| Abrechnungsannahme | Eingabegebühr gpt-6.2-sol | Eingabegebühr gpt-6.1-sol | Differenz | Status |
|---|---|---|---|---|
| A: Hochtarif auf die gesamte Eingabe | 0.3 × $3 = $0.90 | 0.3 × $4 = $1.20 | $0.30 | Beispielrechnung aus der Referenzquelle, Routing noch zu bestätigen |
| B: Hochtarif nur auf den übersteigenden Teil | 0.272 × $2 + 0.028 × $3 = $0.628 | 0.272 × $2 + 0.028 × $4 = $0.656 | $0.028 | Reine mathematische Herleitung, von der Plattform nicht bestätigt |
Wenn die von dir genutzte APIYI-Route bestätigt, dass der Hochtarif auf die gesamte Eingabe angewendet wird, beträgt die Differenz bei einer einzelnen Anfrage mit 300.000 nicht gecachten Eingabe-Token $0.30. Annahme B soll nur zeigen, „dass die Auslegung unterschiedlich ist und die Differenz um eine Größenordnung abweichen kann“ – sie ist keine von der Plattform veröffentlichte Regel. Bevor du dein Budget planst, solltest du klären, zu welcher Auslegung deine Gruppe gehört; das ist wichtiger als jedes Rechenbeispiel.
Drei Unterscheidungen beim Budget für lange Dokumente: Token, Zeichenzahl und Rechnung
Viele Budgetabweichungen entstehen nicht durch die Tarife, sondern durch verwechselte Begriffe. Die folgenden drei Begriffspaare musst du beim Budget für lange Dokumente mit GPT-6.2 Sol oder 6.1 Sol sauber auseinanderhalten.
| Leicht zu verwechseln | Richtiges Verständnis | Auswirkung aufs Budget |
|---|---|---|
| Zeichenzahl vs. Token | Abgerechnet wird nach Token; zwischen Zeichenzahl und Token gibt es kein festes Umrechnungsverhältnis, es variiert je nach Sprache und Inhalt | Man kann „300.000 Zeichen“ nicht einfach in das Rechenbeispiel für 300.000 Token einsetzen |
| Dokument-Token vs. Eingabe-Token pro Anfrage | Die Eingabe einer Anfrage umfasst auch System-Eingabeaufforderung, Gesprächsverlauf, Tool-Definitionen usw. | Das Dokument selbst bleibt unter der Schwelle, mit Kontext kann die Anfrage aber 272.000 überschreiten |
| Theoretische Eingabegebühr vs. tatsächliche Rechnung | Der theoretische Wert ist Listenpreis × Tokenzahl; die tatsächliche Rechnung hängt zusätzlich von Cache-Treffern, Gruppenauslegung und Ausgabegebühr ab | Das Rechenbeispiel taugt nur als Obergrenze, maßgeblich sind die Abrechnungsdetails |
Am zuverlässigsten liest du direkt das usage-Feld der API-Antwort und prüfst anhand der echten prompt_tokens, ob die Schwelle überschritten wird – statt sie über die Zeichenzahl zu schätzen.
So schätzen Sie die Eingabekosten für lange Dokumente bei GPT-6.2 Sol und 6.1 Sol
Minimalbeispiel: tatsächliche Anzahl der Eingabe-Token auslesen
Senden Sie zunächst eine Anfrage und lesen Sie die Anzahl der Eingabe-Token ab, die dieses lange Dokument beim tatsächlichen Aufruf verursacht:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)
print("prompt_tokens:", resp.usage.prompt_tokens)
Vollständigen Implementierungscode ansehen: Eingabekosten nach zwei Abrechnungsannahmen schätzen
import openai

# Preis-Snapshot: APIYI-Preisübersicht, abgefragt am 2026-11-19, Einheit: USD pro Million Token
# Nur Eingabesätze enthalten; Ausgabe- und Cache-Sätze bitte der Plattform-Preisübersicht und der Abrechnung entnehmen
PRICES = {
    "gpt-6.2-sol": {"low": 2.0, "high": 3.0},
    "gpt-6.1-sol": {"low": 2.0, "high": 4.0},
}
THRESHOLD = 272_000

def estimate_input_cost(model: str, input_tokens: int, cached_tokens: int = 0,
                        mode: str = "full") -> float:
    """
    Schätzt die theoretischen Eingabekosten für den nicht zwischengespeicherten Eingabeteil.
    mode="full":     Bei Überschreiten des Schwellenwerts wird der hohe Satz auf den gesamten Betrag angewendet (bitte prüfen, ob die eigene Gruppe so abgerechnet wird)
    mode="marginal": Der hohe Satz wird nur auf den überstehenden Teil angewendet (Annahme; von der Plattform nicht bestätigt)
    cached_tokens wird nur von der Berechnung abgezogen; die Kosten für den zwischengespeicherten Teil müssen separat geprüft werden
    """
    p = PRICES[model]
    uncached = max(input_tokens - cached_tokens, 0)
    if input_tokens <= THRESHOLD:
        return uncached / 1e6 * p["low"]
    if mode == "full":
        return uncached / 1e6 * p["high"]
    low_part = min(uncached, THRESHOLD)
    high_part = max(uncached - THRESHOLD, 0)
    return low_part / 1e6 * p["low"] + high_part / 1e6 * p["high"]

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)

usage = resp.usage
cached = 0
details = getattr(usage, "prompt_tokens_details", None)
if details is not None and getattr(details, "cached_tokens", None):
    cached = details.cached_tokens

for m in PRICES:
    for mode in ("full", "marginal"):
        cost = estimate_input_cost(m, usage.prompt_tokens, cached, mode)
        print(f"{m} [{mode}] 未缓存输入费估算: ${cost:.4f}")
Setzt man input_tokens=300_000 und cached_tokens=0 ein, erhält man im full-Modus $0.90 und $1.20, was mit Rechenbeispiel A oben übereinstimmt. Die Preise im Skript sind ein Snapshot vom Abfragetag und müssen nach einer Preisänderung der Plattform entsprechend aktualisiert werden.
🚀 Schnellstart: Führen Sie am besten zuerst mit dem kostenlosen Testkontingent für neue Nutzer bei APIYI apiyi.com ein echtes langes Dokument aus, lesen Sie
prompt_tokensund die Abrechnungsdetails aus und legen Sie dann das Budget fest – das ist deutlich verlässlicher, als nur anhand der Zeichenzahl zu schätzen.
Szenarioempfehlungen: GPT-6.2 Sol im Vergleich zu GPT-6.1 Sol
Die folgende Tabelle gibt Empfehlungen ausschließlich aus Sicht des Eingabepreises. Unterschiede bei Modellqualität und Geschwindigkeit sind darin nicht enthalten; diese beiden Punkte solltest du mit deinen eigenen Aufgaben praktisch testen.
| Dein Szenario mit langen Dokumenten | Fazit aus Sicht des Eingabepreises | Empfohlene Aktion |
|---|---|---|
| Eine einzelne Eingabe bleibt stabil unter 272.000 Token | Beide kosten $2 pro Million Token, bei diesem Tarif gibt es keinen Unterschied | Wähle nach Ergebnis und anderen Kostenpositionen; erwarte keine Einsparung über den Eingabepreis |
| Eine einzelne Eingabe überschreitet häufig 272.000 Token | Bei GPT-6.2 Sol ist der Preis für die höhere Eingabestufe um 25 % niedriger | Nachdem du die Abrechnungslogik der Gruppe bestätigt hast, evaluiere vorrangig GPT-6.2 Sol |
| Die Eingabe schwankt um den Schwellenwert | Der Unterschied hängt vom Anteil der Anfragen über dem Schwellenwert ab | Erhebe über einen Zeitraum die Verteilung von prompt_tokens und entscheide dann |
| Dasselbe Dokument wird wiederholt abgefragt | Cache-Treffer verändern die tatsächliche Rechnung | Prüfe den Tarif für den Cache-Anteil separat und extrapoliere nicht anhand der ungecachten Berechnung |
Typische Fälle für GPT-6.2 Sol
- Bei Verträgen, Finanzberichten, Code-Repositories und anderen sehr langen Materialien muss alles auf einmal ins Kontextfenster; die Eingabe liegt oft über 272.000 Token.
- Das Budget wird überwiegend von den höheren Eingabekosten aufgebraucht, und die Abrechnungslogik der jeweiligen Gruppe ist bereits bestätigt.
Typische Fälle für die weitere Nutzung von GPT-6.1 Sol
- Die Eingaben bleiben dauerhaft unter dem Schwellenwert; dieser Tarif ist identisch mit GPT-6.2 Sol, ein Wechsel bringt keine Einsparung bei den Eingabekosten.
- Der bestehende Ablauf läuft bereits stabil auf GPT-6.1 Sol; vor einer Migration solltest du zuerst die Unterschiede bei den Ergebnissen bewerten.
GPT-6.2 Sol vs. 6.1 Sol: Entscheidungshilfe und Abrechnungs-Checkliste
Die Entscheidungslogik lässt sich in einem Satz zusammenfassen: Bleibt man unter dem Schwellenwert, spart dieser Tarif kein Geld; wird er überschritten, müssen Tarifgruppe, Cache und Ausgabe gemeinsam geprüft werden. Bevor Sie Langdokument-Aufgaben produktiv einsetzen, sollten Sie die folgende Checkliste Punkt für Punkt durchgehen.
| Prüfpunkt | Zu klärende Frage | Prüfmethode |
|---|---|---|
| Eingabe-Token je Anfrage | Liegt die Anzahl tatsächlich über 272.000? Sind System-Prompt und Verlauf enthalten? | usage.prompt_tokens aus der Antwort auslesen |
| Tarifgruppe | Wird nach Überschreiten des Schwellenwerts der gesamte Betrag mit dem hohen Tarif belegt, oder gilt eine andere Regel? | Hinweise zur Staffelpreisberechnung in der APIYI-Preisübersicht nachsehen, bei Bedarf beim Plattformbetreiber nachfragen |
| Cache-Treffer | Wie viele Eingaben treffen den Cache, und wie wird der Cache-Anteil abgerechnet? | cached_tokens-Feld und Abrechnungsdetails einsehen |
| Ausgabekosten | Wird auch die Ausgabe gestaffelt, und wie hoch ist der Tarif? | Maßgeblich ist die Plattform-Preistabelle; dieser Artikel zitiert keine unbestätigten Ausgabepreise |
| Aktualität der Preise | Der Snapshot dieses Artikels ist vom 2026-11-19 — wurden die Preise inzwischen angepasst? | Vor dem Aufruf die Preisübersicht erneut abfragen |
| Konsistenz der Berechnungsgrundlage | Werden offizielle Hersteller-Stufen und Plattformpreise miteinander vermischt? | Herstellerregeln separat kennzeichnen; für das Budget nur eine Berechnungsgrundlage verwenden |
💡 Auswahlempfehlung: Wenn Ihre Langdokument-Aufgaben tatsächlich häufig den Schwellenwert überschreiten, empfiehlt es sich, auf APIYI apiyi.com mit demselben Dokument sowohl gpt-6.2-sol als auch gpt-6.1-sol aufzurufen, die Abrechnungsdetails der beiden Aufrufe zu vergleichen und dann zu entscheiden, ob ein Wechsel sinnvoll ist. Mit demselben API-Schlüssel lässt sich das Modell wechseln, was solche Vergleiche erleichtert.
Häufig gestellte Fragen (FAQ)
F1: GPT-6.2 Sol im Vergleich zu 6.1 Sol – wo genau unterscheidet sich der Eingabepreis?
Der Unterschied liegt nur in der höheren Preisstufe. Laut der Preistabelle von APIYI kostet die Eingabe bei 0–272.000 Token bei beiden Modellen 2 $ pro Million Token. Oberhalb von 272.000 Token kostet 6.2 Sol 3 $ und 6.1 Sol 4 $ – 6.2 Sol ist also 25 % günstiger.
F2: Entspricht ein Dokument mit 300.000 Zeichen genau 300.000 Token?
Nein. Es gibt kein festes Umrechnungsverhältnis zwischen Zeichenzahl und Token, außerdem enthält eine einzelne Eingabe auch den System-Prompt und den Gesprächsverlauf. Prüfen Sie am besten den von der Schnittstelle zurückgegebenen `prompt_tokens`-Wert, um zu sehen, ob die Schwelle überschritten wird.
F3: Spart man mit 6.2 Sol bei einer Eingabe von 300.000 Token garantiert 0,30 $?
Nicht unbedingt. Die 0,30 $ sind eine illustrative Eingabegebühr, berechnet unter der Annahme, dass die gesamte Eingabe zur höheren Preisstufe zählt und kein Cache-Treffer vorliegt. Bei anderer Gruppierungslogik oder Cache-Treffern ändert sich die Differenz, und die Ausgabegebühr ist dabei nicht eingerechnet.
F4: Kann man sagen, dass 6.2 Sol über die gesamte Rechnung 25 % günstiger ist als 6.1 Sol?
Nein. Die 25 % beziehen sich nur auf die Differenz des Listenpreises für Eingaben in der höheren Stufe. Aus der öffentlichen Gesamttabelle von APIYI lassen sich weder die Abrechnungsregeln für ganze Rechnungen in allen Gruppen noch die Tarife für Ausgaben und Caching in der höheren Stufe ableiten – für den Unterschied der Gesamtrechnung muss man die tatsächliche Abrechnung heranziehen.
F5: Wie kann man die Kosten für lange Dokumente auf APIYI schnell überprüfen?
1. Auf APIYI unter apiyi.com registrieren und einen API-Schlüssel anfordern – neue Nutzer erhalten ein kostenloses Testkontingent
2. Mit dem Code aus diesem Artikel `base_url` auf `https://api.apiyi.com/v1` setzen und ein echtes langes Dokument senden
3. `prompt_tokens` und `cached_tokens` erfassen und mit den Abrechnungsdetails der Plattform vergleichen
F6: Welche Einschränkungen haben die Daten in diesem Artikel?
Die Zahlen in diesem Artikel stammen ausschließlich aus der am 19.11.2026 abgefragten Preistabelle der Plattform. Sie sind keine gemessene Abrechnung und betreffen weder Ausgabepreise noch Modellqualität oder Geschwindigkeit. Die Stufenregeln der offiziellen Model-Cards der Anbieter und die Listenpreise der Plattform folgen unterschiedlichen Bezugsgrößen; in diesem Artikel wurden sie nicht vermischt. Bei Preisänderungen gilt die jeweils aktuelle Preistabelle.
GPT-6.2 Sol im Vergleich zu 6.1 Sol: die wichtigsten Erkenntnisse (Key Takeaways)
- Gleicher Preis innerhalb der Schwelle: Bis 272.000 Token kostet die Eingabe bei beiden Modellen $2 pro Million Token.
- Auf der hohen Stufe gibt es einen Unterschied: Oberhalb der Schwelle kostet 6.2 Sol $3, 6.1 Sol $4 – das sind 25 % weniger.
- Das Rechenbeispiel hat Voraussetzungen: Setzt man komplett die hohe Stufe ohne Caching an, unterscheiden sich die Eingabekosten bei 300.000 Token um $0,30.
- Token sind nicht gleich Zeichen: Ob die Schwelle überschritten ist, entscheidet
prompt_tokens. - Theorie ist nicht gleich Rechnung: Caching, Gruppierungslogik und Ausgabekosten verändern die tatsächlichen Ausgaben.
- Erst messen, dann das Budget festlegen: Führe bei APIYI apiyi.com einen echten Durchlauf mit deinen Dokumenten aus und entscheide erst dann anhand der Abrechnung.
Zusammenfassung
Die Kernpunkte beim Vergleich von GPT-6.2 Sol und 6.1 Sol bei den Eingabekosten für lange Dokumente:
- Innerhalb der Schwelle kein Unterschied: Bleibt die Eingabe unter 272.000 Token, lässt sich durch einen Modellwechsel bei diesen Kosten nichts sparen.
- Oberhalb der Schwelle zählt der Hochstufen-Tarif: Der Hochstufen-Eingabepreis von 6.2 Sol liegt 25 % unter dem von 6.1 Sol; bei 300.000 Token komplett in der hohen Stufe und ohne Caching beträgt die Differenz $0,30.
- Das Budget richtet sich nach der Rechnung: Prüfe zugleich Gruppierungslogik, Cache-Treffer und Ausgabekosten – das Rechenbeispiel zeigt nur die Eingabekosten.
Wenn dein Geschäft wirklich regelmäßig mit sehr langen Dokumenten zu tun hat, empfiehlt es sich, über APIYI apiyi.com mit echten Anfragen die Abrechnungsdetails beider Modelle zu vergleichen und darauf aufbauend Modellauswahl und Monatsbudget festzulegen.
📚 Referenzen
-
APIYI-Modellpreisübersicht: Erläuterung zur gestaffelten Preisgestaltung
- Link:
docs.apiyi.com/models - Hinweis: Quelle aller in diesem Artikel genannten Eingabepreise; Abfragedatum 2026-11-19. Bitte vor dem Aufruf erneut prüfen.
- Link:
-
Offizielle Modellkarte von OpenAI – gpt-6.2-sol: Offizielle Stufenbeschreibung des Anbieters
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Hinweis: Die Regeln des Anbieters und die Plattformpreise beruhen auf unterschiedlichen Berechnungsgrundlagen und dienen nur als separate Referenz; sie werden nicht mit den Zahlen in diesem Artikel vermischt.
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Informationen zu Abrechnung und Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.