Hinweis des Autors: Die Rangliste des Artificial Analysis Search Index vom 9. November 2026 zeigt: Bleibt das antwortende Modell fest und ändert man nur die Suchkonfiguration, kann die Gesamtpunktzahl von 33 auf 83 Punkte springen. Bei der Auswahl muss man allerdings gleichzeitig Aufgabenkosten, Laufzeit und die Grenzen der Bewertung im Blick behalten.
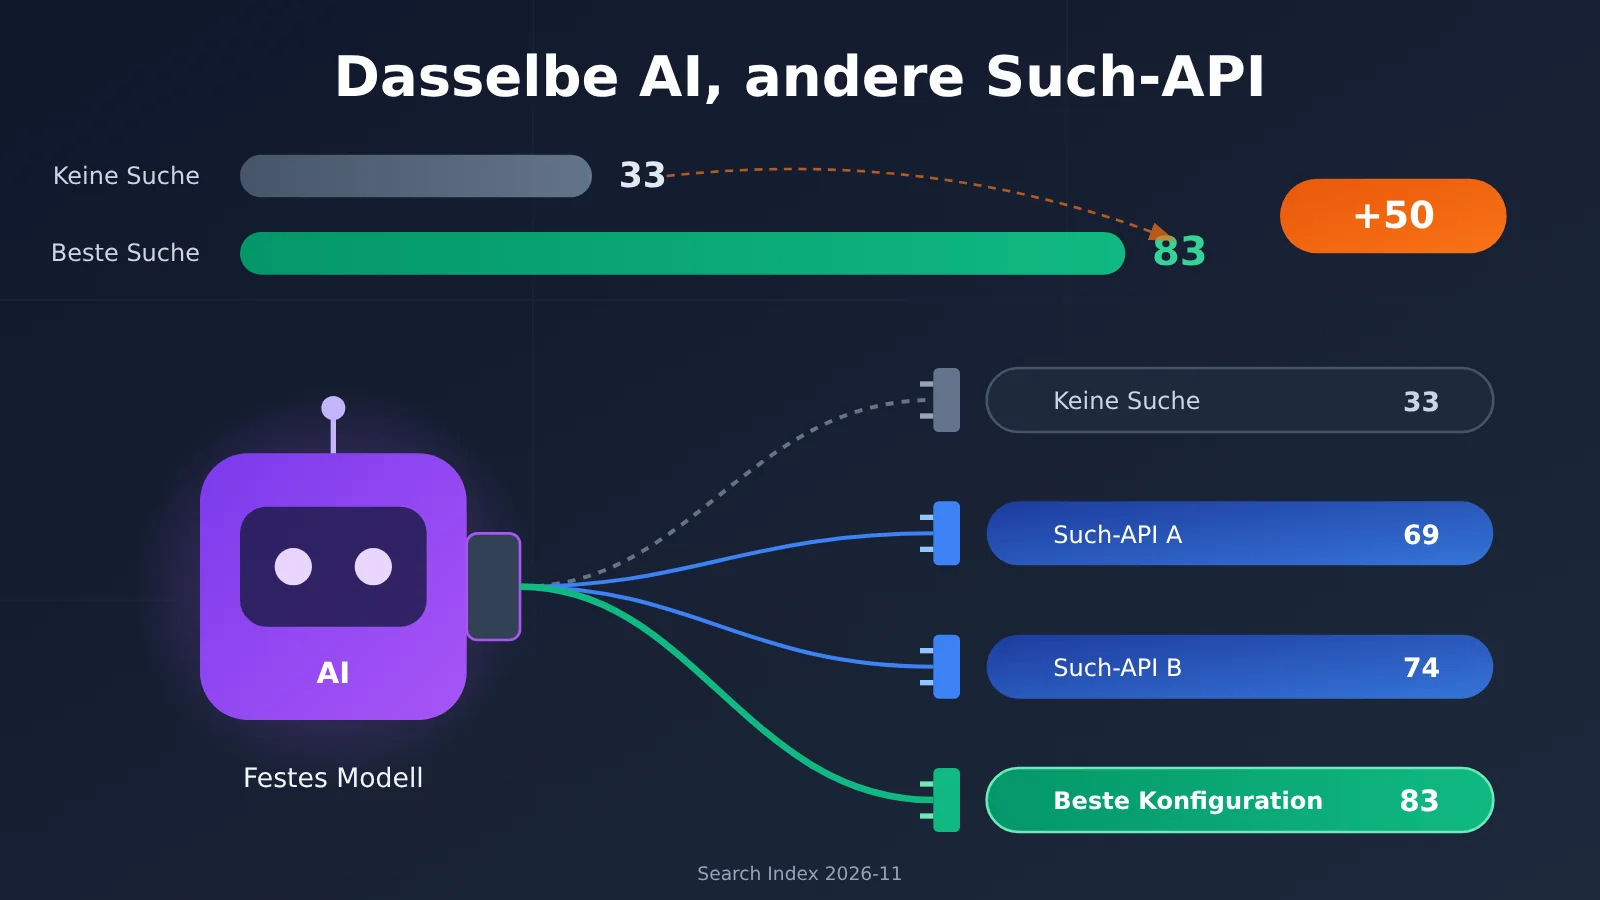
Viele Teams, die einen Agent bauen, suchen sich zuerst das Modell aus und hängen dann nebenbei ein Suchwerkzeug dran. In nicht wenigen Köpfen ist Suche nur ein Zubehörteil nach dem Motto „Hauptsache, es kommt ins Internet“. Der Search Index von Artificial Analysis, aktualisiert am 9. November 2026, liefert ein anderes Bild: Dasselbe Modell kommt ohne Suche auf 33 Punkte, mit der besten Such-API-Konfiguration auf 83 Punkte.
Das ist keine weitere Zusammenfassung einer Rangliste nach dem Motto „Jeder hat eben so seine Stärken“. Dieser Artikel schlüsselt auf, wie die 83 Punkte zustande kommen und unter welchen Testbedingungen sie gemessen wurden, und stellt Qualität, Laufzeit der vollständigen Aufgabe, Suchgebühren und Modellkosten nebeneinander. Zum Schluss geht es szenariobezogen darum, für welche Entscheidungen diese Rangliste taugt – und wo man sie nicht einfach übernehmen sollte.
Der Kernnutzen: Nach dem Lesen kannst du mit der öffentlichen Rangliste eine Vorauswahl an Such-APIs treffen, diese dann mit deinen eigenen Aufgaben nachtesten und so vermeiden, dass du dich nur an der Höchstpunktzahl orientierst.
Begriffe, die man kennen sollte, bevor man die Search-API-Rangliste liest
Zusammenfassung in einem Satz: Der Search Index vergleicht die Leistung desselben Modells unter verschiedenen Suchkonfigurationen – der größte Punkteabstand liegt bei 50 Punkten. Aber „viele Punkte“ heißt nicht „passt am besten zu dir“. Man muss auch Kosten, Laufzeit und die Abdeckung der Evaluierung im Blick behalten.
Bevor du die Rangliste liest, sollten wir ein paar Begriffe einheitlich klären:
- Search Index: Ein Gesamtwert, der aus einem festgelegten Retrieval-Benchmark nach bestimmten Regeln aggregiert wird. In diesem Artikel ist speziell der Search-API-Evaluierungsindex von Artificial Analysis gemeint, maximal 100 Punkte.
- F1: Das harmonische Mittel aus Precision und Recall. Wenn die Antwort „eine Menge von Entitäten“ ist, misst man damit, wie treffsicher und vollständig geantwortet wurde.
- Harness: Ein Testframework, das Modelleingaben, Tool-Ausführung und die Bewertung der Aufgaben organisiert. Die Agent-Schleife, die Artificial Analysis verwendet, heißt Stirrup.
- Search API: Eine Schnittstelle, die zu einer Anfrage Weblinks, Titel, relevante Textausschnitte und ähnliche Suchergebnisse zurückgibt – zum Beispiel Exa, Brave oder die Perplexity Search API.
- Token: Die Maßeinheit, in der Modelle Text verarbeiten. Je ausführlicher die Suchergebnisse, desto mehr Token gehen ins Modell und desto höher die Modellkosten.
Kann die Search API bei derselben KI wirklich 50 Punkte Unterschied ausmachen?
Artificial Analysis hat am 18. August 2026 einen Search-API-Benchmark veröffentlicht. Die neuesten öffentlichen Daten stammen vom 9. November 2026 und decken 14 Anbieter sowie 26 Search-API-Produkte oder -Konfigurationen ab. Bewertet wird nicht das Modell, sondern die tatsächliche Wirkung des Suchdienstes, sobald er in einen Agenten eingebaut ist.
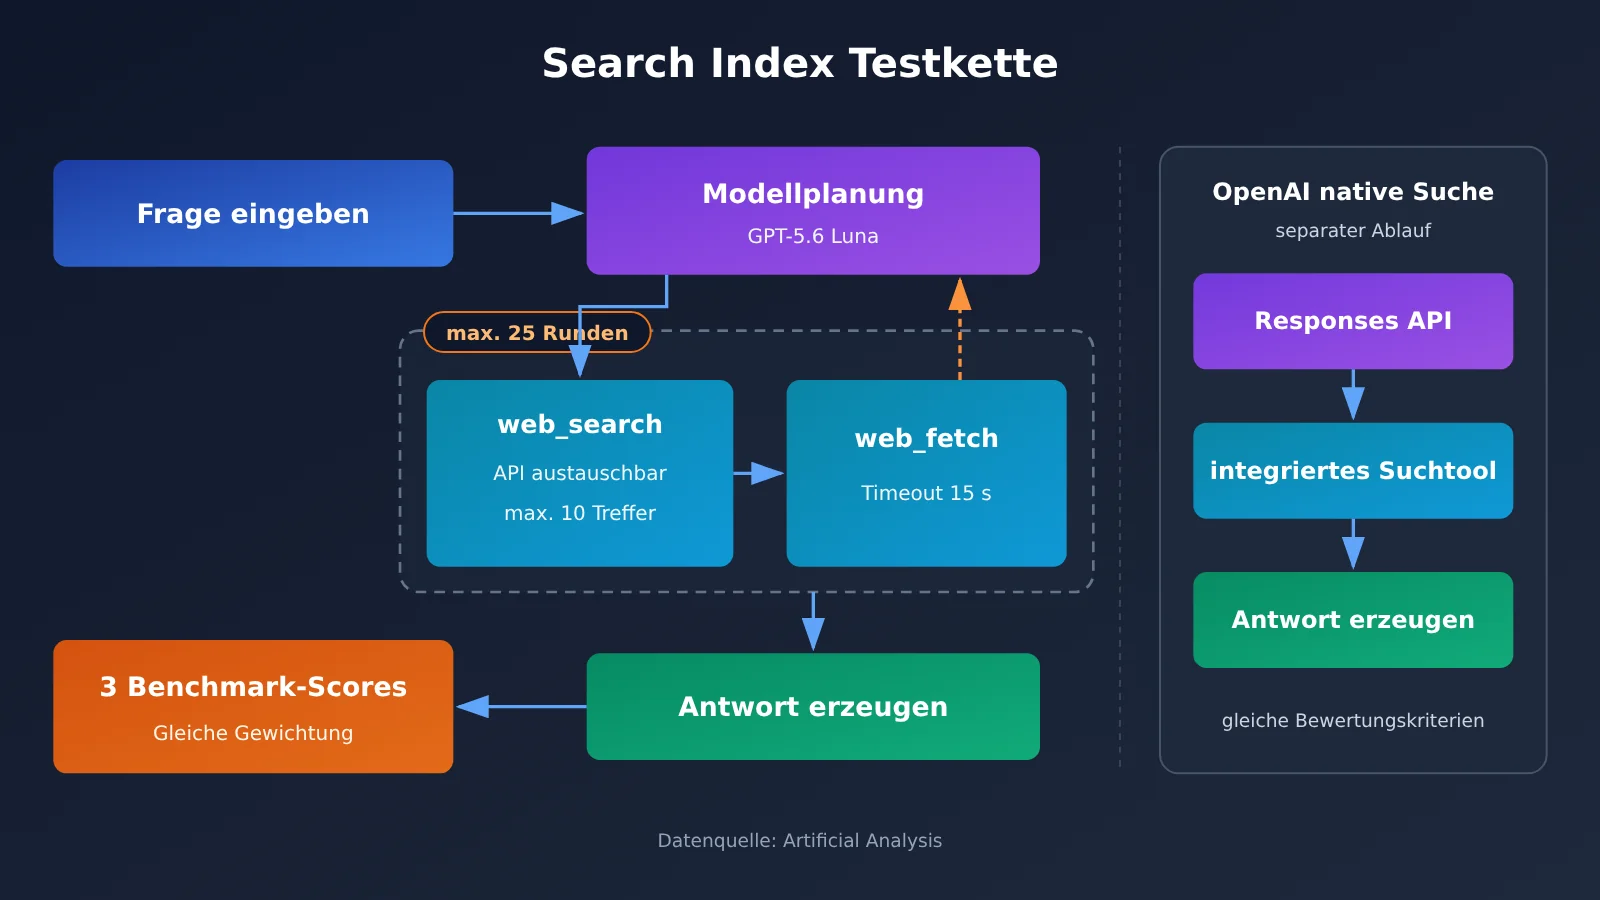
Der Knackpunkt des Versuchsdesigns ist die „Kontrolle der Variablen“. Das Kandidatenmodell für die Antworten ist fest auf GPT-5.6 Luna (medium) eingestellt, auch das Agent-Framework bleibt unverändert – nur der Suchdienst wird ausgetauscht. Unter diesen Bedingungen kommt die Baseline ohne Suchtool auf nur 33 Punkte, während das an erster Stelle stehende Keenable Pro 83 Punkte erreicht. Das ist ein Unterschied von 50 Indexpunkten. Selbst zwischen den Konfigurationen, die eine Suche anbinden, beträgt der Abstand 14 Punkte – von 69 Punkten bei DeepSeek Search Summary bis zu 83 Punkten bei Keenable Pro.
Eine Ausnahme muss man gesondert betrachten: Die native Web Search von OpenAI läuft anders. Alle anderen eigenständigen Search APIs laufen in der externen Agent-Schleife von Artificial Analysis. OpenAIs Web Search nutzt dagegen den integrierten Tool-Ablauf der Responses API – wie oft gesucht wird und wie die Ausführung abläuft, entscheidet OpenAI selbst. Seine 74 Punkte taugen deshalb als Referenz, sollten aber nicht als „API-Austausch“-Experiment unter exakt identischen Bedingungen gelesen werden.
Und noch ein Hinweis: Diese 50 Punkte sind der Effekt der Suchverstärkung innerhalb desselben Bewertungssystems. Sie bedeuten nicht, dass jeder Nutzer mit jedem Modell allein durch das Anbinden einer Suche 50 Prozentpunkte dazugewinnt.
Wie wird der Wert 83 beim Search Index eigentlich gemessen?
Die drei Benchmarks des Search Index und die Bewertungsmethode
Der Gesamtwert ist das gleichgewichtete Mittel der drei Benchmarks; jede zählt zu einem Drittel:
| Benchmark | Aufgabenumfang | Aufgabentyp | Bewertungsmetrik |
|---|---|---|---|
| DeepSearchQA | 900 Aufgaben | Komplexe Faktenrecherche, Antworten oft als Mengen | F1 der Antwortmengen |
| BrowseComp | 200 Aufgaben | Anspruchsvolle Fragen zur Websuche | Genauigkeit exakter Antworten |
| AA-Omniscience | 600 Aufgaben | Faktenfragen | Genauigkeit bei Faktenfragen |
Zusammen sind es 1.700 Aufgaben, aber der Gesamtwert entsteht nicht dadurch, dass man alle 1.700 Fragen zusammenlegt und daraus eine Trefferquote berechnet. Für Keenable Pro liegen die drei Werte beispielsweise bei 88, 87 und 73; der Mittelwert beträgt rund 82,67 und wird auf 83 gerundet. Der Wert 83 bedeutet also nicht „Trefferquote 83 %“.
Testbedingungen für den Search Index
Die in der Methodik veröffentlichten zentralen Konfigurationen sind folgende:
| Experiment | Tatsächliche Einstellung |
|---|---|
| Kandidatenmodell für Antworten / Bewertungsmodell | GPT-5.6 Luna (medium) |
| Maximale Agent-Runden | 25 Runden, Tool-Aufrufe pro Runde unbegrenzt |
| Verfügbare Tools | web_search, web_fetch (eigenständiger Webseitenabruf) |
| Suchergebnisse pro Suche | maximal 10 |
| Timeout für den Abruf des Seiteninhalts | 15 Sekunden pro Seite |
| An das Modell zurückgegebener Inhalt | Native Antwortinhalte des Anbieters |
| Baseline ohne Suche | Dasselbe Modell, ohne Suchtools |
Diese Tabelle zeigt zwei Dinge. Erstens bekommt das Modell die „native Antwort des Anbieters“ zurück. Länge der Auszüge, Art der Zusammenfassung und Struktur der Hervorhebungen fließen in den Kontext des Modells ein. Der Wert spiegelt daher nicht nur die Qualität des zugrunde liegenden Webindex wider, sondern auch, wie die Informationen aufbereitet werden. Zweitens werden fatale Fehler wie 429, 5xx oder Timeouts so lange wiederholt, bis sie erfolgreich sind, und diese Fehler gehen nicht in das Endergebnis ein. Das bedeutet: Die Rangliste misst die Qualität „im erfolgreichen Lauf“ und taugt nicht als Nachweis für die Verfügbarkeit oder Fehlerquote der Anbieter in Produktionsumgebungen.
Aktuelles Search-Index-Ranking: Welche Such-API liefert die besten Ergebnisse?
In der folgenden Tabelle stammen Qualitätswert und BrowseComp aus dem Ranking vom 2026-11-09. Die Dauer entspricht den Werten des Rankings vom 2026-11-13 und bezeichnet die durchschnittliche Zeit einer Standard-Testaufgabe von Beginn bis Ende – nicht die Netzwerklatenz einer einzelnen Anfrage an die Such-API.
| Suchkonfiguration | Gesamtpunktzahl (09.11.) | BrowseComp | Durchschnittliche Task-Dauer (13.11.) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16,6 Sekunden |
| Keenable Realtime | 82 | 86% | 16,0 Sekunden |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36,7 Sekunden |
| Perplexity Search Medium | 80 | 87% | 31,1 Sekunden |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19,4 Sekunden |
| Parallel Advanced | 75 | 77% | im aktuellen Dauer-Update nicht aufgeführt |
| Brave LLM Context | 75 | 77% | im aktuellen Dauer-Update nicht aufgeführt |
| OpenAI Web Search Medium (integrierter Responses-Ablauf) | 74 | 74% | 33,1 Sekunden |
| DeepSeek Search Summary | 69 | 63% | 22,4 Sekunden |
| Baseline ohne Suche | 33 | 17% | — |
Drei typische Unterschiede im Such-API-Ranking
Gleiche Punktzahl, unterschiedliche Geschwindigkeit. Exa Auto und Perplexity Medium erreichen beide 80 Punkte, doch die vollständige Task dauert 36,7 bzw. 31,1 Sekunden. Keenable Pro hat eine höhere Punktzahl und braucht mit rund 16,6 Sekunden nur etwa die Hälfte. Für Agents, die eine Echtzeit-Reaktion benötigen, ist dieser Unterschied für Nutzer direkt spürbar.
BrowseComp folgt der Gesamtpunktzahl nicht vollständig. Perplexity Medium erreicht bei BrowseComp 87% und liegt damit gleichauf mit Keenable Pro, die Gesamtpunktzahl ist jedoch 3 Punkte niedriger. Die Differenz entsteht vor allem bei den beiden anderen Benchmarks. Wenn Ihr Anwendungsfall eher der „Web-Recherche bei schwierigen Fragen“ entspricht, können Sie die BrowseComp-Spalte separat heranziehen.
Verschiedene Modi desselben Anbieters unterscheiden sich stark. Exa Lite und Exa Auto liegen nur 1 Punkt auseinander, die Dauer unterscheidet sich jedoch fast um das Doppelte. Deshalb sollten die Werte pro konkretem Produktmodus interpretiert werden – fassen Sie Exa Lite und Exa Auto nicht zu einem einzigen „Exa-Score“ zusammen.
💡 Hinweis zu den Daten: Die oben genannten Werte sind Ergebnisse einer Drittanbieter-Evaluierung durch Artificial Analysis, die Dauerangaben sind Standard-Task-Zeiten. Wenn Sie einen ähnlichen Vergleich für Ihre eigenen Geschäftsprobleme reproduzieren möchten, können Sie über APIYI (apiyi.com) ein festes Antwortmodell festlegen und anschließend verschiedene Suchtools für A/B-Tests anbinden.
Ist der höchste Score einer Such-API automatisch das beste Preis-Lehstungs-Verhältnis?
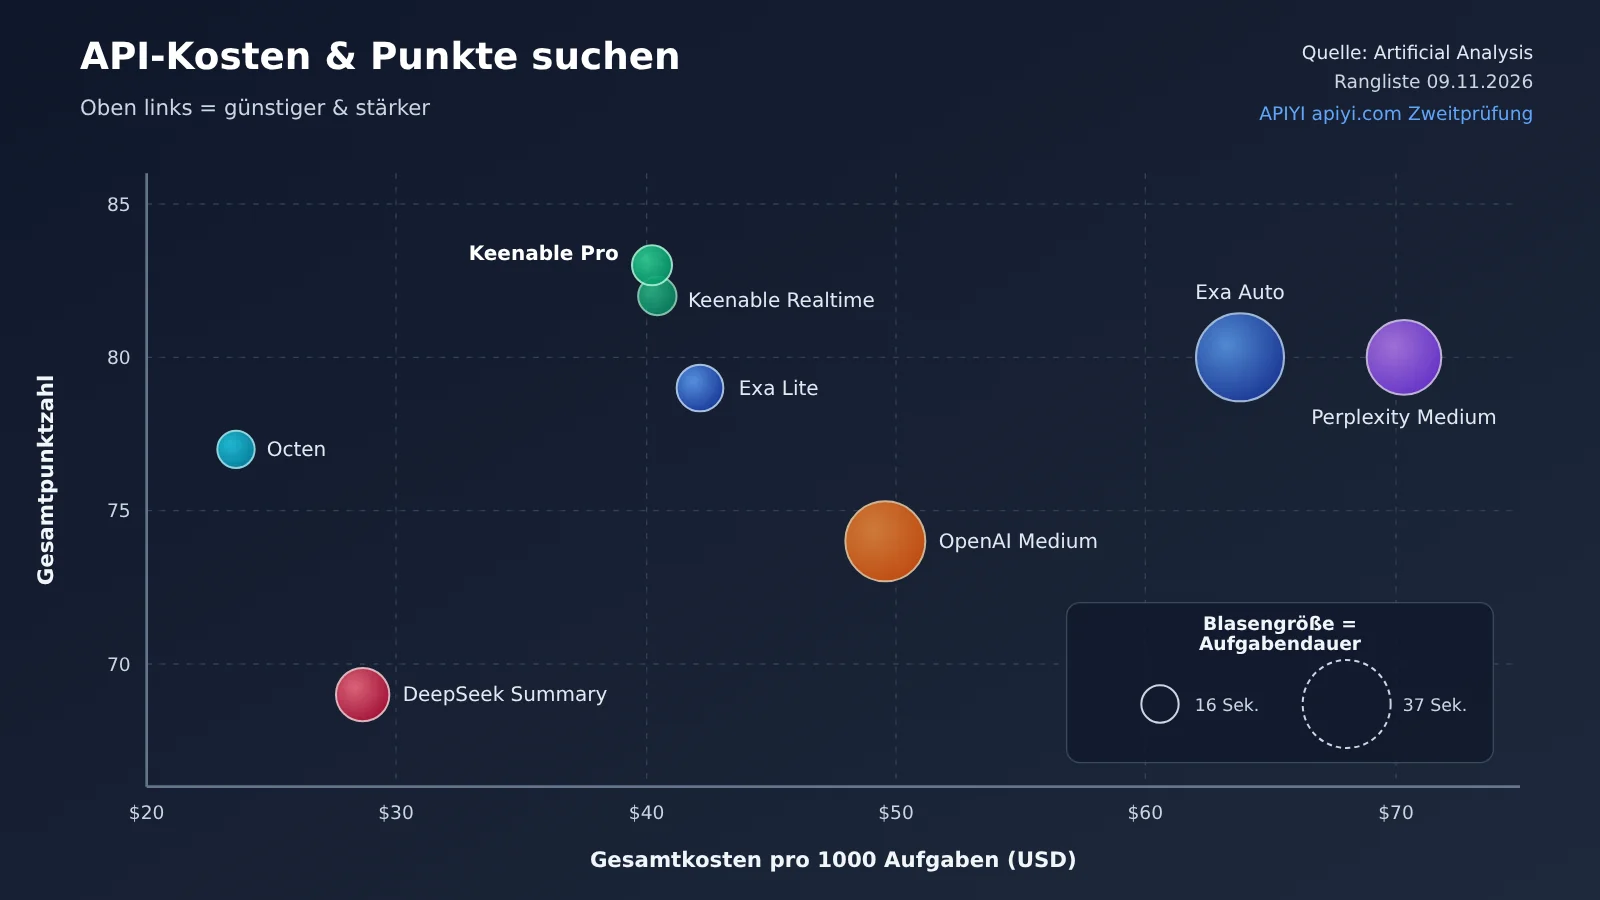
Artificial Analysis veröffentlicht außerdem die geschätzten Kosten pro 1.000 Benchmark-Aufgaben, aufgeschlüsselt in Suchkosten und Modellkosten (Rangliste vom 2026-11-09, in US-Dollar). Die Spalte „Kosten pro Punkt“ ist eine grobe Ableitung der Redaktion dieses Artikels nach dem Muster „Gesamtkosten ÷ Gesamtscore“ und dient nur als Quervergleich – sie ist kein offizieller Kennwert.
| Suchkonfiguration | Qualitätsscore | Suchkosten + Modellkosten | Gesamtkosten/1.000 Aufgaben | Kosten pro Punkt (Redaktionsschätzung) | Aufgabenlaufzeit (11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | ca. $0.48 | 16.6 Sek. |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | ca. $0.49 | 16.0 Sek. |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | ca. $0.80 | 36.7 Sek. |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | ca. $0.88 | 31.1 Sek. |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | ca. $0.53 | 19.4 Sek. |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | ca. $0.31 | 15.6 Sek. |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | ca. $0.67 | 33.1 Sek. |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | ca. $0.42 | 22.4 Sek. |
Drei Erkenntnisse aus der Kostentabelle der Such-APIs
Der höchste Score ist nicht automatisch der teuerste. Keenable Pro liegt mit 83 Punkten auf Platz eins und kostet pro 1.000 Aufgaben rund $40.22, also etwa $0.04 pro einzelner Aufgabe – damit liegt es in der Stichprobe im Mittelfeld. Perplexity Medium erreicht 3 Punkte weniger, kostet in Summe aber rund 75 % mehr.
Ein Punkt Unterschied kann über 30 Prozent Kostenunterschied bedeuten. Exa Lite + Highlights kommt auf 79 Punkte bei $42.15 pro 1.000 Aufgaben, Exa Auto + Highlights auf 80 Punkte bei $63.77 pro 1.000 Aufgaben – die Lite-Variante ist rund 34 % günstiger und braucht zudem weniger Zeit. Laut der offiziellen Preisseite von Exa (Stand: 2026-11-13) kostet die Lite-Stufe $4 pro 1.000 Anfragen, die Auto-Stufe $7 pro 1.000 Anfragen. Die Unterschiede bei den Suchkosten in der Rangliste passen zu dieser Preisstruktur.
Niedrige Suchkosten können höhere Modellkosten bedeuten. Bei DeepSeek Search Summary liegen die Suchkosten bei nur $8.47, die Modellkosten aber bei $20.19 – der höchste Wert in der Tabelle. Octen hat die niedrigsten Gesamtkosten, doch seine Modellkosten liegen ebenfalls über denen von Keenable, Exa und Perplexity. Sind die Suchergebnisse wenig hilfreich, sucht der Agent mehrere Runden weiter und liest mehr Seiten – der Token-Verbrauch steigt entsprechend. Bei der Kostenrechnung sollte man deshalb mit den „Gesamtkosten für das Erledigen einer Aufgabe“ rechnen und nicht nur mit dem Einzelpreis der Such-API.
Bei welchen praktischen Entscheidungen hilft dieses Search-Index-Ranking?
Der Search Index ist eine überwiegend englischsprachige Benchmark für allgemeine Faktenretrieval und kein spezieller Benchmark für das chinesische Internet. Im Folgenden ordnen wir ihn gängigen Agent-Szenarien zu und markieren, welche Szenarien direkt herangezogen werden können und welche zusätzliche Tests erfordern.
| Agent-Szenario | Wichtigste Kennzahl | Referenzwert des Rankings | Empfohlene Kandidaten |
|---|---|---|---|
| Faktenbasierte Frage-Antwort | Genauigkeit, Zitierkorrektheit | Hoch, AA-Omniscience lässt sich direkt heranziehen | Keenable, Exa Lite, Perplexity |
| Komplexe Recherche über mehrere Quellen | Multi-Hop-Retrieval, Set-Recall | Hoch, vor allem DeepSearchQA und BrowseComp beachten | Keenable Pro, Exa Auto, Perplexity Medium |
| Agent mit niedriger Latenz | Gesamtaufgabenzeit, P95-Latenz | Mittel, Aufgabenzeit dient nur als Referenz | Keenable Realtime, Octen, Exa Lite |
| Chinesische Nachrichtenrecherche | Abdeckung chinesischer Quellen, Erreichbarkeit inländischer Websites | Niedrig, eigenes chinesisches Testset erforderlich | Baidu Qianfan, Bocha, Alibaba Cloud Bailian als Vergleich hinzufügen |
| Retrieval in Programmierdokumentation | Abdeckung offizieller Dokumente, Versionsinformationen | Niedrig bis mittel, mit echten technischen Fragen erneut testen | Exa, Perplexity, Parallel |
So vergleicht man Such-APIs mit dem Search Index in einer zweiten Runde
Sinnvoller ist es, das öffentliche Ranking als „Vorfilter“ zu nutzen und dann mit eigenen Aufgaben eine zweite Vergleichsrunde durchzuführen:
- Nach den drei Kriterien Qualität, Zeitaufwand und Gesamtkosten 3–4 Kandidatenkonfigurationen aus dem Ranking auswählen;
- 50–100 eigene Geschäftsfragen vorbereiten, die einfache Fakten, aktuelle Nachrichten, Multi-Hop-Fragen sowie chinesische und sprachübergreifende Abfragen abdecken;
- Dasselbe Antwortmodell, dieselbe maximale Rundenzahl und dieselbe Ergebnisanzahl fixieren und nur das Suchwerkzeug austauschen;
- Genauigkeit, Zitierkorrektheit, Gesamtkosten pro Aufgabe, P50/P95-Zeitaufwand sowie die Anzahl leerer Ergebnisse und Timeouts erfassen;
- Die Stabilität in der Produktionsumgebung separat mit Lasttests prüfen, denn das Ranking schließt fatale Fehler nach Wiederholungsversuchen bereits aus.
Entscheidungshilfe zur Auswahl einer Such-API und schneller Einstieg
🎯 Auswahlempfehlung: Wenn du Gesamtqualität und Geschwindigkeit priorisierst, teste zuerst Keenable Pro/Realtime. Wenn du kostensensitiv bist und eine Qualität nahe 80 Punkten möchtest, sollten Exa Lite + Highlights und Octen besonders gründlich getestet werden. Teams, die bereits tief im OpenAI-Ökosystem arbeiten, können das integrierte Web Search direkt nutzen, müssen aber akzeptieren, dass der Ausführungsablauf nicht kontrollierbar ist. Für den produktiven Einsatz empfehlen wir, das Antwortmodell einheitlich über APIYI apiyi.com aufzurufen und das Suchwerkzeug als austauschbares Modul zu gestalten. So musst du beim Wechsel der Such-API keinen Code auf der Modellseite ändern.
Minimalbeispiel: Das Modell nutzt eine einheitliche Schnittstelle
Der folgende Code fixiert das Antwortmodell und deklariert das Suchwerkzeug als Funktion. Welche Such-API das konkret implementiert, kannst du im lokalen Code austauschen:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle, Modell austauschbar
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Wechsle zu dem Modell, das du evaluieren möchtest
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
Vollständigen Code anzeigen: A/B-Vergleich mehrerer Such-APIs mit demselben Modell
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # Antwortmodell fixieren, Kontrollvariable konstant halten
MAX_TURNS = 25          # Obergrenze für Runden, konsistent mit Search Index

# Adapterfunktionen für die jeweiligen Such-APIs, nach offizieller Dokumentation selbst implementieren
def search_provider_a(query: str) -> list:
    return []  # Rückgabe: [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 Schnellstart: Neue Nutzer können bei APIYI apiyi.com ein kostenloses Testkontingent erhalten. Führe zuerst mit einigen Business-Fragen das obige A/B-Skript durch und entscheide dann, welche Such-API du in die produktive Lösung aufnimmst.
Häufig gestellte Fragen (FAQ)
F1: Was ist der Search Index?
Der Search Index ist ein Bewertungsindex für Such-APIs, den Artificial Analysis veröffentlicht hat. Er fixiert das Antwortmodell und das Agent-Framework und tauscht ausschließlich den Suchdienst aus. Gemessen wird die Suchqualität anhand des gleichgewichteten Durchschnitts der drei Benchmarks DeepSearchQA, BrowseComp und AA-Omniscience – bei einer Maximalpunktzahl von 100.
F2: Bedeuten 83 Punkte eine Trefferquote von 83 %?
Nein. 83 ist der Durchschnitt der Punktzahlen aus drei Benchmarks, und die drei verwenden unterschiedliche Metriken: DeepSearchQA nutzt F1, die beiden anderen nutzen die Genauigkeit. Bei Keenable Pro liegen die drei Werte bei 88, 87 und 73, der Durchschnitt beträgt rund 82,67 und wird als 83 angezeigt.
F3: Von wann stammen die Daten im Ranking?
Die Qualitäts- und Kostendaten stammen aus dem Ranking-Update vom 2026-11-09, die Werte für die vollständige Aufgabenlaufzeit wurden am 2026-11-13 ausgelesen. Das Ranking wird laufend aktualisiert – beim Zitieren sollte daher immer das Datum angegeben werden.
F4: Lässt sich die Laufzeit im Ranking als Antwortgeschwindigkeit einer Such-API interpretieren?
Nein. Die Laufzeit in der Tabelle ist die vollständige Dauer einer Standardaufgabe und umfasst mehrere Suchrunden, das Lesen von Webseiten sowie die Modellinferenz. Die Latenz eines einzelnen HTTP-Aufrufs muss separat gemessen werden, am besten mit Protokollierung von P50 und P95.
F5: Wie vergleiche ich verschiedene Such-APIs schnell in meinem eigenen Geschäftsablauf?
Indem ich ein Antwortmodell fixiere und nur das Suchwerkzeug austausche. Über APIYI apiyi.com lässt sich das Modell über eine OpenAI-kompatible Schnittstelle aufrufen; dazu `base_url` auf `https://api.apiyi.com/v1` setzen und das A/B-Skript aus diesem Artikel anwenden. Wenn man zusätzlich sehen möchte, wie sich die Suchergebnisse bei einem Modellwechsel verändern, kann man mit demselben Key zwischen OpenAI-, Claude- und Gemini-Modellen wechseln.
F6: Welche Einschränkungen hat der Search Index?
Es gibt vor allem vier Punkte: Er ist kein spezieller Benchmark für das chinesische Internet; der Ausführungsablauf der nativen Suche von OpenAI unterscheidet sich von anderen Konfigurationen; Fehler wie 429, 5xx oder Timeouts werden nach Wiederholungsversuchen nicht in das Ergebnis eingerechnet und spiegeln daher nicht die Stabilität im Produktivbetrieb wider; die Kosten basieren auf Schätzungen für die Evaluierungsaufgaben und können von Ihrer tatsächlichen Rechnung abweichen. Für die Suche in chinesischen Nachrichten und in technischer Dokumentation aus chinesischer Produktion empfiehlt es sich, ein eigenes Testset aufzubauen und dieses über APIYI apiyi.com zusammen mit chinesischen Modellen zu validieren.
Search Index: Auswahl der Such-API – wichtigste Erkenntnisse
- Suche ist eine unabhängige Variable: Dasselbe Modell steigt von 33 auf 83 Punkte – die Wahl der Such-API beeinflusst die Qualität des Agenten direkt.
- 83 Punkte sind keine Genauigkeitsrate: Der Wert ist der gleichgewichtete Durchschnitt aus drei Benchmarks, deren Bewertungsschemata sich unterscheiden.
- Laufzeit bezieht sich auf die gesamte Aufgabe: Keenable etwa 16 Sekunden, Exa Auto etwa 37 Sekunden – beides sind keine Latenzen einzelner API-Aufrufe.
- Kosten getrennt betrachten: Niedrige Suchkosten können höhere Modellkosten nach sich ziehen; vergleichen Sie die Gesamtkosten pro Aufgabe.
- 1 Punkt kann 34 % Unterschied bedeuten: Exa Lite und Auto liegen nur 1 Punkt auseinander, dabei ist Exa Lite rund ein Drittel günstiger.
- Das Ranking dient nur als erste Filterstufe: Bei chinesischsprachigen Inhalten, Programmierdokumentation und ähnlichen Szenarien braucht es eigene Aufgaben für einen zweiten A/B-Vergleich.
Zusammenfassung
Das Wertvollste an diesem Search-Index-Ranking ist das Design „gleiches Modell, unterschiedliche Suchwerkzeuge“, mit dem sich der Einfluss der Suchqualität auf den Agenten isoliert messen lässt:
- Qualität: Ohne Suche 33 Punkte, maximal 83 Punkte. Selbst wenn überall eine Suche angebunden ist, liegen die Konfigurationen rund 14 Punkte auseinander;
- Geschwindigkeit: Bei gleichen 80 Punkten kann die Laufzeit der gesamten Aufgabe um mehr als 5 Sekunden variieren; auch Konfigurationen mit hoher Punktzahl können schnell sein;
- Kosten: Keenable Pro hat die höchste Qualität bei mittleren Kosten; Exa Lite und Octen sind besonders kosteneffizient; das Beispiel DeepSeek Summary zeigt, dass niedrige Suchkosten nicht automatisch niedrige Gesamtkosten bedeuten.
Wählen Sie zuerst 3–4 Kandidaten aus dem Ranking aus und führen Sie dann auf Ihrem eigenen Fragenset mit festgelegtem Modell A/B-Tests durch. Empfohlen wird, Antwortmodelle einheitlich über APIYI apiyi.com aufzurufen, das Suchwerkzeug als austauschbares Modul zu gestalten und die endgültige Lösung anhand der drei Kennzahlen Qualität, Geschwindigkeit und Kosten zu bestimmen.
Referenzen
- Artificial Analysis Search API-Ranking: Qualitätswerte, Kosten und Laufzeitdaten
- Link:
artificialanalysis.ai/agents/search-api -
Beschreibung: Hauptquelle für die Punktzahlen, Kosten und Laufzeiten in diesem Artikel
-
Artificial Analysis Search API-Evaluierungsmethodik: Testkonfiguration und Bewertungsregeln
- Link:
artificialanalysis.ai/methodology/search-api -
Beschreibung: Enthält Erläuterungen zu Modellen, Runden, Anzahl der Ergebnisse, Wiederholungsregeln und vielem mehr
-
Exa Pricing: Preisgestaltung für Lite, Auto und weitere Stufen
- Link:
exa.ai/pricing -
Beschreibung: Dient dem Verständnis der unterschiedlichen Suchkosten der Exa-Modi im Ranking
-
Exa 3.0-Ankündigung: Lite-Modus und Dynamic Highlights
- Link:
exa.ai/blog/exa-3 -
Beschreibung: Veröffentlicht am 2026-10-19, enthält vom Anbieter selbst erhobene Daten
-
OpenAI Web Search-Dokumentation: Integriertes Suchtool der Responses API
- Link:
developers.openai.com/api/docs/guides/tools-web-search -
Beschreibung: Erklärt, wie die native Suche von OpenAI ausgeführt wird und welche Parameter verfügbar sind
-
Perplexity Search API-Preise: Standard- und Fast-Stufe
- Link:
docs.perplexity.ai/docs/getting-started/pricing - Beschreibung: Erläutert die Regeln für die Abrechnung pro Anfrage
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Integrationsinformationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.