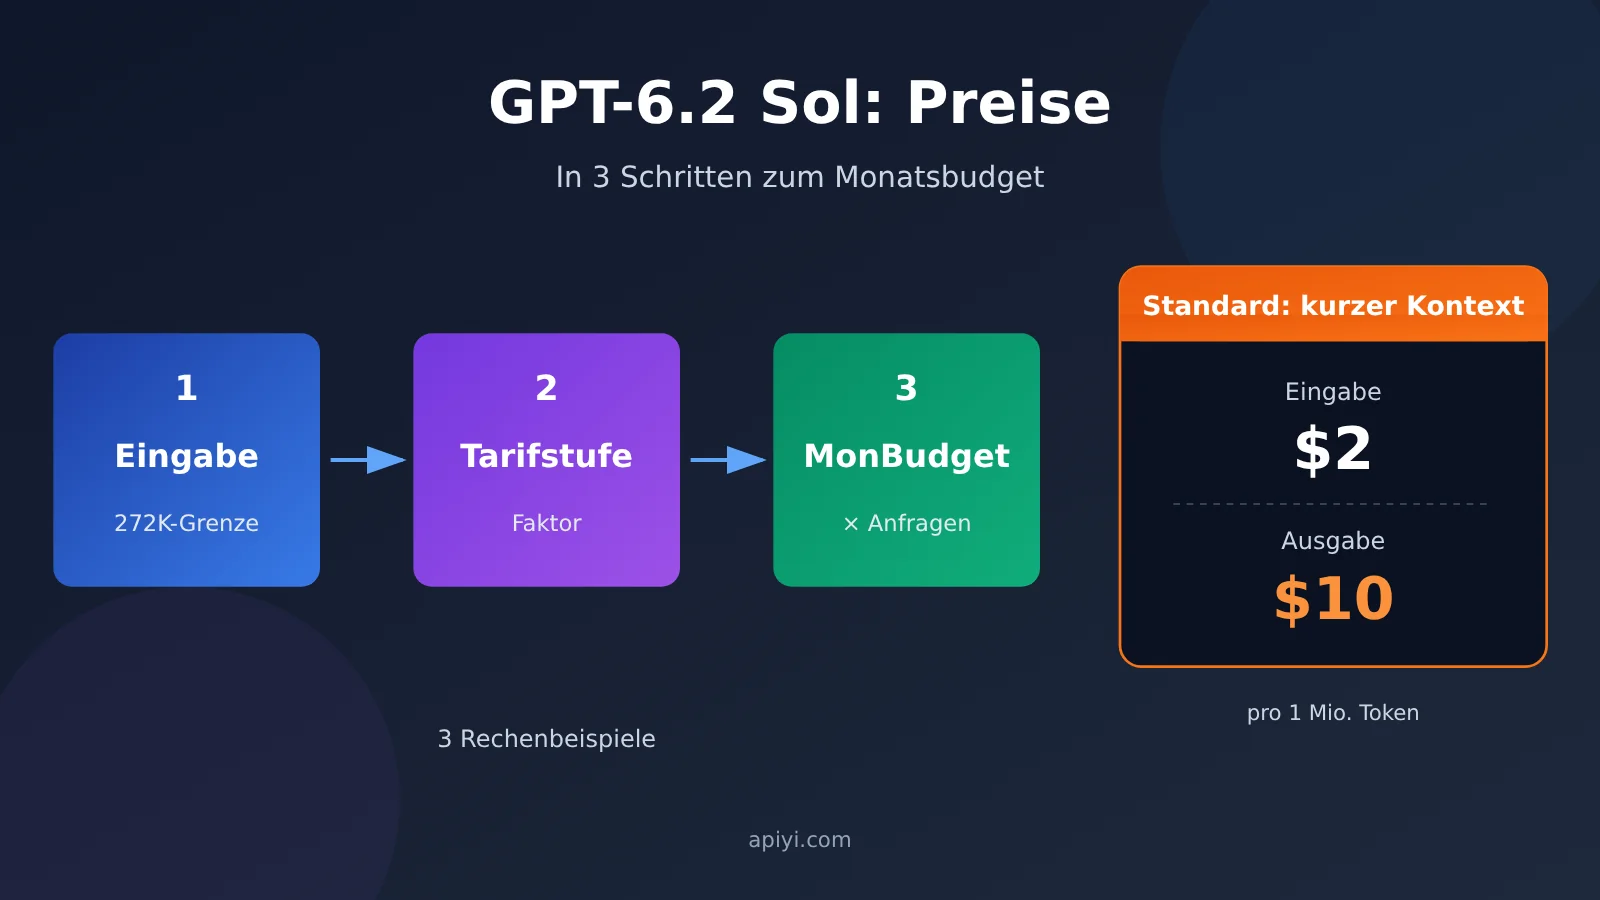
Die Kosten für den Aufruf der GPT-6.2-Sol-API werden in drei Schritten bestimmt. Im ersten Schritt zählt die gesamte Eingabemenge einer einzelnen Anfrage, wobei 272K Token als Grenze zwischen kurzem und langem Kontext dienen: Wird dieser Schwellenwert überschritten, verdoppeln sich die Eingabe- und Cache-Raten der gesamten Anfrage, und die Ausgabe steigt auf das 1,5-Fache. Im zweiten Schritt wählen Sie die Service-Stufe nach Lieferfrist: Standard ist der Basispreis, Batch kostet die Hälfte, die Hintergrundfenster 8h und 2h werden mit 60 % bzw. 70 % berechnet, Fast mit dem 2-Fachen, Ultrafast vor dem 28.02.2027 (Pazifikzeit) mit dem 3-Fachen, danach mit dem 6-Fachen. Im dritten Schritt multiplizieren Sie die Kosten pro Anfrage mit dem monatlichen Anfragevolumen und addieren Tool-Aufrufe, etwaige regionale Gebühren und Wiederholungen.
Der Listenpreis für kurzen Kontext, Standard, lautet: normale Eingabe $2.00 pro Million Token, Cache-Lesen $0.10, Ausgabe (einschließlich Reasoning-Token) $10.00. Bei diesem Preis kostet eine interaktive Anfrage mit 20.000 Token Eingabe und 3.000 Token Ausgabe rund $0.07, bei 2.000 Anfragen pro Monat etwa $140. Alle Preise in diesem Artikel sind in USD pro Million Token angegeben, Stand der Prüfung: 20.11.2026 (Peking-Zeit).
GPT-6.2 Sol API Preis-Wissenskarte und Leseindex
Der gesamte Text ist in der Reihenfolge „Eingabemenge bestimmen → Lieferfrist auswählen → kumulative Aufrufe“ aufgebaut. Die folgende Tabelle fasst für jeden Schritt die zu beantwortende Frage, das Ergebnis und die Textnummer zusammen; das Ergebnis des vorherigen Abschnitts ist die Eingabe für den nächsten.
| Schritt | Zu beantwortende Frage | Ergebnis dieses Schritts | Textnummer |
|---|---|---|---|
| Eingabemenge bestimmen | Fällt diese Anfrage in den kurzen oder in den langen Kontext | Anwendbare Grundtariftabelle | 1, 3.2 |
| Lieferfrist auswählen | Wartet der Nutzer online, oder kann die Lieferung einige Stunden später oder am nächsten Tag erfolgen | Multiplikator der Service-Stufe | 2, 3.1 |
| Kumulative Aufrufe | Wie viele Anfragen pro Monat, welche zusätzlichen Ausgaben gibt es | Monatsbudget | 2, 4 |
| Kanalneuberechnung | Wie viel kostet dieselbe Anfrage über einen anderen Abrechnungskanal | Kanalvergleich und Budgettabelle | 4 |
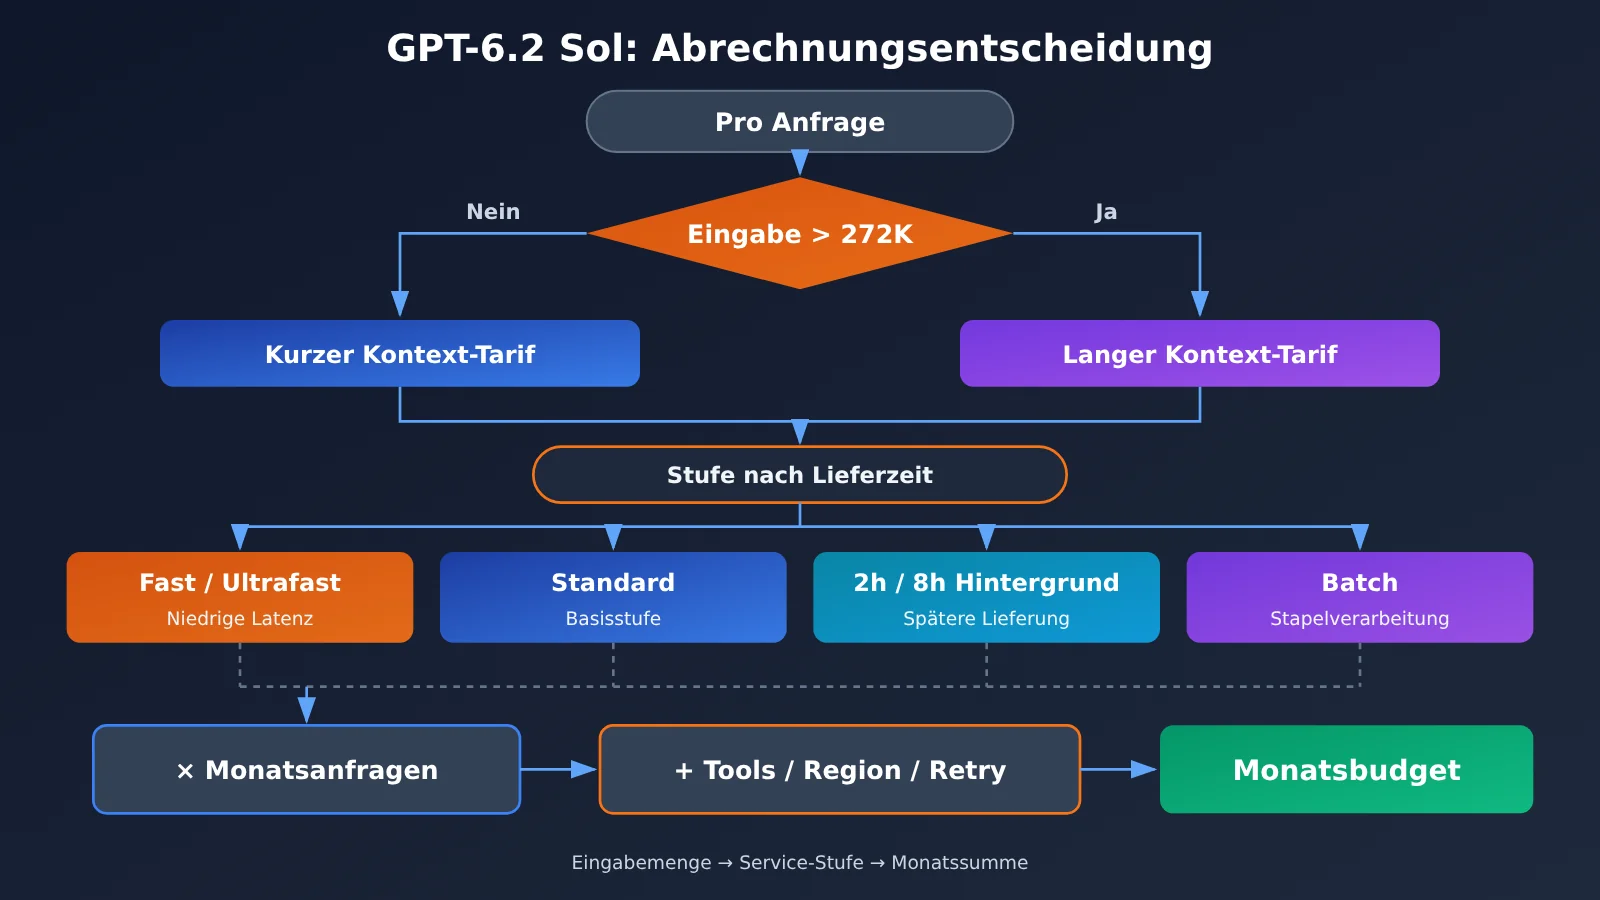
In der Lesereihenfolge gibt Abschnitt 1 die Grundtarife an, die die Grundlage für alle nachfolgenden Berechnungsbeispiele bilden. Abschnitt 2 und Abschnitt 3 entsprechen jeweils zwei Geschäftstypen: „Nutzer wartet online auf das Ergebnis“ und „verzögerte Lieferung erlaubt“; Sie können auch nur den für Sie relevanten Abschnitt lesen. Abschnitt 4 wendet die vorherigen Rechenwege auf die öffentliche Preisliste von APIYI apiyi.com und die offiziellen OpenAI-Tarife an und rechnet sie nebeneinander nach, abschließend wird eine direkt ausfüllbare monatliche Budgettabelle bereitgestellt.
GPT-6.2 Sol Abrechnungsbegriffe To Know
| Begriff | Erklärung |
|---|---|
| Token | Grundeinheit, mit der das Modell Text und andere Ein- und Ausgaben zählt; die Menge richtet sich nach der vom Server zurückgegebenen Statistik |
| Standard | Die reguläre Verarbeitungsstufe der offiziellen API und zugleich die Preisreferenz für die Multiplikatoren der anderen Stufen |
| Cache-Lesen | Wenn eine Anfrage einen bereits zwischengespeicherten historischen Präfix wiederverwendet, wird dieser Eingabeteil zum Cache-Lese-Tarif abgerechnet |
| Cache-Schreiben | Eine eigenständige Abrechnungskategorie für das Speichern qualifizierter Präfixe zur späteren Wiederverwendung, unterteilt in 30 Minuten und 12 Stunden |
| Abgerechnete Ausgabe | Die von der API erfasste Ausgabemenge, einschließlich Reasoning-Token und endgültiger Ausgabe |
| Batch-API | Eine Schnittstelle, die vorab vorbereitete unabhängige Anfragen in Dateiform an die Hintergrund-Batch-Verarbeitung übergibt |
| Fertigstellungsfenster | Das nach Annahme einer Hintergrundanfrage für die initiale Antwort gesetzte Zielzeitfenster |
| Fast und Ultrafast | Zwei Hochtarif-Stufen für Szenarien mit geringer Latenz |
1. Welche Tarife fallen bei einer einzelnen Anfrage an die GPT-6.2 Sol API an
1.1 Die fünf Abrechnungskategorien der Standard-Stufe
Die API-Modell-ID von GPT-6.2 Sol lautet gpt-6.2-sol und kann über die beiden Endpunkte Responses und Chat Completions aufgerufen werden. Eine einzelne Anfrage kann bis zu fünf Abrechnungskategorien betreffen; die folgende Tabelle zeigt die offiziellen Listenpreise der Standard-Stufe. Der Grundpreis für kurzen Kontext entspricht dem von GPT-6.1 Sol; die Spalte für langen Kontext folgt den Multiplikatoren der Modellkarte.
| Abrechnungskategorie Standard | Kurzer Kontext (≤272K Eingabe) | Langer Kontext (>272K Eingabe) |
|---|---|---|
| Normale Eingabe | $2.00 | $4.00 |
| Cache-Lesen | $0.10 | $0.20 |
| Cache-Schreiben (30 Minuten) | $2.50 | $5.00 |
| Cache-Schreiben (12 Stunden) | $5.00 | $10.00 |
| Ausgabe (inkl. Reasoning-Token) | $10.00 | $15.00 |
Bei der Tabelle gibt es drei Punkte, bei denen leicht Fehler passieren.
- Cache-Schreiben wird nicht zusätzlich zur normalen Eingabe berechnet. Die Token, die in den Cache geschrieben werden, werden einmal mit dem vollen Tarif der 30-Minuten- oder 12-Stunden-Stufe abgerechnet und nicht zusätzlich als normale Eingabe.
- Reasoning-Token zählen zur Ausgabe.
usage.output_tokens, das von Responses zurückgegeben wird, ist die Gesamtmenge der Ausgabe; der Reasoning-Verbrauch wird üblicherweise als Unterpunkt inoutput_tokens_details.reasoning_tokensaufgeführt. Für die Budgetierung reicht es, von der Gesamtmenge auszugehen. - Die Stufenumschaltung gilt pro gesamter Anfrage. Sobald die Gesamtmenge der Eingabe 272K übersteigt, wechseln Eingabe, Cache und Ausgabe der gesamten Anfrage auf den Tarif für langen Kontext – nicht nur der übersteigende Teil wird teurer.
Die Modellkarte listet außerdem ein Kontextfenster von 1.050.000 Token, eine maximale Eingabe von 922.000 Token und eine maximale Ausgabe von 128.000 Token. 922K ist die maximal zulässige Eingabe, 272K ist der Umschaltpunkt für die Abrechnung – beides hat nichts miteinander zu tun.
1.2 Ausgaben abseits der Modellkosten
Die obige Tabelle deckt nur die Token-Kosten der Modelle ab. Sol kann in den Responses verschiedene Tools aufrufen, etwa Dateisuche, Websuche, Code-Interpreter und Bilderzeugung. Diese Tools werden in der Praxis nach eigenen Regeln abgerechnet. Wenn Bilder erzeugt werden, löst Sol den Tool-Aufruf aus, das Bild selbst wird jedoch von einem separaten Bild-Tool ausgegeben – die Bildkosten müssen also zusätzlich kalkuliert werden. Wird in einer bestimmten Region bereitgestellt, können außerdem regionale Gebühren anfallen. In der Budgettabelle sollten Sie für diese Posten eigene Spalten vorsehen und sie nicht mit dem Token-Stückpreis vermischen.
1.3 Tatsächliche Abrechnungsnutzung per Code auslesen
Nach der Schätzung sollten Sie mit dem Feld usage einer echten Anfrage kalibrieren. Das folgende Beispiel ruft Sol über die OpenAI-kompatible Schnittstelle auf und rechnet die Modellkosten dieser Anfrage mit dem Standard-Tarif für kurze Kontexte um:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句话说明 Batch API 适合什么任务。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"输入 {u.input_tokens},其中缓存 {cached},输出 {u.output_tokens},模型费约 ${cost:.6f}")
Diese Umrechnung gilt nur für Standard-Anfragen mit einem Input von höchstens 272K und ohne Cache-Schreibvorgänge. Für den Produktivbetrieb empfiehlt es sich, das usage-Feld jeder Anfrage zu protokollieren, nach Aufgabentyp zu aggregieren und die Ergebnisse dann in die Budgettabelle aus Abschnitt 4 einzutragen.
🎯 Empfohlene Vorgehensweise: Bevor Sie das Budget endgültig festlegen, sollten Sie einmal 20 bis 50 echte Geschäftsanfragen durchlaufen lassen und die Verteilung von Input und Output auswerten. Neue Nutzer von APIYI apiyi.com erhalten ein kostenloses Testkontingent – ideal für diese Art der Kalibrierung mit kleinen Stichproben.
2. So berechnen Sie die Interaktionsstufen und das Monatsbudget von GPT-6.2 Sol
2.1 Kosten derselben Anfrage in den drei Interaktionsstufen
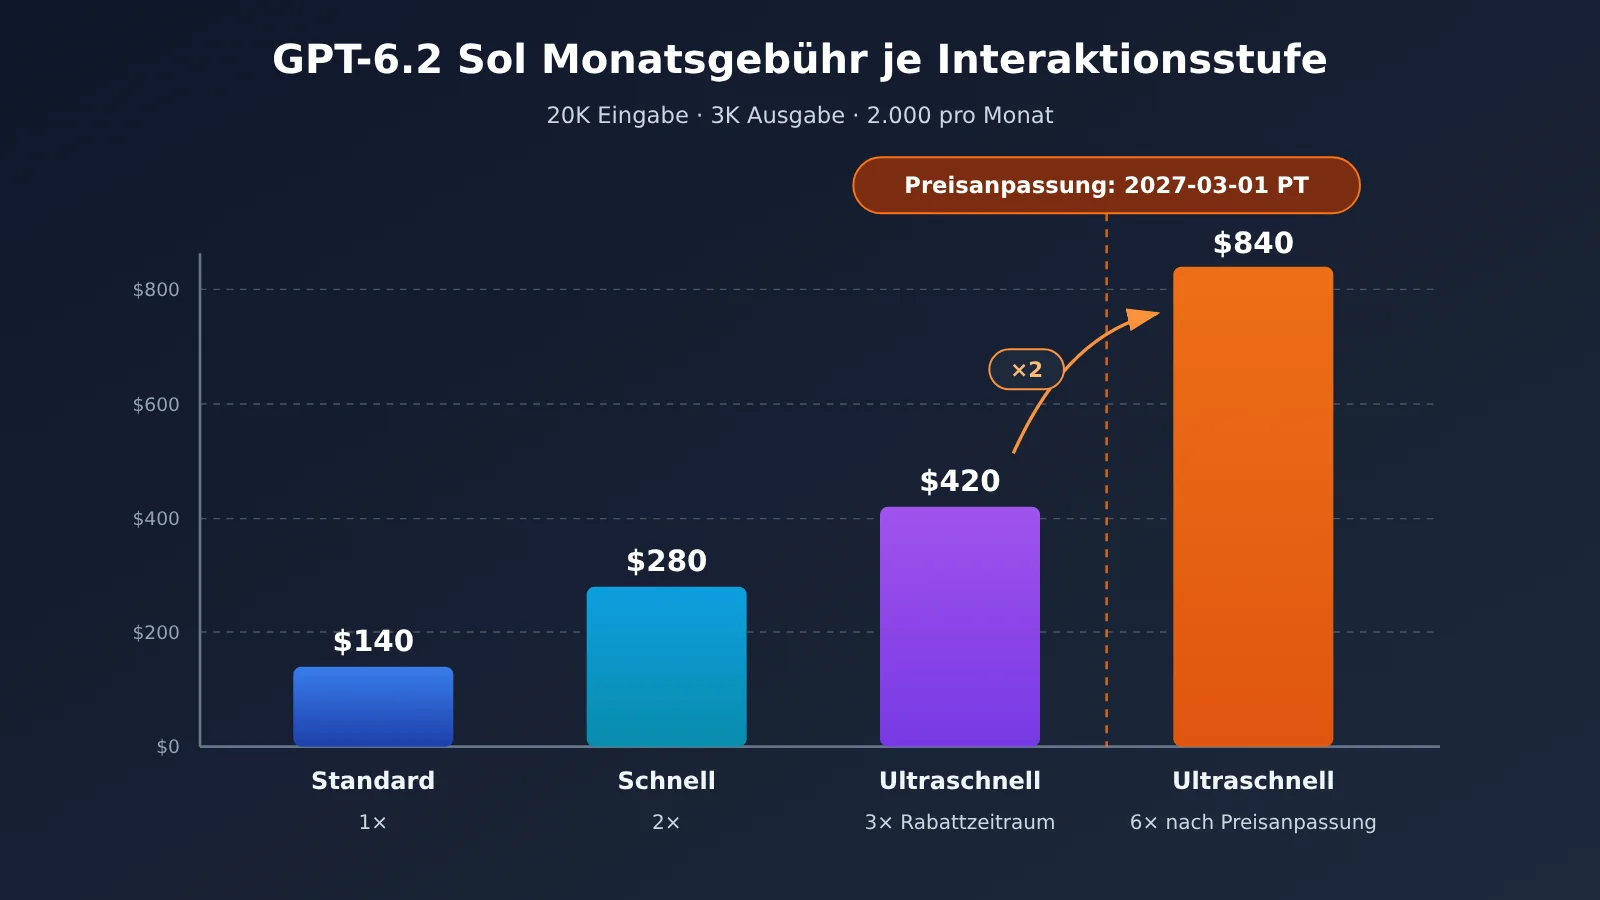
In interaktiven Szenarien wartet der Nutzer in der Oberfläche auf das Ergebnis; zur Auswahl stehen Standard, Fast und Ultrafast. Fast wird mit dem 2-Fachen von Standard abgerechnet; Ultrafast kostet bis zum 28.02.2027 (Pazifikzeit) das 3-Fache, ab dem 01.03.2027 das 6-Fache. GPT-6.2 Sol unterstützt die Flex-Stufe nicht.
Das Rechenbeispiel geht von einer Anfrage mit 20.000 normalen Eingabe- und 3.000 abgerechneten Ausgabe-Tokens aus, ohne Caching, Tools, Regionszuschläge und Wiederholungen, bei 2.000 Anfragen pro Monat. Die Kosten pro Anfrage in der Standard-Stufe betragen 20000×2/1e6 + 3000×10/1e6 = $0.07.
| Service-Stufe | Faktor | Kosten pro Anfrage | 2.000 Anfragen pro Monat |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast (bis 28.02.2027 PT) | 3× | $0.21 | $420 |
| Ultrafast (ab 01.03.2027 PT) | 6× | $0.42 | $840 |
2.2 Bedingungen, die Sie beim Lesen dieser Tabelle beachten sollten
Die Tabelle legt den Verbrauch pro Anfrage fest, damit sich das Budget leichter planen lässt. In der Praxis variieren Token-Verbrauch und Latenz derselben Aufgabe je nach Stufe mit den Anfragen; vor dem Go-live sollten Sie auf jeder Kandidatenstufe eine Charge echter Anfragen zur Gegenprüfung fahren.
Wenn Sie vor März 2027 mit Ultrafast budgetieren, sollten Sie parallel eine Version auf Basis des 6-Fachen vorbereiten. Im vorliegenden Beispiel steigen die Monatskosten von $420 auf $840; die Preiserhöhung erfolgt am 1. März nach Pazifikzeit, was nach Pekinger Zeit dem Nachmittag des 1. März entspricht.
💡 Empfehlung zur Stufenwahl: Die meisten interaktiven Anfragen zunächst mit Standard live schalten und nur latenzempfindliche Einstiegspunkte separat auf Fast oder Ultrafast umstellen. Mit APIYI apiyi.com können Sie über denselben API-Schlüssel parallel testen und so schnell echte Latenz- und Verbrauchsdaten für die einzelnen Stufen erhalten.
3. Wie lassen sich Nachtverarbeitung und Langdokument-Kosten bei GPT-6.2 Sol schätzen
3.1 Nächtliche Batch-Aufgaben: 2h, 8h und Batch
Für Aufgaben, die nicht sofort zurückgegeben werden müssen, gibt es drei Rabattoptionen. Die Abschlussfenster 2h und 8h im Responses-Hintergrundmodus werden mit 70 % bzw. 60 % der Token-Sätze des Standardmodells abgerechnet, aber die Anfrage muss Standard und nicht-streaming sein, und das Fenster bezieht sich auf die Zielzeit der initialen Antwort; soonest hat keinen Fensterrabatt. Die Batch-API wird mit 50 % des Standardpreises abgerechnet, per Datei-Batch eingereicht, mit einem Bearbeitungsfenster von 24 Stunden.
Das Berechnungsbeispiel geht von insgesamt 10.000 Anfragen aus, jede mit 50.000 normalen Eingabe- und 4.000 abgerechneten Ausgabe-Token, ohne Cache und Tools. Die Standard-Einzalkosten betragen 50000×2/1e6 + 4000×10/1e6 = $0.14.
| Methode | Satz | Einzelkosten | 10.000 Anfragen gesamt | Wann wählen |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | Ergebnisse werden schnell benötigt |
Hintergrund 2h |
70% | $0.098 | $980 | Die Anwendung muss innerhalb von zwei Stunden eine initiale Antwort erhalten, und während der Aufgabe müssen Tool-Ergebnisse zurückgegeben werden |
Hintergrund 8h |
60% | $0.084 | $840 | Abends einreichen, vor Arbeitsbeginn am nächsten Tag liefern, und schrittweise Interaktion erforderlich |
| Batch-API | 50% | $0.07 | $700 | Anfragen sind im Voraus vorbereitet, unabhängig voneinander, Lieferung am nächsten Tag möglich |
Die Organisation kann nach Aufgabenform erfolgen. Bei Aufgaben wie Klassifizierung und Extraktion, die unabhängig voneinander sind und vor der Einreichung vollständig geschrieben werden können, kann Batch als Preisreferenz dienen. Wenn die Anwendung während der Aufgabe Tool-Ergebnisse liefern muss, um fortzufahren, schätzen Sie jeden Schritt einzeln und wählen Sie dann je nach Gesamtlieferfrist der Anwendungsseite das 2h– oder 8h-Fenster.
Es gibt noch eine Kapazitätsbeschränkung: Rabattierte Hintergrundanfragen und Batch teilen sich ein separates Queue-Kontingent. Vor der Planung großer Batch-Einreichungen müssen Sie das Kontingent der aufgestauten Eingabe-Token prüfen, um zu vermeiden, dass Anfragen in der Warteschlange blockiert werden.
3.2 Lange Dokumente: der Kostensprung beim Überschreiten von 272K
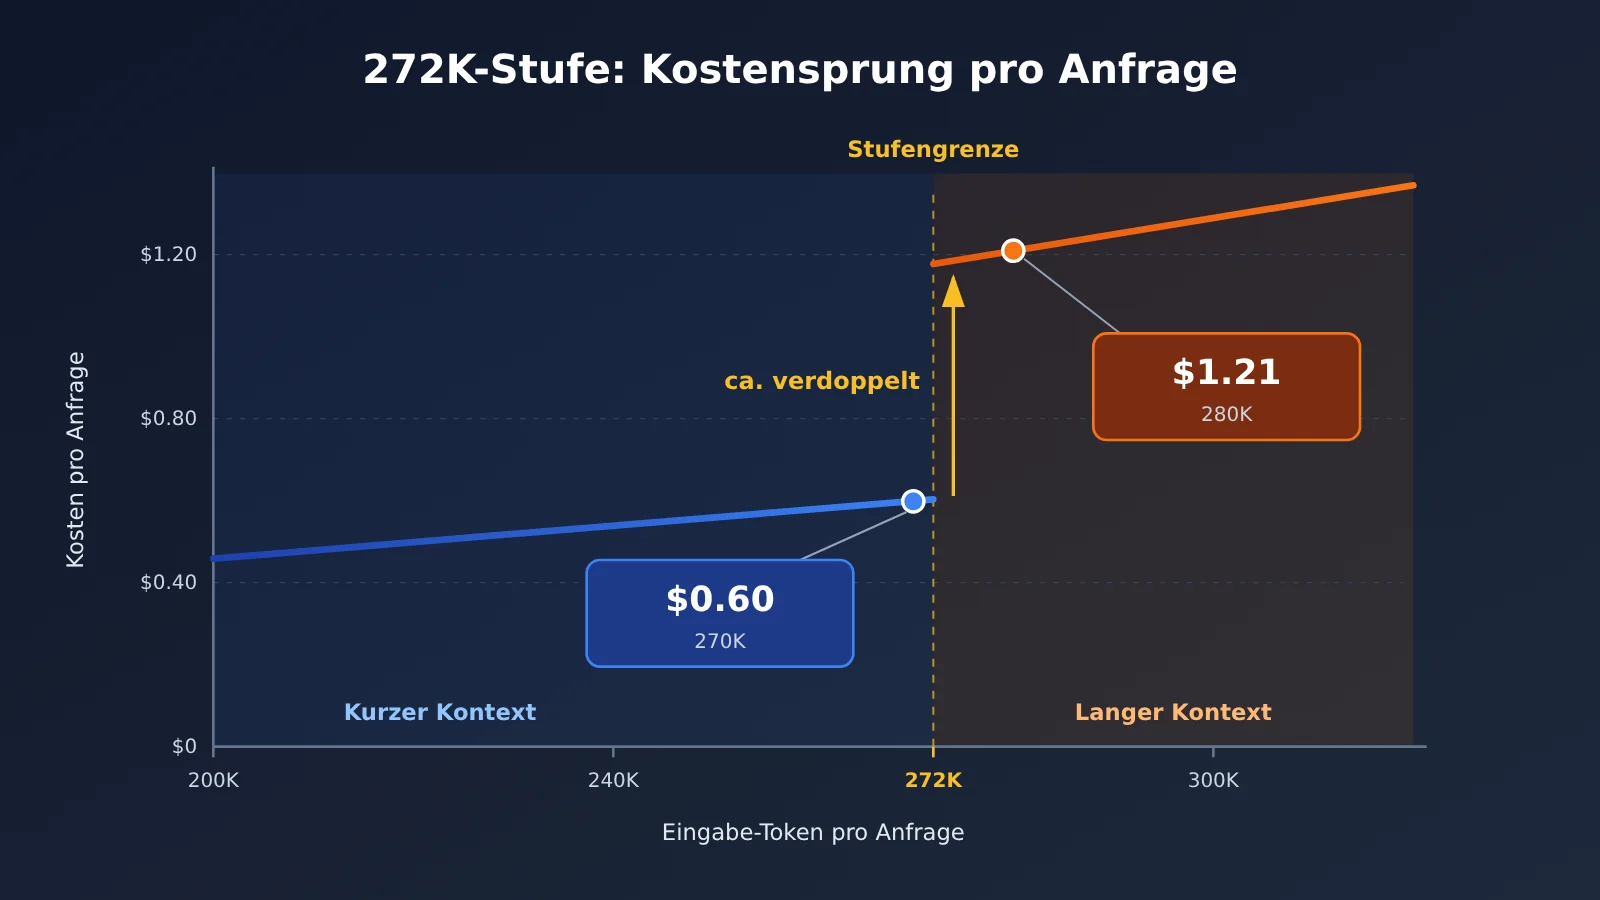
Der Kostensprung bei langen Dokumenten folgt aus der Tarifumschaltung. Das Rechenbeispiel geht von weder Cache noch Tools aus, einer festen Ausgabe von 6,000 Token, Tarif „Standard“ und Eingaben von 270,000 bzw. 280,000:
| Eingabemenge | Anwendbarer Tarif | Berechnung | Modellkosten pro Aufruf |
|---|---|---|---|
| 270,000 | Kurzer Kontext | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | Langer Kontext | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
Die Eingabe wächst nur um 10,000 Token, doch die Kosten pro Aufruf steigen von $0.60 auf $1.21 – also um rund das Doppelte. Der Grund: Die gesamte Anfrage wird plötzlich zum Langkontext-Tarif abgerechnet, und auch der Ausgabepreis steigt von $10 auf $15.
Bei der Budgetplanung sollten Sie pro Geschäfts-Queue die Eingabeverteilung jeder Anfrage erfassen und die regulären Anfragen getrennt von den Spitzen durch lange Dokumente schätzen, bevor Sie beides addieren. Wenn Sie durch Kürzen der Dokumente die Eingabe unter 272K drücken wollen, müssen Sie zugleich prüfen, ob der gekürzte Inhalt noch die für die Auslieferung nötigen Nachweise enthält – sonst werden die eingesparten Kosten womöglich durch Nacharbeit wieder aufgefressen.
4. Monatsbudget für GPT-6.2 Sol nach Kanal ausfüllen
4.1 Öffentliche Preisliste von APIYI und offizielle OpenAI-Tarife parallel nachrechnen
Beim erneuten Abruf der öffentlichen Modellübersicht und der öffentlichen Preis-API von APIYI am 2026-11-20 war gpt-6.2-sol in beiden Einträgen zu finden; die Übersicht weist die beiden Endpunkte responses und chat aus. Die öffentliche Preisliste staffelt ebenfalls bei 272.000 Eingabe-Token, doch der Preisausdruck für die lange Stufe unterscheidet sich vom offiziellen Multiplikator.
| Abrechnungskategorie (USD / Million Token) | OpenAI kurze Stufe | OpenAI lange Stufe | APIYI apiyi.com kurze Stufe | APIYI apiyi.com lange Stufe |
|---|---|---|---|---|
| Reguläre Eingabe | $2.00 | $4.00 | $2.00 | $3.00 |
| Cache-Lesen | $0.10 | $0.20 | $0.10 | $0.15 |
| Cache-Schreiben | $2.50 (30 Minuten) | $5.00 (30 Minuten) | $2.50 | $3.75 |
| Ausgabe | $10.00 | $15.00 | $10.00 | $11.25 |
Wir bleiben bei der Nutzungs-Nachrechnung aus Abschnitt 3.2. Bei 270.000 Eingabe- und 6.000 Ausgabe-Token liegen beide Kanäle bei $0.60. Bei 280.000 Eingabe- und 6.000 Ausgabe-Token kommt OpenAI offiziell auf $1.21, nach der öffentlichen APIYI-Formel sind es (280000×3 + 6000×11.25)÷1e6 = $0.9075, also rund $0.30 Unterschied pro Anfrage. Je höher der Anteil langer Dokumente, desto stärker wirkt sich diese Differenz auf das Monatsbudget aus.
Die oben genannte Differenz leitet sich ausschließlich aus den bereits veröffentlichten Parametern beider Seiten ab. Die weiter oben beschriebenen Batch- und Hintergrundfenster-Rabatte stammen aus offiziellen OpenAI-Rechenbeispielen; beim Aufruf über APIYI richten sich Kontogruppierung, tatsächliche Abrechnung, verfügbare Stufen und API-Fähigkeiten nach der aktuellen Konfiguration und Abrechnung von APIYI.
4.2 Monatliche Budgettabelle: eine Zeile pro Aufgabentyp
Jetzt bringen wir die bisherige Rechnung auf ein Blatt Papier: Jeder Aufgabentyp bekommt eine Zeile, eingetragen werden die durchschnittlichen Werte pro Anfrage – multipliziert mit der Anzahl der monatlichen Anfragen. Wenn ein Workflow mehrere Modellaufrufe enthält (etwa die mehrstufige Inferenz eines Agenten), wird jeder Schritt in einer eigenen Zeile erfasst und am Ende alles einzeln aufsummiert.
| Aufgabentyp | Anfragen pro Monat | Durchschn. normale Eingabe | Durchschn. Cache-Lesevorgänge | Cache-Schreibvorgänge (Stufe) | Durchschn. abgerechnete Ausgabe | Kontextstufe | Service-Stufe | Zusätzliche Kosten (Tools / Region) | Erwartete Wiederholungsrate | Monatliche Kosten |
|---|---|---|---|---|---|---|---|---|---|---|
| Kundenservice-Interaktion | 2,000 | 20,000 | 0 | 0 | 3,000 | kurz | Standard | keine | 0 % | $140 |
| Nächtliche Klassifizierung | 10,000 | 50,000 | 0 | 0 | 4,000 | kurz | Batch | keine | 0 % | $700 |
| Vertragsprüfung | Nach tatsächlichem Wert ausfüllen | Nach tatsächlichem Wert ausfüllen | 6,000 | lang | Standard | Nach tatsächlichem Wert ausfüllen | Nach tatsächlichem Wert ausfüllen |
Die Zahlen in den ersten beiden Zeilen stammen aus den Rechenbeispielen dieses Artikels und lassen sich als Orientierung beim Ausfüllen verwenden. Die Formel für die monatlichen Kosten lautet „Modellkosten pro Aufruf × Anfragen pro Monat × (1 + Wiederholungsrate) + zusätzliche Kosten“. Die Kosten pro Modellaufruf werden dabei je nach Kontextstufe und Service-Stufe der jeweiligen Zeile aus der Preistabelle in Abschnitt 1 entnommen.
🚀 Praxistipp: Wenn die Budgettabelle ausgefüllt ist, nehmen Sie die beiden Aufgabentypen mit den höchsten Beträgen heraus und lassen Sie jeweils eine Runde mit echten Anfragen über APIYI apiyi.com laufen. Tauschen Sie die Schätzwerte gegen die gemessenen
usage-Werte aus – und schon haben Sie ein Budget, das Sie der Buchhaltung vorlegen können.
4.3 Prüfen, ob das Budget verlässlich ist
Sobald die Rechnung des ersten Monats vorliegt, gehen Sie drei Punkte Zeile für Zeile durch.
- Ob der Anteil der Anfragen über 272K in der tatsächlichen Eingabeverteilung nahe an der Schätzung liegt.
- Ob der Anteil der Reasoning-Tokens an den
output_tokensdeutlich höher liegt als in der Testphase. - Ob die tatsächliche Anzahl von Wiederholungen und Tool-Aufrufen mitgezählt wurde.
Liegen die Abweichungen bei allen drei Punkten innerhalb von zehn Prozent, können Sie die Tabelle im nächsten Monat direkt weiterverwenden; der Punkt mit der größeren Abweichung ist derjenige, bei dem Sie das Nutzungsvolumen oder die Tarifstufe vorrangig anpassen sollten.
Referenzen
- Offizielle API-Preise von OpenAI: Multiplikatoren der einzelnen Service-Stufen sowie Batch- und Hintergrundfenster-Rabatte
- Link:
developers.openai.com/api/docs/pricing
- Link:
- Modellkarte GPT-6.2 Sol: Kontextfenster, 272K-Stufenregel und Limits
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Link:
- Leitfaden zu Hintergrundmodus und Batch API: Abschlussfenster, Anforderungen an Nicht-Streaming und Queue-Kontingente
- Link:
developers.openai.com/api/docs/guides/background,developers.openai.com/api/docs/guides/batch
- Link:
- APIYI-Modellübersicht und öffentliche Preisschnittstelle: Listungseinstieg für
gpt-6.2-solund Preisausdruck für die Stufenberechnung- Link:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing
- Link:
Autor: APIYI-Team
Technischer Austausch: Bei Fragen zur Abrechnungslogik und Kontokonfiguration können Sie uns über die Startseite der APIYI-Website kontaktieren; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com