Saat memanggil API GPT-6.2 Sol, biaya ditentukan oleh tiga langkah. Langkah pertama melihat total input per permintaan, dengan batas 272K token untuk membedakan konteks pendek dan panjang; jika melewati ambang ini, tarif input dan cache untuk seluruh permintaan dikalikan 2, sedangkan output dikalikan 1.5. Langkah kedua memilih tingkat layanan berdasarkan tenggat waktu pengiriman: Standard adalah harga dasar, Batch diskon 50%, jendela background 8h dan 2h masing-masing ditagih 60% dan 70%, Fast 2 kali lipat, Ultrafast 3 kali lipat sebelum 2027-02-28 (waktu Pasifik) dan 6 kali lipat setelahnya. Langkah ketiga mengalikan biaya per permintaan dengan volume permintaan bulanan, lalu menambahkan pemanggilan alat, biaya regional yang berlaku, dan percobaan ulang.
Harga list Standard untuk konteks pendek adalah: input biasa $2.00 per juta token, pembacaan cache $0.10, output (termasuk token penalaran) $10.00. Dengan harga ini, satu permintaan interaktif dengan 20,000 input dan 3,000 output sekitar $0.07, dan 2,000 permintaan per bulan sekitar $140. Semua harga dalam artikel ini dihitung dalam dolar AS / juta token, dengan tanggal verifikasi 2026-11-20 (waktu Beijing).
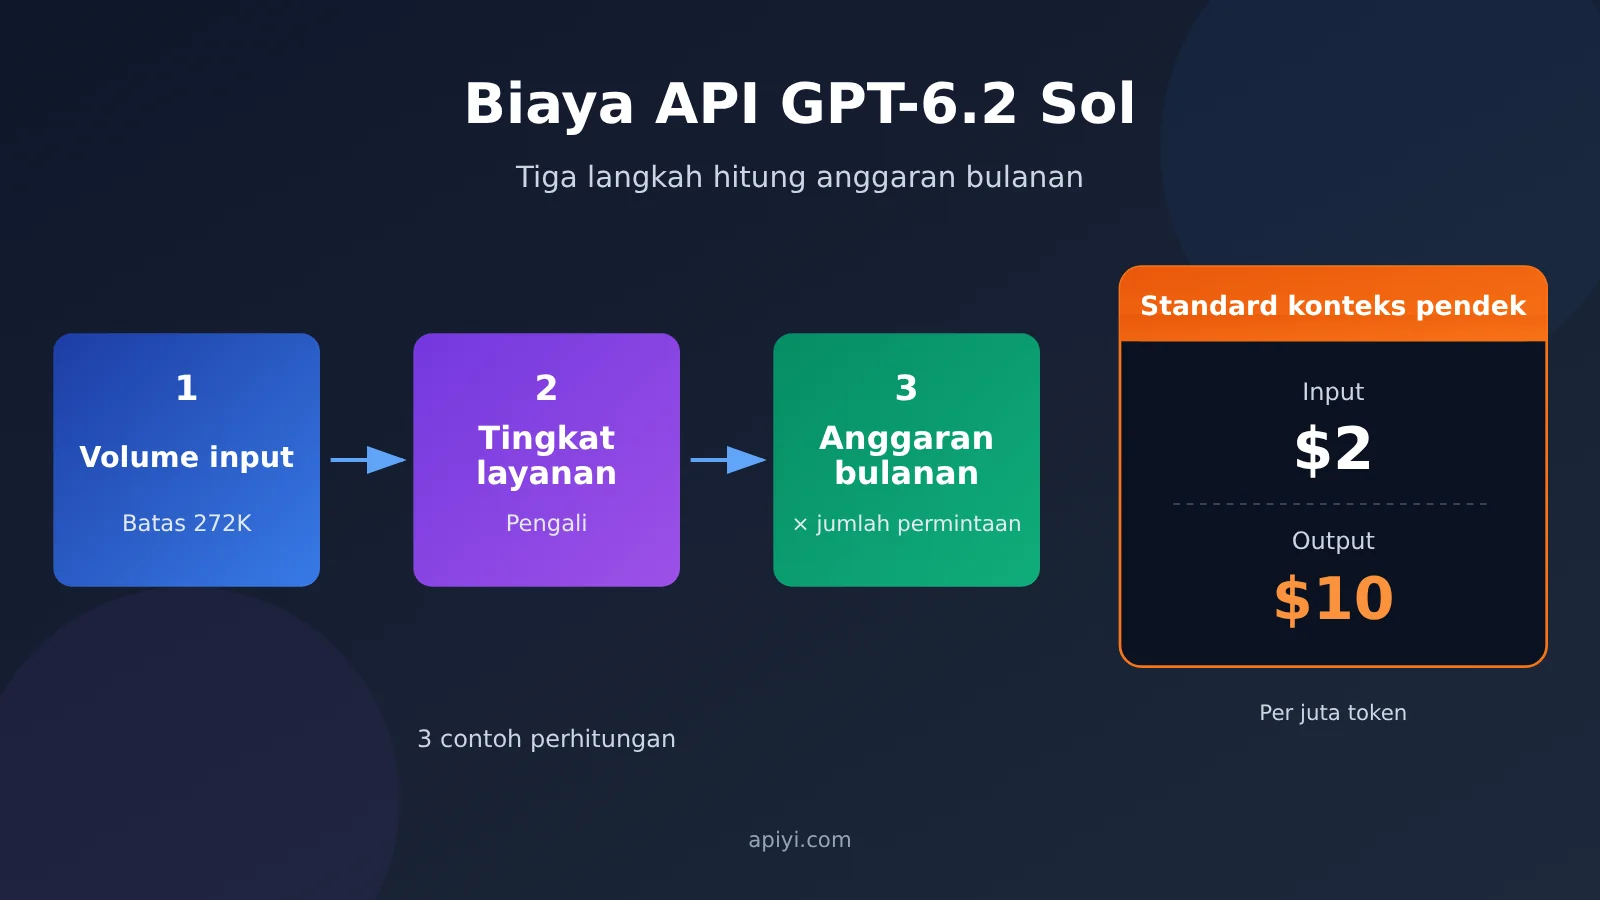
Peta Pengetahuan Penagihan API GPT-6.2 Sol dan Indeks Bacaan
Seluruh artikel disusun dengan urutan “menilai volume input → memilih tingkat berdasarkan tenggat pengiriman → akumulasi pemanggilan”. Tabel berikut menyatukan pertanyaan yang harus dijawab pada setiap langkah, hasil keluaran, dan nomor bagian di teks utama; hasil dari bagian sebelumnya menjadi input bagi bagian berikutnya.
| Langkah | Pertanyaan yang harus dijawab | Output langkah ini | Nomor bagian |
|---|---|---|---|
| Penilaian volume input | Apakah permintaan ini termasuk konteks pendek atau konteks panjang | Tabel tarif dasar yang berlaku | 1, 3.2 |
| Pemilihan tingkat berdasarkan tenggat pengiriman | Apakah pengguna menunggu secara online, atau pengiriman bisa dilakukan beberapa jam kemudian atau hari berikutnya | Pengali tingkat layanan | 2, 3.1 |
| Akumulasi pemanggilan | Berapa banyak permintaan per bulan, dan biaya tambahan apa saja yang ada | Anggaran bulanan | 2, 4 |
| Perhitungan ulang per kanal | Jika berganti kanal penagihan, berapa biaya untuk permintaan yang sama | Perbandingan kanal dan tabel anggaran | 4 |
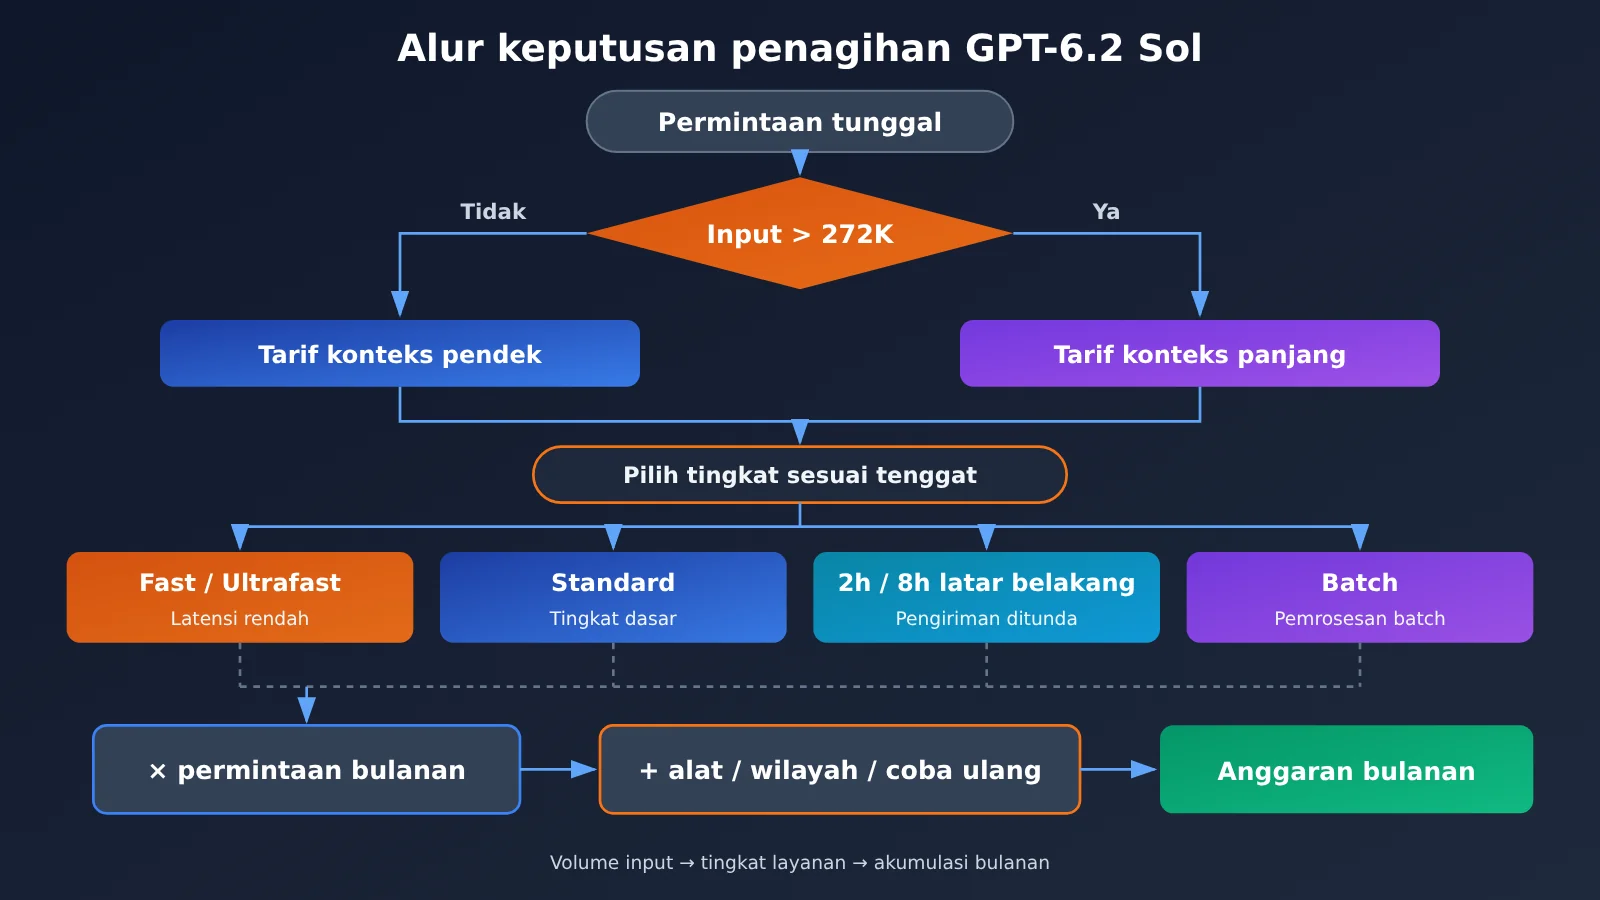
Dalam urutan pembacaan, Bagian 1 memberikan tarif dasar yang menjadi acuan semua contoh perhitungan berikutnya. Bagian 2 dan Bagian 3 masing-masing membahas dua jenis bisnis: “pengguna menunggu hasil secara online” dan “pengiriman boleh ditunda”; Anda dapat membaca hanya bagian yang relevan. Bagian 4 menerapkan perhitungan di atas pada daftar harga publik APIYI apiyi.com dan tarif resmi OpenAI secara berdampingan, lalu diakhiri dengan tabel anggaran bulanan yang bisa langsung diisi.
Istilah Penagihan GPT-6.2 Sol yang Perlu Diketahui
| Istilah | Penjelasan |
|---|---|
| Token | Unit dasar yang digunakan model untuk mengukur teks dan input/output lain; jumlahnya mengikuti statistik yang dikembalikan server |
| Standard | Tingkat pemrosesan standar pada API resmi, sekaligus dasar perhitungan pengali untuk tingkat lain |
| Pembacaan cache | Saat permintaan menggunakan kembali awalan riwayat yang sudah di-cache, bagian input ini ditagih dengan tarif pembacaan cache |
| Penulisan cache | Kategori penagihan terpisah untuk menyimpan awalan yang memenuhi syarat agar dapat digunakan kembali nanti; tersedia dua tingkatan: 30 menit dan 12 jam |
| Output yang ditagih | Volume output yang dihitung API, termasuk token penalaran dan output akhir |
| Batch API | Antarmuka untuk mengirim permintaan independen yang sudah disiapkan dalam bentuk file ke pemrosesan batch latar belakang |
| Jendela penyelesaian | Tenggat target yang ditetapkan untuk respons awal setelah permintaan latar belakang diterima |
| Fast dan Ultrafast | Dua tingkat tarif tinggi untuk skenario latensi rendah |
1. Apa Saja Tarif yang Dikenakan untuk Satu Permintaan GPT-6.2 Sol API
1.1 Lima Kategori Penagihan pada Tier Standard
ID model API GPT-6.2 Sol adalah gpt-6.2-sol, dan dapat dipanggil melalui dua endpoint, yaitu Responses dan Chat Completions. Satu permintaan bisa melibatkan hingga lima kategori penagihan. Tabel berikut adalah harga resmi tier Standard. Harga dasar untuk konteks pendek sama dengan GPT-6.1 Sol; kolom konteks panjang dihitung berdasarkan pengali pada kartu model.
| Kategori penagihan Standard | Konteks pendek (input ≤272K) | Konteks panjang (input >272K) |
|---|---|---|
| Input biasa | $2.00 | $4.00 |
| Pembacaan cache | $0.10 | $0.20 |
| Penulisan cache 30 menit | $2.50 | $5.00 |
| Penulisan cache 12 jam | $5.00 | $10.00 |
| Output (termasuk token penalaran) | $10.00 | $15.00 |
Ada tiga hal di tabel yang mudah salah hitung.
- Penulisan cache tidak ditambahkan ke input biasa. Token yang ditulis ke cache dikenakan tarif penuh sesuai tier 30 menit atau 12 jam, sekali saja, tanpa tambahan biaya input biasa.
- Token penalaran masuk ke output.
usage.output_tokensyang dikembalikan Responses adalah total output, sedangkan penggunaan penalaran biasanya dicantumkan sebagai sub-item dioutput_tokens_details.reasoning_tokens. Anggaran cukup dihitung berdasarkan totalnya. - Perpindahan tier berlaku untuk seluruh permintaan. Begitu total input melewati 272K, seluruh input, cache, dan output dalam permintaan itu beralih ke tarif konteks panjang, bukan hanya bagian yang melewati batas yang dinaikkan harganya.
Kartu model juga mencantumkan jendela konteks 1.050.000 token, input maksimum 922.000 token, dan output maksimum 128.000 token. 922K adalah input maksimum yang diizinkan, sedangkan 272K adalah titik perpindahan tier penagihan; keduanya tidak saling berkaitan.
1.2 Pengeluaran di Luar Biaya Model
Tabel di atas hanya mencakup biaya token model. Di Responses, Sol dapat memanggil alat seperti pencarian file, pencarian web, interpreter kode, dan pembuatan gambar. Alat-alat tersebut ditagih menurut aturan masing-masing saat benar-benar digunakan. Ketika membuat gambar, Sol bertugas memicu pemanggilan alat, sedangkan gambar dihasilkan oleh alat gambar terpisah, sehingga biaya gambar harus dihitung terpisah. Jika diterapkan di wilayah tertentu, biaya regional yang berlaku mungkin juga muncul. Sisakan kolom tersendiri untuk pos-pos ini di tabel anggaran, jangan campurkan dengan harga satuan token.
1.3 Membaca Penggunaan Penagihan Aktual dengan Kode
Setelah melakukan estimasi, kalibrasi menggunakan field usage dari permintaan nyata. Contoh berikut memanggil Sol melalui antarmuka yang kompatibel dengan OpenAI, lalu mengonversi biaya model untuk permintaan ini berdasarkan tarif Standard konteks pendek:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI dari APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句话说明 Batch API 适合什么任务。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"输入 {u.input_tokens},其中缓存 {cached},输出 {u.output_tokens},模型费约 ${cost:.6f}")
Konversi ini hanya berlaku untuk permintaan Standard dengan input tidak melebihi 272K dan tanpa penulisan cache. Untuk lingkungan produksi, sebaiknya tulis usage setiap permintaan ke log, lalu agregasikan berdasarkan jenis tugas sebelum mengisi tabel anggaran di bagian 4.
🎯 Saran resmi: sebelum menetapkan anggaran final, jalankan dulu 20 hingga 50 permintaan bisnis nyata untuk mengumpulkan statistik distribusi input dan output. Pengguna baru APIYI apiyi.com memiliki kuota uji gratis, cocok untuk kalibrasi sampel kecil semacam ini.
2. Cara Menghitung Tingkat Interaksi dan Anggaran Bulanan GPT-6.2 Sol
2.1 Biaya Permintaan yang Sama di Tiga Tingkat Interaksi
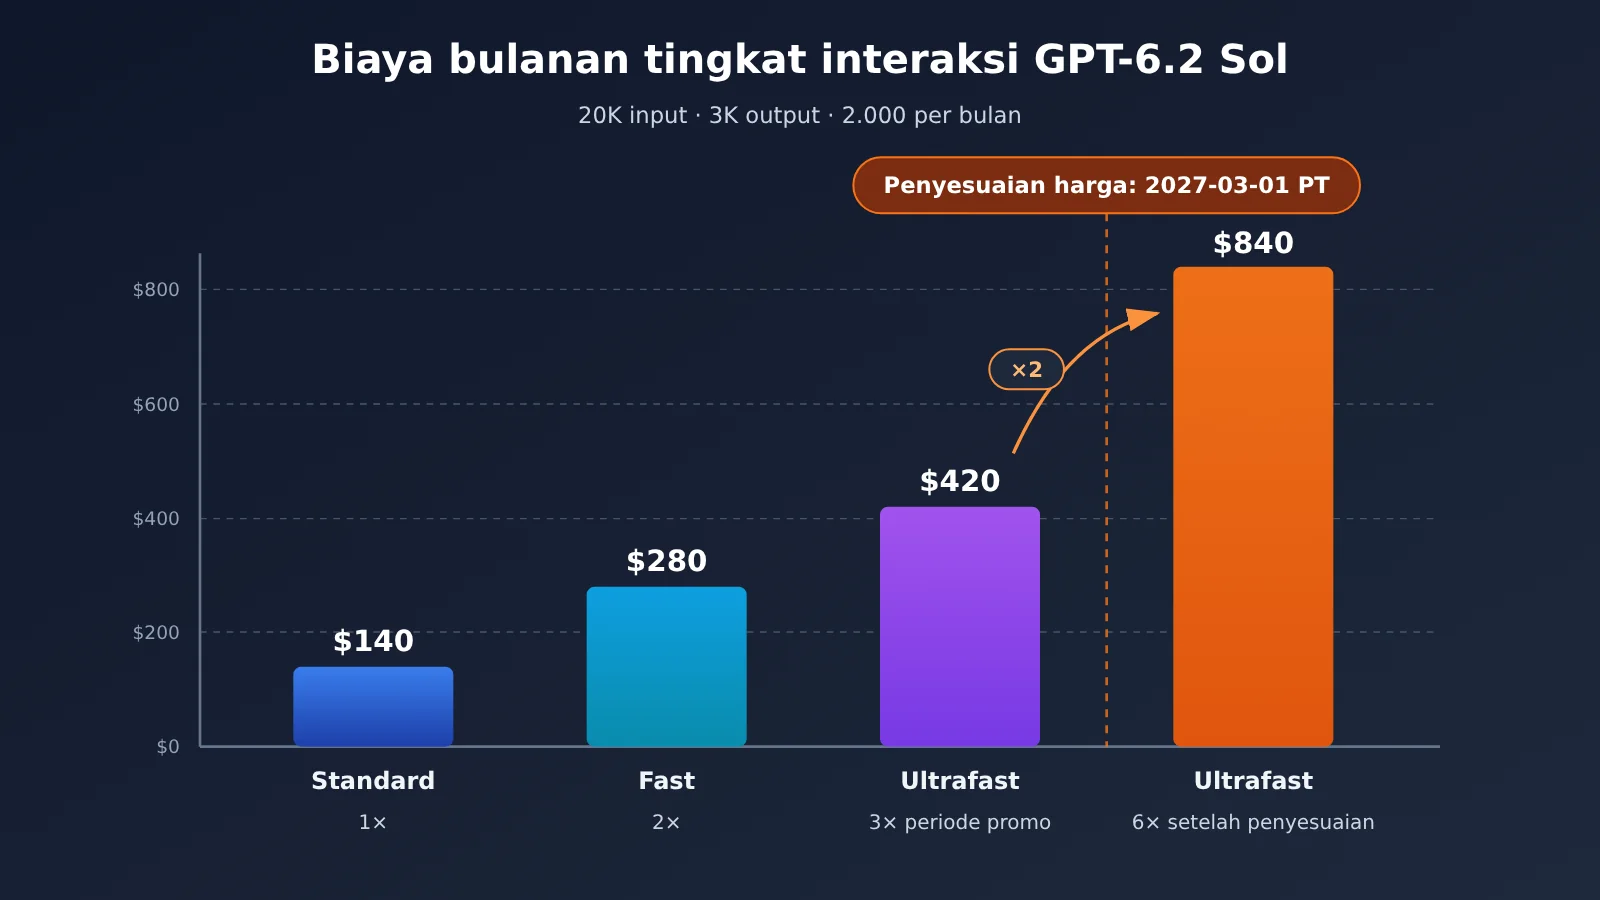
Dalam skenario interaktif, pengguna menunggu hasil di antarmuka, dan pilihan yang tersedia adalah Standard, Fast, dan Ultrafast. Fast ditagih 2× dari Standard; Ultrafast 3× hingga 2027-02-28 (waktu Pasifik), lalu 6× mulai 2027-03-01. GPT-6.2 Sol tidak mendukung tingkat Flex.
Contoh perhitungan mengasumsikan satu permintaan memiliki 20.000 token input biasa dan 3.000 token output yang ditagih, tanpa cache, alat, biaya regional, dan percobaan ulang, sebanyak 2.000 permintaan per bulan. Biaya sekali jalan untuk Standard adalah 20000×2/1e6 + 3000×10/1e6 = $0.07.
| Tingkat Layanan | Pengali | Biaya Sekali | 2.000 per Bulan |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast (hingga 2027-02-28 PT) | 3× | $0.21 | $420 |
| Ultrafast (mulai 2027-03-01 PT) | 6× | $0.42 | $840 |
2.2 Kondisi yang Perlu Diperhatikan Saat Membaca Tabel Ini
Tabel ini menggunakan jumlah penggunaan per permintaan yang tetap agar lebih mudah menyusun anggaran. Pada kenyataannya, konsumsi token dan latensi untuk tugas yang sama di tingkat berbeda akan bervariasi dari permintaan ke permintaan. Sebelum rilis, sebaiknya jalankan sekumpulan permintaan nyata di setiap tingkat kandidat untuk verifikasi ulang.
Jika Anda menyusun anggaran dengan Ultrafast sebelum Maret 2027, siapkan juga versi yang dihitung berdasarkan pengali 6×. Dengan contoh ini, biaya bulanan berubah dari $420 menjadi $840 setelah penyesuaian harga; kenaikan harga berlaku pada 1 Maret waktu Pasifik, yang jika dikonversi ke waktu Beijing berarti sore hari pada 1 Maret.
💡 Saran Pemilihan Tingkat:Untuk sebagian besar permintaan interaktif, mulai dulu dengan Standard, dan hanya beralih ke Fast atau Ultrafast untuk titik masuk yang sensitif terhadap latensi. Dengan menguji secara paralel memakai kunci API yang sama melalui APIYI apiyi.com, Anda bisa lebih cepat memperoleh data latensi dan penggunaan nyata untuk setiap tingkat.
3. Cara mengestimasi biaya pemrosesan malam hari dan dokumen panjang GPT-6.2 Sol
3.1 Tugas batch malam hari: 2h, 8h, dan Batch
Ada tiga cara mendapatkan diskon untuk tugas yang tidak perlu hasil instan. Mode latar belakang Responses dengan jendela penyelesaian 2h dan 8h masing-masing ditagih 70% dan 60% dari tarif token model Standard, tetapi permintaannya harus Standard dan non-streaming; jendela tersebut mengacu pada waktu target respons awal; soonest tidak mendapat diskon jendela. Batch API ditagih 50% dari tarif Standard, dikirim sebagai file batch, dengan jendela penyelesaian 24 jam.
Contoh perhitungan mengasumsikan total 10,000 permintaan, masing-masing 50,000 token input biasa dan 4,000 token output yang ditagih, tanpa cache dan tanpa tool. Biaya Standard per permintaan adalah 50000×2/1e6 + 4000×10/1e6 = $0.14.
| Cara | Tarif | Biaya per permintaan | Total 10,000 permintaan | Kapan dipakai |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | Butuh hasil secepat mungkin |
Latar belakang 2h |
70% | $0.098 | $980 | Aplikasi perlu respons awal dalam dua jam, dan di tengah tugas harus mengisi balik hasil tool |
Latar belakang 8h |
60% | $0.084 | $840 | Dikirim malam itu, diserahkan sebelum jam kerja besok, dan perlu interaksi bertahap |
| Batch API | 50% | $0.07 | $700 | Permintaan sudah disiapkan sebelumnya, saling independen, bisa diserahkan keesokan hari |
Pengorganisasian bisa dilakukan berdasarkan bentuk tugas. Untuk tugas seperti klasifikasi dan ekstraksi yang saling independen dan bisa ditulis lengkap sebelum dikirim, Batch bisa dijadikan patokan harga. Untuk tugas yang di tengah jalan memerlukan hasil tool dari aplikasi sebelum dilanjutkan, estimasikan per langkah, lalu pilih jendela 2h atau 8h berdasarkan batas waktu penyerahan total di sisi aplikasi.
Ada satu batasan kapasitas lagi: permintaan latar belakang berdiskon dan Batch berbagi satu kuota antrean terpisah. Sebelum merencanakan pengiriman dalam jumlah besar, periksa kuota token input yang tertunda, agar permintaan tidak macet di antrean.
3.2 Dokumen panjang: lonjakan biaya saat melewati 272K
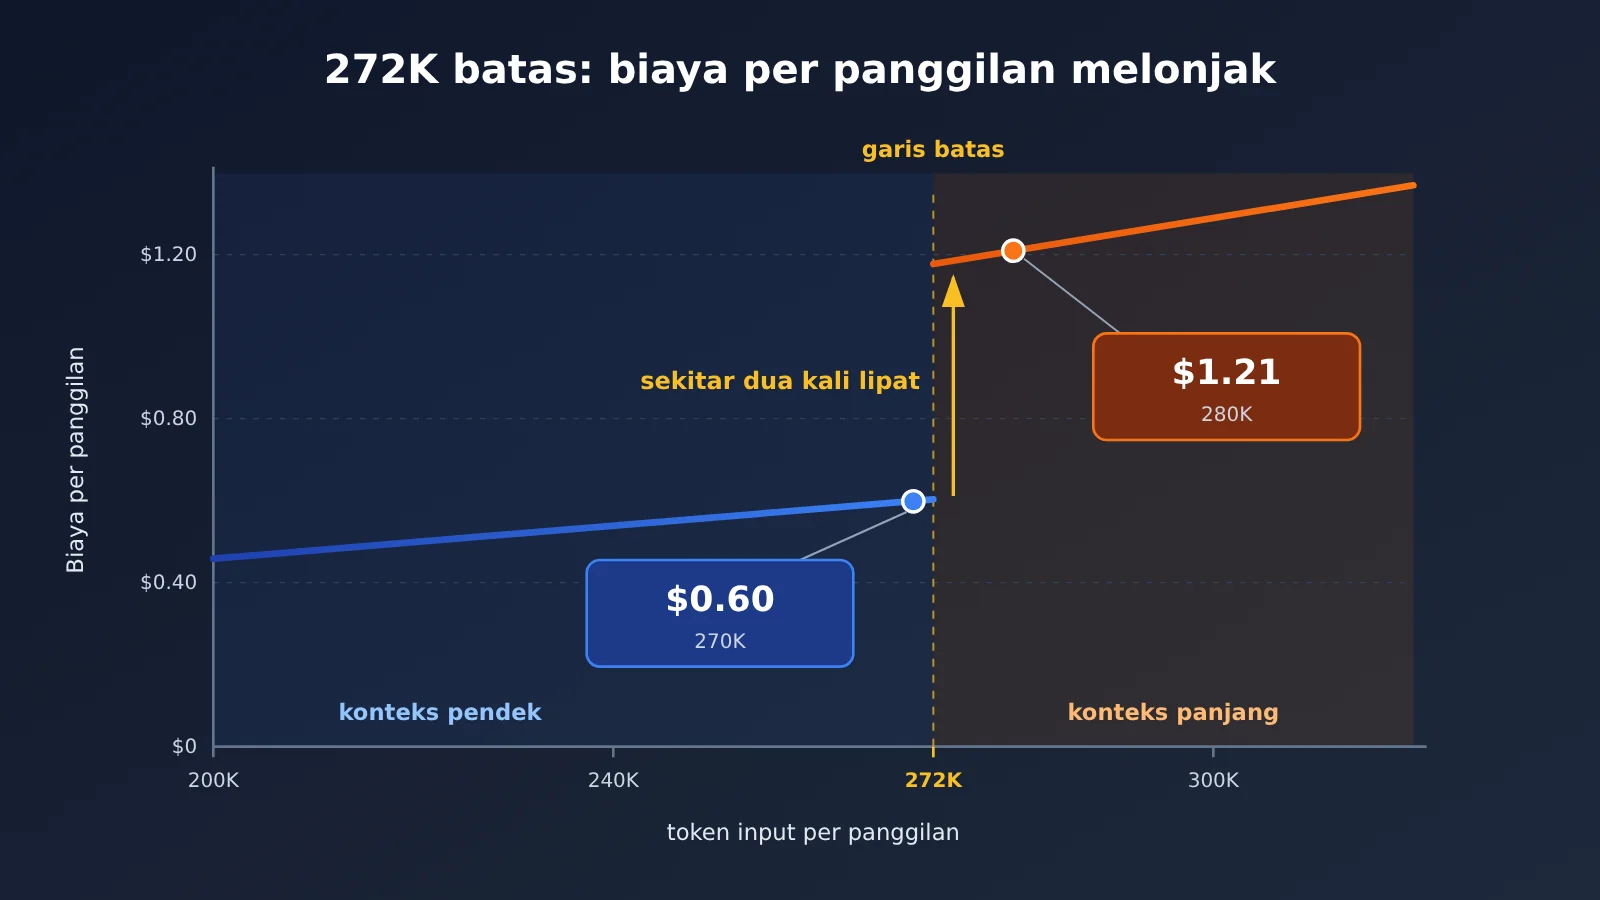
Lonjakan biaya dokumen panjang berasal dari aturan pergantian tier. Contoh perhitungan mengasumsikan tanpa cache dan tool, output tetap 6,000 token, tier Standard, dengan input masing-masing 270,000 dan 280,000:
| Jumlah input | Tarif yang berlaku | Perhitungan | Biaya model per permintaan |
|---|---|---|---|
| 270,000 | Konteks pendek | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | Konteks panjang | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
Input hanya bertambah 10,000 token, tetapi biaya per permintaan berubah dari $0.60 menjadi $1.21, naik sekitar dua kali lipat. Penyebabnya, seluruh permintaan ikut dihitung dengan tarif konteks panjang, dan harga satuan output juga berubah dari $10 menjadi $15.
Saat menyusun anggaran, catat distribusi input setiap permintaan menurut antrean bisnis, estimasikan permintaan normal dan puncak dokumen panjang secara terpisah lalu jumlahkan. Jika berencana memangkas dokumen agar input berada di bawah 272K, pastikan juga bahwa konten hasil pemangkasan masih memuat bukti yang dibutuhkan untuk penyerahan; kalau tidak, biaya yang dihemat bisa habis lagi untuk pekerjaan ulang.
4. Mengisi Anggaran Bulanan GPT-6.2 Sol per Kanal
4.1 Perhitungan Ulang Berdampingan: Daftar Harga Publik APIYI vs Tarif Resmi OpenAI
Pada 2026-11-20, saya membaca ulang tabel total model publik APIYI dan antarmuka harga publiknya, dan gpt-6.2-sol bisa ditemukan di keduanya. Tabel total mencantumkan dua entri, yaitu responses dan chat. Harga publiknya juga memakai pemotongan tarif pada 272,000 token input, tetapi ekspresi perhitungan untuk tarif panjang berbeda dari pengali resmi.
| Kategori penagihan (USD / juta token) | OpenAI tarif pendek | OpenAI tarif panjang | APIYI apiyi.com tarif pendek | APIYI apiyi.com tarif panjang |
|---|---|---|---|---|
| Input biasa | $2.00 | $4.00 | $2.00 | $3.00 |
| Pembacaan cache | $0.10 | $0.20 | $0.10 | $0.15 |
| Penulisan cache | $2.50 (30 menit) | $5.00 (30 menit) | $2.50 | $3.75 |
| Output | $10.00 | $15.00 | $10.00 | $11.25 |
Melanjutkan perhitungan ulang pemakaian dari bagian 3.2. Dengan 270,000 input dan 6,000 output, kedua kanal sama-sama $0.60. Dengan 280,000 input dan 6,000 output, OpenAI resmi sebesar $1.21, sedangkan menurut rumus publik APIYI (280000×3 + 6000×11.25)÷1e6 = $0.9075, selisihnya sekitar $0.30 per item. Semakin tinggi proporsi dokumen panjang, semakin besar dampak selisih ini terhadap anggaran bulanan.
Selisih di atas hanya diturunkan dari parameter yang sudah dipublikasikan oleh kedua pihak. Diskon Batch dan jendela latar belakang yang disebut sebelumnya menggunakan contoh perhitungan resmi OpenAI; saat memanggil melalui APIYI, pengelompokan akun, biaya aktual, tarif yang tersedia, dan kemampuan API mengacu pada konfigurasi serta tagihan APIYI saat ini.
4.2 Tabel anggaran bulanan untuk satu baris per jenis tugas
Ubah algoritma di atas menjadi satu tabel: setiap jenis tugas menempati satu baris, diisi berdasarkan penggunaan rata-rata per permintaan, lalu dikalikan dengan jumlah permintaan per bulan. Jika alur kerja memiliki beberapa pemanggilan model (misalnya penalaran multi-langkah pada Agent), catat setiap langkah sebagai baris terpisah, lalu jumlahkan satu per satu di akhir.
| Jenis tugas | Jumlah permintaan per bulan | Rata-rata input biasa | Rata-rata pembacaan cache | Penulisan cache (tingkat) | Rata-rata output yang ditagih | Kelas jendela konteks | Tingkat layanan | Biaya tambahan (alat / wilayah) | Perkiraan tingkat percobaan ulang | Biaya bulanan |
|---|---|---|---|---|---|---|---|---|---|---|
| Interaksi layanan pelanggan | 2.000 | 20.000 | 0 | 0 | 3.000 | Pendek | Standard | Tidak ada | 0% | $140 |
| Klasifikasi malam hari | 10.000 | 50.000 | 0 | 0 | 4.000 | Pendek | Batch | Tidak ada | 0% | $700 |
| Peninjauan kontrak | Isi sesuai aktual | Isi sesuai aktual | 6.000 | Panjang | Standard | Isi sesuai aktual | Isi sesuai aktual |
Angka pada dua baris pertama berasal dari contoh perhitungan di artikel ini dan bisa dijadikan acuan pengisian. Rumus biaya bulanan adalah “biaya model per permintaan × jumlah permintaan per bulan × (1 + tingkat percobaan ulang) + biaya tambahan”. Biaya model per permintaan harus diambil dari tabel tarif di Bagian 1 sesuai kelas jendela konteks dan tingkat layanan pada baris tersebut.
🚀 Saran penerapan: Setelah tabel anggaran selesai diisi, pilih dua jenis tugas dengan nominal tertinggi, jalankan masing-masing satu putaran dengan permintaan nyata di APIYI apiyi.com, lalu ganti nilai estimasi dengan nilai terukur
usage; hasilnya adalah anggaran yang bisa diserahkan ke bagian keuangan.
4.3 Memverifikasi apakah anggaran dapat diandalkan
Setelah menerima tagihan bulan pertama, periksa tiga hal baris demi baris.
- Dalam distribusi input aktual, apakah proporsi permintaan yang melebihi 272K mendekati perkiraan.
- Apakah proporsi token penalaran dalam
output_tokensjelas lebih tinggi daripada fase pengujian. - Apakah jumlah percobaan ulang dan pemanggilan alat yang sebenarnya telah dihitung.
Jika penyimpangan ketiga item berada dalam kisaran sepuluh persen, bulan depan tabel ini bisa langsung digunakan; item dengan penyimpangan lebih besar adalah bagian yang perlu diprioritaskan untuk menyesuaikan penggunaan atau tingkat layanan.
Referensi
- Harga API resmi OpenAI: pengali tarif tiap tingkat layanan serta diskon Batch dan jendela latar belakang
- Tautan:
developers.openai.com/api/docs/pricing
- Tautan:
- Kartu model GPT-6.2 Sol: jendela konteks, aturan pemotongan tarif 272K, dan batas kuota
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Tautan:
- Panduan mode latar belakang dan Batch API: jendela penyelesaian, persyaratan non-streaming, dan kuota antrean
- Tautan:
developers.openai.com/api/docs/guides/background,developers.openai.com/api/docs/guides/batch
- Tautan:
- Tabel lengkap model APIYI dan antarmuka harga publik: titik masuk pencatatan
gpt-6.2-soldan ekspresi perhitungan tarif pemotongan- Tautan:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing
- Tautan:
Penulis: Tim teknis APIYI
Komunikasi teknis: Untuk pertanyaan terkait standar penagihan dan konfigurasi akun, Anda dapat menghubungi kami di halaman utama situs resmi APIYI; untuk lebih banyak materi integrasi, lihat pusat dokumentasi docs.apiyi.com