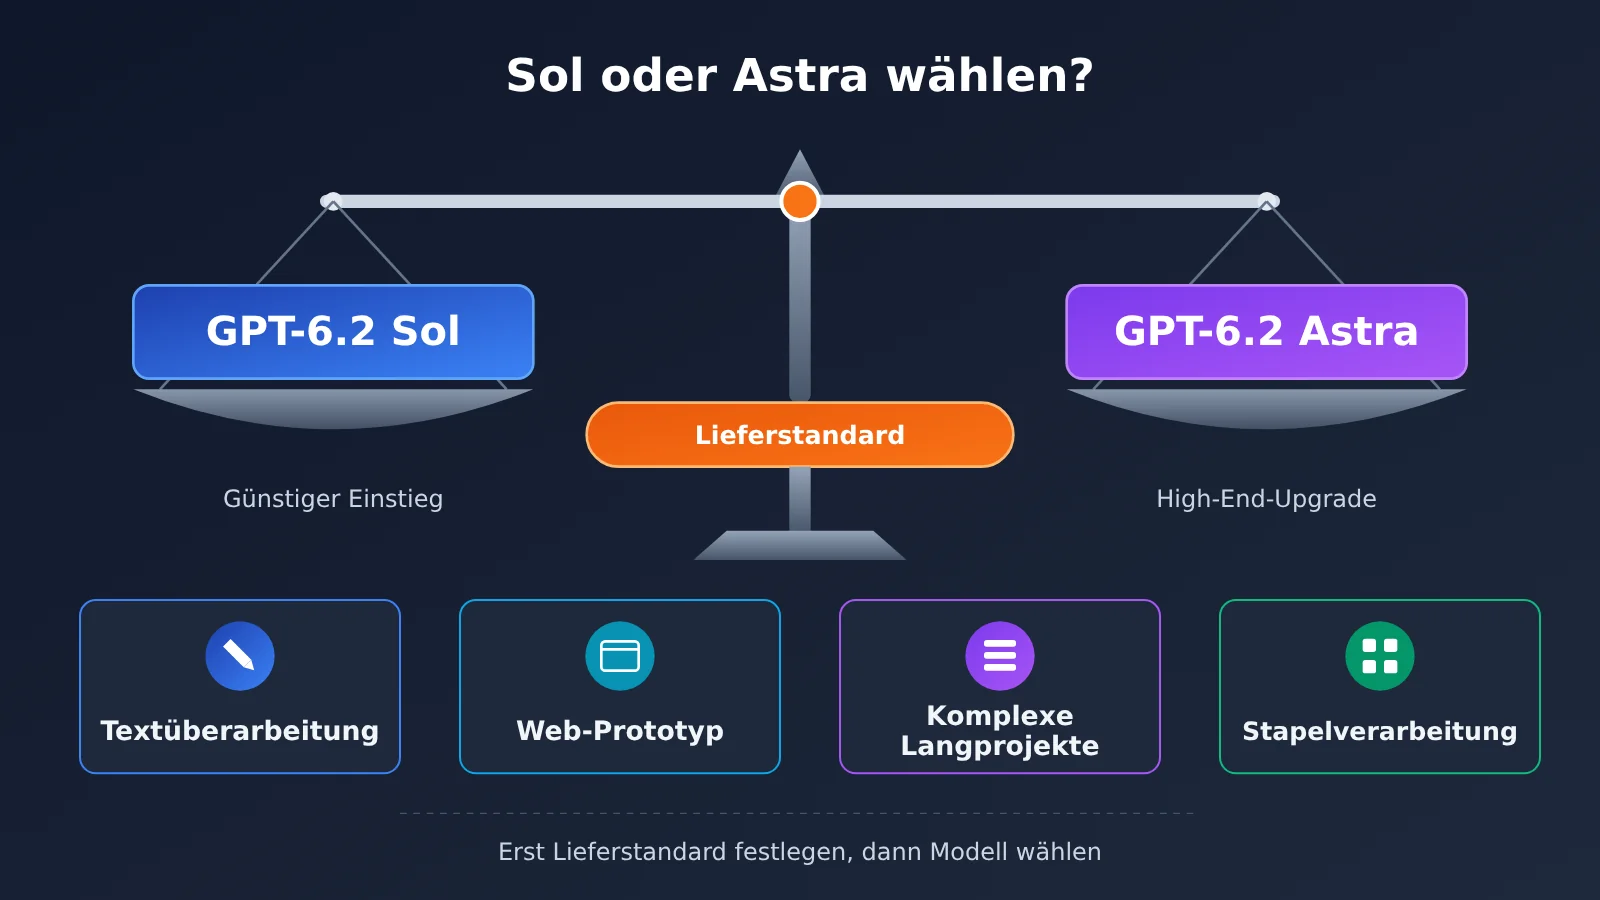
Direkte Antwort: Für die meisten alltäglichen Schreibaufgaben, Webprototypen und Stapelverarbeitungsjobs sollten Sie zunächst mit GPT-6.2 Sol starten. Erst wenn die Ergebnisse von Sol Ihren vorab definierten Lieferstandard nicht erreichen oder die Nacharbeitskosten bereits den Preisunterschied übersteigen, wechseln Sie zu GPT-6.2 Astra. Der offizielle API-Listenpreis der beiden Modelle unterscheidet sich um den Faktor 4. Die offiziellen Benchmarks zeigen, dass beide bei manchen Aufgaben nicht weit auseinanderliegen, doch diese Ergebnisse gelten nur für bestimmte Benchmarks und lassen sich nicht ohne Weiteres als allgemeingültige Schlussfolgerung verwenden. Entscheidend ist also nicht, welches Modell stärker ist, sondern wie hoch der Lieferstandard für Ihre Aufgabe sein muss.
Diese Empfehlung ist eine redaktionelle Einschätzung, keine offizielle Auswahlrichtlinie von OpenAI und auch kein Ergebnis unserer eigenen Tests. Alle im Artikel zitierten Benchmark-Daten stammen aus offiziellen OpenAI-Berichten.
Was Sie aus diesem Artikel mitnehmen
- Veröffentlichungsdatum, Zugangsumfang, Ein- und Ausgabefähigkeiten sowie offizieller API-Listenpreis von GPT-6.2 Sol und Astra.
- Welche Zahlen aus den offiziellen Benchmarks aussagekräftig sind und welche sich nicht verallgemeinern lassen.
- Mit welchem Modell Sie in den vier Szenarien „alltägliches Schreiben und Überarbeiten“, „Webprototypen“, „komplexe Langzeitprojekte“ und „budgetkritische Stapelverarbeitung“ beginnen sollten, wann ein Wechsel zu Astra sinnvoll ist und welche Schritte manuell geprüft werden müssen.
- Eine A/B-Test-Protokolltabelle, die Sie direkt kopieren können, um faktische Genauigkeit, Nutzbarkeit, Nacharbeitsrunden und Gesamtkosten zu vergleichen.
Index: Lesen Sie zuerst die Begriffstabelle „To Know“ und den Kurzüberblick über die Auswirkungen, um Begriffe und die Bedeutung dieser Veröffentlichung für verschiedene Zielgruppen schnell zu erfassen. Teil 1 fasst die objektiven Fakten zusammen, darunter Veröffentlichungsinformationen, offizielle Benchmarks und Preisregeln. Teil 2 enthält die redaktionelle Einschätzung mit einer Entscheidungstabelle nach Szenario, einer Methode zur Kostenschätzung und einem A/B-Testablauf; am Ende folgen die Quellenlinks.
Zur Einordnung: Wichtige Begriffe zu GPT-6.2 Sol und Astra
| Begriff | Kurze Erklärung |
|---|---|
| GPT-6.2 Astra | Ein höher positioniertes und teurer bepreistes Modell aus der GPT-6.2-Reihe, das OpenAI am 17. November 2026 veröffentlicht hat |
| GPT-6.2 Sol | Ein weiteres Modell, das am selben Tag erschien; der offizielle API-Listenpreis liegt bei etwa einem Viertel von Astra |
| GDPval v2 | Einer der Benchmarks im offiziellen OpenAI-Bericht; dieser Artikel zitiert nur die offiziell angegebenen Verbesserungswerte |
| ALE (Agents’ Last Exam) | Bewertet mehrstufige professionelle Arbeitsabläufe; die hier genannten Verbesserungswerte beziehen sich auf GPT-6 Astra als Basis und werden nicht mit GDPval v2 vermischt |
| FrontierCode 2.0 | Ein Programmier-Benchmark aus dem offiziellen Bericht; der in diesem Artikel zitierte Kostenvergleich gilt nur innerhalb dieses Tests |
| max-Reasoning-Stufe | Die höchste Stufe in den Einstellungen für die Inferenzintensität des Modells; bedeutet in der Regel mehr Denkleistung und höhere Kosten |
| Prozentpunkte | Die Differenz zwischen zwei Prozentwerten; von 50% auf 56.2% ist beispielsweise eine Verbesserung um 6.2 Prozentpunkte |
| Cache-Lesen | Wiederverwendete Eingabeinhalte werden nach einem Cache-Treffer zu einem niedrigeren Einzelpreis abgerechnet |
| Cache-Schreiben | Kosten für das Schreiben von Inhalten in den Cache; laut offizieller Angabe fallen dafür zusätzliche Gebühren an |
| 272K-Schwelle | Sobald die Eingabe einer einzelnen Anfrage etwa 272.000 Token überschreitet, wird die gesamte Anfrage mit einem höheren Multiplikator abgerechnet |
| Lieferstandard | Eine von der Redaktion vorgegebene Voraussetzung für die Auswahl: im Voraus klar festlegen, „ab welchem Qualitätsniveau die Ausgabe als verwendbar gilt“ |
GPT-6.2 Sol und Astra: Was sich dadurch ändert
- Normale ChatGPT-Nutzer: Laut offizieller Hilfe-Dokumentation richtet sich diese Runde schrittweise an ChatGPT Work und Codex; der normale Chat gehört nicht dazu. Kurzfristig dürfte sich also wenig ändern.
- Entwickler und kleine Teams: Beide Modelle werden nach und nach über die API freigegeben. Wegen des vierfachen Preisunterschieds pro Einheit wirkt sich die Modell-Routing-Strategie direkt auf die Rechnung aus – es lohnt sich, sie frühzeitig zu planen.
- Content-Creator: Die Eingabe besteht aus Text und Bildern, die Ausgabe aus Text. Eine native Videogenerierung gibt es nicht, Videotools lassen sich damit also nicht ersetzen.
- Kostenbewusste Batch-Nutzer: Die Multiplikator-Regel für lange Eingaben über 272K hat bei der Verarbeitung großer Mengen langer Dokumente erhebliche Auswirkungen auf die Kosten – wichtiger als der reine Preisvergleich pro Einheit.
1. Objektive Fakten zu GPT-6.2 Sol und Astra
Dieser Abschnitt fasst ausschließlich offiziell von OpenAI veröffentlichte Informationen zusammen und enthält keine redaktionelle Bewertung. Stand der Prüfung: 18. November 2026.
1.1 Veröffentlichung und Zugangsbereich von GPT-6.2 Sol und Astra
OpenAI hat am 17. November 2026 gleichzeitig GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Laut offizieller Beschreibung werden beide Modelle schrittweise für ChatGPT Work, Codex und die API freigegeben; der normale Chat ist in dieser Rollout-Runde nicht enthalten. „Schrittweise Freigabe“ bedeutet, dass verschiedene Konten zu unterschiedlichen Zeitpunkten Zugriff erhalten können – maßgeblich ist die offizielle Hilfe-Dokumentation.
Was die Fähigkeiten angeht, unterstützen beide Modelle Text- und Bildeingaben, die Ausgabe ist Text. Das offizielle Material erwähnt keine native Videogenerierung. Wenn Sie Videos erzeugen möchten, löst diese Veröffentlichung das nicht direkt.
1.2 Offizielle Benchmark-Daten zu GPT-6.2 Sol und Astra
Die folgende Tabelle fasst die Benchmark-Ergebnisse aus dem offiziellen Bericht zusammen. Beachten Sie: Jede Zeile ist eine eigenständige Bewertung mit einer anderen Vergleichsbaseline. Zahlen aus verschiedenen Zeilen dürfen nicht horizontal verglichen werden.
| Benchmark | Objekt | Ergebnis im offiziellen Bericht | Einschränkung |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | 6,2 Prozentpunkte besser als GPT-6 Astra, 22 % weniger Ausgabe-Token | Vergleichsbaseline ist die vorherige Astra-Generation |
| GDPval v2 | GPT-6.2 Sol | 5,3 Prozentpunkte besser als GPT-6.1 Sol | Vergleichsbaseline ist GPT-6.1 Sol, also nicht die Astra-Baseline |
| ALE | GPT-6.2 Astra | 5,2 Punkte besser als GPT-6 Astra | Die Einheit ist „Punkte“ und darf nicht mit den „Prozentpunkten“ von GDPval vermischt werden |
| FrontierCode 2.0 | Sol vs. Astra | Wenn beide auf der maximalen Inferenzstufe laufen, liegt die Differenz zwischen Sol und Astra innerhalb von 0,5 Punkten, bei etwa 1/5 der Aufgabenkosten von Astra | Gilt nur für diesen Test und diese Inferenzstufe, keine allgemeine Aussage zu Kosten |
Alle oben genannten Werte stammen aus dem offiziellen OpenAI-Bericht und sind keine eigenen Messergebnisse unseres Teams. Die Angabe, dass Astra 22 % weniger Ausgabe-Token erzeugt, bezieht sich auf den GDPval-v2-Kontext; ob sie sich auf Ihre konkrete Aufgabe übertragen lässt, müssen Sie selbst prüfen.
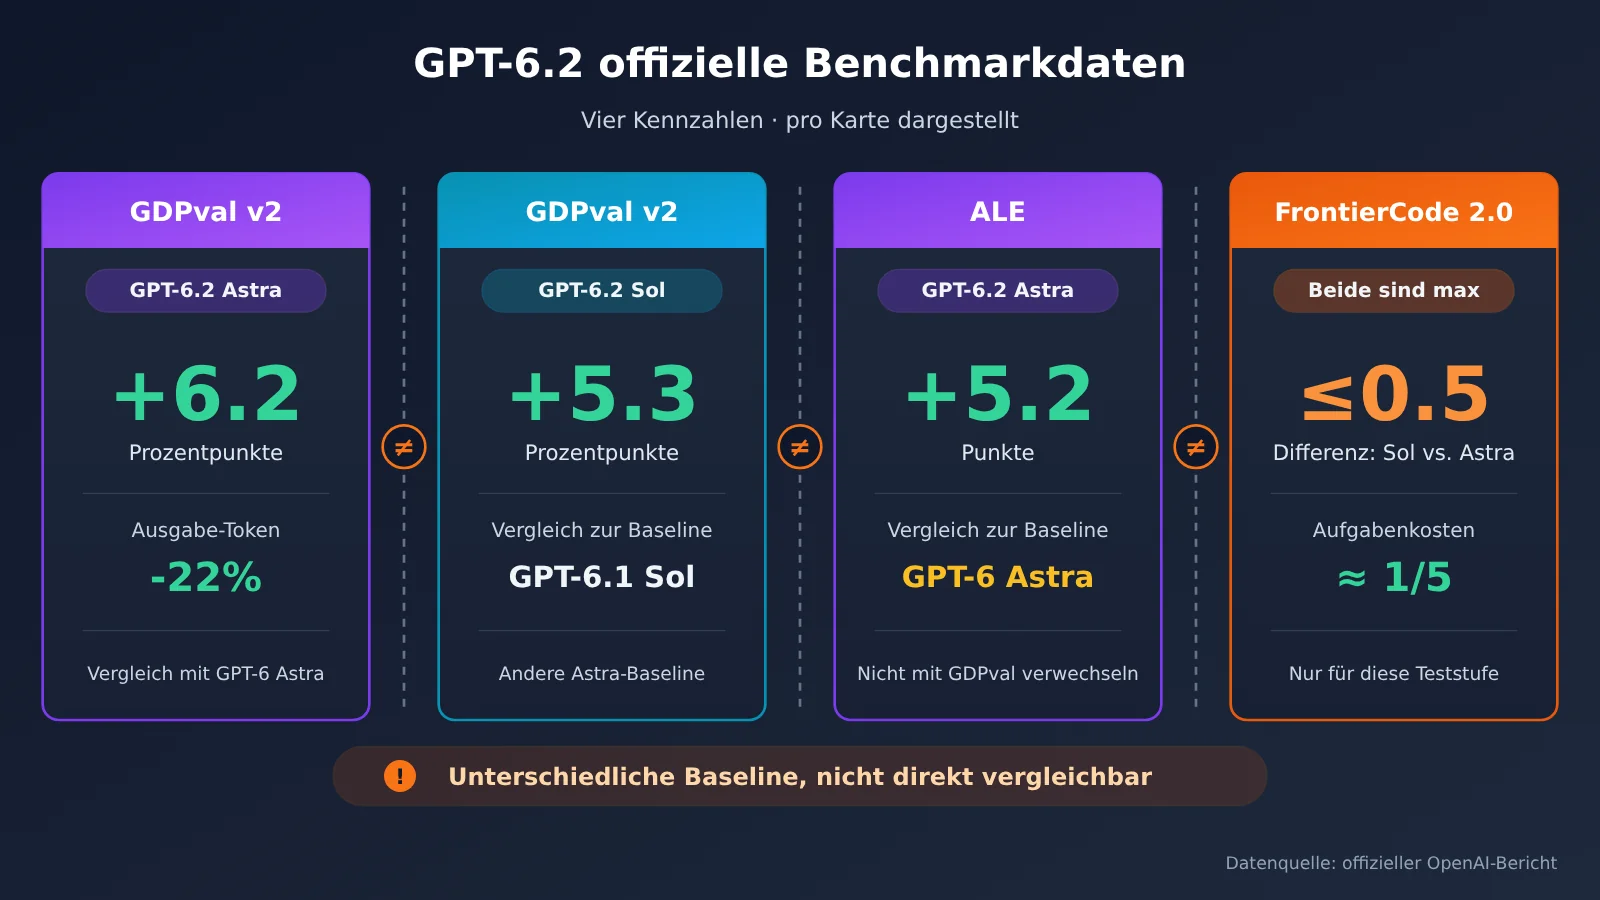
Die Grafik oben teilt die 4 Benchmarks in eigenständige Karten auf, damit Leser nicht versehentlich Zahlen mit unterschiedlichen Baselines miteinander vergleichen. Wenn Sie einen Abgleich mit Ihren eigenen Geschäftsdaten durchführen möchten, können Sie die Ergebnisse anhand der Vorlage aus Abschnitt 2.4 erfassen und dann über eine OpenAI-kompatible Schnittstelle wie APIYI apiyi.com die Modelle im selben Code-Setup austauschen.
1.3 Offizielle API-Preisregeln für GPT-6.2 Sol und Astra
Hier sind die offiziellen API-Standardpreise, angegeben in US-Dollar pro Million Token:
| Abrechnungsposten | GPT-6.2 Astra | GPT-6.2 Sol | Beschreibung |
|---|---|---|---|
| Nicht gecachte Eingabe | $8 | $2 | Sol ist 1/4 von Astra |
| Cache-Lesen | $0.4 | $0.1 | Eingabepreis nach einem Cache-Treffer |
| Ausgabe | $40 | $10 | Sol ist 1/4 von Astra |
| Cache-Schreiben | Wird separat berechnet | Wird separat berechnet | Maßgeblich ist die offizielle Modellseite |
| Eingabe über 272K | Eingabe- und Cache-Rate für die gesamte Anfrage ×2, Ausgabe ×1.5 | Wie links | Wird für die gesamte Anfrage berechnet, nicht nur für den überschrittenen Teil |
Besonders zu beachten ist die letzte Zeile. Nach Überschreiten der 272K-Schwelle wirkt der Multiplikator auf die gesamte Anfrage, nicht nur auf den Teil der Token, der die Schwelle überschreitet. Bei Aufgaben, in die eine große Menge langer Dokumente untergebracht werden muss, sollte man diese Regel separat im Budget berücksichtigen und nicht nur den Grundpreis betrachten.
💡 Preishinweis: Die obige Tabelle zeigt die Standardpreise der offiziellen OpenAI-API. Preise und Verfügbarkeit bei Drittanbieter-Plattformen müssen separat geprüft werden. Dieser Artikel hat die Verfügbarkeit dieser beiden Modelle auf APIYI apiyi.com nicht überprüft; maßgeblich ist die Modellliste der Plattform.
2. GPT-6.2 Sol und Astra: Wie man sie auswählt – die Einschätzung der Redaktion
Die folgenden Inhalte sind Schlussfolgerungen und Empfehlungen der Redaktion, die auf den Fakten aus Teil 1 basieren. Sie geben nicht die offizielle Auffassung von OpenAI wieder und wurden auch nicht durch eigene Tests unsererseits verifiziert.
2.1 Erst den Lieferstandard definieren, dann GPT-6.2 Sol oder Astra wählen
Viele stellen bei der Modellauswahl zuerst die Frage: „Welches ist stärker?“ Doch die offiziellen Daten von FrontierCode 2.0 legen einen anderen Blickwinkel nahe: In diesem Test lagen Sol und Astra bei maximaler Inferenzstufe weniger als 0,5 Punkte auseinander, während die Aufgabenkosten nur rund ein Fünftel betrugen. Selbst wenn sich diese Schlussfolgerung nicht verallgemeinern lässt, reicht sie doch aus, um zu zeigen, dass der Nutzen von „stärker“ möglicherweise gering ist, während die Kostendifferenz groß sein kann.
Deshalb empfiehlt die Redaktion, vor der Modellauswahl drei Fragen zu beantworten: Wer verwendet dieses Ergebnis? Wie groß ist der Preis eines Fehlers? Wie viele Runden Nacharbeit sind maximal akzeptabel? Je klarer die Antworten, desto leichter lässt sich beurteilen, ob Sol bereits ausreicht. Wenn der Lieferstandard unklar formuliert ist, dann wiederholt man mit einem Wechsel zu Astra nur das Ausprobieren auf teurere Weise.
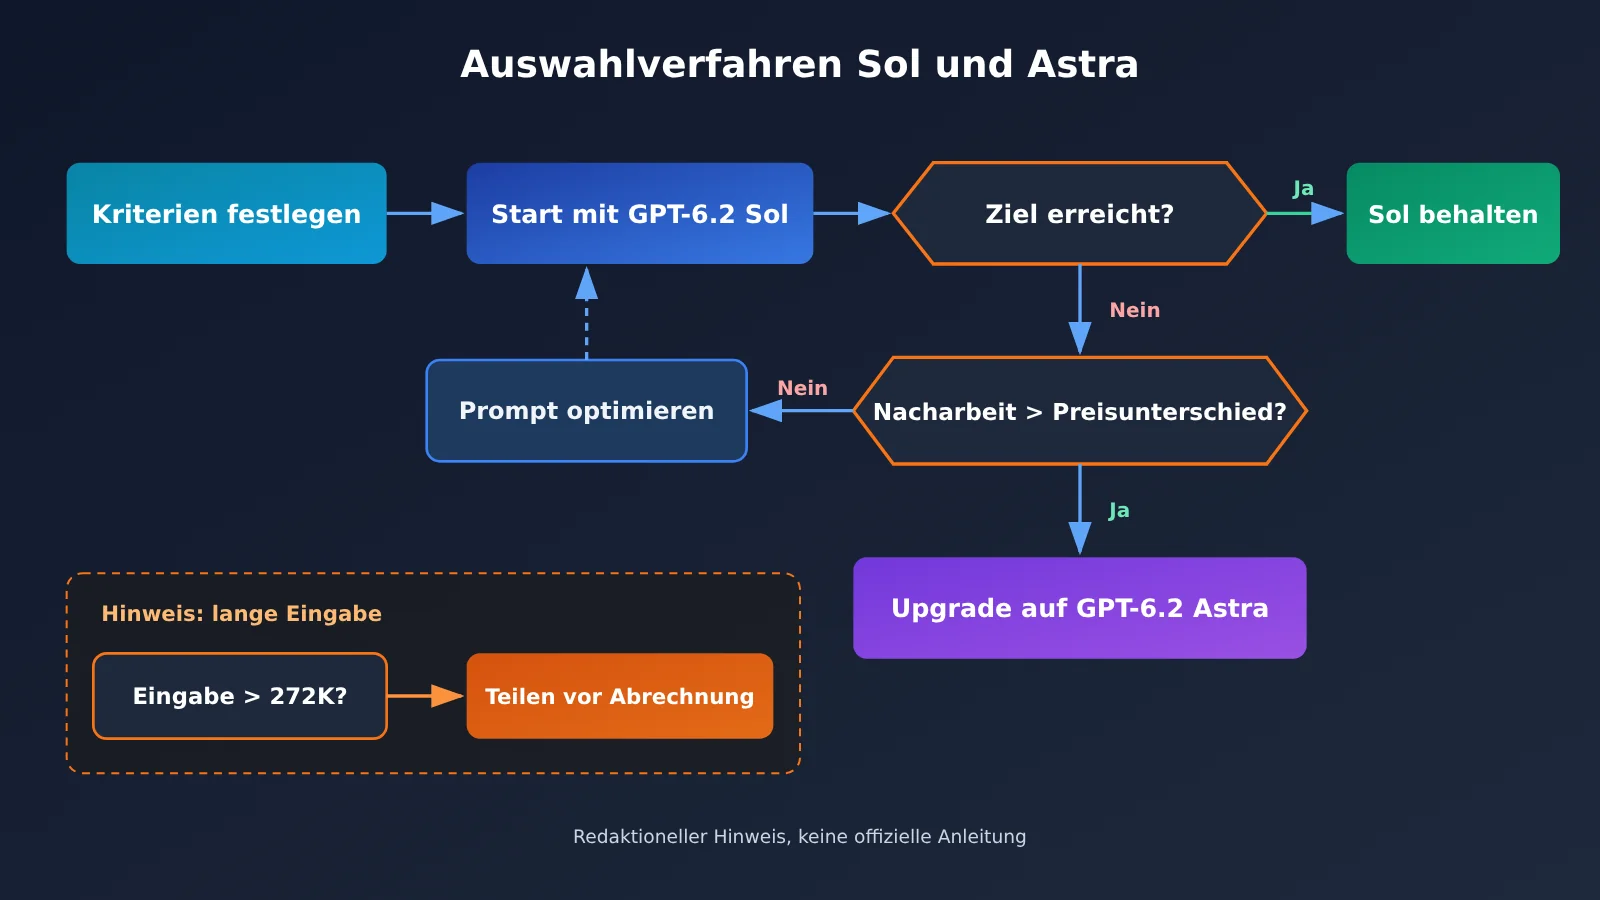
2.2 Entscheidungstabelle für vier Szenarioklassen: GPT-6.2 Sol und Astra
Die folgende Tabelle ist eine redaktionelle Empfehlung, keine offizielle Vorgabe. „Auslöser für ein Upgrade“ bedeutet: In diesen Fällen lohnt es sich, Astra auszuprobieren. „Manuelle Prüfpunkte“ sind Schritte, die unabhängig vom gewählten Modell nicht entfallen dürfen.
| Szenario | Startmodell | Auslöser für ein Upgrade auf Astra | Zwingend manuell zu prüfen |
|---|---|---|---|
| Alltägliches Schreiben und Überarbeiten | GPT-6.2 Sol | Nach 2–3 Runden werden Ton oder Struktur noch immer nicht getroffen; lange Texte mit strenger Argumentation müssen bearbeitet werden | Fakten, Daten, Zitate und Namen; ob die ursprüngliche Bedeutung eigenmächtig verändert wurde |
| Webprototyp | GPT-6.2 Sol | Die Interaktionslogik erstreckt sich über mehrere Seiten, und im von Sol erzeugten Code treten wiederholt Zustandsfehler auf; eine hochgetreue Umsetzung anhand von Designentwurfsbildern ist erforderlich | Tatsächlicher Lauf im Browser; Formularvalidierung, Anpassung an Mobilgeräte; ob die Abhängigkeitspakete tatsächlich existieren |
| Komplexes Langzeitprojekt | Abhängig vom Abgabestandard; Astra kann direkt getestet werden | Lange Aufgabenketten und viele Kontextabhängigkeiten: Ein Fehler an einer Stelle führt zu umfangreichen Nacharbeiten in nachgelagerten Schritten | Wichtige Entscheidungspunkte, dateiübergreifende Konsistenz, Testabdeckung |
| Budgetempfindliche Stapelverarbeitung | GPT-6.2 Sol | Die Fehlerquote in der Stichprobe überschreitet den von Ihnen festgelegten Schwellenwert, und die Korrektur in der Nachbearbeitung ist teurer | Proportionale Stichprobenprüfung; ob eine einzelne Eingabe 272K überschreitet; Cache-Trefferquote |
In alltäglichen Schreib- und Überarbeitungsszenarien liegt die Schwierigkeit meist in faktischer Genauigkeit und passendem Stil, nicht in der Argumentationstiefe. Sol ist als Startmodell wirtschaftlicher, aber unabhängig vom Modell müssen Daten und Zitate manuell geprüft werden.
Im Webprototyp-Szenario ist „läuft“ ein hartes Kriterium und lässt sich objektiv beurteilen. Ob Sol ausreicht, lässt sich nur durch tatsächliches Ausführen beurteilen; dabei sind Kerninteraktionen, Fehlerzustände und die Anpassung an Mobilgeräte zu prüfen. Die Entscheidung über ein Upgrade darf nicht allein auf einem erfolgreichen Lauf beruhen.
Komplexe Langzeitprojekte sind das Szenario, bei dem am ehesten direkt Astra in Betracht kommt. Die im offiziellen Bericht genannten 22 % weniger Ausgabe-Token beziehen sich auf den älteren GPT-6 Astra als Vergleichsbasis; daraus lassen sich keine Einsparungen gegenüber GPT-6.2 Sol ableiten. Die Gesamtkosten der Aufgaben beider neuer Modelle müssen unter gleichen Abgabestandards selbst verifiziert werden. Bei budgetempfindlicher Stapelverarbeitung sollte vorrangig die Länge einzelner Eingaben begrenzt werden, um den 272K-Multiplikator nicht auszulösen.
2.3 Methodik zur Kostenschätzung für GPT-6.2 Sol und Astra
Hier eine beispielhafte Berechnung auf Basis der offiziellen Standardpreise, um den Einfluss der Abrechnungsregeln zu veranschaulichen; sie repräsentiert keinen realen Verbrauch irgendeiner Aufgabe. Angenommen, eine einzelne Anfrage umfasst 50K Token Eingabe (ohne Cache) und 5K Token Ausgabe:
- Sol: 0.05 × $2 + 0.005 × $10 = $0.15
- Astra: 0.05 × $8 + 0.005 × $40 = $0.60
Erhöht man die Eingabe auf 300K Token und die Ausgabe auf 10K Token, wird der 272K-Multiplikator ausgelöst:
- Sol: 0.3 × $4 + 0.01 × $15 = $1.35
- Astra: 0.3 × $16 + 0.01 × $60 = $5.40
Aus diesem Beispiel lassen sich zwei Punkte ablesen. Erstens bleibt der Preisunterschied bei gleichem Token-Verbrauch konstant bei etwa Faktor 4. Zweitens steigen die Kosten pro Anfrage deutlich, sobald 272K überschritten werden. Bei Batch-Aufgaben kann das Aufteilen langer Dokumente unterhalb der Schwelle die Zusatzkosten für langen Kontext senken, aber die Nettoeinsparung hängt von wiederholtem Kontext, zusätzlichen Anfragen und Qualitätsverlusten ab. Man sollte nicht voraussetzen, dass dies günstiger ist als ein Modellwechsel.
Die tatsächlichen Kosten hängen außerdem von der realen Ausgabelänge und der Anzahl der Überarbeitungsrunden ab. Wenn Sol durchschnittlich 3 Runden benötigt, um die Anforderungen zu erfüllen, während Astra bereits nach 1 Runde fertig ist, verringert sich der Unterschied in der Endabrechnung. Deshalb wird in Abschnitt 2.4 empfohlen, die „Anzahl der Überarbeitungsrunden“ zu protokollieren.
Der folgende Code dient nur als Integrationsbeispiel und wurde in diesem Artikel nicht praktisch getestet. Die Ausgabe des A/B-Skripts ist eine Schätzung der äquivalenten Kosten zum offiziellen Standardpreis ohne Cache und bei einer Eingabe von höchstens 272K; es handelt sich nicht um eine tatsächliche Rechnung eines Drittanbieters. Gebühren von Drittanbietern sollten nach deren tatsächlichen Tarifen berechnet werden.
Der folgende Beispielcode zeigt, wie sich Modelle innerhalb derselben Codebasis umschalten lassen. Die Modell-IDs orientieren sich an der Benennung auf der offiziellen Modellseite; maßgeblich ist die tatsächliche Modellliste der Plattform, die du verwendest:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI: OpenAI-kompatible Schnittstelle; Modellverfügbarkeit gemäß Plattformliste
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # Bei einem Upgrade auf "gpt-6.2-astra" ändern
    messages=[{"role": "user", "content": "按以下交付标准改写这段文案:……"}]
)
print(response.choices[0].message.content)
print(response.usage)  # Token-Verbrauch erfassen, um die Gesamtkosten zu berechnen
A/B-Vergleichsskript ansehen (gleiche Aufgabe mit zwei Modellen ausführen und Verbrauch protokollieren)
import openai

PRICES = {  # Äquivalente Schätzung zum offiziellen Standardpreis, keine tatsächliche Abrechnung durch Dritte; gilt nur für Anfragen mit ≤272K und ohne Cache
    "gpt-6.2-sol":   {"input": 2.0, "output": 10.0},
    "gpt-6.2-astra": {"input": 8.0, "output": 40.0},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Modelle über die einheitliche Schnittstelle von APIYI wechseln
)

def run_once(model: str, prompt: str) -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    if u.prompt_tokens > 272000 or cached:
        raise ValueError("此简化估算仅适用于输入≤272K且无缓存的请求")
    p = PRICES[model]
    cost = u.prompt_tokens / 1e6 * p["input"] + u.completion_tokens / 1e6 * p["output"]
    return {
        "model": model,
        "output": resp.choices[0].message.content,
        "input_tokens": u.prompt_tokens,
        "output_tokens": u.completion_tokens,
        "official_standard_equivalent_usd": round(cost, 4),
    }

task = "在这里放同一个任务的完整提示词和交付标准"
for m in PRICES:
    r = run_once(m, task)
    print(r["model"], r["input_tokens"], r["output_tokens"], r["official_standard_equivalent_usd"])
🚀 Tipp für den Einstieg: Der Kern eines A/B-Tests ist „gleiche Aufgabe, gleiche Eingabeaufforderung, gleicher Abgabestandard“. Bei einer OpenAI-kompatiblen Schnittstelle wie APIYI apiyi.com müssen Sie nur den Parameter
modeländern, um das Modell zu wechseln – das erleichtert die Kontrolle der Variablen. Prüfen Sie vor dem Livegang, ob das Zielmodell in der Modellliste der Plattform aufgeführt ist.
2.4 A/B-Test-Protokollvorlage für GPT-6.2 Sol und Astra
Hier finden Sie eine leere Vorlage – tragen Sie Ihre eigenen Testergebnisse ein. Es empfiehlt sich, pro Szenario mindestens 3–5 repräsentative Aufgaben auszuwählen und einzeln zu dokumentieren. Ziehen Sie keine voreiligen Schlüsse aus einem einzigen Ergebnis.
| Prüfdimension | Erfassungsmethode | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| Faktische Genauigkeit | Daten, Zitate und Namen Punkt für Punkt prüfen und die Fehleranzahl notieren | ||
| Verwendbarkeit | Wird der zuvor festgelegte Abgabestandard erreicht (Ja / Nein / Teilweise) | ||
| Anzahl der Nacharbeitsrunden | Wie viele Runden von der ersten Erstellung bis zum Erreichen des Standards nötig waren | ||
| Eingabe-/Ausgabe-Token | Über alle Runden kumuliert; beachten Sie, ob 272K überschritten werden | ||
| Gesamtkosten | Auf Basis der kumulierten Token aller Runden berechnet, einschließlich der Nacharbeitsrunden | ||
| Manueller Zeitaufwand | Minuten, die für Prüfung und Korrektur aufgewendet wurden | ||
| Fazit | Welches Modell künftig standardmäßig für diese Aufgabe verwendet wird |
Beim Ausfüllen empfiehlt es sich, „Gesamtkosten“ und „manuellen Zeitaufwand“ gemeinsam zu betrachten. Wenn der durch Astra eingesparte Zeitaufwand den zusätzlichen API-Aufwand übersteigt, ist ein Upgrade sinnvoll. Andernfalls sollten Sie bei Sol bleiben und Ihre Energie in die Optimierung der Eingabeaufforderungen und Abgabestandards stecken.
2.5 Wie kleine Teams das Routing für GPT-6.2 Sol und Astra gestalten
Für kleine Teams empfiehlt die Redaktion ein Routing nach dem Prinzip „Sol als Standard, Astra bei Bedarf hochstufen“. Konkret lassen sich die Auslösebedingungen aus der Tabelle in Abschnitt 2.2 direkt in den Workflow schreiben: Wenn etwa eine bestimmte Aufgabenklasse mehr als die festgelegte Zahl an Nacharbeitsrunden erfordert, wird automatisch auf Astra umgeschaltet und neu generiert – der Grund wird im Log festgehalten. Nach einer Weile hast du so eine Auswahlgrundlage, die auf deinen eigenen Geschäftsdaten basiert und verlässlicher ist als jede allgemeine Benchmark.
Ein solches Routing braucht eine Zugriffsschicht, über die sich Modelle bequem wechseln lassen. APIYI apiyi.com bietet eine OpenAI-kompatible Schnittstelle: Mit einem einzigen API-Schlüssel lassen sich mehrere gängige Modelle aufrufen – ideal, um ein solches Routing aufzubauen. Bevor die GPT-6.2-Serie jedoch offiziell in der Modellliste der Plattform auftaucht, solltest du den Ablauf erst einmal mit den vorhandenen Modellen zum Laufen bringen.
Einen Punkt solltest du dabei weiter im Auge behalten: Beide Modelle befinden sich in einer schrittweisen Freigabephase, offizielle Preise, der Umfang der Verfügbarkeit und die Informationen auf den Modellseiten können sich also ändern. Die folgenden Einschätzungen sind Prognosen: Mit dem Auftauchen weiterer Benchmarks von Drittanbietern werden die Unterschiede zwischen Sol und Astra bei konkreten Aufgaben feiner ausfallen, als es die offiziellen Berichte zeigen. Dann ist deine eigene A/B-Tabelle aussagekräftiger als jede einzelne Benchmark-Punktzahl.
Referenzen
- Offizielle OpenAI-Ankündigungsseite: Versionshinweise und offizielle Benchmarks zu GPT-6.2 Astra und Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Hinweis: Die in diesem Artikel genannten Werte für GDPval v2, ALE und FrontierCode 2.0 stammen alle von dieser Seite
- Link:
- OpenAI Help Center: Erläuterungen zur Verfügbarkeit von ChatGPT Work und Codex
- Link:
help.openai.com/en/articles/20001275-chatgpt-work-and-codex - Hinweis: Informationen zum Rollout-Umfang und zur schrittweisen Freigabe
- Link:
- Modellinformationen zu GPT-6.2 Astra: offizielle API-Modellseite
- Link:
developers.openai.com/api/docs/models/gpt-6.2-astra - Hinweis: Preise, Caching und Abrechnungsregeln für lange Kontextfenster
- Link:
- Modellinformationen zu GPT-6.2 Sol: offizielle API-Modellseite
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Hinweis: Preise, Caching und Abrechnungsregeln für lange Kontextfenster
- Link:
Modelle werden laufend weiterentwickelt. Verlässlicher ist es, zuerst die Abnahmekriterien klar zu formulieren und dann dieselbe Aufgabe für den Vergleich zu verwenden. Wenn Sie mehrere Modelle innerhalb einer Codebasis vergleichen möchten, können Sie sie über APIYI apiyi.com anbinden und die Ergebnisse anschließend nach der Vorlage in diesem Artikel dokumentieren.
Wer vorausschauend plant, steht auf festem Grund; wer nicht vorausschauend plant, scheitert. — Buch der Riten, Kapitel „Das rechte Maß“
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com