Hinweis des Autors: Dieser Artikel beantwortet eine konkrete Frage – ist deepseek-v4-1-flash-economy-261017 das schlechtere Modell? Das Fazit: Nein. Es verwendet dieselben Gewichte wie deepseek-v4.1-flash, ist nur langsamer und günstiger.
Nachdem DeepSeek V4.1 Flash in zwei Preistarife aufgeteilt wurde, stehen Entwickler, die dieses Modell bereits einsetzen, vor einer Entscheidung, an der sie nicht vorbeikommen: Welcher Wert gehört nun in das model-Feld der Anfrage? Dieser Artikel vergleicht deepseek-v4-1-flash-economy-261017 mit deepseek-v4.1-flash und gibt aus vier Blickwinkeln – Preis, Endpunkt, Gruppe und Geschwindigkeit – eine klare Empfehlung.
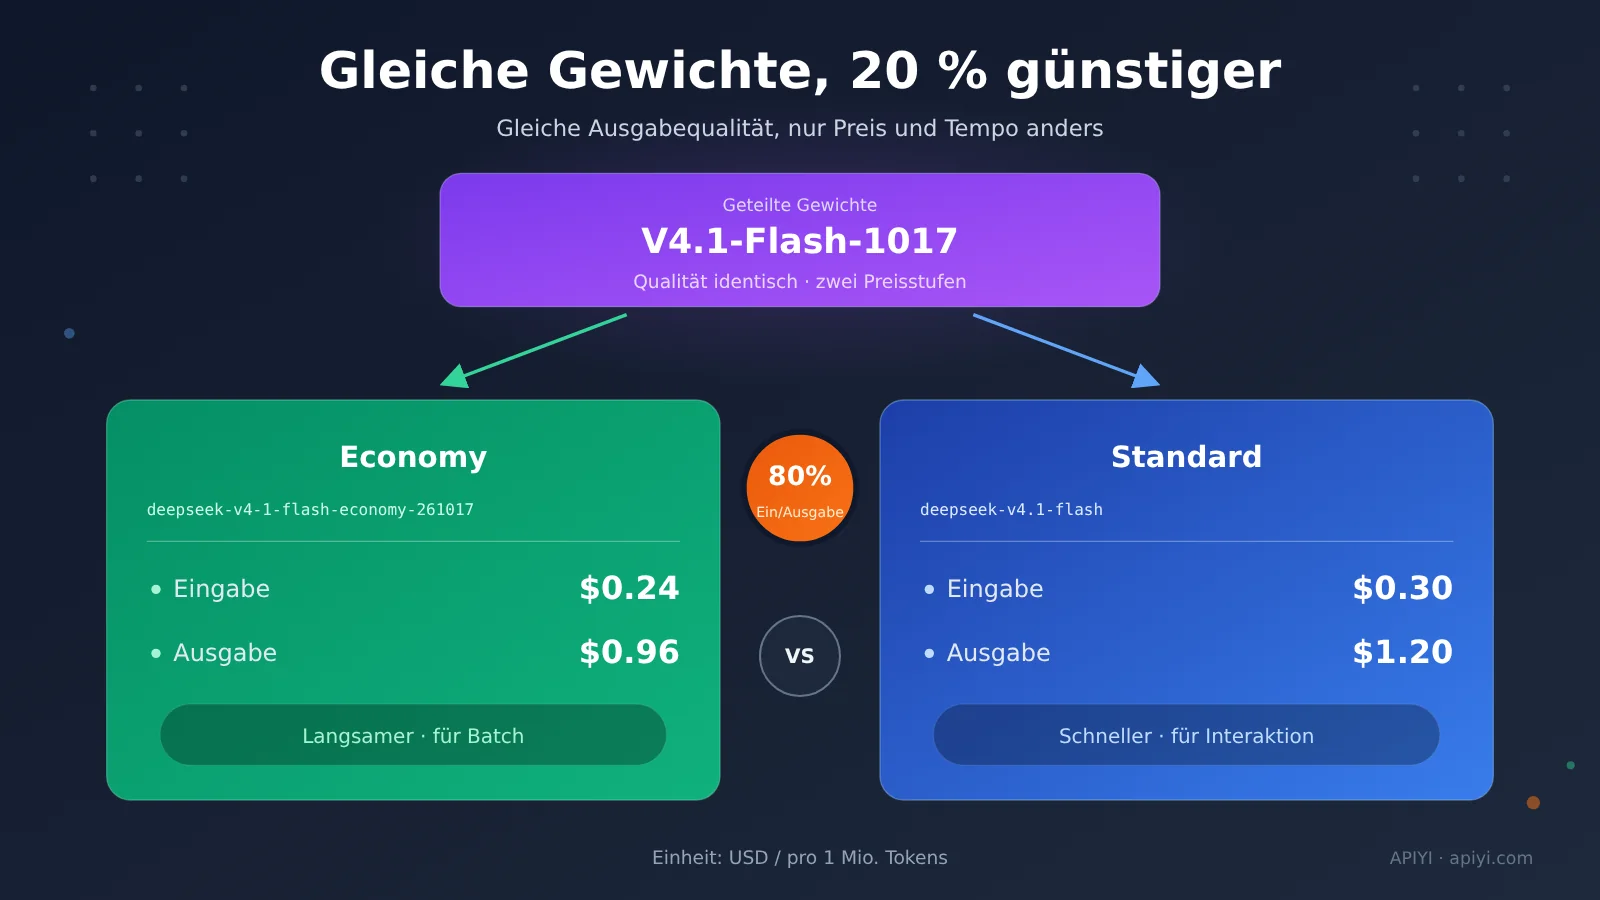
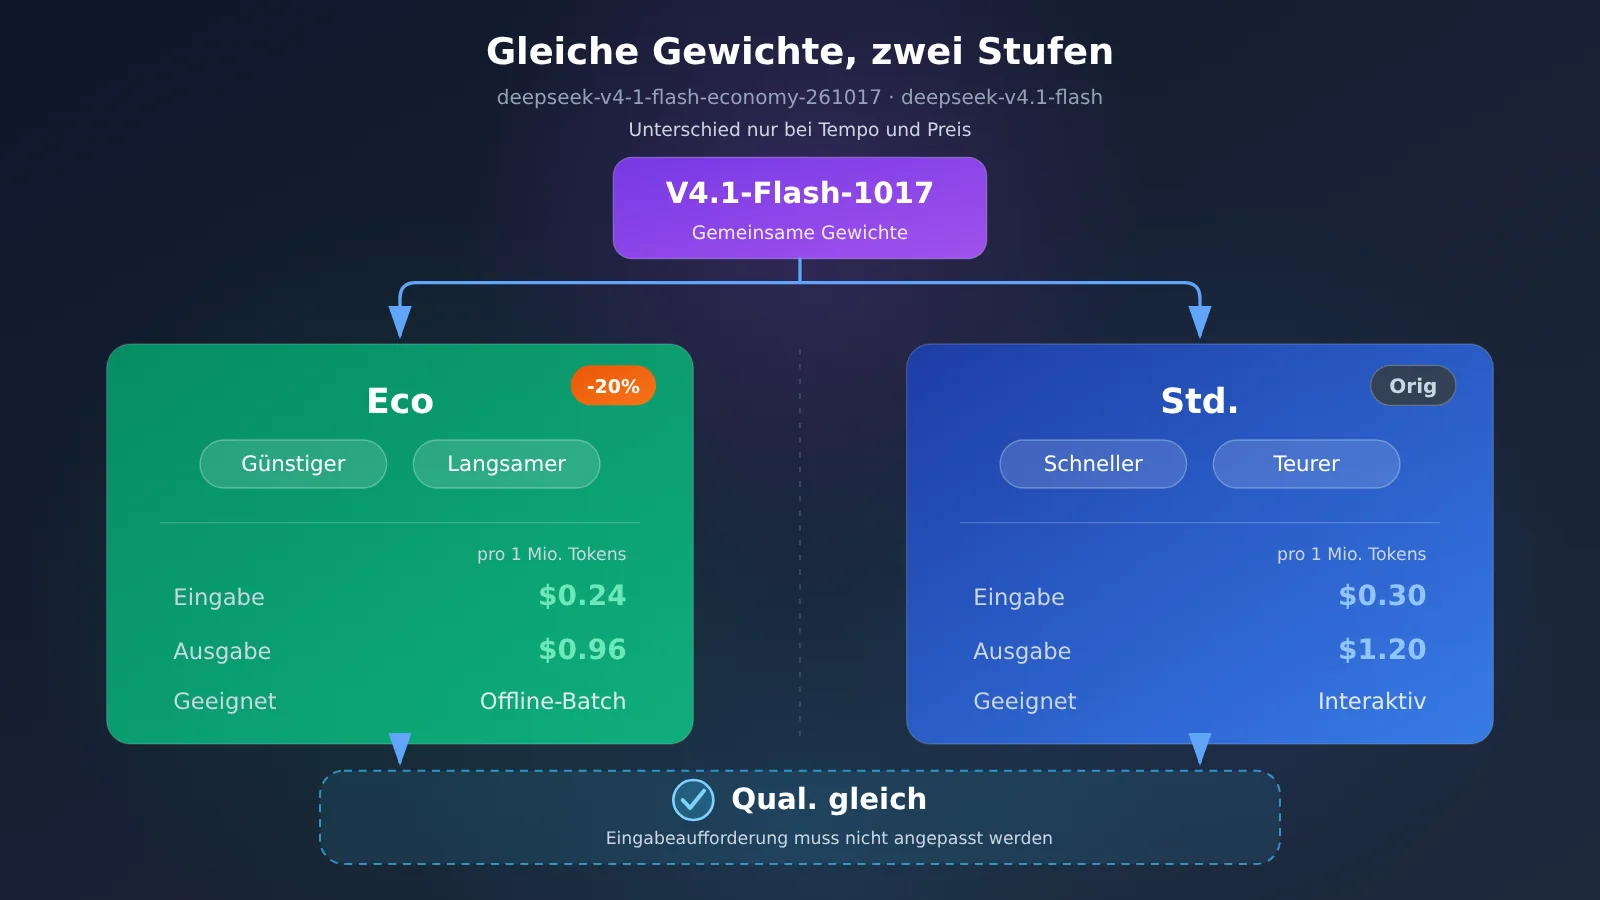
Das Fazit vorweg: Die Economy-Version ist kein schlechteres Modell. Beide IDs laden dieselben V4.1-Flash-1017-Gewichte, und laut offizieller Angabe ist die Ausgabequalität identisch. Unterschiede gibt es nur an zwei Stellen – die Generierung ist langsamer, und der Stückpreis für Input und Output liegt bei 80 % des Standardtarifs. Das ist kein Test eines neuen Modells und auch keine abgespeckte Variante, sondern ein und dieselben Gewichte in zwei Preistarifen.
Der praktische Nutzen: Nach diesem Artikel weißt du genau, welchen ID du in welchem Szenario wählst – etwa bei Batch-Offline-Jobs, in interaktiven Produkten oder in Workflows im Anthropic-Format. Beide Varianten sind bereits bei APIYI (apiyi.com) verfügbar; für den Wechsel reicht es, einen einzigen String zu ändern.
Was ist deepseek-v4-1-flash-economy-261017
Die Economy-Variante ging am 2026-11-11 um 12:22 Uhr (UTC+8) live; als dieser Artikel geprüft wurde (2026-11-13), war sie gerade einmal zwei Tage alt. Ihre Positionierung lässt sich in einem Satz zusammenfassen: dieselben V4.1-Flash-1017-Gewichte, ein niedrigerer Preis pro Input- und Output-Token, eine langsamere Generierung. Sie ist weder eine destillierte noch eine quantisierte Version – APIYI stellt über den offiziellen BytePlus-Kanal die vollständigen 552B-Gewichte bereit, ohne Quantisierung, ohne Destillation; abgerechnet wird in der Peak-Price-Stufe.
Derzeit gibt es für die Economy-Variante keine eigene Modell-Detailseite und keine Erklärungsseite; die entscheidenden Parameter richten sich nach dem Launch-Dokument. Die Preise wurden sowohl gegen die offizielle Modellliste als auch gegen die Preis-Schnittstelle von apiyi.com geprüft – beide stimmen überein. Damit du nicht durch die Dokumentation scrollen musst, sind die Kernpunkte zuerst in einer Tabelle zusammengefasst:
| Punkt | Erläuterung | Bedeutung für dich |
|---|---|---|
| Dieselben Gewichte | Teilt V4.1-Flash-1017 mit deepseek-v4.1-flash |
Ausgabequalität laut offizieller Angabe identisch, Eingabeaufforderungen müssen nicht neu abgestimmt werden |
| 20 % Rabatt auf Input und Output | Input $0.24, Output $0.96 (pro 1 Million Tokens) | Bei Batch-Aufgaben sinken die Kosten direkt um ein Fünftel |
| Langsamere Generierung | Laut Dokumentation ca. 2 Sekunden bis zum ersten Token, ca. 15 Millisekunden pro Token | Geeignet für Offline-Batchverarbeitung, ungeeignet für stark interaktive Nutzung |
| Weniger Endpunkte | Nur der Chat-Endpunkt, Gruppen Default und SVIP | Über die OpenAI-kompatible Schnittstelle sofort nutzbar |
Warum deepseek-v4-1-flash-economy-261017 eine eigene Modell-ID verdient
Weil hier direkt Kosten gespart werden – und man keine Qualitätseinbußen absichern muss. Bei Batch-Aufgaben macht die Token-Gebühr für Input und Output den größten Teil der Rechnung aus; 20 % Nachlass heißt, dass sich mit demselben Budget rund ein Viertel mehr Volumen bewältigen lässt. Da Gewichte und Ausgabequalität unverändert bleiben, ist der einzige Preis die Wartezeit – damit verschiebt sich die Frage von „Soll ich wechseln?“ zu „Kann meine Aufgabe so lange warten?“ Genau diesen Unterschied nimmt der nächste Abschnitt auseinander.
Zentrale Unterschiede zwischen deepseek-v4-1-flash-economy-261017 und deepseek-v4.1-flash
Die Unterschiede zwischen den beiden Versionen konzentrieren sich auf drei Bereiche: Preis, Endpunkt und Gruppierung sowie Geschwindigkeit. Modellgewichte und Qualität stehen nicht auf dieser Unterschiedsliste – beide Versionen nutzen ohnehin gemeinsam V4.1-Flash-1017.
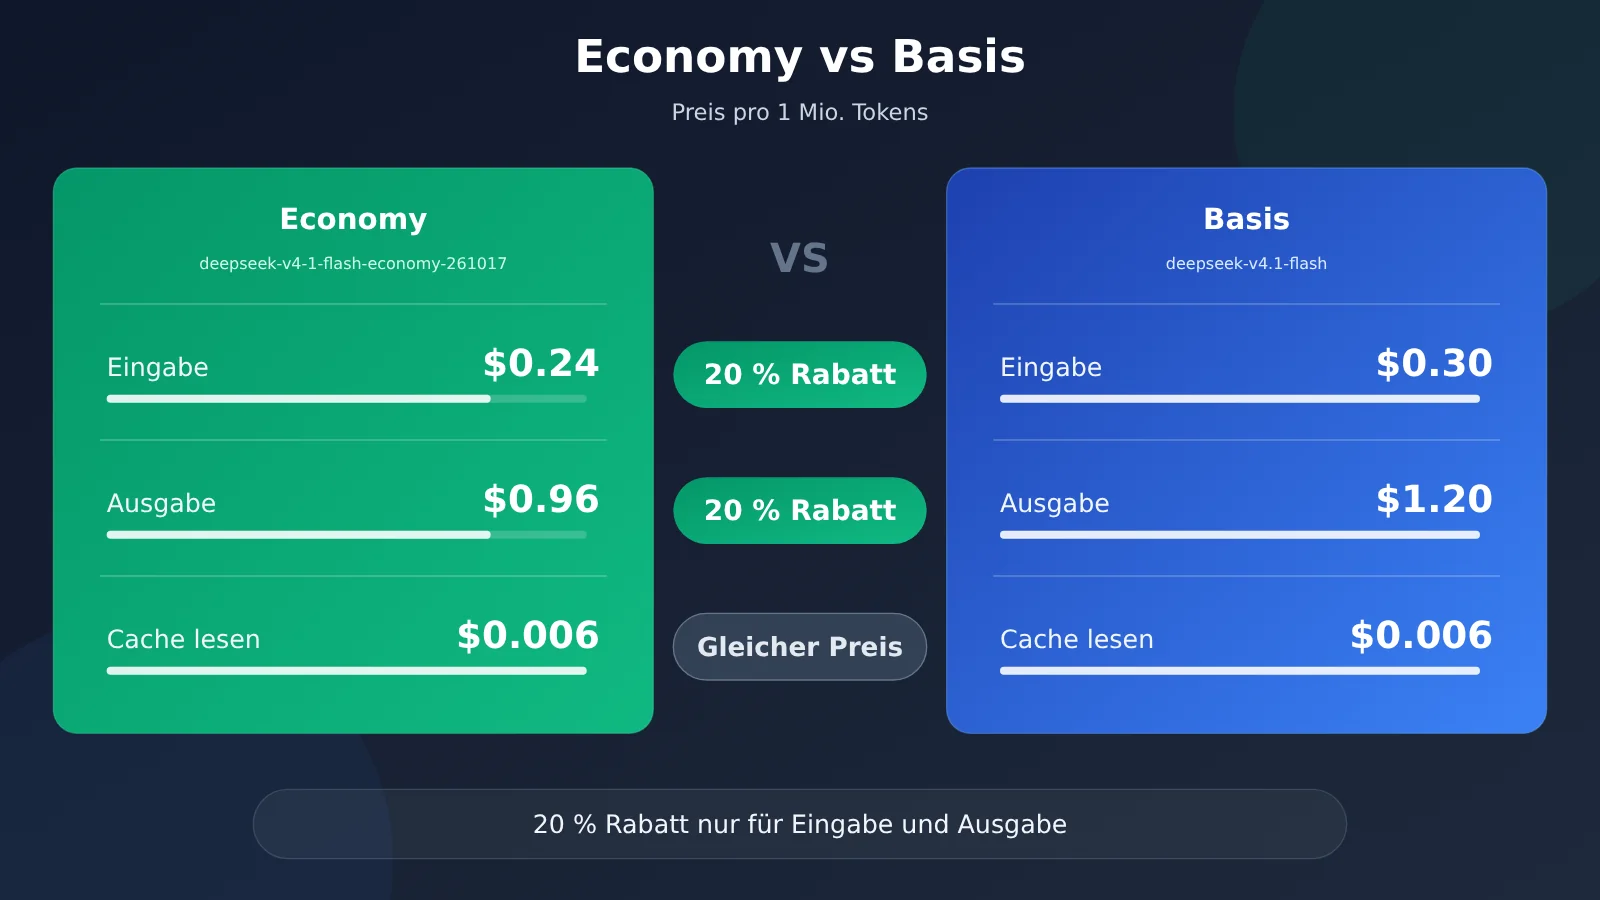
Preisunterschied: 20 % Rabatt auf Eingabe und Ausgabe, gleicher Preis beim Cache-Lesen
| Abrechnungsposten (pro 1 Mio. Tokens) | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash | Rabatt |
|---|---|---|---|
| Eingabe | $0.24 | $0.30 | 20 % Rabatt |
| Ausgabe | $0.96 | $1.20 | 20 % Rabatt |
| Cache-Lesen | $0.006 | $0.006 | Gleicher Preis |
0.24 geteilt durch 0.30 ergibt 0.8; 0.96 geteilt durch 1.20 ebenfalls 0.8. Der Rabatt von 20 % gilt also nur für die beiden Abrechnungsposten Eingabe und Ausgabe der Economy-Version gegenüber der Standardversion; das Cache-Lesen kostet in beiden Versionen gleich $0.006 und ist nicht rabattiert. Wenn Ihre Aufgaben eine hohe Cache-Trefferrate haben, gibt es bei diesen Kosten keinen Unterschied zwischen den Versionen, wodurch sich die insgesamt erzielte Ersparnis verringert. Bei der Kostenkalkulation sollten Sie das Cache-Lesen daher separat berechnen.
Ein weiterer leicht zu verwechselnder Punkt sollte klargestellt werden: Dieser Rabatt von 20 % ist ein fester Unterschied zwischen den Listenpreisen der beiden Modelle und keine zeitlich begrenzte Aktion. Die Konto-Vorteile bei APIYI laufen über eine Aufladung mit Bonus; das Bonusguthaben ändert nichts an den in der Tabelle genannten Stückpreisen. Die Abrechnung erfolgt nach der Peak-Preisstufe und schwankt nicht durch Aktionen.
💰 Kostentipp: Bei Batch-Aufgaben können Sie
reasoning_effortaufnonesetzen, um das Nachdenken abzuschalten, und zusätzlich den 20-%-Rabatt der Economy-Version auf Eingabe und Ausgabe nutzen – so sparen Sie bei beidem. Wenn Sie erst rechnen und dann loslegen möchten, können Sie auf APIYI apiyi.com die Stückpreise der beiden Modelle gegenüberstellen und eine Kostensimulation durchführen.
Endpunktunterschied: deepseek-v4-1-flash-economy-261017 bietet nur Chat
Das ist der einzige harte Unterschied zwischen den beiden Versionen auf der Ebene der grundsätzlichen Nutzbarkeit. Die Economy-Version öffnet ausschließlich den Chat-Endpunkt; als Gruppen stehen nur Default und SVIP zur Verfügung. Die Standardversion kann neben Chat auch das Anthropic-Format nutzen und bietet zusätzlich die Gruppen ClaudeCode und CodexResponses.
| Dimension | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash |
|---|---|---|
| Endpunkt | Chat | Chat, Anthropic-Format |
| Gruppe | Default, SVIP | Default, SVIP, ClaudeCode, CodexResponses |
Auf Workflows übertragen bedeutet das: Wenn ein Client Anfragen im Anthropic-Nachrichtenformat zusammenstellt oder die Orchestrierung unter den Gruppen ClaudeCode und CodexResponses läuft, kommt nur deepseek-v4.1-flash infrage. Bei normalen Anwendungen, die die OpenAI-kompatible Schnittstelle nutzen, können beide Versionen gewählt werden. Beim Aufruf wird base_url einheitlich als https://api.apiyi.com/v1 geschrieben; zum Wechsel der Stufe ändert man nur das Feld model.
Geschwindigkeitsunterschied: deepseek-v4-1-flash-economy-261017 ist langsamer, aber eben nur langsamer
Die zum Launch veröffentlichte Dokumentation gibt eine Geschwindigkeitsschätzung an: etwa 2 Sekunden bis zum ersten Token und etwa 15 Millisekunden pro Token. Wichtig: Das ist die Schätzmethodik aus der Dokumentation, keine gemessene Rangliste. Die tatsächliche Wahrnehmung schwankt je nach Aufgabenlänge und Tageszeit; für Kapazitätsplanung sollte man Spielraum einplanen. Um die Qualität muss man sich keine Sorgen machen: Laut offizieller Angabe ist die Ausgabequalität beider Versionen identisch, da sie ohnehin dieselbe V4.1-Flash-1017 laden.
Anders gesagt: Betrachten Sie die beiden IDs bei der Qualitätsbewertung nicht als zwei Modelle. Zu bewerten ist wirklich nur eines: Ob Ihre Aufgabe eine langsamere Generierung akzeptieren kann.
Szenarioempfehlungen für deepseek-v4-1-flash-economy-261017
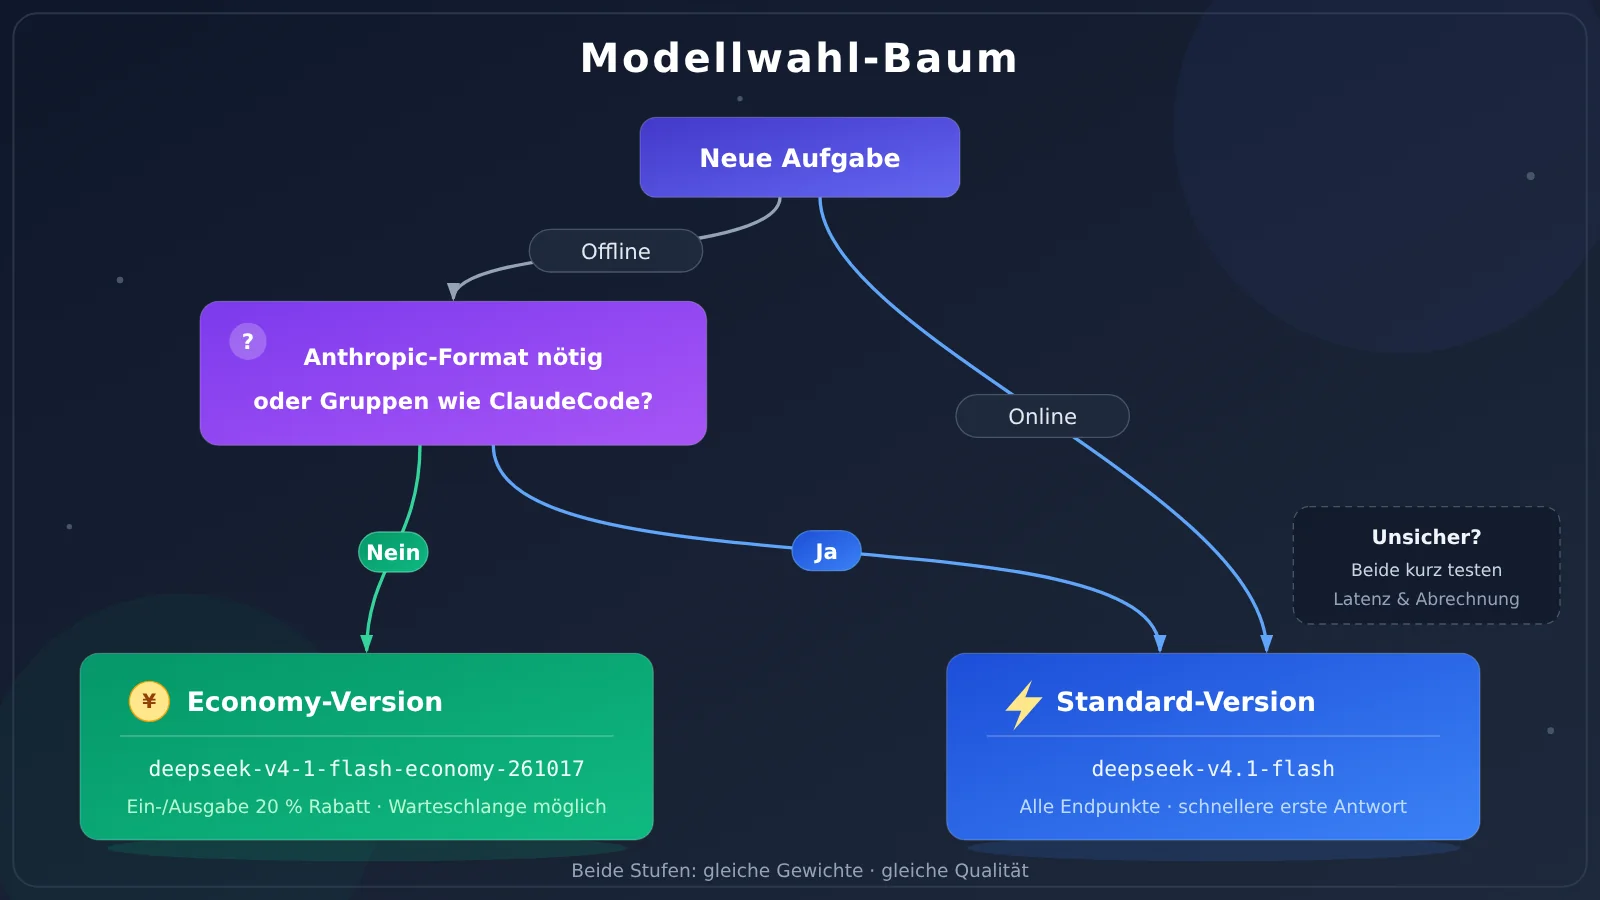
Die Auswahl in einem Satz: Bei unkritischer Latenz und Nutzung des Chat-Endpunkts die Economy-Version verwenden; ansonsten die Standardversion. Im Folgenden die Details nach Szenarien.
Wann Sie deepseek-v4-1-flash-economy-261017 wählen sollten
Geeignet für Szenarien, in denen der Stückpreis an erster Stelle steht und niemand vor dem Bildschirm auf das Ergebnis wartet:
- Batch-Offline-Verarbeitung: Log-Zusammenfassungen, Dokument-Tagging, Korpusbereinigung, Batch-Übersetzung – große Mengen, warteschlangenfähig, wiederholbar
- Nächtliche geplante Aufgaben: Tagsüber angesammelte Aufgaben laufen nachts, die 2 Sekunden bis zum ersten Token fallen nicht ins Gewicht
- Kostensensible Zwischenschritte: Klassifikation, Extraktion, strukturierte Transformation – solche Pipeline-Knoten, die keine Interaktion mit Menschen erfordern
- Wiederholte Läufe mit langem Prefix: Derselbe Kontext wird wiederholt aufgerufen; bei Cache-Treffern kosten beide Versionen gleich viel, bei Cache-Misses liegt der Input der Economy-Version bei 80 % des Preises
Für die Batch-Verarbeitung gibt es noch einen kleinen Schalter, den man sich merken sollte: Setzt man reasoning_effort auf none, wird das Nachdenken abgeschaltet und man spart Ausgabe-Tokens. Das ist unabhängig von den 80 % und lässt sich kombinieren.
Wann Sie weiterhin deepseek-v4.1-flash verwenden
- Interaktive Produkte: Chat- und Copilot-Oberflächen, bei denen die Latenz bis zum ersten Token das Erlebnis direkt beeinflusst
- Workflows mit festem Anthropic-Format: Der Client baut Requests nach dem Anthropic-Protokoll zusammen – die Economy-Version kann das nicht
- Gruppen ClaudeCode und CodexResponses: Die Orchestrierung hängt von diesen beiden Gruppen ab, die nur die Standardversion anbietet
- Online-Durchsatz hat Vorrang: Lieber mehr bezahlen als auf ein schnelleres Generierungstempo zu verzichten
| Ihr Szenario | Empfehlung | Grund |
|---|---|---|
| Batch-Offline, geplante Aufgaben | deepseek-v4-1-flash-economy-261017 |
80 % des Preises für Input und Output, Latenz unkritisch |
| Chat- und Copilot-Oberflächen | deepseek-v4.1-flash |
Antwortgeschwindigkeit hat Vorrang |
| Anthropic-Format oder Gruppen ClaudeCode/CodexResponses | deepseek-v4.1-flash |
Economy-Version hat nur den Chat-Endpunkt |
| Warteschlangenfähig, kostensensibel | deepseek-v4-1-flash-economy-261017 |
Dieselben Gewichte, identische Qualität |
🎯 Szenario-Tipp: Wenn Sie unsicher sind, lassen Sie dieselbe Aufgabenmenge in beiden Stufen jeweils als kleinen Batch laufen und vergleichen Sie Latenz und Abrechnung, bevor Sie sich entscheiden. APIYI apiyi.com unterstützt den direkten Wechsel des model-Felds mit einem einzigen API-Schlüssel, ohne andere Konfigurationen ändern zu müssen.
deepseek-v4-1-flash-economy-261017: Entscheidungshilfe und Umstieg
Der Wechsel kostet nichts. Die Anfrage-Struktur bleibt unverändert, base_url ist weiterhin https://api.apiyi.com/v1. Sie müssen nur das Feld model von deepseek-v4.1-flash auf deepseek-v4-1-flash-economy-261017 ändern, um die Stufe zu wechseln. Die Abrechnung erfolgt automatisch je nach Modell, ein neuer API-Schlüssel ist nicht nötig. Die Economy-Version steht sowohl in der Default- als auch in der SVIP-Gruppe zur Verfügung.
| Feld | Economy-Version | Standardversion |
|---|---|---|
| model | deepseek-v4-1-flash-economy-261017 |
deepseek-v4.1-flash |
| base_url | https://api.apiyi.com/v1 |
https://api.apiyi.com/v1 |
| Endpunkt | Chat | Chat, Anthropic-Format |
| Eingabe-/Ausgabepreis | $0.24, $0.96 | $0.30, $1.20 |
Eine häufige Stolperfalle: In der ID der Standardversion steht ein Punkt – deepseek-v4.1-flash, kein Bindestrich. Wenn eine der beiden IDs falsch geschrieben ist, meldet das System, dass das Modell nicht existiert. Speichern Sie diese Übersicht am besten in den Modellkonfigurations-Notizen Ihres Teams, um Tippfehler zu vermeiden.
💡 Auswahlempfehlung: Für die Offline-Stapelverarbeitung die Economy-Version verwenden, für interaktive Online-Anwendungen die Standardversion. Wer das Anthropic-Format oder die ClaudeCode- und CodexResponses-Gruppen nutzt, braucht die Standardversion. Bei neuen Aufgaben können Sie zunächst bei APIYI apiyi.com mit dem kostenlosen Testkontingent beide Stufen jeweils mit einer kleinen Charge testen und sich dann festlegen.
Häufig gestellte Fragen (FAQ) zu deepseek-v4-1-flash-economy-261017
F1: Was ist deepseek-v4-1-flash-economy-261017?
Die Economy-Variante von DeepSeek V4.1 Flash, seit dem 2026-11-11 um 12:22 (UTC+8) online. Sie nutzt dieselben V4.1-Flash-1017-Gewichte wie die Standardversion `deepseek-v4.1-flash`; der Preis für Ein- und Ausgabe liegt bei 80 % der Standardversion, die Generierungsgeschwindigkeit ist langsamer.
F2: Worin unterscheidet sich deepseek-v4-1-flash-economy-261017 von deepseek-v4.1-flash?
In drei Punkten: Preis (80 % für Ein- und Ausgabe, gleicher Preis beim Cache-Lesen), Geschwindigkeit (die Economy-Variante ist langsamer) sowie Endpunkte und Gruppen (die Economy-Variante bietet nur Chat und Default, SVIP; die Standardversion zusätzlich das Anthropic-Format sowie ClaudeCode und CodexResponses). Gewichte und Ausgabequalität sind identisch.
F3: Wann ist die Economy-Variante erschienen? Kann ich sie schon nutzen?
Sie ist seit dem 2026-11-11 um 12:22 (UTC+8) online und derzeit bei APIYI apiyi.com gelistet; verfügbar in den Gruppen Default und SVIP. Eine eigene Modell-Detailseite gibt es vorerst nicht; maßgeblich sind die Launch-Dokumentation und die offizielle Modellliste.
F4: Für welche Anwendungsfälle eignet sich deepseek-v4-1-flash-economy-261017 am besten?
Für Aufgaben, bei denen Latenz keine große Rolle spielt und die über den Chat-Endpunkt laufen: Batch-Zusammenfassungen von Logs, Dokumenten-Tagging, Korpusbereinigung, Batch-Übersetzung, nächtliche geplante Jobs, kostensensible Pipelines für Klassifizierung und Extraktion. Bei Offline-Batches lässt sich außerdem `reasoning_effort` auf `none` setzen, um das Reasoning abzuschalten und dadurch zusätzlich Tokens zu sparen.
F5: Wie rufe ich deepseek-v4-1-flash-economy-261017 über die API auf?
Registrieren Sie sich bei APIYI apiyi.com, um einen API-Schlüssel zu erhalten; setzen Sie `base_url` auf `https://api.apiyi.com/v1`, tragen Sie im Feld `model` `deepseek-v4-1-flash-economy-261017` ein und starten Sie einen Chat-Aufruf über die OpenAI-kompatible Schnittstelle. Neue Nutzer erhalten ein kostenloses Testkontingent und können die Unterschiede bei Latenz und Abrechnung zwischen den beiden Varianten direkt prüfen.
F6: Welche bekannten Einschränkungen hat deepseek-v4-1-flash-economy-261017?
Drei Punkte sollten Sie einkalkulieren: Die Generierung ist langsamer (laut Dokumentation etwa 2 Sekunden bis zum ersten Token und etwa 15 Millisekunden pro Token); es gibt nur den Chat-Endpunkt – wer das Anthropic-Format braucht, sollte die Standardversion verwenden; Cache-Lesevorgänge erhalten keinen Rabatt und kosten wie bei der Standardversion $0.006. Die Economy-Variante ist „langsamer, aber günstiger“ – nicht „schlechter“.
F7: Sind die 80 % eine Aktion? Wird später wieder der reguläre Preis gelten?
Nein, das ist keine Aktion. Die 80 % beschreiben den festen Unterschied zwischen den Listenpreisen der beiden Modelle – $0.24 gegenüber $0.30 für die Eingabe und $0.96 gegenüber $1.20 für die Ausgabe. Bei APIYI apiyi.com laufen Kontovorteile über eine Bonusgutschrift beim Aufladen; die beiden Stückpreise ändern sich dadurch nicht. Die Abrechnung erfolgt nach der Spitzenpreisstufe.
deepseek-v4-1-flash-economy-261017 — Kernpunkte (Key Takeaways)
- Dieselben Gewichte: teilt sich V4.1-Flash-1017 mit
deepseek-v4.1-flash, die Ausgabequalität ist laut offizieller Angabe identisch - Der 80-Prozent-Spielraum: Input $0,24, Output $0,96 (pro 1 Mio. Tokens) entsprechen 80 % des Standardpreises; Cache-Read kostet mit $0,006 in beiden Varianten gleich viel
- Der Preis der Geschwindigkeit: Laut Doku etwa 2 Sekunden bis zum ersten Token und rund 15 Millisekunden pro Token – geeignet für Offline-Batchjobs, nicht für Interaktion
- Unterschied bei den Endpunkten: Die Economy-Variante bietet nur Chat (Default, SVIP); die Standardvariante hat zusätzlich das Anthropic-Format sowie die Gruppen ClaudeCode und CodexResponses
- Wechselkosten: Die Request-Struktur bleibt gleich, nur das Feld
modelmuss geändert werden, um zwischen den beiden Stufen zu wechseln - Faustregel: Wer warten kann, spart – wer nicht warten kann, nimmt die schnelle Variante
Fazit
Das Verhältnis der beiden Modelle lässt sich in einem Satz erklären: deepseek-v4-1-flash-economy-261017 und deepseek-v4.1-flash sind zwei Stufen derselben V4.1-Flash-1017-Gewichte – gleiche Qualität, unterschiedliche Geschwindigkeit, 80 % Preisniveau bei Input und Output.
- Kosten: Batch-Verarbeitungsaufgaben profitieren direkt, Input und Output zum 80-%-Preis, Cache-Read zum gleichen Preis
- Fähigkeiten: Die vollständigen 552B-Gewichte werden über den offiziellen BytePlus-Kanal bereitgestellt – nicht quantisiert, nicht destilliert
- Grenzen: Die Economy-Variante hat nur den Chat-Endpunkt und die Gruppen Default und SVIP; Anthropic-Format sowie ClaudeCode und CodexResponses gibt es nur in der Standardvariante
Die Auswahl bleibt einfach: Wer unempfindlich gegenüber Latenz ist, nimmt die Economy-Variante; wer Online-Interaktion oder ein festes Anthropic-Format braucht, nimmt die Standardvariante. Empfehlenswert ist, über APIYI apiyi.com mit dem kostenlosen Testkontingent beide Stufen jeweils mit einem kleinen Batch laufen zu lassen – dann entscheidet die Rechnung für Sie.
📚 Referenzen
- DeepSeek V4.1 Flash Economy-Version – Launch-Dokumentation
- Link:
docs.apiyi.com/live/2026-11/deepseek-v4-1-flash-economy-launch.md -
Erläuterung: Erstquelle für Gewichte, Preise, Endpunkte, Gruppierungen und Geschwindigkeitsschätzungen
-
APIYI-Modellliste
- Link:
docs.apiyi.com/models -
Erläuterung: Prüfeinstieg für die gelisteten Stückpreise der beiden Modelle
-
APIYI-Preisschnittstelle
- Link:
api.apiyi.com/api/pricing - Erläuterung: Maschinenlesbare Preisdaten, geeignet für skriptgesteuerten Abgleich
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Materialien finden Sie im Dokumentationszentrum von docs.apiyi.com.