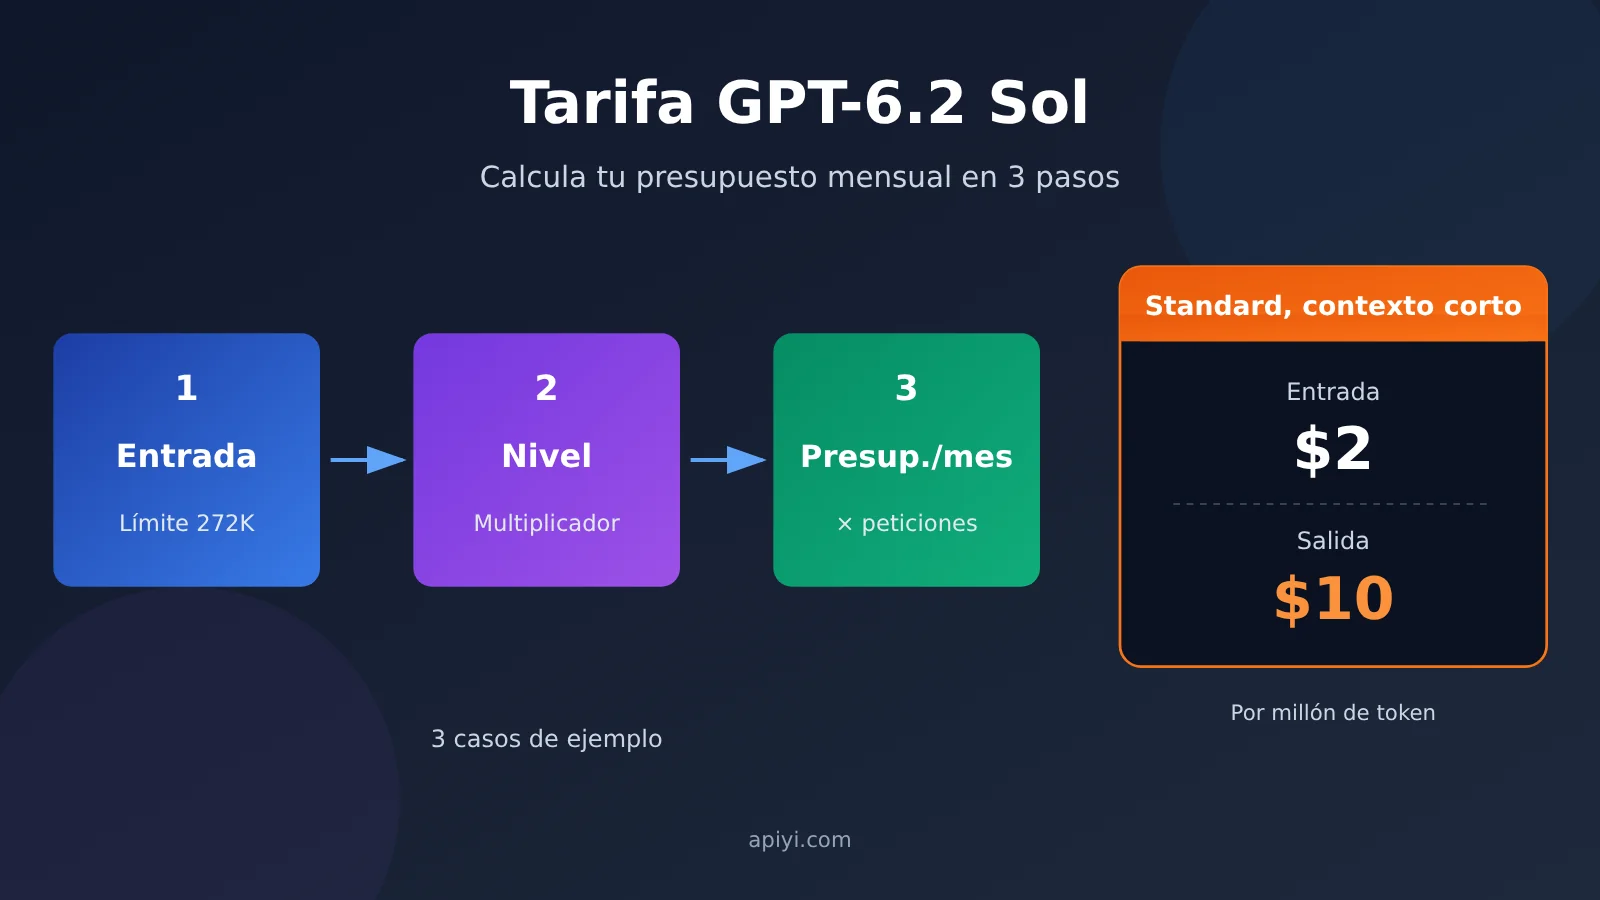
Invocar la API de GPT-6.2 Sol: el costo se decide en tres pasos. El primero mira el volumen total de entrada de una sola solicitud, usando 272K tokens como frontera entre contexto corto y largo; al superar ese umbral, las tarifas de entrada y de caché de toda la solicitud se multiplican por 2, y la salida por 1.5. El segundo paso elige el nivel de servicio según el plazo de entrega: Standard es el precio base, Batch aplica un 50% de descuento, las ventanas 8h y 2h en segundo plano se facturan al 60% y 70% respectivamente, Fast va a 2x, y Ultrafast es 3x antes del 2027-02-28 (hora del Pacífico) y 6x después. El tercer paso multiplica el costo por solicitud por el volumen mensual de solicitudes y luego suma las llamadas a herramientas, las tarifas regionales aplicables y los reintentos.
El precio de lista de Standard con contexto corto es: entrada normal $2.00 por millón de tokens, lectura de caché $0.10, salida (incluidos los tokens de razonamiento) $10.00. Con estos precios, una solicitud interactiva de 20,000 tokens de entrada y 3,000 de salida cuesta aproximadamente $0.07, y 2,000 solicitudes al mes rondan los $140. Todos los precios de este artículo están expresados en dólares por millón de tokens, con fecha de verificación 2026-11-20 (hora de Beijing).
Mapa de conocimiento de precios y índice de lectura de la API GPT-6.2 Sol
El artículo completo se desarrolla en el orden «evaluación del volumen de entrada → selección del nivel según el plazo de entrega → invocaciones acumuladas». La siguiente tabla reúne, para cada paso, la pregunta que debe responder, el resultado que produce y el número de sección del texto; el resultado de la sección anterior alimenta la siguiente.
| Paso | Pregunta a responder | Resultado de este paso | Número de sección |
|---|---|---|---|
| Evaluación del volumen de entrada | ¿Esta solicitud cae en contexto corto o en contexto largo? | Tabla de tarifas base aplicable | 1, 3.2 |
| Selección del nivel según el plazo de entrega | ¿El usuario espera en línea o puede recibir la entrega en unas horas o al día siguiente? | Multiplicador del nivel de servicio | 2, 3.1 |
| Invocaciones acumuladas | ¿Cuántas solicitudes al mes y qué otros gastos adicionales hay? | Presupuesto mensual | 2, 4 |
| Recálculo por canal | Si se cambia de canal de facturación, ¿cuánto costaría la misma solicitud? | Comparativa de canales y tabla de presupuesto | 4 |
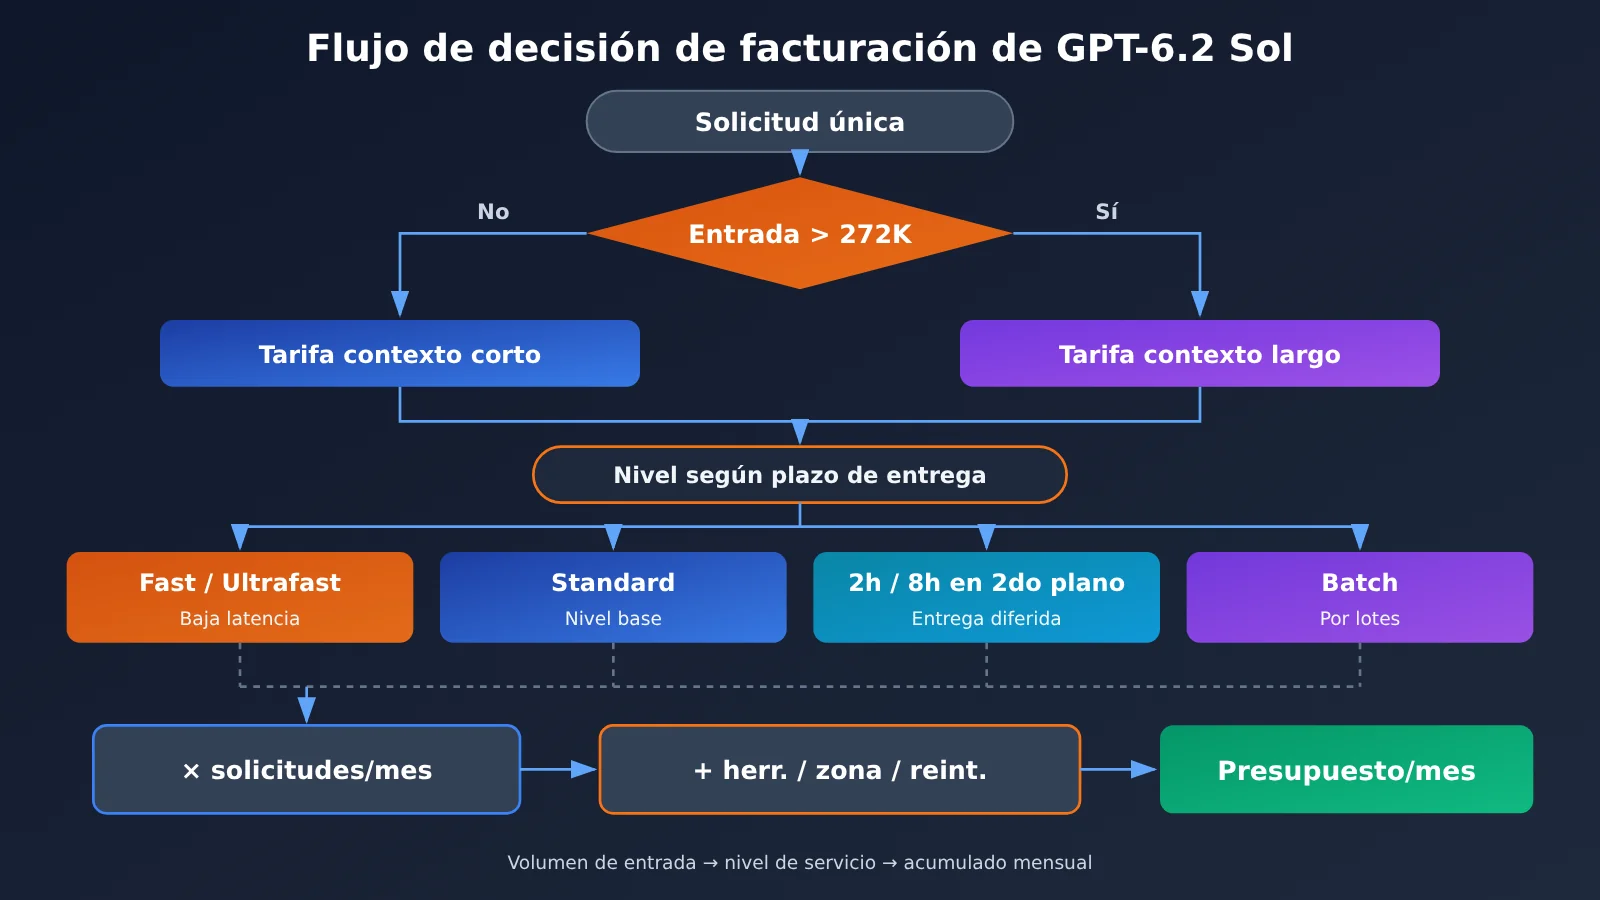
En cuanto al orden de lectura, la sección 1 presenta las tarifas base, que son la referencia para todos los ejemplos de cálculo posteriores. Las secciones 2 y 3 corresponden, respectivamente, a los dos tipos de negocio: «el usuario espera en línea el resultado» y «se permite retrasar la entrega»; puedes leer solo la sección que te interese. La sección 4 aplica los cálculos anteriores a las tarifas públicas de APIYI apiyi.com y a las tarifas oficiales de OpenAI, recalculándolos en paralelo, y al final ofrece una tabla de presupuesto mensual que puedes rellenar directamente.
Términos de facturación de GPT-6.2 Sol que conviene conocer
| Término | Explicación |
|---|---|
| Token | Unidad básica con la que el modelo mide el texto y otras entradas/salidas; la cantidad se toma de las estadísticas devueltas por el servidor |
| Standard | Nivel de procesamiento habitual de la API oficial y base de referencia para calcular los multiplicadores de los demás niveles |
| Lectura de caché | Cuando una solicitud reutiliza un prefijo histórico ya almacenado en caché, esa parte de la entrada se factura según la tarifa de lectura de caché |
| Escritura de caché | Categoría de facturación independiente para guardar prefijos válidos que se reutilizarán más adelante; tiene dos niveles: 30 minutos y 12 horas |
| Salida facturable | Volumen de salida contabilizado por la API, incluidos los tokens de razonamiento y la salida final |
| Batch API | Interfaz para enviar por archivo un conjunto de solicitudes independientes ya preparadas al procesamiento por lotes en segundo plano |
| Ventana de finalización | Plazo objetivo fijado para la respuesta inicial una vez aceptada una solicitud en segundo plano |
| Fast y Ultrafast | Dos niveles de tarifa alta orientados a escenarios de baja latencia |
1. ¿Qué tarifas tiene una solicitud a la API de GPT-6.2 Sol?
1.1 Las cinco categorías de facturación del nivel Standard
El ID del modelo de API de GPT-6.2 Sol es gpt-6.2-sol y se puede invocar mediante los dos endpoints Responses y Chat Completions. Una solicitud puede llegar a implicar hasta cinco categorías de facturación. La siguiente tabla recoge los precios oficiales del nivel Standard. El precio base para contexto corto es el mismo que el de GPT-6.1 Sol; la columna de contexto largo se calcula según el multiplicador de la ficha del modelo.
| Categoría de facturación Standard | Contexto corto (≤272K de entrada) | Contexto largo (>272K de entrada) |
|---|---|---|
| Entrada normal | $2.00 | $4.00 |
| Lectura de caché | $0.10 | $0.20 |
| Escritura en caché de 30 minutos | $2.50 | $5.00 |
| Escritura en caché de 12 horas | $5.00 | $10.00 |
| Salida (incluye tokens de razonamiento) | $10.00 | $15.00 |
Hay tres detalles de la tabla que se prestan a errores de cálculo.
- La escritura en caché no se suma a la entrada normal. El lote de tokens que se escribe en caché se cobra una sola vez según la tarifa completa de 30 minutos o 12 horas, y no se cobra adicionalmente como entrada normal.
- Los tokens de razonamiento se incluyen en la salida. El
usage.output_tokensque devuelve Responses es el total de salida; el uso de razonamiento suele aparecer como subelemento enoutput_tokens_details.reasoning_tokens, así que para el presupuesto basta calcular sobre el total. - El cambio de tramo se aplica a toda la solicitud. Cuando el total de entrada supera 272K, la entrada, la caché y la salida de toda la solicitud pasan a las tarifas de contexto largo; no se aplica un recargo solo a la parte que excede.
La ficha del modelo también indica una ventana de contexto de 1,050,000 tokens, una entrada máxima de 922,000 tokens y una salida máxima de 128,000 tokens. 922K es la entrada máxima permitida; 272K es el punto de cambio de tramo de facturación, y ambos no tienen relación entre sí.
1.2 Gastos adicionales al coste del modelo
La tabla anterior solo cubre el coste de tokens del modelo. Sol, en Responses, puede invocar herramientas como búsqueda de archivos, búsqueda web, intérprete de código y generación de imágenes, y esas herramientas se facturan según reglas independientes cuando se usan realmente. Al generar imágenes, Sol se encarga de iniciar la invocación de la herramienta, la imagen la produce una herramienta de imagen aparte y el coste de la imagen se calcula por separado. Al desplegar en una región concreta, también pueden aplicarse cargas regionales. En la hoja de presupuesto conviene reservar columnas separadas para estos conceptos, sin mezclarlos con el precio unitario de los tokens.
1.3 Leer el consumo real facturado mediante código
Después de estimar, toca calibrar con el campo usage de solicitudes reales. El siguiente ejemplo invoca Sol a través de la interfaz compatible con OpenAI y convierte el coste del modelo de esta llamada usando la tarifa Standard de contexto corto:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句话说明 Batch API 适合什么任务。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"输入 {u.input_tokens},其中缓存 {cached},输出 {u.output_tokens},模型费约 ${cost:.6f}")
Esta conversión solo aplica a solicitudes Standard con entrada de hasta 272K y sin escritura de caché. En producción se recomienda registrar el usage de cada solicitud en el log, agregarlo por tipo de tarea y luego rellenar la hoja de presupuesto de la sección 4.
🎯 Práctica recomendada oficial: antes de fijar el presupuesto definitivo, ejecuta primero una ronda con 20 a 50 solicitudes reales del negocio y analiza la distribución de entrada y salida. Los nuevos usuarios de APIYI apiyi.com disponen de cupo de prueba gratuito, ideal para este tipo de calibración con muestras pequeñas.
2. Cómo calcular los niveles de interacción y el presupuesto mensual de GPT-6.2 Sol
2.1 Coste de una misma solicitud en los tres niveles de interacción
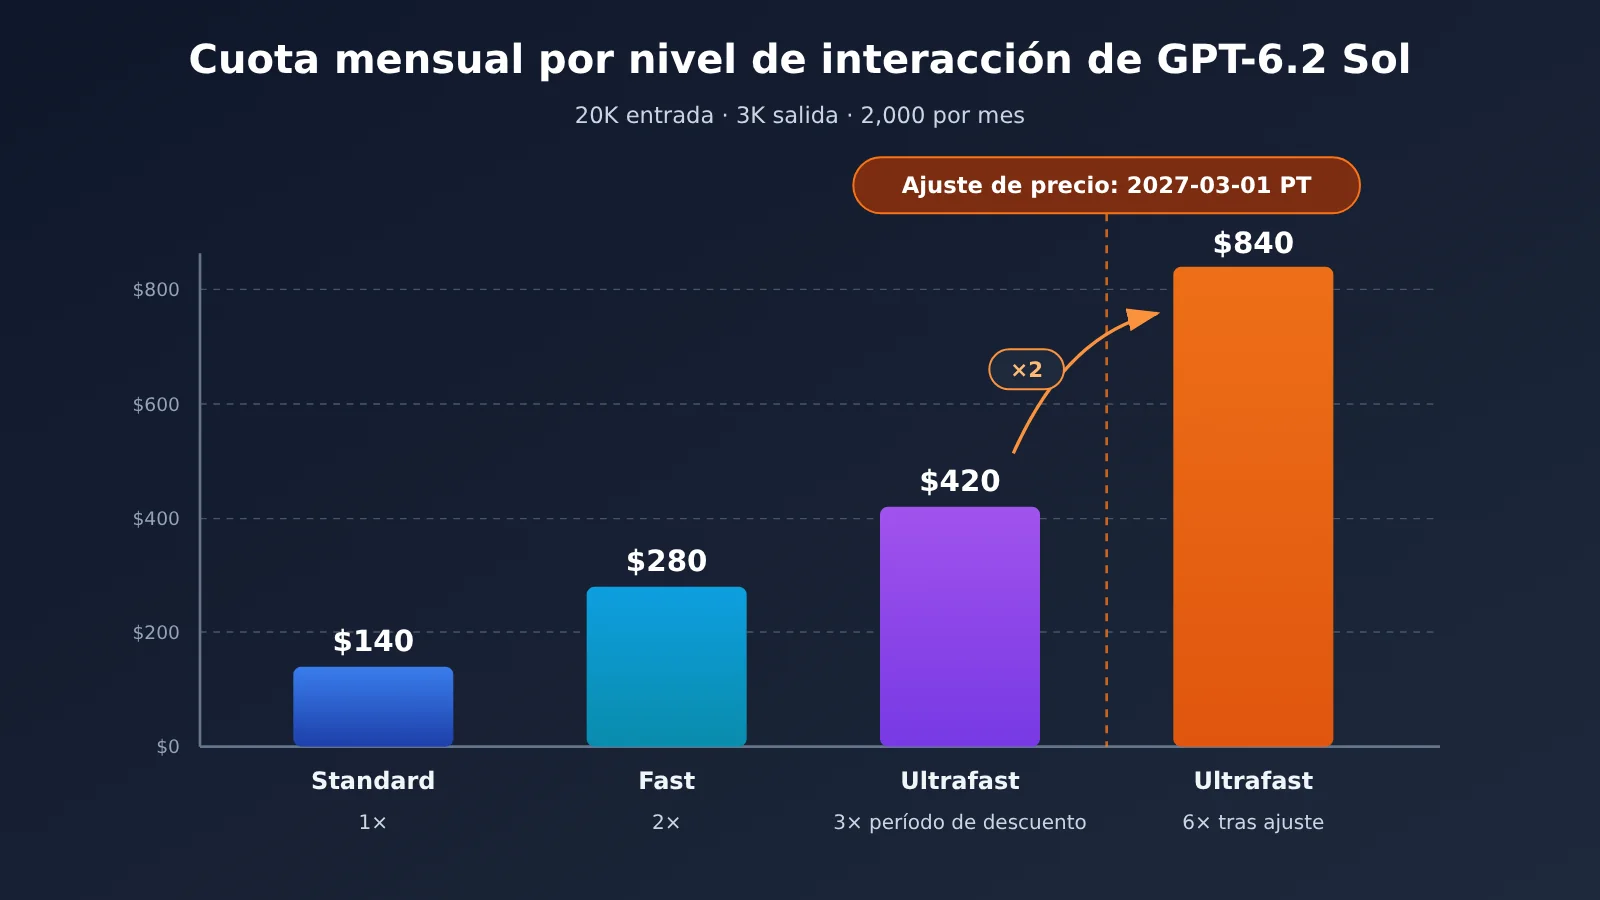
En los escenarios interactivos, el usuario espera el resultado en la interfaz, y los niveles disponibles son Standard, Fast y Ultrafast. Fast se factura al doble de Standard; Ultrafast cuesta 3 veces más hasta el 2027-02-28 (hora del Pacífico) y 6 veces a partir del 2027-03-01. GPT-6.2 Sol no admite el nivel Flex.
El ejemplo supone que cada solicitud tiene 20.000 tokens de entrada normales y 3.000 tokens de salida facturables, sin caché, herramientas, recargos regionales ni reintentos, con 2.000 solicitudes al mes. El coste por solicitud en Standard es 20000×2/1e6 + 3000×10/1e6 = $0.07.
| Nivel de servicio | Multiplicador | Coste por solicitud | 2.000 al mes |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast (hasta 2027-02-28 PT) | 3× | $0.21 | $420 |
| Ultrafast (desde 2027-03-01 PT) | 6× | $0.42 | $840 |
2.2 Condiciones que hay que tener en cuenta al leer esta tabla
La tabla fija el consumo por solicitud para facilitar la planificación del presupuesto. En la práctica, el consumo de tokens y la latencia de una misma tarea varían según la solicitud en cada nivel, así que antes de lanzar conviene ejecutar un lote de solicitudes reales en cada nivel candidato para verificarlo.
Si vas a presupuestar con Ultrafast antes de marzo de 2027, prepara también una versión calculada con el multiplicador de 6. Con este ejemplo, tras el ajuste la cuota mensual pasa de $420 a $840; el aumento entra en vigor el 1 de marzo (hora del Pacífico), que en hora de Pekín equivale a la tarde del 1 de marzo.
💡 Consejo para elegir el nivel: en la mayoría de las solicitudes interactivas, empieza con Standard; cambia solo las entradas sensibles a la latencia a Fast o Ultrafast. Probar en paralelo con la misma clave API a través de APIYI apiyi.com permite obtener rápidamente datos reales de latencia y consumo de cada nivel.
3. Cómo estimar los costes de procesamiento nocturno y de documentos largos con GPT-6.2 Sol
3.1 Tareas por lotes nocturnas: 2h, 8h y Batch
Hay tres formas de descuento para tareas que no necesitan devolverse de inmediato. Las ventanas de finalización 2h y 8h del modo en segundo plano de Responses se cobran al 70% y 60% de la tarifa de tokens del modelo Standard respectivamente, pero la solicitud debe ser Standard y no en streaming; la ventana se refiere al tiempo objetivo de la respuesta inicial; soonest no tiene descuento por ventana. La Batch API se cobra al 50% de Standard, se envía por lotes mediante archivos y su ventana de entrega es de 24 horas.
El ejemplo supone un total de 10.000 solicitudes, cada una con 50.000 tokens de entrada normal y 4.000 tokens de salida facturables, sin caché ni herramientas. El coste por solicitud en Standard es 50000×2/1e6 + 4000×10/1e6 = $0.14.
| Modo | Tarifa | Coste por solicitud | Total de 10.000 | Cuándo elegirlo |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | Necesitas el resultado cuanto antes |
Segundo plano 2h |
70% | $0.098 | $980 | La aplicación necesita la respuesta inicial en menos de dos horas y debe reinyectar resultados de herramientas a mitad de la tarea |
Segundo plano 8h |
60% | $0.084 | $840 | Enviar esa misma noche y entregar antes de la jornada siguiente, con interacción gradual |
| Batch API | 50% | $0.07 | $700 | Las solicitudes ya están preparadas de antemano, son independientes entre sí y se pueden entregar al día siguiente |
Conviene organizarlo según la forma de la tarea. En tareas independientes como clasificación y extracción, donde todo se puede escribir antes de enviar, puedes tomar Batch como referencia de precio. Si la tarea necesita que la aplicación aporte resultados de herramientas para continuar, estima cada paso por separado y luego elige la ventana 2h o 8h según el plazo total de entrega del lado de la aplicación.
Hay además una restricción de capacidad: las solicitudes en segundo plano con descuento comparten una cuota de cola independiente con Batch. Antes de planificar un envío masivo, conviene verificar la cuota de tokens de entrada en cola para evitar que las solicitudes queden atascadas.
3.2 Documentos largos: el salto de coste al cruzar 272K
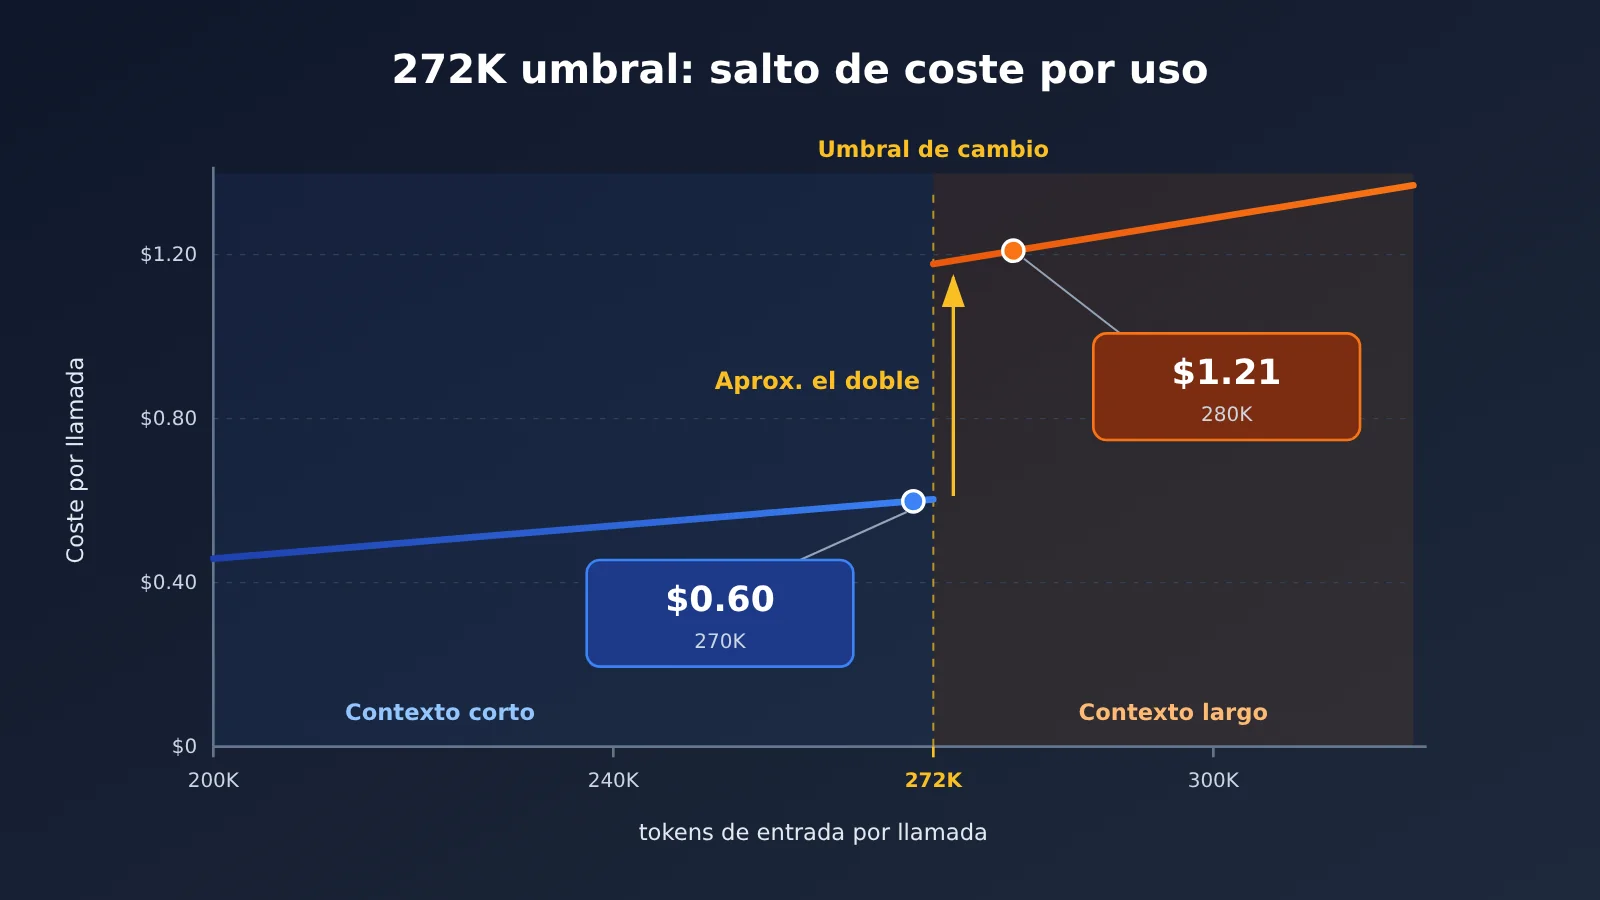
El salto de coste en documentos largos proviene de la regla de cambio de tramo. El ejemplo supone sin caché ni herramientas, salida fija de 6.000 tokens, tramo Standard, con entradas de 270.000 y 280.000 respectivamente:
| Cantidad de entrada | Tarifa aplicable | Cálculo | Coste del modelo por solicitud |
|---|---|---|---|
| 270,000 | Contexto corto | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | Contexto largo | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
La entrada solo aumenta en 10.000 tokens, pero el coste por solicitud pasa de $0.60 a $1.21, aproximadamente el doble. La razón es que toda la solicitud completa pasa a facturarse como contexto largo, y el precio unitario de salida también sube de $10 a $15.
A la hora de presupuestar, conviene registrar la distribución de entradas de cada solicitud por cola de negocio, estimar por separado las solicitudes habituales y los picos de documentos largos, y luego sumarlas. Si piensas recortar documentos para bajar la entrada por debajo de 272K, debes verificar al mismo tiempo que el contenido recortado aún conserva las evidencias necesarias para la entrega; de lo contrario, el coste ahorrado podría acabar compensándose con retrabajo.
4. Cómo completar el presupuesto mensual de GPT-6.2 Sol según el canal
4.1 Recálculo paralelo: tarifas públicas de APIYI frente a las tarifas oficiales de OpenAI
El 2026-11-20 revisamos de nuevo la tabla general pública de modelos de APIYI y la interfaz pública de precios, y en ambas aparece gpt-6.2-sol; la tabla general marca los dos puntos de entrada responses y chat. La tarifa pública también usa 272,000 tokens de entrada como punto de cambio de tramo, pero la expresión de cálculo del tramo largo difiere del multiplicador oficial.
| Categoría de facturación (USD / millón de tokens) | OpenAI tramo corto | OpenAI tramo largo | APIYI apiyi.com tramo corto | APIYI apiyi.com tramo largo |
|---|---|---|---|---|
| Entrada normal | $2.00 | $4.00 | $2.00 | $3.00 |
| Lectura de caché | $0.10 | $0.20 | $0.10 | $0.15 |
| Escritura de caché | $2.50 (30 minutos) | $5.00 (30 minutos) | $2.50 | $3.75 |
| Salida | $10.00 | $15.00 | $10.00 | $11.25 |
Retomamos el recálculo de uso de la sección 3.2. Con 270,000 de entrada y 6,000 de salida, ambos canales dan $0.60. Con 280,000 de entrada y 6,000 de salida, OpenAI oficial da $1.21, mientras que con la fórmula pública de APIYI da (280000×3 + 6000×11.25)÷1e6 = $0.9075, una diferencia de aproximadamente $0.30 por cada solicitud. Cuanto mayor sea la proporción de documentos largos, mayor será el impacto de esta diferencia en el presupuesto mensual.
La diferencia anterior se deriva únicamente de los parámetros ya publicados por ambas partes. El Batch y el descuento de ventana en segundo plano mencionados antes usan el ejemplo de cálculo oficial de OpenAI; cuando se invoca a través de APIYI, la agrupación de cuenta, el cargo real, los tramos disponibles y las capacidades de API se rigen por la configuración y la facturación actuales de APIYI.
4.2 Tabla de presupuesto mensual con una fila por tipo de tarea
Traslademos el algoritmo anterior a una tabla: cada tipo de tarea ocupa una fila, se rellena con el consumo promedio por solicitud y luego se multiplica por el número de solicitudes mensuales. Cuando un flujo de trabajo incluye varias invocaciones del modelo (por ejemplo, el razonamiento en varios pasos de un Agent), registra cada paso en una fila aparte y sumas al final, concepto por concepto.
| Tipo de tarea | Solicitudes mensuales | Entrada normal promedio | Lectura de caché promedio | Escritura de caché (nivel) | Salida facturable promedio | Nivel de contexto | Nivel de servicio | Costos adicionales (herramientas / región) | Tasa de reintentos estimada | Costo mensual |
|---|---|---|---|---|---|---|---|---|---|---|
| Interacción de atención al cliente | 2,000 | 20,000 | 0 | 0 | 3,000 | Corto | Standard | Ninguno | 0% | $140 |
| Clasificación nocturna | 10,000 | 50,000 | 0 | 0 | 4,000 | Corto | Batch | Ninguno | 0% | $700 |
| Revisión de contratos | Rellenar según el caso real | Rellenar según el caso real | 6,000 | Largo | Standard | Rellenar según el caso real | Rellenar según el caso real |
Las cifras de las dos primeras filas provienen de los ejemplos de cálculo de este artículo y pueden servir como referencia para rellenar la tabla. La fórmula del costo mensual es «costo del modelo por solicitud × solicitudes mensuales × (1 + tasa de reintentos) + costos adicionales». El costo del modelo por solicitud debe tomarse de la tabla de tarifas de la sección 1, según el nivel de contexto y el nivel de servicio de esa fila.
🚀 Recomendación práctica: una vez completada la tabla de presupuesto, elige las dos tareas con los importes más altos y ejecuta una ronda de solicitudes reales en APIYI apiyi.com; sustituye los valores estimados por los valores medidos de
usagey tendrás un presupuesto listo para entregar a finanzas.
4.3 Verificar si el presupuesto es confiable
Cuando llegue la factura del primer mes, revisa línea por línea tres cosas.
- En la distribución real de entrada, si la proporción de solicitudes que superan 272K se acerca a lo estimado.
- Si la proporción de tokens de razonamiento dentro de
output_tokenses claramente superior a la de la fase de pruebas. - Si los reintentos y las llamadas a herramientas realmente realizadas quedaron contabilizados.
Si la desviación de las tres partidas se mantiene por debajo del 10%, el próximo mes puedes seguir usando esta tabla tal cual; la partida con mayor desviación es justo donde conviene ajustar primero el consumo o el nivel de servicio.
Referencias
- Precios oficiales de la API de OpenAI: multiplicadores por nivel de servicio y descuentos de Batch y de la ventana en segundo plano
- Enlace:
developers.openai.com/api/docs/pricing
- Enlace:
- Ficha del modelo GPT-6.2 Sol: ventana de contexto, regla de cambio de nivel a 272K y límites
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Enlace:
- Guía del modo en segundo plano y de la Batch API: ventana de finalización, requisito de no streaming y cuota de cola
- Enlace:
developers.openai.com/api/docs/guides/background,developers.openai.com/api/docs/guides/batch
- Enlace:
- Tabla general de modelos de APIYI y endpoint público de precios: entrada de listado de
gpt-6.2-soly expresión de cálculo por cambio de nivel- Enlace:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: para dudas sobre criterios de facturación y configuración de cuenta, puedes contactarnos desde la página principal del sitio web oficial de APIYI; más material de integración en el centro de documentación docs.apiyi.com