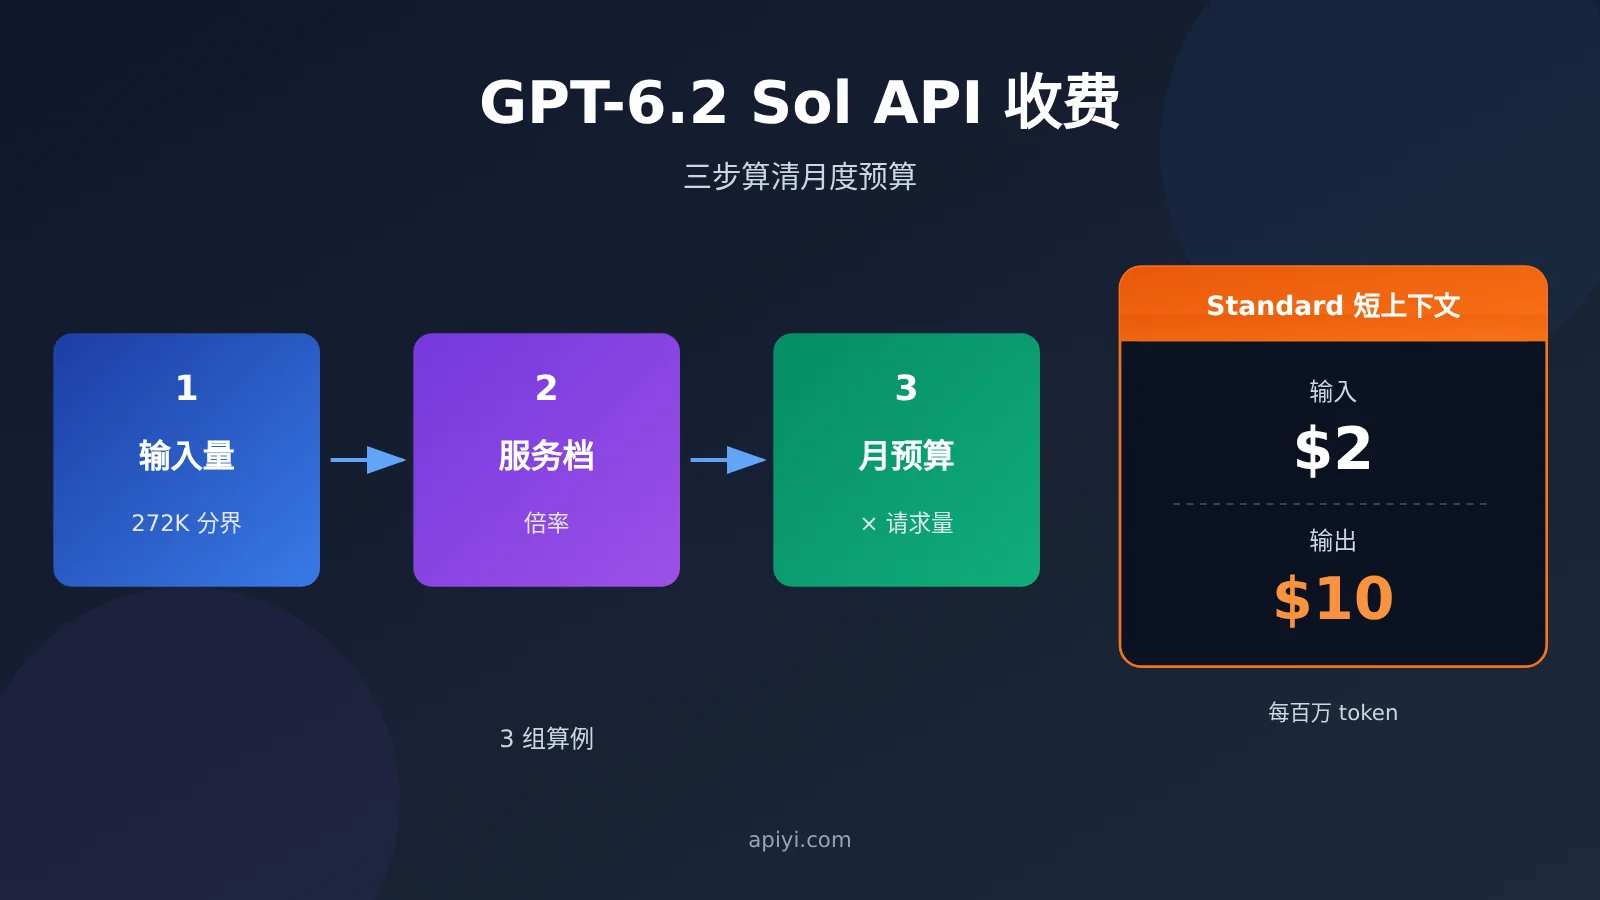
调用 GPT-6.2 Sol 的 API,费用由三步决定。第一步看单次请求的输入总量,以 272K token 为界区分短、长上下文;超过这个阈值时,整笔请求的输入和缓存费率乘 2,输出乘 1.5。第二步按交付时限选服务档:Standard 是基准价,Batch 打五折,后台 8h 与 2h 窗口分别按 60% 和 70% 计费,Fast 为 2 倍,Ultrafast 在 2027-02-28(太平洋时间)之前为 3 倍,之后为 6 倍。第三步把单次费用乘以月请求量,再加上工具调用、适用的区域费用和重试。
短上下文 Standard 的标价为:普通输入每百万 token $2.00,缓存读取 $0.10,输出(含推理 token)$10.00。按这个价格,一条 20,000 输入、3,000 输出的交互请求约 $0.07,每月 2,000 条约 $140。本文所有价格都以美元 / 百万 token 计,核验日期为 2026-11-20(北京时间)。
GPT-6.2 Sol API 收费知识地图与阅读索引
全文按“输入量判断 → 交付时限选档 → 累计调用”的顺序展开。下表把每个环节要回答的问题、输出结果和正文编号放在一起,前一节的结果是后一节的输入。
| 步骤 | 要回答的问题 | 本步输出 | 正文编号 |
|---|---|---|---|
| 输入量判断 | 这笔请求落在短上下文还是长上下文 | 适用的基础费率表 | 1、3.2 |
| 交付时限选档 | 用户在线等,还是可以几小时后或隔日交付 | 服务档倍率 | 2、3.1 |
| 累计调用 | 每月多少请求,另有哪些附加支出 | 月预算 | 2、4 |
| 渠道复算 | 换一个计费渠道,同一请求要花多少 | 渠道对照与预算表 | 4 |
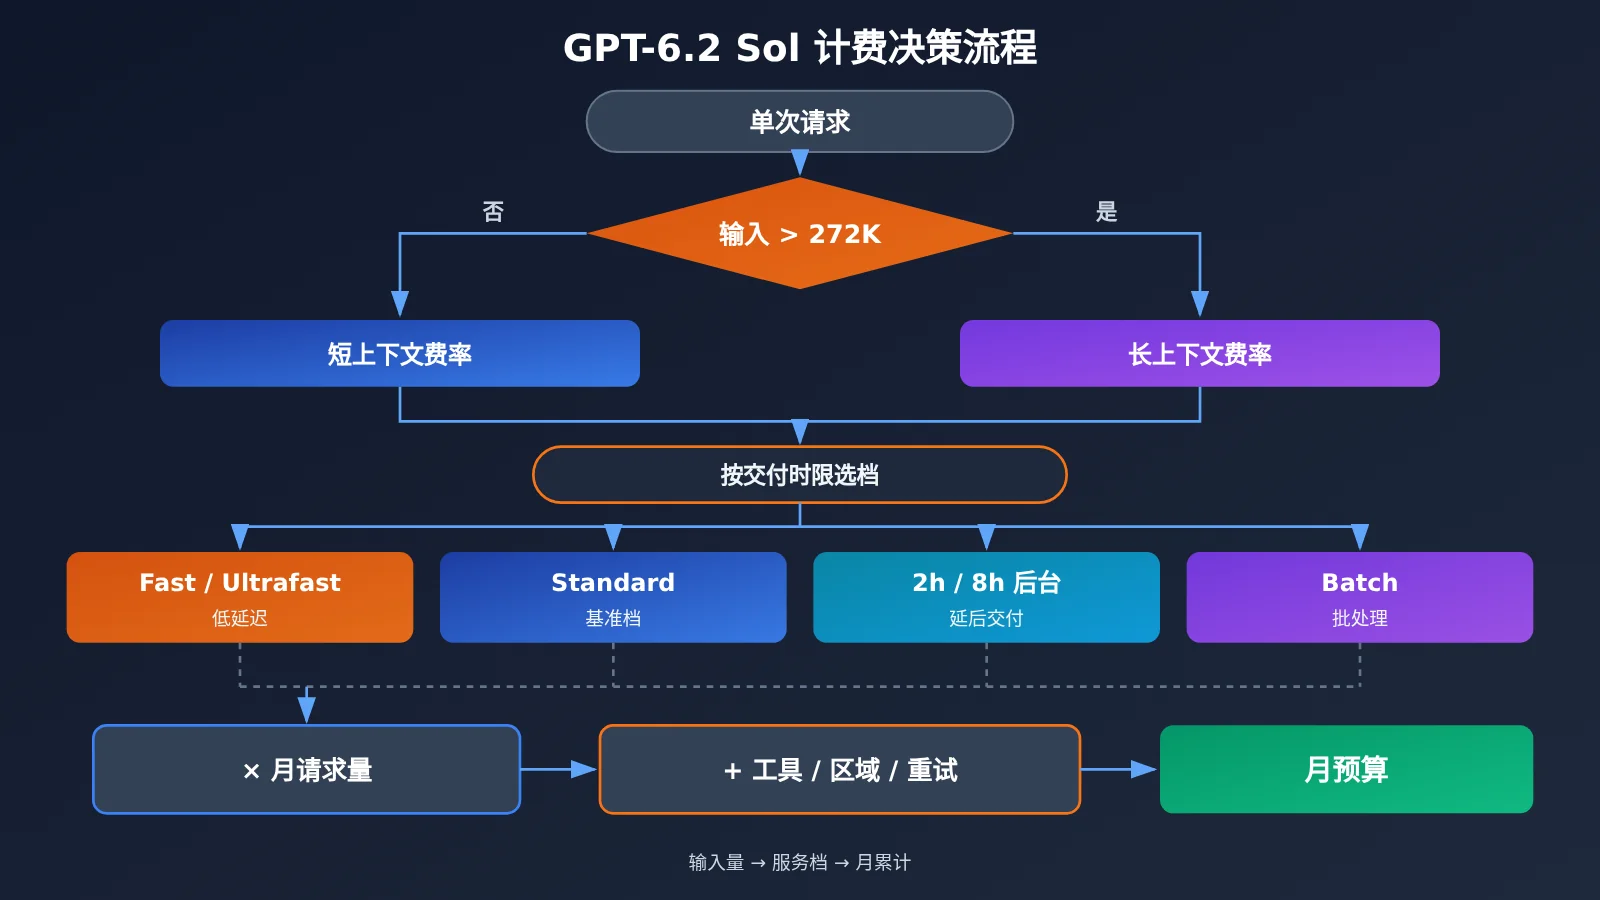
阅读顺序上,第 1 节给出基础费率,是后面所有算例的依据。第 2 节和第 3 节分别对应“用户在线等结果”和“允许延后交付”两类业务,可以只读与自己相关的那一节。第 4 节把前面的算法套到 API易 apiyi.com 公开价目和 OpenAI 官方费率上并列复算,最后给出一张可以直接填写的月度预算表。
GPT-6.2 Sol 计费术语 To Know
| 术语 | 解释 |
|---|---|
| Token | 模型计量文本和其他输入输出的基本单位,数量以服务端返回的统计为准 |
| Standard | 官方 API 的常规处理档,也是其他档位倍率的计价基准 |
| 缓存读取 | 请求复用已缓存的历史前缀时,这部分输入按缓存读取费率计费 |
| 缓存写入 | 为以后复用而保存合格前缀的独立计价类别,分 30 分钟和 12 小时两档 |
| 计费输出 | API 统计的输出量,包括推理 token 和最终输出 |
| Batch API | 把事先准备好的独立请求以文件形式提交给后台批处理的接口 |
| 完成窗口 | 后台请求被接受后,针对初始响应设定的目标时限 |
| Fast 与 Ultrafast | 面向低延迟场景的两个高费率档 |
1. GPT-6.2 Sol API 一笔请求有哪些费率
1.1 Standard 档的五个计费类别
GPT-6.2 Sol 的 API 模型 ID 是 gpt-6.2-sol,可通过 Responses 和 Chat Completions 两个端点调用。一笔请求最多会涉及五个计费类别,下表是 Standard 档的官方标价。短上下文的基础标价与 GPT-6.1 Sol 相同;长上下文栏按模型卡倍率计算。
| Standard 计费类别 | 短上下文(≤272K 输入) | 长上下文(>272K 输入) |
|---|---|---|
| 普通输入 | $2.00 | $4.00 |
| 缓存读取 | $0.10 | $0.20 |
| 30 分钟缓存写入 | $2.50 | $5.00 |
| 12 小时缓存写入 | $5.00 | $10.00 |
| 输出(已含推理 token) | $10.00 | $15.00 |
表中有三点容易算错。
- 缓存写入不叠加普通输入。 写入缓存的那批 token 按 30 分钟或 12 小时档的完整费率计一次,不再额外按普通输入计价。
- 推理 token 计入输出。 Responses 返回的
usage.output_tokens是输出总量,推理用量通常作为子项列在output_tokens_details.reasoning_tokens中,预算按总量计算即可。 - 切档按整笔请求。 输入总量一旦超过 272K,整笔请求的输入、缓存和输出都换到长上下文费率,并非只对超出部分加价。
模型卡还列出 1,050,000 token 上下文窗口、922,000 token 最大输入和 128,000 token 最大输出。922K 是允许的最大输入,272K 是计费切档点,两者互不相关。
1.2 模型费之外的支出
上表只覆盖模型 token 费。Sol 在 Responses 中可以调用文件搜索、网页搜索、代码解释器和图像生成等工具,这些工具在实际使用时按各自的独立规则计费。生成图片时,Sol 负责发起工具调用,图像由单独的图像工具输出,图像费用要另算。部署在特定区域时,还可能产生适用的区域费用。预算表里应给这些项目单独留列,不要把它们混进 token 单价。
1.3 用代码读取实际计费用量
估算之后,要用真实请求的 usage 字段校准。下面的示例通过 OpenAI 兼容接口调用 Sol,并按短上下文 Standard 费率换算这一次的模型费:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input="用三句话说明 Batch API 适合什么任务。"
)

u = resp.usage
cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
plain_in = u.input_tokens - cached
cost = (plain_in * 2.00 + cached * 0.10 + u.output_tokens * 10.00) / 1e6
print(resp.output_text)
print(f"输入 {u.input_tokens},其中缓存 {cached},输出 {u.output_tokens},模型费约 ${cost:.6f}")
这个换算只适用于输入不超过 272K、没有缓存写入的 Standard 请求。生产环境建议把每次请求的 usage 写入日志,按任务类型汇总后再填入第 4 节的预算表。
🎯 官方推荐做法:正式定预算之前,先用 20 到 50 条真实业务请求跑一轮,统计输入和输出的分布。API易 apiyi.com 新用户有免费测试额度,适合做这类小样本标定。
2. GPT-6.2 Sol 交互档位和月预算怎么算
2.1 同一请求在三个交互档的费用
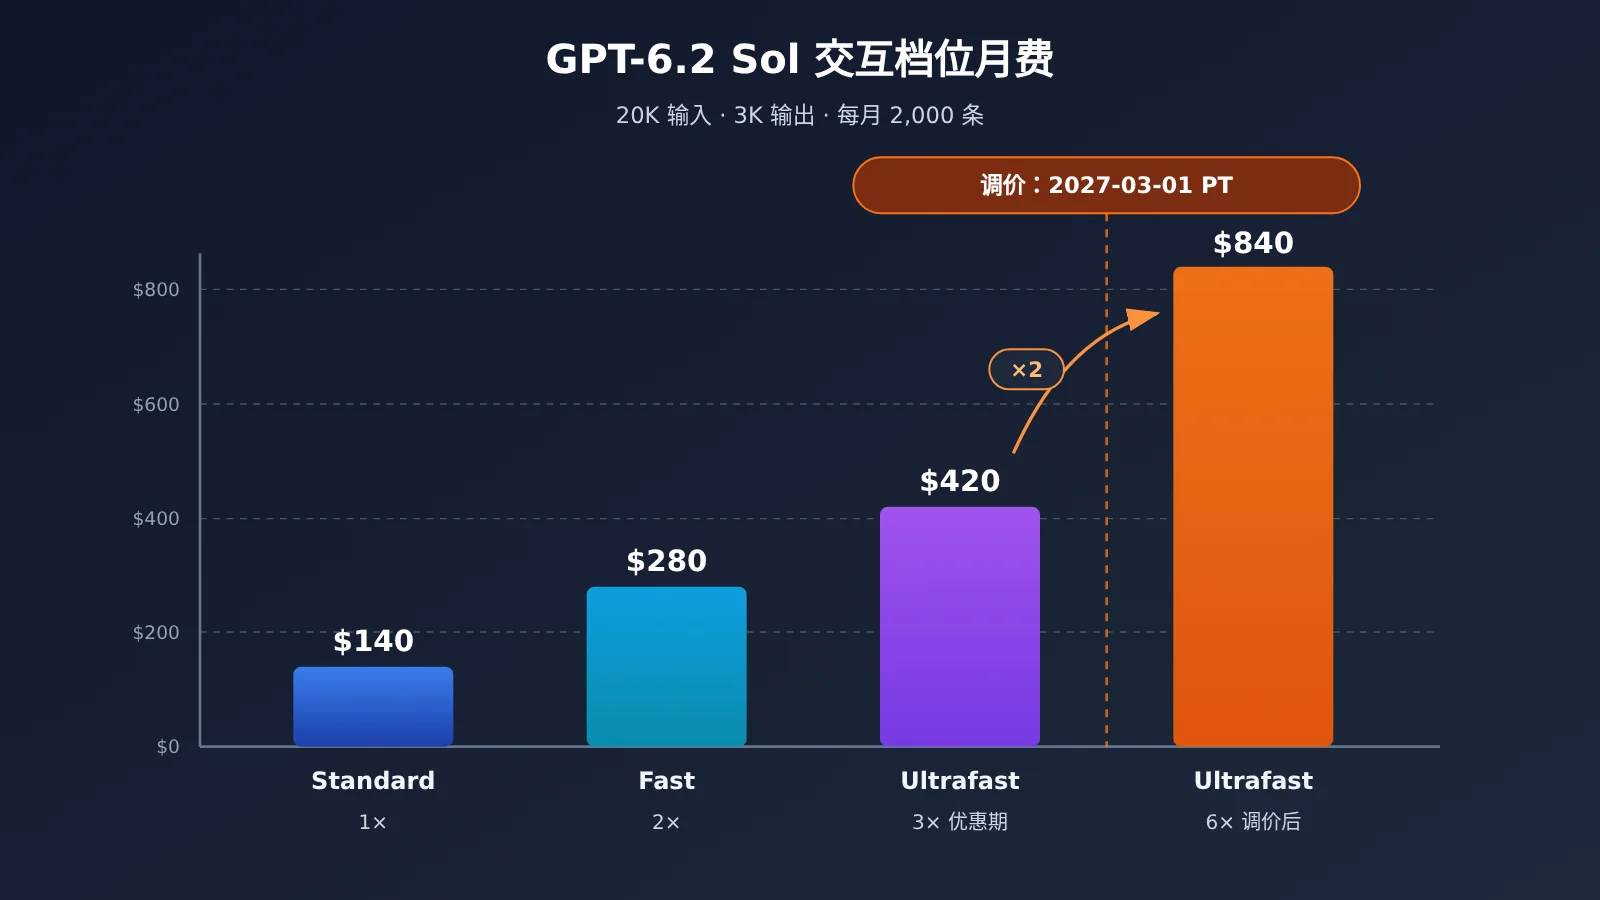
交互场景下,用户在界面上等待结果,可选的是 Standard、Fast 和 Ultrafast。Fast 按 Standard 的 2 倍计费;Ultrafast 到 2027-02-28(太平洋时间)为 3 倍,2027-03-01 起为 6 倍。GPT-6.2 Sol 不支持 Flex 档。
算例假设一条请求有 20,000 普通输入、3,000 计费输出 token,没有缓存、工具、区域费用和重试,每月 2,000 条。Standard 单次费用为 20000×2/1e6 + 3000×10/1e6 = $0.07。
| 服务档 | 倍率 | 单次费用 | 每月 2,000 条 |
|---|---|---|---|
| Standard | 1× | $0.07 | $140 |
| Fast | 2× | $0.14 | $280 |
| Ultrafast(至 2027-02-28 PT) | 3× | $0.21 | $420 |
| Ultrafast(2027-03-01 PT 起) | 6× | $0.42 | $840 |
2.2 读这张表时要注意的条件
表中固定了每条请求的用量,便于安排预算。实际上,同一任务在不同档位的 token 消耗和延迟会随请求变化,上线前应在每个候选档位上各跑一批真实请求复核。
如果在 2027 年 3 月之前用 Ultrafast 做预算,要同时准备一份按 6 倍计算的版本。以本例计算,调价后月费从 $420 变为 $840,涨价发生在太平洋时间 3 月 1 日,换算成北京时间是 3 月 1 日下午。
💡 选档建议:大多数交互请求先用 Standard 上线,只对延迟敏感的入口单独切到 Fast 或 Ultrafast。通过 API易 apiyi.com 用同一个 API Key 并行测试,可以较快拿到各档的真实延迟和用量数据。
3. GPT-6.2 Sol 夜间处理和长文档费用怎么估
3.1 夜间批量任务:2h、8h 与 Batch
不需要即时返回的任务有三种折扣方式。Responses 后台模式的 2h 和 8h 完成窗口分别按 Standard 模型 token 费率的 70% 和 60% 收费,但请求必须是 Standard 且非流式,窗口指初始响应的目标时间;soonest 没有窗口折扣。Batch API 按 Standard 的 50% 收费,以文件批量提交,周转窗口为 24 小时。
算例假设共 10,000 条请求,每条 50,000 普通输入、4,000 计费输出 token,无缓存和工具。Standard 单次费用为 50000×2/1e6 + 4000×10/1e6 = $0.14。
| 方式 | 费率 | 单次费用 | 10,000 条合计 | 何时选用 |
|---|---|---|---|---|
| Standard | 100% | $0.14 | $1,400 | 需要尽快拿到结果 |
后台 2h |
70% | $0.098 | $980 | 应用需在两小时内拿到初始响应,任务中途要回填工具结果 |
后台 8h |
60% | $0.084 | $840 | 当晚提交、次日上班前交付,且需要逐步交互 |
| Batch API | 50% | $0.07 | $700 | 请求事先已准备好、相互独立,可以隔日交付 |
可以按任务形态来组织。分类、抽取这类彼此独立、提交前就能全部写好的任务,可以把 Batch 当作价格基准。任务中途需要应用提供工具结果再继续的,按每一步分别估算,再根据应用端的总交付时限选择 2h 或 8h 窗口。
还有一项容量约束:折扣后台请求与 Batch 共享一个独立的队列额度。计划大批量提交前,需要核对积压的输入 token 配额,避免请求在队列里被卡住。
3.2 长文档:跨过 272K 时的费用跳变
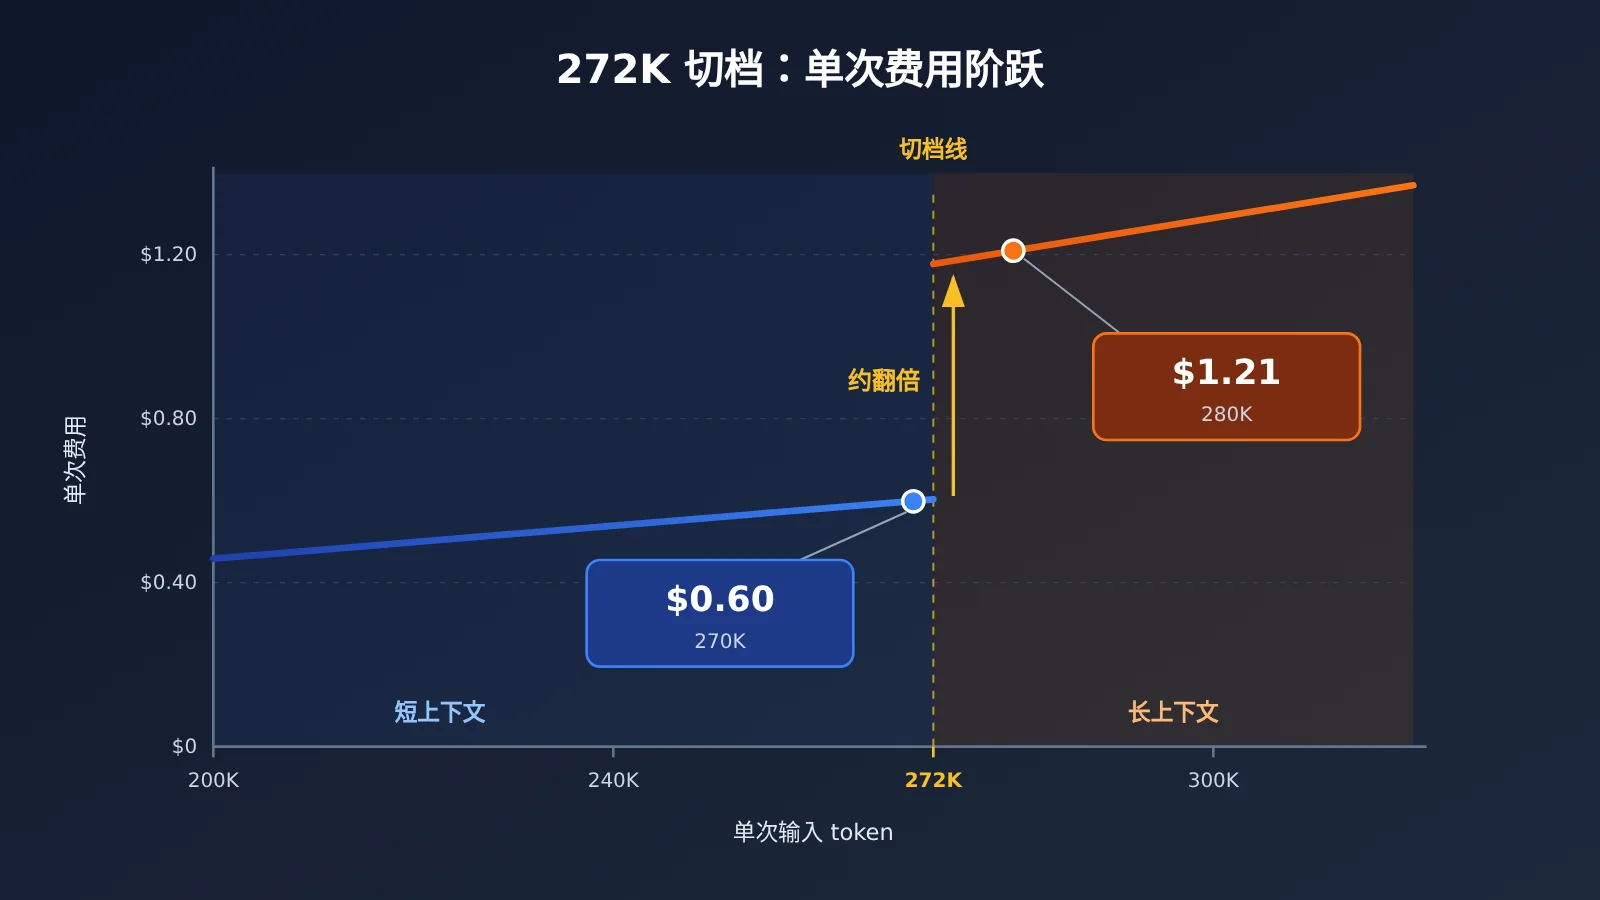
长文档的费用跳变来自切档规则。算例假设无缓存和工具,输出固定 6,000 token,Standard 档,输入分别为 270,000 和 280,000:
| 输入量 | 适用费率 | 计算 | 单次模型费 |
|---|---|---|---|
| 270,000 | 短上下文 | 270000×2/1e6 + 6000×10/1e6 |
$0.60 |
| 280,000 | 长上下文 | 280000×4/1e6 + 6000×15/1e6 |
$1.21 |
输入只多出 10,000 token,单次费用却从 $0.60 变为 $1.21,增加约一倍。原因是整笔请求都改按长上下文计价,输出单价也从 $10 变成 $15。
做预算时,应按业务队列记录每条请求的输入分布,把常态请求和长文档高峰分开估算后再累加。如果打算通过裁剪文档把输入压到 272K 以下,必须同时验证裁剪后的内容是否还保留了交付所需的证据,否则省下的费用可能要用返工补回来。
4. 按渠道填写 GPT-6.2 Sol 月预算
4.1 API易公开价目与 OpenAI 官方费率并列复算
2026-11-20 回读 API易公开模型总表和公开定价接口,均可查到 gpt-6.2-sol,总表标注了 responses 和 chat 两个入口。公开定价同样以 272,000 输入 token 切档,但长档的计价表达式与官方倍率不同。
| 计费类别(USD / 百万 token) | OpenAI 短档 | OpenAI 长档 | API易 apiyi.com 短档 | API易 apiyi.com 长档 |
|---|---|---|---|---|
| 普通输入 | $2.00 | $4.00 | $2.00 | $3.00 |
| 缓存读取 | $0.10 | $0.20 | $0.10 | $0.15 |
| 缓存写入 | $2.50(30 分钟) | $5.00(30 分钟) | $2.50 | $3.75 |
| 输出 | $10.00 | $15.00 | $10.00 | $11.25 |
沿用 3.2 节的用量复算。270,000 输入、6,000 输出时,两个渠道都是 $0.60。280,000 输入、6,000 输出时,OpenAI 官方为 $1.21,按 API易公开公式为 (280000×3 + 6000×11.25)÷1e6 = $0.9075,每条相差约 $0.30。长文档占比越高,这个差额对月预算的影响越大。
上述差额只根据双方已公开的参数推导。前文的 Batch 和后台窗口折扣用的是 OpenAI 官方算例;在 API易调用时,账户分组、实际扣费、可用档位和 API 能力以 API易当前配置和账单为准。
4.2 一行一类任务的月度预算表
把前面的算法落到一张表上:每类任务占一行,按单次请求的平均用量填写,再乘以月请求数。工作流中有多次模型调用(例如 Agent 的多步推理)时,每一步单独记一行,最后逐条累加。
| 任务类型 | 月请求数 | 平均普通输入 | 平均缓存读取 | 缓存写入(档位) | 平均计费输出 | 上下文档 | 服务档 | 另计费用(工具 / 区域) | 预计重试率 | 月费用 |
|---|---|---|---|---|---|---|---|---|---|---|
| 客服交互 | 2,000 | 20,000 | 0 | 0 | 3,000 | 短 | Standard | 无 | 0% | $140 |
| 夜间分类 | 10,000 | 50,000 | 0 | 0 | 4,000 | 短 | Batch | 无 | 0% | $700 |
| 合同审阅 | 按实际填写 | 按实际填写 | 6,000 | 长 | Standard | 按实际填写 | 按实际填写 |
前两行的数字来自本文的算例,可以作为填写参照。月费用的计算公式是“单次模型费 × 月请求数 × (1 + 重试率) + 另计费用”。其中,单次模型费要按该行的上下文档和服务档,从第 1 节的费率表中取值。
🚀 落地建议:预算表填完后,挑出金额最高的两类任务,在 API易 apiyi.com 上用真实请求各跑一轮,拿
usage实测值替换估算值,就是一份可以交给财务的预算。
4.3 检验预算是否可靠
拿到第一个月的账单后,逐行核对三件事。
- 实际输入分布中,超过 272K 的请求占比是否接近预估。
output_tokens中推理 token 的占比是否明显高于测试阶段。- 重试和工具调用的实际次数是否被计入。
三项的偏差都在一成以内,下个月就可以直接沿用这张表;偏差更大的那一项,就是需要优先调整用量或档位的地方。
参考资料
- OpenAI 官方 API 定价:各服务档倍率与 Batch、后台窗口折扣
- 链接:
developers.openai.com/api/docs/pricing
- 链接:
- GPT-6.2 Sol 模型卡:上下文窗口、272K 切档规则与限额
- 链接:
developers.openai.com/api/docs/models/gpt-6.2-sol
- 链接:
- 后台模式与 Batch API 指南:完成窗口、非流式要求与队列额度
- 链接:
developers.openai.com/api/docs/guides/background、developers.openai.com/api/docs/guides/batch
- 链接:
- API易模型总表与公开定价接口:
gpt-6.2-sol挂牌入口与切档计价表达式- 链接:
docs.apiyi.com/models.md、api.apiyi.com/api/pricing
- 链接:
作者:APIYI 技术团队
技术交流:计费口径和账户配置相关的问题,可在 API易官网首页联系我们,更多接入资料见 docs.apiyi.com 文档中心