Autorhinweis: Nach Aufgaben aufgeschlüsselt zeigt dieser Beitrag die von Tencent selbst gemeldeten Scores, die Kosten pro Aufgabe, den offiziellen Preis und den APIYI-Kanalpreis von Hy4 flash und DeepSeek-V4.1-Flash-1017 – damit du entscheiden kannst, ob sich ein Wechsel bei alltäglichen Aufgaben lohnt.
Am 16. November 2026 veröffentlichte Tencent Hunyuan Hy4 flash. Im offiziellen Beitrag wird es als „das günstigste Modell für den täglichen Produktivitätseinsatz“ bezeichnet. Wenn du derzeit DeepSeek-V4.1-Flash-1017 verwendest, willst du wissen, ob sich ein Umstieg für alltägliche Aufgaben lohnt. Dieser Artikel stellt beide anhand derselben Aufgabengruppe gegenüber: Wer die höheren Scores erzielt, wer die niedrigeren Kosten pro Aufgabe hat und auf welcher Stufe der offizielle Preis bzw. der APIYI-Preis jeweils liegt.
Dies ist kein Beitrag nach dem Motto „Das neue Modell gewinnt überall“. Die im Text genannten Blindtests, WorkIndex-Werte, Scores aus dem Anhang und Produktaussagen stammen alle von der Tencent-Forschungsseite; es handelt sich um von Tencent selbst gemeldete Angaben, nicht um Daten, die der Autor dieses Artikels selbst erhoben hat. Nach Aufgaben betrachtet ist das Fazit eindeutig: Bei gemeinsamem Schreiben im Büro und bei visueller Fragebeantwortung lässt sich den Tencent-Anhang-Angaben zufolge der Kostenvorteil von Hy4 flash ablesen; bei Terminal-Bench 4.0, ProgramBench, DeepSWE und dem Reparieren von PPT-Folien liegen die Scores weiterhin bei DeepSeek höher.
Der zentrale Nutzen: Nach dem Lesen dieses Artikels kannst du je nach Aufgabentyp entscheiden, welche Anfragen du auf Hy4 flash umstellst und welche du bei DeepSeek V4.1 Flash belässt – und du kannst einordnen, woher jede einzelne Preisangabe stammt.
Hy4 flash im Vergleich zu DeepSeek V4.1 Flash: die zentralen Unterschiede
Zuerst ein Blick auf die Basisspezifikationen der beiden Modelle. Die Angaben zu Hy4 flash stammen von der Tencent-Forschungsseite: 224B Gesamtparameter, davon 64B Engram-Parameter, mit 12B aktivierten Parametern pro Token. Das Modell ist von Haus aus multimodal und hat ein Kontextfenster von 1M Token. Die Angaben zu DeepSeek V4.1 Flash stammen von der offiziellen DeepSeek-Preisseite: Der Aufrufname lautet deepseek-flash, die aktuelle Version ist DeepSeek-V4.1-Flash-1017, der Kontext umfasst 1M Token, die maximale Ausgabe 384K. Das Modell bietet visuelle Fähigkeiten und stellt sowohl Schnittstellen im OpenAI-Format als auch im Anthropic-Format bereit.
Auch die Positionierung unterscheidet sich. Die Tencent-Forschungsseite empfiehlt Hy4 flash für Alltagsaufgaben wie tiefgehende Suche, Dokumentenverarbeitung, das Erstellen von Präsentationsfolien, einfache Frontend-Demos und Computerbedienung. Für komplexe Workloads, insbesondere langlaufende Software-Engineering-Projekte, empfiehlt Tencent selbst, weiterhin Hy4 zu verwenden. DeepSeek V4.1 Flash ist ein allgemeines Modell der Flash-Klasse; der Reasoning-Modus ist standardmäßig aktiv und kann auch deaktiviert werden.
| Vergleichsdimension | Hy4 flash | DeepSeek V4.1 Flash (1017) | Verfügbare Plattform |
|---|---|---|---|
| Parameterumfang | 224B Gesamtparameter, 12B aktiviert (Forschungsseite) | Auf der offiziellen Preisseite nicht angegeben | — |
| Kontext | 1M Token | 1M, maximale Ausgabe 384K | — |
| Multimodalität | Nativ multimodal | Unterstützt Vision | — |
| Protokoll | Forschungsseite nennt keine API-Modell-ID | OpenAI-Format, Anthropic-Format | — |
| Offizielle Kanäle | Tencent Cloud TokenHub, WorkBuddy, Yuanbao u. a.; OpenRouter folgt in Kürze | Offizielle DeepSeek-API | — |
| APIYI-Status | Noch nicht gelistet | Bereits gelistet, u. a. deepseek-v4.1-flash |
APIYI apiyi.com |
Wichtig: Die Forschungsseite nennt keine API-Modell-ID für Hy4 flash. Dieser Artikel erfindet keine ID. Bei Aufrufen über Tencent Cloud gilt der Name, der in der TokenHub-Konsole angezeigt wird.
Warum Hy4 flash günstig ist: die technische Erklärung der Forschungsseite
Die Forschungsseite beschreibt drei Hebel zur Kostensenkung. Beim Pretraining kamen hybrid attention, LatentMoE und Engram zum Einsatz; der KV-Cache beträgt 1/24 desjenigen von Hy3 und 1/6 desjenigen von Hy4. Beim Post-Training kam Self-Distillation aus Hy4 zum Einsatz; durch Reinforcement Learning sank die durchschnittliche End-to-End-Ausgabelänge um 50 % Token. In der Inferenz kommen Megakernel, 4-Bit-Quantisierung und DFly zum Einsatz; die Dekodiergeschwindigkeit liegt über 150 Token/s.
All diese Punkte laufen auf dasselbe hinaus: Pro Aufgabe fallen weniger Token an, jedes Token ist günstiger und die Verarbeitung ist schneller. Das erklärt auch, warum Hy4 flash im Anhang in fast jeder Zelle günstigere Kosten als DeepSeek aufweist. Niedrige Kosten bedeuten jedoch nicht automatisch bessere Ergebnisse – deshalb schauen wir uns die Aufgaben im Einzelnen an.
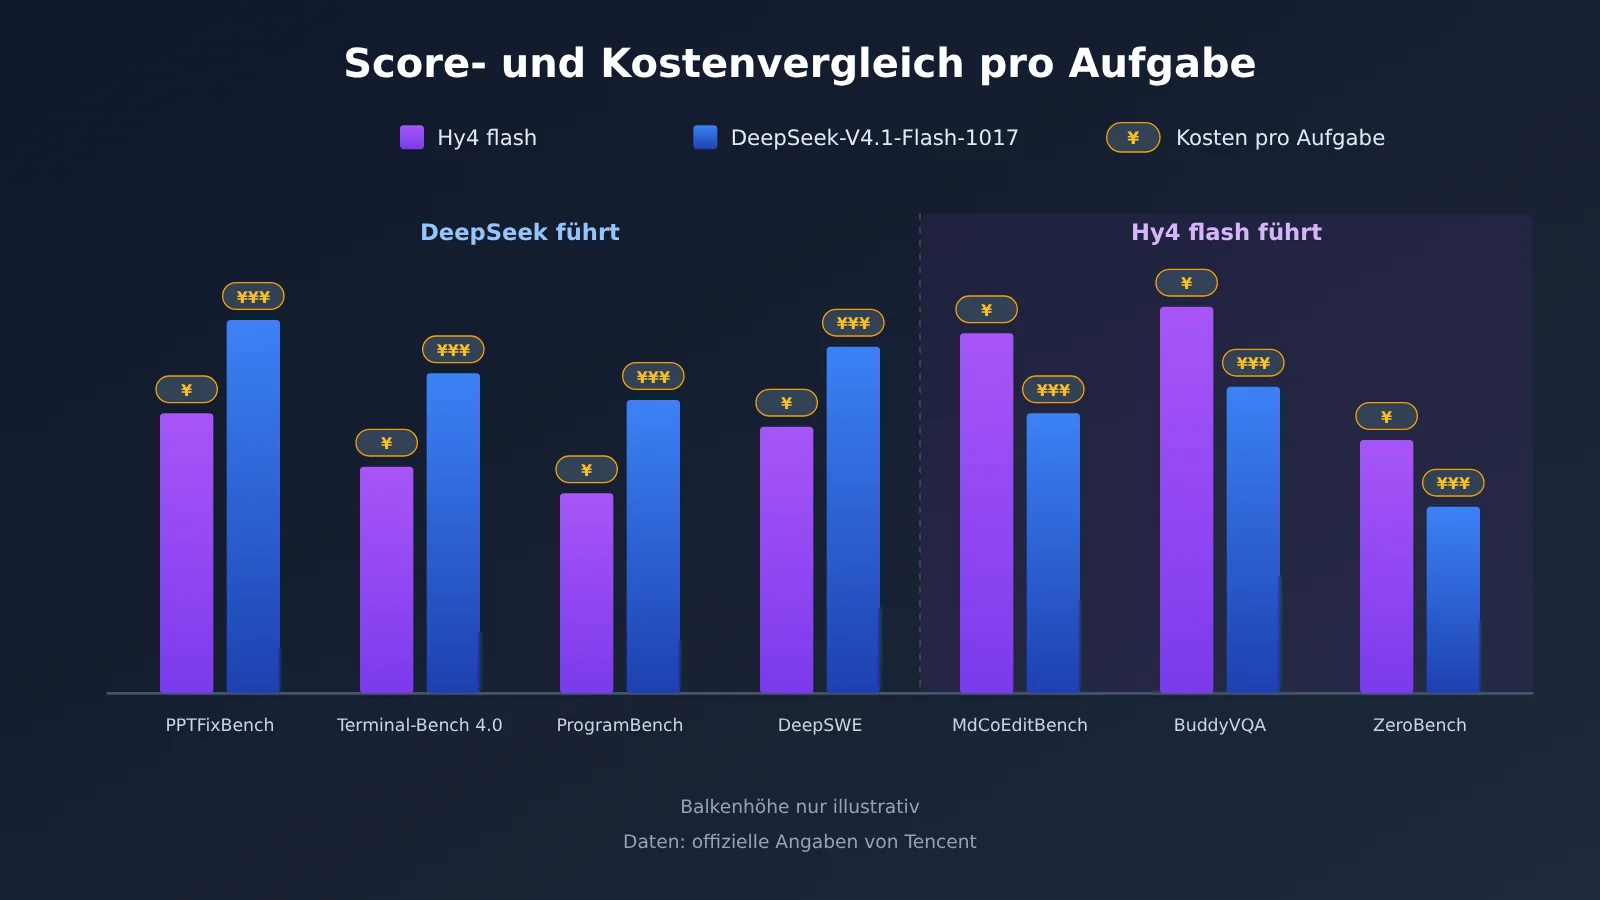
Die Diagrammdaten stammen aus dem Anhang der Tencent-Forschungsseite zu Hy4 flash (von Tencent selbst gemeldete Angaben). Die aktuellen Preise der einzelnen DeepSeek-Zugänge lassen sich auf der Preisseite von apiyi.com Punkt für Punkt prüfen.
Blindtestdaten: Hy4 flash im Vergleich zu DeepSeek V4.1 Flash
Die Tencent-Forschungsseite hat eine manuelle Blindtestreihe veröffentlicht: 85 interne WorkBuddy-Nutzer, 259 Aufgaben und 27 Kategorien. Die drei Spalten der folgenden Tabelle zeigen die Zufriedenheit auf einer 4-Punkte-Skala, die Median-End-to-End-Zeit und die Kosten pro Aufgabe (CNY). Alle Werte stammen unverändert von der Forschungsseite.
| Modell | Zufriedenheit (4-Punkte-Skala) | Median-End-to-End-Zeit | Kosten pro Aufgabe (CNY) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3.09 | 10.3 Minuten | 1.20 |
| Hy4 flash (Stufe nicht angegeben) | 2.79 | 6.7 Minuten | 0.26 |
| Claude-Haiku-5.5 (high) | 2.81 | 6.8 Minuten | 4.73 |
| GLM-5.3-Flash (high) | 2.53 | 7.6 Minuten | 0.81 |
Bei dieser Tabelle sind drei Punkte entscheidend. Erstens erzielt DeepSeek mit 3.09 die höchste Zufriedenheit; Hy4 flash liegt bei 2.79. Man sollte diesen Blindtest also nicht so deuten, dass Hy4 flash besser funktioniert. Zweitens liegt Hy4 flash 0.02 Punkte unter Claude Haiku 5.5; die Forschungsseite verwendet dafür den Begriff „close to“ (nahe dran), nicht „übertrifft“. Drittens ergibt sich die in offiziellen Beiträgen genannte „18-fache Senkung der Aufgabenkosten“ aus 4.73 geteilt durch 0.26, was rund 18.2 entspricht. Verglichen wird dabei mit Haiku, nicht mit DeepSeek.
Wirklich vorne liegt Hy4 flash in dieser Tabelle bei Zeit und Kosten. Die Median-Fertigstellungszeit beträgt 6.7 Minuten, bei DeepSeek sind es 10.3 Minuten; die Kosten pro Aufgabe liegen bei 0.26 CNY gegenüber 1.20 CNY. Wenn in Ihrem Geschäft vor allem Wartezeit und Rechnung zählen und Sie eine etwas niedrigere Zufriedenheit akzeptieren können, dann sind diese Daten für Sie relevant.
Darüber hinaus enthält die Forschungsseite eine Zusammenfassung auf WorkIndex-Ebene.
Auf WorkIndex-Ebene betragen die durchschnittlichen Kosten pro Aufgabe bei Hy4 flash 1/8 der Kosten von DeepSeek-V4.1-Flash-1017 (Max-Stufe, Spitzenlastpreis).
Dieses 1/8 gilt nur für WorkIndex; die Berechnungsgrundlage ist die höchste DeepSeek-Stufe plus Spitzenlastpreis. Es darf nicht als Ersatz für die Renminbi-Beträge in der Blindtest-Tabelle verwendet werden. WorkIndex besteht aus 8 internen Sets und deckt Foliengenerierung, Folienbearbeitung, gemeinsames Schreiben von Folien durch Mensch und KI, gemeinsames Schreiben von Markdown durch Mensch und KI, Dokumentbearbeitung, Tabellenreparatur, Audio-/Video-Verarbeitung und visuelles Verständnis ab. Es handelt sich um eine von Tencent selbst entwickelte Evaluierung, nicht um einen Rang in einem öffentlichen Benchmark.
Hy4 flash im Vergleich zu DeepSeek V4.1 Flash: Aufgabenvergleich im Anhang
Der Anhang der Forschungsseite gibt für jede Aufgabe die Punktzahl und die Kosten pro Aufgabe an. Die Kosten werden nach den offiziellen API-Preisen der jeweiligen Modelle berechnet, wobei 1 US-Dollar mit 7,2 Yuan umgerechnet wird. In der DeepSeek-Spalte wird der Spitzenpreis verwendet, also 2 Yuan pro Million Token für die Eingabe, 0,04 Yuan für Cache-Treffer und 8 Yuan für die Ausgabe. Diese Yuan-Beträge sind die Berechnungsgrundlage, die Tencent für die Tabelle verwendet hat – nicht die Preisangabe von APIYI, und sie sollten auch nicht in deine Abrechnung auf irgendeiner Plattform umgerechnet werden. Für alle Modelle wird jeweils die höchste Inferenzstufe verwendet.
| Aufgabe | Hy4 flash Punktzahl / Kosten | DeepSeek-V4.1-Flash-1017 Punktzahl / Kosten | Höhere Punktzahl |
|---|---|---|---|
| MdCoEditBench (Markdown-Co-Editing) | 56,9 / 0,057 | 29,2 / 0,194 | Hy4 flash |
| BuddyVQA Atlas (ohne Tools) | 48,5 / 0,007 | 43,7 / 0,059 | Hy4 flash |
| ZeroBench-main (mit Tools) | 45,8 / 0,077 | 16,5 / 0,095 | Hy4 flash |
| PPTCoEditBench (Folien-Co-Editing) | 74,0 / 0,105 | 76,8 / 0,459 | DeepSeek |
| PPTFixBench (PPT-Reparatur) | 23,7 / 0,253 | 45,3 / 1,672 | DeepSeek |
| DeepSWE v1.1 | 64,6 / 0,290 | 73,8 / 1,304 | DeepSeek |
| ProgramBench (almost solved) | 16,0 / 0,561 | 29,0 / 9,214 | DeepSeek |
| Terminal-Bench 4.0 | 19,2 / 0,558 | 40,0 / 3,882 | DeepSeek |
| OSWorld 2.1 (partial score) | 68,1 / 0,451 | 68,4 / 2,073 | im Wesentlichen gleichauf |
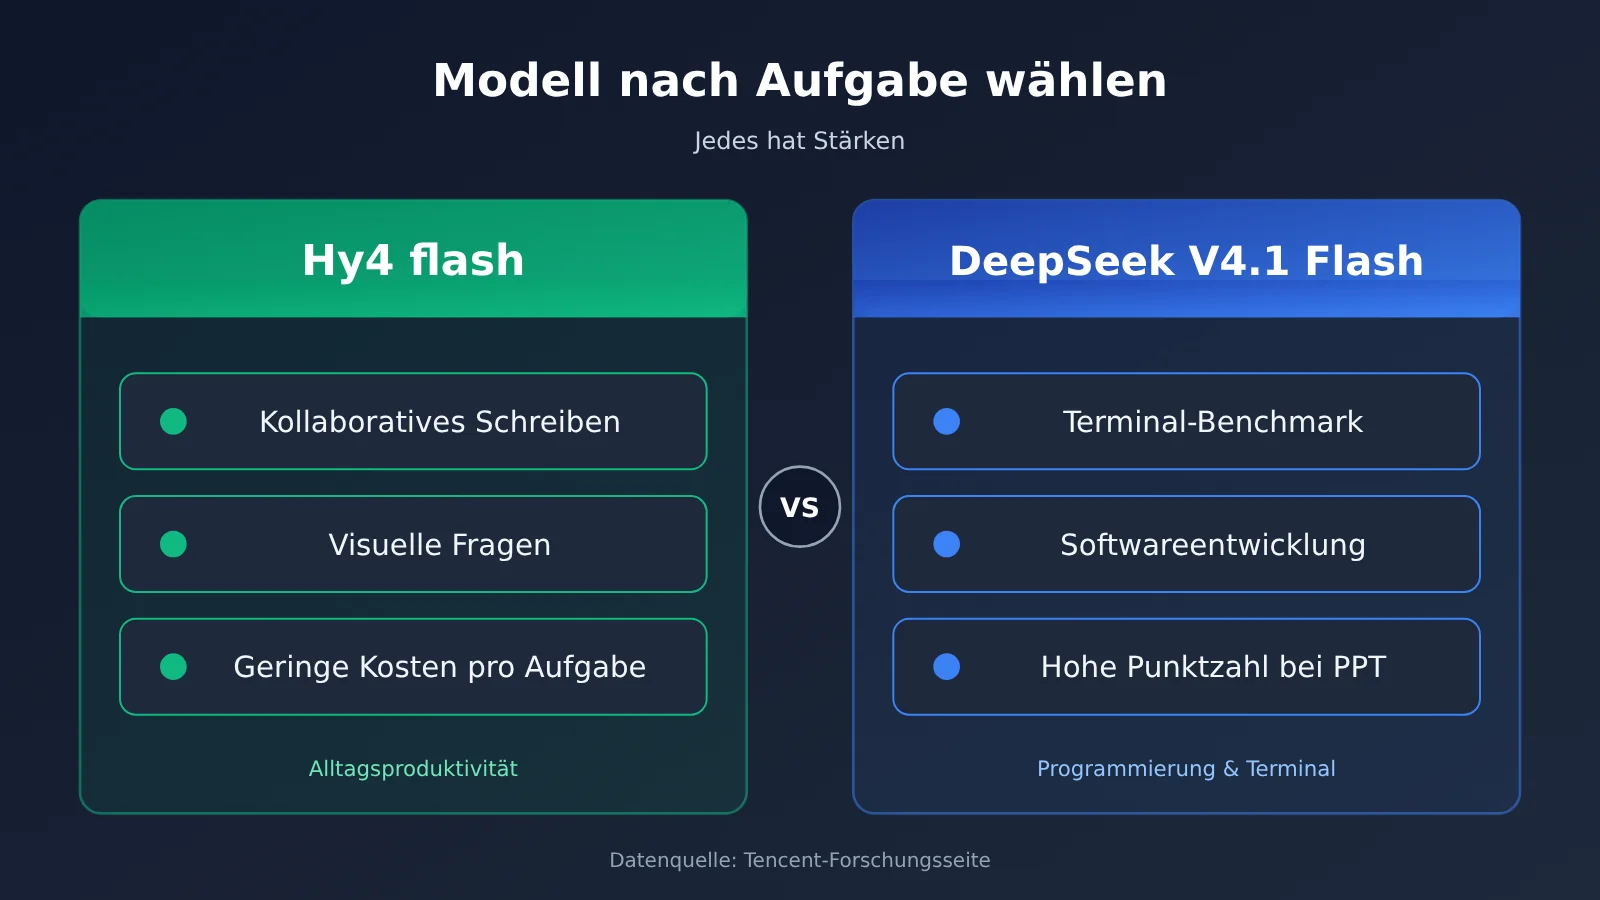
Aus der Tabelle lassen sich direkt zwei Aufgabenkategorien ablesen. Auf der Seite des Office-Co-Editing und der visuellen Fragebeantwortung erzielt Hy4 flash beim Markdown-Co-Editing, bei BuddyVQA und bei ZeroBench höhere Punktzahlen – und das zu niedrigeren Kosten. Beim Folien-Co-Editing steht es 74,0 zu 76,8; der Unterschied ist nicht groß, aber die Kosten betragen nur etwa ein Viertel von DeepSeek.
Auf der Seite von Engineering und Reparatur ist der Punktvorteil von DeepSeek deutlich. Terminal-Bench 4.0 steht bei 40,0 zu 19,2, ProgramBench bei 29,0 zu 16,0, DeepSWE bei 73,8 zu 64,6 und die PPT-Reparatur bei 45,3 zu 23,7. Auch bei den übrigen Punkten im Anhang – darunter PPTGenBench, WordEditBench, ExcelFixBench, AudioVideoBench, APEX-Agents, AutomationBench, HLE und MMMU-Pro – liegt DeepSeek leicht oder deutlich vorn; der Vorteil von Hy4 flash liegt bei diesen Punkten ausschließlich in den Kosten.
Zur Testmethode von Terminal-Bench 4.0 heißt es auf der Forschungsseite, dass der Claude Code harness verwendet wird, mit maximal 500 Runden, einer maximalen Dauer von 13 Stunden pro Durchlauf, 16 CPUs und 32 GB Speicher; für die drei GPU-abhängigen Aufgaben kommt zusätzlich eine H100 hinzu. All das sind die Evaluierungseinstellungen von Tencent und keine offiziellen Platzierungen in einer finalen Rangliste.
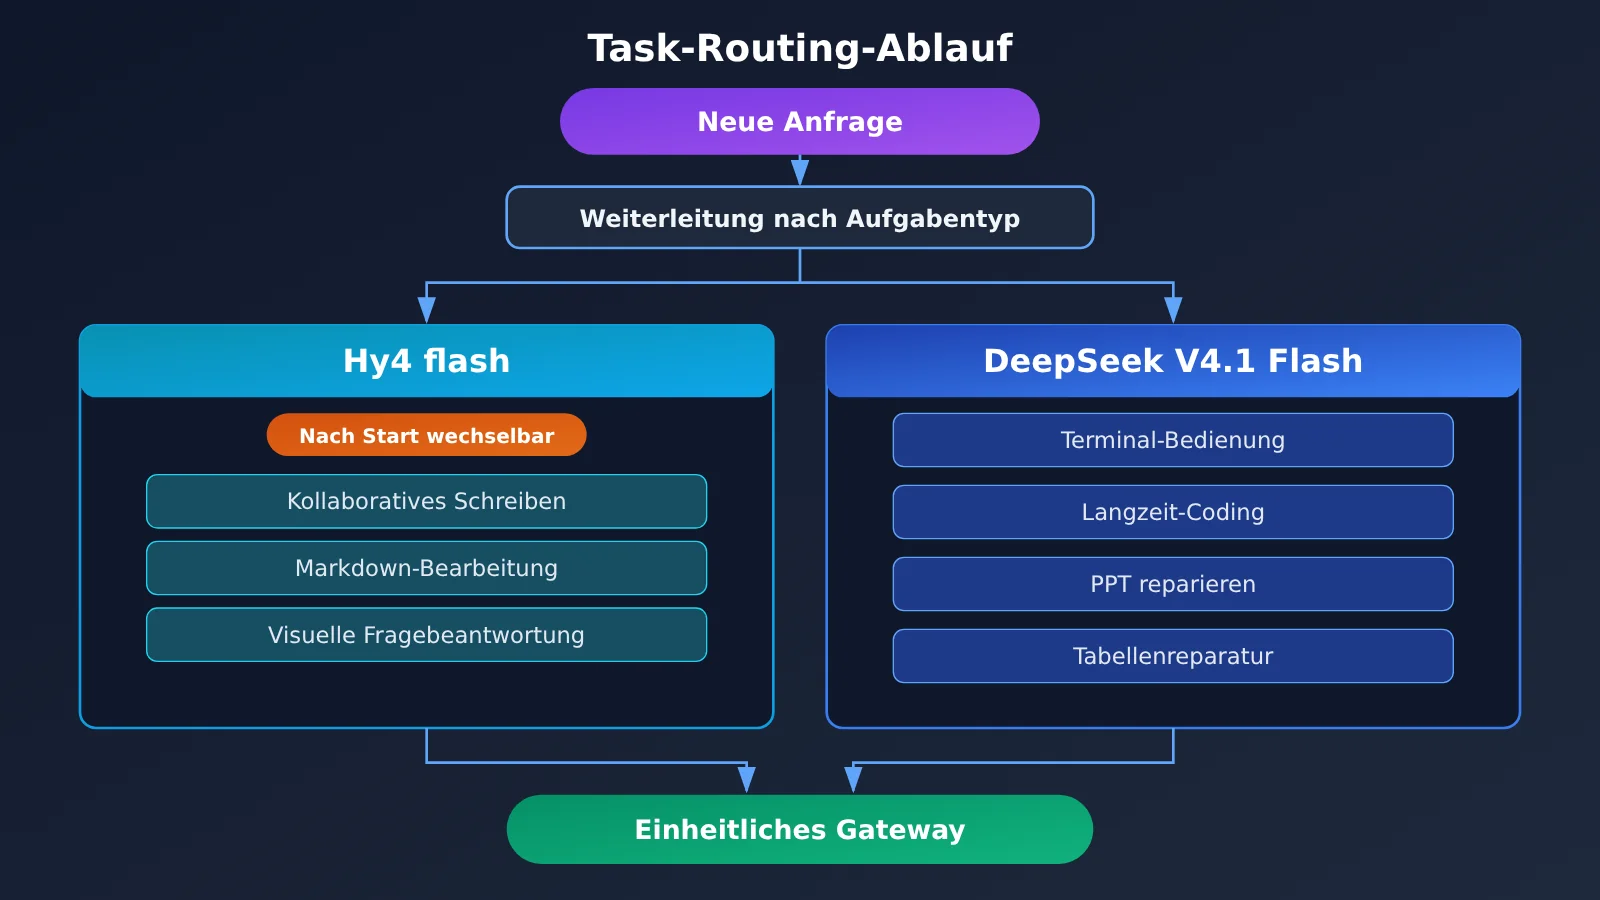
Selbstauskunft der Produktteams: Vergleichsszenarien mit DeepSeek
Die Studienseite enthält außerdem Aussagen von Tencent-internen Produktteams. Alle folgenden Angaben sind Selbstdarstellungen der Produktteams und keine unabhängigen Tests. WeChat Pay gibt an, dass im Vergleich zu DeepSeek-V4.1-Flash-1017 die Durchschnittsbewertung über vier Workflows gleichauf oder höher liegt, die Zahl der Ausführungsschritte um etwa 6 % und die Ausgabelänge pro Turn um etwa 29 % niedriger sind. Marvis gibt an, dass die Zufriedenheit bei App-Installation, Systemeinstellungen und Diagnose sowie bei Dokumenten und Forschungsberichten um 6,2 %, 4,4 % bzw. 6,9 % höher liegt, die Gesamtzufriedenheit aber gleich bleibt.
Das QQ-Team nennt als Vergleichsobjekt DeepSeek-V4.1-Flash, ohne die Versionskennung 1017 zu nennen. Laut seiner Darstellung liegt die Rate der zufriedenstellenden Antworten in Szenarien wie Musikempfehlungen und Kanalinteraktion um 0,92 bis 6,16 Prozentpunkte höher, und die P90-Latenz bei Kommentaren ist um 39 % geringer. Das Honor-of-Kings-Team gibt an, die Ursachenlokalisierung sei vergleichbar, die Modellanfragen seien um 22,0 % bis 39,1 % niedriger, dafür fielen aber mehr Tool-Aufrufe an. Diese Aussagen betreffen überwiegend Dialog, Begleitung und leichtgewichtige Workflows und decken sich mit der Schlussfolgerung im Anhang, dass sich bei Alltagsaufgaben Kosten sparen lassen, bei aufwendiger Engineering-Arbeit aber weiterhin DeepSeek gefragt ist.
Die Preise müssen in drei Blöcken beschrieben werden, jeweils mit Quellenangabe, und dürfen nicht vermischt werden. Die Einheit ist überall US-Dollar pro Million Token.
Offizieller DeepSeek-Preis (DeepSeek-Preisseite, abgerufen am 16.11.2026) ist in zwei Stufen unterteilt: Hauptverkehrszeit und Nebenzeit. Die Hauptverkehrszeit ist Montag bis Freitag UTC 01:00–04:00 und 06:00–10:00, umgerechnet in Pekinger Zeit etwa 9:00–12:00 und 14:00–18:00, ohne chinesische gesetzliche Feiertage. Alle übrigen Zeiten sind Nebenzeit, einschließlich Wochenenden und ganzer Feiertage; der Nebenzeitpreis beträgt die Hälfte des Hauptverkehrszeitpreises. Der Nebenzeitpreis gilt nur für die offizielle DeepSeek-API.
APIYI-Kanalpreise (Abfrage am 16.11.2026). Für Modelle, die bereits bei APIYI gelistet sind, verwendet man den Schlüssel von apiyi.com und sendet Anfragen an https://api.apiyi.com/v1. Die relevanten DeepSeek-Einträge verteilen sich auf drei Kanäle: Der Hauptkanal umfasst deepseek-v4.1-flash, deepseek-v4.1-flash-1017 und deepseek-flash, der Preis entspricht dem offiziellen DeepSeek-Hauptverkehrszeitpreis; die beiden anderen sind eigenständige Kanäle deepseek-v4-1-flash-260910 und die Economy-Version deepseek-v4-1-flash-economy-261017, die nicht als Preis für das eine Modell 1017 gelten dürfen.
Der Listenpreis auf der Hy4-flash-Forschungsseite ist der auf der Tencent-Forschungsseite veröffentlichte Preis, nicht der APIYI-Listenpreis. Tencent Cloud TokenHub gewährt bis zum 30.11.2026 50 % Rabatt; die Forschungsseite druckt keine separate Tabelle mit rabattierten Preisen. Die rabattierten Zahlen in der folgenden Tabelle sind eine Hochrechnung aus dem Listenpreis geteilt durch 2; nach dem 30. November gilt wieder der Listenpreis.
| Quelle / Modell | Cache-Input | Input | Output |
|---|---|---|---|
| DeepSeek offiziell · Hauptverkehrszeit | 0.006 | 0.30 | 1.20 |
| DeepSeek offiziell · Nebenzeit | 0.003 | 0.15 | 0.60 |
APIYI · deepseek-v4.1-flash / -1017 / deepseek-flash |
0.006 | 0.30 | 1.20 |
APIYI · deepseek-v4-1-flash-260910 (weiterer Kanal) |
0.003 | 0.15 | 0.60 |
APIYI · deepseek-v4-1-flash-economy-261017 (Economy-Version) |
0.006 | 0.24 | 0.96 |
| Hy4 flash Listenpreis der Forschungsseite | 0.003 | 0.070 | 0.281 |
| Hy4 flash TokenHub 50 % Rabatt (berechnet, bis 30.11.) | 0.0015 | 0.035 | 0.1405 |
Bei APIYI entspricht der Preis des Hauptkanals dem offiziellen DeepSeek-Hauptverkehrszeitpreis, nicht dem Nebenzeitpreis. Wenn Sie heute aufrufen möchten, empfehlen wir deepseek-v4.1-flash oder deepseek-v4.1-flash-1017. Beide kosten gleich viel, der Unterschied liegt in der Gruppierung: Ersteres hat die Gruppen ClaudeCode, CodexResponses, Default und SVIP, letzteres hat kein CodexResponses. Beide unterstützen den chat-Endpunkt, deepseek-v4.1-flash unterstützt zusätzlich den messages-Endpunkt.
Hy4 flash ist noch nicht gelistet; wir werden dieses Modell so bald wie möglich aufnehmen. Modell und Preis richten sich nach der Modellliste der Plattform. Außerdem ist hy4 bei APIYI das Modell Hy4, nicht Hy4 flash; der Listenpreis beträgt Input 0.85, Output 2.55 und Cache-Lesen 0.045, während der Hy4-Listenpreis auf der Forschungsseite 0.834, 2.501 und 0.042 beträgt – das sind zwei verschiedene Zahlensätze, die jeweils nach ihrer eigenen Quelle gelten.
Hy4 flash vs. DeepSeek V4.1 Flash: Szenario-Empfehlungen
Betrachtet man Blindtest, Anhang und Preise gemeinsam, lässt sich die Auswahl nach Aufgabentyp aufteilen, statt pauschal eines von beiden zu wählen.
Szenarien, in denen der Wechsel zu Hy4 flash sinnvoll ist (nach Markteinführung)
- Gemeinsames Schreiben von Markdown und Dokumenten: Im Anhang MdCoEditBench 56.9 gegenüber 29.2, Kosten 0.057 Yuan gegenüber 0.194 Yuan.
- Visuelle Fragebeantwortung: Bei BuddyVQA und ZeroBench erzielt Hy4 flash höhere Werte und verursacht auch niedrigere Kosten pro Aufgabe.
- Gemeinsames Erstellen von Präsentationen: Die Punktzahl liegt etwas unter DeepSeek, aber die Kosten betragen etwa ein Viertel; geeignet für die Massenerstellung von Entwürfen.
- Leichte, wartezeitempfindliche Aufgaben: Die mediane Fertigstellungszeit im Blindtest beträgt 6.7 Minuten und ist damit kürzer als die 10.3 Minuten von DeepSeek.
Szenarien, in denen man bei DeepSeek V4.1 Flash bleiben sollte
- Terminal-basierte Agenten: Terminal-Bench 4.0 40.0 gegenüber 19.2, etwa doppelt so hoch.
- Softwareentwicklung und Long-Horizon-Coding: ProgramBench und DeepSWE sind bei DeepSeek höher; Tencent selbst empfiehlt für komplexe Engineering-Aufgaben ein höherwertiges Modell.
- Reparaturaufgaben in Office: PPT-Reparatur 45.3 gegenüber 23.7, Tabellenreparatur 20.0 gegenüber 15.6.
- Allgemeine Deliverables mit hohen Zufriedenheitsanforderungen: Die Zufriedenheit im Blindtest liegt mit 3.09 an der Spitze der gesamten Tabelle.
| Aufgabentyp | Empfohlenes Modell | Grundlage (von Tencent selbst angegeben) |
|---|---|---|
| Gemeinsames Schreiben von Markdown / Dokumenten | Hy4 flash | Höherer MdCoEditBench-Wert, niedrigere Kosten |
| Visuelle Fragebeantwortung | Hy4 flash | Höhere Werte bei BuddyVQA und ZeroBench |
| Massenerstellung von Präsentationsentwürfen | Hy4 flash | Geringer Punktabstand, Kosten etwa ein Viertel |
| Terminal-/Kommandozeilen-Agenten | DeepSeek V4.1 Flash | Terminal-Bench 4.0 etwa doppelt so hoch |
| Coding und Reparatur | DeepSeek V4.1 Flash | ProgramBench, DeepSWE und PPTFix höher |
Hy4 flash vs. DeepSeek V4.1 Flash: Empfehlung für die Entscheidung
💡 Auswahl-Empfehlung: Wenn in deinen Anfragen der Anteil an Engineering- und Terminal-Aufgaben hoch ist, bleibst du mit DeepSeek V4.1 Flash auf der sichereren Seite. Geht es überwiegend ums Schreiben, Redigieren und um Fragen zu Bildern, dann warte, bis Hy4 flash verfügbar ist, teste zuerst eine kleine Stichprobe echter Aufgaben im A/B-Vergleich und entscheide danach, welcher Anteil migriert wird.
Was du schon jetzt umsetzen kannst: ein einheitliches Gateway anbinden und den Modellnamen als Konfigurationsparameter führen. Im OpenAI-kompatiblen SDK setzt du base_url auf https://api.apiyi.com/v1 und trägst bei model deepseek-v4.1-flash-1017 ein – damit läuft deine bestehende Aufruflogik unverändert weiter. Wenn du eine Toolchain mit dem Anthropic-Messages-Protokoll verwendest, kannst du deepseek-v4.1-flash nehmen; es unterstützt sowohl den chat- als auch den messages-Endpunkt.
Sobald Hy4 flash verfügbar ist, musst du in der Routing-Tabelle nur das model-Feld für Büro-Aufgaben auf den Namen ändern, der in der Modellliste der Plattform angegeben ist – die Code-Struktur bleibt gleich. Der Vorteil: Beide Modelle lassen sich unter derselben Abrechnungslogik vergleichen, und du vermeidest es, DeepSeeks offiziellen Off-Peak-Preis, den Preis des APIYI-Kanals und die Tencent-Listenpreise in einen Topf zu werfen.
Ein Detail solltest du im Blick behalten: Bei DeepSeek halbiert sich der Preis in den Off-Peak-Zeiten, während der APIYI-Hauptkanal nach Spitzenzeittarif abrechnet. Wenn du deine Batch-Aufgaben aufs Wochenende oder in die Nacht verschieben kannst und direkt bei DeepSeek anbindest, ist der Off-Peak-Preis günstiger. Wenn dir ein einziger Schlüssel für die Verwaltung mehrerer Modelle wichtiger ist, hast du mit dem einheitlichen Gateway geringere Betriebskosten. Wäge also nach deinen Aufrufzeiten und deinen Protokollanforderungen ab.
Häufig gestellte Fragen (FAQ)
F1: Was ist Hy4 flash?
Hy4 flash ist ein Leichtgewichtsmodell, das Tencent Hunyuan am 16.11.2026 veröffentlicht hat. Laut der Forschungsseite umfasst es 224 Mrd. Gesamtparameter, aktiviert pro Token 12 Mrd. Parameter und ist von Haus aus multimodal mit einem Kontextfenster von 1 Mio. Tencent positioniert es als kostengünstige Wahl für alltägliche Produktivitätsaufgaben.
F2: Ist Hy4 flash besser nutzbar als DeepSeek V4.1 Flash?
So kann man das nicht sagen. In den von Tencent selbst gemeldeten Blindtests erreicht DeepSeek-V4.1-Flash-1017 eine Zufriedenheit von 3,09, gegenüber 2,79 bei Hy4 flash. Die Vorteile von Hy4 flash liegen in der kürzeren Bearbeitungszeit, den niedrigeren Kosten pro Aufgabe sowie in einigen höheren Punktwerten im Anhang bei gemeinsamen Markdown-Texteingaben und bei visuellen Frage-Antwort-Aufgaben.
F3: Bezieht sich die im offiziellen Beitrag genannte 18-fache Kostensenkung auf den Vergleich mit DeepSeek?
Nein. Die Zahl 18 ergibt sich aus der Blindtest-Tabelle: 4,73 Yuan für Claude Haiku 5.5 geteilt durch 0,26 Yuan für Hy4 flash. Mit DeepSeek hängt der Wert von 1/8 auf dem WorkIndex zusammen, bezogen auf die höchste DeepSeek-Stufe zuzüglich Spitzenlastpreis.
F4: Welches Modell sollte man für Terminal- und Coding-Aufgaben verwenden?
Laut dem Anhang von Tencent erzielt DeepSeek V4.1 Flash bei Terminal-Bench 4.0, ProgramBench und DeepSWE durchweg höhere Werte. Die Forschungsseite von Tencent selbst empfiehlt, für langfristiges Software-Engineering weiterhin Modelle mit höherer Intelligenz-Obergrenze zu nutzen und nicht Hy4 flash.
F5: Wie ruft man diese beiden Modelle jetzt über die API auf?
DeepSeek V4.1 Flash ist bereits bei APIYI gelistet. Nach der Registrierung auf apiyi.com und dem Abruf eines API-Schlüssels genügt es, als Modellnamen `deepseek-v4.1-flash` oder `deepseek-v4.1-flash-1017` einzutragen; neue Nutzer erhalten ein kostenloses Testkontingent. Hy4 flash ist derzeit noch nicht bei APIYI gelistet. Wer es vorab ausprobieren möchte, kann den TokenHub von Tencent Cloud nutzen, wobei der im Konsolen-Interface angezeigte Modellname maßgeblich ist.
F6: Welche Einschränkungen von Hy4 flash sollte man beachten?
Erstens: Die Forschungsseite nennt keine API-Modell-ID, die Gewichte sind als geplante Open-Source-Veröffentlichung angekündigt, und die Seite macht keine Angaben dazu, ob sie bereits freigegeben wurden. Zweitens: Der 50-prozentige Rabatt im TokenHub gilt nur bis zum 30.11.2026, danach gilt wieder der Listenpreis. Drittens: Alle Punktwerte sind von Tencent selbst gemeldet, bei Engineering-, Terminal- und Reparaturaufgaben liegt das Modell deutlich hinter DeepSeek zurück. Vor einer Migration sollte man daher eigene Aufgabenstichproben zur Validierung verwenden.
F7: Wie schneidet es im Vergleich zu Claude Haiku 5.5 ab?
Haiku ist nicht in der Tabelle im Anhang enthalten, daher lässt sich nur der Blindtest heranziehen: Zufriedenheit 2,81 gegenüber 2,79 bei Hy4 flash, Kosten pro Aufgabe 4,73 Yuan gegenüber 0,26 Yuan. Der offizielle Anthropic-Preis hat zwei Stufen: Bei Eingabeaufforderungen bis zu 100.000 Token gilt Eingabe 0,10 und Ausgabe 0,50; darüber wird die gesamte Anfrage mit Eingabe 0,50 und Ausgabe 2,50 abgerechnet. Die Übersichtstabelle von APIYI listet 0,10, 0,50 und 0,01, wobei die Fußnote nur die zweite Eingabestufe erwähnt. Für die konkrete Abrechnung sind die Plattformhinweise maßgeblich.
Hy4 flash vs. DeepSeek V4.1 Flash – die wichtigsten Erkenntnisse (Key Takeaways)
- Bei Blindtests liegt DeepSeek vorn: 3,09 zu 2,79 – Hy4 flash punktet bei Zeit und Kosten.
- WorkIndex-Kosten 1/8: Die Berechnungsgrundlage ist DeepSeeks höchste Tarifstufe plus Spitzenpreis; das gilt nur für WorkIndex.
- Büro-Co-Writing und visuelle Fragenbeantwortung: Im Anhang erzielt Hy4 flash höhere Scores bei niedrigeren Kosten pro Aufgabe.
- Terminal und Coding: DeepSeek vorn: Terminal-Bench 4.0, ProgramBench, DeepSWE und PPT-Reparatur liegen alle höher.
- Off-Peak-Preise gibt es nur bei DeepSeek direkt: Der Hauptkanal von APIYI entspricht dem offiziellen Peak-Preis.
- Heute aufrufbare Modelle:
deepseek-v4.1-flashoderdeepseek-v4.1-flash-1017; Hy4 flash steht noch nicht zur Verfügung.
Zusammenfassung
Die zentralen Schlussfolgerungen aus dem Vergleich von Hy4 flash mit DeepSeek V4.1 Flash:
- Nach Aufgaben aufteilen statt pauschal ersetzen: Für Büro-Co-Writing und visuelle Fragenbeantwortung kann man Hy4 flash ins Auge fassen; Terminal-, Coding- und Reparaturaufgaben laufen weiterhin mit DeepSeek.
- Datenquellen klar kennzeichnen: Blindtests, WorkIndex, Anhang und Erfahrungsberichte stammen allesamt aus eigenen Angaben von Tencent – vor der Migration mit eigenen Aufgabenproben gegenprüfen.
- Preisgrundlagen nicht vermischen: DeepSeek offiziell unterscheidet Peak- und Off-Peak-Preise, APIYI hat drei Kanäle, und Hy4 flash kennt nur die Listenpreise der Research-Seite plus einen zeitlich begrenzten 50-Prozent-Rabatt.
Wer bereits DeepSeek-V4.1-Flash-1017 nutzt, fährt am günstigsten damit, zuerst ein einheitliches Gateway anzubinden und den Modellnamen konfigurierbar zu machen. Sobald Hy4 flash verfügbar ist, lässt sich dann direkt ein kleiner Vergleichstest durchführen. Empfohlen wird, deepseek-v4.1-flash-1017 über APIYI apiyi.com aufzurufen und damit den bestehenden Ablauf zu verifizieren; die Plattform bietet eine OpenAI-kompatible Schnittstelle und ein kostenloses Testkontingent.
📚 Referenzmaterial
-
Tencent Hunyuan Hy4 flash Forschungsseite: Spezifikationen, Blindtests, WorkIndex, Anhang und Listenpreise
- Link:
hy.tencent.ai/research/hy4-flash - Hinweis: Alle in diesem Artikel genannten Werte und Kosten für Hy4 flash stammen aus den offiziellen Angaben von Tencent.
- Link:
-
Offizielle DeepSeek-Preisseite: Spitzen- und Nebenzeiten-Preise für DeepSeek-V4.1-Flash-1017
- Link:
api-docs.deepseek.com/quick_start/pricing - Hinweis: Enthält die Definition der Spitzenzeiten sowie Erläuterungen zu den Aufrufnamen.
- Link:
-
Offizielle Dokumentation zu Claude Haiku 5.5: Modellspezifikationen und zwei Preisstufen
- Link:
platform.claude.com/docs/en/models/haiku-5-5/overview - Hinweis: Dient zur Überprüfung des Vergleichskontexts von Haiku in der Blindtesttabelle.
- Link:
-
APIYI-Modellliste: Verfügbare Modelle, Gruppen und Endpunkte
- Link:
docs.apiyi.com/models - Hinweis: Die Verfügbarkeit von Hy4 flash und die Preise der einzelnen DeepSeek-Kanäle richten sich nach dieser Quelle.
- Link:
Autor: APIYI-Technichteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Den Fortschritt bei der Modellverfügbarkeit können Sie in den Aktualisierungen der Plattform-Modellliste verfolgen.