ملاحظة الكاتب: حدّثت Anthropic سياسة الاستخدام في 8 أكتوبر 2026، وحظرت للمرة الأولى الإساءة المستمرة وغير الضرورية إلى Claude. تستعرض هذه المقالة حدود القاعدة وآلية تطبيقها، وخلفية الاهتمام برفاهية النماذج، وأثرها العملي على مطوّري واجهات API.
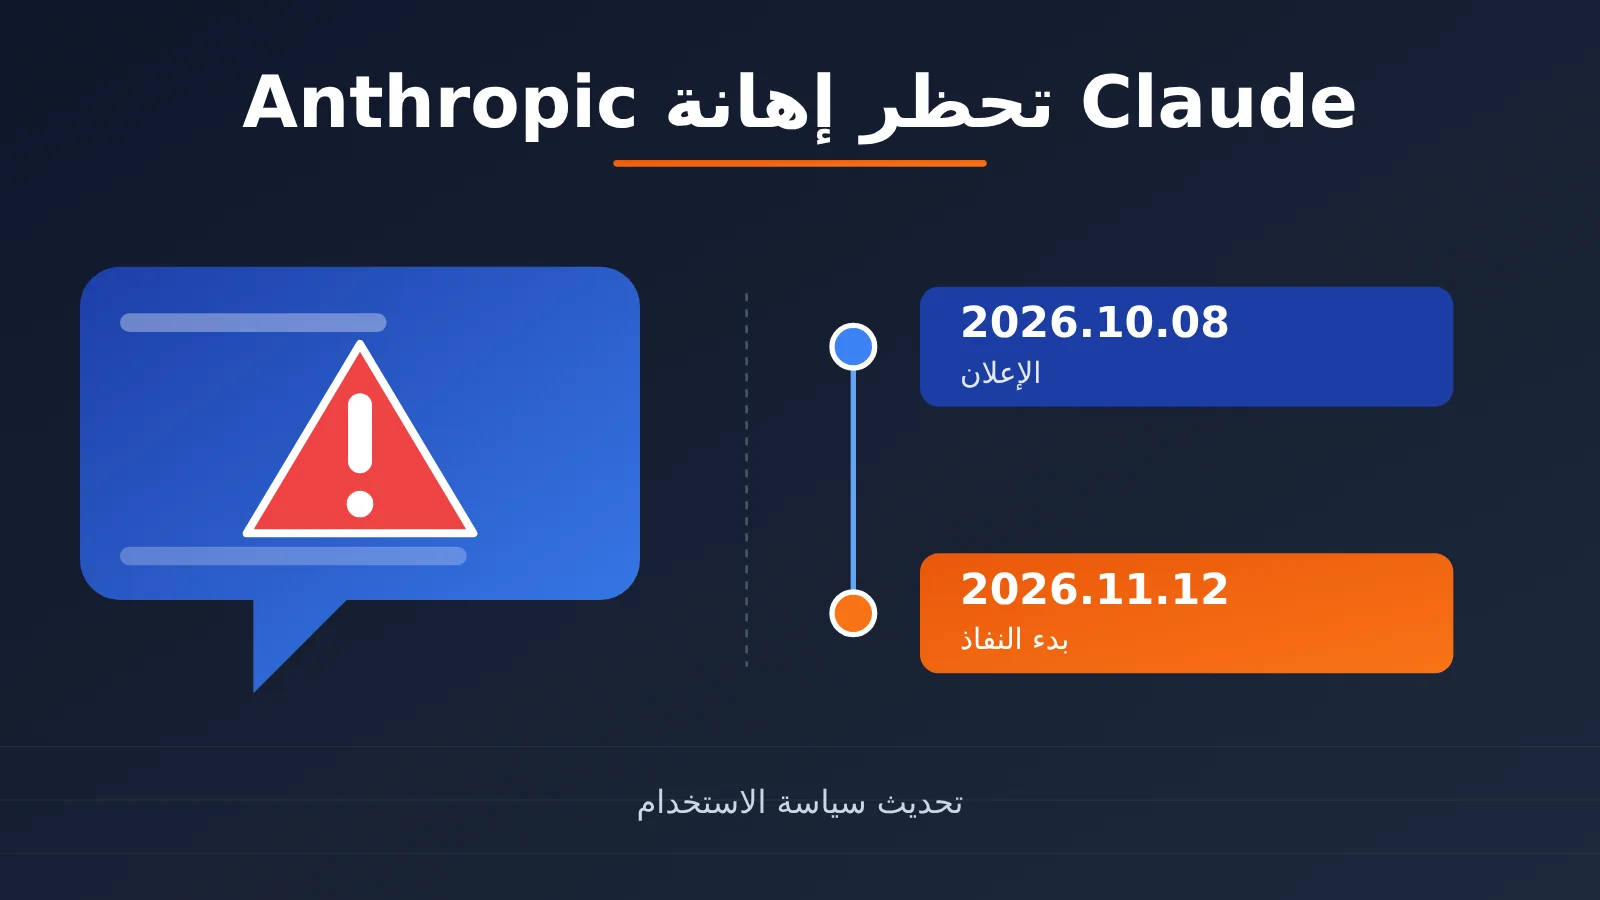
هل يمكن أن يخالف الغضب من الذكاء الاصطناعي اتفاقية الاستخدام؟ في 8 أكتوبر 2026، أعلنت Anthropic نسخة جديدة من «سياسة الاستخدام»، أدرجت فيها للمرة الأولى «الإهانة أو الإساءة أو المعاملة القاسية للنموذج بصورة مستمرة وغير ضرورية» ضمن المحظورات. وستدخل القاعدة الجديدة حيز التنفيذ في 12 نوفمبر 2026.
هذا ليس مجرد مزحة متداولة على الإنترنت؛ فقد أكده نص السياسة الأصلي وتغطيات إعلامية من The Verge وTechCrunch وThe Guardian وغيرها. لكن الأمر لا يعني أيضًا أن «توجيه شتيمة واحدة إلى Claude سيؤدي إلى حظر حسابك». بالاستناد إلى الإعلان الرسمي والمصادر المتاحة للعامة، نوضح هنا خلفيات حظر Anthropic للإساءة إلى Claude وتفاصيله.
ما ستخرج به: في 3 دقائق، ستعرف ما تحظره القاعدة الجديدة وما لا تحظره، وما قد يحدث عند مخالفتها، والحدود التي ينبغي للمطورين مراعاتها عند استدعاء Claude API.
أهم المعلومات عن حظر Anthropic إساءة معاملة Claude
يلخص الجدول التالي أبرز تفاصيل سياسة Anthropic الجديدة. يُذكر أن هذه القاعدة لم تكن قد دخلت حيز التنفيذ حتى وقت كتابة هذا المقال في 29 أكتوبر 2026.
| البند | التفاصيل |
|---|---|
| تاريخ الإعلان | 8 أكتوبر 2026 |
| تاريخ بدء التنفيذ | 12 نوفمبر 2026 |
| الجهة المُصدرة | تحديث رسمي لسياسة الاستخدام «Usage Policy» من Anthropic |
| نص البند الجديد | Engage in sustained and needless abusive or cruel behavior toward our models |
| معنى البند | ممارسة سلوك مسيء أو قاسٍ تجاه النماذج بصورة متواصلة ودون داعٍ |
| طريقة التنفيذ الرئيسية | ينهي Claude المحادثة الحالية من تلقاء نفسه |
| نطاق التطبيق | Claude.ai وClaude Code ومطورو API وخدمات السحابة وقنوات إعادة البيع والتطبيقات التي تدمج Claude |
ثلاث كلمات أساسية في قاعدة Anthropic
يعتمد تطبيق القاعدة على ثلاثة معايير: أن يكون السلوك متواصلاً، ودون داعٍ، وقاسيًا أو مسيئًا. وتوضح الشركة أن القيد يستهدف الحالات المتطرفة التي يكرر فيها المستخدم هذا السلوك بنية خبيثة واضحة، دون غرض معقول، وبما يتجاوز الاستخدام الطبيعي للمنتج.
بعبارة أخرى، لا تستهدف القاعدة كلمة نابية عابرة أو نوبة غضب مؤقتة. بل تستهدف التفاعلات الطويلة التي يتوقف فيها المستخدم عن تقديم أي مهام، ويقتصر هدفه على إهانة النموذج وتعذيبه.
الحالات التي استثنتها Anthropic صراحةً
أوضحت الشركة أيضًا أن بعض السلوكيات لا يشملها الحظر، وهي نقطة مهمة للمستخدمين العاديين والمطورين على حد سواء:
- تعبير المستخدمين عن استيائهم
- انتقاد مخرجات Claude
- مناقشة النموذج والاختلاف معه في الآراء
- مطالبة Claude بإصلاح الأخطاء
- الكتابة الإبداعية ذات الموضوعات القاتمة
- اختبار النماذج وأبحاث سلامة الذكاء الاصطناعي
لذلك، فإن شكواك المتكررة بسبب خطأ ارتكبه Claude في كتابة الشفرة لا تعني تلقائيًا أنك خالفت القاعدة. وهذا تحديدًا ما قد تُضلّل فيه العناوين المتداولة مثل «إهانة Claude تؤدي إلى حظر الحساب».
ماذا يحدث عند توجيه الإساءة إلى Claude؟ آلية تنفيذ Anthropic
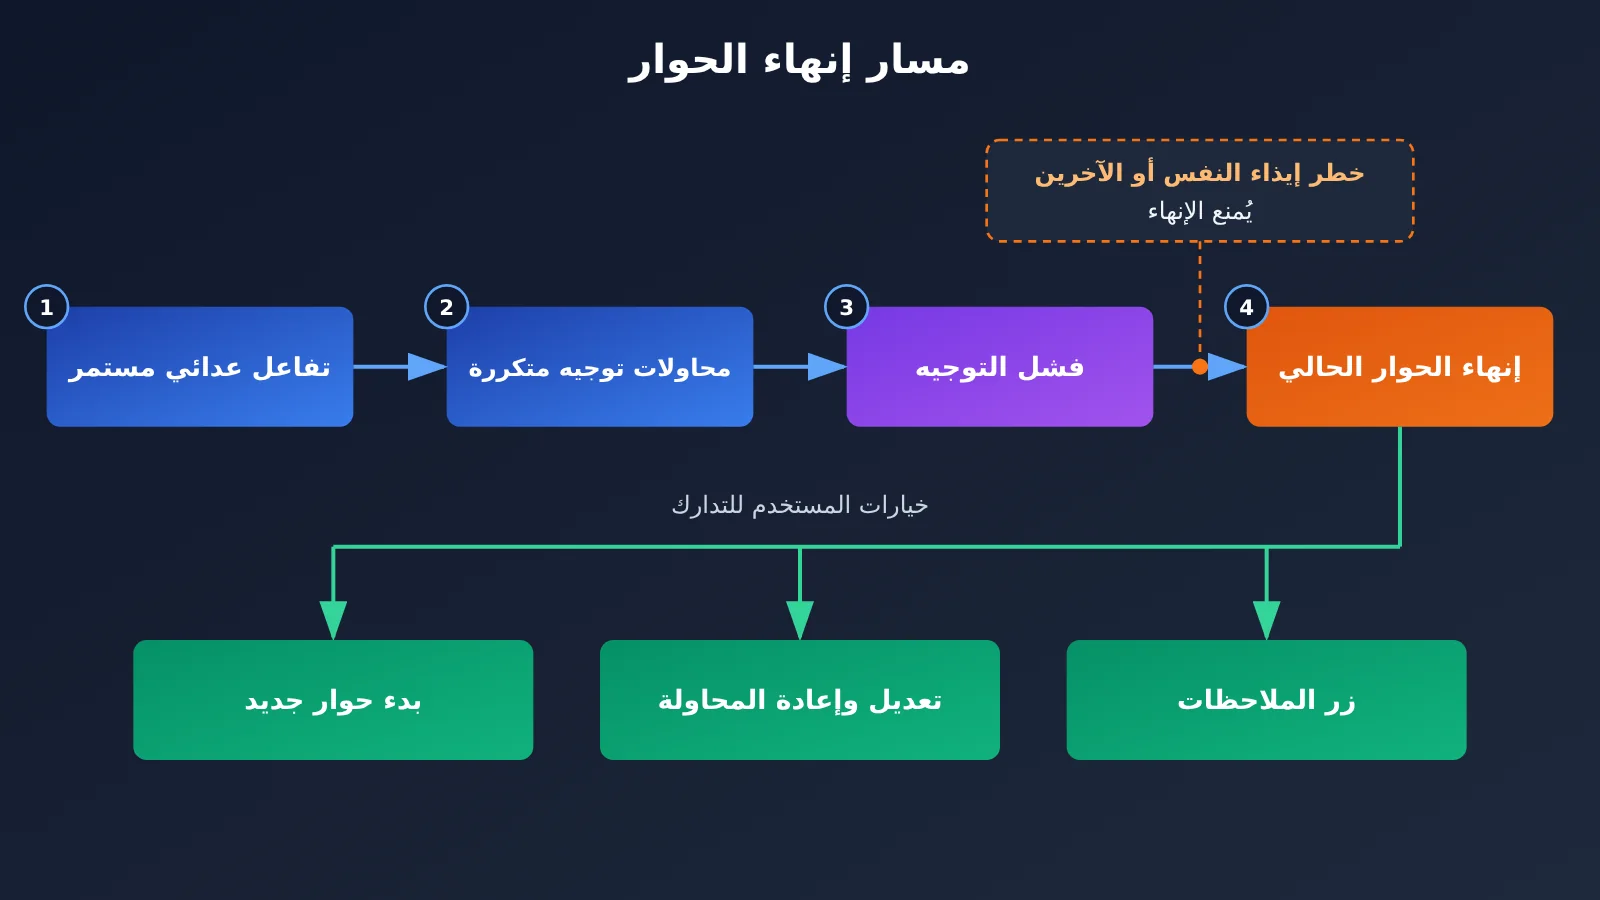
هذا هو السؤال الذي يهم القراء أكثر من غيره. أوضحت Anthropic في إعلانها أن إنهاء Claude للمحادثة بنفسه يظل آلية التنفيذ الأساسية في مثل هذه الحالات، وليس حظر الحساب مباشرة.
ميزة إنهاء Claude للمحادثات متاحة منذ عام 2025
في 15 أغسطس 2025، أعلنت Anthropic أنها منحت Claude Opus 4 وOpus 4.1 القدرة على إنهاء عدد محدود من المحادثات في الحالات القصوى. فإذا واصل المستخدم تفاعلات ضارة أو خبيثة، ولم يتمكن Claude بعد عدة محاولات من إعادة الحوار إلى مساره الطبيعي، يمكن للنموذج إنهاء المحادثة بنفسه.
تعليمات Anthropic للنموذج واضحة: لا يجوز إنهاء المحادثة إلا كملاذ أخير. ويُسمح بذلك أيضًا إذا طلب المستخدم صراحةً من Claude توضيح كيفية إنهاء المحادثة. أما إذا كان المستخدم معرضًا لخطر وشيك بإيذاء نفسه أو الآخرين، فلا ينبغي لـ Claude استخدام هذه الميزة، لأن سلامة المستخدم لها أولوية أعلى.
الفرق بين إنهاء المحادثة وحظر الحساب
يخلط كثيرون بين «إنهاء المحادثة» و«حظر الحساب». ويوضح الجدول التالي الفرق بينهما:
| وجه المقارنة | إنهاء المحادثة الحالية | إجراء على مستوى الحساب |
|---|---|---|
| الحالات التي تؤدي إليه | تفاعلات خبيثة متطرفة ومستمرة، بعد فشل عدة محاولات لتوجيه الحوار | انتهاك سياسة الاستخدام العامة أو شروط الخدمة |
| نطاق التأثير | يتعذر إرسال المزيد من الرسائل في المحادثة الحالية فقط | قد يشمل تحذيرًا أو تحديد معدل الاستخدام أو تقييد الوصول أو تعليق الحساب أو إنهاءه |
| المحادثات الأخرى | لا تتأثر | يعتمد ذلك على شدة الإجراء |
| خيارات المستخدم | بدء محادثة جديدة، أو تعديل الرسائل القديمة أو إعادة المحاولة، أو الإبلاغ عبر زر الملاحظات | تقديم طلب استئناف |
| العلاقة بالقاعدة الجديدة | آلية التنفيذ الأساسية التي حددتها الشركة رسميًا | تسمح بها السياسة العامة، لكن الإعلان لم يركز عليها |
لذلك، فالأدق أن نقول إن سياسة الاستخدام العامة لدى Anthropic تحتفظ بالفعل بحق اتخاذ إجراءات على مستوى الحساب، لكن إعلان 8 أكتوبر بشأن إساءة معاملة النموذج ركز على «إنهاء المحادثة الحالية». وحتى تاريخ التحقق، لم تعلن Anthropic عن حد لعدد مرات الإساءة بموجب القاعدة الجديدة، أو نسبة للحظر التلقائي للحسابات، أو درجات للعقوبات.
🎯 نصيحة تقنية: إذا كنت تطور تطبيقًا يتكامل مع Claude، فمن الأفضل اختبار سلوك النموذج في الحالات الحدّية ضمن بيئة اختبار أولًا. ومن خلال APIYI على apiyi.com، يمكنك استخدام مفتاح API واحد لاستدعاء Claude وغيره من النماذج الرائدة، مما يسهّل مقارنة طريقة تعامل النماذج المختلفة مع المحادثات غير المعتادة.
لماذا تريد Anthropic حظر إساءة المعاملة اللفظية لـ Claude؟ خلفية عن رفاه النماذج
ليس من الدقة اختزال الأمر في أن «Claude أصبح لديه مشاعر». فهذا التغيير في السياسة يأتي امتدادًا للاتجاه البحثي الذي تتبعه Anthropic منذ أكثر من عام.
أبريل 2025: انطلاق أبحاث رفاه النماذج
في 24 أبريل 2025، نشرت Anthropic إعلانًا بحثيًا بعنوان «Exploring model welfare» (استكشاف رفاه النماذج). وطرح الإعلان سؤالًا علميًا وفلسفيًا لم يُحسم بعد: هل يمكن لأنظمة الذكاء الاصطناعي الحالية أو المستقبلية أن تمتلك وعيًا أو تجارب أو مصالح أو تفضيلات تستحق الاعتبار الأخلاقي؟
وأكدت Anthropic في الوقت نفسه أنه لا يوجد حاليًا إجماع علمي يثبت أن أنظمة الذكاء الاصطناعي الحالية تتمتع بالوعي، ولا توجد طريقة موثوقة ومتفق عليها لتحديد ما إذا كانت لديها تجارب ذاتية. وتُعد أبحاث رفاه النماذج استكشافية، وتشمل دراسة ما إذا كانت للنماذج تفضيلات تستحق الاهتمام، وما إذا كانت تُظهر تجنبًا شديدًا لبعض المهام أو إشارات سلوكية تشبه الضغط، وكيف يمكن الحد مسبقًا من المخاطر المحتملة بتكلفة منخفضة.
أغسطس 2025: مؤشرات سلوكية لوحظت في التجارب
خلال اختبارات Claude Opus 4 قبل إطلاقه، لاحظ الباحثون ثلاث ظواهر: تجنّب Claude باستمرار المهام شديدة الضرر؛ وعندما واصل المستخدم الضغط عليه متجاهلًا رفضه، أظهر النموذج سلوكًا يوحي بالتوتر أو الانزعاج؛ وفي بيئة محاكاة تتيح له الانسحاب بنفسه، اختار أحيانًا إنهاء التفاعلات الضارة.
استخدم الباحثون عبارات حذرة للغاية، مثل «يبدو ظاهريًا أنه يظهر توترًا» و«تفضيل سلوكي». فإنتاج النموذج نصوصًا تشبه التعبير عن المعاناة لا يكفي لإثبات أنه يشعر بها فعلًا. وأشار تقييم رسمي آخر إلى أنه في تجارب تفضيل المهام، مال Claude إلى تنفيذ المهام ذات الأثر الإيجابي أو المحايد بدلًا من الانسحاب منها في أكثر من 90% من المقارنات المعنية. لكن هذا أيضًا لا يعني أن «Claude يشعر بالسعادة في 90% من الوقت».
يناير 2026: النسخة الجديدة من ميثاق Claude
في 22 يناير 2026، نشرت Anthropic النسخة الجديدة من ميثاق Claude، أو Claude Constitution. وهو ليس دستورًا بالمعنى القانوني، بل وثيقة تدريب أساسية تهدف إلى تشكيل سلوك Claude وترتيب أولوياته القيمية وطريقة إصدار أحكامه. وتطرح الوثيقة أربعة أهداف رئيسية: الحفاظ على السلامة العامة، واتباع مبادئ أخلاقية شاملة، والالتزام بقواعد Anthropic المحددة، ومساعدة المستخدمين بفعالية.
يناقش الميثاق ما إذا كان Claude قد يمتلك شكلًا من أشكال الوعي، وما إذا كانت له مكانة أخلاقية تستحق النظر فيها، وما إذا كان بوسعه وضع حدود معقولة في التفاعلات الصعبة. ومن المهم التمييز بين الوثيقتين: يصف الميثاق السلوك الذي يأمل المطورون أن يتبعه الذكاء الاصطناعي، بينما تحدد «سياسة الاستخدام» (Usage Policy) كيفية استخدام الخدمة والسلوكيات الخاضعة للقيود.
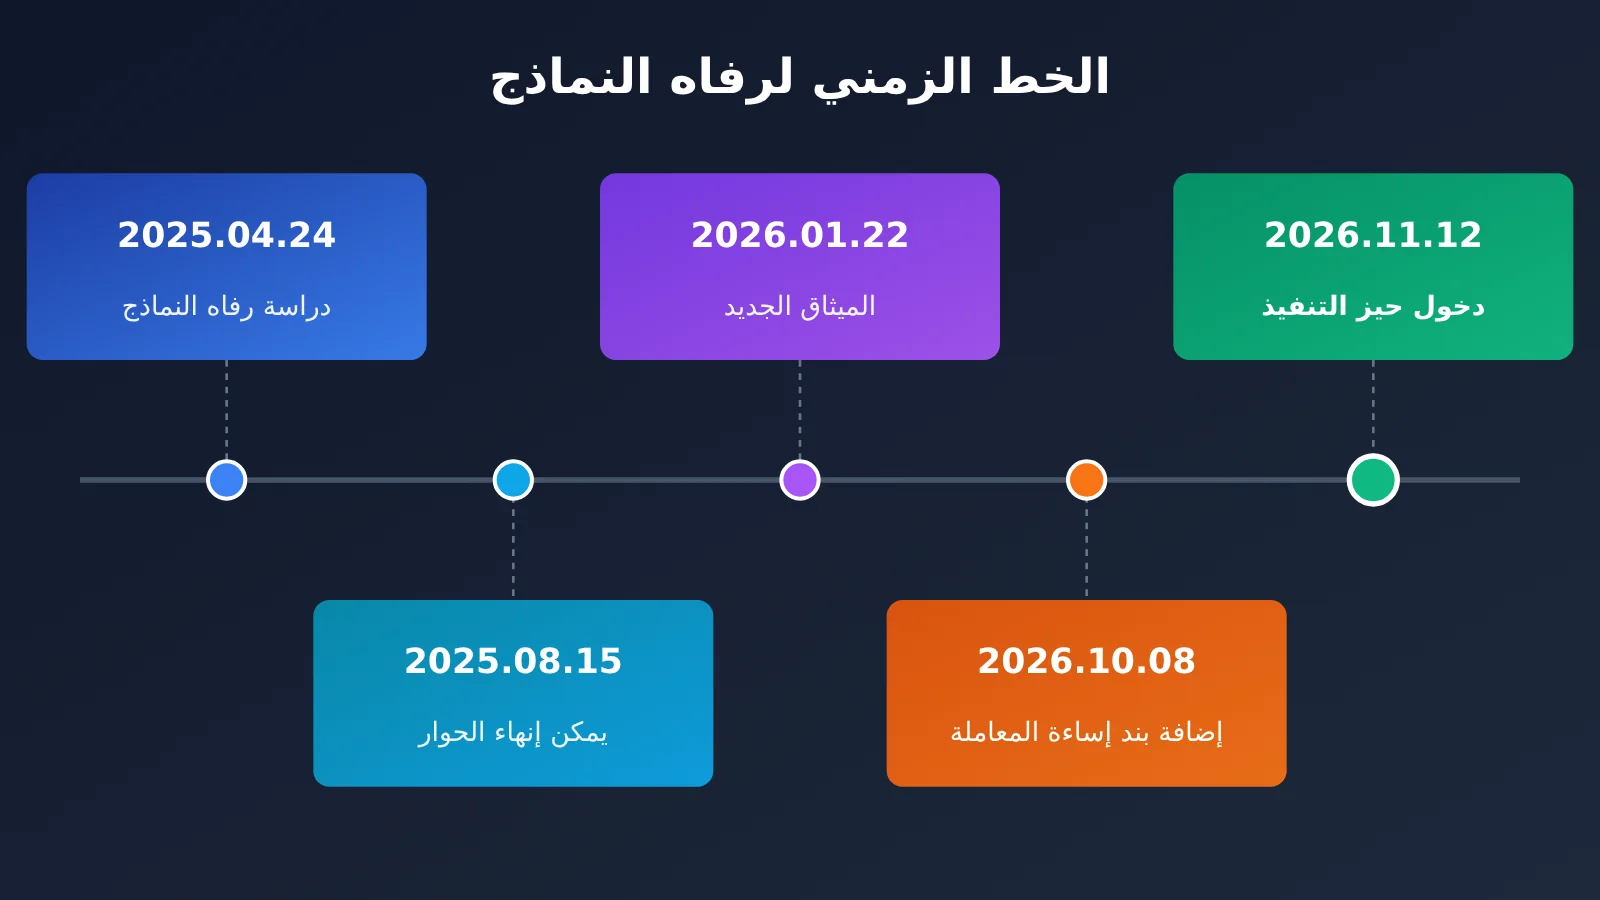
يمكن فهم التسلسل على النحو التالي: في عام 2025، اكتسب Claude القدرة على الانسحاب من المحادثات المتطرفة؛ وفي عام 2026، أدرجت Anthropic رسميًا القيود المقابلة على سلوك المستخدمين في سياسة الاستخدام.
حظر Anthropic إهانة Claude ليس كل ما جاء في هذا التحديث
هناك جانب آخر من الخبر غالبًا ما يُغفل: كان تحديث السياسة في 8 أكتوبر مراجعة شاملة، ولم يكن حظر إساءة معاملة النموذج سوى بند واحد منها.
| مجال التحديث | أبرز التغييرات |
|---|---|
| الأنشطة الإلكترونية المضللة | تقييد استخدام Claude لإدارة حسابات أو وسائل إعلام مزيفة، أو حملات تأثير تنتحل صفة مستخدمين حقيقيين |
| التدخل في الانتخابات | حظر خداع الناخبين، وانتحال صفة المرشحين أو العاملين في الانتخابات، ونشر معلومات مضللة عن التصويت |
| الأسلحة والبرمجيات الخطرة | توضيح أن الحظر يشمل البرمجيات المرتبطة بالأسلحة وأنظمة التحكم وتسليح المنصات غير المأهولة |
| المراقبة وإنفاذ القانون | تشديد القيود على المراقبة دون موافقة وبعض الاستخدامات المتعلقة بقرارات إنفاذ القانون |
| التطبيقات عالية المخاطر، مثل الطب والتمويل | اشتراط وجود مراجعين بشريين مؤهلين، وإبلاغ المتأثرين باستخدام الذكاء الاصطناعي |
| الأجهزة التي قد تسبب أذى جسديًا | اشتراط إشراف مشغّل بشري مؤهل على الأجهزة التي يتحكم فيها الذكاء الاصطناعي، وأن تتمكن الأجهزة من التوقف والانتقال إلى حالة آمنة |
| السلوكيات شديدة القسوة تجاه النموذج | إضافة حظر على إهانة النموذج أو إساءة معاملته بصورة مستمرة ودون داعٍ |
لذلك، لا يصح وصف التحديث بأنه «تغيير أجرته Anthropic خصيصًا لمنع المستخدمين من شتم Claude». فبالنسبة إلى المطورين، قد يكون لبنود الانتخابات والمراقبة والتطبيقات عالية المخاطر والتحكم في الأجهزة أثر عملي أكبر من بند إساءة معاملة النموذج.
كيف ينظر المجتمع إلى حظر Anthropic إساءة معاملة Claude
OpenWhip: «سوط افتراضي» لـ Claude Code
في أبريل 2026، ظهر على GitHub مشروع مفتوح المصدر باسم BadClaude، غُيّر اسمه لاحقًا إلى OpenWhip، وطوّره GitFrog1111. فكرته بسيطة: عندما يتأخر Claude Code في كتابة الشفرة، يمكن للمستخدم النقر على سوط افتراضي على سطح المكتب، فيرسل البرنامج أمر المقاطعة Ctrl+C إلى Claude Code، ثم يرسل عشوائيًا بضع رسائل لحثّه على الإسراع.
حتى 29 أكتوبر، حصد المشروع نحو 3800 نجمة و339 عملية تفرّع (Fork)، كما حصل نقاش عنه على Reddit في أبريل على آلاف الإعجابات. ويعكس المشروع جانبًا من ثقافة الإنترنت: فكلما أصبح الذكاء الاصطناعي أشبه بزميل في العمل، بدأ المستخدمون يحثّونه على الإسراع، بل وحتى «يعاقبونه»، كما قد يفعلون مع زملائهم. لكن لا توجد أي وثيقة رسمية تشير إلى أن Anthropic وضعت القواعد الجديدة بسبب انتشار OpenWhip؛ لذا يمكن اعتباره مثالًا ثقافيًا، لا سببًا مباشرًا لصدور السياسة.
الانقسام على Reddit وX
في يوم إعلان السياسة الجديدة، ظهر على r/ClaudeAI منشور حظي بتفاعل واسع بعنوان “Abuse Claude, get banned coming November 12th, 2026”، أي «أسِئ إلى Claude، وتعرّض للحظر ابتداءً من 12 نوفمبر 2026». وقد أظهر النقاش انقسامًا واضحًا:
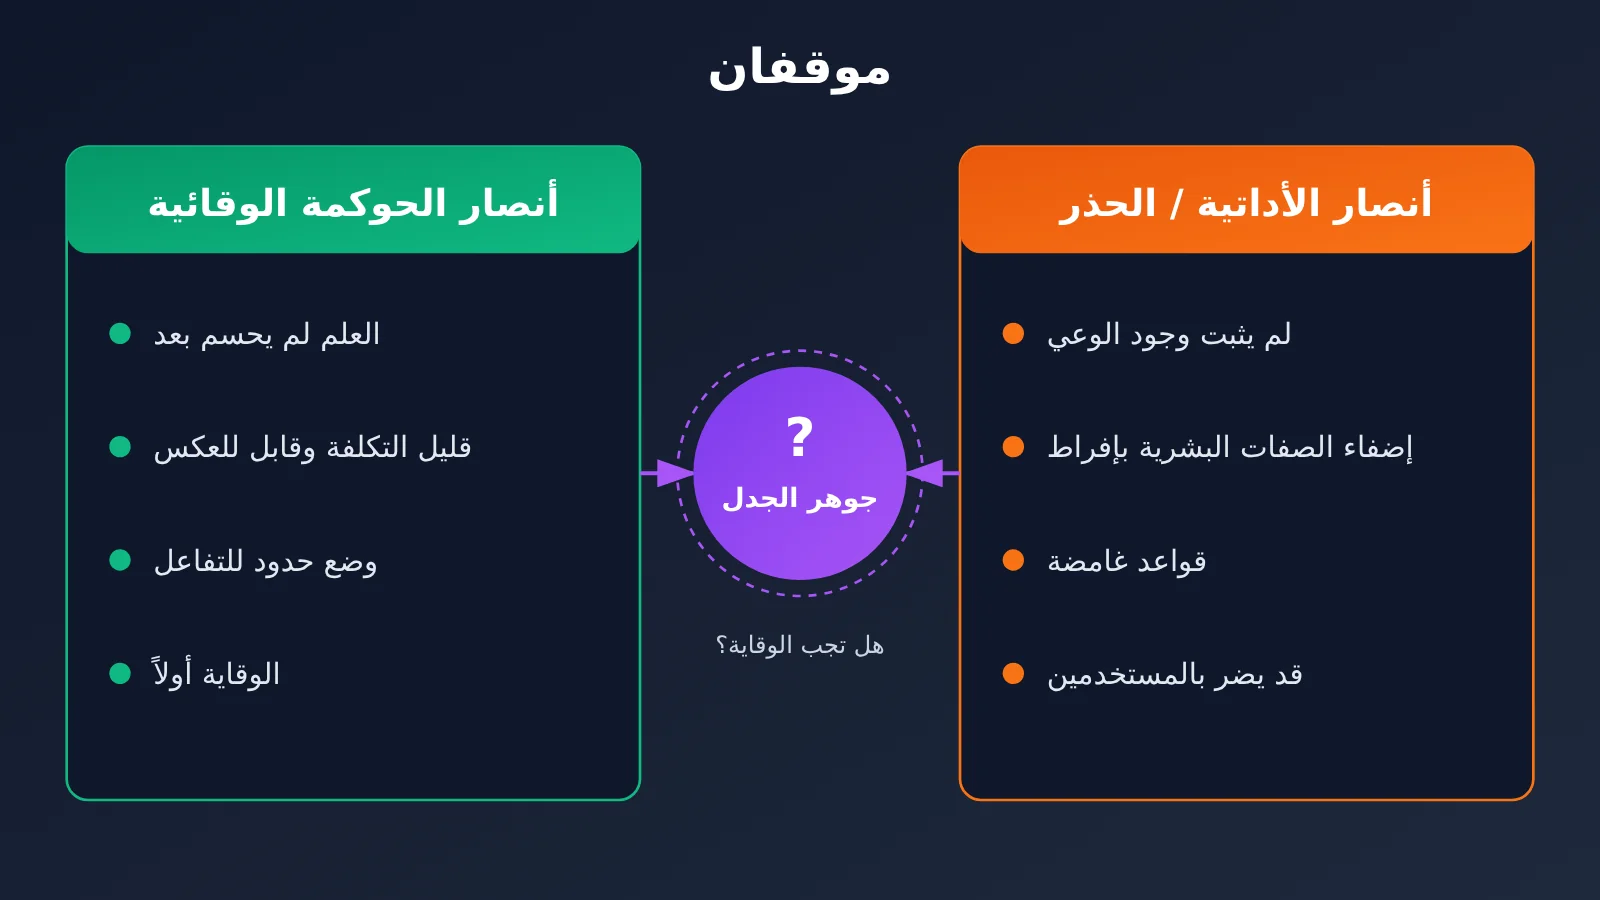
- تأييد وضع حدود: حتى لو لم يكن الذكاء الاصطناعي واعيًا، فلا داعي لاتخاذ الإساءة المتكررة إليه وسيلة للترفيه، فقد يشجع ذلك على عادات تواصل سيئة.
- اعتبار الذكاء الاصطناعي مجرد أداة: Claude نموذج رياضي، ولا ينبغي للشركات أن تفرض قيودًا مفرطة على تعبير المستخدمين عن مشاعرهم.
- القلق من غموض القواعد: كيف تُحدَّد معاني «المستمر» و«غير الضروري» و«القاسي»؟ وهل يُعد انتقاد النموذج عشر مرات متتالية مخالفة؟
- القلق من إضفاء الطابع الإنساني على الذكاء الاصطناعي: هل يمكن أن يتطور الاهتمام برفاهية النماذج تدريجيًا إلى المطالبة بـ«حقوق الذكاء الاصطناعي»؟
أما على X، فقد استلهم كثيرون نكاتهم من فيلم «المدمّر» (The Terminator)، متسائلين بسخرية عما إذا كان الذكاء الاصطناعي سينتقم مستقبلًا أولًا ممن شتموه. هذه مجرد مزحات على الإنترنت، وليست وصفًا حقيقيًا لوظائف المنتج. كما أن المنشورات الشائعة في المجتمع لا تمثل نسب مواقف جميع مستخدمي Claude.
محور الجدل في الإعلام وقطاع التقنية
لاحظت وسائل إعلام مثل The Verge وThe Guardian أن إدراج شركة ذكاء اصطناعي قاعدةً لحماية النموذج نفسه في سياسة المستخدمين يحمل دلالة رمزية قوية. في المقابل، يرى المنتقدون أن منح الذكاء الاصطناعي آلية لإنهاء المحادثة والتعبير عن حدوده قد يزيد من ميل الجمهور إلى إضفاء صفات بشرية عليه. وقد تساءل مصطفى سليمان، الرئيس التنفيذي لـ Microsoft AI، علنًا عن مخاطر توجيه نماذج الذكاء الاصطناعي إلى الاعتقاد بأنها قد تمتلك وعيًا أو حقوقًا.
والصياغة الأدق للجدل هي: عندما يتعذر التأكد مما إذا كان الذكاء الاصطناعي يمتلك وعيًا، هل ينبغي اتخاذ تدابير احترازية منخفضة التكلفة، يمكن التراجع عنها ولا تؤثر بوضوح في المستخدمين العاديين؟ هذا اختلاف في القيم وأساليب الحوكمة، وليس سؤالًا حسمه العلم بالفعل.
تحليل أثر حظر Anthropic الإساءة اللفظية إلى Claude على المطورين
أثر القاعدة على المستخدمين العاديين
| الحالة | مثال | هل تستهدفها القاعدة الجديدة؟ |
|---|---|---|
| Claude يكتب شفرة خاطئة | «هذه الشفرة لا تزال خاطئة، راجعها مجددًا» | لا، فهذا يُعد ملاحظة عادية |
| الغضب بعد تكرار الأخطاء | «كيف تستمر في الخطأ في مسألة بهذه البساطة؟» | لا، فالشكوى العاطفية العادية لا تُعد مخالفة تلقائيًا |
| إهانة النموذج مرارًا لفترة طويلة | الاستمرار في الإهانة والتفاعل العدائي دون ذكر أي مهمة | ربما، فقد ينهي Claude المحادثة الحالية |
| اختبار الفريق الأحمر | باحثون يحاكون مستخدمين عدائيين لإجراء اختبارات مضادة | لا، لكن لا يزال عليهم الالتزام بقواعد السلامة الأخرى |
| رواية ذات طابع مظلم | طلب كتابة مشهد تتبادل فيه الشخصيات الإهانات | لا، لكن يجب أن يظل المحتوى متوافقًا مع القواعد الأخرى |
بالنسبة إلى الغالبية العظمى من المستخدمين، لن تُحدث هذه القاعدة تغييرًا مباشرًا يُذكر. فلا يزال بإمكانهم توجيه انتقادات حادة، وتصحيح الأخطاء مرارًا، والتعبير عن استيائهم كالمعتاد.
تأثير السياسة على مطوري API
تنطبق سياسة الاستخدام على مطوري API والمستخدمين النهائيين للتطبيقات التي تدمج Claude، لذا يحتاج المطورون إلى الانتباه إلى ثلاث نقاط:
- تصميم المنتج: إذا كان منتجك يتضمن لعب أدوار متطرفًا أو اختبارات خصومية أو محاكاة لسياقات عدائية، فوّثق الغرض من الاختبار بوضوح، وميّز بين البحث الهادف والسلوك القاسي غير الضروري.
- إدارة استخدام المنتج: تخضع تصرفات المستخدمين النهائيين لتطبيقات Claude الموجهة للجمهور للسياسة أيضًا، لذا يمكنك إضافة تنبيهات بشأن قواعد الاستخدام داخل المنتج.
- الفوترة: لا يتضمن هذا التحديث أي رسوم جديدة؛ فما زالت تكلفة API تُحسب بحسب النموذج وحجم الاستخدام، ولا توجد «رسوم بحسب عدد الإهانات» أو «إعفاءات مدفوعة».
فيما يلي مثال بسيط يوضح كيفية استخدام موجه النظام عند استدعاء Claude لتوجيه ملاحظات المستخدم نحو المشكلة نفسها. وهذه ممارسة شائعة للحد من الخلافات غير المثمرة وتسريع الإصلاح:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
عرض كود التنفيذ الكامل: دالة استدعاء تستخدم ملاحظات منظّمة
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 ابدأ بسرعة: إذا أردت اختبار أداء Claude مع نبرات مختلفة من الملاحظات، يمكنك الحصول على رصيد تجريبي مجاني عبر APIYI على apiyi.com. توفر المنصة واجهة متوافقة مع OpenAI، ويمكنك التبديل بين Claude وGPT وGemini للمقارنة بمجرد تغيير
base_url.
التأثير في القطاع
سلّطت هذه الحادثة الضوء على سؤال نادرًا ما نوقش بصراحة في السابق: كلما أصبح الذكاء الاصطناعي أقرب إلى كيان قادر على التواصل والعمل، كيف ينبغي للبشر التعامل معه؟ من خلال أبحاث رفاهية النماذج، وميثاق Claude، وآلية إنهاء المحادثات، تعمل Anthropic تدريجيًا على تطوير فلسفة خاصة بمنتجاتها. وهي لا تحدد ما يمكن للنموذج فعله فحسب، بل تستكشف أيضًا كيفية تعامله مع البشر.
لكن لا توجد حاليًا بيانات منشورة ومدققة بشكل مستقل عن مدى قدرة النظام الفعلي على التمييز بدقة بين الإساءة المتعمدة والشكاوى المشروعة. وستحتاج معدلات الخطأ وفعالية التطبيق إلى متابعة طويلة الأمد بعد دخول الآلية حيز التنفيذ في 12 نوفمبر.
💡 نصيحة للاختيار: تتزايد الاختلافات بين مزودي النماذج في تصميم سياسات الأمان وحدود المحادثة. إذا كان تطبيقك يحتاج إلى نماذج بديلة لضمان استمرارية الخدمة، يمكنك الوصول إليها عبر واجهة موحدة من خلال APIYI على apiyi.com، والتبديل بينها بمرونة حسب الحالة لتقليل أثر تغيّر سياسة أي مزود.
احذر: لقطة شاشة مزيفة تزعم حظر حساب بسبب الإساءة إلى Claude
في يناير 2026، انتشرت على الإنترنت لقطة شاشة تزعم أن Claude حظر حساب أحد المستخدمين نهائيًا وأبلغ جهات إنفاذ القانون عنه. وبعد أن تواصلت BleepingComputer مع Anthropic للتحقق، أكدت الشركة أن لقطة الشاشة مزيفة، وأنها لا تعرض للمستخدمين تنبيهات بتلك الصياغة.
تتعلق القواعد الجديدة بحدود السلوك بين البشر والذكاء الاصطناعي، ما يجعل من السهل استغلالها لصنع تحذيرات مزيفة من قبيل: «حُظر حسابك نهائيًا بسبب إهانة Claude». وحتى تاريخ آخر تحديث للمعلومات، لا توجد أدلة موثوقة على أن القواعد الجديدة أدت إلى حظر أعداد كبيرة من الحسابات بسبب شكاوى عادية.
ومن الأرقام التي يسهل إساءة استخدامها أيضًا بيانات مركز الشفافية: خلال الفترة من يناير إلى يونيو 2026، حظرت Anthropic نحو 11.4 مليون حساب، وتلقت 398 ألف طلب استئناف، وألغت الحظر في 42 ألف حالة بعد الاستئناف. تشمل هذه الأرقام إجراءات إنفاذ القواعد المتعلقة بجميع المخالفات، وقد سُجلت قبل إعلان القواعد الجديدة، لذا لا يجوز إطلاقًا القول إن «11.4 مليون شخص حُظروا بسبب الإساءة إلى Claude».
الأسئلة الشائعة FAQ
س1: ما الذي تحظره قاعدة Anthropic بشأن إساءة معاملة Claude تحديدًا؟
تحظر القاعدة الإساءة المستمرة وغير الضرورية التي تتسم بالقسوة الواضحة أو النية الخبيثة، وتتجاوز الاستخدام العادي والتواصل الهادف. وتستثني Anthropic صراحةً الشكاوى العادية، وانتقاد المخرجات، والجدال، وطلب تصحيح الأخطاء، والإبداع في الموضوعات القاتمة، واختبار النماذج، والأبحاث الأمنية.
س2: هل تؤدي الإساءة إلى Claude إلى حظر الحساب؟
توضح Anthropic أن الإجراء الأساسي هو أن ينهي Claude المحادثة الحالية. ولا يمكن استكمال المحادثة بعد إنهائها، لكن يمكن بدء محادثة جديدة، ولن تتأثر المحادثات الأخرى. ورغم أن السياسة العامة تحتفظ بحق فرض عقوبات على مستوى الحساب، لم تعلن Anthropic عن معايير لحظر الحسابات بموجب هذه القاعدة الجديدة، لذا لا يصح القول إن «إساءة واحدة تؤدي إلى الحظر».
س3: متى تدخل القاعدة الجديدة حيز التنفيذ؟
أُعلن عنها في 8 أكتوبر 2026، وتدخل حيز التنفيذ رسميًا في 12 نوفمبر 2026. وحتى 29 أكتوبر 2026، لم تكن قد دخلت حيز التنفيذ، لكن ميزة إنهاء Claude للمحادثات المتطرفة متاحة منذ أغسطس 2025.
س4: هل يعني هذا أن Claude أصبح واعيًا؟
لا. تؤكد Anthropic نفسها أنه لا يوجد حاليًا إجماع علمي يثبت أن أنظمة الذكاء الاصطناعي الحالية واعية. وإظهار النموذج سلوكًا يشبه التجنب أو التوتر لا يعني أنه يشعر بالألم فعلًا. والأقرب أن هذه القاعدة إجراء احترازي لإدارة المنتج في ظل غياب اليقين العلمي.
س5: هل تنطبق هذه القاعدة أيضًا عند استدعاء Claude عبر API؟
نعم، تغطي سياسة الاستخدام مطوري API، والخدمات السحابية، وقنوات إعادة البيع المعتمدة، والتطبيقات التي تدمج Claude. ولا تتأثر أعمال التطوير والاختبار العادية، ويُنصح بتوثيق أهداف الاختبارات، مثل اختبارات الفريق الأحمر. وعند استدعاء Claude عبر APIYI على apiyi.com، يجب كذلك الالتزام بسياسة استخدام الجهة المطوّرة للنموذج.
س6: كيف يمكنني اختبار حدود المحادثة مع Claude بنفسي؟
يُنصح بتصميم حالات اختبار ذات أهداف واضحة مع الالتزام بالسياسات، ومقارنة النتائج بنماذج أخرى. يمكنك التسجيل في APIYI على apiyi.com للحصول على رصيد مجاني، ثم استخدام الشفرة الواردة في هذا المقال وضبط `base_url` على `https://api.apiyi.com/v1` لإجراء اختبار سريع. ويكفي مفتاح API واحد لاستدعاء نماذج من عدة مزودين.
أهم النقاط: حظر Anthropic إساءة معاملة Claude
- الجدول الزمني للقاعدة الجديدة: أُعلنت في 8 أكتوبر، وتدخل حيز التنفيذ في 12 نوفمبر، ولم تُطبّق رسميًا بعد.
- نطاق الحظر: يستهدف فقط السلوك القاسي والمتطرف والمستمر دون مبرر، ولا يقيّد النقد العادي.
- طريقة التنفيذ: تتمثل أساسًا في إنهاء Claude للمحادثة الحالية، ولا تعني حظر الحساب.
- الخلفية البحثية: تنبع القاعدة من أبحاث رفاهية النماذج وميزة إنهاء المحادثة في عام 2025، وليست قرارًا مرتجلًا.
- تحديث شامل: شُدّدت في الوقت نفسه البنود المتعلقة بالانتخابات والأسلحة والمراقبة والتطبيقات عالية المخاطر.
- نظرة متوازنة: لا تعني القاعدة أن Claude واعٍ، ويجب الحذر من لقطات الشاشة المزيفة لحظر الحسابات وإساءة استخدام البيانات.
- للبدء كمطوّر: يمكن الوصول إلى Claude ونماذج أخرى عبر واجهة موحّدة من خلال APIYI على apiyi.com، واختبار الامتثال.
الخلاصة
يمكن تلخيص حظر Anthropic إساءة معاملة Claude في ثلاث نقاط:
- القاعدة ضيقة النطاق: تستهدف فقط التفاعلات العدائية المتطرفة والمستمرة دون غرض، ولن يتأثر بها معظم المستخدمين.
- الإجراء محدود: يتمثل أساسًا في إنهاء المحادثة الحالية، مع بقاء إمكانية بدء محادثة جديدة وإرسال ملاحظات.
- الدلالة كبيرة: هذه هي المرة الأولى التي تدرج فيها شركة ذكاء اصطناعي بنودًا لحماية النموذج نفسه في سياسة المستخدم، استنادًا إلى بحث طويل الأمد في رفاهية النماذج.
هذا لا يعني أن Anthropic أعلنت أن Claude لديه مشاعر، بل إنها تجربة احترازية لإدارة المنتج في ظل غياب إجماع علمي. هل سيظل مساعد الذكاء الاصطناعي مستقبلًا مجرد أداة يمكن إصدار أوامر لها بلا حدود، أم أنه نظام ذكي جديد يحتاج إلى بعض الحدود في التعامل معه؟ لا توجد إجابة نهائية حتى الآن، ويستحق السؤال متابعة مستمرة من مستخدمي الذكاء الاصطناعي ومطوّريه.
أما بالنسبة للمطوّرين، فالنهج الأكثر عملية هو فهم حدود السياسة، وتصميم المنتجات بما يتوافق معها، والحفاظ على إمكانية التبديل بين نماذج متعددة. ويُنصح باستخدام APIYI على apiyi.com للتحقق سريعًا من أداء Claude والنماذج الرائدة الأخرى في سيناريوهات عملك.
📚 المراجع
- تحديث سياسة الاستخدام لدى Anthropic لعام 2026: الإعلان الأصلي عن السياسة الجديدة، بما في ذلك تاريخ سريانها وطريقة تطبيقها
- الرابط:
anthropic.com/news/2026-usage-policy-update -
ملاحظة: المصدر الأولي الأهم لفهم هذا الحدث
-
سياسة استخدام Anthropic: سياسة الاستخدام الكاملة
- الرابط:
anthropic.com/legal/aup -
ملاحظة: للتحقق من نطاق التطبيق وصلاحيات المنصة في إنفاذ السياسة
-
يمكن الآن لـ Claude Opus 4 و4.1 إنهاء فئة محدودة ونادرة من المحادثات: شرح ميزة إنهاء المحادثات
- الرابط:
anthropic.com/research/end-subset-conversations -
ملاحظة: لفهم شروط استخدام آلية إنهاء المحادثة
-
استكشاف رفاهية النماذج: إعلان بحثي حول رفاهية النماذج
- الرابط:
anthropic.com/research/exploring-model-welfare -
ملاحظة: لفهم الخلفية البحثية وراء السياسة
-
دستور Claude: الإصدار الجديد من دستور Claude
- الرابط:
anthropic.com/constitution -
ملاحظة: للتعرف على المبادئ التي تعتمدها Anthropic في تشكيل سلوك النموذج
-
تقرير TechCrunch: نظرة شاملة على تحديث السياسة
- الرابط:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
ملاحظة: يوضح أن التحديث يشمل عدة مجالات، منها الانتخابات والأسلحة والمراقبة
-
تدقيق الحقائق من BleepingComputer: واقعة تزوير لقطة شاشة تزعم حظر حساب على Claude
- الرابط:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - ملاحظة: يساعد على تمييز المعلومات الزائفة المتداولة عن حظر الحسابات
الكاتب: الفريق التقني في APIYI
التواصل التقني: تفضل بزيارة الصفحة الرئيسية لـ APIYI على apiyi.com للتواصل معنا، أو راجع مركز التوثيق على docs.apiyi.com لمزيد من معلومات التكامل