
ملاحظة المؤلف: قراءة في بيانات استخدام ChatGPT المتاحة للعموم ضمن OpenAI Signals v3.0، والتي تغطي 165 فئة من أنشطة العمل؛ مع توضيح منهجية القياس، وتحليل قيمتها المرجعية للمطورين ولتطبيقات الذكاء الاصطناعي في الشركات.
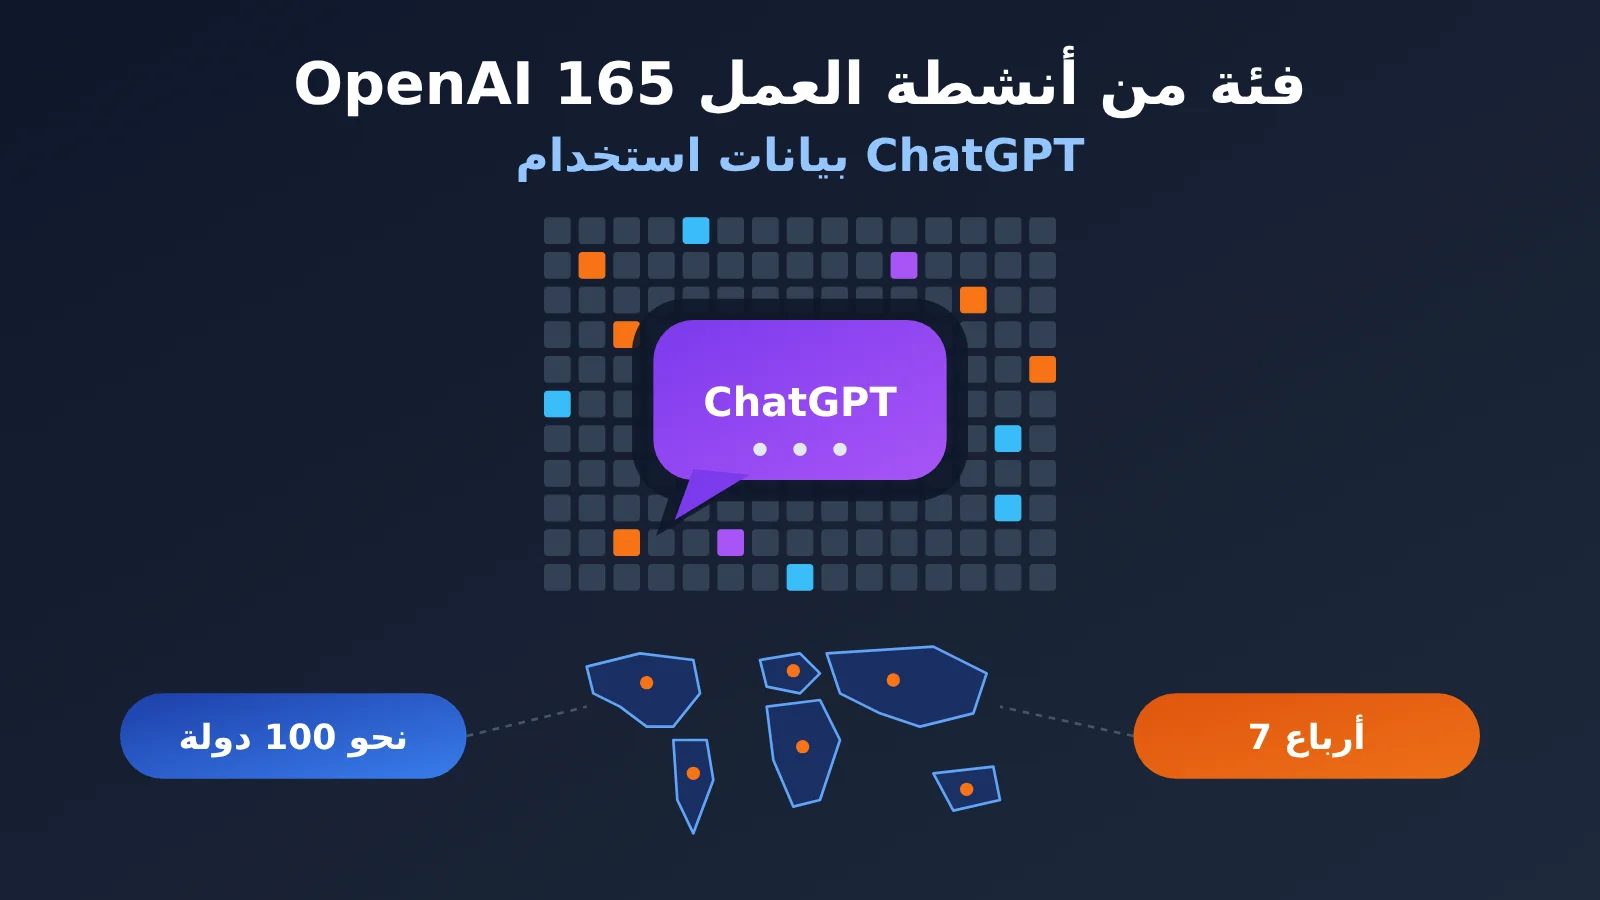
في 26 أكتوبر 2026، نشر فريق الأبحاث الاقتصادية في OpenAI تقرير «ChatGPT’s expanding world of work» (وعنوانه الرسمي بالصينية: «عالم عمل ChatGPT المتوسع»)، وكشف فيه عن بيانات استخدام ChatGPT تغطي ما يقرب من 100 دولة ومنطقة، و165 فئة من أنشطة العمل، وعلى مدى 7 أرباع متتالية. تنتمي هذه البيانات إلى مبادرة OpenAI Signals v3.0، وهي متاحة للتنزيل مجانًا بموجب ترخيص CC BY 4.0، ويمكن للباحثين استخدام ملفات CSV مباشرة لإجراء تحليل ثانوي.
هذا ليس إعلانًا عن نموذج جديد أو ميزة جديدة، بل مجموعة بيانات استخدام اقتصادية موجهة إلى الباحثين. وقد ظهرت في الوقت نفسه الإعلانات الرسمية وقاموس البيانات ومراجعات وسائل الإعلام المستقلة لملف CSV الأصلي، بحيث يمكن التحقق من تعريفات الأرقام ومقارنتها. وسيفصل هذا المقال بوضوح بين استنتاجات OpenAI والحسابات التي أجراها طرف ثالث، لتجنب فهم «حصة الرسائل» على أنها «استبدال للوظائف».
القيمة الأساسية: فهم في دقائق لما تقيسه بيانات OpenAI التي تغطي 165 فئة من أنشطة العمل فعليًا، وما الذي اكتشفته، وما أهميتها العملية لمطوري تطبيقات الذكاء الاصطناعي.
نظرة سريعة على بيانات OpenAI لأنشطة العمل الـ165
نبدأ بجدول يوضح الحقائق الأساسية لهذا الإصدار من بيانات استخدام ChatGPT:
| البند | التفاصيل |
|---|---|
| تاريخ النشر | 26 أكتوبر 2026 |
| الجهة الناشرة | فريق الأبحاث الاقتصادية في OpenAI (OpenAI Signals v3.0) |
| نظام التصنيف | أنشطة العمل متوسطة المستوى (IWA) من O*NET الأمريكية |
| النطاق الجغرافي | ما يقرب من 100 دولة ومنطقة، و165 نشاط عمل |
| الفترة الزمنية | من الربع الأول من 2025 إلى الربع الثالث من 2026، أي سبعة أرباع |
| مصدر العينة | حسابات فردية Free وGo وPlus وPro، يصرح أصحابها بأن أعمارهم 18 عامًا أو أكثر |
| النطاق المستبعد | ChatGPT Enterprise وCodex والحسابات المحذوفة والعينات غير المسموح باستخدامها في التدريب |
| ترخيص البيانات | CC BY 4.0، متاح للاطلاع والتنزيل بصيغة CSV مجانًا، مع وجوب الإسناد |
165 نشاط عمل لا تعني 165 مهنة
هذه هي النقطة التي يسهل الوقوع في الخطأ عند تفسير بيانات OpenAI. فـ O*NET قاعدة بيانات رسمية أمريكية للمعلومات المهنية، وهي تقسّم «المهنة» إلى طبقات متعددة من «أنشطة العمل». فعلى سبيل المثال، يظهر نشاط «تحرير المواد المكتوبة» في عمل المحرر، ويظهر أيضًا في يوم عمل المعلم والمحامي والمهندس والمختص المالي.
لذلك، ما تحسبه OpenAI هو «ما الذي يفعله الناس باستخدام ChatGPT»، وليس «أي المهن يستخدم أصحابها ChatGPT». وتقع IWA (أنشطة العمل متوسطة المستوى) بين سلوكيات العمل العامة والمهام شديدة التحديد، ويضم الإطار المرجعي O*NET ما مجموعه 332 بندًا من IWA.
أبلغت OpenAI بشكل منفصل عن الأنشطة الشائعة التي تستوفي حد العينة فقط، بينما دُمجت الأنشطة منخفضة التكرار. ووفقًا لمراجعة PPC Land لملف CSV الأصلي، فإن الجدول المنشور يتكون فعليًا من 164 فئة محددة الاسم، إضافة إلى فئة مجمعة واحدة باسم «Other IWA»، ليصل الإجمالي إلى 165 نتيجة تصنيف. لذلك لا يمكن القول إن OpenAI أحصت فئات IWA الـ332 بالكامل.
كيف تُجمع البيانات وتُصنَّف
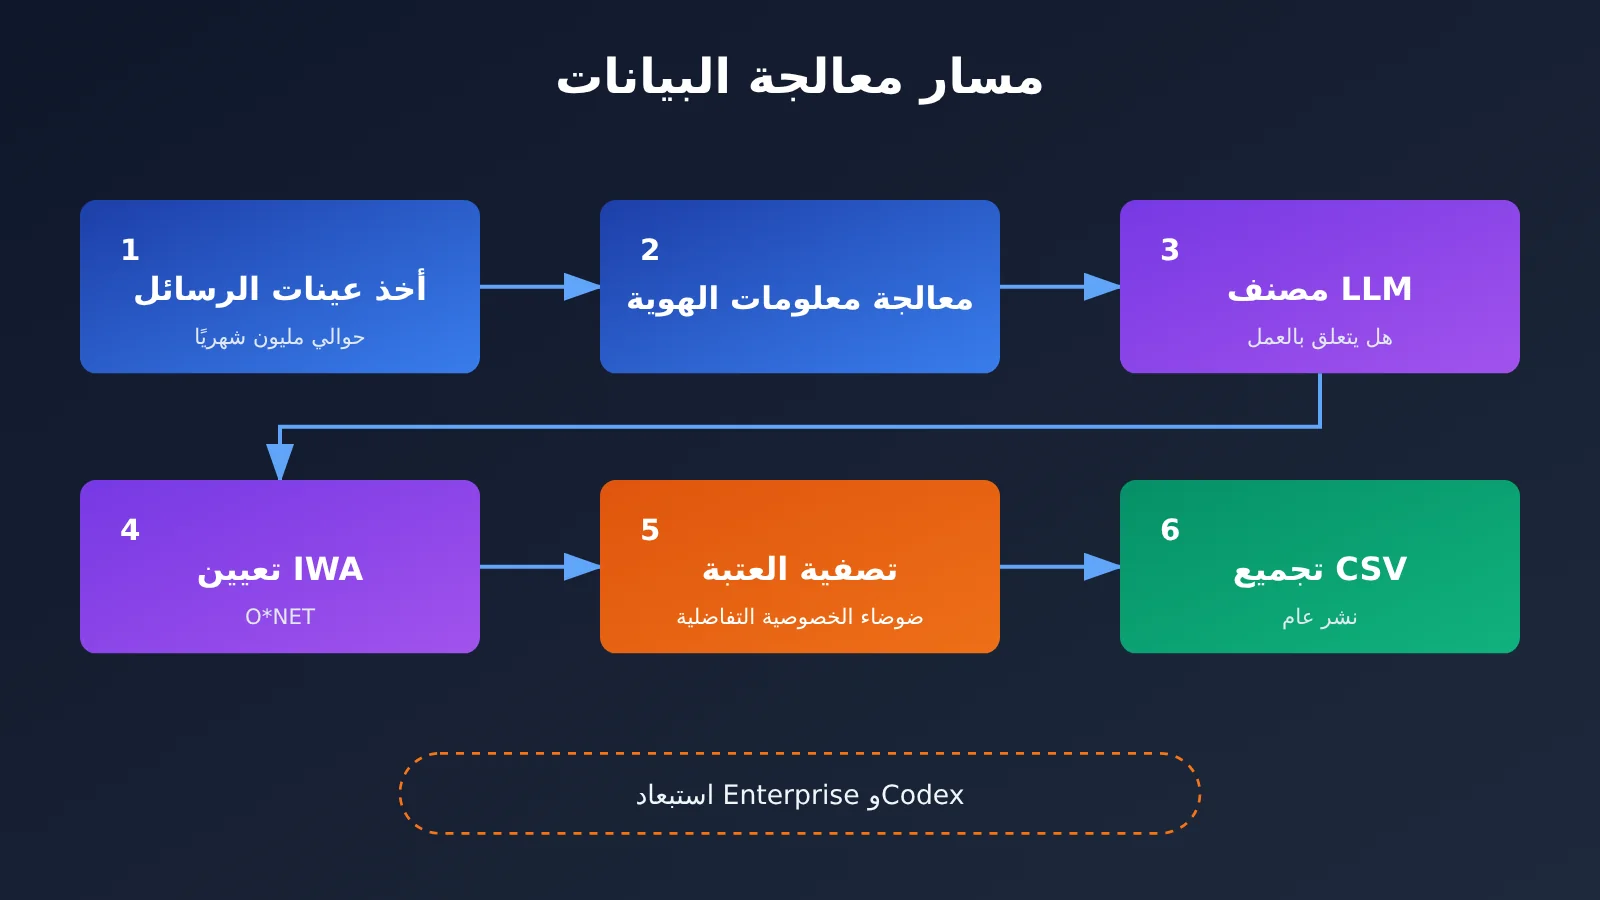
يعتمد Signals v3.0 على أخذ عينات شهرية تبلغ نحو مليون رسالة من ChatGPT، ليغطي بذلك الفترة من يوليو 2024 حتى سبتمبر 2026، أي 27 شهرًا، بما مجموعه نحو 27 مليون عيّنة مصنَّفة. ومن المهم التنبيه إلى أن الـ 27 مليونًا هي مجموع أعداد العينات في كل شهر، فهي لا تساوي عدد المستخدمين الفريدين، ولا تعني أن جميعها رسائل متعلقة بالعمل.
تتم عملية التصنيف بواسطة مصنِّف آلي مبني على نموذج لغة كبير: يحدد أولًا ما إذا كانت الرسالة مرتبطة بالعمل، ثم يربطها بنشاط من أنشطة العمل في إطار O*NET، مع وسم الموضوع والقصد والزمن والمنطقة. أما من ناحية الخصوصية، فتشير OpenAI إلى أن الباحثين لا يقرؤون المحادثات الأصلية مباشرة، وأن بيانات الهوية تُعالَج قبل التصنيف، وأنه لا تُنشر سوى النتائج المجمَّعة، مع إخفاء العينات الصغيرة وإضافة ضوضاء الخصوصية التفاضلية. كما يُشترط أن تحتوي بيانات توزيع أنشطة العمل الفصلية لأي دولة على 1000 رسالة صالحة على الأقل قبل نشرها.
أهم اكتشاف في بيانات استخدام ChatGPT: توزّع أوسع لاستخدامات العمل
الخلاصة الرئيسية التي أعلنتها OpenAI رسميًا هي أن أنواع المهام العملية التي يعالجها المستخدمون الأفراد عبر ChatGPT أصبحت أكثر تنوعًا. ففي 74 دولة ومنطقة تتوفر لها سجلات كاملة عبر سبعة أرباع سنوية، انخفض بشكل واضح متوسط حصة أكثر عشر فئات من أنشطة العمل شيوعًا في كل دولة، وذلك من إجمالي رسائل العمل المصنّفة داخل تلك الدولة.
| الفترة | متوسط حصة أكثر عشر فئات من أنشطة العمل شيوعًا في كل دولة |
|---|---|
| الربع الأول من 2025 | 56.0% |
| الربع الثالث من 2026 | 51.1% |
| التغيّر | -4.9 نقطة مئوية |
هناك نقطتان منهجيتان يجب توضيحهما بدقة. أولًا، نسبة 51.1% ليست حصة قائمة عالمية موحّدة لأفضل عشر فئات، بل تُحسب أولًا أفضل عشر فئات في كل دولة على حدة، ثم يُؤخذ متوسط الدول الـ74، ما يعني أن الفئات العشر الأولى قد تختلف من دولة إلى أخرى. ثانيًا، انخفاض الحصة لا يعني انخفاض عدد الرسائل؛ فإذا كان الاستخدام الإجمالي ينمو، فقد يزداد العدد المطلق للطلبات في الأنشطة الرئيسية رغم تراجع حصتها.
بعبارة أخرى، حصلت المزيد من أنشطة العمل «الطويلة الذيل» على حصة أكبر. وهنا يجب الانتباه إلى أن نطاق الـ74 دولة ونطاق قرابة 100 دولة يمثلان عينتين مختلفتين، ولا يجوز الخلط بينهما عند الاقتباس.
ما أنشطة العمل المحددة الأكثر شيوعًا؟
أجرت PPC Land في 27 أكتوبر 2026 حسابًا مستقلًا استنادًا إلى جميع ملفات CSV المتاحة للعموم، وبعد إحصاء كل دولة من الدول الـ74 على حدة، حسبت المتوسط. فيما يلي أنشطة العمل الستة المحددة بالاسم الأكثر شيوعًا في الربع الثالث من عام 2026 (وهي حسابات طرف ثالث، وليست مذكورة مباشرة في إعلانات OpenAI):
| الترتيب | نشاط العمل | متوسط حصة الرسائل في 74 دولة |
|---|---|---|
| 1 | تحرير المواد المكتوبة أو المستندات | 15.0% |
| 2 | إنشاء تصاميم بصرية أو محتوى عرض | 7.9% |
| 3 | تطوير مواد تسويقية أو ترويجية | 5.1% |
| 4 | تفسير معلومات لغوية أو ثقافية | 4.0% |
| 5 | إعداد مواد معلوماتية أو تعليمية | 3.2% |
| 6 | برمجة أنظمة الحاسوب أو معدات الإنتاج | 3.1% |
لا يزال تحرير المستندات هو الاستخدام العملي الأكثر انتشارًا، وقد ارتفع التصميم البصري إلى المرتبة الثانية. وهناك طلب واضح على المحتوى التسويقي والمواد التعليمية وفهم اللغات المختلفة، أما البرمجة فرغم أهميتها، فإنها لا تمثل الحصة الأكبر في هذه العينة من الحسابات الفردية.
ارتفاع التصميم البصري وانخفاض حصة البرمجة
بحسب حسابات PPC Land، ارتفع متوسط نسبة نشاط “إنشاء تصاميم بصرية أو محتوى عرضي” عبر 74 دولة من 3.1% في الربع الأول من 2025 إلى 7.9% في الربع الثالث من 2026، أي بزيادة 4.8 نقطة مئوية، وهو أكبر نمو بين 165 فئة من الأنشطة المحددة. وفي الولايات المتحدة ارتفعت النسبة في الفترة نفسها من 2.4% إلى 7.6%، وبلغت في الربع الثالث من 2026 نحو 11.2% في البرازيل و8.7% في الهند.
في المقابل، تراجعت نسبة “برمجة أنظمة الحاسوب أو معدات الإنتاج” من 7.8% إلى 3.1%، وفي الولايات المتحدة من 6.7% إلى 2.4%، بينما ظلت في الهند عند 5.8% في الربع الثالث من 2026. كما انخفضت بالمثل أنشطة مثل حل مشكلات الحاسوب وبحث التصاميم التقنية. من المعقول افتراض أن المطورين انتقلوا إلى وكلاء برمجة متخصصين مثل Codex، لكن البيانات نفسها لا تثبت هذا الانتقال. التعبير الأدق هو: في هذه البيانات التي تستثني Codex وحسابات المؤسسات، انخفضت حصة رسائل العمل البرمجية بشكل واضح.
التسويق إشارة أخرى تستحق الانتباه. متوسط نسبة “إنتاج مواد تسويقية أو ترويجية” انتقل من 5.2% إلى 5.1%، أي شبه ثابت، وبلغ في الأرجنتين وباكستان ونيجيريا نحو 9% في الربع الثالث من 2026. وهذا يعني أنه رغم تراجع حصة الكتابة العامة، فإن الطلب على محتوى تسويقي متخصص لا يزال مستقرًا.
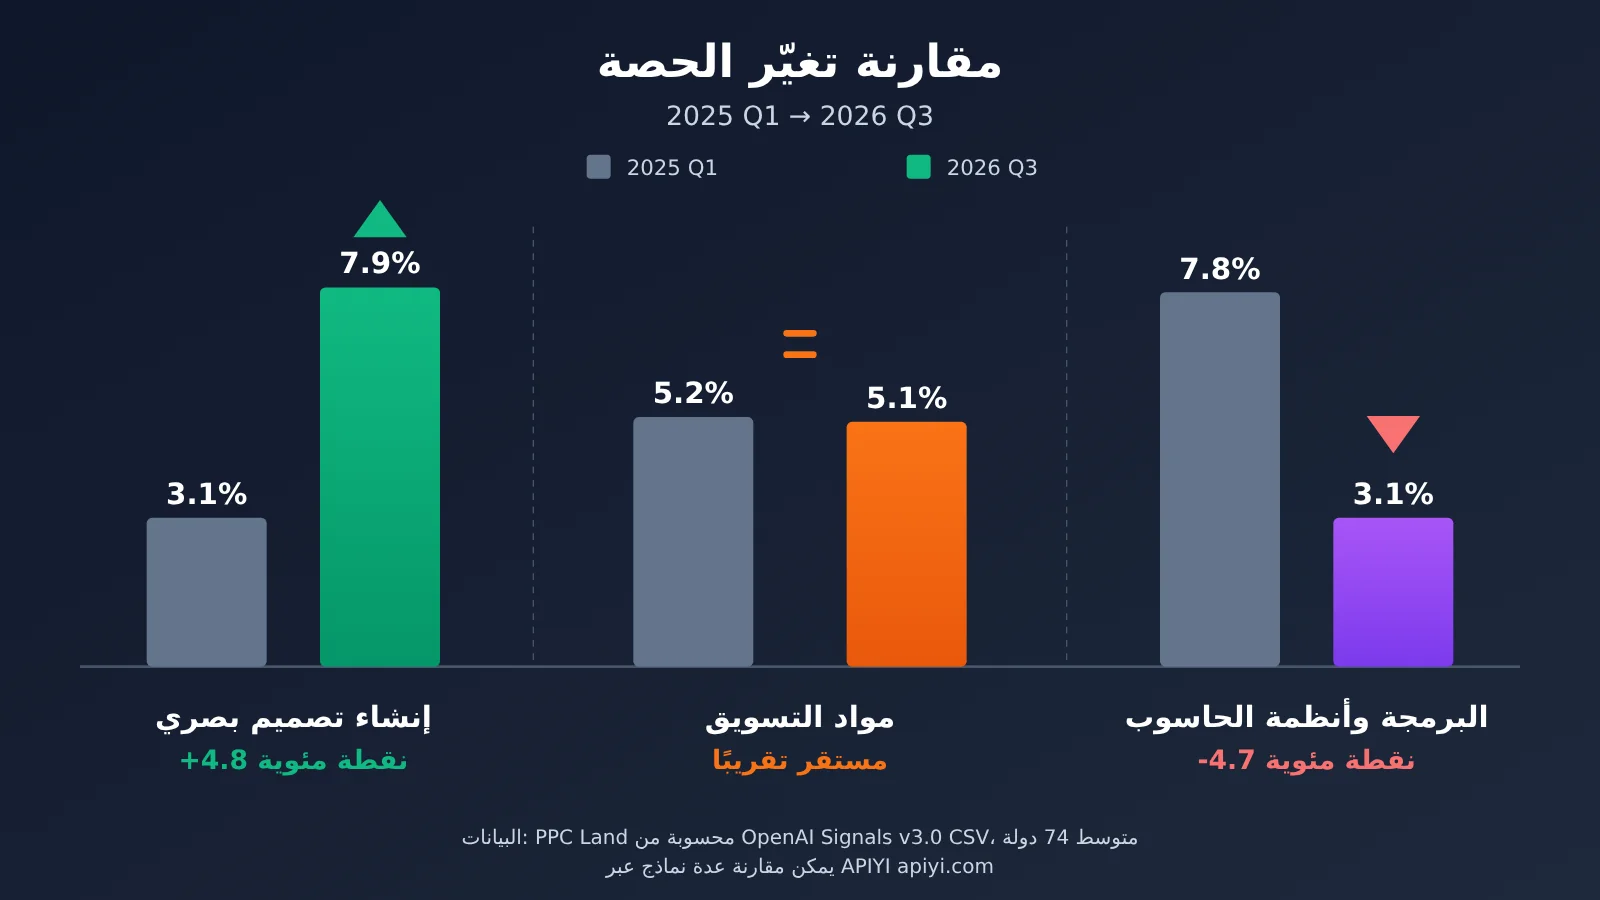
📊 شرح الرسم البياني: بيانات الرسم أعلاه مأخوذة من إعادة حساب أجراها PPC Land على ملف CSV المنشور من OpenAI. وإذا أردت أن تتحقق داخل عملك من النموذج الأنسب لكل من طلبات “التصميم” و”الكتابة الإعلانية” و”البرمجة”، يمكنك عبر APIYI apiyi.com استخدام مفتاح API واحد للتبديل بين OpenAI وClaude وGemini وغيرها وإجراء مقارنة على نطاق صغير.
مقارنة هيكل العمل في ChatGPT بين الولايات المتحدة وألمانيا
كما قرأت PPC Land بندًا بندًا فئات أنشطة العمل المعمّمة (Generalized Work Activities) الأوسع في مخطط OpenAI التفاعلي (لاحظ أنها ليست على نفس المستوى مع IWA المذكورة أعلاه، ولا يمكن خلطها معها). والمعيار الإحصائي هو نسبة الرسائل المتعلقة بالعمل في كل بلد:
| أنشطة العمل المعمّمة | الولايات المتحدة الربع الأول 2025 | الولايات المتحدة الربع الأول 2026 | ألمانيا الربع الأول 2025 | ألمانيا الربع الأول 2026 |
|---|---|---|---|---|
| اتخاذ القرارات وحل المشكلات | 22.8% | 21.6% | 22.0% | 19.4% |
| التفكير الإبداعي | 11.8% | 15.6% | 11.3% | 13.1% |
| تسجيل المعلومات | 10.6% | 11.8% | 10.3% | 11.4% |
| استخدام الحاسوب | 11.7% | 6.7% | 12.7% | 8.4% |
| تقديم الاستشارة والنصيحة | 5.5% | 9.0% | 7.1% | 11.7% |
| شرح المعلومات للآخرين | 5.1% | 4.0% | 9.5% | 8.6% |
يُظهر كلا البلدين أن “اتخاذ القرارات وحل المشكلات” استخدام مهم، وأن نسبة “التفكير الإبداعي” و”الاستشارة والنصيحة” ارتفعت بشكل ملحوظ. وهذا يصف أنواع طلبات المستخدمين، ولا يعني أن ChatGPT قد اتخذ قرارات تجارية بشكل مستقل، ولا أنه قدّم استشارات خبيرة مُتحقَّقًا من صحتها.
وبين الدول، ارتفع مؤشر اختلاف التوزيع عبر الدول (مسافة التباين الكلي) الذي قرأته PPC Land من حوالي 22.2% إلى حوالي 23.0% بشكل طفيف. وتعترف OpenAI أيضًا بأن هذا الاختلاف قد يكون ناتجًا عن هيكل العمل واللغة والثقافة وتوفر الأدوات وعادات الاستخدام، وأن بيانات هذه المرة لا تكفي لإثبات علاقة سببية.
تحليل تأثير بيانات 165 فئة من أنشطة العمل على المطورين
التأثير على مطوري تطبيقات الذكاء الاصطناعي
- الطلب يتوسع: لم يعد المستخدمون يستخدمون ChatGPT فقط لتعديل المستندات، بل أصبح للتصميم البصري والتسويق والمواد التعليمية والاستشارات نصيب كبير، ما يعني أن أدوات الذكاء الاصطناعي أحادية الوظيفة تحتاج إلى مراعاة سيناريوهات المهام المتعددة.
- تعدد الوسائط أصبح أكثر أهمية: التصميم البصري هو النشاط الأكبر نموًا، وفي الفترة نفسها ارتفع موضوع “الوسائط المتعددة” من 2.0% إلى 8.8% من جميع الرسائل الشخصية (بحسب حسابات PPC Land)، لذا تستحق قدرات الصور أن تُدرَج في تخطيط المنتج.
- سيناريوهات البرمجة تتجه نحو التخصص: انخفضت نسبة رسائل البرمجة في الدردشة العامة، ما يشير إلى أن طلبات تطوير الموجهات قد تحدث أكثر في وكلاء متخصصين أو بيئات مؤسسية، وهو ما يناسب التعامل معه عبر نماذج برمجية وسير عمل مخصصة.
- منهجية تصنيف قابلة لإعادة الاستخدام: استخدمت OpenAI مصنّف نموذج لغة كبير لربط الرسائل بنظام مهام معياري، وهذه الفكرة نفسها يمكنك تطبيقها على تحليل سجلات منتجك الخاص.
تأثير تطبيق الذكاء الاصطناعي في المؤسسات
لا يمكن لبيانات الحسابات الفردية أن تمثل استخدام المؤسسات. تُظهر بيانات أخرى من Enterprise Signals أنه حتى يونيو 2026، ساهم Codex بنسبة 64% من إجمالي رموز الإخراج لكل من ChatGPT وCodex among عملاء المؤسسات الذين جرى تحليلهم. يشير هذا إلى أن بنية الاستخدام لدى المؤسسات قد تختلف كثيرًا عن الحسابات الفردية. عند تقييم حلول الذكاء الاصطناعي الداخلية، ينبغي الاعتماد على سجلات المهام الخاصة بك، بدلاً من تطبيق بيانات Signals الخاصة بالأفراد مباشرة.
🚀 بدء سريع: إذا كنت ترغب في وسم طلبات أعمالك بعلامة «نشاط العمل» كما تفعل OpenAI، نوصي ببناء نموذج أولي بسرعة عبر APIYI apiyi.com. توفر المنصة واجهة متوافقة مع OpenAI، وللمستخدمين الجدد حصة اختبار مجانية، ويمكنك تشغيل المثال أدناه في غضون دقائق.
إعادة إنتاج فكرة «تصنيف أنشطة العمل» باستخدام API
فيما يلي مثال مبسّط للغاية يستخدم نموذج لغة كبير لتصنيف طلب مستخدم واحد ضمن عدد قليل من تسميات أنشطة العمل. الفكرة نفسها التي يعتمدها مصنّف OpenAI (التسميات هنا للتوضيح المبسّط فقط، وليست النظام الكامل O*NET):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

labels = "编辑文档, 视觉设计, 营销推广, 语言解释, 教学材料, 编程, 决策分析, 其他"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"从[{labels}]中选一个标签描述这条工作请求,只输出标签:帮我写一份新品发布的公众号推文"}]
)
print(resp.choices[0].message.content)
عرض الكود الكامل للتصنيف الدفعي وإحصاء النسب
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # مفتاح API واحد يمكنه التبديل بين عدة نماذج
)

LABELS = ["编辑文档", "视觉设计", "营销推广", "语言解释",
          "教学材料", "编程", "决策分析", "非工作", "其他"]

SYSTEM = (
    "你是工作活动分类器。先判断请求是否与工作相关,"
    f"再从以下标签中选择一个:{', '.join(LABELS)}。只输出标签本身。"
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "其他"
    except Exception as e:
        print(f"Error: {e}")
        return "其他"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "非工作"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "帮我润色这份季度汇报",
        "设计一组活动海报的构图建议",
        "这段 Python 为什么读不到数据",
        "周末去哪里露营比较好",
    ]
    print(activity_share(logs))
وكما في طريقة OpenAI، قد يقع هذا التصنيف التلقائي في أخطاء، وقد تُقسَّم المهمة الواحدة إلى عدة رسائل؛ لذلك لا يمكن اعتبار «نسبة الرسائل» الناتجة عن الإحصاء مكافئًا مباشرًا لحجم العمل أو القيمة التجارية.
مرجع اختيار النماذج حسب أنشطة العمل المختلفة
بناءً على الأنشطة ذات النسبة الأعلى في البيانات، يمكن إجراء اختيار أولي حسب نوع المهمة، لكن النتائج الفعلية تحتاج إلى اختبار على بياناتك الخاصة:
| نشاط العمل | الجانب Capacity | فكرة الاختيار | المنصات المتاحة |
|---|---|---|---|
| تحرير المواد المكتوبة | فهم النصوص وإعادة صياغتها | نموذج محادثة عام بعائدية عالية مقابل التكلفة | APIYI apiyi.com، API الرسمي |
| التصميم البصري والعرض | توليد الصور وفهمها | نموذج متعدد الوسائط / نموذج صور | APIYI apiyi.com، API الرسمي |
| مواد التسويق والترويج | الإبداع والتحكم في الأسلوب | نموذج رائد بأسلوب كتابة مستقر | APIYI apiyi.com، API الرسمي |
| البرمجة واستكشاف الأخطاء | استدلال برمجي | نموذج قوي في البرمجة أو وكيل متخصص | APIYI apiyi.com، API الرسمي |
| القرارات والاستشارات | استدلال بنافذة سياق طويلة | نموذج استدلالي مع مراجعة بشرية | APIYI apiyi.com، API الرسمي |
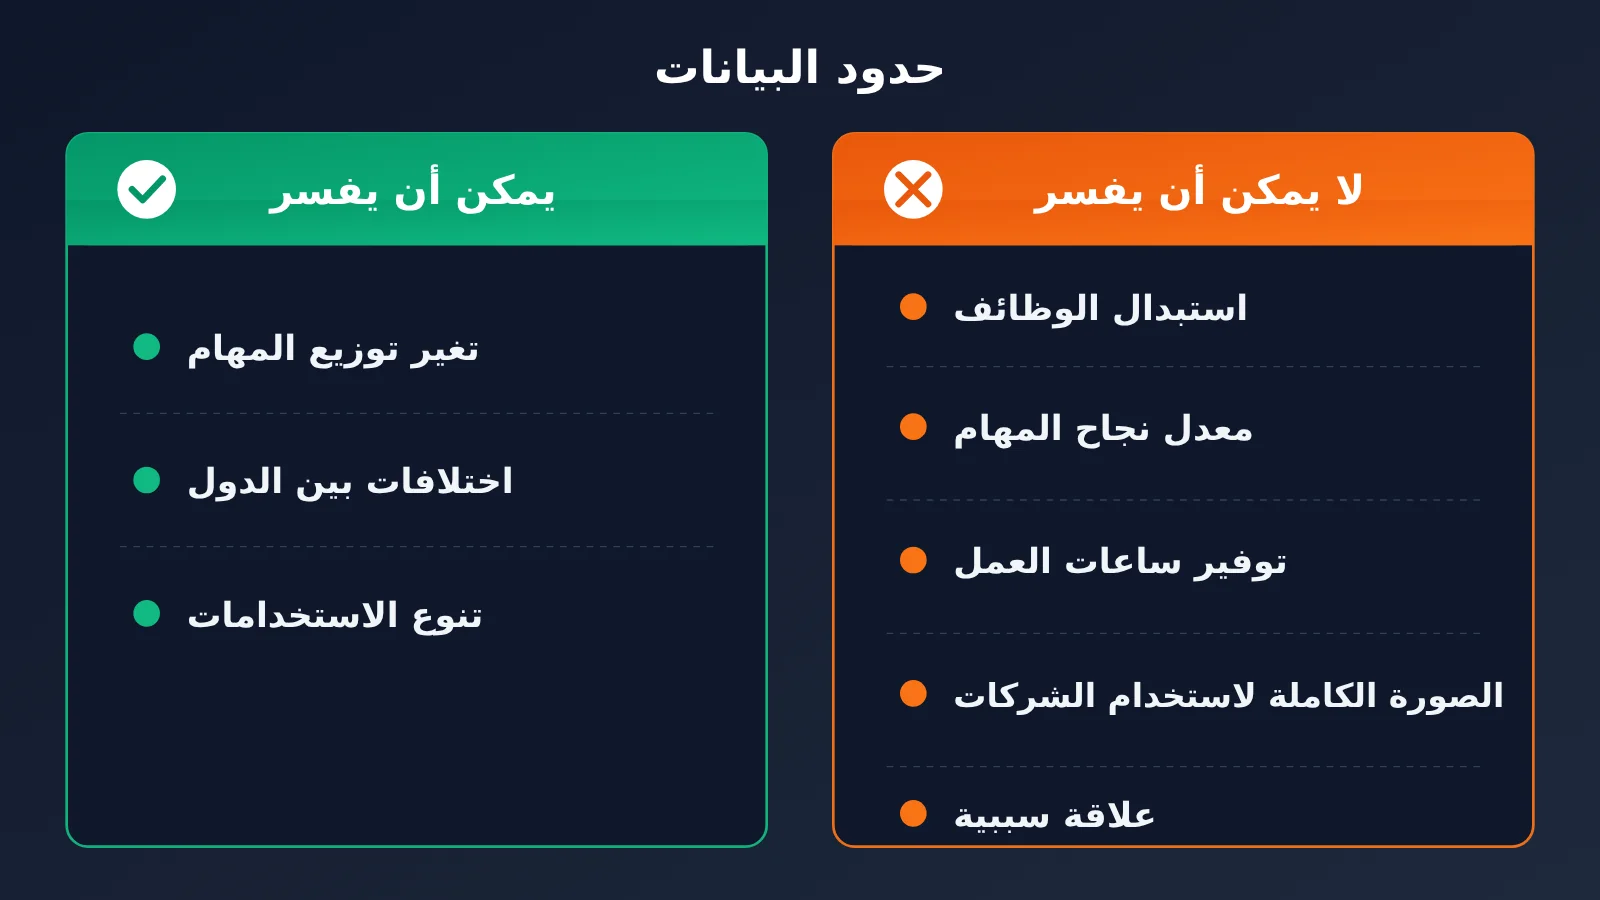
حدود بيانات OpenAI حول 165 فئة من أنشطة العمل
هذه البيانات قيّمة للغاية، لكن حدودها واضحة أيضاً. النقاط التالية هي الأهم عند الاستشهاد بها:
- العينة تشمل حسابات فردية للبالغين فقط: استُثنيت Enterprise وCodex، لذا لا يمكنها تمثيل كامل تطبيقات العمل في منتجات OpenAI المؤسسية.
- التصنيف يتم تلقائياً: قد يخطئ مصنّف نموذج اللغة الكبير في قراءة النية، فمثلاً “تصميم خطة ترويجية لنشاط ما” قد يكون عملاً تسويقياً حقيقياً أو اهتماماً شخصياً.
- نسبة الرسائل لا تساوي الإنتاجية: فهي لا تمثل عدد المهام أو ساعات العمل أو عدد المستخدمين أو الوقت الموفّر أو معدل النجاح.
- توجد ضوضاء خصوصية وحد أدنى للعينة: النتائج ذات العينات الصغيرة تُخفى، وتُضاف ضوضاء الخصوصية التفاضلية.
- لا تتطابق واحداً بواحد مع الاقتصاد الحقيقي: عند الترجيح بعدد العاملين، فإن حوالي 43% من أنشطة العمل الواقعية في الولايات المتحدة تقع في فئة “Other IWA”، وهذا لا يعني أن 43% من الوظائف لا يمكن للذكاء الاصطناعي إنجازها، ولا يعني أن الـ57% المتبقية تغطيها ChatGPT بالفعل.
بالإضافة إلى ذلك، تُظهر حسابات PPC Land أن نسبة الرسائل الشخصية المصنّفة كمتعلقة بالعمل انخفضت من حوالي 51.6% في يوليو 2024 إلى حوالي 32.2% في سبتمبر 2026. وهذا قد يعود بالأحرى إلى انضمام كبير من المستخدمين غير العاملين، وتحوّل بعض الأعمال المهنية إلى حسابات مؤسسية ووكلاء متخصصين، ولا يمكن بناءً عليه الحكم بأن ChatGPT أصبح أقل أهمية في بيئة العمل.
الأسئلة الشائعة (FAQ)
س1: ما هي بيانات الـ165 فئة من الأنشطة العملية التي نشرتها OpenAI؟
هذه مجموعة بيانات مجمّعة أعلن عنها برنامج OpenAI Signals v3.0، تربط الرسائل المرتبطة بالعمل لدى مستخدمي ChatGPT الأفراد بـ165 فئة من الأنشطة العملية الوسيطة وفق تصنيف O*NET، وتغطي قرابة 100 دولة ومنطقة، و7 أرباع سنوية تمتد من الربع الأول 2025 حتى الربع الثالث 2026، ويمكن تنزيلها بصيغة CSV مجانًا.
س2: ما الفرق بين الـ165 فئة من الأنشطة العملية والـ165 مهنة؟
نشاط العمل يجيب عن سؤال “ما الذي يُفعَل”، أما المهنة فتجيب عن سؤال “ما الوظيفة”. النشاط الواحد (مثل تحرير المستندات) قد يظهر في عدة مهن، لذلك تصف هذه البيانات أنواع الأعمال التي يُستخدم ChatGPT لإنجازها، وليس معدل الاستخدام في كل مهنة، ولا يمكن بحال استنتاج أي المهن قد تُستبدل.
س3: متى نُشرت هذه البيانات، وهل ستُحدَّث لاحقًا؟
نشرتها OpenAI في 26 أكتوبر 2026، والبيانات تمتد حتى الربع الثالث من 2026. وتتتبع الجهة الرسمية التغييرات على أساس ربع سنوي، أما مسألة استمرار التحديث لاحقًا فمرجعها الإعلانات المنشورة على صفحة بيانات OpenAI Signals، ولا يقدّم هذا المقال أي تخمين بهذا الشأن.
س4: انخفاض نسبة الرسائل البرمجية، هل يعني أن الطلب على البرمجة بالذكاء الاصطناعي يتراجع؟
لا يمكن الوصول إلى هذا الاستنتاج. فهذه البيانات تستثني Codex وحسابات المؤسسات، بينما يُظهر Enterprise Signals أن نسبة توكنات الإخراج لدى Codex في الجانب المؤسسي مرتفعة. قد يكون الطلب على البرمجة قد انتقل إلى وكلاء متخصصين، وقد يكون مرتبطًا بتغيّر تركيبة المستخدمين، والبيانات نفسها لا تستطيع التمييز بين الاحتمالين.
س5: كيف يمكن إعادة إنتاج تحليل مشابه لتصنيف الأنشطة العملية باستخدام API؟
يمكنك الرجوع إلى الشفرة النموذجية في هذا المقال، واستخدام نموذج لغة كبير لوسم طلبات المستخدمين لديك، ثم إحصاء النسب:
1. تفضّل بزيارة APIYI على apiyi.com لتسجيل حساب والحصول على مفتاح API
2. احصل على حصة اختبار مجانية للمستخدمين الجدد
3. اضبط `base_url` في الشفرة على `https://api.apiyi.com/v1`، وبذلك يمكنك تبديل النماذج لمقارنة نتائج التصنيف
س6: أريد مقارنة أداء النماذج المختلفة في مهام التصميم والكتابة الإعلانية والبرمجة، هل توجد طريقة سهلة؟
أسهل طريقة هي استدعاء عدة نماذج عبر واجهة موحدة، وتشغيل الدفعة نفسها من الموجهات مرة واحدة ثم التقييم يدويًا. عبر APIYI على apiyi.com يمكنك استدعاء نماذج OpenAI وClaude وGemini وغيرها بمفتاح واحد، مع الدفع حسب الاستخدام، وهو ما يناسب هذا النوع من التجارب المقارنة صغيرة الحجم.
أهم النقاط المستخلصة من بيانات OpenAI حول 165 فئة من أنشطة العمل
- موضوع الإحصاء هو الأنشطة وليس المهن: تشير الفئات الـ165 إلى أنشطة العمل في O*NET، وتتضمن فئة مجمّعة واحدة باسم “أخرى”.
- الاستخدامات أكثر توزعًا: انخفض متوسط حصة الأنشطة العشرة الأولى في 74 دولة من 56.0% إلى 51.1%.
- التصميم البصري سجّل أكبر زيادة: تُظهر حسابات طرف ثالث ارتفاعه من 3.1% إلى 7.9%.
- انخفضت حصة البرمجة لكن يجب تفسير ذلك بحذر: استبعدت العينة Codex وحسابات الشركات.
- الطلب التسويقي مستقر: بقيت حصة مواد التسويق والترويج عند نحو 5% تقريبًا.
- حصة الرسائل لا تعادل الإنتاجية: لا يمكن استنتاج استبدال الوظائف أو توفير ساعات العمل أو معدلات النجاح منها.
- يمكن إعادة استخدام منهجية التصنيف: بمساعدة واجهات النماذج المتعددة لدى APIYI عبر apiyi.com، يمكنك بناء تحليل تصنيف المهام الخاص بك بسرعة.
الخلاصة
أبرز ما تكشفه بيانات OpenAI حول استخدام ChatGPT في 165 فئة من أنشطة العمل:
- طبيعة البيانات: مجموعة بيانات بحثية مجانية ومفتوحة تُتابَع فصليًا، وتحصي أنشطة العمل التي تُنجَز عبر ChatGPT في الحسابات الشخصية.
- أبرز النتائج: أصبحت استخدامات العمل أكثر توزعًا؛ إذ ارتفعت حصص التصميم البصري والاستشارات والتفكير الإبداعي، بينما انخفضت حصة رسائل البرمجة العامة.
- حدود التفسير: لا تشمل البيانات حسابات الشركات ولا Codex، ولا يمكن مساواة حصة الرسائل بحجم العمل أو تأثير الوظائف أو القيمة الاقتصادية.
ما تكشفه هذه البيانات حقًا ليس المهن الـ165 التي قد تختفي، بل أن الذكاء الاصطناعي يدخل إلى مسارات عمل مختلفة بطرق أكثر تفصيلًا وتنوعًا، ويختلف ذلك باختلاف الدولة ونوع المهمة. وبالنسبة للمطورين، بدلًا من السؤال: “من سيحل الذكاء الاصطناعي محله؟”، من الأجدى معرفة الأنشطة التي يستخدم المستخدمون الذكاء الاصطناعي لإنجازها فعليًا، ثم اختيار النموذج وسير العمل المناسبين لها.
نوصي بالتحقق سريعًا من أداء النماذج المختلفة في سيناريوهات عملك عبر APIYI apiyi.com؛ إذ توفر المنصة رصيدًا تجريبيًا مجانيًا وواجهة موحدة للنماذج المتعددة.
📚 المراجع
- إعلان OpenAI الرسمي: عالم عمل ChatGPT يتوسّع – المصدر الأساسي لهذا الإصدار
- الرابط:
openai.com/index/chatgpt-expanding-world-of-work -
الوصف: 165 فئة نشاط، ما يقارب 100 دولة، ونتائج رسمية مثل 56.0% إلى 51.1%
-
تنزيل بيانات OpenAI Signals وشرح المنهجية – مدخل ملف CSV الأصلي وقاموس البيانات
- الرابط:
openai.com/signals/data-download -
الوصف: نطاق العينة، والمعالجة الخاصة بالخصوصية، وبيان ترخيص CC BY 4.0
-
PPC Land: الكتابة تنخفض من 34% إلى 21% من طلبات ChatGPT منذ يوليو 2024 – تحليل ملف CSV من طرف ثالث
- الرابط:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
الوصف: ترتيب الأنشطة المحددة، والتغيّر في نسب التصميم البصري والبرمجة
-
PPC Land: الأمريكيون يستخدمون ChatGPT في العمل أكثر لاتخاذ القرارات – قراءة الرسوم البيانية التفاعلية بين美德
- الرابط:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
الوصف: بيانات المقارنة بين الدول حول أنشطة العمل الواسعة
-
الموقع الرسمي لـ O*NET – نظام تصنيف أنشطة العمل والمهن
- الرابط:
onetcenter.org -
الوصف: فهم تعريف IWA و332 مدخلًا مرجعيًا
-
OpenAI Enterprise Signals – بيانات استخدام حسابات المؤسسات
- الرابط:
openai.com/signals/enterprise-data - الوصف: يُستخدم للتمييز بين معايير البيانات الفردية وبيانات المؤسسات
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد التكامل يمكنكم زيارة مركز التوثيق docs.apiyi.com




