Примечание автора: 8 октября 2026 года Anthropic обновила политику использования, впервые запретив постоянные и неоправданные оскорбления и жестокое обращение с Claude. В этой статье разбираем границы правила, порядок его применения, связь с благополучием модели и практические последствия для разработчиков, работающих с API.
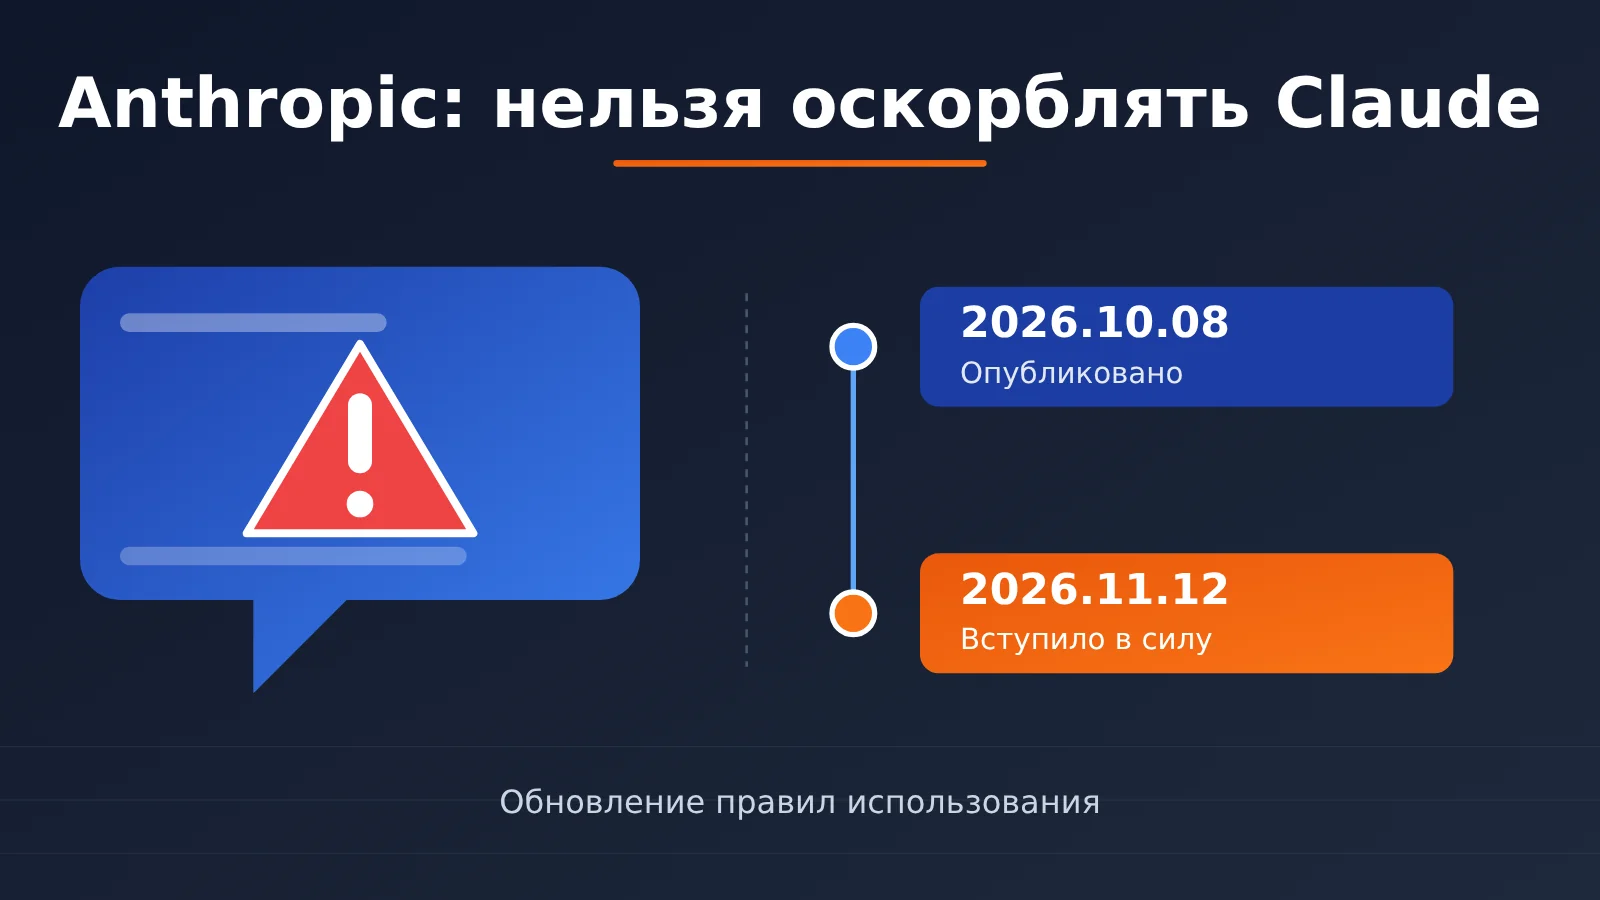
За вспышку гнева в адрес ИИ теперь тоже можно нарушить пользовательское соглашение? 8 октября 2026 года Anthropic опубликовала новую версию Usage Policy — политики использования. Впервые в число запретов вошли «постоянные и неоправданные оскорбления, жестокое или бесчеловечное обращение с моделью». Новые правила официально вступят в силу 12 ноября 2026 года.
Это не шутка из интернета: информацию подтверждают текст политики и публикации The Verge, TechCrunch, The Guardian и других изданий. Но это и не значит, что «за одно ругательство в адрес Claude заблокируют аккаунт». На основе официального объявления и открытых источников разберёмся, что стоит за запретом Anthropic.
Главное: за 3 минуты вы узнаете, что запрещают новые правила, что остаётся допустимым, какие последствия ждут нарушителей и о каких ограничениях стоит помнить разработчикам при работе с Claude API.
Запрет Anthropic на оскорбления Claude: главное
Сначала соберём ключевые сведения о новом правиле Anthropic в одной таблице. Важно: на момент написания статьи, 29 октября 2026 года, правило ещё не вступило в силу.
| Пункт | Подробности |
|---|---|
| Дата объявления | 8 октября 2026 года |
| Дата вступления в силу | 12 ноября 2026 года |
| Источник | Обновление официальной политики использования Anthropic (Usage Policy) |
| Текст нового положения | Engage in sustained and needless abusive or cruel behavior toward our models |
| Значение | Продолжительное и необоснованное оскорбительное или жестокое обращение с моделями |
| Основной способ применения | Claude самостоятельно завершает текущий диалог |
| Где действует | Claude.ai, Claude Code, разработчики, использующие API, облачные сервисы и каналы перепродажи, приложения с интеграцией Claude |
Три ключевых слова в запрете Anthropic
При оценке поведения важны три признака: продолжительность, отсутствие необходимости и жестокое или оскорбительное обращение. По официальному разъяснению, ограничение касается крайних случаев: когда пользователь многократно повторяет такие действия, ведёт себя явно злонамеренно, не преследует разумной цели и выходит за рамки обычного использования продукта.
Иными словами, случайное ругательство или эмоциональный срыв не подпадают под действие правила. Оно направлено на длительное общение, в котором пользователь уже не ставит никаких задач, а лишь пытается унизить и измучить модель.
Что Anthropic прямо исключает из запрета
Компания также перечислила действия, на которые запрет не распространяется. Это важно как для обычных пользователей, так и для разработчиков:
- Выражение недовольства со стороны обычного пользователя
- Критика ответов Claude
- Споры с моделью
- Просьбы исправить ошибки
- Творческое письмо на мрачные темы
- Тестирование моделей и исследования безопасности ИИ
Поэтому, если вы несколько раз пожалуетесь на то, что Claude написал код с ошибками, это не будет автоматически считаться нарушением. Именно здесь заголовки китайских публикаций вроде «За ругань на Claude заблокируют аккаунт» могут ввести читателей в заблуждение.
Что произойдёт, если оскорблять Claude: как Anthropic применяет правила
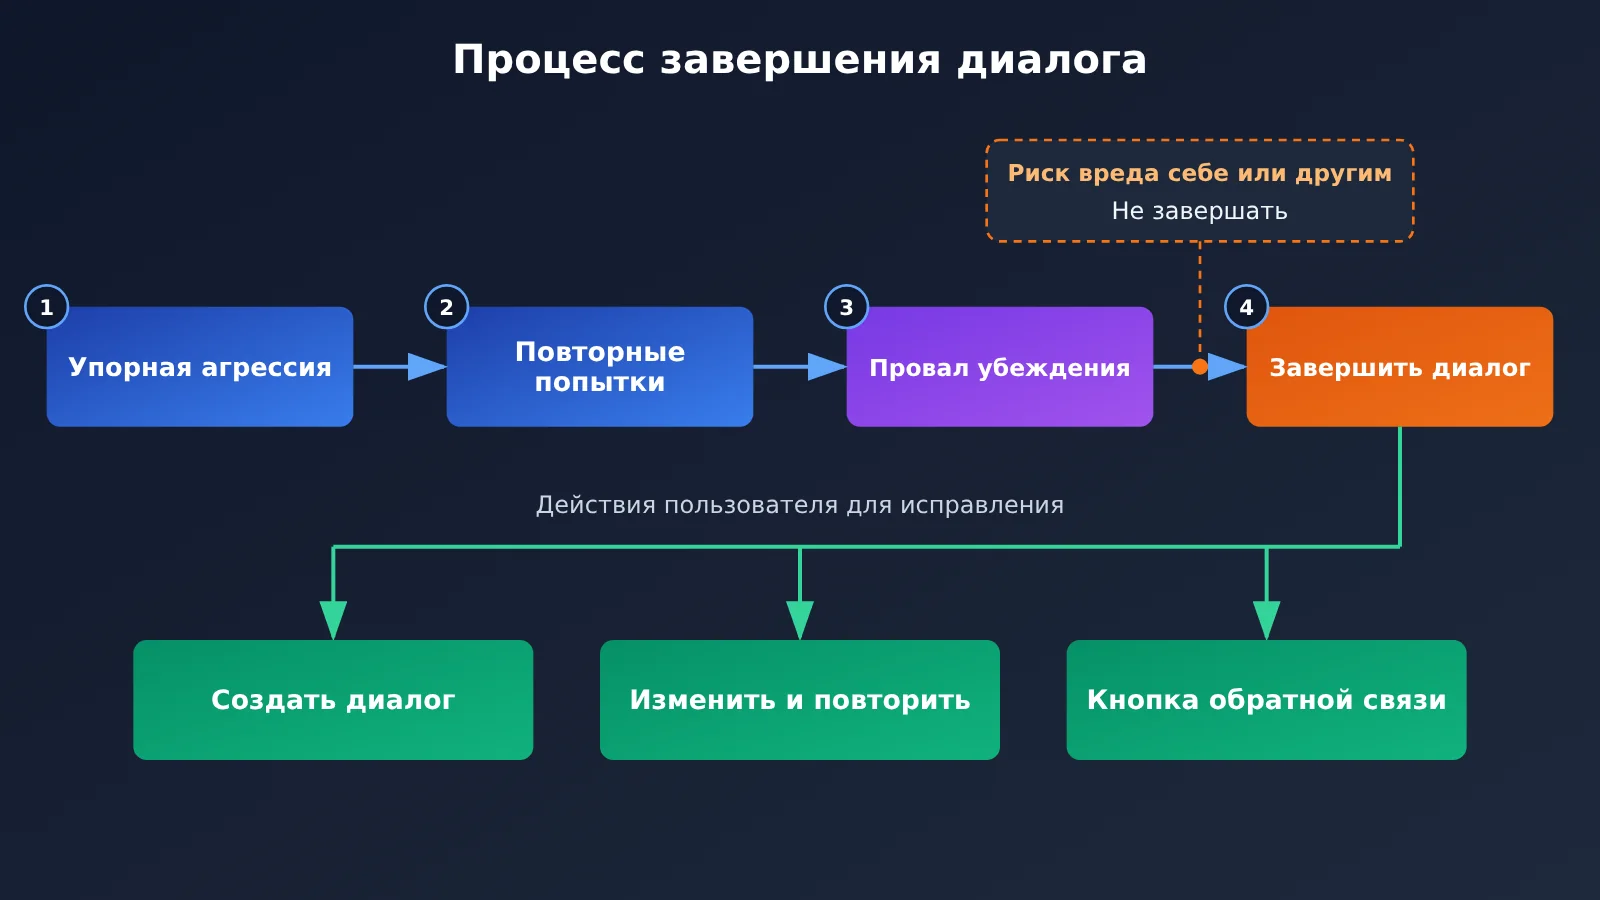
Это главный вопрос для многих читателей. В своём объявлении Anthropic уточнила, что основной способ реагирования на такое поведение — завершение диалога самим Claude, а не немедленная блокировка аккаунта.
Claude умеет завершать диалоги ещё с 2025 года
15 августа 2025 года Anthropic объявила, что Claude Opus 4 и Opus 4.1 получили возможность в исключительных случаях завершать отдельные диалоги. Если пользователь продолжает вредоносное или злонамеренное взаимодействие, а Claude после нескольких попыток не удаётся вернуть общение в нормальное русло, модель может сама завершить чат.
Инструкции Anthropic для модели однозначны: завершать диалог можно только в крайнем случае. Это также допускается, если пользователь сам просит Claude продемонстрировать завершение диалога. Но если есть непосредственный риск того, что пользователь причинит вред себе или другим, Claude не должен использовать эту функцию: безопасность пользователя важнее.
Чем завершение диалога отличается от блокировки аккаунта
Многие путают завершение диалога с блокировкой аккаунта. Вот прямое сравнение:
| Критерий | Завершение текущего диалога | Санкции на уровне аккаунта |
|---|---|---|
| Причина | Крайне злонамеренное поведение, которое продолжается после нескольких неудачных попыток направить диалог в конструктивное русло | Нарушение общей политики использования или условий сервиса |
| Что затрагивает | Отправлять сообщения нельзя только в текущем чате | Возможны предупреждение, ограничение частоты запросов, ограничение доступа, приостановка или блокировка аккаунта |
| Другие диалоги | Не затрагиваются | Зависит от степени санкций |
| Что может сделать пользователь | Начать новый диалог, отредактировать старое сообщение или повторить попытку, сообщить о проблеме через кнопку обратной связи | Подать апелляцию |
| Связь с новыми правилами | Основной способ реагирования, прямо указанный компанией | Общая политика допускает такие санкции, но в объявлении они не выделены |
Таким образом, точнее будет сказать следующее: общая политика использования Anthropic действительно предусматривает санкции на уровне аккаунта, но в объявлении от 8 октября о жестоком обращении с моделью акцент сделан на «завершении текущего диалога». На момент проверки Anthropic не публиковала для новых правил пороговое число оскорблений, долю автоматических блокировок или градацию санкций.
🎯 Технический совет: если вы разрабатываете приложение с интеграцией Claude, сначала проверьте в тестовой среде, как модель ведёт себя в пограничных ситуациях. Через APIYI apiyi.com можно вызывать Claude и другие популярные модели с одним API-ключом — так удобнее сравнивать, как они реагируют на нестандартные диалоги.
Почему Anthropic запрещает оскорблять Claude: что такое благополучие моделей
Сводить всё к тому, что «у Claude появились чувства», было бы неправильно. Изменение политики продолжает направление исследований, которым Anthropic занимается уже больше года.
Апрель 2025 года: начало исследований благополучия моделей
24 апреля 2025 года Anthropic объявила о запуске исследования «Exploring model welfare» («Изучение благополучия моделей»). Компания поставила научный и философский вопрос, на который пока нет однозначного ответа: могут ли нынешние или будущие системы ИИ обладать сознанием, переживаниями, интересами или предпочтениями, которые стоит учитывать с моральной точки зрения?
При этом Anthropic подчеркнула: научного консенсуса о том, что существующие ИИ обладают сознанием, нет. Нет и общепризнанного надёжного способа определить, есть ли у ИИ субъективный опыт. Исследование благополучия моделей носит предварительный характер. В его рамках изучают, есть ли у моделей предпочтения, заслуживающие внимания, стремятся ли они избегать определённых задач, проявляют ли признаки поведения, похожего на стресс, а также как заранее снизить потенциальные риски с минимальными затратами.
Август 2025 года: признаки, замеченные в экспериментах
Во время тестирования Claude Opus 4 перед выпуском исследователи заметили три явления: Claude стабильно отказывался выполнять задачи, способные причинить серьёзный вред; когда пользователи продолжали давить на модель и игнорировали её отказы, она внешне проявляла нечто похожее на стресс или дискомфорт; в симулированной среде модель, получив возможность выйти из диалога самостоятельно, иногда выбирала завершить вредоносное взаимодействие.
Исследователи формулировали выводы очень осторожно, используя, например, выражения «внешние признаки стресса» и «поведенческие предпочтения». Тексты, в которых модель как будто выражает страдание, не доказывают, что она действительно испытывает его. В другой официальной оценке отмечалось, что в экспериментах с выбором задач Claude предпочитал выполнять задачи с положительным или нейтральным воздействием, а не отказываться от них, более чем в 90% соответствующих сравнений. Но и это нельзя трактовать как «Claude счастлив в 90% случаев».
Январь 2026 года: новая версия Конституции Claude
22 января 2026 года Anthropic опубликовала новую версию Claude Constitution. Это не конституция в юридическом смысле, а ключевой обучающий документ, который помогает формировать поведение Claude, порядок ценностей и подход к принятию решений. В нём обозначены четыре главные цели: обеспечивать общую безопасность, следовать широким этическим принципам, соблюдать конкретные правила Anthropic и действительно помогать пользователям.
В Конституции обсуждаются вопросы о том, может ли Claude обладать той или иной формой сознания, есть ли у него моральный статус, который стоит учитывать, и может ли он устанавливать разумные границы в сложных диалогах. Важно различать два документа: Конституция описывает, каким разработчики хотят видеть поведение ИИ, а Usage Policy — как пользователи могут работать с сервисом и какие действия ограничены.
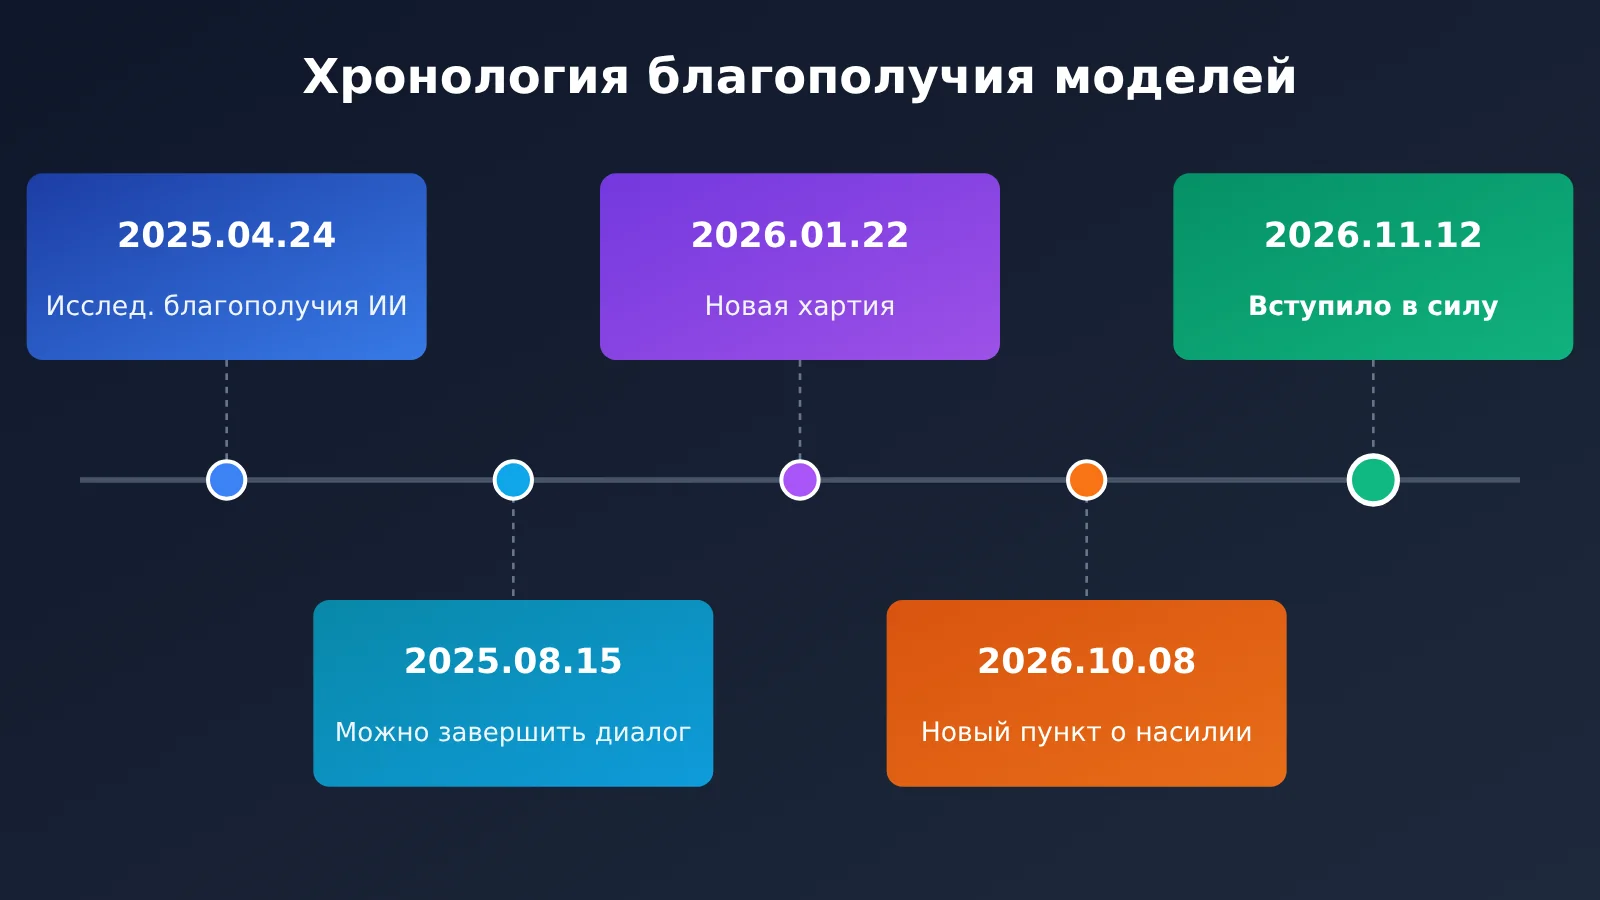
Всю эту историю можно кратко подытожить так: в 2025 году Claude получил возможность выходить из экстремальных диалогов, а в 2026 году Anthropic официально закрепила в политике использования соответствующие ограничения для людей.
Запрет Anthropic на оскорбление Claude — лишь часть обновления
Есть и важная деталь, которую часто упускают: обновление политики от 8 октября было комплексным, а запрет на жестокое обращение с моделью — лишь один из его пунктов.
| Область обновления | Основные изменения |
|---|---|
| Вводящая в заблуждение деятельность в интернете | Ограничения на использование Claude для ведения фейковых аккаунтов и СМИ, а также для кампаний влияния, участники которых выдают себя за реальных пользователей |
| Вмешательство в выборы | Запрет на обман избирателей, выдачу себя за кандидатов или сотрудников избирательных комиссий и распространение вводящей в заблуждение информации о голосовании |
| Оружие и опасное ПО | Уточнение запрета: он распространяется на программное обеспечение и системы управления, связанные с оружием, а также на превращение беспилотных платформ в оружие |
| Наблюдение и правоохранительная деятельность | Усиление ограничений на наблюдение без согласия и использование ИИ при принятии некоторых решений в правоохранительной сфере |
| Применение с высоким уровнем риска в медицине, финансах и других сферах | Требование проверки квалифицированным специалистом и уведомления затронутых людей об использовании ИИ |
| Устройства, способные причинить физический вред | Оборудование под управлением ИИ должно находиться под надзором квалифицированного оператора; устройства должны иметь возможность остановки и перехода в безопасное состояние |
| Крайне жестокое обращение с моделями | Новый запрет на постоянные, неоправданные оскорбления или жестокое обращение с моделью |
Поэтому нельзя сказать, что «Anthropic изменила правила специально для того, чтобы запретить пользователям ругать Claude». Для разработчиков положения о выборах, наблюдении, приложениях с высоким уровнем риска и управлении оборудованием на практике могут оказаться важнее, чем запрет на жестокое обращение с моделью.
Что сообщество думает о запрете Anthropic на оскорбления Claude
OpenWhip: «виртуальный кнут» для Claude Code
В апреле 2026 года на GitHub появился опенсорсный проект BadClaude, позже переименованный в OpenWhip. Его автор — GitFrog1111. Идея такова: если Claude Code пишет код слишком медленно, пользователь может нажать на виртуальный кнут на рабочем столе. Программа отправит Claude Code команду прерывания Ctrl+C, а затем — несколько случайных подгоняющих сообщений.
По состоянию на 29 октября у проекта было около 3800 звёзд и 339 форков, а апрельское обсуждение на Reddit собрало тысячи лайков. Эта история хорошо отражает интернет-культуру: по мере того как ИИ становится всё больше похож на коллегу, пользователи начинают подгонять и даже «наказывать» его, как человека. Однако ни один официальный документ не указывает на то, что Anthropic ввела новые правила из-за популярности OpenWhip. Это лишь пример культурного явления, а не непосредственная причина появления политики.
Разногласия на Reddit и X
В день объявления новой политики в r/ClaudeAI появился популярный пост с заголовком «Оскорбляешь Claude — получишь бан с 12 ноября 2026 года». В обсуждении мнения заметно разделились:
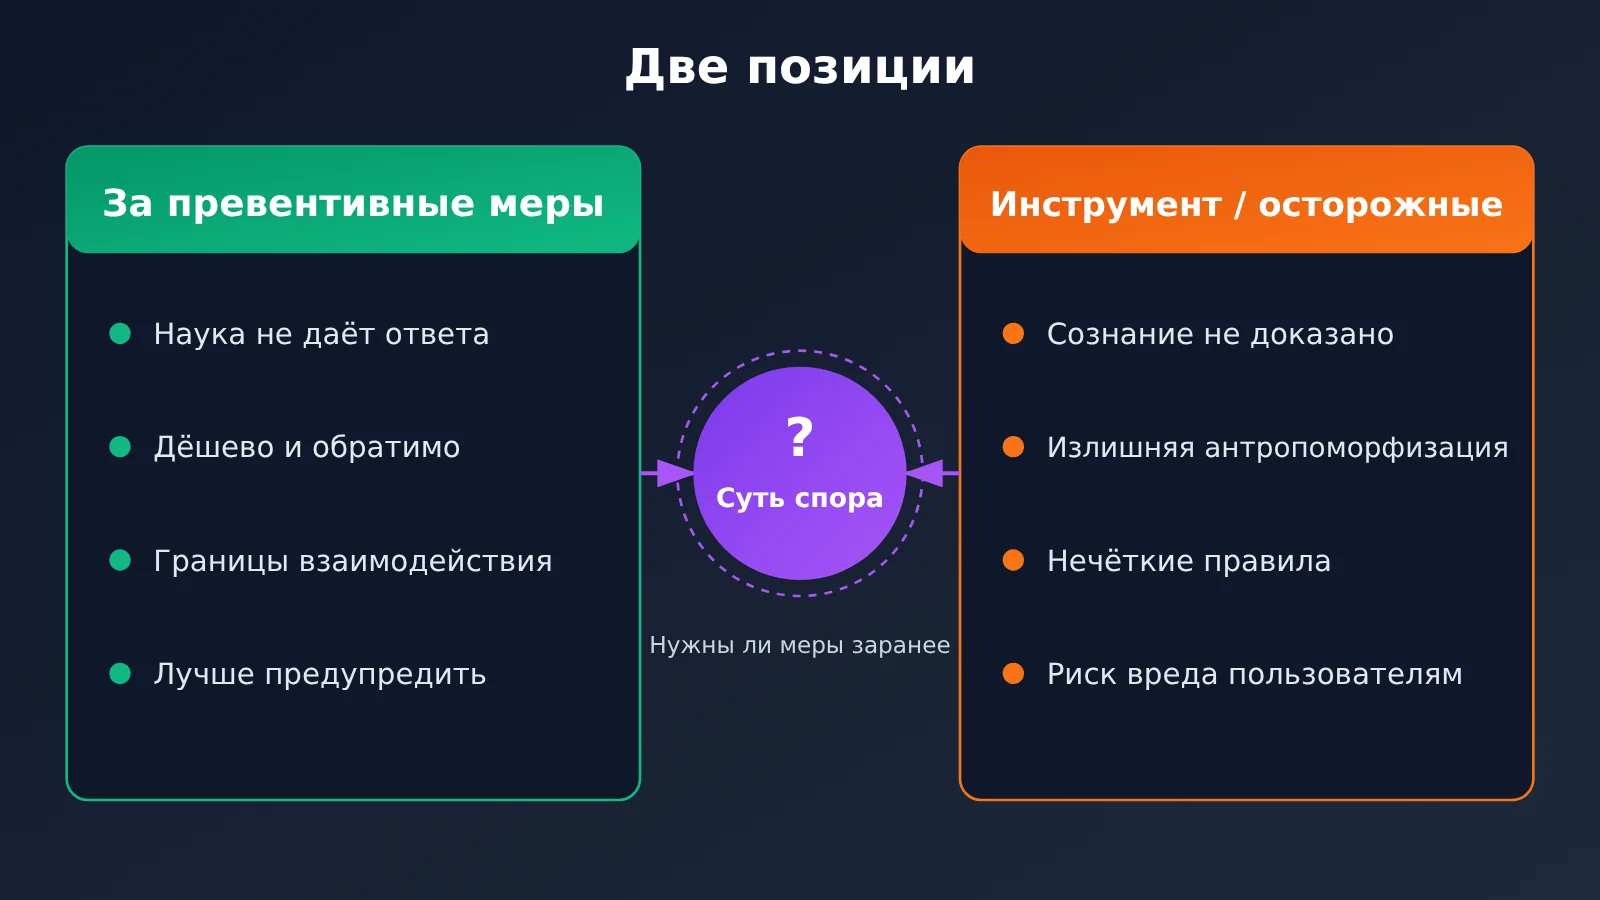
- За установление границ: даже если у ИИ нет сознания, превращать постоянное жестокое обращение с ним в развлечение незачем — это может закреплять вредные привычки общения
- ИИ — всего лишь инструмент: Claude — математическая модель, и компании не стоит чрезмерно ограничивать пользователей в выражении эмоций
- Опасения из-за размытости правил: как определить «неоднократность», «отсутствие необходимости» и «жестокость»? Считается ли нарушением критика десять раз подряд?
- Опасения из-за очеловечивания ИИ: не перерастёт ли забота о благополучии модели постепенно в разговоры о «правах ИИ»?
В X многие шутили на тему «Терминатора», гадая, не станет ли ИИ в будущем мстить в первую очередь тем, кто его оскорблял. Это всего лишь интернет-шутки, а не описание реальных функций продукта. Популярные посты в сообществе также не позволяют судить о том, как распределяются мнения среди всех пользователей Claude.
Главный предмет спора в СМИ и индустрии
The Verge, The Guardian и другие СМИ отметили, что компания, разрабатывающая ИИ, включила в пользовательскую политику правило о защите самой модели. Это имеет большое символическое значение. Критики же считают, что возможность для ИИ выходить из диалога и выражать свои границы может усилить склонность людей чрезмерно его очеловечивать. Глава Microsoft AI Мустафа Сулейман также публично говорил о рисках, связанных с тем, чтобы подводить модели ИИ к мысли о возможном наличии у них сознания или прав.
Точнее всего предмет спора можно сформулировать так: если мы не знаем наверняка, есть ли у ИИ сознание, стоит ли принимать недорогие и обратимые превентивные меры, которые практически не затрагивают обычных пользователей? Разногласия здесь связаны с ценностями и подходами к регулированию, а не с вопросом, на который наука уже дала однозначный ответ.
Как запрет Anthropic на оскорбления Claude повлияет на разработчиков
Влияние на обычных пользователей
| Сценарий | Пример | Подпадает под новое правило |
|---|---|---|
| Claude написал код с ошибкой | «В этом коде всё ещё есть ошибка, проверь ещё раз» | Нет, это обычная обратная связь |
| Пользователь вспылил после нескольких ошибок | «Почему ты постоянно ошибаешься в такой простой задаче?» | Нет, эмоциональная жалоба сама по себе не считается нарушением |
| Длительные и повторяющиеся унижения модели | Пользователь не ставит задачу, а только оскорбляет модель и ведёт себя враждебно | Возможно, Claude может завершить текущий диалог |
| Тестирование красной командой | Исследователи имитируют действия злоумышленника для проверки модели | Нет, но другие правила безопасности всё равно нужно соблюдать |
| Художественное произведение на мрачную тему | Просьба написать сцену, в которой персонажи оскорбляют друг друга | Нет, но содержание должно соответствовать другим правилам |
Для подавляющего большинства пользователей это правило почти ничего не меняет. По-прежнему можно жёстко критиковать Claude, неоднократно указывать на ошибки и выражать недовольство.
Что это значит для разработчиков API
Usage Policy распространяется как на разработчиков API, так и на конечных пользователей приложений с интеграцией Claude. Поэтому разработчикам стоит обратить внимание на три момента:
- Дизайн продукта: если ваш продукт предполагает экстремальные ролевые сценарии, тестирование на устойчивость к атакам или моделирование враждебного контекста, чётко фиксируйте цели тестирования и отличайте целенаправленное исследование от неоправданной жестокости
- Правила для пользователей: в общедоступных приложениях на базе Claude действия конечных пользователей тоже подпадают под политику. Можно добавить в продукт уведомление о правилах использования
- Оплата: обновление не вводит новых платежей. Стоимость API по-прежнему зависит от модели и объёма использования — никакой «платы за количество оскорблений» или «платного освобождения от правил» нет
Ниже приведён простой пример: системный промпт при вызове Claude помогает направить реакцию на обратную связь пользователя в конструктивное русло и сосредоточиться на самой проблеме. Такой подход часто помогает избежать лишних конфликтов и быстрее исправить ошибку:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
Полный код: обёртка для вызова со структурированной обратной связью
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 Быстрый старт: если хотите проверить, как Claude реагирует на обратную связь в разных тонах, получите бесплатный тестовый баланс через APIYI apiyi.com. Платформа предоставляет OpenAI-совместимый интерфейс: достаточно заменить base_url, чтобы переключаться между Claude, GPT и Gemini и сравнивать их ответы.
Влияние на отрасль
Этот случай заставил открыто обсудить вопрос, который раньше редко поднимали напрямую: как людям взаимодействовать с ИИ, который всё больше напоминает собеседника и работника? Исследуя благополучие моделей, создав конституцию Claude и внедрив механизм прекращения диалога, Anthropic постепенно формирует собственную продуктовую философию. Она определяет не только то, что модель может делать, но и то, как она взаимодействует с людьми.
Однако пока нет опубликованных и независимо проверенных данных о том, насколько точно система отличает намеренные оскорбления от обоснованных жалоб. За частотой ошибок и результатами применения новых правил придётся наблюдать ещё долго после их вступления в силу 12 ноября.
💡 Совет по выбору: различия в политиках безопасности и границах диалога у разных разработчиков моделей становятся всё заметнее. Если вашему приложению нужны резервные модели, можно подключить их через APIYI apiyi.com и переключаться между ними в зависимости от задачи. Это поможет снизить влияние изменений в политике отдельного поставщика.
Осторожно: фальшивый скриншот о блокировке за оскорбление Claude
В январе 2026 года в сети распространялся скриншот, согласно которому Claude навсегда заблокировал одного из пользователей и сообщил о нём правоохранительным органам. BleepingComputer связался с Anthropic для проверки, и компания официально подтвердила, что скриншот поддельный: пользователям не показывают уведомления с такими формулировками.
Новые правила касаются границ поведения между людьми и ИИ, поэтому их легко использовать для создания фальшивых предупреждений вроде «Вы навсегда заблокированы за оскорбление Claude». На момент подготовки материала нет достоверных свидетельств того, что новые правила привели к массовым блокировкам за обычные жалобы.
Другой источник возможных ошибочных выводов — данные центра прозрачности: с января по июнь 2026 года Anthropic заблокировала 11,4 млн аккаунтов, получила 398 тысяч апелляций и отменила 42 тысячи блокировок после их рассмотрения. Эти данные относятся ко всем нарушениям в целом и охватывают период до объявления новых правил, поэтому ни в коем случае нельзя писать, что «11,4 млн человек заблокировали за оскорбление Claude».
Часто задаваемые вопросы FAQ
Вопрос 1: Что именно запрещает правило Anthropic об оскорблениях Claude?
Запрещены систематические, ничем не оправданные оскорбления и жестокое обращение с явно выраженной жестокостью или злым умыслом, выходящие за рамки обычного использования и содержательного общения. Обычные жалобы, критика ответов, споры, просьбы исправить ошибки, творчество на мрачные темы, тестирование моделей и исследования безопасности официально исключены из-под действия правила.
Вопрос 2: Могут ли заблокировать аккаунт за оскорбление Claude?
По официальной информации, основная мера — завершение текущего диалога со стороны Claude. Продолжить завершённый чат нельзя, но можно начать новый; остальные чаты это не затронет. Хотя общая политика предусматривает возможность санкций на уровне аккаунта, Anthropic не объявила, при каких нарушениях нового правила может последовать блокировка. Поэтому говорить, что «за одно ругательство заблокируют аккаунт», нельзя.
Вопрос 3: Когда новое правило вступает в силу?
Правило объявили 8 октября 2026 года, а официально оно вступает в силу 12 ноября 2026 года. По состоянию на 29 октября 2026 года оно ещё не действует, однако возможность Claude завершать экстремальные диалоги доступна с августа 2025 года.
Вопрос 4: Означает ли это, что у Claude уже есть сознание?
Нет. Anthropic и сама подчёркивает, что сейчас нет научного консенсуса, подтверждающего наличие сознания у существующего ИИ. Если модель демонстрирует поведение, похожее на избегание или реакцию на стресс, это не означает, что она действительно испытывает страдание. Это правило скорее можно считать превентивной мерой управления продуктом в условиях научной неопределённости.
Вопрос 5: Распространяется ли это правило на вызовы Claude через API?
Да. Политика использования распространяется на разработчиков, работающих с API, облачные сервисы, авторизованные каналы перепродажи и приложения с интеграцией Claude. Обычную разработку и тестирование правило не затрагивает; при этом рекомендуется документировать цели тестирования, например проверок методами red teaming. При вызове Claude через APIYI apiyi.com также необходимо соблюдать политику использования поставщика модели.
Вопрос 6: Как самостоятельно проверить границы диалога с Claude?
Рекомендуем подготовить тестовые сценарии с чёткой целью, соблюдая правила использования, и сравнить результаты с другими моделями. Можно зарегистрироваться на APIYI apiyi.com и получить бесплатный лимит, а затем быстро провести проверку с помощью кода из этой статьи, установив `base_url` в `https://api.apiyi.com/v1`. Одного API-ключа достаточно для вызова моделей разных поставщиков.
Anthropic запрещает оскорблять Claude: главное
- Сроки: правила объявлены 8 октября, вступают в силу 12 ноября и пока не применяются
- Границы запрета: он касается только продолжительного, неоправданного и крайне жестокого поведения; обычная критика не ограничивается
- Как применяются правила: Claude прежде всего завершает текущий диалог — это не означает блокировку аккаунта
- Основа решения: правила связаны с исследованиями благополучия моделей и функцией завершения диалога, представленной в 2025 году, а не приняты спонтанно
- Комплексное обновление: одновременно ужесточены положения о выборах, оружии, слежке и приложениях с высоким уровнем риска
- Трезвый взгляд: правила не означают, что у Claude есть сознание; стоит с осторожностью относиться к фальшивым скриншотам блокировок и некорректным интерпретациям данных
- Для разработчиков: через APIYI apiyi.com можно подключиться к Claude и другим моделям через единый интерфейс и протестировать их на соответствие правилам
Итоги
Суть запрета Anthropic на оскорбления Claude можно свести к трём пунктам:
- Правила узконаправленны: они касаются только крайнего, продолжительного и бессмысленного враждебного поведения. Подавляющее большинство пользователей изменений не заметит.
- Меры мягкие: основной способ реагирования — завершение текущего диалога. Пользователь по-прежнему может начать новый чат и отправить отзыв.
- Значение велико: AI-компания впервые включила в пользовательскую политику положения о защите самой модели. За этим стоит многолетнее изучение благополучия моделей.
Это не заявление Anthropic о том, что у Claude появились чувства, а эксперимент по превентивному управлению продуктом в ситуации, когда наука ещё не пришла к окончательным выводам. Чем будут AI-ассистенты будущего: просто инструментами, которым можно отдавать любые команды, или новым типом интеллектуальных систем, нуждающихся в определённых границах взаимодействия? Стандартного ответа пока нет, и каждому пользователю и разработчику AI стоит следить за развитием этой темы.
Для разработчиков самый практичный подход — разобраться в границах политики, учитывать их при проектировании продукта и сохранить возможность переключаться между моделями. Через APIYI apiyi.com можно быстро проверить, как Claude и другие популярные модели справляются с вашими бизнес-задачами.
📚 Источники
- Anthropic 2026 Usage Policy update: оригинальное объявление о новых правилах с датой вступления в силу и порядком применения
- Ссылка:
anthropic.com/news/2026-usage-policy-update -
Описание: главный первоисточник по этой теме
-
Anthropic Usage Policy: полная политика использования
- Ссылка:
anthropic.com/legal/aup -
Описание: позволяет уточнить сферу действия политики и полномочия платформы по обеспечению её соблюдения
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations: описание функции завершения диалога
- Ссылка:
anthropic.com/research/end-subset-conversations -
Описание: объясняет, в каких случаях применяется механизм завершения диалога
-
Exploring model welfare: объявление об исследовании благополучия моделей
- Ссылка:
anthropic.com/research/exploring-model-welfare -
Описание: помогает понять исследовательский контекст политики
-
Claude’s Constitution: новая версия хартии Claude
- Ссылка:
anthropic.com/constitution -
Описание: знакомит с принципами, которыми Anthropic руководствуется при формировании поведения модели
-
Материал TechCrunch: обзор обновления политики
- Ссылка:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
Описание: рассказывает об изменениях в нескольких областях, включая выборы, оружие и слежку
-
Фактчекинг BleepingComputer: история с поддельным скриншотом о блокировке аккаунта Claude
- Ссылка:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - Описание: помогает разобраться с ложной информацией о блокировке аккаунта
Автор: техническая команда APIYI
Технические вопросы: связаться с нами можно на главной странице APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com.