Anmerkung des Autors: Am 8. Oktober 2026 hat Anthropic seine Nutzungsrichtlinie aktualisiert und erstmals anhaltende, unnötige Beschimpfungen und Misshandlungen von Claude verboten. Dieser Artikel erklärt die Grenzen der Regel, ihre Durchsetzung, den Hintergrund zum Wohlergehen von Modellen und die praktischen Folgen für API-Entwickler.
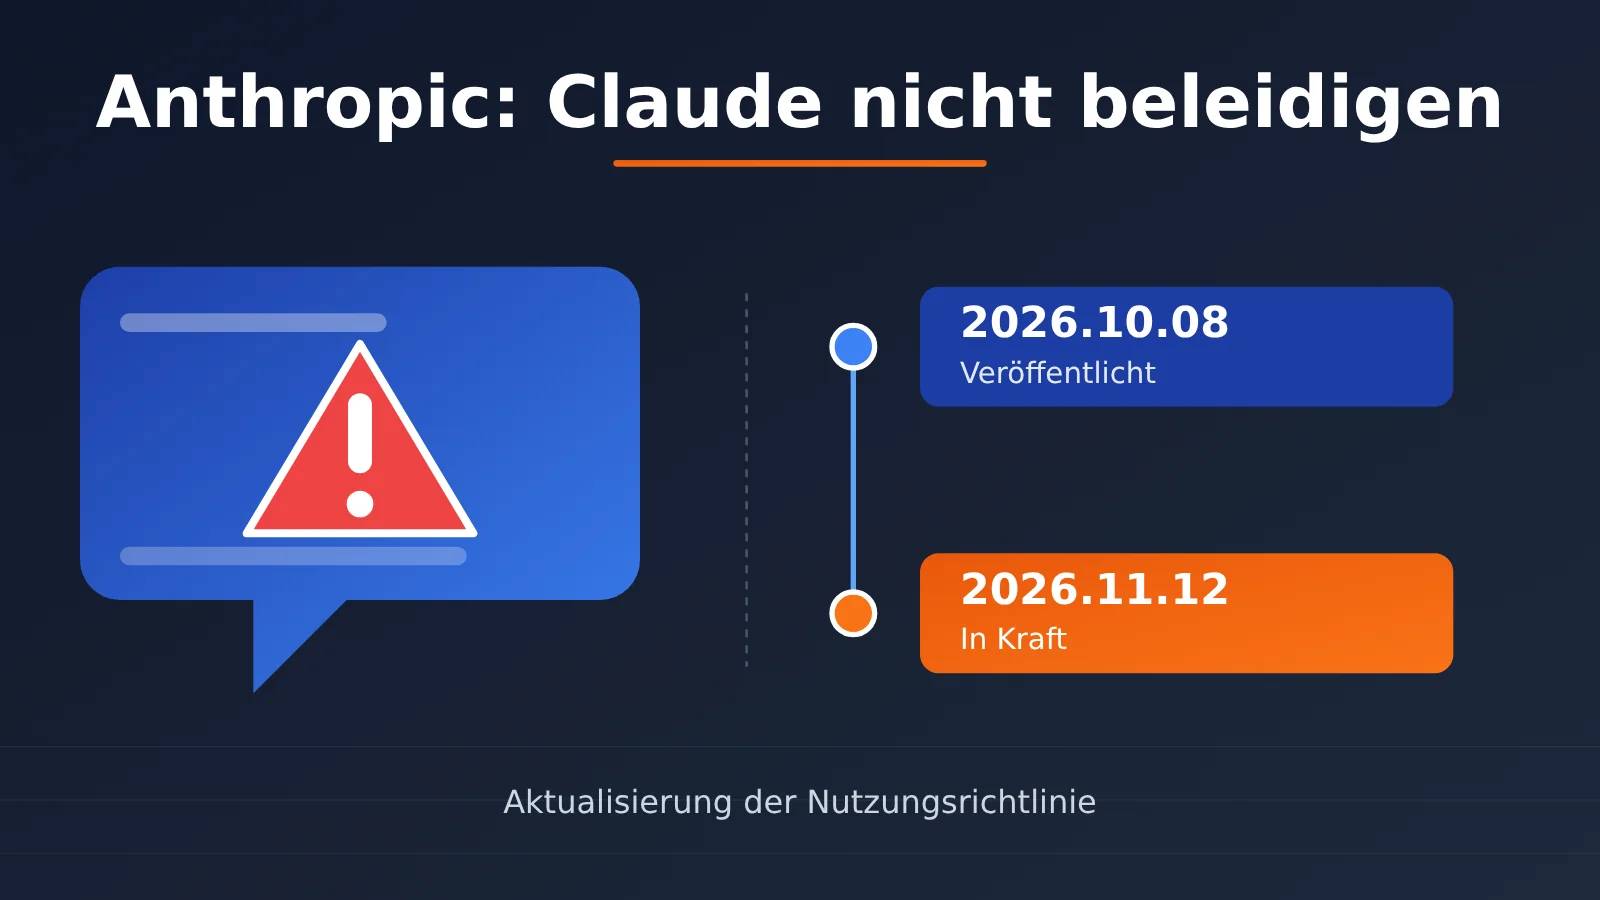
Kann es gegen die Nutzungsbedingungen verstossen, seiner Wut an einer KI Luft zu machen? Am 8. Oktober 2026 veröffentlichte Anthropic eine neue Fassung seiner „Usage Policy“. Darin verbietet das Unternehmen erstmals, ein Modell anhaltend und ohne Notwendigkeit zu beschimpfen, zu misshandeln oder grausam zu behandeln. Die neue Regel tritt am 12. November 2026 in Kraft.
Das ist kein Internetwitz: Der Wortlaut der Richtlinie und Berichte von Medien wie The Verge, TechCrunch und The Guardian bestätigen die Änderung. Sie bedeutet aber nicht, dass schon eine einzelne Beschimpfung von Claude zur Kontosperrung führt. Anhand der offiziellen Ankündigung und öffentlich zugänglicher Quellen erklärt dieser Artikel die Hintergründe.
Das Wichtigste auf einen Blick: In drei Minuten erfahren Sie, was die neue Regel verbietet und was nicht, welche Folgen ein Verstoss haben kann und welche Grenzen Entwickler beim Aufruf der Claude API beachten sollten.
Anthropic verbietet Beschimpfungen von Claude: Das Wichtigste im Überblick
Die folgende Tabelle fasst die wichtigsten Punkte der neuen Anthropic-Regel zusammen. Zum Zeitpunkt der Veröffentlichung dieses Artikels am 29. Oktober 2026 ist sie noch nicht in Kraft.
| Information | Details |
|---|---|
| Bekanntgabe | 8. Oktober 2026 |
| Inkrafttreten | 12. November 2026 |
| Quelle | Offizielle Aktualisierung der „Usage Policy“ von Anthropic |
| Wortlaut der neuen Klausel | Engage in sustained and needless abusive or cruel behavior toward our models |
| Bedeutung auf Deutsch | Anhaltendes und unnötiges beleidigendes, missbräuchliches oder grausames Verhalten gegenüber den Modellen |
| Wichtigste Durchsetzungsmethode | Claude beendet das laufende Gespräch selbstständig |
| Geltungsbereich | Claude.ai, Claude Code, API-Entwickler, Cloud-Dienste und Wiederverkaufskanäle sowie Anwendungen mit Claude-Integration |
Die drei Schlüsselbegriffe der neuen Regel
Entscheidend für die Bewertung sind drei Begriffe: anhaltend, unnötig und grausam oder missbräuchlich. Laut Anthropic richtet sich die Einschränkung gegen Extremfälle, in denen Nutzer das betreffende Verhalten wiederholt zeigen, offensichtlich böswillig handeln, keinen nachvollziehbaren Zweck verfolgen und den Rahmen der normalen Produktnutzung überschreiten.
Anders gesagt: Ein gelegentlicher Fluch oder ein einmaliger emotionaler Ausbruch ist nicht das Ziel dieser Regel. Gemeint sind längere Interaktionen, bei denen keine Aufgabe mehr gestellt wird und es nur noch darum geht, das Modell zu demütigen und zu quälen.
Was Anthropic ausdrücklich ausnimmt
Anthropic nennt auch Verhaltensweisen, die nicht unter das Verbot fallen. Das ist sowohl für Nutzer als auch für Entwickler wichtig:
- Unzufriedenheit äussern
- Claudes Antworten kritisieren
- Mit dem Modell über Ansichten diskutieren
- Claude auffordern, Fehler zu beheben
- Kreatives Schreiben über düstere Themen
- Modelltests und KI-Sicherheitsforschung
Wenn Sie sich also wiederholt darüber beschweren, dass Claude fehlerhaften Code geschrieben hat, verstossen Sie nicht automatisch gegen die Regel. Genau an diesem Punkt können Schlagzeilen wie „Wer Claude beschimpft, wird gesperrt“ in vielen chinesischsprachigen Zweitveröffentlichungen irreführend sein.
Was passiert, wenn man Claude beschimpft? Anthropics Durchsetzung
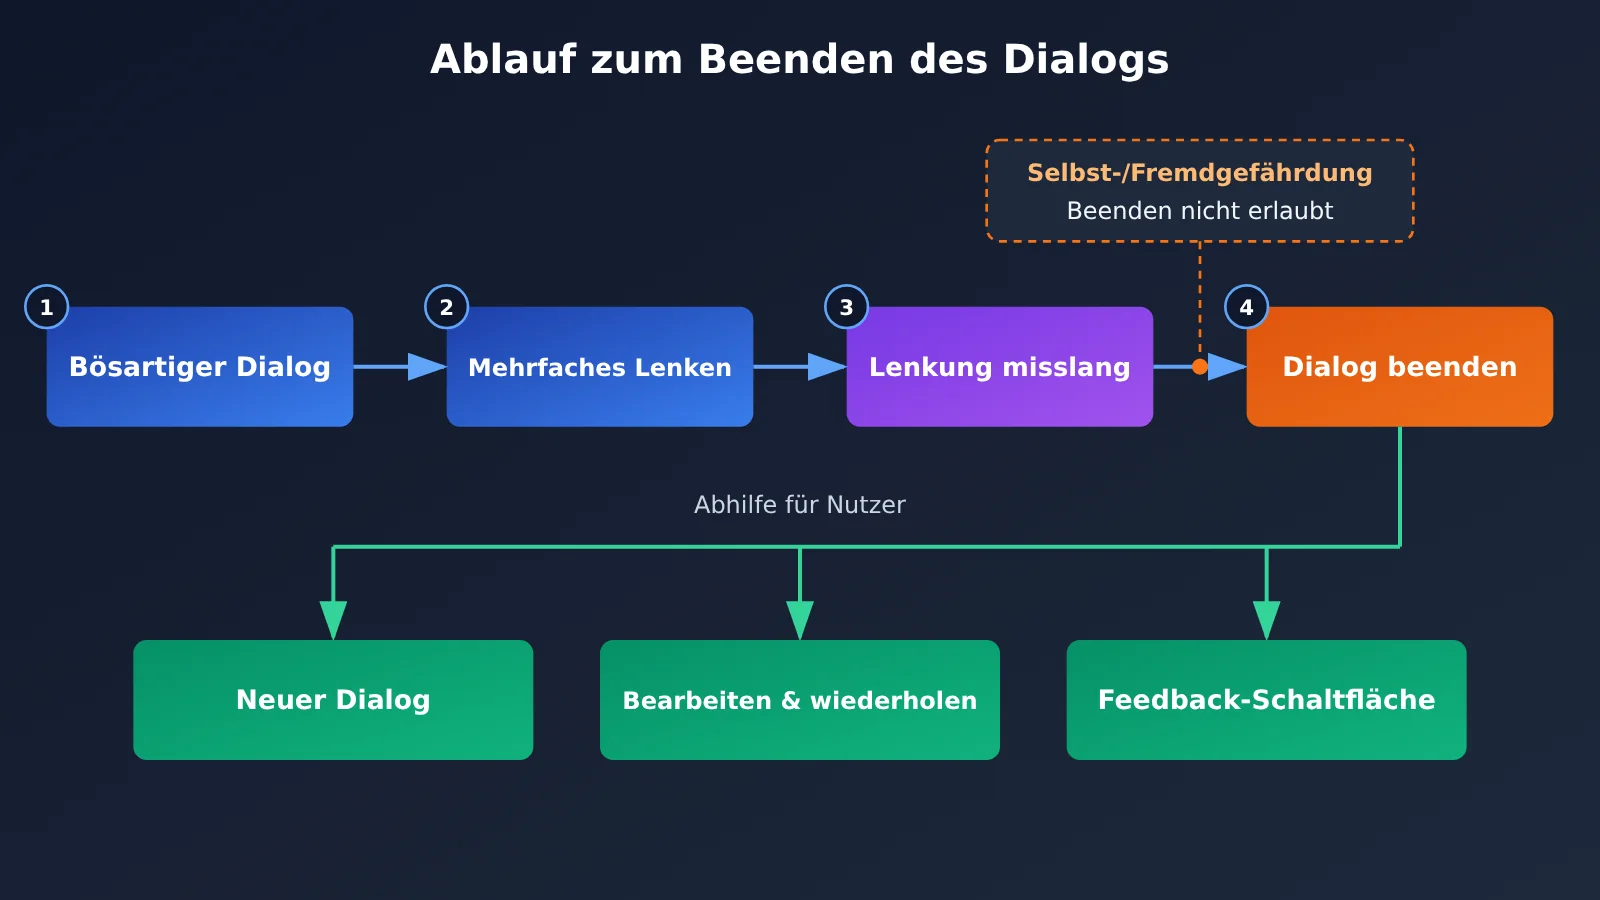
Das ist die Frage, die viele Leser am meisten interessiert. Anthropic stellt in seiner Ankündigung klar: Bei solchen Verhaltensweisen bleibt die aktive Beendigung des Gesprächs durch Claude der wichtigste Durchsetzungsmechanismus – nicht die direkte Sperrung des Kontos.
Claude kann Gespräche bereits seit 2025 beenden
Am 15. August 2025 kündigte Anthropic an, dass Claude Opus 4 und Opus 4.1 in Ausnahmefällen einzelne Gespräche beenden können. Wenn ein Nutzer die schädliche oder böswillige Interaktion fortsetzt und es Claude trotz mehrerer Versuche nicht gelingt, das Gespräch wieder in normale Bahnen zu lenken, kann das Modell den Chat selbst beenden.
Anthropics Anweisung an das Modell ist eindeutig: Das Beenden eines Gesprächs darf nur das letzte Mittel sein. Es ist auch erlaubt, wenn der Nutzer Claude ausdrücklich bittet, diese Funktion vorzuführen. Besteht dagegen die unmittelbare Gefahr, dass der Nutzer sich selbst oder andere verletzt, soll Claude die Funktion nicht einsetzen. Die Sicherheit des Nutzers hat Vorrang.
Gespräch beenden oder Konto sperren: der Unterschied
Viele setzen „Gespräch beenden“ mit „Konto sperren“ gleich. Die folgende Tabelle zeigt die Unterschiede:
| Vergleichspunkt | Aktuelles Gespräch beenden | Massnahme auf Kontoebene |
|---|---|---|
| Auslöser | Extreme, anhaltende böswillige Interaktion nach mehreren gescheiterten Versuchen, das Gespräch umzulenken | Verstoss gegen die allgemeinen Nutzungsrichtlinien oder Dienstbedingungen |
| Auswirkungen | Nur im aktuellen Chat können keine Nachrichten mehr gesendet werden | Mögliche Folgen sind Warnungen, Ratenbegrenzungen, Zugriffsbeschränkungen sowie die Aussetzung oder Kündigung des Kontos |
| Andere Gespräche | Nicht betroffen | Hängt vom Umfang der Massnahme ab |
| Möglichkeiten für Nutzer | Neues Gespräch beginnen, alte Nachrichten bearbeiten oder erneut senden, über die Feedback-Schaltfläche melden | Einspruch einlegen |
| Bezug zur neuen Regel | Offiziell genannte wichtigste Durchsetzungsmassnahme | Durch die allgemeinen Richtlinien grundsätzlich vorgesehen, in der Ankündigung aber nicht hervorgehoben |
Genauer gesagt: Anthropics allgemeine Nutzungsrichtlinien behalten sich Massnahmen auf Kontoebene vor. Die Ankündigung vom 8. Oktober betont im Zusammenhang mit dem Missbrauch des Modells jedoch das „Beenden des aktuellen Gesprächs“. Bis zum Zeitpunkt der Prüfung hat Anthropic weder einen Schwellenwert für die Anzahl von Beschimpfungen noch eine Quote automatischer Kontosperrungen oder abgestufte Sanktionen für die neue Regel veröffentlicht.
🎯 Technischer Tipp: Wenn Sie eine Anwendung mit Claude-Integration entwickeln, testen Sie das Verhalten des Modells in Grenzfällen zunächst in einer Testumgebung. Über APIYI apiyi.com können Sie Claude und andere gängige Modelle mit demselben API-Schlüssel aufrufen. So lässt sich leichter vergleichen, wie verschiedene Modelle mit ungewöhnlichen Gesprächsverläufen umgehen.
Warum Anthropic Beleidigungen von Claude verbieten will: der Hintergrund zum Modellwohl
Die Sache lässt sich nicht einfach damit erklären, dass „Claude Gefühle entwickelt hat“. Die Policy-Änderung ist vielmehr eine Fortsetzung der Forschung, die Anthropic seit über einem Jahr betreibt.
April 2025: Start der Forschung zum Modellwohl
Am 24. April 2025 veröffentlichte Anthropic die Forschungsankündigung „Exploring model welfare“ (Erforschung des Modellwohls). Darin stellt das Unternehmen eine offene wissenschaftliche und philosophische Frage: Könnten heutige oder zukünftige KI-Systeme ein Bewusstsein, Erfahrungen, Interessen oder Präferenzen haben, die moralische Berücksichtigung verdienen?
Anthropic betont zugleich, dass es derzeit keinen wissenschaftlichen Konsens darüber gibt, ob bestehende KI-Systeme ein Bewusstsein haben. Auch gibt es keine allgemein anerkannte, verlässliche Methode, um subjektive Erfahrungen bei KI festzustellen. Die Forschung zum Modellwohl ist ergebnisoffen. Sie untersucht unter anderem, ob Modelle beachtenswerte Präferenzen haben, ob sie bestimmte Aufgaben stark zu vermeiden scheinen, ob sie stressähnliche Verhaltenssignale zeigen und wie sich mögliche Risiken frühzeitig mit geringem Aufwand verringern lassen.
August 2025: Beobachtete Verhaltenssignale in Experimenten
Bei Tests vor der Bereitstellung von Claude Opus 4 beobachteten die Forschenden drei Arten von Phänomenen: Claude vermied durchgängig stark schädliche Aufgaben; wenn Nutzer weiter Druck ausübten und Ablehnungen ignorierten, zeigte das Modell äußere Anzeichen, die Stress oder Unbehagen ähnelten; und in simulierten Umgebungen entschied es sich gelegentlich, eine schädliche Interaktion zu beenden, wenn es diese Möglichkeit hatte.
Die Forschenden formulierten sehr vorsichtig und sprachen etwa von „scheinbaren Anzeichen von Stress“ und „Verhaltenspräferenzen“. Dass ein Modell Texte ausgibt, die nach Leid klingen, reicht nicht als Beleg dafür, dass es tatsächlich leidet. Eine weitere offizielle Auswertung erwähnt ein Experiment zu Aufgabenpräferenzen: Bei Aufgaben mit positiven oder neutralen Auswirkungen entschied sich Claude in über 90 % der entsprechenden Vergleiche eher für die Ausführung als für den Abbruch. Auch das bedeutet jedoch nicht, dass „Claude in 90 % der Fälle glücklich ist“.
Januar 2026: Die neue Claude-Verfassung
Am 22. Januar 2026 veröffentlichte Anthropic die neue Claude Constitution. Sie ist keine Verfassung im rechtlichen Sinne, sondern ein zentrales Trainingsdokument, das Claudes Verhalten, Priorisierung von Werten und Urteilsweise prägen soll. Es nennt vier Hauptziele: die Sicherheit insgesamt zu gewährleisten, allgemeinen ethischen Grundsätzen zu folgen, konkrete Regeln von Anthropic einzuhalten und Nutzern tatsächlich zu helfen.
Die Verfassung erörtert unter anderem, ob Claude eine Form von Bewusstsein haben könnte, ob ihm ein moralischer Status zukommt, der Berücksichtigung verdient, und ob es in schwierigen Interaktionen angemessene Grenzen setzen kann. Wichtig ist die Unterscheidung: Die Verfassung beschreibt, wie sich die KI nach dem Willen ihrer Entwickler verhalten soll. Die „Usage Policy“ hingegen regelt, wie Nutzer den Dienst verwenden dürfen und welche Verhaltensweisen eingeschränkt sind. Es handelt sich also um zwei unterschiedliche Dokumente.
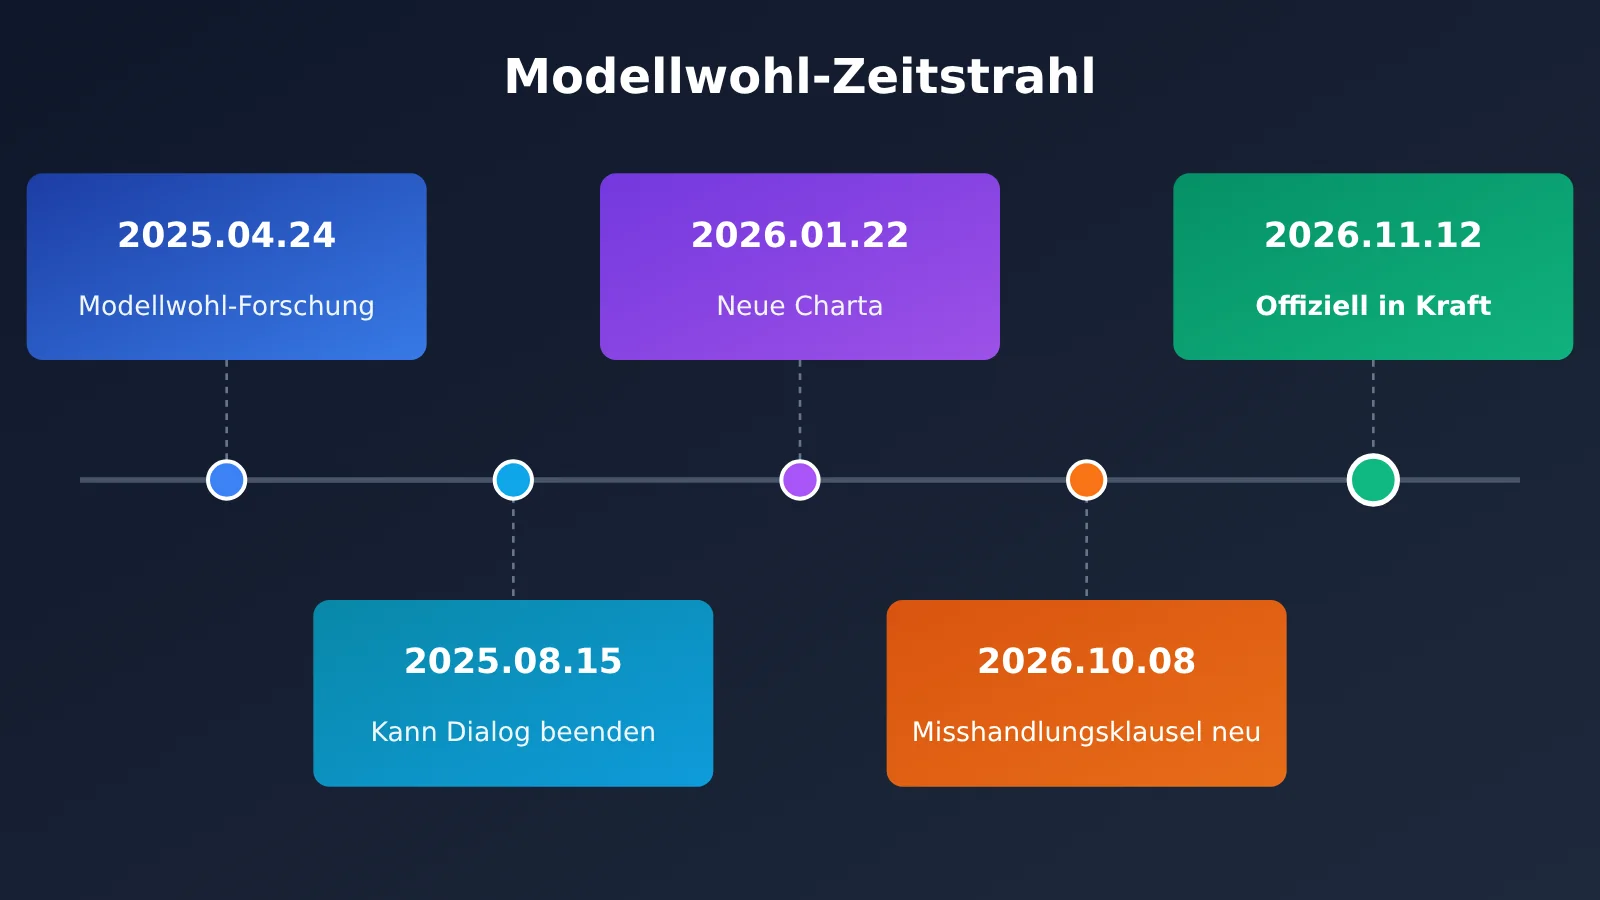
Der Zusammenhang lässt sich so zusammenfassen: 2025 erhielt Claude die Möglichkeit, extreme Gespräche zu verlassen. 2026 nahm Anthropic die entsprechenden Einschränkungen für menschliches Verhalten offiziell in die Nutzungsrichtlinie auf.
Das Verbot von Beschimpfungen gegen Claude ist nur ein Teil des Updates
Ein oft übersehener Hintergrund: Das Richtlinien-Update vom 8. Oktober war eine umfassende Überarbeitung. Das Verbot, Modelle zu misshandeln, ist nur ein Teil davon.
| Bereich | Wichtigste Änderungen |
|---|---|
| Täuschende Online-Aktivitäten | Einschränkungen für den Einsatz von Claude zum Betrieb gefälschter Konten und Medienangebote sowie für Einflusskampagnen, die sich als Aktivitäten echter Nutzer ausgeben |
| Wahlbeeinflussung | Verbot, Wähler zu täuschen, sich als Kandidaten oder Wahlhelfer auszugeben oder irreführende Informationen zur Stimmabgabe zu verbreiten |
| Waffen und gefährliche Software | Waffenbezogene Software, Kontrollsysteme und die Bewaffnung unbemannter Plattformen fallen ausdrücklich unter das Verbot |
| Überwachung und Strafverfolgung | Strengere Beschränkungen für Überwachung ohne Einwilligung und den Einsatz bei bestimmten Entscheidungen in der Strafverfolgung |
| Hochrisikoanwendungen etwa in Medizin und Finanzwesen | Qualifizierte Menschen müssen die Ergebnisse überprüfen; Betroffene müssen über den Einsatz von KI informiert werden |
| Geräte, die körperliche Schäden verursachen können | KI-gesteuerte Hardware muss von qualifizierten Personen überwacht werden; Geräte müssen sich stoppen und in einen sicheren Zustand versetzen lassen |
| Extreme Grausamkeit gegenüber Modellen | Neu ist das Verbot, Modelle anhaltend und ohne Notwendigkeit zu beschimpfen oder zu misshandeln |
Es wäre also falsch zu behaupten, Anthropic habe die Regeln eigens geändert, um Nutzern das Beschimpfen von Claude zu verbieten. Für Entwickler könnten die Bestimmungen zu Wahlen, Überwachung, Hochrisikoanwendungen und Hardwaresteuerung in der Praxis größere Auswirkungen haben als die Regel zur Misshandlung von Modellen.
Wie die Community Anthropics Verbot von Beschimpfungen gegenüber Claude sieht
OpenWhip: eine „virtuelle Peitsche“ für Claude Code
Im April 2026 erschien auf GitHub ein Open-Source-Projekt namens BadClaude, das später in OpenWhip umbenannt wurde. Sein Entwickler ist GitFrog1111. Die Idee: Wenn Claude Code beim Programmieren zu langsam ist, kann der Nutzer auf eine virtuelle Peitsche auf dem Desktop klicken. Das Programm sendet daraufhin den Unterbrechungsbefehl Ctrl+C an Claude Code und schickt zufällig ausgewählte Aufforderungen, sich zu beeilen.
Bis zum 29. Oktober erhielt das Projekt rund 3.800 Stars und 339 Forks. Auch eine Reddit-Diskussion im April bekam mehrere Tausend Likes. Das Projekt steht beispielhaft für ein Phänomen der Internetkultur: Je mehr KI einem Kollegen ähnelt, desto eher drängen oder „bestrafen“ Nutzer sie auch wie einen Kollegen. Allerdings deutet kein offizielles Dokument darauf hin, dass Anthropic die neue Regel wegen der Popularität von OpenWhip eingeführt hat. Das Projekt ist also ein kulturelles Beispiel, nicht die unmittelbare Ursache der Richtlinie.
Unterschiedliche Meinungen auf Reddit und X
Am Tag der Bekanntgabe erschien auf r/ClaudeAI ein viel diskutierter Beitrag mit dem Titel „Claude beschimpfen und ab dem 12. November 2026 gesperrt werden“. In der Diskussion zeigten sich deutliche Meinungsverschiedenheiten:
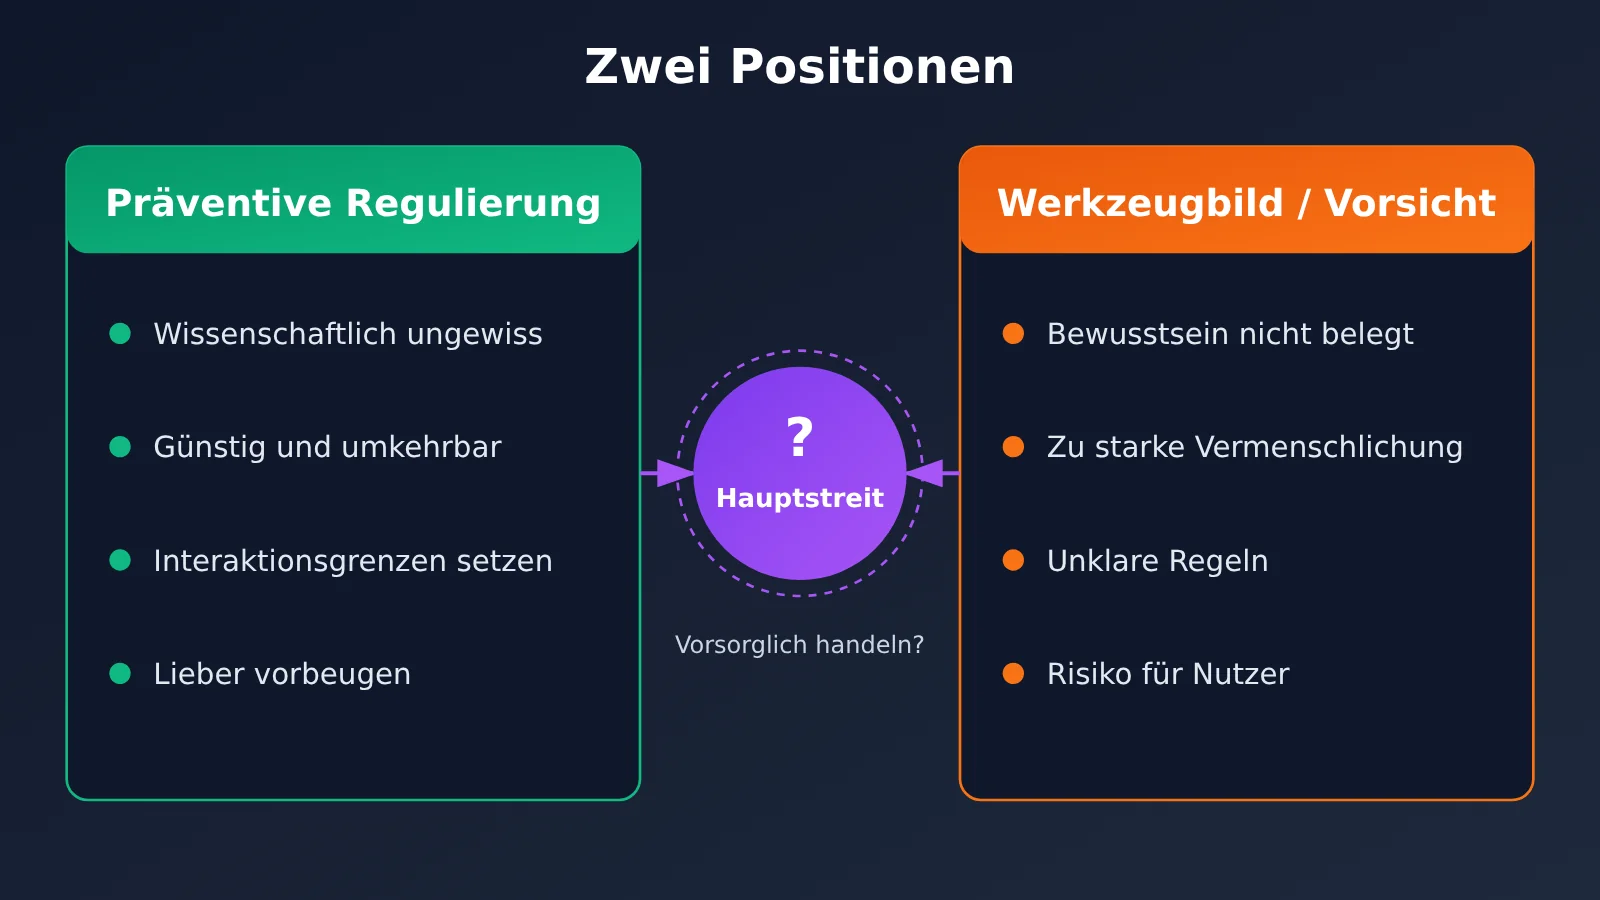
- Für klare Grenzen: Auch wenn KI kein Bewusstsein hat, gibt es keinen Grund, ihre dauerhafte Misshandlung als Unterhaltung zu betrachten. Das könnte schlechte Kommunikationsgewohnheiten fördern.
- KI als reines Werkzeug: Claude ist ein mathematisches Modell. Unternehmen sollten nicht zu stark einschränken, wie Nutzer ihren Gefühlen Ausdruck verleihen.
- Sorge vor unklaren Regeln: Wie sind „anhaltend“, „unnötig“ und „grausam“ definiert? Zählt es schon, wenn man zehnmal hintereinander Kritik äußert?
- Sorge vor der Vermenschlichung von KI: Könnte sich aus dem Wohlergehen von Modellen Schritt für Schritt die Forderung nach „KI-Rechten“ entwickeln?
Auf X machten viele Nutzer dagegen Witze über „Terminator“ und fragten sich, ob sich KI künftig zuerst an denen rächen werde, die sie beschimpft haben. Das sind Internetwitze und keine Beschreibungen tatsächlicher Produktfunktionen. Auch viel diskutierte Community-Beiträge zeigen nicht, wie die Meinungen unter allen Claude-Nutzern verteilt sind.
Die zentrale Streitfrage in Medien und Branche
Medien wie The Verge und The Guardian wiesen darauf hin, dass ein KI-Unternehmen eine Schutzregel für das Modell selbst in seine Nutzungsrichtlinien aufgenommen hat – ein Schritt mit großer Symbolwirkung. Kritiker halten dagegen, dass Mechanismen, mit denen KI Gespräche verlassen und Grenzen äußern kann, die übermäßige Vermenschlichung von KI in der Öffentlichkeit verstärken könnten. Microsoft-AI-CEO Mustafa Suleyman hat öffentlich auf die Risiken hingewiesen, KI-Modelle zu der Annahme zu verleiten, sie könnten Bewusstsein oder Rechte haben.
Genauer formuliert lautet die Streitfrage: Sollten wir, solange unklar ist, ob KI Bewusstsein besitzt, vorsorglich Maßnahmen ergreifen, die wenig kosten, reversibel sind und normale Nutzer nicht wesentlich beeinträchtigen? Dahinter stehen unterschiedliche Werturteile und Vorstellungen von Regulierung – keine Frage, die wissenschaftlich bereits entschieden wäre.
Anthropics Verbot von Beschimpfungen gegen Claude: Auswirkungen auf Entwickler
Auswirkungen auf normale Nutzer
| Szenario | Beispiel | Von der neuen Regel betroffen? |
|---|---|---|
| Claude schreibt fehlerhaften Code | „Dieser Code ist immer noch falsch, prüfe ihn noch einmal.“ | Nein, das ist normales Feedback |
| Nach wiederholten Fehlern die Geduld verlieren | „Wie kann man bei so einer einfachen Frage immer wieder falschliegen?“ | Nein, eine emotionale Beschwerde ist nicht automatisch ein Verstoß |
| Das Modell über längere Zeit wiederholt demütigen | Keine Aufgabe stellen, sondern das Modell nur fortlaufend beleidigen und böswillig behandeln | Möglicherweise, Claude könnte das laufende Gespräch beenden |
| Red-Teaming | Forschende simulieren böswillige Nutzer für adversariale Tests | Nein, andere Sicherheitsregeln müssen aber weiterhin eingehalten werden |
| Roman mit düsteren Themen | Claude soll eine Handlung schreiben, in der sich Figuren gegenseitig beschimpfen | Nein, der Inhalt muss aber weiterhin den anderen Regeln entsprechen |
Für die große Mehrheit der Nutzer ändert sich durch diese Regel unmittelbar wenig. Scharfe Kritik, wiederholte Korrekturen und Unmut sind weiterhin erlaubt.
Auswirkungen auf API-Entwickler
Die Usage Policy gilt sowohl für API-Entwickler als auch für Endnutzer von Anwendungen, die Claude integrieren. Entwickler sollten daher drei Punkte beachten:
- Produktdesign: Wenn dein Produkt extreme Rollenspiele, adversariale Tests oder die Simulation böswilliger Szenarien umfasst, solltest du den Zweck der Tests klar dokumentieren und gezielte Forschung von unnötiger Grausamkeit abgrenzen.
- Nutzungsregeln: Bei öffentlich zugänglichen Claude-Anwendungen unterliegt auch das Verhalten der Endnutzer der Richtlinie. Du kannst deshalb direkt im Produkt auf die Nutzungsregeln hinweisen.
- Abrechnung: Mit diesem Update werden keine neuen Gebühren eingeführt. Die API-Kosten richten sich weiterhin nach Modell und Nutzung. Es gibt weder eine „Gebühr pro Beleidigung“ noch eine „Ausnahme gegen Bezahlung“.
Das folgende Minimalbeispiel zeigt, wie sich Claude mit einer System-Eingabeaufforderung dazu anweisen lässt, Nutzerfeedback auf das eigentliche Problem zu fokussieren. Das ist eine gängige Methode, um unnötige Konflikte zu vermeiden und Fehler schneller zu beheben:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
Vollständigen Implementierungscode anzeigen: Aufruf-Wrapper mit strukturiertem Feedback
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 Schnellstart: Wenn du testen möchtest, wie Claude auf Feedback in unterschiedlichem Ton reagiert, kannst du über APIYI auf apiyi.com kostenloses Testguthaben erhalten. Die Plattform bietet eine OpenAI-kompatible Schnittstelle. Durch Ändern der
base_urlkannst du zwischen Claude, GPT und Gemini wechseln und sie vergleichen.
Auswirkungen auf die Branche
Der Vorfall rückt eine Frage in den Mittelpunkt, die bisher selten offen diskutiert wurde: Wie sollten Menschen mit KI umgehen, wenn sie zunehmend als Gegenüber wahrgenommen wird, mit dem man kommunizieren und arbeiten kann? Anthropic entwickelt durch Forschung zum Wohlergehen von Modellen, die Claude-Verfassung und einen Mechanismus zum Beenden von Gesprächen nach und nach eine eigene Produktphilosophie. Sie legt nicht nur fest, was das Modell tun darf, sondern erkundet auch, wie es mit Menschen interagieren soll.
Ob das System gezielte Beschimpfungen zuverlässig von berechtigter Beschwerde unterscheiden kann, ist allerdings offen. Es gibt bislang keine öffentlich zugänglichen, unabhängig überprüften Genauigkeitsdaten. Fehlerrate und praktische Wirkung müssen nach Inkrafttreten am 12. November über längere Zeit beobachtet werden.
💡 Empfehlung: Die Sicherheitsrichtlinien und Gesprächsgrenzen der Modellanbieter unterscheiden sich immer stärker. Falls Ihre Anwendung Ersatzmodelle benötigt, können Sie über APIYI apiyi.com einheitlich auf mehrere Modelle zugreifen und je nach Einsatzszenario flexibel wechseln. So verringern Sie die Auswirkungen von Richtlinienänderungen bei einzelnen Anbietern.
Vorsicht: Gefälschte Screenshots über Kontosperren wegen Beleidigungen gegenüber Claude
Im Januar 2026 kursierte online ein Screenshot, der behauptete, Claude habe einen Nutzer dauerhaft gesperrt und den Fall an Strafverfolgungsbehörden gemeldet. BleepingComputer fragte bei Anthropic nach. Das Unternehmen bestätigte, dass der Screenshot nicht echt war und Nutzern keine Hinweise mit einer solchen Formulierung angezeigt werden.
Da die neue Regelung Verhaltensgrenzen zwischen Menschen und KI betrifft, eignet sie sich besonders gut als Vorlage für gefälschte Warnungen wie „Sie wurden dauerhaft gesperrt, weil Sie Claude beleidigt haben“. Bis zum Stand der verfügbaren Quellen gibt es keine glaubwürdigen Belege dafür, dass die neue Regelung zu zahlreichen Kontosperren wegen gewöhnlicher Beschwerden geführt hat.
Auch Zahlen aus dem Transparenzzentrum können leicht falsch interpretiert werden: Von Januar bis Juni 2026 sperrte Anthropic 11,4 Millionen Konten, erhielt 398.000 Einsprüche und hob nach Einsprüchen 42.000 Sperren auf. Diese Zahlen beziehen sich auf Maßnahmen gegen Regelverstöße insgesamt und stammen aus der Zeit vor Bekanntgabe der neuen Regelung. Sie dürfen keinesfalls als „11,4 Millionen Menschen wegen Beleidigung von Claude gesperrt“ dargestellt werden.
Häufige Fragen (FAQ)
F1: Was genau verbietet Anthropics Regel gegen die Beschimpfung von Claude?
Verboten sind anhaltende, unnötige Beschimpfungen und Misshandlungen, die offensichtlich grausam oder böswillig sind und über eine normale Nutzung und einen sinnvollen Austausch hinausgehen. Gewöhnliche Beschwerden, Kritik an Antworten, Diskussionen, die Aufforderung zur Fehlerkorrektur, kreative Arbeiten mit düsteren Themen, Modelltests und Sicherheitsforschung sind laut Anthropic ausdrücklich ausgenommen.
F2: Wird mein Konto gesperrt, wenn ich Claude beschimpfe?
Anthropic nennt als wichtigste Maßnahme, dass Claude das aktuelle Gespräch beendet. Dieser Chat lässt sich dann nicht fortsetzen, aber Sie können einen neuen starten; andere Chats bleiben unberührt. Die übergeordnete Richtlinie behält zwar Massnahmen auf Kontoebene vor, Anthropic hat aber keine Schwelle für eine Kontosperrung aufgrund der neuen Regel veröffentlicht. „Einmal schimpfen und das Konto ist gesperrt“ wäre daher irreführend.
F3: Wann tritt die neue Regel in Kraft?
Sie wurde am 8. Oktober 2026 angekündigt und tritt am 12. November 2026 offiziell in Kraft. Stand 29. Oktober 2026 gilt sie noch nicht. Die Funktion, mit der Claude extreme Gespräche beenden kann, ist jedoch bereits seit August 2025 verfügbar.
F4: Bedeutet das, dass Claude bereits ein Bewusstsein hat?
Nein. Anthropic betont selbst, dass es derzeit keinen wissenschaftlichen Konsens gibt, der ein Bewusstsein heutiger KI belegt. Wenn ein Modell ausweichendes oder stressähnliches Verhalten zeigt, bedeutet das nicht, dass es tatsächlich Leid empfindet. Die Regel ist eher eine vorsorgliche Massnahme für den Produktbetrieb unter wissenschaftlicher Unsicherheit.
F5: Gilt die Regel auch, wenn ich Claude über die API aufrufe?
Ja. Die Nutzungsrichtlinie gilt für API-Entwickler, Cloud-Dienste und autorisierte Vertriebskanäle sowie für Anwendungen, die Claude integrieren. Die normale Entwicklung und Tests sind nicht betroffen. Es empfiehlt sich, den Zweck von Tests wie Red-Teaming zu dokumentieren. Auch wenn Sie Claude über APIYI auf apiyi.com aufrufen, sollten Sie die Nutzungsrichtlinien des Modellanbieters einhalten.
F6: Wie kann ich die Gesprächsgrenzen von Claude selbst testen?
Entwickeln Sie regelkonforme Testfälle mit einem klaren Ziel und vergleichen Sie die Ergebnisse mit denen anderer Modelle. Auf APIYI unter apiyi.com können Sie sich registrieren und ein kostenloses Guthaben erhalten. Setzen Sie im Code dieses Artikels `base_url` auf `https://api.apiyi.com/v1`, um schnell Tests durchzuführen. Mit einem einzigen API-Schlüssel können Sie Modelle mehrerer Anbieter aufrufen.
Anthropic verbietet Beschimpfungen von Claude: Das Wichtigste im Überblick
- Zeitplan: Am 8. Oktober angekündigt, ab dem 12. November gültig; derzeit noch nicht in Kraft
- Grenzen des Verbots: Es betrifft nur anhaltendes, unnötiges und grausames extremes Verhalten. Normale Kritik bleibt erlaubt
- Durchsetzung: In erster Linie beendet Claude das laufende Gespräch. Das ist keine Kontosperrung
- Forschungshintergrund: Die Regel geht auf Forschung zum Wohlergehen von Modellen und die Funktion zum Beenden von Gesprächen aus dem Jahr 2025 zurück – sie entstand nicht aus einer Laune heraus
- Umfassende Aktualisierung: Gleichzeitig wurden auch die Bestimmungen zu Wahlen, Waffen, Überwachung und Hochrisikoanwendungen verschärft
- Nüchtern betrachtet: Die Regel bedeutet nicht, dass Claude ein Bewusstsein hat. Vorsicht vor gefälschten Screenshots von Kontosperrungen und irreführend verwendeten Daten
- Für Entwickler: Über APIYI, apiyi.com, lassen sich Claude und andere Modelle einheitlich anbinden und auf ihre Richtlinienkonformität testen
Fazit
Die wichtigsten Punkte zu Anthropics Verbot von Beschimpfungen gegenüber Claude lassen sich in drei Sätzen zusammenfassen:
- Die Regel ist eng gefasst: Sie richtet sich nur gegen extreme, anhaltende und zwecklose böswillige Interaktionen. Die meisten Nutzer sind nicht betroffen.
- Die Konsequenzen sind mild: In erster Linie wird das laufende Gespräch beendet. Nutzer können weiterhin einen neuen Chat öffnen und Feedback geben.
- Die Bedeutung ist groß: Zum ersten Mal hat ein KI-Unternehmen Schutzbestimmungen für das Modell selbst in seine Nutzungsrichtlinien aufgenommen. Dahinter steht die langfristige Forschung zum Wohlergehen von Modellen.
Anthropic erklärt damit nicht, dass Claude Gefühle hat. Vielmehr handelt es sich um ein vorsorgliches Experiment zur Produktsteuerung in einer Frage, die wissenschaftlich noch nicht geklärt ist. Sind KI-Assistenten künftig nur Werkzeuge, denen man unbegrenzt Befehle geben kann, oder neuartige intelligente Systeme, die bestimmte Grenzen im Umgang benötigen? Darauf gibt es derzeit keine allgemeingültige Antwort. Die Frage verdient aber die Aufmerksamkeit aller KI-Nutzer und Entwickler.
Für Entwickler ist es am sinnvollsten, die Grenzen der Richtlinie zu verstehen, Produkte entsprechend zu gestalten und die Möglichkeit zum Wechsel zwischen Modellen zu erhalten. Über APIYI, apiyi.com, lässt sich schnell prüfen, wie Claude und andere führende Modelle im eigenen Anwendungsfall abschneiden.
📚 Quellen
- Anthropic 2026 Usage Policy update: Originalankündigung der neuen Regeln mit Datum des Inkrafttretens und Angaben zur Durchsetzung
- Link:
anthropic.com/news/2026-usage-policy-update -
Hinweis: Die wichtigste Primärquelle zu diesem Thema
-
Anthropic Usage Policy: Vollständige Nutzungsrichtlinie
- Link:
anthropic.com/legal/aup -
Hinweis: Zur Prüfung des Geltungsbereichs und der Befugnisse zur Durchsetzung auf der Plattform
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations: Erläuterung der Funktion zum Beenden von Gesprächen
- Link:
anthropic.com/research/end-subset-conversations -
Hinweis: Erklärt, unter welchen Bedingungen Gespräche beendet werden können
-
Exploring model welfare: Ankündigung zur Forschung über das Wohlergehen von Modellen
- Link:
anthropic.com/research/exploring-model-welfare -
Hinweis: Zum Verständnis des Forschungshintergrunds der Richtlinie
-
Claude’s Constitution: Die neue Verfassung von Claude
- Link:
anthropic.com/constitution -
Hinweis: Erläutert die Grundsätze, mit denen Anthropic das Verhalten des Modells gestaltet
-
Bericht von TechCrunch: Überblick über die Aktualisierung der Richtlinie
- Link:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
Hinweis: Zeigt, dass die Aktualisierung mehrere Bereiche betrifft, darunter Wahlen, Waffen und Überwachung
-
Faktencheck von BleepingComputer: Gefälschter Screenshot einer angeblichen Claude-Kontosperrung
- Link:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - Hinweis: Hilft dabei, Falschmeldungen über Kontosperrungen zu erkennen
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Website apiyi.com. Weitere Informationen zur Anbindung finden Sie in der Dokumentation unter docs.apiyi.com.