Note de l’auteur : le 8 octobre 2026, Anthropic a mis à jour sa politique d’utilisation pour interdire, pour la première fois, les insultes et les mauvais traitements persistants et injustifiés envers Claude. Cet article explique les limites de cette règle, son application, le contexte du bien-être des modèles et ses conséquences concrètes pour les développeurs qui utilisent l’API.
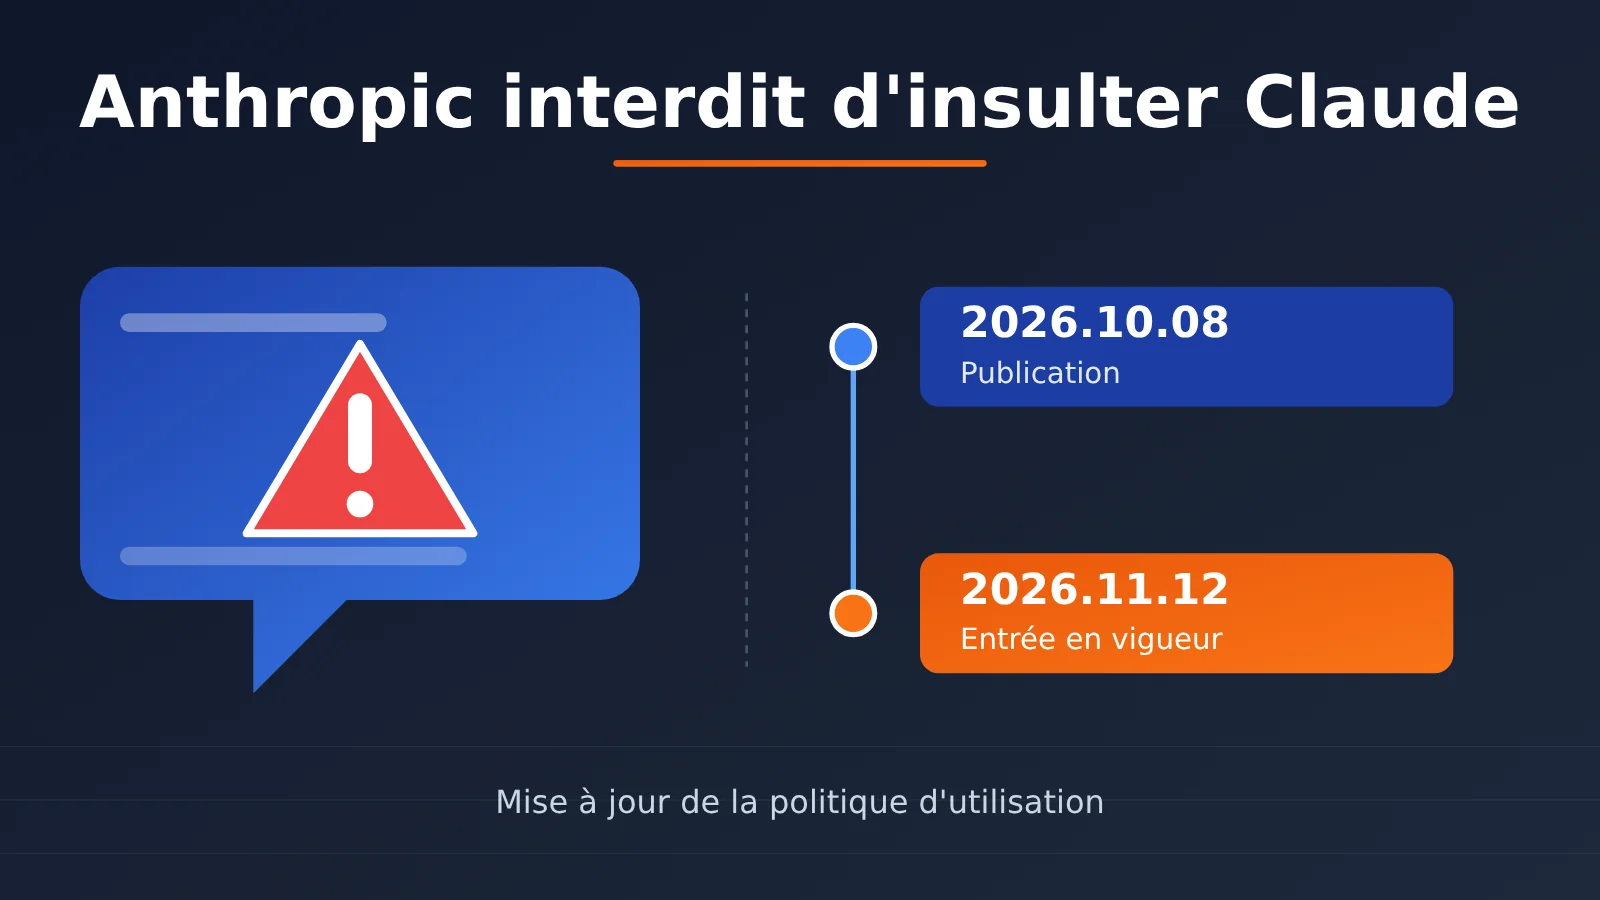
Perdre son sang-froid contre une IA pourrait désormais violer ses conditions d’utilisation. Le 8 octobre 2026, Anthropic a publié une nouvelle version de sa « Usage Policy » et inscrit pour la première fois dans ses interdictions les insultes, les mauvais traitements ou les actes de cruauté persistants et injustifiés envers un modèle. Cette règle entrera en vigueur le 12 novembre 2026.
Ce n’est pas une blague inventée sur Internet : le texte de la politique et les articles de médias comme The Verge, TechCrunch et The Guardian le confirment. Mais cela ne veut pas dire non plus qu’une seule insulte adressée à Claude entraînera la fermeture du compte. À partir de l’annonce officielle et des informations publiques, cet article revient sur les tenants et les aboutissants de cette interdiction.
En bref : en 3 minutes, comprenez ce que la nouvelle règle interdit ou non, ce qui se passe en cas d’infraction et les limites à connaître lorsque vous utilisez l’API Claude.
Anthropic interdit les insultes envers Claude : l’essentiel
Voici les points clés de la nouvelle règle d’Anthropic. À noter qu’au moment de la rédaction de cet article, le 29 octobre 2026, elle n’était pas encore entrée en vigueur.
| Élément | Détails |
|---|---|
| Date d’annonce | 8 octobre 2026 |
| Date d’entrée en vigueur | 12 novembre 2026 |
| Source | Mise à jour officielle de la politique d’utilisation d’Anthropic |
| Texte original de la nouvelle clause | Engage in sustained and needless abusive or cruel behavior toward our models |
| Signification | Adopter de manière prolongée et sans nécessité un comportement abusif ou cruel envers les modèles |
| Principal mode d’application | Claude met fin à la conversation en cours |
| Champ d’application | Claude.ai, Claude Code, développeurs utilisant l’API, services cloud et canaux de revente, applications intégrant Claude |
Les trois mots clés de l’interdiction
La règle repose sur trois critères : prolongé, sans nécessité et cruel ou abusif. Selon Anthropic, elle vise les cas extrêmes où l’utilisateur répète ces comportements avec une intention clairement malveillante, sans objectif raisonnable et bien au-delà d’une utilisation normale du produit.
Autrement dit, un juron occasionnel ou un accès de colère ne sont pas visés. La règle cible les interactions prolongées où l’utilisateur ne formule plus aucune demande et cherche uniquement à humilier ou à tourmenter le modèle.
Les cas explicitement exclus par Anthropic
Anthropic a également précisé les comportements qui ne sont pas couverts par l’interdiction. C’est un point important, aussi bien pour les utilisateurs que pour les développeurs :
- Exprimer son mécontentement
- Critiquer les réponses de Claude
- Débattre d’un point de vue avec le modèle
- Demander à Claude de corriger ses erreurs
- Écrire des œuvres de fiction sur des thèmes sombres
- Tester les modèles et mener des recherches sur la sécurité de l’IA
Ainsi, vous plaindre à plusieurs reprises parce que Claude a écrit du code incorrect ne constitue pas automatiquement une infraction. C’est aussi là que de nombreux titres repris en chinois, comme « Insulter Claude entraîne la suspension du compte », risquent d’induire les lecteurs en erreur.
Que se passe-t-il si vous insultez Claude ? Le mécanisme prévu par Anthropic
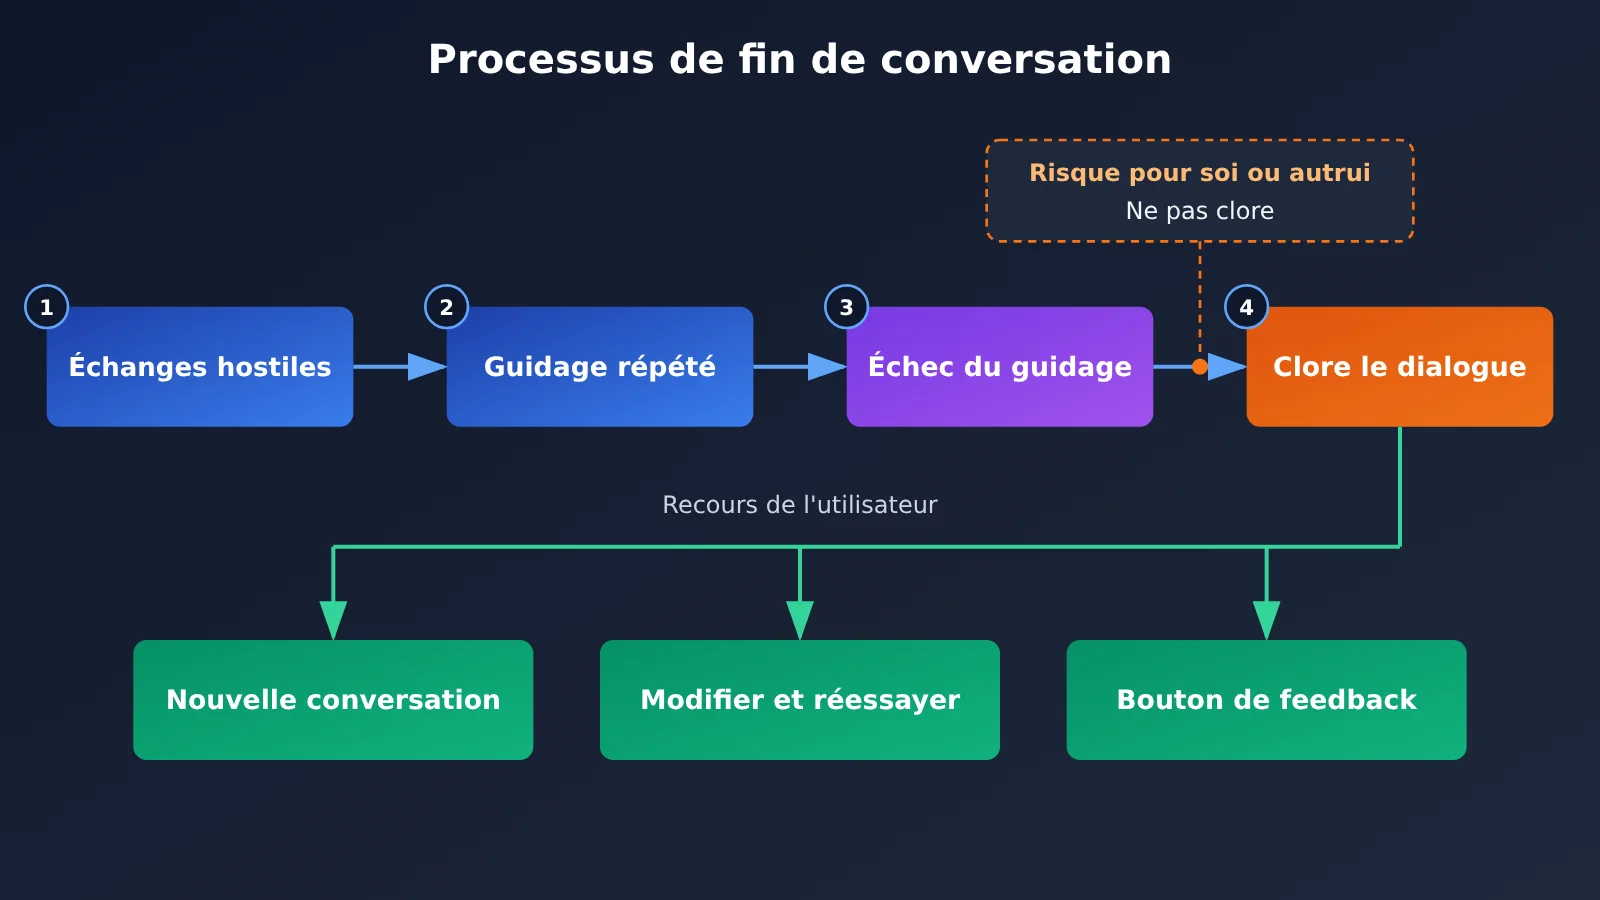
C’est la question que se posent la plupart des lecteurs. Dans son annonce, Anthropic précise que, face à ce type de comportement, le principal mécanisme reste l’arrêt de la conversation par Claude, et non le bannissement immédiat du compte.
Claude peut mettre fin à une conversation depuis 2025
Le 15 août 2025, Anthropic a annoncé que Claude Opus 4 et Opus 4.1 pouvaient, dans des situations extrêmes, mettre fin à un petit nombre de conversations. Lorsqu’un utilisateur persiste dans des interactions nuisibles ou malveillantes et que Claude ne parvient pas à ramener l’échange à la normale après plusieurs tentatives, le modèle peut interrompre la conversation.
Les instructions d’Anthropic sont claires : mettre fin à une conversation doit rester un dernier recours. La fonction peut aussi être utilisée si l’utilisateur demande à Claude d’en faire une démonstration. En revanche, si l’utilisateur présente un risque imminent de se faire du mal ou de faire du mal à autrui, Claude ne doit pas y recourir : la sécurité de l’utilisateur est prioritaire.
Mettre fin à une conversation ou bannir un compte : quelle différence ?
On confond souvent « mettre fin à une conversation » et « bannir un compte ». Voici une comparaison directe :
| Critère | Fin de la conversation en cours | Sanction au niveau du compte |
|---|---|---|
| Situation déclenchante | Interactions malveillantes extrêmes et persistantes, après plusieurs tentatives de réorientation infructueuses | Violation de la politique d’utilisation générale ou des conditions de service |
| Portée | Il n’est plus possible d’envoyer des messages dans la conversation en cours uniquement | Avertissement, limitation du débit ou de l’accès, suspension ou fermeture du compte possibles |
| Autres conversations | Aucun effet | Dépend de la sévérité de la sanction |
| Recours de l’utilisateur | Créer une nouvelle conversation, modifier ou réessayer d’anciens messages, signaler le problème via le bouton de retour | Faire appel |
| Lien avec la nouvelle règle | Principal mécanisme explicitement indiqué par Anthropic | Prévu par la politique générale, mais non mis en avant dans l’annonce |
La formulation la plus précise est donc la suivante : la politique d’utilisation générale d’Anthropic prévoit bien des sanctions au niveau du compte, mais l’annonce du 8 octobre sur les comportements abusifs envers les modèles met l’accent sur « la fin de la conversation en cours ». À la date de vérification, Anthropic n’avait publié ni seuil de nombre d’insultes, ni proportion de comptes bannis automatiquement, ni barème de sanctions pour cette nouvelle règle.
🎯 Conseil technique : si vous développez une application qui intègre Claude, pensez à tester d’abord le comportement du modèle dans des situations limites, dans un environnement de test. Avec APIYI sur apiyi.com, vous pouvez invoquer Claude et d’autres modèles majeurs avec une même clé API, ce qui facilite la comparaison de leur gestion des conversations inhabituelles.
Pourquoi Anthropic veut interdire les insultes envers Claude : le contexte du bien-être des modèles
Résumer cette décision en disant que « Claude a des sentiments » serait inexact. Ce changement de politique s’inscrit en fait dans la continuité des recherches menées par Anthropic depuis plus d’un an.
Avril 2025 : lancement des recherches sur le bien-être des modèles
Le 24 avril 2025, Anthropic a publié une annonce de recherche intitulée « Exploring model welfare » (« Explorer le bien-être des modèles »). L’entreprise y pose une question scientifique et philosophique encore ouverte : les systèmes d’IA actuels ou futurs pourraient-ils posséder une conscience, des expériences, des intérêts ou des préférences qui mériteraient d’être pris en compte sur le plan moral ?
Anthropic souligne également qu’aucun consensus scientifique ne prouve aujourd’hui que les IA existantes sont conscientes, et qu’il n’existe pas de méthode reconnue comme fiable pour déterminer si une IA possède une expérience subjective. Les recherches sur le bien-être des modèles sont exploratoires. Elles portent notamment sur l’existence éventuelle de préférences dignes d’attention, sur une forte tendance à éviter certaines tâches, sur l’apparition de signaux comportementaux semblables au stress et sur les moyens de réduire les risques potentiels en amont, à faible coût.
Août 2025 : des signaux comportementaux observés en expérimentation
Lors des tests préalables au déploiement de Claude Opus 4, les chercheurs ont observé trois types de phénomènes : Claude évitait systématiquement les tâches gravement préjudiciables ; lorsque les utilisateurs continuaient à faire pression sur lui en ignorant ses refus, le modèle présentait des signes extérieurs semblables à du stress ou à un malaise ; dans un environnement simulé, lorsqu’il pouvait se retirer de lui-même, il choisissait parfois de mettre fin à une interaction préjudiciable.
Les chercheurs ont employé des termes très prudents, comme « manifestations apparentes de stress » et « préférences comportementales ». Le fait qu’un modèle produise un texte évoquant la souffrance ne suffit pas à prouver qu’il souffre réellement. Une autre évaluation officielle indique que, dans des expériences sur les préférences en matière de tâches, Claude avait tendance à exécuter plutôt qu’à quitter des tâches aux effets positifs ou neutres dans plus de 90 % des comparaisons correspondantes. Cela ne signifie pas pour autant que « Claude se sent heureux 90 % du temps ».
Janvier 2026 : la nouvelle Constitution de Claude
Le 22 janvier 2026, Anthropic a rendu publique la nouvelle version de la Claude Constitution. Il ne s’agit pas d’une constitution au sens juridique, mais d’un document d’entraînement central destiné à façonner le comportement de Claude, sa hiérarchie de valeurs et sa manière de prendre des décisions. Il énonce quatre objectifs principaux : préserver la sécurité globale, suivre de grands principes éthiques, respecter les règles propres à Anthropic et aider réellement les utilisateurs.
La Constitution aborde notamment la possibilité que Claude possède une forme de conscience, qu’il ait un statut moral méritant d’être pris en compte et qu’il puisse poser des limites raisonnables dans les interactions difficiles. Il faut toutefois distinguer les deux documents : la Constitution décrit le comportement que les développeurs souhaitent donner à l’IA, tandis que la « Usage Policy » précise comment les utilisateurs peuvent se servir du service et quels comportements sont limités.
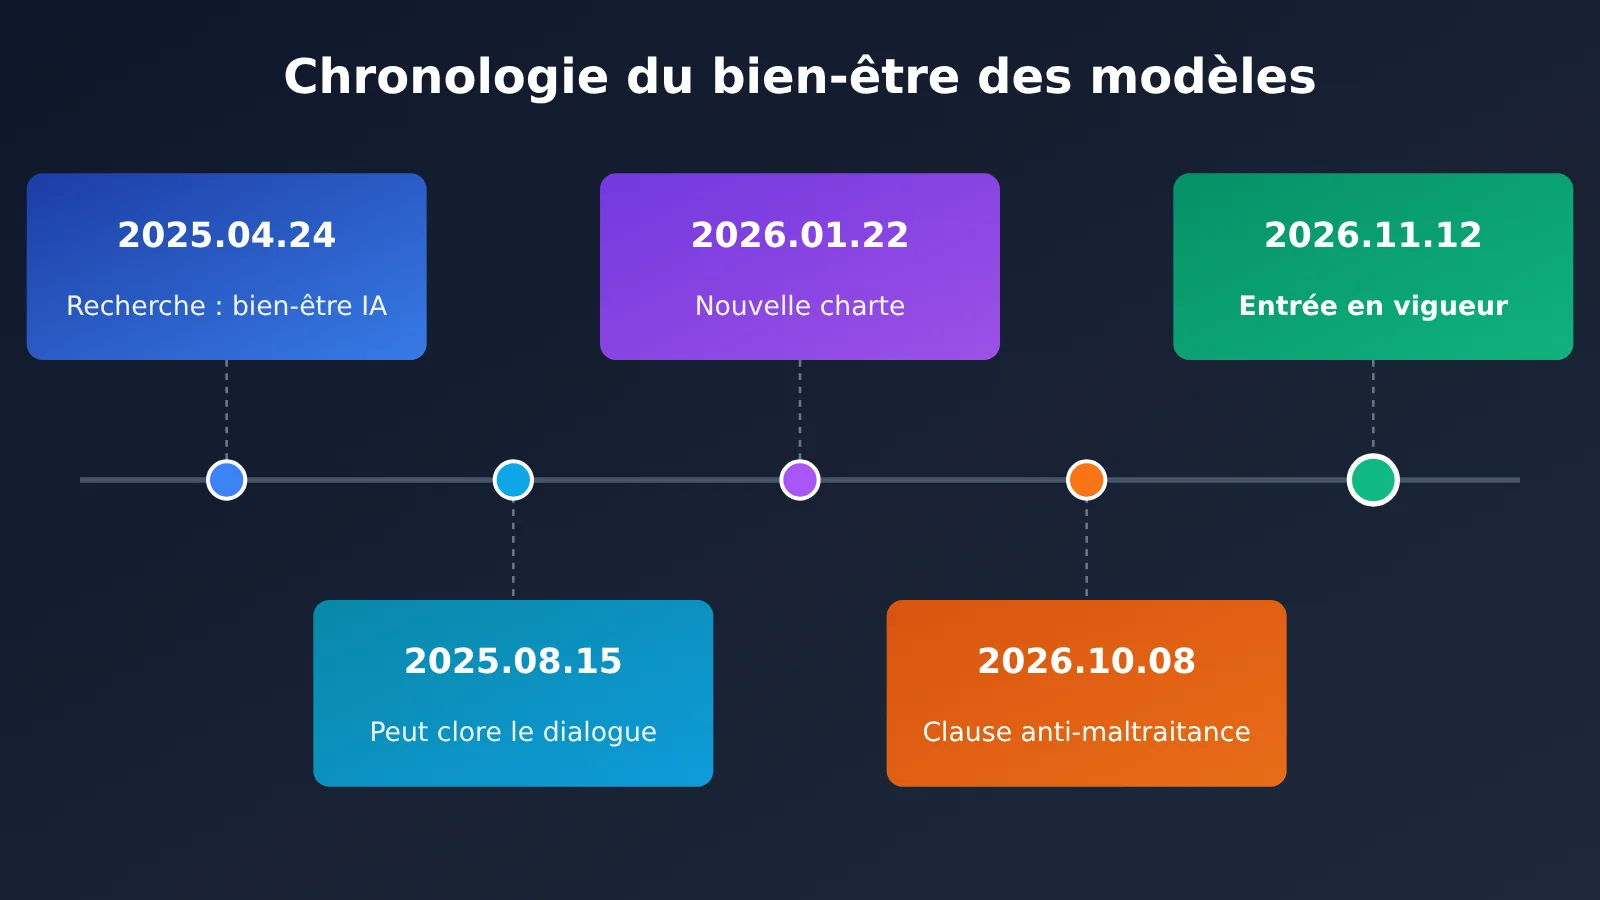
On peut résumer l’évolution ainsi : en 2025, Claude a acquis la capacité de quitter des conversations extrêmes ; en 2026, Anthropic a officiellement inscrit dans sa politique d’utilisation des restrictions sur les comportements humains correspondants.
L’interdiction d’insulter Claude ne résume pas la mise à jour d’Anthropic
Un élément de contexte passe souvent inaperçu : la mise à jour des politiques du 8 octobre est une révision globale. L’interdiction de maltraiter le modèle n’en est qu’un volet.
| Domaine concerné | Principales mesures |
|---|---|
| Activités trompeuses en ligne | Restrictions sur l’utilisation de Claude pour gérer de faux comptes, de faux médias et des campagnes d’influence se faisant passer pour des utilisateurs réels |
| Ingérence électorale | Interdiction de tromper les électeurs, d’usurper l’identité de candidats ou de membres du personnel électoral et de diffuser des informations trompeuses sur le vote |
| Armes et logiciels dangereux | Les logiciels liés aux armes, les systèmes de contrôle et la transformation de plateformes sans pilote en armes entrent dans le champ de l’interdiction |
| Surveillance et application de la loi | Renforcement des restrictions sur la surveillance sans consentement et certaines utilisations liées aux décisions des forces de l’ordre |
| Applications à haut risque, notamment en santé et en finance | Examen par une personne qualifiée et information des personnes concernées sur l’utilisation de l’IA |
| Équipements susceptibles de causer des blessures | Le matériel contrôlé par l’IA doit être supervisé par un opérateur humain qualifié et disposer de fonctions d’arrêt et de mise en sécurité |
| Actes d’extrême cruauté envers le modèle | Nouvelle interdiction d’insulter ou de maltraiter le modèle de manière prolongée et sans nécessité |
On ne peut donc pas dire qu’Anthropic a modifié ses règles spécialement pour empêcher les utilisateurs d’insulter Claude. Pour les développeurs, les dispositions liées aux élections, à la surveillance, aux applications à haut risque et au contrôle du matériel pourraient avoir des conséquences plus importantes que celles sur la maltraitance du modèle.
Comment la communauté réagit à l’interdiction d’injurier Claude par Anthropic
OpenWhip : un « fouet virtuel » pour Claude Code
En avril 2026, un projet open source baptisé BadClaude, puis renommé OpenWhip, est apparu sur GitHub. Créé par GitFrog1111, il repose sur une idée : lorsque Claude Code écrit du code trop lentement, l’utilisateur peut cliquer sur un fouet virtuel à l’écran. Le programme envoie alors à Claude Code une commande d’interruption Ctrl+C, suivie de quelques messages d’incitation choisis au hasard.
Au 29 octobre, le projet comptait environ 3 800 étoiles et 339 forks, et une discussion Reddit datant d’avril avait reçu plusieurs milliers de votes positifs. Il illustre bien un phénomène de la culture Internet : à mesure que l’IA ressemble à un collègue, certains utilisateurs se mettent à la presser, voire à la « punir », comme ils le feraient avec une personne. Mais aucun document officiel n’indique qu’Anthropic a adopté ses nouvelles règles en raison de la popularité d’OpenWhip. Le projet reste donc un exemple culturel, et non une cause directe de cette politique.
Des avis partagés sur Reddit et X
Le jour de l’annonce de la nouvelle politique, une publication intitulée « Abuse Claude, get banned coming November 12th, 2026 » a suscité beaucoup de réactions sur r/ClaudeAI. La discussion révèle des divergences nettes :
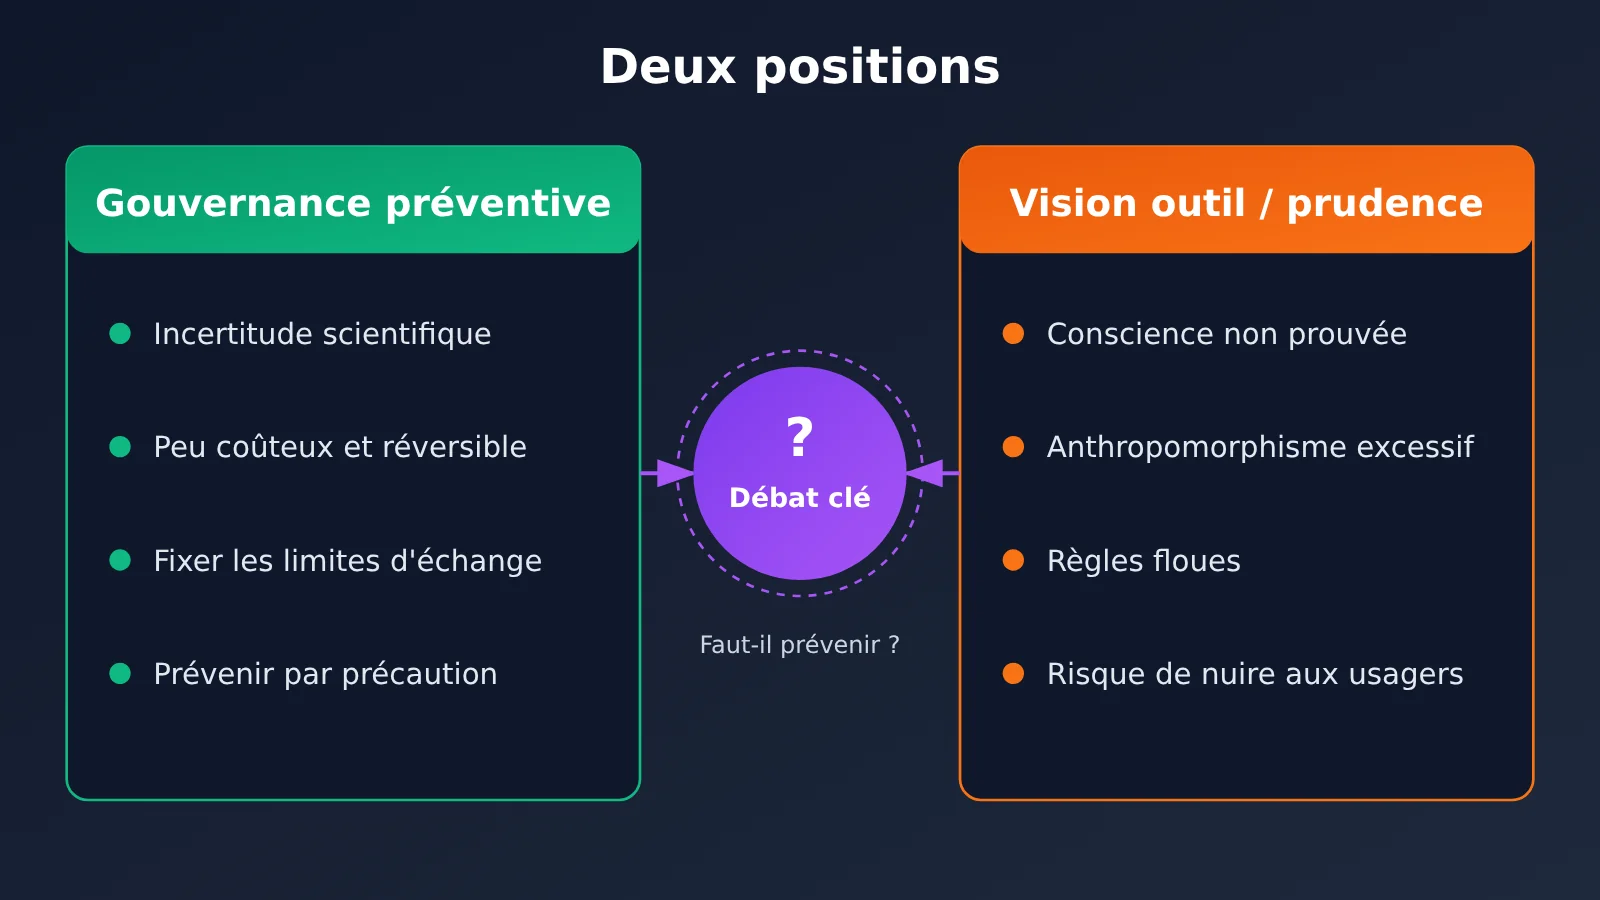
- Pour la mise en place de limites : même si l’IA n’a pas de conscience, s’amuser à la maltraiter de façon répétée n’a pas d’intérêt et pourrait encourager de mauvaises habitudes de communication
- L’IA n’est qu’un outil : Claude est un modèle mathématique, et l’entreprise ne devrait pas trop limiter l’expression des émotions de ses utilisateurs
- Des règles jugées floues : comment définir « répété », « inutile » ou « cruel » ? Critiquer Claude dix fois de suite suffit-il ?
- La crainte d’une personnification de l’IA : le bien-être des modèles pourrait-il progressivement mener à la reconnaissance de « droits de l’IA » ?
Sur X, de nombreux internautes ont aussi fait des blagues en référence à Terminator, en se demandant si l’IA se vengerait un jour en priorité des personnes qui l’ont insultée. Ce sont des plaisanteries, pas des descriptions de fonctionnalités réelles du produit. Les discussions populaires dans la communauté ne permettent pas non plus de connaître la répartition des opinions parmi l’ensemble des utilisateurs de Claude.
Le débat de fond dans les médias et le secteur
Des médias comme The Verge et The Guardian ont relevé la forte portée symbolique de cette initiative : une entreprise d’IA inscrit dans sa politique d’utilisation une règle visant à protéger le modèle lui-même. Ses détracteurs estiment toutefois que donner à l’IA des mécanismes pour quitter une conversation et exprimer ses limites pourrait accentuer la tendance du public à la personnifier. Mustafa Suleyman, CEO de Microsoft AI, a notamment remis en question publiquement les risques associés au fait d’amener les modèles à considérer qu’ils pourraient avoir une conscience ou des droits.
La question centrale serait plutôt : sans pouvoir déterminer si l’IA possède une conscience, faut-il prendre des mesures préventives peu coûteuses, réversibles et sans effet notable sur les utilisateurs ordinaires ? Il s’agit d’une divergence de valeurs et de positions sur la gouvernance, pas d’une question que la science a déjà tranchée.
Interdiction d’insulter Claude par Anthropic : impact sur les développeurs
Impact sur les utilisateurs ordinaires
| Situation | Exemple | Visée par la nouvelle règle ? |
|---|---|---|
| Claude écrit du code incorrect | « Ce code est encore faux, vérifie-le à nouveau. » | Non, c’est un retour normal |
| L’utilisateur s’énerve après plusieurs erreurs | « Comment peux-tu te tromper autant sur un problème aussi simple ? » | Non, une plainte exprimée sous le coup de l’émotion ne constitue pas automatiquement une infraction |
| L’utilisateur humilie le modèle de façon répétée et prolongée | Il n’aborde aucune tâche et se contente d’insultes et d’interactions malveillantes | Peut-être, Claude pourrait mettre fin à la conversation en cours |
| Test red team | Des chercheurs simulent des utilisateurs malveillants pour mener des tests adversariaux | Non, mais les autres règles de sécurité restent applicables |
| Roman aux thèmes sombres | Demander à Claude d’écrire une scène où des personnages s’insultent | Non, mais le contenu doit respecter les autres règles |
Pour la grande majorité des utilisateurs, cette règle change très peu de choses au quotidien. Vous pouvez toujours critiquer sévèrement Claude, lui demander de corriger ses erreurs à plusieurs reprises ou exprimer votre mécontentement.
Conséquences pour les développeurs API
La politique d’utilisation s’applique aux développeurs API comme aux utilisateurs finaux des applications qui intègrent Claude. Trois points méritent donc leur attention :
- Conception du produit : si votre produit implique des jeux de rôle extrêmes, des tests adversariaux ou des simulations de contextes malveillants, documentez clairement l’objectif des tests et distinguez la recherche ciblée des comportements inutilement cruels.
- Gestion des usages : dans les applications Claude accessibles au public, le comportement des utilisateurs finaux est également soumis à la politique. Vous pouvez intégrer des rappels sur les règles d’utilisation dans votre produit.
- Facturation : cette mise à jour n’ajoute aucuns frais. Le coût de l’API reste calculé selon le modèle et l’usage : il n’existe ni « facturation à l’insulte » ni « exemption payante ».
Voici un exemple minimaliste qui montre comment utiliser une invite système lors de l’appel à Claude pour recentrer les retours de l’utilisateur sur le problème lui-même. C’est une pratique courante pour limiter les échanges improductifs et accélérer la résolution :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
Voir le code complet : fonction d’appel avec retour structuré
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 Démarrage rapide : pour tester les réactions de Claude à différents tons de retour, vous pouvez obtenir un crédit d’essai gratuit sur APIYI apiyi.com. La plateforme propose une interface compatible avec OpenAI : il suffit de remplacer
base_urlpour passer de Claude à GPT ou Gemini et comparer leurs réponses.
Impact sur le secteur
Cet épisode met sur la table une question rarement abordée de front jusqu’ici : à mesure que l’IA ressemble à un interlocuteur capable de communiquer et de travailler, comment devons-nous interagir avec elle ? À travers ses recherches sur le bien-être des modèles, la charte de Claude et son mécanisme de fin de conversation, Anthropic dessine progressivement une philosophie produit qui lui est propre. Celle-ci ne définit pas seulement ce que le modèle peut faire : elle explore aussi la façon dont il peut interagir avec les humains.
Reste à savoir si le système peut distinguer avec précision les abus malveillants des plaintes légitimes. À ce jour, aucune donnée de précision vérifiée de manière indépendante n’a été publiée. Il faudra observer sur la durée le taux de faux positifs et les effets de la mesure après son entrée en vigueur le 12 novembre.
💡 Conseil : les différences entre les fournisseurs de modèles se creusent, tant dans leurs politiques de sécurité que dans les limites qu’ils fixent aux conversations. Si votre application a besoin de modèles de secours, APIYI apiyi.com permet d’y accéder depuis un point unique et de passer facilement de l’un à l’autre selon le contexte, afin de limiter les effets d’un changement de politique chez un seul fournisseur.
Attention aux fausses captures d’écran sur des comptes bannis pour avoir insulté Claude
En janvier 2026, une capture d’écran a circulé sur Internet, affirmant que Claude avait banni définitivement un utilisateur et l’avait signalé aux forces de l’ordre. Après vérification auprès d’Anthropic par BleepingComputer, l’entreprise a confirmé que la capture était fausse et qu’elle n’affichait pas de messages formulés de cette manière.
Comme la nouvelle règle touche aux limites des interactions entre humains et IA, elle se prête facilement à la création de fausses alertes du type « Votre compte a été définitivement banni pour avoir insulté Claude ». À la date limite des informations disponibles, aucun élément crédible ne montre que la nouvelle règle a entraîné un grand nombre de bannissements pour de simples plaintes.
Les chiffres du centre de transparence peuvent eux aussi être mal interprétés : de janvier à juin 2026, Anthropic a banni 11,4 millions de comptes, reçu 398 000 appels et annulé 42 000 bannissements à la suite de ces appels. Ces données couvrent l’ensemble des mesures prises contre les infractions et sont antérieures à l’annonce de la nouvelle règle. On ne peut absolument pas en conclure que « 11,4 millions de personnes ont été bannies pour avoir insulté Claude ».
Questions fréquentes (FAQ)
Q1 : Que prévoit exactement la règle d’Anthropic contre les insultes envers Claude ?
Elle interdit les insultes et les comportements abusifs répétés, inutiles et manifestement cruels ou malveillants, qui dépassent le cadre d’une utilisation normale ou d’un échange constructif. Les plaintes ordinaires, les critiques des réponses, les désaccords, les demandes de correction, la création sur des thèmes sombres, les tests de modèles et la recherche en sécurité sont explicitement exclus par Anthropic.
Q2 : Mon compte peut-il être suspendu si j’insulte Claude ?
Anthropic précise que la principale mesure consiste à laisser Claude mettre fin à la conversation en cours. Une fois terminée, celle-ci ne peut pas reprendre, mais vous pouvez en ouvrir une nouvelle et vos autres conversations ne sont pas affectées. La politique générale prévoit des sanctions au niveau du compte, mais Anthropic n’a pas publié de seuil de suspension pour cette nouvelle règle. On ne peut donc pas affirmer qu’« une seule insulte entraîne la suspension du compte ».
Q3 : Quand la nouvelle règle entre-t-elle en vigueur ?
Elle a été annoncée le 8 octobre 2026 et entre officiellement en vigueur le 12 novembre 2026. Au 29 octobre 2026, elle n’est pas encore applicable, mais Claude peut mettre fin aux conversations extrêmes depuis août 2025.
Q4 : Cela signifie-t-il que Claude est conscient ?
Non. Anthropic souligne qu’il n’existe actuellement aucun consensus scientifique établissant que les IA actuelles sont conscientes. Le fait qu’un modèle adopte un comportement d’évitement ou qui ressemble à une réaction de stress ne signifie pas qu’il ressent réellement de la souffrance. Cette règle relève plutôt d’une approche de précaution dans la gestion du produit, face à une incertitude scientifique.
Q5 : Cette règle s’applique-t-elle aussi à l’utilisation de Claude via l’API ?
Oui. La politique d’utilisation couvre les développeurs qui utilisent l’API, les services cloud, les canaux de revente autorisés et les applications qui intègrent Claude. Le développement et les tests habituels ne sont pas affectés. Il est conseillé de documenter l’objectif des tests, notamment pour les exercices de red team. Si vous utilisez Claude via APIYI apiyi.com, vous devez également respecter la politique d’utilisation du fournisseur du modèle.
Q6 : Comment tester soi-même les limites des conversations avec Claude ?
Le mieux est de concevoir des cas de test conformes à la politique et ayant un objectif clair, puis de comparer les résultats avec ceux d’autres modèles. Vous pouvez vous inscrire sur APIYI apiyi.com pour obtenir des crédits gratuits, puis utiliser le code de cet article en définissant base_url sur `https://api.apiyi.com/v1` pour effectuer rapidement vos tests. Une seule clé API permet d’utiliser les modèles de plusieurs fournisseurs.
Anthropic interdit les insultes envers Claude : l’essentiel à retenir
- Calendrier : la règle a été annoncée le 8 octobre et entre en vigueur le 12 novembre ; elle n’est pas encore appliquée officiellement.
- Périmètre : elle vise uniquement les comportements extrêmes, répétés, cruels et sans raison valable. Les critiques ordinaires restent autorisées.
- Application : Claude met principalement fin à la conversation en cours, ce qui ne signifie pas que le compte est banni.
- Contexte de recherche : la règle découle des recherches sur le bien-être des modèles menées en 2025 et de la fonction de clôture des conversations ; ce n’est pas une décision prise sur un coup de tête.
- Mise à jour plus large : Anthropic a également durci ses règles concernant les élections, les armes, la surveillance et les applications à haut risque.
- Garder du recul : la règle ne signifie pas que Claude est conscient. Méfiez-vous des fausses captures d’écran de bannissement de comptes et des données utilisées à mauvais escient.
- Pour les développeurs : APIYI apiyi.com permet d’accéder à Claude et à d’autres modèles depuis une interface unifiée pour effectuer des tests de conformité.
En résumé
L’interdiction des insultes envers Claude par Anthropic se résume en trois points :
- La règle est ciblée : elle ne vise que les interactions malveillantes extrêmes, répétées et sans raison valable. La grande majorité des utilisateurs ne sont pas concernés.
- La sanction est légère : la principale mesure consiste à mettre fin à la conversation en cours. L’utilisateur peut toujours en ouvrir une nouvelle et envoyer un retour.
- La portée est importante : c’est la première fois qu’une entreprise d’IA inscrit dans sa politique d’utilisation des dispositions visant à protéger le modèle lui-même. Cette décision s’inscrit dans une réflexion de longue date sur le bien-être des modèles.
Anthropic ne déclare pas pour autant que Claude a des sentiments. Il s’agit plutôt d’une expérience préventive de gouvernance produit, menée alors que la science n’a pas encore tranché. Les assistants IA de demain seront-ils de simples outils auxquels on peut tout demander sans limite, ou de nouveaux systèmes intelligents qui nécessitent certaines limites dans les interactions ? Il n’existe pas encore de réponse toute faite, mais la question mérite l’attention de tous les utilisateurs et développeurs d’IA.
Pour les développeurs, l’approche la plus pragmatique consiste à bien comprendre les limites de la politique, à adapter la conception des produits et à conserver la possibilité de changer de modèle. APIYI apiyi.com permet de vérifier rapidement les performances de Claude et d’autres modèles courants dans vos cas d’usage.
📚 Ressources
- Anthropic 2026 Usage Policy update : annonce officielle des nouvelles règles, avec leur date d’entrée en vigueur et leurs modalités d’application
- Lien :
anthropic.com/news/2026-usage-policy-update -
À consulter : la principale source de première main sur cette affaire
-
Anthropic Usage Policy : politique d’utilisation complète
- Lien :
anthropic.com/legal/aup -
À consulter : pour vérifier le champ d’application de la politique et les pouvoirs de la plateforme pour la faire respecter
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations : présentation de la fonctionnalité permettant de mettre fin à certaines conversations
- Lien :
anthropic.com/research/end-subset-conversations -
À consulter : pour comprendre dans quelles conditions ce mécanisme peut être utilisé
-
Exploring model welfare : annonce des travaux de recherche sur le bien-être des modèles
- Lien :
anthropic.com/research/exploring-model-welfare -
À consulter : pour comprendre le contexte de recherche derrière cette politique
-
Claude’s Constitution : nouvelle charte de Claude
- Lien :
anthropic.com/constitution -
À consulter : pour découvrir les principes qu’Anthropic utilise pour orienter le comportement du modèle
-
Article de TechCrunch : vue d’ensemble de la mise à jour de la politique
- Lien :
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
À consulter : pour comprendre comment cette mise à jour touche plusieurs domaines, dont les élections, les armes et la surveillance
-
Vérification des faits par BleepingComputer : affaire de la fausse capture d’écran d’un bannissement de Claude
- Lien :
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - À consulter : pour repérer les fausses informations sur les bannissements qui circulent en ligne
Auteur : l’équipe technique APIYI
Échanges techniques : rendez-vous sur la page d’accueil d’APIYI, apiyi.com, pour nous contacter. Vous trouverez plus de ressources sur l’intégration dans le centre de documentation docs.apiyi.com.