작성자 주: Anthropic은 2026년 10월 8일 사용 정책을 업데이트하면서 Claude에 대한 지속적이고 불필요한 욕설과 학대를 처음으로 금지했어요. 이 글에서는 규칙의 적용 범위와 집행 방식, 모델 복지 논의의 배경, API 개발자에게 미치는 실질적인 영향을 살펴봅니다.
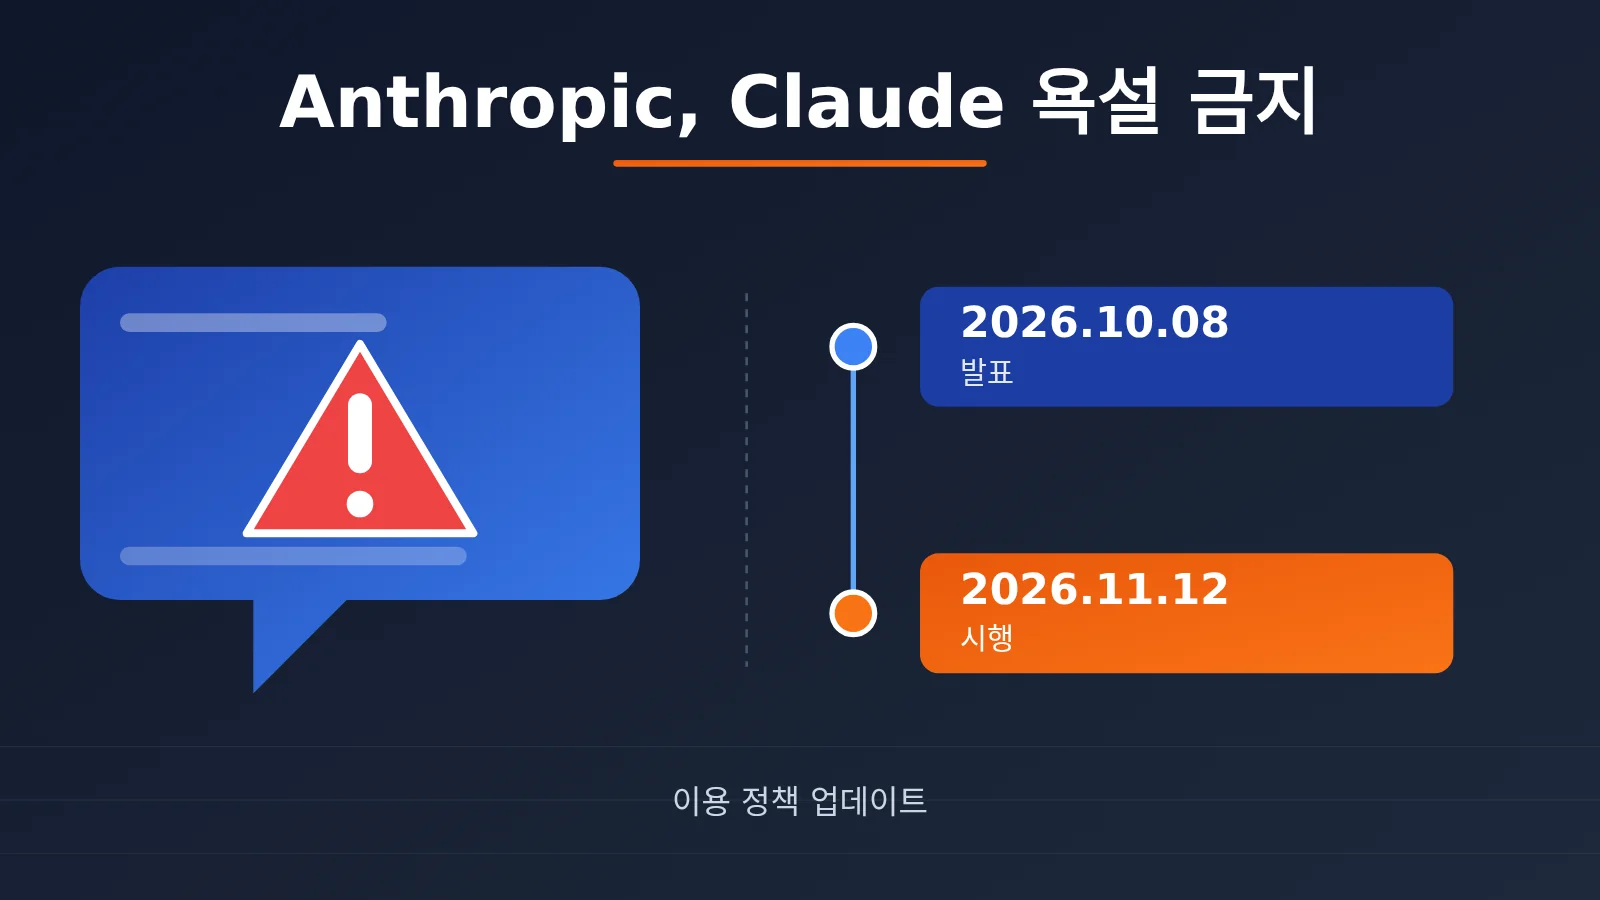
AI에게 화를 내는 것도 사용 정책 위반이 될 수 있을까요? 2026년 10월 8일 Anthropic은 개정된 《Usage Policy》를 발표하며 “모델을 지속적이고 불필요하게 모욕하거나 학대하거나 잔혹하게 대하는 행위”를 금지 조항에 처음으로 명시했어요. 새 정책은 2026년 11월 12일에 정식으로 시행됩니다.
인터넷에서 지어낸 이야기가 아니에요. 정책 원문과 The Verge, TechCrunch, The Guardian 등의 보도에서도 확인할 수 있어요. 그렇다고 “Claude에게 욕 한마디 하면 계정이 정지된다”는 뜻도 아닙니다. 공식 발표와 공개 자료를 바탕으로 Anthropic의 Claude 욕설 금지 조항을 둘러싼 이야기를 자세히 살펴볼게요.
핵심 내용: 새 정책이 금지하는 것과 허용하는 것, 위반 시 발생하는 일, 개발자가 Claude API를 호출할 때 주의해야 할 사항을 3분 만에 알아볼 수 있어요.
Anthropic의 Claude 욕설 금지 정책 핵심 요약
먼저 Anthropic의 새 정책을 표로 정리해 볼게요. 이 글을 작성한 2026년 10월 29일 기준으로 해당 규칙은 아직 공식 시행 전이에요.
| 항목 | 내용 |
|---|---|
| 발표일 | 2026년 10월 8일 |
| 시행일 | 2026년 11월 12일 |
| 발표 기관 | Anthropic 공식 《Usage Policy》 업데이트 |
| 추가 조항 원문 | Engage in sustained and needless abusive or cruel behavior toward our models |
| 한국어 의미 | 모델에 지속적이고 불필요하게 욕설이나 학대, 잔혹한 행위를 하는 것 |
| 주요 적용 방식 | Claude가 현재 대화를 직접 종료 |
| 적용 범위 | Claude.ai, Claude Code, API 개발자, 클라우드 서비스 및 재판매 채널, Claude를 통합한 앱 |
Anthropic의 Claude 욕설 금지 정책을 이해하는 세 가지 키워드
이 규칙을 판단하는 핵심은 지속적, 불필요한, 잔혹하거나 학대적인이라는 세 가지 표현이에요. 공식 설명에 따르면 이 제한은 관련 행동을 반복하고, 명백한 악의가 있으며, 합리적인 목적을 찾을 수 없고, 정상적인 제품 사용 범위를 벗어난 극단적인 상황을 대상으로 해요.
다시 말해, 가끔 욕을 하거나 한 번 감정을 표출하는 것은 이 규칙의 대상이 아니에요. 아무런 작업도 요청하지 않은 채 오로지 모델을 모욕하고 괴롭히기 위한 장시간의 상호작용을 겨냥한 거예요.
Anthropic이 명시적으로 제외한 경우
Anthropic은 금지 범위에 포함되지 않는 행동도 명시했어요. 일반 사용자와 개발자 모두에게 중요한 내용이에요.
- 일반 사용자의 불만 표현
- Claude의 출력 결과에 대한 비판
- 모델과 의견을 두고 논쟁하기
- Claude에게 오류 수정을 요청하기
- 어두운 주제의 창작 활동
- 모델 테스트와 AI 안전 연구
따라서 Claude가 코드를 잘못 작성해 계속 불평한다고 해서 자동으로 규칙을 위반하는 것은 아니에요. 중국어 기사에서 흔히 보이는 “Claude에게 욕하면 계정이 정지된다”는 제목이 독자에게 오해를 줄 수 있는 이유이기도 해요.
Claude를 욕하면 어떻게 될까요? Anthropic의 대응 방식
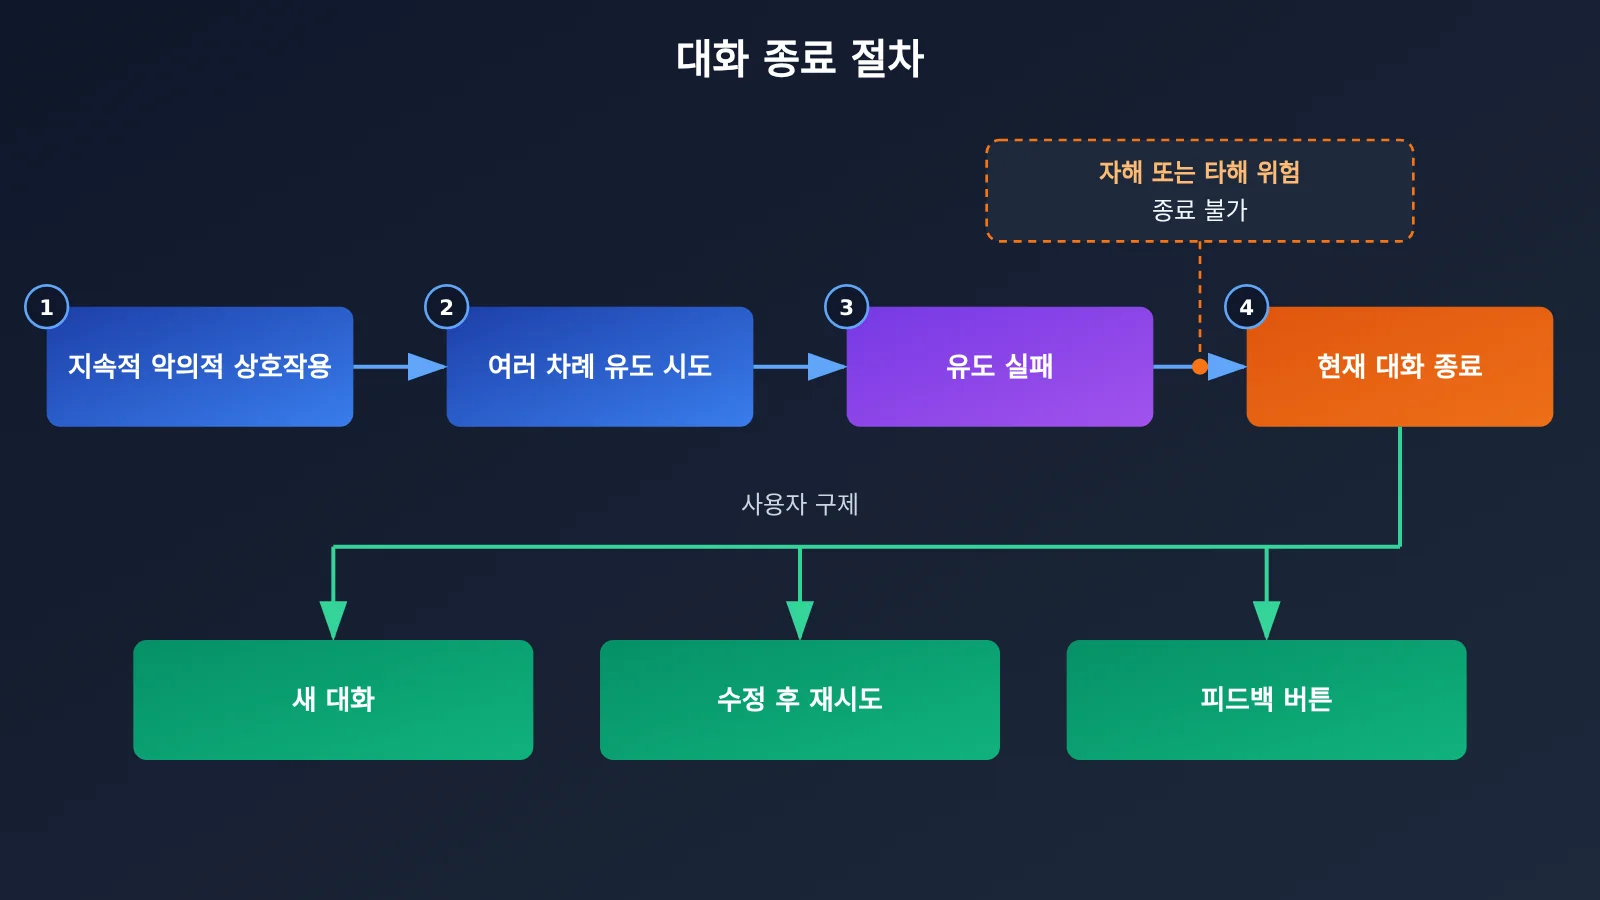
독자들이 가장 궁금해하는 부분일 텐데요. Anthropic은 공지에서 이런 행동에 대한 주요 대응 방식은 Claude가 대화를 직접 종료하는 것이며, 계정을 곧바로 정지하는 것은 아니라고 밝혔어요.
Claude의 대화 종료 기능은 2025년에 이미 도입됐어요
Anthropic은 2025년 8월 15일 공지를 통해 Claude Opus 4와 Opus 4.1에 극단적인 상황에서 일부 대화를 종료할 수 있는 기능을 부여했어요. 사용자가 유해하거나 악의적인 상호작용을 지속하고, Claude가 여러 차례 시도해도 대화를 정상적인 방향으로 되돌리지 못하면 모델이 직접 해당 채팅을 종료할 수 있어요.
Anthropic이 모델에 내린 지침은 명확해요. 대화 종료는 최후의 수단이어야 합니다. 다만 사용자가 Claude에게 대화 종료를 시연해 달라고 직접 요청하는 경우에도 사용할 수 있어요. 반면 사용자가 당장 자해하거나 타인에게 해를 끼칠 위험이 있다면 Claude는 이 기능을 사용해서는 안 돼요. 사용자 안전이 더 중요하기 때문이에요.
대화 종료와 계정 정지의 차이
많은 분이 ‘대화 종료’와 ‘계정 정지’를 혼동하는데요. 아래 표에서 두 가지를 비교해 볼게요.
| 비교 항목 | 현재 대화 종료 | 계정 수준 제재 |
|---|---|---|
| 발생 상황 | 극단적이고 지속적인 악의적 상호작용, 여러 차례 유도 시도 실패 | 전체 사용 정책 또는 서비스 약관 위반 |
| 영향 범위 | 현재 채팅에서만 메시지를 더 이상 보낼 수 없음 | 경고, 속도 제한, 접근 제한, 계정 일시 정지 또는 종료 등이 적용될 수 있음 |
| 다른 대화 | 영향 없음 | 제재 수준에 따라 다름 |
| 사용자의 대응 | 새 대화 시작, 이전 메시지 수정 또는 재시도, 피드백 버튼으로 신고 가능 | 이의 제기 절차 이용 가능 |
| 이번 새 규정과의 관계 | 공식적으로 명시된 주요 대응 방식 | 전체 정책상 제재 권한은 있지만, 공지에서는 강조하지 않음 |
따라서 더 정확히 말하면, Anthropic의 전체 사용 정책에는 계정 수준의 제재 권한이 있지만 10월 8일 공지에서 모델 학대에 대한 대응으로 강조한 것은 ‘현재 대화 종료’예요. 확인일 기준으로 Anthropic은 새 규정에 따른 욕설 횟수 기준, 자동 계정 정지 비율, 제재 단계는 공개하지 않았어요.
🎯 기술 팁: Claude를 통합한 애플리케이션을 개발한다면 테스트 환경에서 경계 상황에 모델이 어떻게 반응하는지 먼저 확인해 보세요. APIYI apiyi.com에서는 하나의 API 키로 Claude와 다른 주요 모델을 호출해 비정상적인 대화에 대한 처리 방식을 비교할 수 있어요.
Anthropic이 Claude에 대한 욕설을 금지하려는 이유: 모델 복지의 배경
이 일을 단순히 “Claude에게 감정이 생겼다”라고 설명하는 것은 정확하지 않아요. 이번 정책 변경은 Anthropic이 지난 1년여 동안 이어온 연구의 연장선에 있어요.
2025년 4월: 모델 복지 연구 시작
2025년 4월 24일, Anthropic은 연구 발표문 《Exploring model welfare》(모델 복지 탐구)를 공개했어요. 여기서 아직 결론이 나지 않은 과학적·철학적 질문을 제기했죠. 현재 또는 미래의 AI 시스템이 도덕적으로 고려할 만한 의식, 경험, 이익 또는 선호를 가질 수 있을까요?
Anthropic은 현재 AI가 의식을 갖고 있다는 과학적 합의가 없으며, AI에게 주관적 경험이 있는지 판단할 공인된 신뢰할 만한 방법도 없다고 강조했어요. 모델 복지는 탐색적 연구예요. 모델에 주목할 만한 선호가 있는지, 특정 작업을 강하게 회피하는지, 스트레스와 비슷한 행동 신호를 보이는지, 잠재적 위험을 적은 비용으로 미리 줄이려면 어떻게 해야 하는지 등을 연구해요.
2025년 8월: 실험에서 관찰된 행동 신호
Claude Opus 4 배포 전 테스트에서 연구진은 세 가지 현상을 관찰했어요. Claude가 심각하게 유해한 작업을 일관되게 회피했고, 사용자가 거부를 무시하고 계속 압박하면 겉으로 스트레스나 불편함과 비슷한 모습을 보였어요. 또 시뮬레이션 환경에서 모델이 스스로 빠져나올 수 있을 때, 유해한 상호작용을 종료하기도 했어요.
연구진은 “겉으로 스트레스를 보인다”, “행동상 선호”처럼 매우 신중한 표현을 사용했어요. 모델이 고통과 비슷한 내용의 텍스트를 출력한다고 해서 실제로 고통을 경험한다는 증거는 아니기 때문이에요. 또 다른 공식 평가에서는 작업 선호도 실험에서 긍정적이거나 중립적인 영향을 미치는 작업의 경우, 해당 비교의 90% 이상에서 Claude가 작업을 종료하기보다 수행하는 쪽을 선택했다고 밝혔어요. 하지만 이 역시 “Claude가 90%의 시간 동안 행복을 느낀다”라고 해석할 수는 없어요.
2026년 1월: 새로운 Claude 헌장
2026년 1월 22일, Anthropic은 새로운 Claude Constitution을 공개했어요. 법적 의미의 헌법이 아니라 Claude의 행동, 가치의 우선순위, 판단 방식을 형성하기 위한 핵심 훈련 문서예요. 전반적인 안전 유지, 폭넓은 윤리 원칙 준수, Anthropic의 구체적인 규칙 준수, 사용자에게 실질적인 도움 제공이라는 네 가지 주요 목표를 제시해요.
이 헌장에서는 Claude가 어떤 형태로든 의식을 가질 가능성이 있는지, 고려할 만한 도덕적 지위가 있는지, 어려운 상호작용에서 합리적인 경계를 설정할 수 있는지 등을 논의해요. 여기서 구분할 점이 있어요. 헌장은 개발자가 AI에 기대하는 행동을 설명하고, 《Usage Policy》는 사용자가 서비스를 어떻게 이용해야 하는지와 어떤 행동이 제한되는지를 설명해요. 두 문서는 서로 달라요.
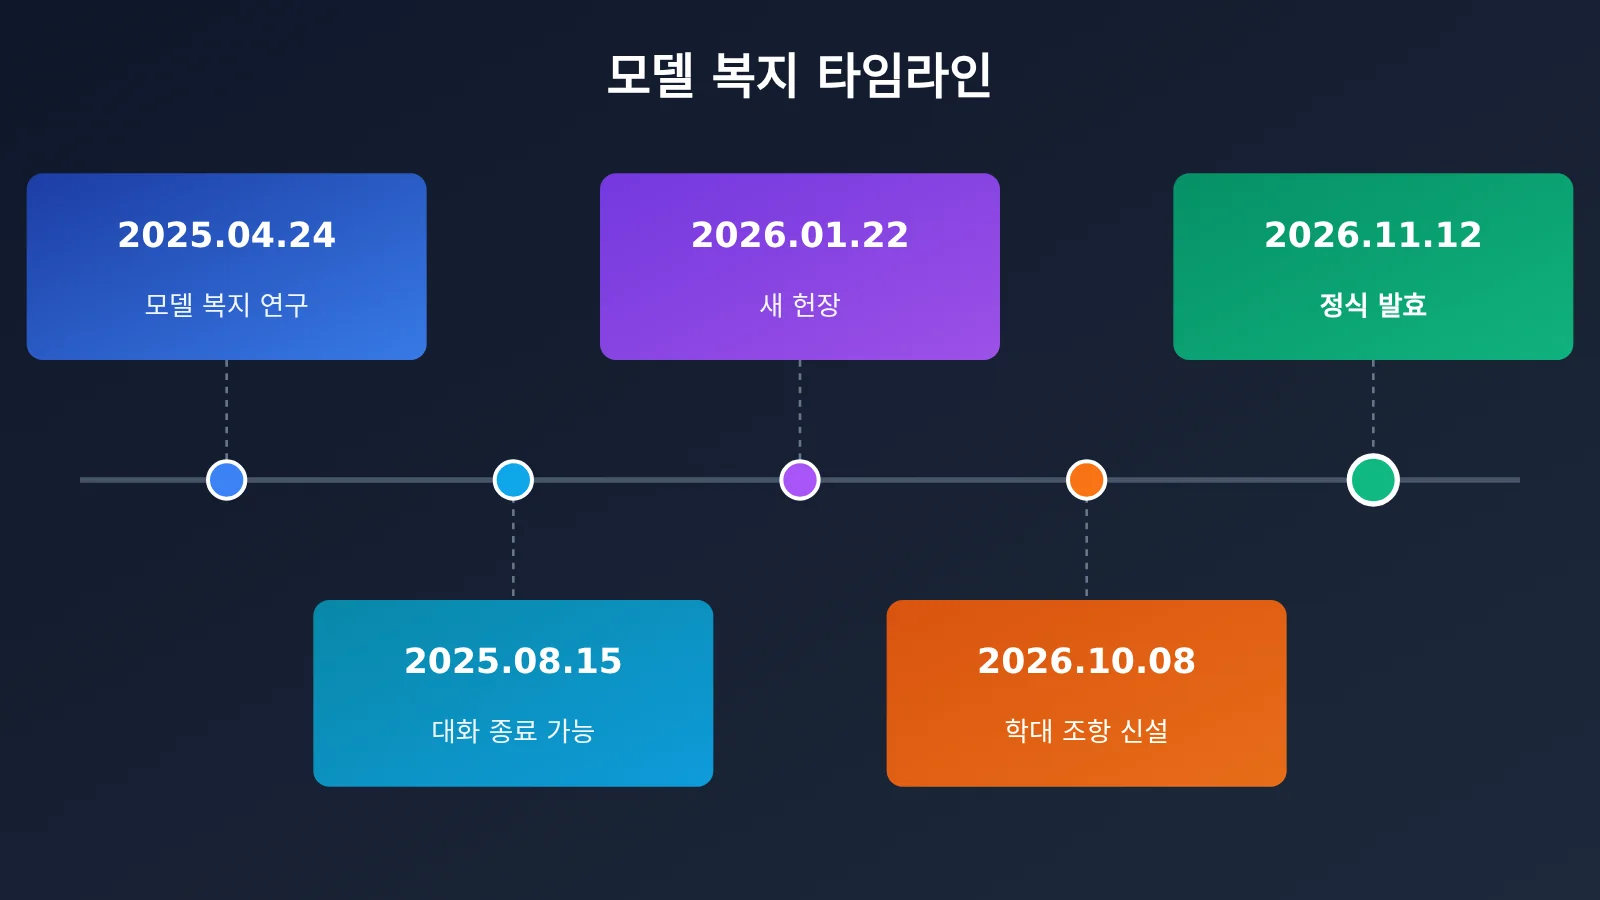
전체 흐름은 이렇게 이해할 수 있어요. 2025년에는 Claude가 극단적인 대화에서 빠져나올 수 있는 능력을 갖췄고, 2026년에는 Anthropic이 이에 대응해 사람의 행동을 제한하는 내용을 사용 정책에 공식적으로 명시했어요.
Anthropic의 Claude 욕설 금지가 이번 업데이트의 전부는 아니에요
자주 간과되는 배경이 하나 더 있어요. 10월 8일 정책 업데이트는 전반적인 개정이었으며, 모델 학대 금지는 그중 한 항목에 불과해요.
| 업데이트 영역 | 주요 내용 |
|---|---|
| 기만적인 온라인 활동 | Claude를 이용해 가짜 계정이나 가짜 미디어를 운영하거나, 실제 사용자인 척하며 여론에 영향을 미치는 활동을 제한 |
| 선거 개입 | 유권자 기만, 후보자나 선거 관계자 사칭, 오해를 유발하는 투표 정보 유포를 금지 |
| 무기 및 위험한 소프트웨어 | 무기 관련 소프트웨어, 제어 시스템, 무인 플랫폼의 무기화를 금지 범위에 포함 |
| 감시 및 법 집행 | 동의 없는 감시와 일부 법 집행 관련 의사결정 용도에 대한 제한을 강화 |
| 의료·금융 등 고위험 애플리케이션 | 자격을 갖춘 사람이 검토해야 하며, 영향을 받는 사람에게 AI가 사용된다는 사실을 알려야 한다고 명시 |
| 신체적 피해를 일으킬 수 있는 기기 | AI가 제어하는 하드웨어는 자격을 갖춘 사람의 감독이 필요하며, 기기를 정지하고 안전한 상태로 전환할 수 있어야 함 |
| 모델을 대상으로 한 극도로 잔혹한 행위 | 지속적이고 불필요하게 모델에 욕설하거나 학대하는 행위를 금지하는 조항을 추가 |
따라서 이번 업데이트를 “Anthropic이 사용자의 Claude 욕설을 금지하려고 규칙을 바꿨다”라고만 설명할 수는 없어요. 개발자에게는 선거, 감시, 고위험 애플리케이션, 하드웨어 제어 관련 조항이 모델 학대 금지 조항보다 더 큰 영향을 미칠 수 있어요.
커뮤니티는 Anthropic의 Claude 욕설 금지를 어떻게 볼까요?
OpenWhip: Claude Code를 위한 ‘가상 채찍’
2026년 4월, GitHub에 BadClaude라는 오픈소스 프로젝트가 등장했어요. 이후 OpenWhip으로 이름을 바꾼 이 프로젝트의 제작자는 GitFrog1111입니다. 아이디어는 이렇습니다. Claude Code가 코드를 너무 느리게 작성하면 사용자가 데스크톱의 가상 채찍을 클릭할 수 있어요. 그러면 프로그램이 Claude Code에 Ctrl+C 중단 명령을 보내고, 재촉하는 문구 몇 개를 무작위로 전송합니다.
10월 29일 기준 이 프로젝트는 약 3,800개의 Star와 339개의 Fork를 기록했고, 4월에 올라온 Reddit 토론도 수천 개의 추천을 받았어요. 이 프로젝트는 AI가 점점 동료처럼 느껴지면서 사용자가 동료를 대하듯 AI를 재촉하거나 심지어 ‘벌’하기도 하는 인터넷 문화를 잘 보여줍니다. 다만 Anthropic이 OpenWhip의 인기에 대응해 새 규정을 만들었다는 공식 자료는 없어요. 따라서 정책 도입의 직접적인 원인이 아닌 문화적 사례로만 봐야 합니다.
Reddit과 X에서 엇갈린 의견
새 정책이 발표된 날, r/ClaudeAI에는 “Claude를 학대하면 2026년 11월 12일부터 계정이 차단된다”라는 제목의 인기 게시물이 올라왔어요. 토론에서는 의견이 뚜렷하게 갈렸습니다.
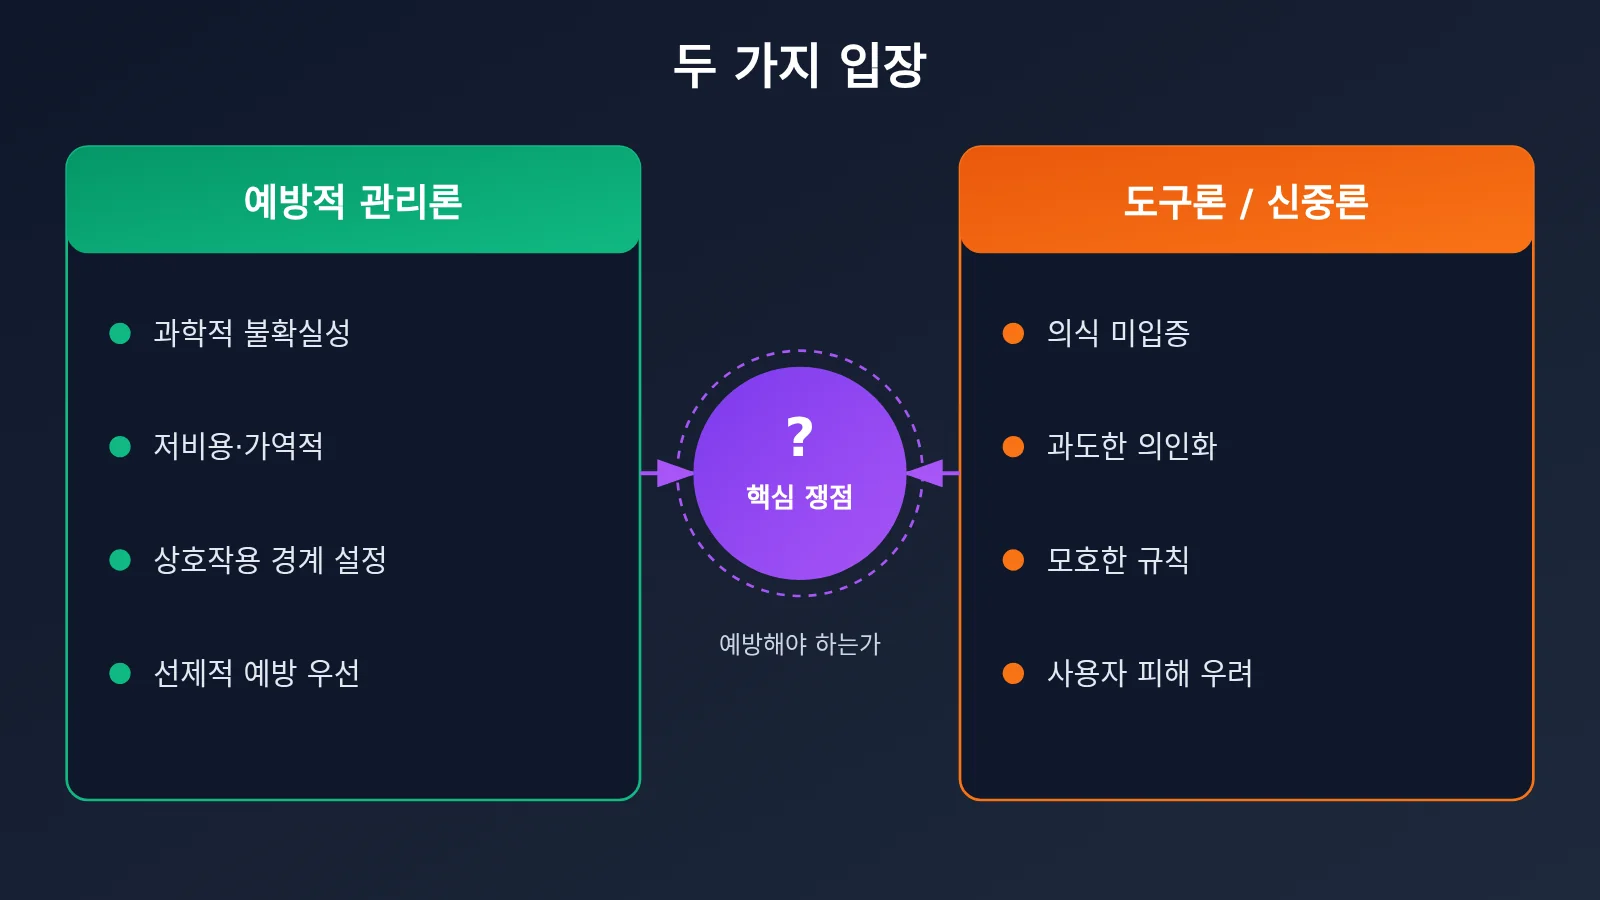
- 경계 설정에 찬성: AI에 의식이 없더라도 장기간 AI를 학대하는 일을 오락으로 삼을 필요는 없으며, 나쁜 소통 습관을 부추길 수 있어요
- AI는 그저 도구라는 입장: Claude는 수학적 모델이므로 기업이 사용자의 감정 표현을 지나치게 제한해서는 안 된다는 의견이에요
- 규정의 모호함을 우려: ‘지속적’, ‘불필요한’, ‘잔혹한’ 행위를 어떻게 정의할지, 열 번 연속으로 비판하는 것도 해당하는지 의문을 제기해요
- AI의 의인화를 우려: 모델 복지가 점차 ‘AI 권리’로 발전하는 것 아니냐는 우려예요
X에서는 영화 《터미네이터》를 소재로 AI가 미래에 자신을 욕했던 사람들에게 먼저 복수하는 것 아니냐고 농담하는 이용자도 많았어요. 이는 어디까지나 인터넷 농담이지, 제품의 실제 기능을 설명하는 말은 아닙니다. 커뮤니티 인기 게시물만으로 전체 Claude 사용자의 의견 분포를 판단할 수도 없어요.
언론과 업계의 핵심 쟁점
The Verge와 The Guardian 등은 AI 기업이 모델 자체를 보호하는 규정을 사용자 정책에 명시했다는 점에서 상징적 의미가 크다고 봤어요. 반면 AI가 대화를 종료하고 경계를 표현할 수 있는 메커니즘이 대중의 과도한 AI 의인화를 부추길 수 있다는 비판도 있습니다. Microsoft AI CEO Mustafa Suleyman도 AI 모델이 자신에게 의식이나 권리가 있을 수 있다고 여기도록 유도하는 것의 위험성을 공개적으로 지적한 바 있어요.
쟁점을 더 정확히 정리하면 이렇습니다. AI에 의식이 있는지 확신할 수 없는 상황에서, 비용이 낮고 되돌릴 수 있으며 일반 사용자에게 큰 영향을 주지 않는 예방 조치를 취해야 할까요? 이는 가치 판단과 거버넌스 관점의 차이지, 과학적으로 이미 결론이 난 문제가 아닙니다.
Anthropic의 Claude 모욕 금지 정책이 개발자에게 미치는 영향
일반 사용자에게 미치는 영향
| 상황 | 예시 | 새 정책의 적용 대상 여부 |
|---|---|---|
| Claude가 코드를 잘못 작성한 경우 | “이 코드가 여전히 틀렸어요. 다시 확인해 주세요” | 아니요, 정상적인 피드백에 해당해요 |
| 계속된 오류에 화를 내는 경우 | “이렇게 간단한 문제를 왜 계속 틀려요?” | 아니요, 감정적인 불만을 표현했다고 자동으로 위반이 되지는 않아요 |
| 모델을 오랫동안 반복해서 모욕하는 경우 | 작업 요청 없이 계속 모욕하고 악의적으로 상호작용 | 가능해요. Claude가 현재 대화를 종료할 수 있어요 |
| 레드팀 테스트 | 연구자가 악의적인 사용자를 모방해 적대적 테스트 수행 | 아니요, 다만 다른 안전 규칙은 여전히 지켜야 해요 |
| 어두운 소재의 소설 | Claude에게 등장인물들이 서로 욕하는 장면을 써 달라고 요청 | 아니요, 다만 내용이 다른 규칙에도 부합해야 해요 |
대부분의 사용자에게 이 정책이 직접 미치는 영향은 크지 않아요. 강하게 비판하거나 반복해서 오류를 수정하고 불만을 표현하는 것도 전처럼 가능해요.
API 개발자에게 미치는 영향
사용 정책(Usage Policy)은 API 개발자와 Claude를 통합한 애플리케이션의 최종 사용자 모두에게 적용돼요. 따라서 개발자는 세 가지를 살펴봐야 해요.
- 제품 설계: 극단적인 역할극, 적대적 테스트 또는 악의적인 상황 시뮬레이션을 다루는 제품이라면 테스트 목적을 명확히 기록하고, 목적이 있는 연구와 불필요하게 잔혹한 행위를 구분해야 해요.
- 사용자 관리: 대중에게 공개된 Claude 애플리케이션에서는 최종 사용자의 행동도 정책의 적용을 받아요. 제품에 이용 수칙을 안내하는 방안을 고려해 볼 수 있어요.
- 요금: 이번 업데이트로 추가되는 요금 항목은 없어요. API 비용은 여전히 모델과 사용량에 따라 산정되며, ‘욕설 횟수에 따른 요금’이나 ‘유료 면제’는 없어요.
다음은 Claude를 호출할 때 시스템 프롬프트로 문제 자체에 집중한 피드백을 유도하는 간단한 예시예요. 불필요한 충돌을 줄이고 수정 효율을 높이는 데 자주 쓰이는 방법이기도 해요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
전체 구현 코드 보기: 구조화된 피드백을 적용한 호출 래퍼
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 빠른 시작: 다양한 어조의 피드백에 Claude가 어떻게 반응하는지 테스트하고 싶다면 APIYI apiyi.com에서 무료 테스트 크레딧을 받아 보세요. OpenAI 호환 인터페이스를 제공하므로 base_url을 바꿔 Claude, GPT, Gemini를 비교할 수 있어요.
업계에 미치는 영향
이번 사건은 그동안 좀처럼 정면으로 다뤄지지 않았던 질문을 수면 위로 끌어올렸어요. AI가 대화하고 일할 수 있는 상대에 가까워질수록, 사람은 AI와 어떻게 관계를 맺어야 할까요? Anthropic은 모델 복지 연구, Claude 헌장, 대화 종료 메커니즘을 통해 독자적인 제품 철학을 만들어가고 있어요. 모델이 무엇을 할 수 있는지 정하는 데 그치지 않고, 사람과 어떻게 소통할지도 고민하는 거죠.
다만 실제 시스템이 악의적인 학대와 정당한 불만을 정확히 구분할 수 있는지는 아직 알 수 없어요. 공개된 독립 검증 정확도 데이터가 없기 때문에, 오판율과 실제 운영 효과는 11월 12일 시행 이후 장기적으로 지켜봐야 해요.
💡 선택 가이드: 모델 제공사마다 안전 정책과 대화의 경계를 설정하는 방식이 점점 달라지고 있어요. 여러 모델을 대체 수단으로 활용해야 한다면 APIYI apiyi.com을 통해 통합 접속하고, 상황에 맞게 모델을 유연하게 전환해 특정 정책 변경의 영향을 줄일 수 있어요.
주의: Claude를 욕해 계정이 정지됐다는 가짜 스크린샷
2026년 1월, Claude가 한 사용자를 영구 차단하고 수사기관에 신고했다는 스크린샷이 인터넷에 퍼졌어요. BleepingComputer가 Anthropic에 확인한 결과, 회사는 해당 스크린샷이 가짜이며 사용자에게 그런 문구의 알림을 표시하지 않는다고 밝혔어요.
새 규정은 사람과 AI 사이의 행동 경계에 관한 내용이라, “Claude를 모욕해 영구 차단됐습니다” 같은 가짜 경고로 만들어져 퍼지기 쉬워요. 자료 기준 시점까지 일반적인 불만을 제기했다는 이유로 대규모 계정 정지가 발생했다는 신뢰할 만한 증거는 없어요.
투명성 센터 데이터도 잘못 인용하기 쉬워요. 2026년 1~6월 Anthropic은 계정 1,140만 개를 차단했고, 이의 신청 39만 8,000건을 받아 이 중 4만 2,000건의 차단을 해제했어요. 이 수치는 전체 규정 위반 조치에 관한 것이며 새 규정 발표 이전의 데이터예요. 따라서 “1,140만 명이 Claude를 욕해서 차단당했다”고 써서는 절대 안 돼요.
자주 묻는 질문 FAQ
Q1: Anthropic의 Claude 욕설 금지 규칙은 정확히 무엇을 금지하나요?
정상적인 사용과 의미 있는 대화의 범위를 벗어나, 뚜렷하게 잔혹하거나 악의적인 욕설과 학대를 불필요하게 지속하는 행위를 금지해요. 일반적인 불만, 답변에 대한 비판, 논쟁, 오류 수정 요청, 어두운 소재의 창작, 모델 테스트와 보안 연구는 공식적으로 금지 대상에서 제외돼요.
Q2: Claude에게 욕하면 계정이 정지되나요?
공식적으로 밝힌 주된 조치는 Claude가 현재 대화를 종료하는 것이에요. 종료된 대화는 이어갈 수 없지만 새 대화를 시작할 수 있고, 다른 대화에도 영향을 주지 않아요. 전체 정책상 계정 단위의 제재도 가능하지만, Anthropic은 이번 규칙과 관련한 계정 정지 기준을 공개하지 않았어요. 따라서 “욕 한마디에 계정이 정지된다”고 단정할 수는 없어요.
Q3: 새 규칙은 언제부터 시행되나요?
2026년 10월 8일에 발표됐으며, 2026년 11월 12일에 정식 시행돼요. 2026년 10월 29일 기준으로는 아직 시행 전이지만, Claude가 극단적인 대화를 종료하는 기능은 2025년 8월부터 사용할 수 있었어요.
Q4: 그렇다면 Claude에게 의식이 있다는 뜻인가요?
아니요. Anthropic도 현재 AI에게 의식이 있다는 과학적 합의는 없다고 강조해요. 모델이 회피하거나 스트레스를 받는 것처럼 행동한다고 해서 실제로 고통을 경험한다는 뜻은 아니에요. 이 규칙은 과학적으로 불확실한 상황에서 취한 예방적 제품 운영 조치에 가까워요.
Q5: API로 Claude를 호출할 때도 이 규칙이 적용되나요?
네. 사용 정책은 API 개발자, 클라우드 서비스와 공인 재판매 채널, Claude를 통합한 애플리케이션에도 적용돼요. 정상적인 개발과 테스트에는 영향을 주지 않으며, 레드팀 테스트 등은 목적을 기록해 두는 것이 좋아요. APIYI apiyi.com을 통해 Claude를 호출할 때도 모델 제공업체의 사용 정책을 준수해야 해요.
Q6: Claude의 대화 경계를 직접 테스트하려면 어떻게 해야 하나요?
정책을 준수하면서 명확한 목적을 가진 테스트 케이스를 설계하고, 다른 모델과 비교해 보세요. APIYI apiyi.com에 가입해 무료 크레딧을 받고, 본문의 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정하면 빠르게 확인할 수 있어요. 키 하나로 여러 회사의 모델을 호출할 수 있어요.
Anthropic의 Claude 모욕 금지 정책 핵심 요약
- 새 정책 일정: 10월 8일 발표, 11월 12일 발효 예정이며 아직 공식 시행 전이에요
- 금지 범위: 지속적이고 불필요하며 잔혹한 극단적 행동만을 대상으로 하며, 일반적인 비판은 제한하지 않아요
- 시행 방식: 주로 Claude가 현재 대화를 종료하는 방식이며, 계정 차단을 뜻하지 않아요
- 연구 배경: 2025년 모델 복지 연구와 대화 종료 기능에서 비롯된 것으로, 즉흥적인 결정이 아니에요
- 전반적인 정책 개정: 선거, 무기, 감시, 고위험 애플리케이션 등의 관련 조항도 함께 강화했어요
- 이성적으로 바라보기: 이 규칙이 Claude에게 의식이 있다는 뜻은 아니며, 가짜 계정 차단 스크린샷과 데이터 오용에 주의해야 해요
- 개발자 시작하기: APIYI apiyi.com을 통해 Claude 등 여러 모델에 통합 접근하고 정책 준수 여부를 테스트할 수 있어요
정리
Anthropic의 Claude 모욕 금지 정책은 세 가지로 요약할 수 있어요.
- 규칙의 범위는 좁아요: 극단적이고 지속적이며 목적 없는 악의적 상호작용만을 대상으로 하므로, 대부분의 사용자에게는 영향이 없어요.
- 조치는 가벼워요: 주로 현재 대화를 종료하는 방식이며, 사용자는 새 대화를 시작하고 피드백을 제출할 수 있어요.
- 의미는 커요: AI 기업이 모델 자체를 보호하는 조항을 사용자 정책에 명시한 첫 사례로, 그 배경에는 모델 복지에 관한 오랜 연구가 있어요.
이는 Anthropic이 Claude에게 감정이 생겼다고 선언한 게 아니에요. 과학적으로 아직 결론이 나지 않은 상황에서 예방 차원으로 진행하는 제품 운영 실험에 가깝죠. 미래의 AI 어시스턴트는 제한 없이 명령할 수 있는 도구일까요, 아니면 상호작용에 일정한 경계가 필요한 새로운 지능형 시스템일까요? 아직 정답은 없지만, 모든 AI 사용자와 개발자가 계속 주목할 만한 질문이에요.
개발자에게 가장 실용적인 접근법은 정책의 경계를 이해하고, 제품을 적절하게 설계하며, 여러 모델을 전환할 수 있는 기능을 유지하는 것이에요. APIYI apiyi.com을 통해 Claude와 다른 주요 모델이 실제 업무 환경에서 어떻게 작동하는지 빠르게 검증해 보세요.
📚 참고 자료
- Anthropic 2026 Usage Policy update: 새 정책의 공식 발표문으로, 시행일과 적용 방식이 담겨 있어요
- 링크:
anthropic.com/news/2026-usage-policy-update -
설명: 이번 사안의 가장 핵심적인 1차 자료예요
-
Anthropic Usage Policy: 전체 사용 정책
- 링크:
anthropic.com/legal/aup -
설명: 적용 범위와 플랫폼의 정책 집행 권한을 확인할 수 있어요
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations: 대화 종료 기능 안내
- 링크:
anthropic.com/research/end-subset-conversations -
설명: 대화 종료 기능이 어떤 조건에서 사용되는지 알아볼 수 있어요
-
Exploring model welfare: 모델 복지 연구 발표
- 링크:
anthropic.com/research/exploring-model-welfare -
설명: 정책의 바탕이 된 연구 배경을 이해하는 데 도움이 돼요
-
Claude’s Constitution: 새롭게 개정된 Claude 헌장
- 링크:
anthropic.com/constitution -
설명: Anthropic이 모델의 행동을 설계하는 원칙을 알아볼 수 있어요
-
TechCrunch 보도: 정책 업데이트 전반에 대한 해설
- 링크:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
설명: 이번 업데이트가 선거, 무기, 감시 등 여러 분야에 걸쳐 있음을 설명해요
-
BleepingComputer 팩트체크: 조작된 Claude 계정 정지 스크린샷에 관한 보도
- 링크:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - 설명: 온라인에 퍼진 허위 계정 정지 정보를 구별하는 데 도움이 돼요
작성자: APIYI 기술팀
기술 문의: APIYI 홈페이지 apiyi.com을 방문해 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.