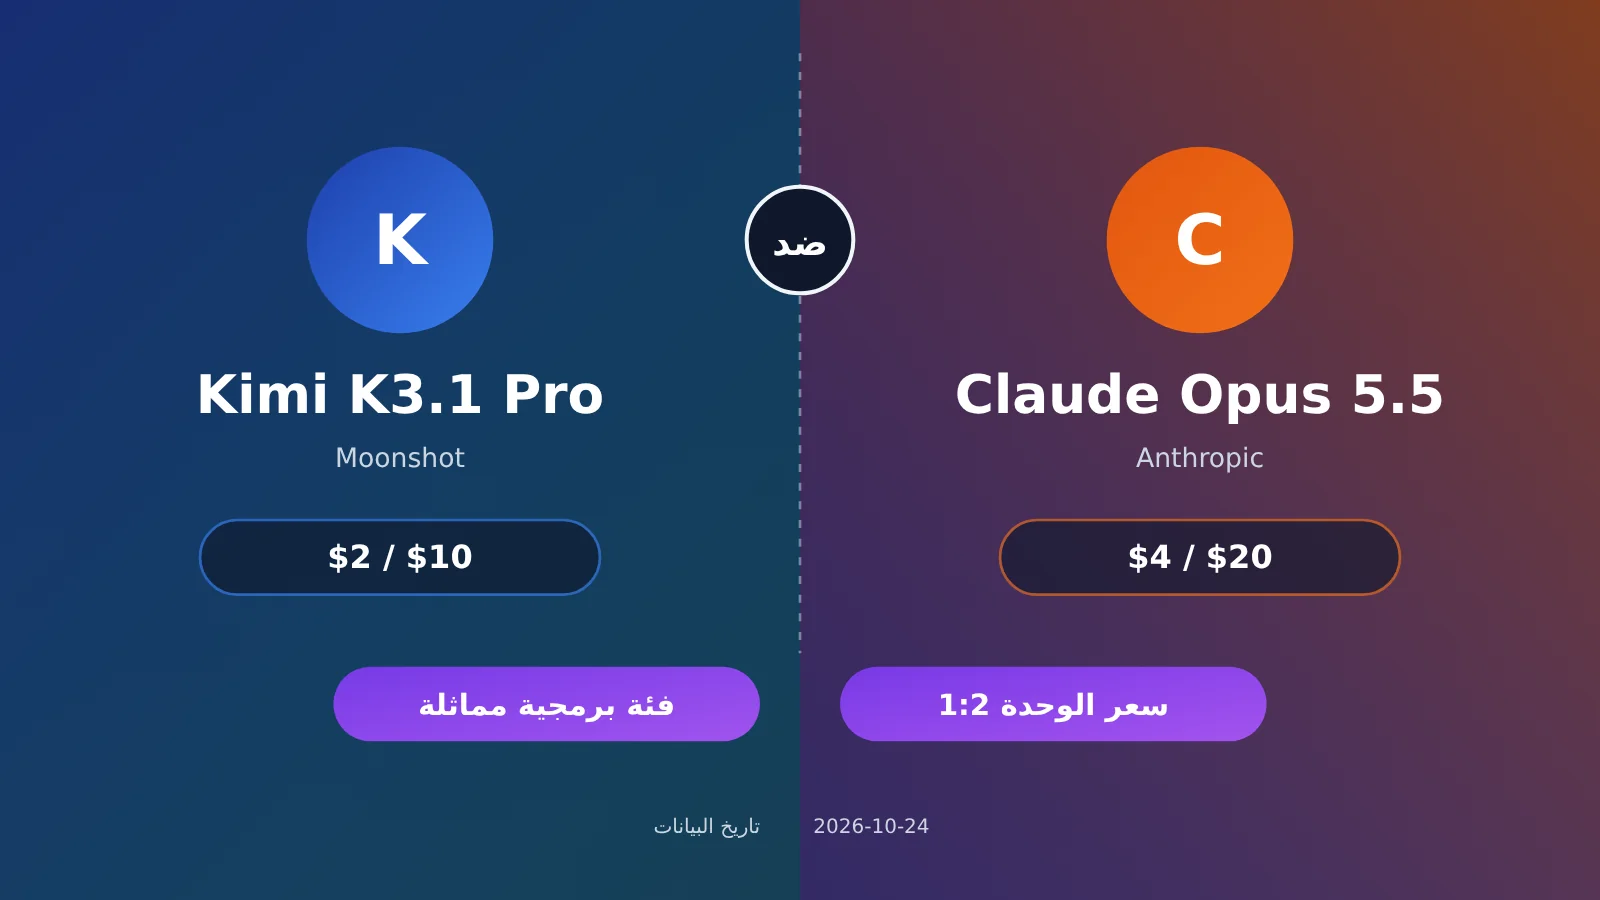
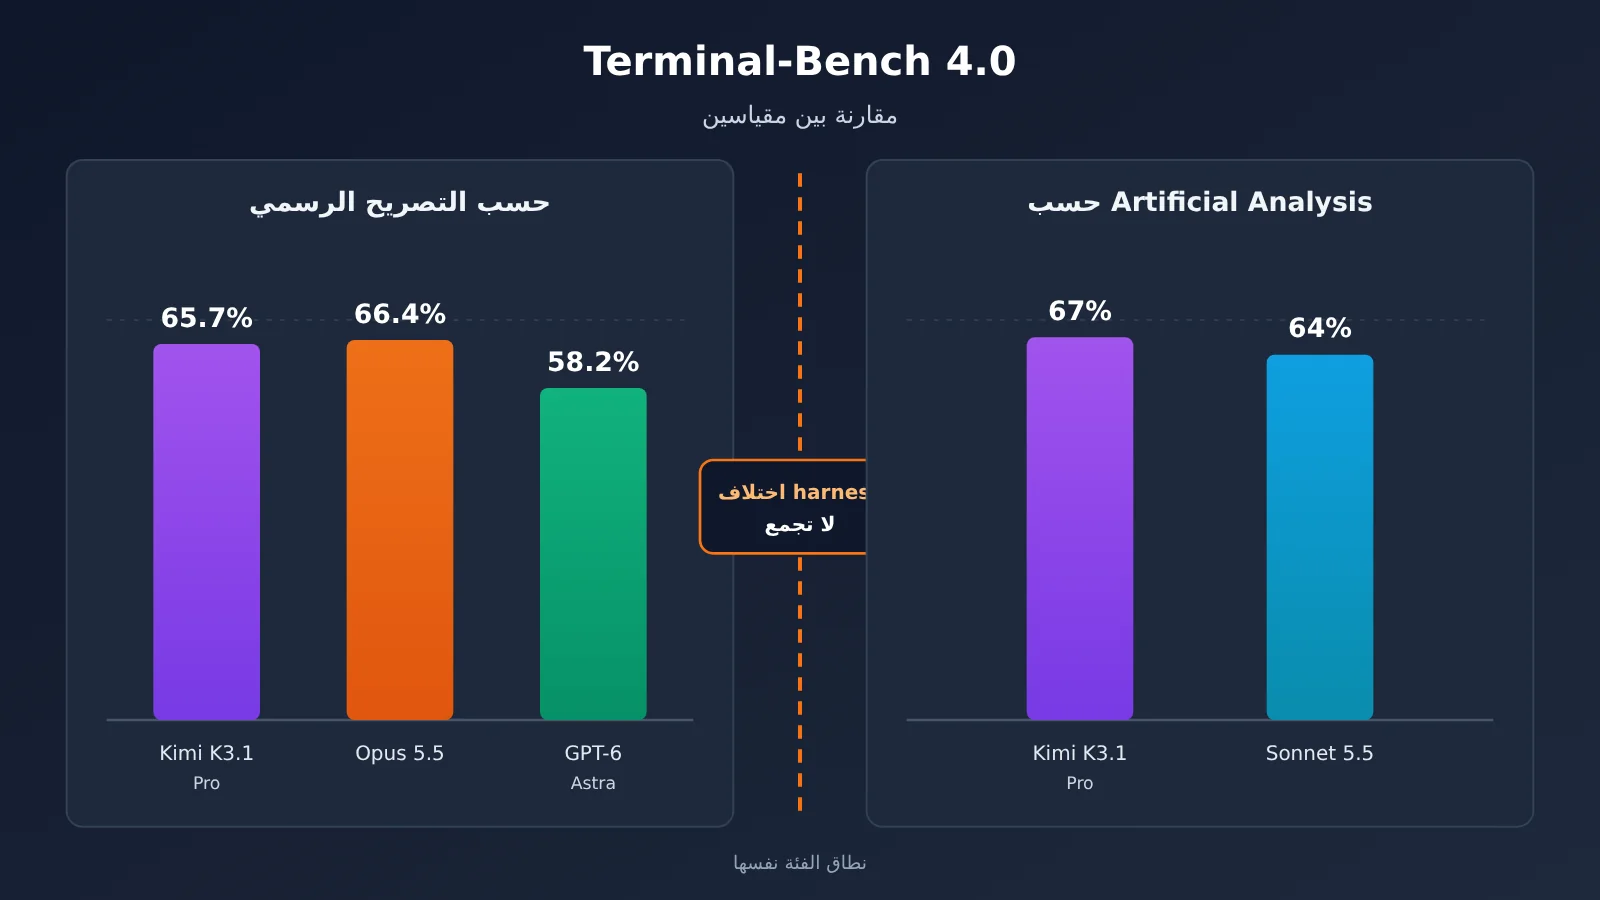
الخلاصة أولًا: قدرات البرمجة في Kimi K3.1 Pro وClaude Opus 5.5 متقاربة. في نتائج Terminal-Bench 4.0 التي نشرتها Moonshot رسميًا، حقق K3.1 Pro نسبة 65.7%، مقابل 66.4% لـOpus 5.5، أي إن الفارق لمصلحة الأخير يبلغ نحو 0.7 نقطة مئوية. لكن عند النظر إلى نتائج Terminal-Bench 4.0 وحدها، تصدّر K3.1 Pro تقييم Artificial Analysis المستقل. أما السعر، فتبلغ تكلفة الإدخال والإخراج في K3.1 Pro نصف تكلفة Opus 5.5 تمامًا (2 و10 دولارات، مقابل 4 و20 دولارًا)، بينما يتساوى النموذجان في سعر استخدام الذاكرة المؤقتة. مع ذلك، تستغرق عملية التفكير في K3.1 Pro وقتًا أطول، ووفقًا لتقديرات جهة خارجية، لا تنخفض التكلفة الفعلية للمهمة الواحدة إلى النصف.
أشرنا إلى مصدر كل البيانات الواردة أدناه، وصنّفناها ضمن ثلاث فئات: بيانات رسمية منشورة ذاتيًا (مدونة Moonshot والوثائق الرسمية لـKimi وAnthropic)، وبيانات من جهة خارجية (Artificial Analysis، ويُشار إليها لاحقًا بالاختصار AA)، وبيانات غير متحقق منها (لا تتوفر عنها بيانات علنية حاليًا، لذا لا يمكن تقديم سوى تقديرات عامة). ويمكن فهم الرمز المميز (token) على أنه «وحدة نصية» تُستخدم في احتساب تكلفة النموذج. ويعادل الحرف الصيني الواحد تقريبًا أكثر من token واحد، أما جميع الأسعار فتُحتسب بالدولار لكل مليون token.
لن نحول هذا المقال إلى منافسة من نوع «من يسحق الآخر». لكل من النموذجين نقاط قوة وضعف؛ لذلك سنعرض البيانات وفق معايير موحدة، ثم نقدم توصيات تساعدك على الاختيار بحسب احتياجاتك.
الفائدة الأساسية: بعد قراءة هذا المقال، ستتمكن من تحديد ما إذا كان Kimi K3.1 Pro أو Claude Opus 5.5 أنسب لمهمتك، وستعرف أيضًا حجم الفرق الفعلي في التكلفة بينهما.
1. نظرة سريعة على أبرز الفروق بين Kimi K3.1 Pro وClaude Opus 5.5
يلخّص الجدول التالي أبرز الفروق، ثم نتناول كل نقطة بالتفصيل في الأقسام التالية. ويبيّن عمود «مصدر البيانات» مصدر كل رقم، لتتمكن من التحقق منه بنفسك.
| مجال المقارنة | Kimi K3.1 Pro | Claude Opus 5.5 | مصدر البيانات |
|---|---|---|---|
| Terminal-Bench 4.0 (وفق الأرقام الرسمية) | 65.7% | 66.4% | أرقام صادرة عن الشركة (مدونة Moonshot) |
| Terminal-Bench 4.0 (وفق AA) | 67%، الأعلى بين النماذج التي اختبرتها AA | لم تذكره المراجع | جهة خارجية (AA) |
| سعر الإدخال / الإخراج | $2 / $10 | $4 / $20 | الأسعار الرسمية |
| سعر التخزين المؤقت عند تطابق المحتوى | $0.20 | $0.20 | الأسعار الرسمية |
| طول السياق | 1,048,576 رمزًا | حتى مليون رمز (بحسب النموذج) | الوثائق الرسمية |
| إمكانية إيقاف التفكير | لا؛ يمكن تعديل مستوى التفكير فقط | يُرجع إلى وثائق Anthropic | الوثائق الرسمية / لم يتم التحقق |
| الأوزان المفتوحة | التزمت الشركة بإتاحتها قبل 2026-11-04 | غير مفتوحة | أرقام صادرة عن الشركة |
«السياق» هو إجمالي المحتوى الذي يستطيع النموذج قراءته دفعة واحدة. ويبلغ حجم نافذة السياق في كلا النموذجين نحو مليون رمز، ما يكفي لإدخال مستودع شيفرة متوسط الحجم كاملًا دفعة واحدة. لذلك، لا يُعد هذا الجانب فرقًا حاسمًا عند الاختيار بينهما.
2. مقارنة الأسعار بين Kimi K3.1 Pro وClaude Opus 5.5: الأسعار في الفئات الخمس
لنوضّح أولًا مصطلحين متعلقين بالتسعير. إصابة ذاكرة التخزين المؤقت: عندما ترسل المحتوى نفسه في بداية الطلب مرارًا، مثل موجه النظام أو ملخص مستودع الشفرة، يحفظه مزوّد النموذج، ثم يحتسب تكلفة أقل عند قراءته مجددًا. الكتابة في ذاكرة التخزين المؤقت: هي الرسوم التي تُدفع عند حفظ هذا المحتوى فيها للمرة الأولى. وتختلف الأسعار حسب مدة الاحتفاظ به، سواء كانت 5 دقائق أو ساعة واحدة.
| النموذج | الإدخال | الإخراج | إصابة ذاكرة التخزين المؤقت | الكتابة في ذاكرة التخزين المؤقت لمدة 5 دقائق | الكتابة في ذاكرة التخزين المؤقت لمدة ساعة |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5 (للمقارنة) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
ملاحظة حول الأسعار: جُمعت البيانات في 2026-10-24. الأسعار بالدولار لكل مليون رمز، ولا تشمل الضرائب. المصدر: صفحات التسعير الرسمية لكل من Kimi وAnthropic.
2.1 كم يبلغ فرق الأسعار؟ ضعف السعر للإدخال والإخراج، ولا فرق في إصابة ذاكرة التخزين المؤقت
سعرا الإدخال والإخراج في Opus 5.5 يعادلان ضعف نظيريهما في K3.1 Pro تمامًا. أما سعر إصابة ذاكرة التخزين المؤقت فهو $0.20 لدى الشركتين، من دون أي فرق. وفي ما يتعلق بالكتابة في ذاكرة التخزين المؤقت، فإن Kimi أرخص: $2 مقابل $5 لمدة 5 دقائق، و$4 مقابل $8 لمدة ساعة.
وعند إدراج Claude Sonnet 5.5 للمقارنة، نلاحظ أن سعري الإدخال والإخراج فيه يطابقان تمامًا أسعارهما في K3.1 Pro، بينما يبلغ سعر إصابة ذاكرة التخزين المؤقت نصف السعر فقط ($0.10). لذا، إذا كنت تبحث عن «خيار من الفئة الرائدة بسعر أقل»، فإن المقابل المباشر لـKimi هو في الواقع Sonnet 5.5، وليس Opus 5.5 وحده.
2.2 لكل من النموذجين خيار سريع
توفّر الشركتان إصدارًا أسرع بسعر أعلى، لذا انتبه إلى اختيار الإصدار المناسب عند المقارنة:
kimi-k3.1-pro-highspeed: $4 / $20، وسعر إصابة ذاكرة التخزين المؤقت $0.20، والكتابة لمدة 5 دقائق $4، ولمدة ساعة $8 (وفقًا للتسعير الرسمي)- وضع Fast في Claude Opus 5.5: $8 / $40، ويشمل السياق كامل الطول، بما في ذلك الأجزاء التي تتجاوز 200k (وفقًا للتسعير الرسمي)
كما ترى، يطابق سعرا الإدخال والإخراج في إصدار Kimi السريع نظيريهما في Opus 5.5 العادي، بينما تظل تكلفة الكتابة في ذاكرة التخزين المؤقت لمدة 5 دقائق أقل.
3. نتائج Kimi K3.1 Pro وClaude Opus 5.5 في اختبارات البرمجة: منهجان مختلفان يجب النظر إليهما كلٌّ على حدة
Terminal-Bench 4.0 مجموعة اختبارات تتطلب إنجاز مهام حقيقية عبر الطرفية، مثل تثبيت الاعتماديات وإصلاح الأخطاء وتشغيل البرامج النصية. ولا تُحتسب المهمة ناجحة إلا إذا كانت النتيجة النهائية صحيحة. يستند الجدولان أدناه إلى مؤسستين مختلفتين، لذا لا تجوز مقارنة الأرقام بينهما.
3.1 الأرقام التي أعلنتها Moonshot بنفسها (مدونة Moonshot)
| الاختبار | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD (إعادة بناء ثلاثية الأبعاد عبر إنشاء شيفرة CAD من عروض متعددة) | 92.7% (مع الأدوات) | 96.2% | — |
أُجريت الاختبارات مع ضبط reasoning_effort على max، أي على أعلى مستوى للتفكير، وشُغّل K3.1 Pro باستخدام بيئة التشغيل (harness) الخاصة بـ Claude Code. ووصفت Moonshot أداءه في مدونتها بأنه «أقل بقليل من Claude Opus 5.5».
3.2 نتائج جهة خارجية (Artificial Analysis، 2026-10-23)
| بند الاختبار | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index (مؤشر الذكاء الشامل) | 55 (المركز الرابع) | 58 | 56 |
| Terminal-Bench 4.0 | 67% (الأعلى بين جميع النماذج) | غير وارد في المراجع | 64% |
| GDPval-AA (Elo) | 1846 (المركز الثالث) | 1866 | — |
| AA-Omniscience (موثوقية المعرفة) | المؤشر 30، ومعدل الهلوسة 44% | غير وارد في المراجع | — |
أُجري اختبار المؤشر الشامل لـ Opus 5.5 وفق إعداد «max with fallback». وحصل نموذج Muse Wonder Full، المدرج في التصنيف نفسه، على 56 نقطة أيضًا. وElo خوارزمية شبيهة بنظام النقاط في ألعاب مثل الشطرنج، تُحتسب فيها النتائج بناءً على المقارنة الثنائية بين النماذج؛ وكلما ارتفعت النتيجة كان ذلك أفضل. ويمكن فهم معدل الهلوسة ببساطة على أنه نسبة المرات التي يختلق فيها النموذج إجابة عندما لا يعرفها. لذا يجدر الانتباه إلى أن معدل K3.1 Pro بلغ 44%.
3.3 لماذا لا ينبغي احتساب نتائج المنهجين معًا؟
حصل K3.1 Pro على 65.7% وفق النتائج الرسمية، وعلى 67% وفق نتائج AA، في اختبار Terminal-Bench 4.0. لكن بيئة الاختبار (harness) المستخدمة في كل منهما مختلفة. ويمكن فهم بيئة الاختبار على أنها «البرنامج المحيط بالنموذج أثناء الامتحان»؛ فهي تحدد الأدوات التي يمكن للنموذج استخدامها، وطريقة قراءة الملفات والكتابة فيها، والمهلة الزمنية. وعندما تتغير هذه البيئة، قد تتغير نتيجة النموذج نفسه.
لذلك، لا يصح القول: «حصل K3.1 Pro على 67% لدى AA، متفوقًا بذلك على نتيجة Opus الرسمية البالغة 66.4%». والصياغة الأدق هي: وفق المنهج الرسمي، تقل نتيجة K3.1 Pro عن Opus بمقدار 0.7 نقطة مئوية؛ أما وفق منهج AA، فقد سجل K3.1 Pro أعلى نتيجة بين النماذج التي اختبرتها هذه الجهة. كلا الاستنتاجين صحيح ضمن منهجه، لكن جمعهما لا يثبت سوى أن النموذجين يقعان في المستوى نفسه تقريبًا.
3.4 ماذا يعني فرق نقطة واحدة في الاستخدام العملي؟
يُقيّم Terminal-Bench 4.0 المهام بدقة، والنتيجة إما اجتياز أو إخفاق. فرق نقطة مئوية واحدة يعني تقريبًا إنجاز إجابة صحيحة إضافية أو أقل لكل 100 مهمة. وغالبًا ما يظهر هذا الفرق في المهام النادرة، مثل سلاسل الأدوات قليلة الاستخدام أو إعدادات البيئات الخاصة. أما في المهام اليومية، مثل كتابة واجهات برمجية وتعديل شيفرة الأعمال وإضافة اختبارات الوحدات، فمن الصعب ملاحظة فرق بهذا الحجم.
ما يؤثر فعلًا في تجربة التطوير هو اختلاف النموذجين في جانبين من «طبيعتهما». الأول هو أسلوب التفكير: يعمل K3.1 Pro مع تفعيل التفكير دائمًا، وقد لاحظت AA أن مخرجاته لكل مهمة أطول (بحسب جهة خارجية). والثاني هو عادات استدعاء الأدوات، مثل عدد مرات استدعاء النموذج للأوامر وما إذا كان يميل إلى قراءة الملفات قبل تعديلها. لا تتوفر حاليًا بيانات مقارنة علنية وموثوقة حول هذا الجانب (غير متحقق منها)، لذا يُنصح بتجربة النموذجين على مهام حقيقية في مستودعك للحكم بنفسك.
4. مزايا Kimi K3.1 Pro وClaude Opus 5.5 وعيوبهما
مزايا Kimi K3.1 Pro (وفقًا للوثائق الرسمية):
- سعر الإدخال والإخراج نصف سعر Opus 5.5، كما أن كتابة البيانات في ذاكرة التخزين المؤقت أرخص.
- نافذة سياق بسعة 1,048,576 رمزًا، مع قيمة افتراضية لـ
max_completion_tokensتبلغ 131072، ويمكن أن تصل إلى 1048576. - متوافق مع تنسيقي واجهات OpenAI وAnthropic، وتوصي الوثائق الرسمية باستخدامه مع وكلاء البرمجة مثل Kimi Code وCodex وClaude Code.
- يدعم المخرجات المنظّمة واستدعاء الأدوات ومتابعة الكتابة باستخدام
partial. ويمكن لعملاء API اختيار الاحتفاظ بالبيانات لمدة صفر، وتتعهد الشركة بإتاحة الأوزان الكاملة قبل 2026-11-04.
قيود Kimi K3.1 Pro (وفقًا للوثائق الرسمية ومصادر خارجية):
- لا يمكن إيقاف التفكير. يمكن ضبط
reasoning_effortعلىlowأوhighأوmax، والإعداد الافتراضي هوmax. - قيمة
temperatureثابتة عند 1.0، وقيمةtop_pثابتة عند 0.95، ولا يمكن تمرير قيم مخصصة لهذين المعاملين. - لا يدعم إدخال الصور عبر عناوين URL العامة؛ إذ يجب إرسال الصور بترميز base64 (أي تحويل الصورة إلى سلسلة نصية طويلة) أو باستخدام
ms://file-id. - سجّلت AA معدل هلوسة بلغ 44%، كما أن مخرجاته لكل مهمة تميل إلى الطول.
مزايا Claude Opus 5.5: يتصدر نتائج الاختبارات ومؤشر AA الإجمالي، ويتقدم في BenchCAD بنحو 3.5 نقاط مئوية، كما يحقق نتيجة أعلى في GDPval-AA. ويوفر خيار تخزين مؤقت لمدة ساعة ووضع Fast، ما يتيح الموازنة بين السرعة والتكلفة حسب الحاجة. أما أبرز قيوده فهي السعر: فتكلُفة الإدخال والإخراج تبلغ ضعفي تكلفة K3.1 Pro، بينما يضاعف وضع Fast التكلفة مرة أخرى.
5. توصيات حسب الاستخدام: متى تختار Kimi K3.1 Pro ومتى تختار Claude Opus 5.5؟
يشير مصطلح «Agent» إلى تطبيق نموذج يستطيع تخطيط الخطوات بنفسه، واستخدام الأدوات، وتنفيذ المهام عبر جولات متعددة؛ مثل مساعد برمجي يعدّل الشفرة تلقائيًا ثم يشغّل الاختبارات.
| نوع المهمة | التوصية | الخلاصة في جملة واحدة |
|---|---|---|
| المهام غير المتصلة بالإنترنت ذات الحجم الكبير | Kimi K3.1 Pro | تكلفته نصف تكلفة الآخر، كما أن كتابة البيانات في الذاكرة المؤقتة أرخص؛ لذا يكون التوفير أوضح عند معالجة دفعات كبيرة من المهام |
| Agent برمجي ينفّذ جولات متعددة | كلاهما مناسب؛ يُنصح بإجراء اختبارات عملية | نتائجهما متقاربة، والاختيار يعتمد أساسًا على مدى ملاءمة طول التفكير وطريقة استخدام الأدوات لمستودع الشفرة لديك |
| إنشاء شفرات 3D وCAD | Claude Opus 5.5 | وفقًا لنتائج BenchCAD التي أعلنتها الشركة، سجّل Opus 5.5 نسبة 96.2% مقابل 92.7%، ما يجعله أكثر ثباتًا |
| فهم الصور | اختر وفقًا لطريقة التكامل | يدعم K3.1 Pro الصور، لكنه لا يتيح إرسال رابط URL عام مباشرةً؛ كما لا تتوفر بيانات متكافئة للمقارنة بين قدرات النموذجين في الصور (لم يتم التحقق منها) |
| الاستخدامات المؤسسية التي تتطلب الاستقرار والامتثال | يُفضّل Claude Opus 5.5؛ ويمكن النظر في Kimi عند الحاجة إلى التحكم في البيانات | يحقق Opus 5.5 مؤشرًا إجماليًا أعلى؛ بينما يوفّر Kimi سياسة عدم الاحتفاظ بالبيانات، ومن المقرر أن يتيح أوزانه قريبًا |
| الاستخدامات منخفضة الكمون التي تتطلب إيقاف التفكير | نماذج Claude | لا يمكن إيقاف التفكير في K3.1 Pro؛ أما إعدادات التفكير في Claude، فارجع فيها إلى وثائق Anthropic، ويمكنك أيضًا تجربة وضع Fast |
6. حساب تكلفة Kimi K3.1 Pro مقابل Claude Opus 5.5: خفض سعر الوحدة إلى النصف لا يعني خفض التكلفة إلى النصف
لنحسب تكلفة طلب واحد بسيط: 50 ألف token للإدخال و5 آلاف token للإخراج.
- Kimi K3.1 Pro: 50 ألفًا × 2 دولار ÷ مليون + 5 آلاف × 10 دولارات ÷ مليون = 0.10 دولار + 0.05 دولار = 0.15 دولار
- Claude Opus 5.5: 50 ألفًا × 4 دولارات ÷ مليون + 5 آلاف × 20 دولارًا ÷ مليون = 0.20 دولار + 0.10 دولار = 0.30 دولار
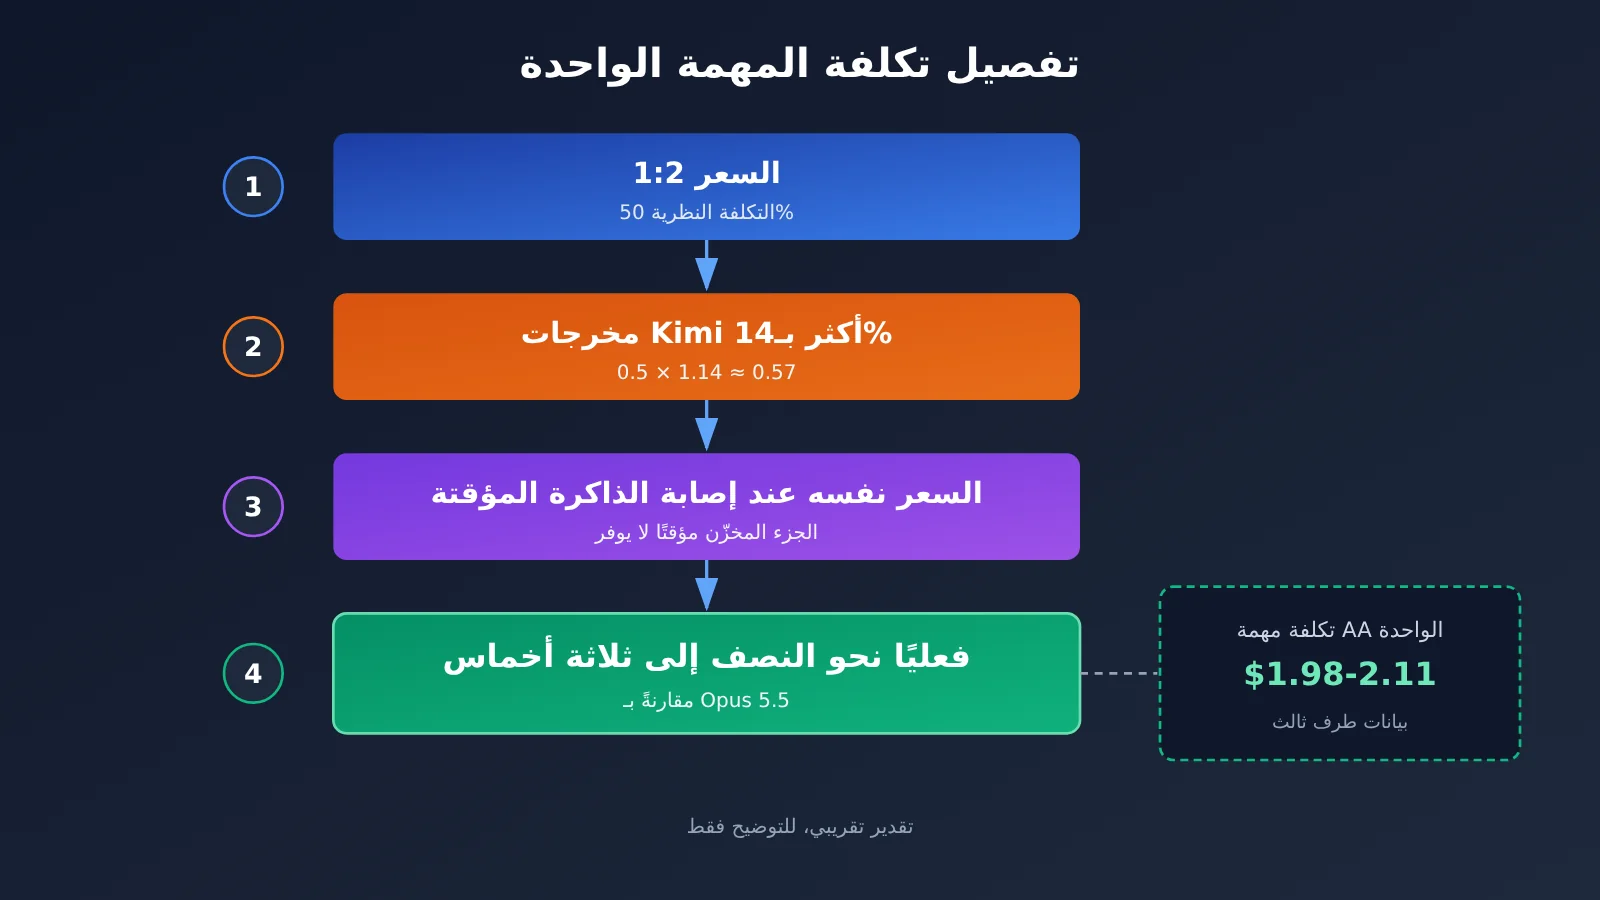
بحساب سعر الوحدة، تكلفته نصف التكلفة تمامًا. لكن هذا يفترض أن النموذجين ينتجان المقدار نفسه من النص. وهذا لا يحدث عمليًا. تُظهر بيانات AA أن مخرجات Kimi لكل مهمة تزيد بنحو 14% من حيث عدد الـtokens، بمتوسط يقارب 55 ألف token لكل مهمة، وتكلفة تبلغ نحو 1.98 دولار للمهمة الواحدة (بينما تعرض صفحة النموذج 2.11 دولار) (مصدر خارجي). وخلاصة AA هي أن سعر الوحدة في Kimi لا يتجاوز نصف سعر Opus 5.5، لكن مخرجاته المطوّلة تعني أن تكلفة المهمة الواحدة لا تنخفض إلى النصف فعليًا.
لنجرِ تقديرًا تقريبيًا (غير متحقق منه، والغرض منه التوضيح فقط): تأتي معظم تكلفة مهام وكيل البرمجة من المخرجات. فإذا كانت مخرجات Kimi أطول بنسبة 14%، فستبلغ تكلفة قسم الإخراج نحو 1.14 × 0.5 ≈ 57% من تكلفة Opus 5.5. أي إن التوفير يتجاوز 40% بقليل، لا 50%. ومع ذلك، يظل توفير أكثر من 40% كبيرًا، لكن لا تعتمدوا نسبة 50% عند إعداد الميزانية.
7. كيفية استدعاء Kimi K3.1 Pro وClaude Opus 5.5 من داخل الصين
قد يواجه المطورون في الصين مشكلات تتعلق بالدفع والاتصال بالشبكة عند استخدام الواجهات الرسمية الخارجية مباشرةً. APIYI (apiyi.com) منصة لتجميع واجهات API، تتيح استدعاء نماذج متعددة باستخدام مفتاح API واحد، وتتوافق واجهاتها مع تنسيق OpenAI، مع احتساب التكلفة حسب الاستخدام. وفقًا للتحقق بتاريخ 2026-10-24، يبلغ سعر claude-opus-5-5 على المنصة 4 دولارات للإدخال، و20 دولارًا للإخراج، و0.2 دولار لقراءة الذاكرة المؤقتة. أما claude-sonnet-5-5 فسعره 2 دولار / 10 دولارات / 0.1 دولار على الترتيب، وهي الأسعار نفسها لدى Anthropic. تشمل طرازات Kimi المتاحة حاليًا ما يلي:
kimi-k3: 3 دولارات / 15 دولارًا، و0.3 دولار لقراءة الذاكرة المؤقتةkimi-k2.7-code: 0.95 دولار / 3.99 دولاراتkimi-k2.6: 0.6 دولار / 2.4 دولارkimi-k2.5: 0.6 دولار / 3.15 دولارات
لم يكن kimi-k3.1-pro مدرجًا بعد في القائمة في ذلك اليوم. لمعرفة اسم الطراز وسعره على APIYI، يُرجى الرجوع إلى قائمة الطرازات على المنصة. وسنطرحه في أقرب وقت. إليك كيفية الربط:
- التنسيق المتوافق مع OpenAI: املأ
base_urlبالقيمةhttps://api.apiyi.com/v1 - تنسيق Anthropic: املأ عنوان
baseبالقيمةhttps://api.apiyi.com - وكلاء البرمجة (مثل Claude Code) يستخدمون تنسيق Anthropic عادةً، بينما تستخدم حزم SDK العادية تنسيق OpenAI
نصيحة للبدء سريعًا: يمكنك استخدام الرصيد المجاني للمستخدمين الجدد على APIYI apiyi.com، ثم تجربة
claude-opus-5-5وclaude-sonnet-5-5في مهام واقعية ضمن مستودعك، واتخاذ النتائج خط أساس للمقارنة. لمعرفة الطرازات والأسعار، يُرجى الرجوع إلى قائمة الطرازات على المنصة. سنطرح Kimi K3.1 Pro في أقرب وقت، وبعد إطلاقه يمكنك مقارنته مباشرةً بمجرد تبديل اسم الطراز.
8. توصية لاتخاذ القرار بين Kimi K3.1 Pro وClaude Opus 5.5
إذا كان حجم مهامك كبيرًا، وكانت الميزانية عاملًا مهمًا، ولا تمانع إبقاء وضع التفكير مفعّلًا باستمرار، فسيكون Kimi K3.1 Pro أفضل من حيث القيمة مقابل السعر. أما إذا كنت تفضّل الاستقرار العام، أو تحتاج إلى توليد محتوى ثلاثي الأبعاد أو تصميمات CAD، أو تريد إيقاف التفكير للحصول على استجابة أسرع، فالأفضل اختيار أحد نماذج Claude، سواء Opus 5.5 أو Sonnet 5.5. وفي مهام وكيل البرمجة متعددة الجولات، يحقق النموذجان نتائج متقاربة؛ لذا بدلًا من الاكتفاء بمراجعة قوائم الترتيب، جرّبهما على قاعدة شيفرتك لمدة أسبوع.
وهناك خيار آخر يسهل إغفاله: إذا كان ما يجذبك إلى Kimi هو أن تكلفته «نصف السعر»، فاعلم أن سعرَي الإدخال والإخراج في Claude Sonnet 5.5 مماثلان تمامًا، بينما تكون تكلفة الطلبات التي تستفيد من التخزين المؤقت أقل، كما أن مؤشر AA الشامل أعلى قليلًا. لذا يجدر بك إضافته إلى قائمة الخيارات.
الأسئلة الشائعة
س1: ما الفرق فعلًا بين Kimi K3.1 Pro وClaude Opus 5.5 في البرمجة؟
وفقًا للأرقام التي أعلنتها Moonshot، يتأخر K3.1 Pro عن Opus 5.5 بمقدار 0.7 نقطة مئوية في اختبار Terminal-Bench 4.0 (65.7% مقابل 66.4%). أما في اختبار AA المستقل، فقد حقق K3.1 Pro أعلى نتيجة بين جميع النماذج التي خضعت للاختبار في Terminal-Bench 4.0. ينتمي النموذجان إلى الفئة نفسها، والفارق بينهما يتراوح تقريبًا بين نقطة وثلاث نقاط مئوية.
س2: كم يبلغ الفرق بينهما في السعر؟
سعر الإدخال والإخراج لكل وحدة أعلى بمرتين في Opus، بينما يتساوى سعر الطلبات التي تُصيب ذاكرة التخزين المؤقت (0.20 دولار لكليهما)، وتكلفة الكتابة في الذاكرة المؤقتة أقل في Kimi. وبما أن مخرجات Kimi أطول، فإن تكلفة المهمة الواحدة فعليًا تُقدّر بنحو 50% إلى 60% من تكلفة Opus 5.5.
س3: لماذا تختلف النسبة الرسمية البالغة 65.7% عن نسبة 67% التي سجلها AA؟
استخدم الطرفان بيئتي اختبار (harness) مختلفتين؛ إذ استخدمت الاختبارات الرسمية بيئة Claude Code. لا يمكن مقارنة الدرجات الناتجة عن منهجيات مختلفة مباشرةً، بل ينبغي مقارنة كل نتيجة بنظيراتها ضمن المنهجية نفسها.
س4: هل يمكن إيقاف التفكير في Kimi K3.1 Pro؟
لا. الخيار الوحيد هو خفض `reasoning_effort` إلى `low`، أما `temperature` و`top_p` فقيمتاهما ثابتتان أيضًا. إذا كان زمن الاستجابة مهمًا جدًا، فننصح بالنظر في أحد نماذج Claude.
س5: كيف يمكن استدعاء النموذجين للمقارنة بينهما من داخل الصين؟
يمكنك استدعاء `claude-opus-5-5` عبر APIYI apiyi.com باستخدام المفتاح نفسه، مع ضبط `base_url` على `https://api.apiyi.com/v1`. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة اسم نموذج Kimi K3.1 Pro وسعره. سنضيف هذا النموذج في أقرب وقت؛ وإلى ذلك الحين، يمكنك استخدام `kimi-k3` لإجراء مقارنة أولية.
س6: أي النموذجين أنسب للمبتدئين للتجربة بتكلفة معقولة؟
ننصح بالبدء باستخدام Claude Sonnet 5.5 لتكوين معيار أولي، فسعره لكل وحدة يساوي سعر K3.1 Pro. بعد التسجيل في APIYI apiyi.com، ستحصل على رصيد مجاني للاختبار. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة الطرازات والأسعار المتاحة؛ وسنضيف K3.1 Pro في أقرب وقت، لتتمكن بعدها من التبديل بين النموذجين مباشرةً ومقارنتهما.
Kimi K3.1 Pro مقابل Claude Opus 5.5: أبرز النقاط
- متقاربان في البرمجة: وفق الأرقام الرسمية، تقل نتيجة K3.1 Pro بمقدار 0.7 نقطة مئوية، بينما سجّل أعلى نتيجة في Terminal-Bench 4.0 وفقًا لـAA
- السعر نصف السعر: $2/$10 مقابل $4/$20، وسعر الاستخدام عند إصابة ذاكرة التخزين المؤقت متساوٍ عند $0.20
- التكلفة لا تنخفض إلى النصف: ينتج Kimi نصًا أطول بنحو 14% لكل مهمة، وقدّرت AA تكلفة المهمة الواحدة بنحو $1.98–2.11
- لا تخلط بين منهجيتي القياس: نتيجة 65.7% الرسمية ونتيجة 67% لدى AA تستندان إلى بيئتي اختبار مختلفتين
- نقاط قوة Opus: يتقدم في المؤشر الإجمالي وBenchCAD وGDPval-AA
- قيود Kimi: لا يمكن إيقاف وضع التفكير، ولا يمكن تحميل الصور عبر رابط عام، ومعدل الهلوسة 44%
- كيفية البدء: يمكنك تجربة سلسلة Claude أولًا على APIYI apiyi.com. يُرجى الرجوع إلى قائمة الطرازات على المنصة لمعرفة الطرازات والأسعار؛ وسنطرح K3.1 Pro في أقرب وقت ممكن
الخلاصة
يمكن تلخيص المقارنة بين Kimi K3.1 Pro وClaude Opus 5.5 في ثلاث نقاط:
- القدرات: يتقاربان في البرمجة وقدرات الوكلاء، والفارق بينهما يقع ضمن نطاق اختلافات الاختبارات ومنهجيات القياس
- السعر: سعر الوحدة نصف الآخر تمامًا، لكن Kimi يستغرق وقتًا أطول في التفكير، لذا تكون التكلفة الفعلية أقل بنحو 40%
- اختيار النموذج: يُفضّل Kimi للمهام المجمّعة والسيناريوهات التي تراعي الميزانية، بينما يُفضّل Claude للمهام المتعلقة بـ3D وCAD، وللسيناريوهات التي تتطلب زمن استجابة منخفضًا وأداءً مستقرًا على نحو عام
تبقى الطريقة الأوثق للحكم هي اختبار النموذج على مهامك الفعلية. يمكنك أولًا استخدام سلسلة Claude على APIYI apiyi.com لتحديد مستوى أساسي للأداء. راجع قائمة الطرازات على المنصة لمعرفة الطرازات والأسعار؛ وسنطرح Kimi K3.1 Pro في أقرب وقت ممكن، وعند إطلاقه يمكنك مقارنة النتائج بمجرد تبديل اسم النموذج.
المراجع
- المدونة الرسمية لـ Moonshot ووثائق Kimi API: نتائج K3.1 Pro في الاختبارات، وقيود المعلمات، والأسعار
- الرابط:
platform.moonshot.cn/docs -
ملاحظة: تتضمن النتائج التي أعلنتها الشركة لاختباري Terminal-Bench 4.0 وBenchCAD، إضافةً إلى معلومات المعلمات
-
الأسعار الرسمية لـ Anthropic: أسعار Claude Opus 5.5 وSonnet 5.5 ضمن خمس فئات
- الرابط:
anthropic.com/pricing -
ملاحظة: تشمل وضع Fast وفئة التخزين المؤقت لمدة ساعة واحدة
-
Artificial Analysis: المؤشرات الشاملة من جهة خارجية وتكلفة المهام الفردية
- الرابط:
artificialanalysis.ai -
ملاحظة: بيانات 2026-10-23، وتشمل Terminal-Bench 4.0 وGDPval-AA وAA-Omniscience
-
قائمة النماذج لدى APIYI: نماذج المنصة وأسعارها
- الرابط:
docs.apiyi.com/models - ملاحظة: تم التحقق منها في 2026-10-24؛ يُرجى الرجوع إلى القائمة المباشرة للاطلاع على أحدث المعلومات
الكاتب: فريق APIYI التقني
للتواصل التقني: للمزيد من المعلومات، يُرجى زيارة مركز الوثائق على docs.apiyi.com. يُرجى اعتماد قائمة النماذج في المنصة للاطلاع على النماذج والأسعار؛ وسنوفّر نموذج Kimi K3.1 Pro في أقرب وقت ممكن.