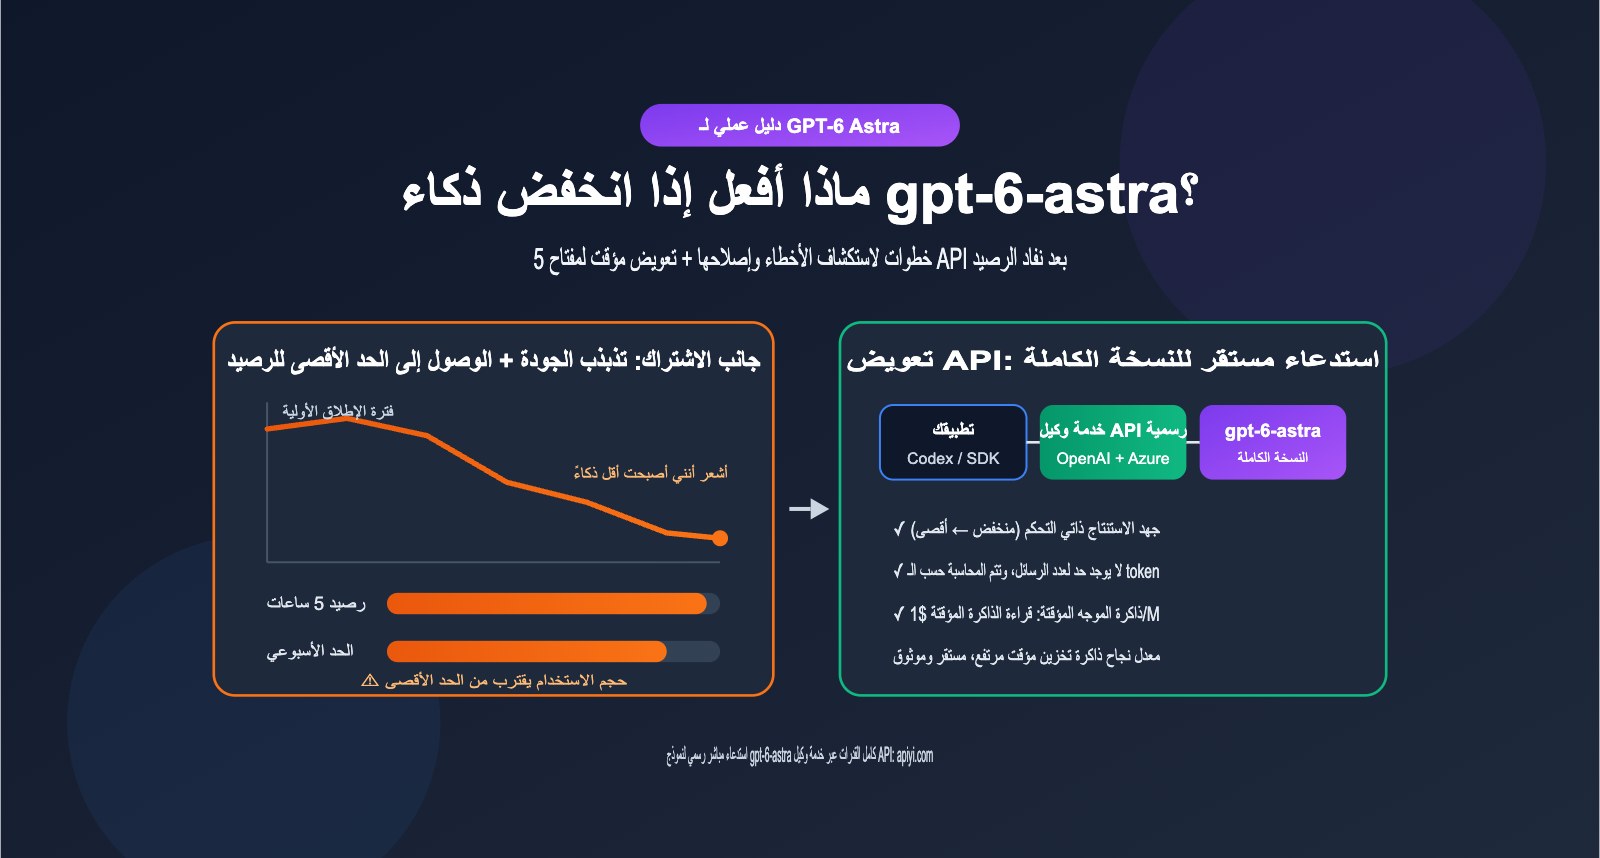
تم إطلاق نموذج gpt-6-astra في 3 سبتمبر 2026، وأصبح متاحاً للجميع في اليوم التالي. ولكن بعد أسبوع واحد فقط من إطلاقه، امتلأت وسائل التواصل الاجتماعي بشكاوى المستخدمين حول "تراجع ذكاء" gpt-6-astra؛ حيث أشاروا إلى أن نفس الموجه (Prompt) لم يعد يعطي جودة المخرجات التي كانت في الأيام الأولى، وأن مستوى الاستدلال "Extra high" أصبح أسرع ولكنه ينتج نتائج أكثر سطحية. في الوقت نفسه، أصبحت حصص استخدام Astra في ChatGPT وCodex أكثر تقييداً مقارنة بالجيل السابق GPT-5.6 Sol، مما أدى إلى توقف العديد من المطورين عن العمل بسبب نفاد الحصة المخصصة لهم. سنستعرض في هذا المقال طريقة الفحص المكونة من 5 خطوات للتأكد مما إذا كان gpt-6-astra قد تراجع ذكاؤه فعلياً، بالإضافة إلى حلول بديلة باستخدام خدمة وكيل API الرسمية عند نفاد الحصة، لمساعدتك في استقرار سير عملك.
القيمة الجوهرية: بعد قراءة هذا المقال، ستتمكن من التمييز بين "التراجع الحقيقي في الذكاء" و"التحيز الإدراكي"، وستعرف الحدود الحقيقية لحصص الاشتراك، كما ستتعلم كيفية استخدام كثافة استدلال قابلة للتحكم واستراتيجيات التخزين المؤقت لاستدعاء نسخة gpt-6-astra الكاملة بتكلفة معقولة.
النقاط الجوهرية حول جدل "تراجع ذكاء" gpt-6-astra
قبل البدء في الفحص، دعونا نضع الحقائق المعروفة حالياً على الطاولة. وفقاً لما جمعته وسائل إعلام أجنبية مثل Decrypt، بدأت الشكاوى تتركز بعد أسبوع من إطلاق Astra، حيث قام بعض المطورين (بما في ذلك فريق opencode) بالعودة إلى GPT-5.6 Sol بسبب تضاعف التكاليف وعدم تلبية الجودة للتوقعات. ولكن حتى وقت كتابة هذا المقال، لم تصدر OpenAI بياناً رسمياً بشأن Astra، كما يعتقد العديد من المستخدمين المخضرمين أن النموذج نفسه لم يتغير، بل إن فترة "شهر العسل" قد انتهت وبدأ الجميع يلاحظون أخطاءه.
| النقطة | الحقيقة المعروفة | ماذا يعني ذلك بالنسبة لك |
|---|---|---|
| تاريخ الإصدار | 03-09-2026 للمستخدمين المعتمدين، 04-09 متاح للجميع | النموذج لا يزال في مراحله الأولى، وقد تتغير سياسات الخادم بشكل متكرر |
| شكاوى التراجع | ملاحظات المستخدمين حول تراجع جودة المخرجات لنفس الموجه، وتقليل وقت الاستدلال العالي | يجب التحقق بطريقة قابلة للتكرار، لا تعتمد على الشعور فقط |
| الرد الرسمي | لا يوجد بيان رسمي حول Astra حتى الآن | لا يمكن التأكد مما إذا تم تعديل كثافة الاستدلال الافتراضية |
| سوابق تاريخية | في يوليو 2026 واجه Sol شكاوى مماثلة، نفت OpenAI التقليل المتعمد، لكنها اعترفت بتجربة إعدادات "كثافة الاستدلال" | ميزانية الاستدلال في ChatGPT ليست تحت سيطرتك الكاملة |
| تقييد الحصص | حصة Plus في Work/Codex حوالي 5-45 رسالة/5 ساعات، أي نصف ما كانت عليه في فترة Sol | من السهل جداً على المستخدمين المكثفين الوصول للحد الأقصى في أوقات الذروة |
لماذا يبدو gpt-6-astra "أقل ذكاءً"؟
احتمالية استبدال أوزان النموذج سراً منخفضة جداً، والسبب الأكثر شيوعاً يكمن في "ميزانية الاستدلال". يدعم gpt-6-astra في واجهة برمجة التطبيقات (API) خمسة مستويات لكثافة الاستدلال: low، medium، high، xhigh، وmax. كلما زاد المستوى، زادت خطوات تفكير النموذج قبل الإجابة، مما يرفع الجودة والوقت المستغرق بالتوازي. في منتجات الاشتراك مثل ChatGPT وCodex، يتم جدولة ميزانية الاستدلال مركزياً بواسطة المنصة؛ وبمجرد أن تقوم المنصة بخفض الميزانية الفعلية للتعامل مع ضغط الحوسبة، يرى المستخدم نتائج "أسرع ولكن أكثر سطحية"، وهو ما يتطابق تماماً مع محتوى الشكاوى.
من ناحية أخرى، أشار مطورون مثل Theo إلى أن التباين في مخرجات Astra كبير بطبيعته؛ فالمهمة الواحدة قد تؤدي إلى نتائج مذهلة أو أخطاء ساذجة. في البداية، يسهل على الناس تذكر الحالات المذهلة، ومع مرور الوقت يتم تضخيم حالات الفشل، وهذا التباين النفسي يتم تفسيره أيضاً على أنه "تراجع في الذكاء". لذا، فإن مفتاح الفحص هو فصل المتغيرات الثلاثة: "جدولة المنصة"، "تباين النموذج"، و"طريقة الاستخدام الشخصية".
خطوات استكشاف الأخطاء وإصلاحها الخمس لـ gpt-6-astra عند تراجع الأداء
هذه المجموعة من الخطوات مصممة لتتبعها بالترتيب عندما تشك في تراجع أداء نموذج gpt-6-astra، حيث تساعدك كل خطوة على استبعاد فئة معينة من الأسباب، مما يجنبك تبديل النماذج بشكل عشوائي.
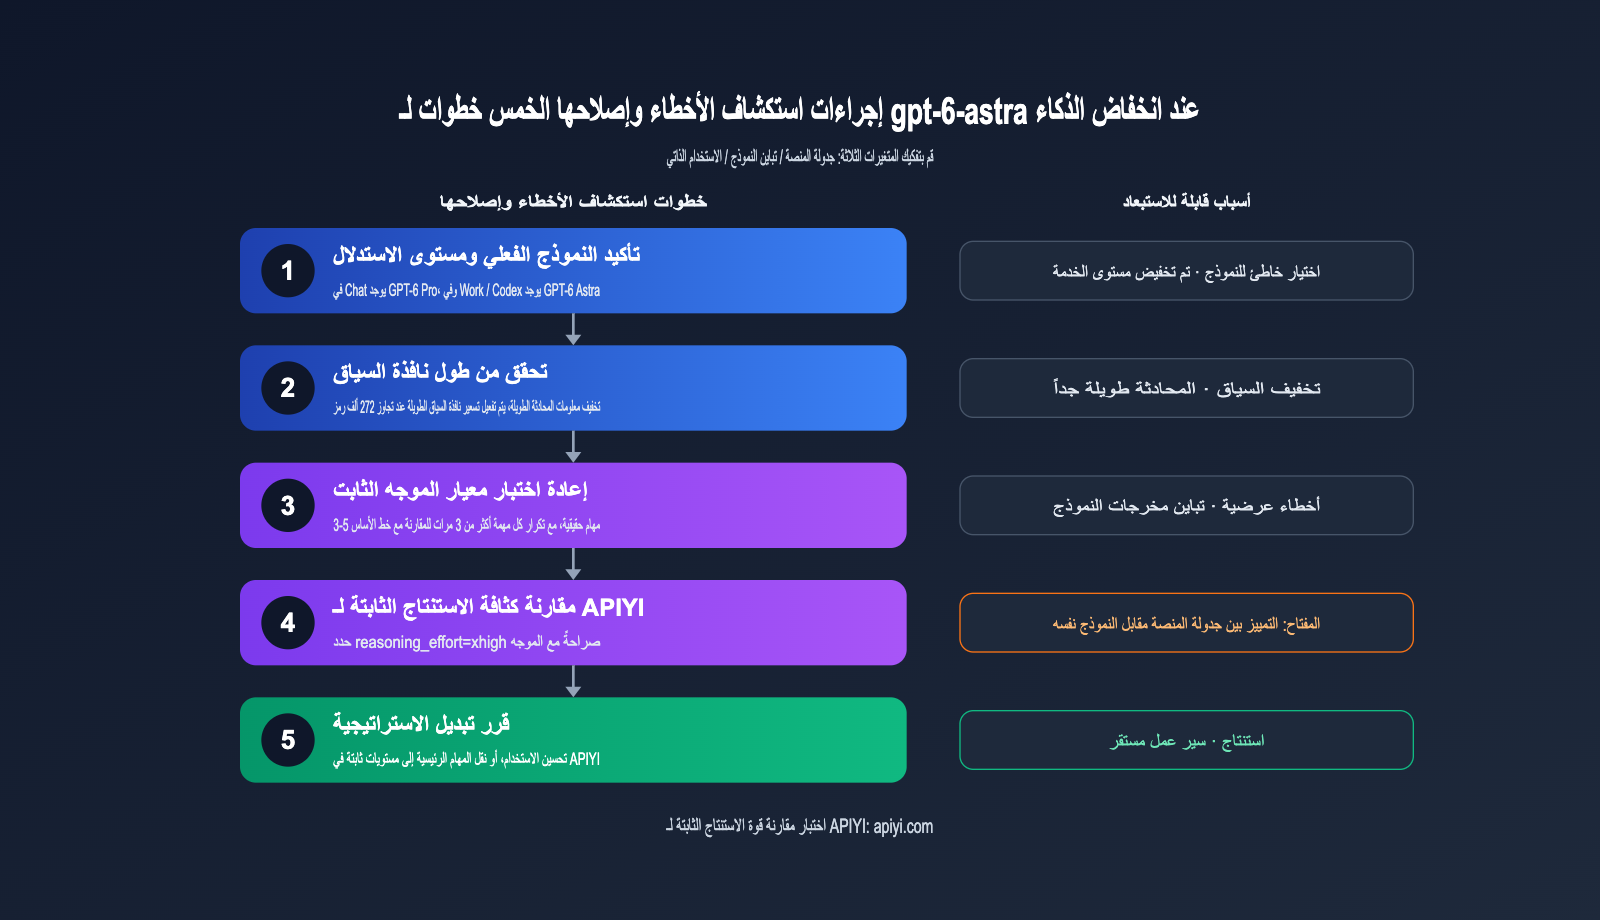
- التحقق من النموذج الفعلي ومستوى الأداء: في ChatGPT، يظهر Astra في الدردشة باسم GPT-6 Pro، بينما في Work وCodex يظهر باسم GPT-6 Astra، ولكل منهما نظام حصص مختلف. تأكد أولاً من النموذج الذي تستخدمه حالياً ومستوى قوة التفكير المختار، وتحقق مما إذا كانت الواجهة تشير إلى تراجع في الأداء بسبب نفاد الحصص.
- فحص ما إذا كانت نافذة السياق طويلة جداً: تبلغ نافذة السياق لـ Astra حوالي 1,050,000 رمز (token)، لكن تخفيف المعلومات المبكرة في المحادثات الطويلة مشكلة شائعة في جميع نماذج اللغة الكبيرة. إذا كانت جلسة Codex مستمرة منذ ساعات، ابدأ جلسة جديدة وقم بتبسيط المواد المرجعية قبل إعادة الاختبار.
- إعادة الاختبار باستخدام موجه ثابت كمرجع: اختر 3-5 مهام حقيقية تعرفها جيداً، واحفظ مخرجات الفترة الأولى كخط أساس، وكرر نفس الموجه أكثر من 3 مرات لترى ما إذا كان الأداء يتراجع بشكل مستقر أم أنها أخطاء عرضية. المقارنة لمرة واحدة لا تحمل دلالة إحصائية.
- استخدام API مع قوة استنتاج ثابتة للمقارنة: حدد
reasoning_effortبشكل صريح عبر API، وقارن المخرجات مع نسخة ChatGPT باستخدام نفس الموجه. إذا كانت نتائجxhighعبر API أفضل بشكل ملحوظ من نسخة الاشتراك، فمن المرجح أن المشكلة تكمن في ميزانية الاستنتاج الخاصة بالمنصة، وليس في النموذج نفسه. - تحديد الاستراتيجية بناءً على النتائج: إذا كانت المشكلة تتعلق بطريقة استخدامك، قم بتحسين الموجه وإدارة الجلسة؛ أما إذا كانت مشكلة في جدولة المنصة أو الحصص، فانقل المهام الحرجة إلى استدعاءات API التي يمكنك التحكم بها.
| الظاهرة | السبب الأكثر احتمالاً | طريقة التحقق | الإجراء المقترح |
|---|---|---|---|
| إجابات أسرع ولكن استنتاج سطحي | خفض ميزانية الاستنتاج الفعلية | المقارنة عبر API باستخدام xhigh |
نقل المهام الحرجة إلى API وتثبيت المستوى |
| أخطاء متكررة في الجلسات الطويلة | تخفيف السياق أو تجاوز نطاق 272K | إعادة الاختبار في جلسة جديدة | تقسيم المهام وتبسيط السياق |
| تباين في أداء نفس المهمة | تباين كبير في مخرجات النموذج | تشغيل نفس الموجه 3-5 مرات | إضافة خطوات تحقق أو أخذ عينات متعددة |
| تنبيه مفاجئ بنفاد الاستخدام | بلوغ حد الاستخدام لـ 5 ساعات أو الأسبوعي | التحقق من لوحة الاستخدام | انتظار إعادة التعيين أو استخدام API كبديل |
| تراجع ملحوظ في جودة الكود | تبديل مستوى الأداء أو انحراف الموجه | المقارنة مع خط أساس الفترة الأولى | تثبيت موجه النظام ومستوى الأداء |
🎯 نصيحة للاستكشاف: الخطوة الرابعة هي المفتاح للتمييز بين "مشاكل المنصة" و"مشاكل النموذج". ننصح باستخدام APIYI (apiyi.com) لتشغيل مستويي
highوxhighبنفس الموجه؛ حيث توفر المنصة وصولاً مباشراً للنموذج الأصلي، وتتوافق معلمات الاستدعاء مع واجهة OpenAI الرسمية، مما يجعل نتائج المقارنة أكثر دقة ومصداقية.
ماذا تفعل إذا نفدت حصة استخدام gpt-6-astra؟
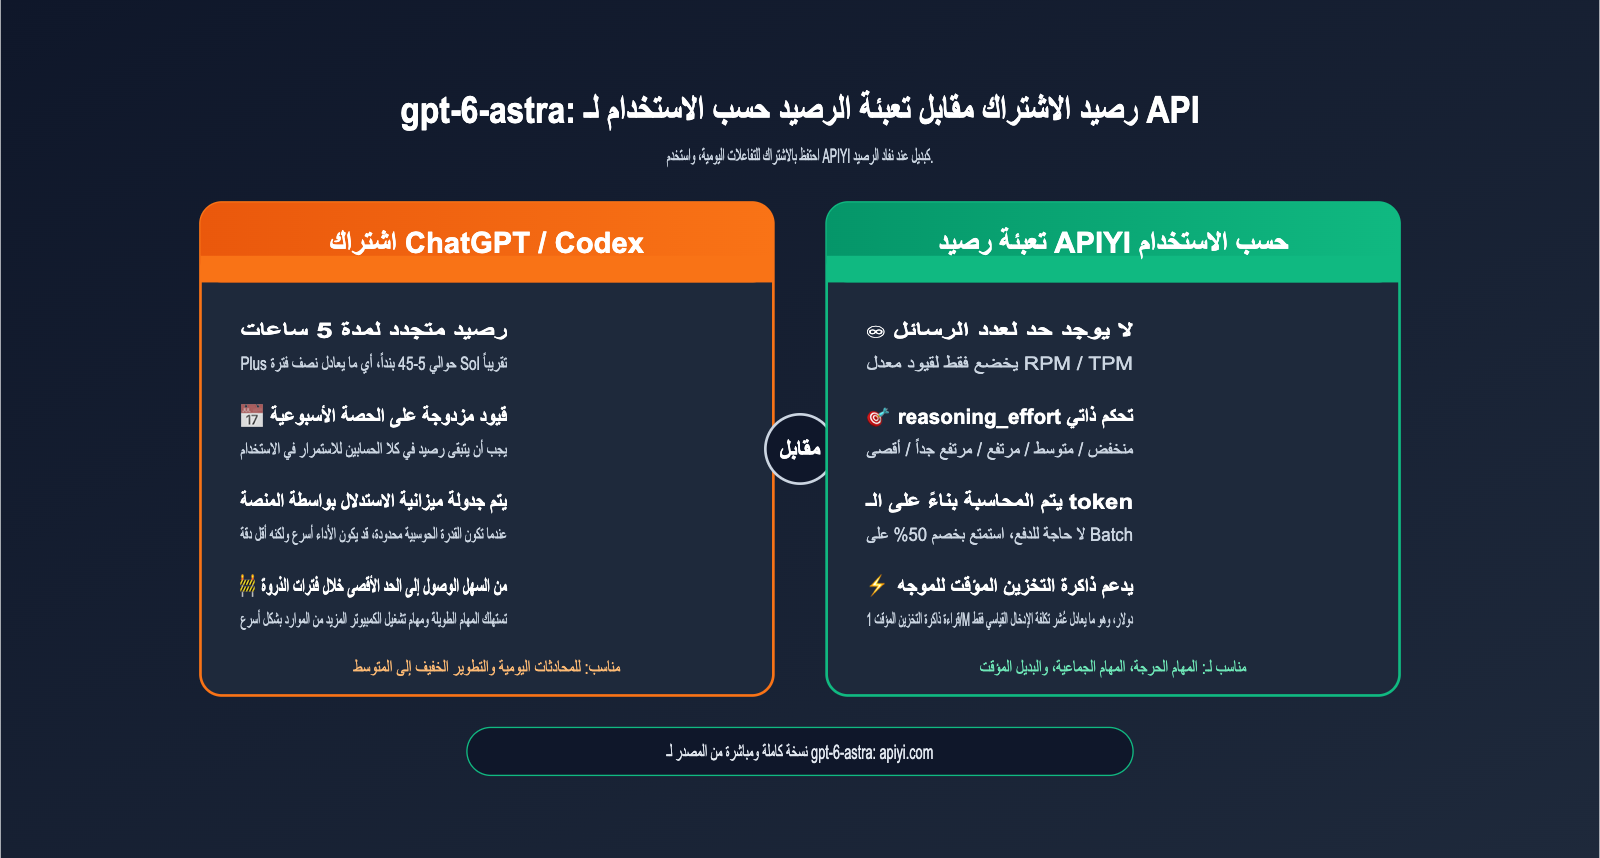
حتى لو لم يكن النموذج يعاني من تراجع في الأداء، فإن مشكلة نفاد الحصة كافية لتعطيل سير عملك. وفقاً للمعلومات المجمعة من وسائل الإعلام والمجتمعات التقنية، يطبق Astra في ChatGPT Work وCodex قيوداً مزدوجة تتمثل في "حصة متجددة كل 5 ساعات + حصة أسبوعية"، ويجب أن تتوفر حصة في كليهما لمواصلة الاستخدام. بالإضافة إلى ذلك، تشير تقارير إلى أنه بعد إعادة تعيين الحصة لجميع المستخدمين في 5 سبتمبر، تم تشديد الحدود لبعض المستخدمين ذوي الاستخدام المكثف. يوضح الجدول أدناه تقديرات جمعها المجتمع، مع العلم أن المرجع الأساسي هو لوحة استخدام OpenAI الرسمية.
| خطة الاشتراك | حصة Astra التقديرية في Work/Codex | GPT-6 Pro في Chat | الفئة المستهدفة |
|---|---|---|---|
| Plus | حوالي 5-45 رسالة / 5 ساعات | غير متوفر | تجربة خفيفة، مهام معقدة متقطعة |
| Pro $100 | حوالي 25-225 رسالة / 5 ساعات | حوالي 50 رسالة / أسبوع | المطورون المحترفون |
| Pro $200 | حوالي 100-900 رسالة / 5 ساعات | حوالي 200 رسالة / أسبوع | الاستخدام المكثف طوال اليوم |
| API حسب الاستخدام | لا يوجد حد لعدد الرسائل، مقيد بـ RPM/TPM | غير قابل للتطبيق | المهام الجماعية، المهام الحرجة، الطوارئ |
يعود التباين الكبير في هذه الأرقام إلى أن استهلاك الحصة لكل رسالة يعتمد على تعقيد المهمة، ومستوى الاستدلال، وطول نافذة السياق؛ فالمهمة التي تتطلب تشغيل الحاسوب لمدة 40 دقيقة تستهلك موارد تختلف تماماً عن سؤال وجواب بسيط. بالنسبة لمعظم المطورين، ليس من المجدي ترقية الاشتراك إلى خطة 200 دولار لمجرد ذروة استخدام عارضة، والنهج الأكثر اقتصاداً هو الاحتفاظ بالاشتراك الحالي واستخدام API لتغطية العجز عند نفاد الحصة.
ثلاث مزايا لاستخدام API كبديل لـ gpt-6-astra
إن استخدام API كبديل مؤقت لا يعني فقط الحصول على "حصة إضافية"، بل الأهم من ذلك هو استعادة السيطرة. أولاً، يمكنك تحديد قوة الاستدلال بنفسك، ولن يتم تعديلها بصمت من قبل المنصة، مما يواجه حالة عدم اليقين المتعلقة بـ "تراجع الأداء". ثانياً، يتم محاسبة API بناءً على عدد الرموز (tokens)، لذا لا تدفع شيئاً عندما لا تستخدمه، وهو أمر مثالي للاحتياجات المتقطعة مثل ذروة الاستخدام. ثالثاً، يدعم API تقنيات تحسين التكلفة مثل Batch والتخزين المؤقت للموجهات، مما يجعل التكاليف قابلة للتحكم على المدى الطويل.
عند اختيار القناة، المفتاح هو التأكد مما إذا كانت توفر وصولاً مباشراً رسمياً. قد تستخدم بعض القنوات الخارجية واجهات برمجية عكسية أو توجه الطلبات إلى نماذج أخرى، مما يجعل مشكلة "تراجع الأداء" أسوأ. يوفر APIYI (apiyi.com) نسخة كاملة من gpt-6-astra، مع وصول مباشر رسمي عبر خطي OpenAI وAzure، ومعلمات واجهة مطابقة تماماً للنسخة الرسمية، مما يجعله مكملاً مستقراً وموثوقاً بجانب اشتراكك.
دليل البدء السريع لـ API الخاص بـ gpt-6-astra
يدعم gpt-6-astra ثلاث نقاط نهاية (Endpoints) هي: Chat Completions، وResponses، وBatch. كما يدعم إدخال النصوص والصور، بينما يكون المخرج نصياً. يوضح المثال البسيط التالي كيفية استخدام حزمة SDK الرسمية لـ OpenAI، حيث يكفي استبدال base_url ومفتاح API للبدء.
مثال بسيط لاستدعاء gpt-6-astra
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "أنت مهندس خلفية (Backend) خبير، يجب أن تتضمن إجاباتك كوداً قابلاً للتشغيل."},
        {"role": "user", "content": "قم بتنفيذ ذاكرة تخزين مؤقت من نوع LRU مع وقت انتهاء صلاحية باستخدام لغة Python"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # راقب prompt_tokens_details.cached_tokens
عرض الكود الكامل: تغليف مع مفاتيح التخزين المؤقت، وإعادة المحاولة، وإحصائيات الاستخدام
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# وضع الموجه (System Prompt) الطويل والثابت في البداية لتسهيل مطابقة ذاكرة التخزين المؤقت
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """استدعاء gpt-6-astra مع تثبيت قوة الاستنتاج وإعادة استخدام مفتاح التخزين المؤقت"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"الإدخال {usage.prompt_tokens} | التخزين المؤقت {cached} "
                  f"| معدل الإصابة {hit_rate:.1%} | المخرج {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"تم تجاوز الحد، إعادة المحاولة بعد {wait} ثانية")
            time.sleep(wait)
        except APIError as e:
            print(f"خطأ في الواجهة: {e}")
            time.sleep(1)
    raise RuntimeError("فشلت المحاولة بعد عدة محاولات")


if __name__ == "__main__":
    tasks = [
        "مراجعة استخدام الفهارس في هذا الاستعلام: SELECT ...",
        "تصميم خطة إعادة محاولة متماثلة لخدمة الطلبات",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 نصيحة للبدء: يُفضل في الاستدعاء الأول استخدام مستوى
mediumللتأكد من عمل المسار، ثم رفعه تدريجياً حسب صعوبة المهمة. يمكنك التسجيل في APIYI عبر apiyi.com للحصول على رصيد تجريبي، والتأكد من جودة المخرجات قبل الانتقال للمهام الرسمية.
التبديل إلى API الخاص بـ gpt-6-astra في Codex
إذا كنت تستخدم Astra بشكل أساسي عبر Codex CLI، فلا داعي للتوقف عن العمل عند نفاد الرصيد. يمكنك تكوين مزود نموذج مخصص في ~/.codex/config.toml واستخدام مفتاح API الخاص بك:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
بعد الانتهاء من التكوين، قم بتنفيذ export APIYI_API_KEY=مفتاحك ثم ابدأ تشغيل Codex. عند تجديد رصيد الاشتراك، يمكنك التعليق على model_provider للعودة إلى طريقة تسجيل الدخول الأصلية، حيث يمكنك التبديل بين النمطين حسب الحاجة.
كيفية اختيار قوة الاستنتاج لـ gpt-6-astra
تحدد قوة الاستنتاج مباشرة الجودة، والوقت المستغرق، والتكلفة. يُنصح بتصنيفها حسب نوع المهمة بدلاً من رفعها إلى الحد الأقصى دائماً.
| قوة الاستنتاج | السيناريو النموذجي | مستوى الجودة | الوقت والتكلفة |
|---|---|---|---|
| low | تحويل التنسيق، أسئلة بسيطة، استخراج معلومات | تلبي الاحتياجات الأساسية | الأدنى |
| medium | إكمال الكود اليومي، كتابة الوثائق | متوازن | منخفضة |
| high | إعادة الهيكلة المعقدة، التصميم المعماري، تحليل البيانات | مستقرة وموثوقة | متوسطة |
| xhigh | تحديد الأخطاء البرمجية الصعبة، مهام الوكيل (Agent) الطويلة | قريبة من التجربة الأصلية | مرتفعة |
| max | الإثباتات الرياضية، التدقيق الأمني، القرارات عالية القيمة | الحد الأقصى للجودة | الأعلى، يجب التحكم في وتيرة الاستدعاء |
🎯 نصيحة اختيار: إذا كنت تشك في "انخفاض ذكاء" النموذج في اشتراكك، يمكنك تثبيت المهام الحساسة على مستوى
xhigh. عند الاستدعاء عبر APIYI (apiyi.com)، يتم تحديد قوة الاستنتاج بالكامل بواسطة معلمات الطلب، مما يسهل التحكم في تقلبات الجودة ضمن نطاق مفهوم.
التحكم في التكلفة وتحسين معدل إصابة التخزين المؤقت لـ gpt-6-astra
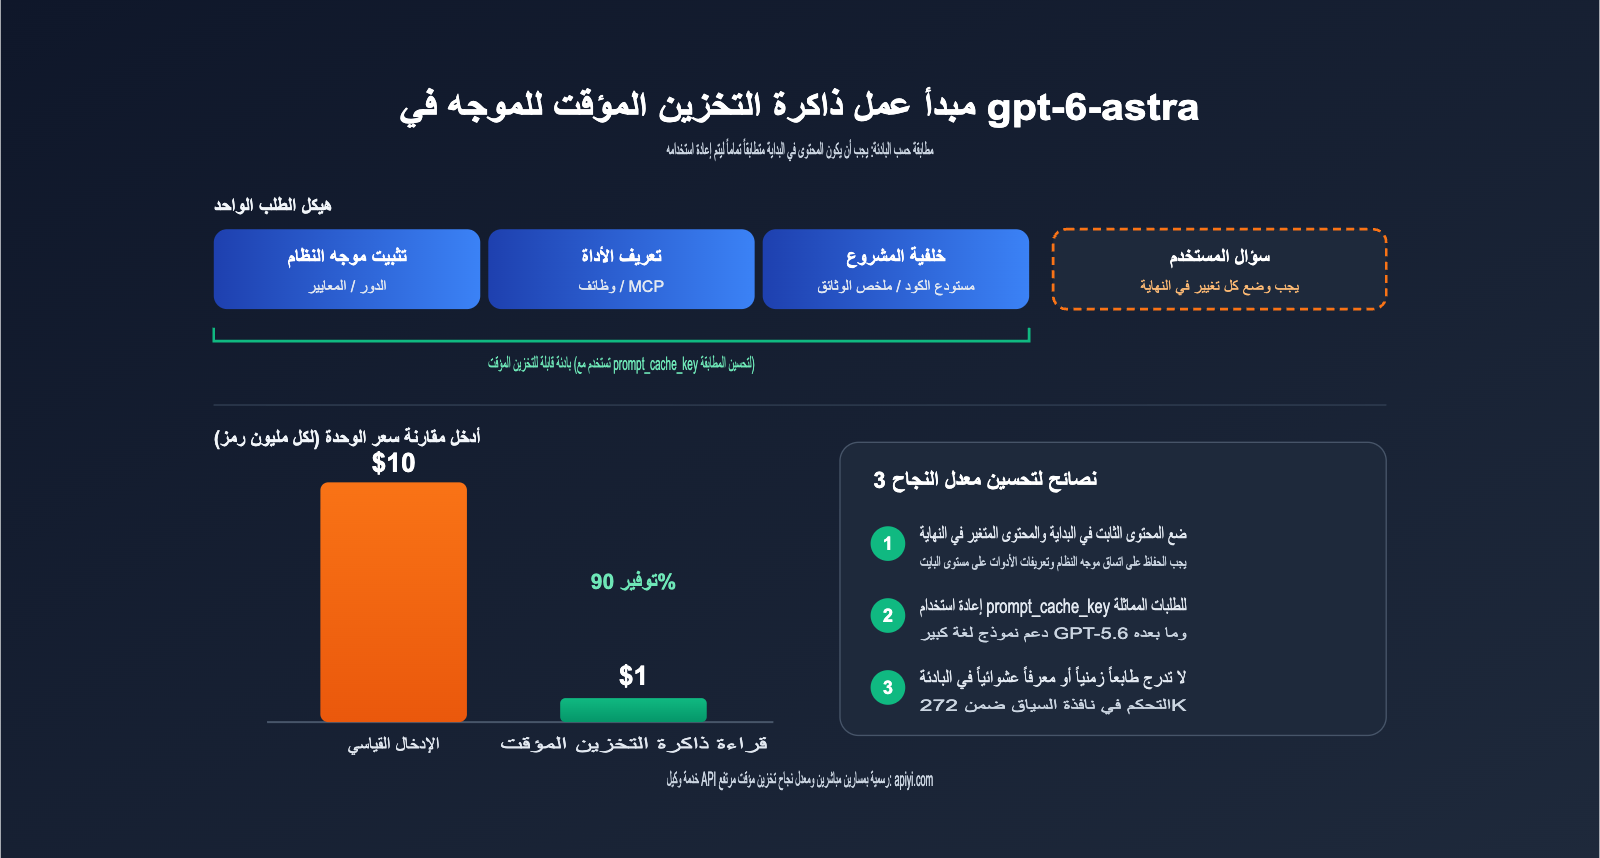
السعر الرسمي لـ gpt-6-astra هو 10 دولارات للإدخال و50 دولاراً للمخرج (لكل مليون رمز)، وهو عدة أضعاف سعر إطلاق GPT-5.6 Sol، لذا يجب مراعاة التحكم في التكلفة عند استخدام API كبديل. الخبر السار هو أن سعر إدخال التخزين المؤقت لـ Astra هو دولار واحد فقط، أي عُشر سعر الإدخال القياسي، مما يجعل معدل إصابة التخزين المؤقت عاملاً حاسماً في الفاتورة.
| عنصر التكلفة | السعر الرسمي (لكل مليون رمز) | ملاحظات |
|---|---|---|
| إدخال قياسي | 10$ | ينطبق عندما لا يتجاوز الإدخال 272 ألف رمز |
| قراءة التخزين المؤقت | 1$ | الجزء المطابق للموجه المخزن مؤقتاً، يوفر 90% |
| كتابة التخزين المؤقت | 12.5$ | البادئة المكتوبة حديثاً، أعلى قليلاً من الإدخال القياسي |
| مخرج قياسي | 50$ | يتضمن رموز الاستنتاج |
| سياق طويل | ضعف سعر الإدخال والتخزين، 1.5 ضعف للمخرج | يتم تفعيله عند تجاوز 272 ألف رمز |
| Batch / Flex | 50% من السعر القياسي | مناسب للمهام التي لا تتطلب استجابة فورية |
4 نصائح لتحسين معدل إصابة التخزين المؤقت لـ gpt-6-astra
يعتمد التخزين المؤقت للموجه على مطابقة "البادئة"، طالما أن محتوى بداية الطلب متطابق تماماً، يمكن إعادة استخدام نتائج الحساب السابقة. بناءً على هذه الآلية، يمكنك التحسين من الجوانب التالية:
- وضع المحتوى الثابت في البداية: ضع الموجهات (System Prompts)، وتعريفات الأدوات، ومعايير المشروع، وغيرها من المحتويات غير المتغيرة في مقدمة الرسالة، بينما ضع أسئلة المستخدم والطوابع الزمنية وغيرها من المحتويات المتغيرة في النهاية.
- استخدام prompt_cache_key: تدعم النماذج من GPT-5.6 فما فوق هذه المعلمة، حيث يؤدي استخدام نفس مفتاح التخزين المؤقت للطلبات التي تشترك في بادئة طويلة إلى تحسين احتمالية المطابقة بشكل ملحوظ.
- تجنب إدراج قيم ديناميكية في البادئة: كتابة الوقت الحالي أو معرف عشوائي في الموجه سيجعل البادئة مختلفة في كل طلب، مما يؤدي إلى فشل التخزين المؤقت مباشرة.
- التحكم في السياق ضمن 272 ألف رمز: تجاوز هذا الحد سيؤدي إلى تفعيل تسعير السياق الطويل، كما سيتضاعف سعر قراءة التخزين المؤقت، لذا يُنصح بإجراء استرجاع للمستندات الطويلة قبل إرسالها إلى النموذج.
يرتبط معدل إصابة التخزين المؤقت أيضاً باستقرار المسار الأساسي؛ فإذا كانت الطلبات تنتقل بشكل متكرر بين خلفيات مختلفة، فمن الصعب الحفاظ على استمرارية التخزين المؤقت. تعتمد APIYI (apiyi.com) مسارات مباشرة من OpenAI وAzure، وقامت بتحسين التوجيه لـ gpt-6-astra ليكون صديقاً للتخزين المؤقت، مما يتيح لك الحصول على معدل إصابة مرتفع في سيناريوهات البادئة الثابتة، ويمكنك التحقق من النتائج مباشرة عبر حقل cached_tokens في الاستجابة.
الأسئلة الشائعة حول انخفاض ذكاء gpt-6-astra والتعويض عنه
س1: هل تعرض نموذج gpt-6-astra حقاً لـ “انخفاض في الذكاء” من قبل OpenAI؟
لا يوجد حالياً دليل رسمي يثبت استبدال أوزان النموذج، كما لم تصدر OpenAI أي بيان رسمي بهذا الشأن. التفسير الأكثر ترجيحاً هو وجود تغييرات في جدولة ميزانية الاستدلال لمشتركي الخدمة، بالإضافة إلى التباين الطبيعي في مخرجات النموذج نفسه. ننصح باستخدام طريقة الفحص المكونة من 5 خطوات المذكورة في هذا المقال، وإجراء مقارنة باستخدام مستويات ثابتة عبر API قبل اتخاذ أي استنتاج.
س2: هل نموذج gpt-6-astra الذي يتم استدعاؤه عبر API هو نفسه المستخدم في ChatGPT؟
نعم، هو نفس النموذج، والفرق يكمن في أن API يسمح لك بتحديد قوة الاستدلال بشكل صريح، بينما يتم تحديد ميزانية الاستدلال في اشتراكات المنتجات بواسطة المنصة. توفر APIYI (apiyi.com) نسخة كاملة ومباشرة من gpt-6-astra، حيث يتم تنفيذ قوة الاستدلال تماماً وفقاً للمعايير التي تحددها أنت.
س3: هل يمكن استخدام رصيد الاشتراك و API في وقت واحد؟
نعم، كلاهما مستقل عن الآخر. النهج الموصى به هو الاستمرار في استخدام رصيد الاشتراك للتفاعلات اليومية، والتحويل إلى API عند نفاد الرصيد أو عند الحاجة إلى معالجة كميات كبيرة من البيانات، حيث يمكنك التبديل بسرعة عبر ملفات الإعدادات في Codex.
س4: هل سيكون استخدام API للتعويض مكلفاً؟
يعتمد ذلك على طريقة الاستخدام. التحكم في مستويات الاستدلال، وزيادة معدل نجاح التخزين المؤقت (Cache)، ووضع المهام غير الفورية في دفعات (Batch)، يمكن أن يقلل التكاليف بأكثر من النصف. نوصي بتجربة مهام حقيقية بسيطة عبر APIYI (apiyi.com) لحساب التكلفة لكل عملية قبل تحديد حجم التعويض المطلوب.
س5: كيف يمكن الجمع بين gpt-6-astra و GPT-5.6 Sol؟
يتميز Sol بسعر أقل بكثير، مما يجعله مناسباً للبرمجة الروتينية والمهام الجماعية؛ بينما يتفوق Astra في عمليات الحاسوب، والاستدلال المعقد، ومهام الوكيل (Agent) ذات السلاسل الطويلة. يمكنك جعل Sol النموذج الافتراضي، والترقية إلى Astra فقط في المهام الصعبة، مما يضمن الجودة ويتحكم في التكاليف في آن واحد.
الخلاصة: تحويل عدم اليقين في gpt-6-astra إلى متغيرات قابلة للتحكم
يعد gpt-6-astra أقوى نموذج رائد لدى OpenAI حالياً، لكن الجدل حول "انخفاض الذكاء" وتشديد القيود في البداية كشف عن سمة جوهرية لخدمات الاشتراك: ميزانية الاستدلال وحدود الاستخدام يحددها النظام الأساسي، ولا يملك المستخدم سوى القبول. بدلاً من التخمين المستمر حول ما إذا كان النموذج قد أصبح أقل ذكاءً، من الأفضل بناء معيار الجودة الخاص بك باستخدام موجهات ثابتة ومستويات استدلال محددة.
من الناحية العملية، يمكنك اتباع ثلاث خطوات: أولاً، استخدم طريقة الفحص المكونة من 5 خطوات للتمييز بين جدولة المنصة، وتباين النموذج، وطريقة استخدامك الشخصية؛ ثانياً، استخدم API للتعويض عند نفاد الرصيد، مع تثبيت المهام الحرجة على مستويات high أو xhigh؛ أخيراً، قلل التكاليف عبر استخدام البادئات الثابتة، و prompt_cache_key، ونظام الدفعات (Batch). بهذه الطريقة، سيظل سير عملك الأساسي مستقراً بغض النظر عن التغييرات في جانب الاشتراك.
إذا كنت بحاجة إلى قناة تعويض مستقرة، نوصي باستدعاء النسخة الكاملة من gpt-6-astra عبر APIYI (apiyi.com). توفر المنصة وصولاً مباشراً ورسمياً إلى OpenAI و Azure، وتتوافق الواجهات تماماً مع النسخ الرسمية، مع معدل نجاح عالٍ في التخزين المؤقت، مما يجعلها إضافة موثوقة بجانب اشتراكات ChatGPT و Codex.
مراجع:
- وثائق نماذج OpenAI (gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- مركز مساعدة OpenAI حول استخدام Astra: help.openai.com
- تقرير Decrypt حول جدل انخفاض ذكاء Astra: decrypt.co
- وثائق التخزين المؤقت للموجهات من Microsoft Foundry: learn.microsoft.com
- وثائق نماذج APIYI: docs.apiyi.com
نبذة عن الكاتب: فريق APIYI التقني، متخصص في دمج واجهات برمجة تطبيقات نماذج اللغة الكبيرة (LLM) والممارسات الهندسية. نرحب بالتواصل عبر APIYI (apiyi.com) لتبادل الخبرات حول تحسين استدعاء gpt-6-astra والتحكم في التكاليف.