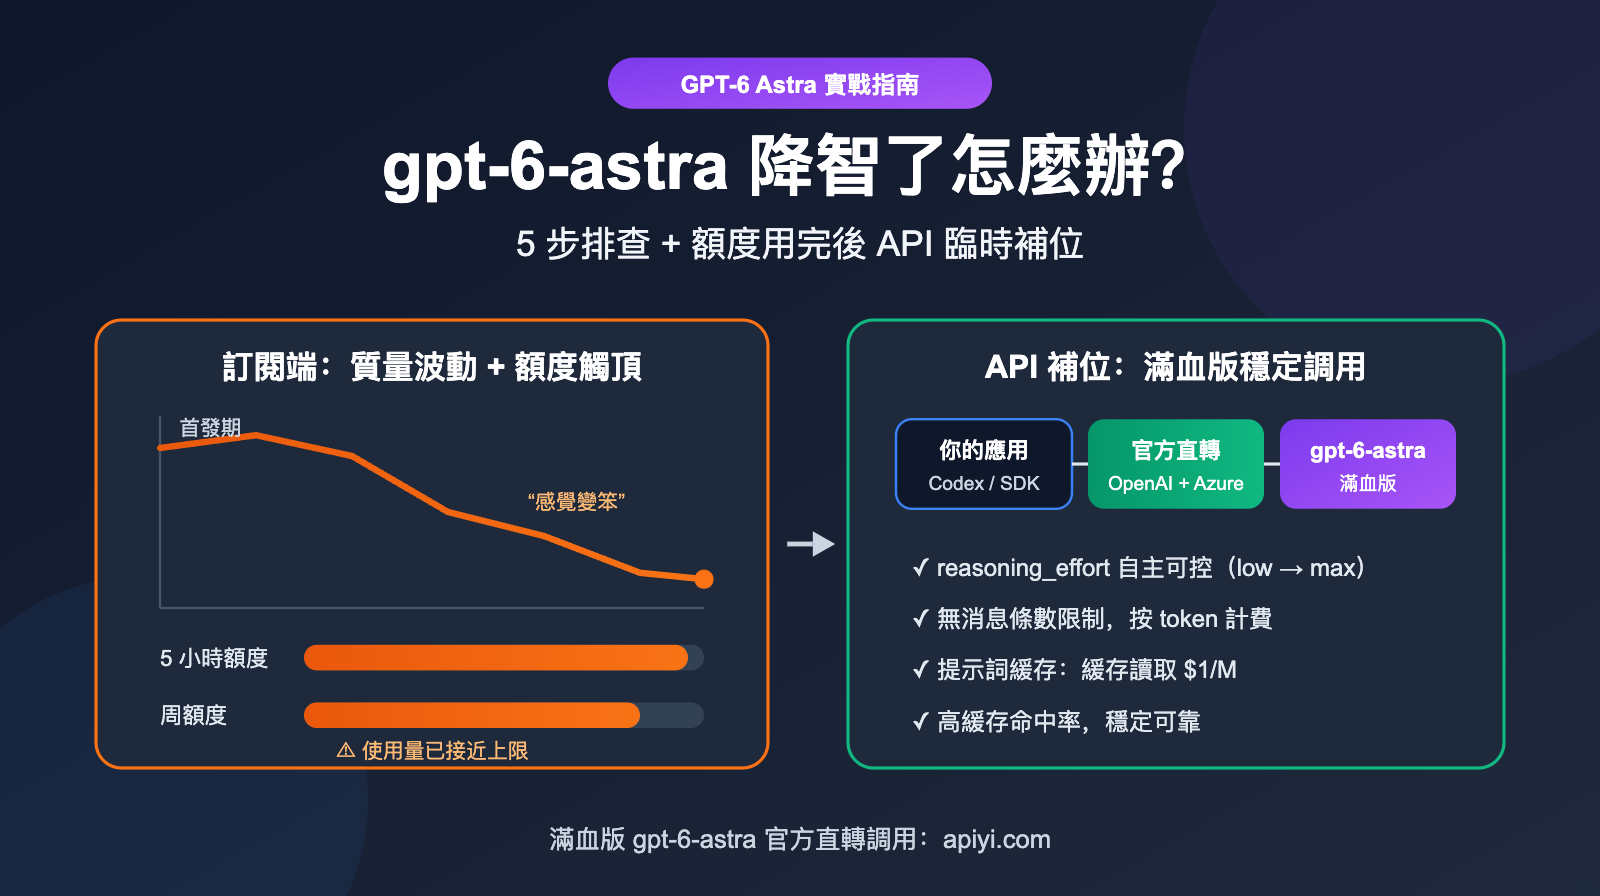
gpt-6-astra 於 2026 年 9 月 3 日發佈、次日全量開放,上線僅一週,社交媒體上就出現了大量“gpt-6-astra 降智了”的吐槽:同樣的提示詞,輸出質量不如首發那幾天;Extra high 推理檔位跑得更快了,結果卻更粗糙。與此同時,ChatGPT 和 Codex 的 Astra 額度比上一代 GPT-5.6 Sol 明顯收緊,很多開發者幹到一半就被限額卡住。本文將介紹 判斷 gpt-6-astra 是否真的降智的 5 步排查法,以及額度用完後用官方直轉 API 臨時補位的方案,幫你把工作流穩定下來。
核心價值:讀完本文,你將能區分“真降智”和“感知偏差”,知道訂閱額度的真實邊界,並學會用可控的推理強度和緩存策略,以合理成本調用滿血版 gpt-6-astra。
gpt-6-astra 降智爭議核心要點
在動手排查之前,先把目前已知的事實擺清楚。根據 Decrypt 等海外媒體的整理,Astra 發佈一週後開始出現集中投訴,部分開發者(包括 opencode 團隊)因爲成本翻倍、質量不及預期而切回了 GPT-5.6 Sol。但截至發稿,OpenAI 尚未就 Astra 發佈正式說明,也有不少資深用戶認爲模型本身沒有變化,只是“蜜月期”過後大家開始注意到它的失誤。
| 要點 | 已知事實 | 對你的意義 |
|---|---|---|
| 發佈時間 | 2026-09-03 向獲批用戶開放,09-04 全面可用 | 模型仍處於上線初期,服務端策略可能頻繁調整 |
| 降智投訴 | 用戶反饋同提示詞輸出變差、高推理檔位耗時縮短 | 需要用可復現的方式驗證,不能只憑感覺 |
| 官方回應 | 暫無針對 Astra 的正式聲明 | 無法確認是否調整過默認推理強度 |
| 歷史先例 | 2026 年 7 月 Sol 也遭遇同類質疑,OpenAI 否認刻意削弱,但承認會實驗“推理強度”設置 | ChatGPT 端的推理預算並非由你完全掌控 |
| 額度收緊 | Plus 在 Work/Codex 中約 5-45 條/5 小時,約爲 Sol 時期的一半 | 重度用戶很容易在高峯期觸頂 |
gpt-6-astra 爲什麼會“感覺變笨”
模型權重被偷偷替換的可能性其實很低,更常見的原因出在“推理預算”上。gpt-6-astra 在 API 中支持 low、medium、high、xhigh、max 五檔推理強度,檔位越高,模型在作答前的思考步驟越多,質量和耗時同步上升。在 ChatGPT 和 Codex 這類訂閱產品裏,推理預算由平臺統一調度,一旦平臺爲了應對算力壓力而下調實際預算,用戶看到的就是“更快但更粗糙”的結果,這與投訴內容高度吻合。
另一方面,Theo 等開發者指出,Astra 本身的輸出方差就比較大,同一個任務既可能給出驚豔的結果,也可能犯低級錯誤。首發時大家容易記住驚豔的案例,用久了之後失敗案例被放大,這種心理落差同樣會被解讀爲“降智”。所以排查的關鍵,是把“平臺調度”“模型方差”“自身用法”三個變量拆開來看。
gpt-6-astra 降智 5 步排查法
下面這套流程適合在你懷疑 gpt-6-astra 降智時按順序執行,每一步都能排除一類原因,避免盲目切換模型。
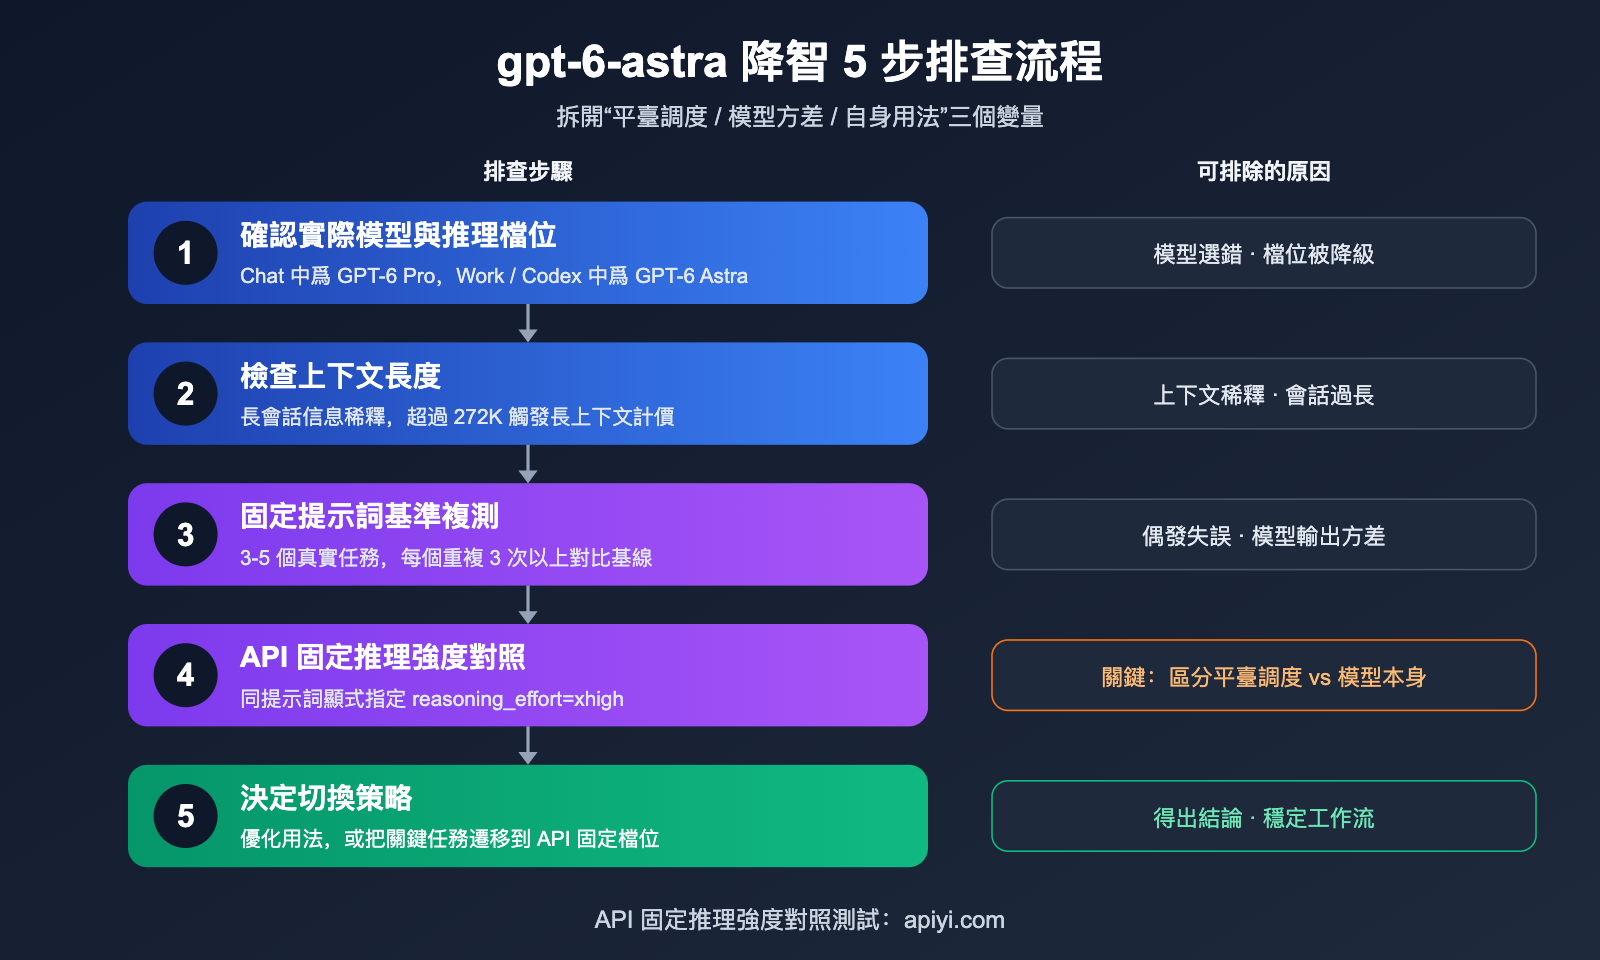
- 確認實際使用的模型和檔位:在 ChatGPT 中,Astra 在 Chat 裏以 GPT-6 Pro 的名稱出現,在 Work 與 Codex 中則是 GPT-6 Astra,兩者配額體系不同。先確認你當前對話到底跑的是哪個模型、選的是哪一檔思考強度,額度緊張時界面是否已經提示降級。
- 檢查上下文是否過長:Astra 的上下文窗口爲 1,050,000 tokens,但長會話裏早期信息被稀釋是所有大模型的通病。如果一個 Codex 會話已經持續了幾個小時,先開新會話、精簡背景材料再測。
- 用固定提示詞做基準複測:挑 3-5 個你熟悉的真實任務,保存首發期的輸出作爲基線,同一提示詞重複跑 3 次以上,看是穩定變差還是偶發失誤。單次對比幾乎沒有統計意義。
- 用 API 固定推理強度做對照:通過 API 顯式指定
reasoning_effort,在相同提示詞下對比 ChatGPT 端的輸出。如果 API 的xhigh結果明顯優於訂閱端,問題大概率出在平臺側的推理預算,而非模型本身。 - 根據結論決定策略:屬於自身用法問題就優化提示詞和會話管理;屬於平臺調度或額度問題,就把關鍵任務遷移到可控的 API 調用上。
| 現象 | 最可能原因 | 驗證方法 | 建議動作 |
|---|---|---|---|
| 回答變快但推理變淺 | 實際推理預算被下調 | API 指定 xhigh 對照 |
關鍵任務改走 API 並固定檔位 |
| 長會話後期頻繁出錯 | 上下文稀釋或超過 272K 區間 | 新開會話複測 | 拆分任務、精簡上下文 |
| 同一任務時好時壞 | 模型輸出方差較大 | 同提示詞跑 3-5 次 | 增加校驗步驟或多次採樣 |
| 突然提示用量不足 | 5 小時或周額度觸頂 | 查看用量面板 | 等待重置或切換 API 補位 |
| 代碼質量明顯回退 | 檔位被切換或提示詞漂移 | 對比首發期基線 | 固化系統提示詞與檔位 |
🎯 排查建議:第 4 步是區分“平臺問題”與“模型問題”的關鍵。我們建議通過 API易 apiyi.com 用同一套提示詞分別跑
high和xhigh兩檔,該平臺以純官方直轉方式提供 gpt-6-astra,調用參數與 OpenAI 原生接口一致,對照結果更有說服力。
gpt-6-astra 額度用完了怎麼辦
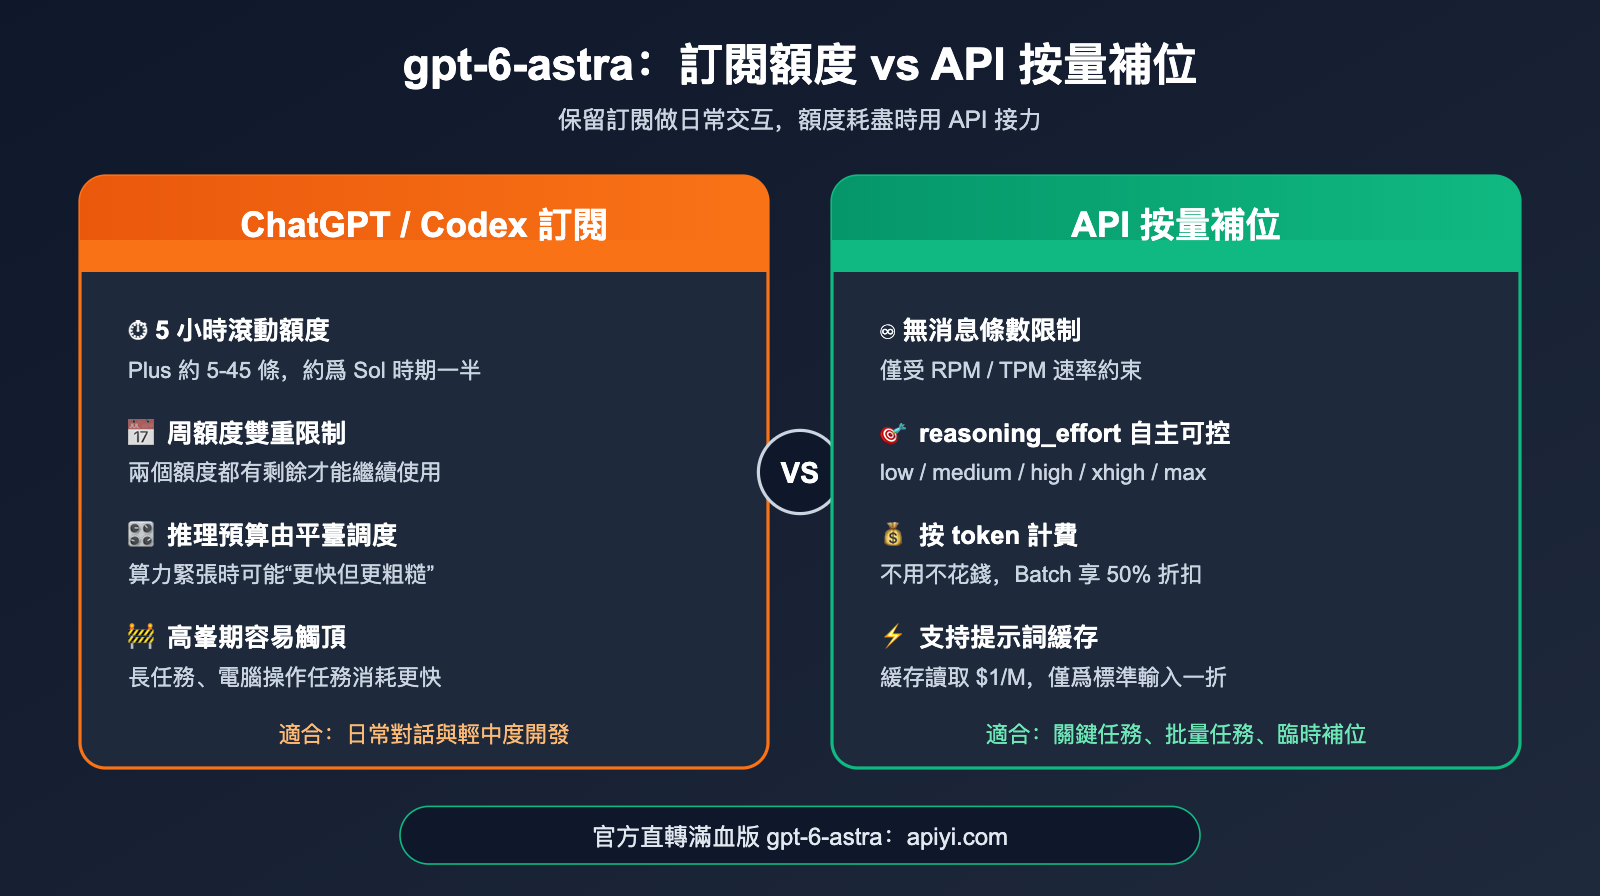
即便模型沒有降智,額度問題也足以打斷工作節奏。根據海外媒體和社區彙總的信息,Astra 在 ChatGPT Work 與 Codex 中採用“5 小時滾動額度 + 周額度”的雙重限制,兩者都有剩餘才能繼續使用;此外有報道稱在 9 月 5 日全員額度重置後,部分重度用戶的上限被進一步收緊。下表爲社區整理的估算值,實際以 OpenAI 官方用量面板爲準。
| 訂閱方案 | Work/Codex 中 Astra 估算額度 | Chat 中 GPT-6 Pro | 適合人羣 |
|---|---|---|---|
| Plus | 約 5-45 條 / 5 小時 | 不提供 | 輕度體驗、偶爾處理複雜任務 |
| Pro $100 | 約 25-225 條 / 5 小時 | 約 50 條 / 周 | 日常開發主力 |
| Pro $200 | 約 100-900 條 / 5 小時 | 約 200 條 / 周 | 全天候重度使用 |
| API 按量計費 | 無消息條數限制,受 RPM/TPM 約束 | 不適用 | 批量任務、關鍵任務、臨時補位 |
區間跨度之所以這麼大,是因爲一條消息消耗的額度取決於任務複雜度、推理檔位和上下文長度,一次跑滿 40 分鐘的電腦操作任務,和一次簡單問答的消耗完全不是一個量級。對於大多數開發者來說,爲了偶爾的額度高峯去升級到 $200 方案並不划算,更經濟的做法是保留現有訂閱,在額度耗盡時用 API 按量補位。
gpt-6-astra API 補位的三個優勢
用 API 臨時補位,不只是“多了一份額度”,更重要的是換回了控制權。首先,推理強度由你顯式指定,不會被平臺靜默調整,這正好對沖了“降智”的不確定性。其次,API 按 token 計費,不用的時候不花錢,適合額度高峯這種間歇性需求。第三,API 支持 Batch、提示詞緩存等成本優化手段,長期跑下來成本可控。
選擇渠道時,關鍵看是否爲官方直轉。部分第三方渠道可能使用逆向接口或將請求路由到其他模型,這會讓“降智”問題雪上加霜。API易 apiyi.com 提供的 gpt-6-astra 爲滿血版,純官方直轉 OpenAI 與 Azure 雙線路,接口參數與官方完全一致,適合作爲訂閱之外的穩定補充。
gpt-6-astra API 快速上手
gpt-6-astra 支持 Chat Completions、Responses 和 Batch 三個端點,輸入支持文本與圖像,輸出爲文本。下面的極簡示例使用 OpenAI 官方 SDK,只需替換 base_url 和密鑰即可運行。
gpt-6-astra 極簡調用示例
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "你是一名資深後端工程師,回答需給出可運行代碼。"},
        {"role": "user", "content": "用 Python 實現一個帶過期時間的 LRU 緩存"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # 關注 prompt_tokens_details.cached_tokens
查看完整代碼:帶緩存鍵、重試與用量統計的封裝
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 固定的長系統提示詞放在最前面,便於命中提示詞緩存
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """調用 gpt-6-astra,固定推理強度並複用緩存鍵"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"輸入 {usage.prompt_tokens} | 緩存 {cached} "
                  f"| 命中率 {hit_rate:.1%} | 輸出 {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"觸發限流,{wait} 秒後重試")
            time.sleep(wait)
        except APIError as e:
            print(f"接口錯誤:{e}")
            time.sleep(1)
    raise RuntimeError("多次重試仍失敗")


if __name__ == "__main__":
    tasks = [
        "審查這段 SQL 的索引使用情況:SELECT ...",
        "爲訂單服務設計冪等重試方案",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 上手建議:首次調用建議先用
medium檔位跑通鏈路,再按任務難度逐步上調。可以在 API易 apiyi.com 註冊後獲取測試額度,確認輸出質量符合預期後再遷移正式任務。
在 Codex 中切換 gpt-6-astra API 補位
如果你主要在 Codex CLI 中使用 Astra,額度用完後不必中斷工作,可以在 ~/.codex/config.toml 中配置自定義模型提供方,改用 API 密鑰繼續幹活:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
配置完成後執行 export APIYI_API_KEY=你的密鑰 再啓動 Codex 即可。訂閱額度重置後,把 model_provider 註釋掉就能切回原來的登錄方式,兩種模式可以按需來回切換。
gpt-6-astra 推理強度怎麼選
推理強度直接決定質量、耗時與成本,建議按任務類型分檔,而不是一律拉滿。
| 推理強度 | 典型場景 | 質量表現 | 耗時與成本 |
|---|---|---|---|
| low | 格式轉換、簡單問答、信息抽取 | 滿足基礎需求 | 最低 |
| medium | 日常代碼補全、文檔撰寫 | 均衡 | 較低 |
| high | 複雜重構、架構設計、數據分析 | 穩定可靠 | 中等 |
| xhigh | 疑難 Bug 定位、長鏈路 Agent 任務 | 接近首發體驗 | 較高 |
| max | 數學證明、安全審計、高價值決策 | 上限最高 | 最高,需控制調用頻次 |
🎯 選型建議:如果你懷疑訂閱端“降智”,可以把原本在 ChatGPT 裏跑的關鍵任務固定在
xhigh檔位調用。通過 API易 apiyi.com 調用時,推理強度完全由請求參數決定,便於把質量波動控制在可解釋的範圍內。
gpt-6-astra 成本控制與緩存命中率優化
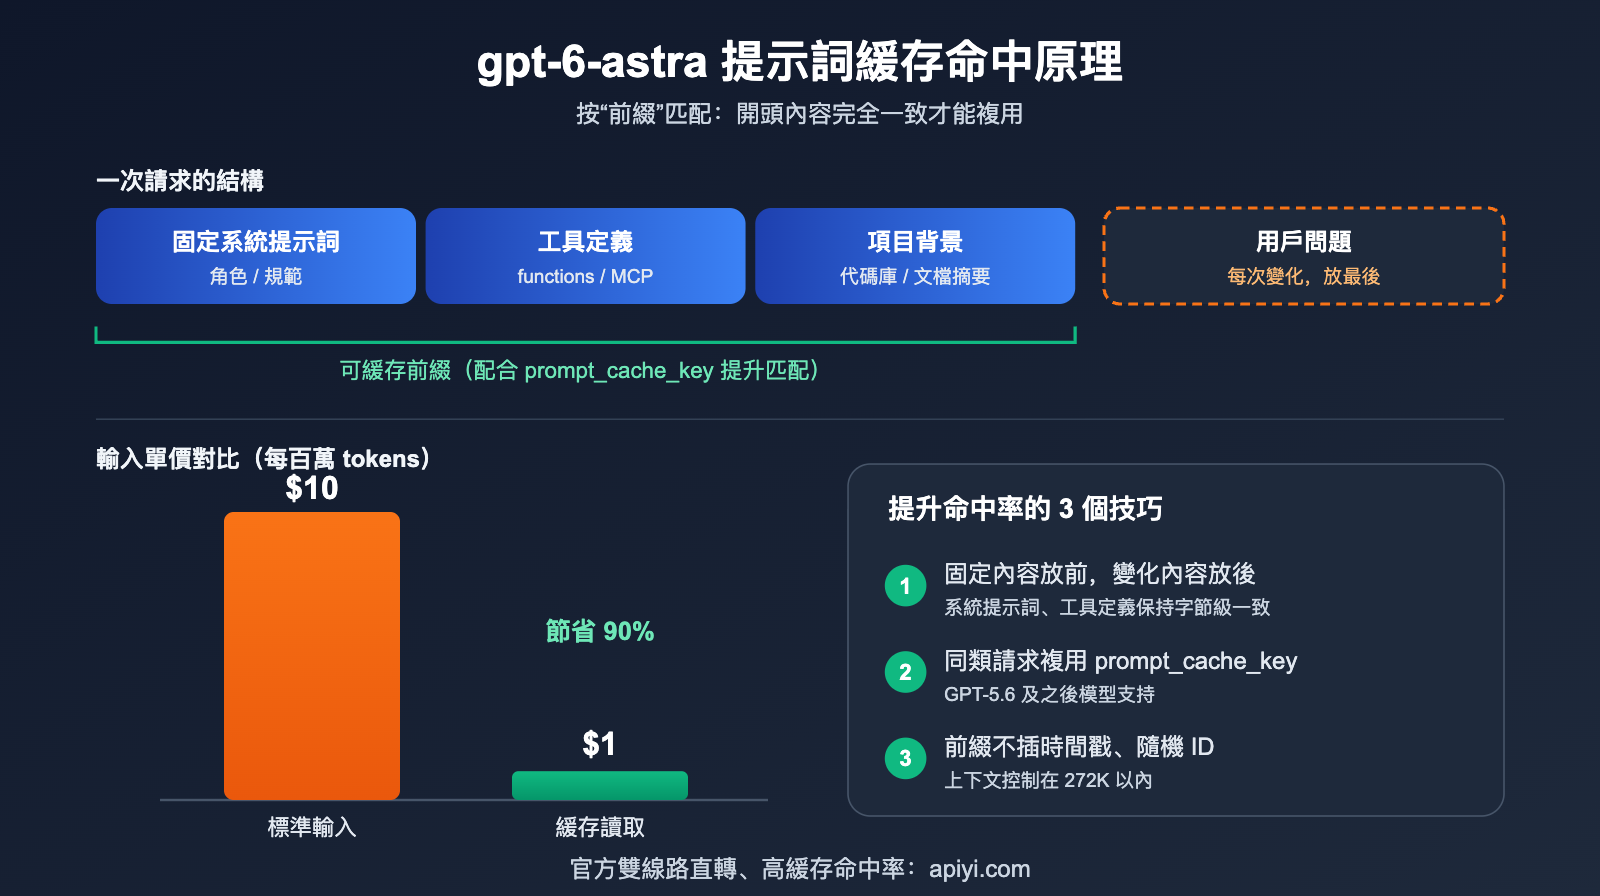
gpt-6-astra 的官方價格爲輸入 $10、輸出 $50(每百萬 tokens),是 GPT-5.6 Sol 首發價格的數倍,因此補位用 API 時成本控制必須前置考慮。好消息是 Astra 的緩存輸入價格只有 $1,相當於標準輸入價的一折,緩存命中率高低會直接拉開賬單差距。
| 計費項 | 官方價格(每百萬 tokens) | 說明 |
|---|---|---|
| 標準輸入 | $10 | 輸入不超過 272K tokens 時適用 |
| 緩存讀取 | $1 | 命中提示詞緩存的部分,節省 90% |
| 緩存寫入 | $12.5 | 新寫入緩存的前綴,略高於標準輸入 |
| 標準輸出 | $50 | 包含推理 tokens |
| 長上下文 | 輸入與緩存 2 倍、輸出 1.5 倍 | 輸入超過 272K tokens 時觸發 |
| Batch / Flex | 標準價的 50% | 適合不要求實時返回的任務 |
提升 gpt-6-astra 緩存命中率的 4 個技巧
提示詞緩存按“前綴”匹配,只要請求開頭的內容完全一致,就能複用之前的計算結果。圍繞這一機制,可以從以下幾個方面優化:
- 固定內容放前面:系統提示詞、工具定義、項目規範等不變的內容放在消息最前面,用戶問題、時間戳等變化內容放在最後。
- 使用 prompt_cache_key:GPT-5.6 及之後的模型支持該參數,對共享長前綴的請求使用相同的緩存鍵,能顯著提升匹配概率。
- 避免在前綴裏插入動態值:在系統提示詞裏寫入當前時間、隨機 ID,會讓每次請求的前綴都不同,緩存直接失效。
- 控制上下文在 272K 以內:超過該閾值會觸發長上下文計價,緩存讀取價格也會翻倍,長文檔建議先做檢索再送入模型。
緩存命中率還與底層線路的穩定性有關,如果請求在不同後端之間頻繁漂移,緩存很難持續命中。API易 apiyi.com 採用 OpenAI 與 Azure 官方雙線路直轉,並針對 gpt-6-astra 做了緩存友好的路由優化,在固定前綴的場景下可以獲得較高的緩存命中率,你可以通過響應中的 cached_tokens 字段直接覈對效果。
gpt-6-astra 降智與補位常見問題
Q1:gpt-6-astra 真的被 OpenAI 降智了嗎?
目前沒有官方證據證明模型權重被替換,OpenAI 也尚未發表正式說明。更可能的解釋是訂閱端推理預算的調度變化,疊加模型本身的輸出方差。建議用本文的 5 步排查法,用 API 固定檔位做對照後再下結論。
Q2:通過 API 調用的 gpt-6-astra 和 ChatGPT 裏的是同一個模型嗎?
是同一個模型,區別在於 API 允許你顯式指定推理強度,而訂閱產品的推理預算由平臺調度。API易 apiyi.com 提供的是純官方直轉的滿血版 gpt-6-astra,推理強度完全按你傳入的參數執行。
Q3:訂閱額度和 API 可以同時使用嗎?
可以,兩者相互獨立。比較推薦的做法是日常交互繼續用訂閱額度,額度耗盡或需要批量處理時切換到 API,Codex 中通過配置文件即可快速切換。
Q4:用 API 補位會不會很貴?
取決於用法。控制推理檔位、提高緩存命中率、把非實時任務放進 Batch,能把成本壓低一半以上。建議先在 API易 apiyi.com 用少量真實任務測算單次成本,再決定補位規模。
Q5:gpt-6-astra 和 GPT-5.6 Sol 該怎麼搭配?
Sol 價格低很多,適合常規編碼和批量任務;Astra 在電腦操作、複雜推理和長鏈路 Agent 任務上優勢明顯。可以把 Sol 作爲默認模型,只在難題上升級到 Astra,這樣既保證質量又控制成本。
總結:把 gpt-6-astra 的不確定性變成可控變量
gpt-6-astra 是 OpenAI 目前能力最強的旗艦模型,但上線初期的“降智”爭議和額度收緊,暴露了訂閱產品的一個本質特點:推理預算和使用上限都由平臺決定,用戶只能被動接受。面對這種情況,與其反覆猜測模型是不是變笨了,不如用固定提示詞和固定推理檔位建立自己的質量基線。
實操上可以分三步走:先用 5 步排查法區分平臺調度、模型方差和自身用法;再在額度耗盡時用 API 補位,把關鍵任務固定在 high 或 xhigh 檔位;最後通過固定前綴、prompt_cache_key 和 Batch 把成本壓下來。這樣無論訂閱端如何調整,你的核心工作流都能保持穩定。
如果你需要一個穩定的補位渠道,推薦通過 API易 apiyi.com 調用滿血版 gpt-6-astra。該平臺純官方直轉 OpenAI 與 Azure,接口與官方完全兼容,緩存命中率高,適合作爲 ChatGPT 和 Codex 訂閱之外的可靠補充。
參考資料:
- OpenAI 模型文檔(gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI 幫助中心 Astra 用量說明: help.openai.com
- Decrypt 關於 Astra 降智爭議的報道: decrypt.co
- Microsoft Foundry 提示詞緩存文檔: learn.microsoft.com
- API易 模型文檔: docs.apiyi.com
作者簡介:APIYI 技術團隊,專注 AI 大模型 API 接入與工程化實踐。歡迎通過 API易 apiyi.com 交流 gpt-6-astra 的調用優化與成本控制經驗。