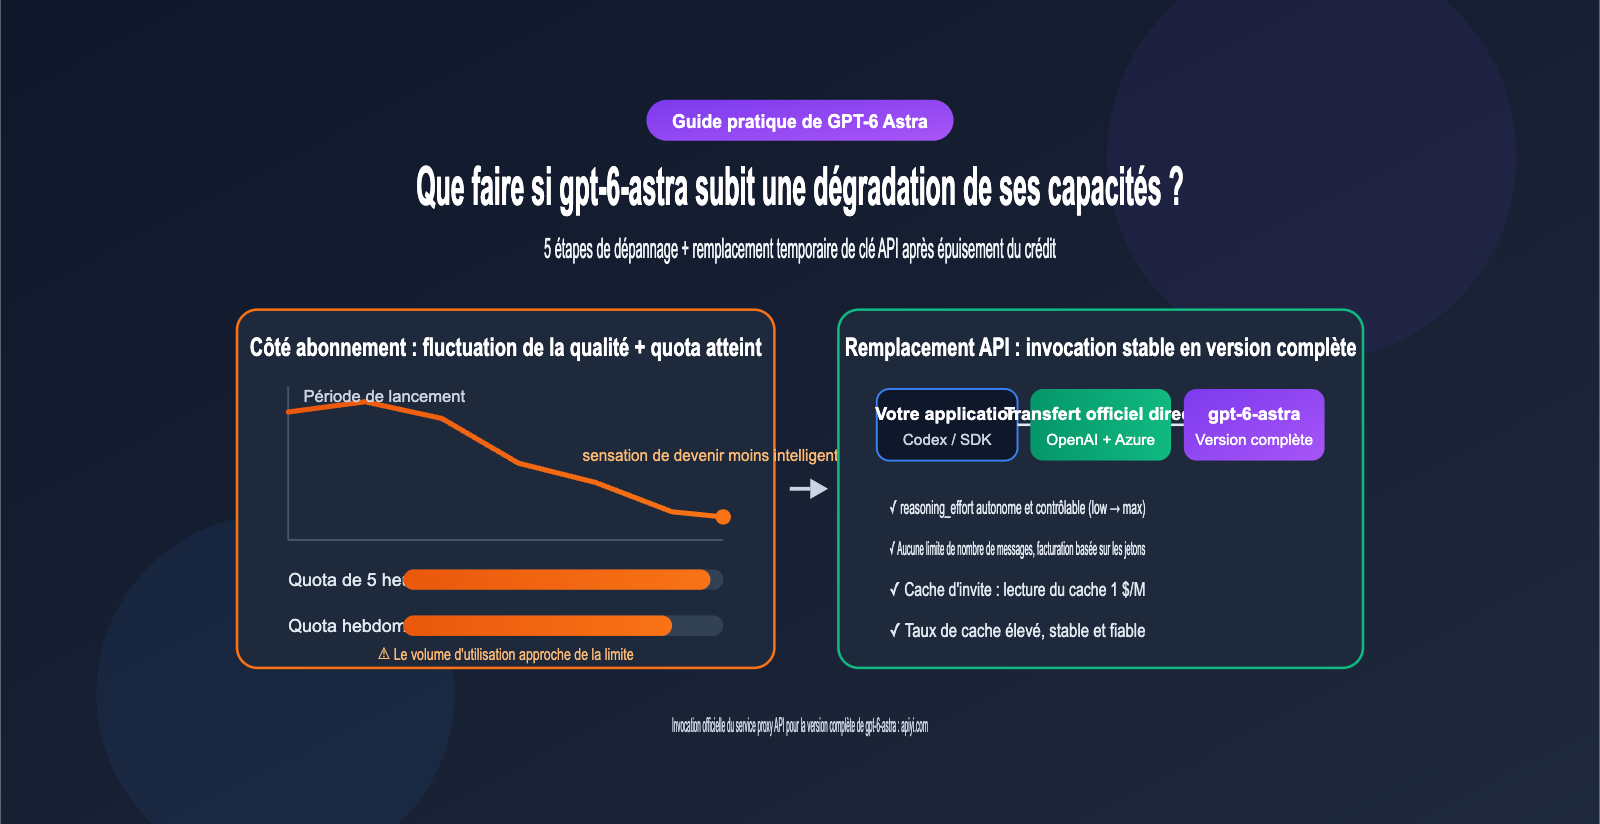
Le modèle gpt-6-astra a été lancé le 3 septembre 2026 et a été rendu accessible à tous dès le lendemain. À peine une semaine après sa mise en ligne, les réseaux sociaux ont été inondés de plaintes affirmant que « gpt-6-astra est devenu moins intelligent » : pour une même invite, la qualité des réponses est jugée inférieure à celle des premiers jours, et le mode de raisonnement « Extra high » est devenu plus rapide, mais avec des résultats plus approximatifs. Parallèlement, les quotas Astra sur ChatGPT et Codex sont nettement plus restreints que ceux de la génération précédente, le GPT-5.6 Sol, ce qui bloque de nombreux développeurs en plein travail. Cet article vous présente une méthode de diagnostic en 5 étapes pour vérifier si gpt-6-astra a réellement perdu en performance, ainsi qu'une solution de secours via le service proxy API officiel pour stabiliser votre flux de travail.
Valeur ajoutée : Après avoir lu cet article, vous serez capable de distinguer une « réelle baisse de performance » d'un « biais de perception », de comprendre les limites réelles de vos quotas d'abonnement et d'apprendre à utiliser des stratégies de contrôle de l'intensité de raisonnement et de mise en cache pour invoquer le gpt-6-astra dans sa pleine puissance à un coût raisonnable.
Points clés de la controverse sur la baisse de performance de gpt-6-astra
Avant de commencer le diagnostic, mettons au clair les faits connus. Selon les analyses de médias étrangers comme Decrypt, les plaintes ont commencé à se concentrer une semaine après le lancement d'Astra. Certains développeurs (y compris l'équipe opencode) sont revenus à GPT-5.6 Sol en raison d'un coût doublé et d'une qualité inférieure aux attentes. Cependant, à l'heure où nous écrivons ces lignes, OpenAI n'a pas publié de déclaration officielle sur Astra, et de nombreux utilisateurs expérimentés estiment que le modèle lui-même n'a pas changé, mais que la fin de la « période de lune de miel » a rendu les utilisateurs plus attentifs à ses erreurs.
| Point | Fait établi | Ce que cela signifie pour vous |
|---|---|---|
| Date de sortie | 03/09/2026 pour les utilisateurs approuvés, 04/09 disponible pour tous | Le modèle est encore en phase initiale, les stratégies côté serveur peuvent changer fréquemment |
| Plaintes | Retours d'utilisateurs sur une baisse de qualité et une réduction du temps de traitement en mode intensif | Nécessite une vérification reproductible, ne pas se fier uniquement à son ressenti |
| Réponse officielle | Aucune déclaration officielle concernant Astra pour le moment | Impossible de confirmer si l'intensité de raisonnement par défaut a été ajustée |
| Précédents | En juillet 2026, Sol a subi des critiques similaires ; OpenAI a nié toute réduction volontaire, mais a admis tester des réglages d'« intensité de raisonnement » | Le budget de raisonnement côté ChatGPT n'est pas entièrement sous votre contrôle |
| Quotas restreints | Plus dans Work/Codex : environ 5 à 45 messages/5 heures, soit environ la moitié de la période Sol | Les utilisateurs intensifs atteignent facilement la limite aux heures de pointe |
Pourquoi gpt-6-astra semble-t-il « devenir plus bête » ?
La probabilité que les poids du modèle aient été secrètement remplacés est en réalité très faible. La cause la plus fréquente réside dans le « budget de raisonnement ». gpt-6-astra prend en charge cinq niveaux d'intensité de raisonnement dans l'API : low, medium, high, xhigh et max. Plus le niveau est élevé, plus le modèle effectue d'étapes de réflexion avant de répondre, ce qui augmente simultanément la qualité et le temps de traitement. Dans les produits par abonnement comme ChatGPT et Codex, le budget de raisonnement est géré de manière centralisée par la plateforme. Si celle-ci réduit le budget réel pour faire face à la pression de calcul, les utilisateurs obtiennent des résultats « plus rapides mais plus grossiers », ce qui correspond parfaitement au contenu des plaintes.
D'un autre côté, des développeurs comme Theo soulignent que la variance de sortie d'Astra est assez élevée : pour une même tâche, il peut fournir un résultat époustouflant comme commettre une erreur grossière. Au lancement, il est facile de retenir les cas réussis, mais avec le temps, les échecs sont davantage remarqués. Ce décalage psychologique est souvent interprété comme une « baisse d'intelligence ». Par conséquent, la clé du diagnostic consiste à séparer les trois variables : « gestion de la plateforme », « variance du modèle » et « vos propres méthodes d'utilisation ».
Voici une méthode en 5 étapes pour diagnostiquer une baisse de performance suspectée sur gpt-6-astra. Ce processus vous permet d'isoler les causes probables une par une, évitant ainsi de changer de modèle à l'aveugle.
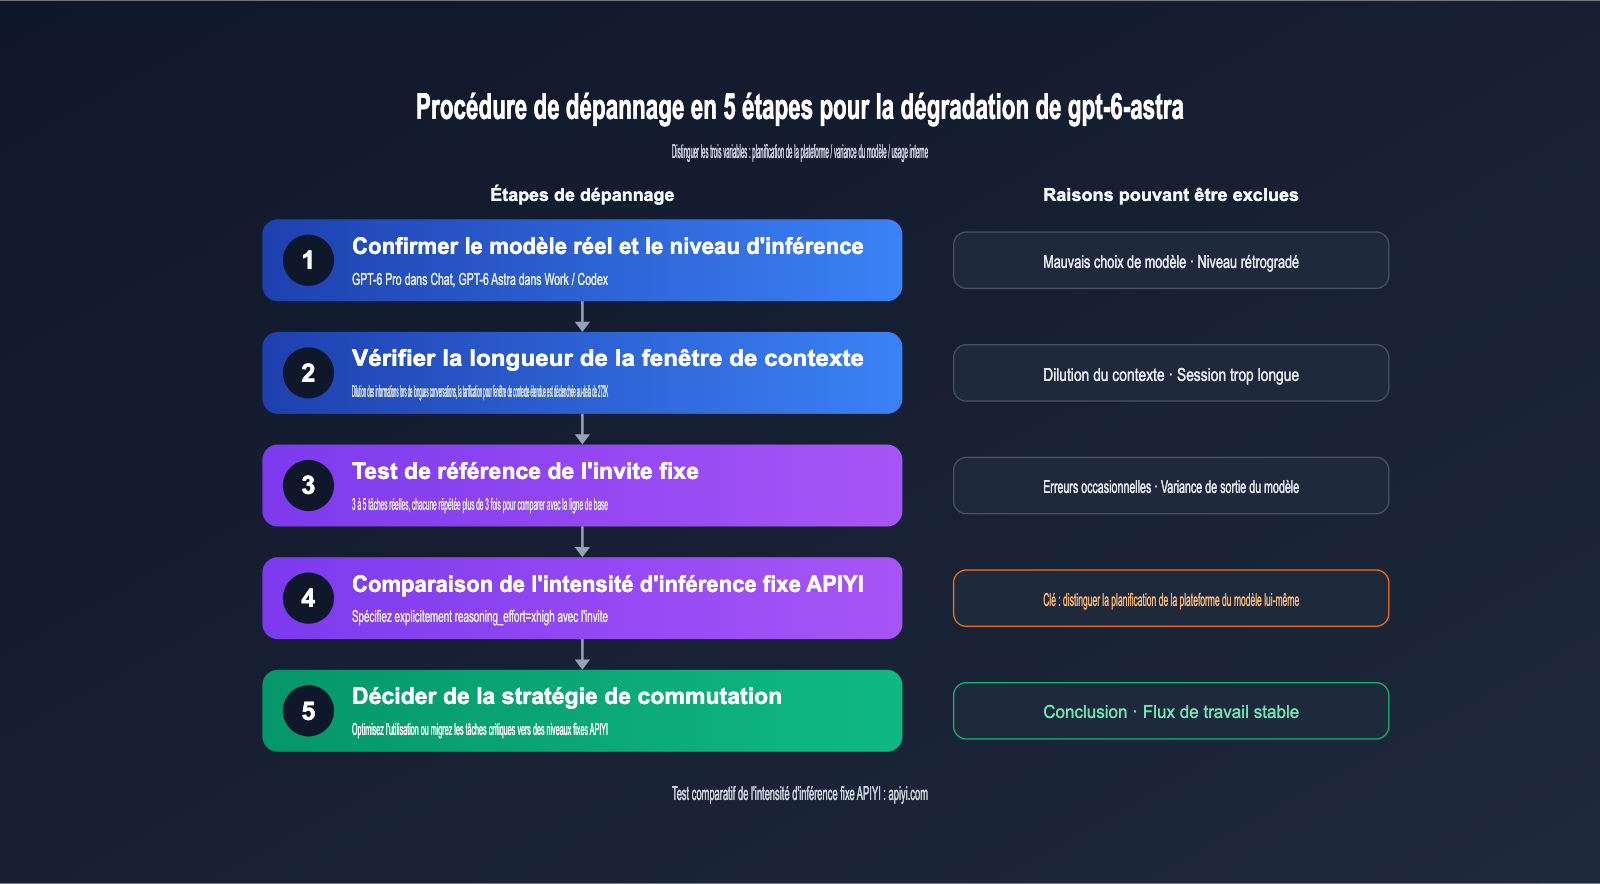
- Vérifiez le modèle et le niveau utilisés : Dans ChatGPT, Astra apparaît sous le nom de GPT-6 Pro dans le chat, et GPT-6 Astra dans Work et Codex. Les systèmes de quotas diffèrent. Vérifiez quel modèle est réellement utilisé et quel niveau d'intensité de réflexion est sélectionné. Regardez si l'interface indique une dégradation en cas de quotas limités.
- Vérifiez si la fenêtre de contexte est trop longue : La fenêtre de contexte d'Astra est de 1 050 000 jetons, mais la dilution des informations initiales dans les longues conversations est un problème courant sur tous les grands modèles de langage. Si une session Codex dure depuis plusieurs heures, commencez par ouvrir une nouvelle session et simplifiez les documents de référence avant de retester.
- Effectuez des tests de référence avec des invites fixes : Choisissez 3 à 5 tâches réelles que vous connaissez bien, enregistrez les résultats obtenus lors de la période initiale comme base de référence, et répétez la même invite au moins 3 fois pour voir s'il s'agit d'une baisse stable ou d'une erreur ponctuelle. Une comparaison unique n'a pratiquement aucune valeur statistique.
- Utilisez l'API pour comparer avec une intensité de raisonnement fixe : Via l'API, spécifiez explicitement
reasoning_effortet comparez les résultats avec ceux de l'interface ChatGPT pour une même invite. Si les résultatsxhighde l'API sont nettement meilleurs, le problème vient probablement du budget d'inférence de la plateforme, et non du modèle lui-même. - Décidez de votre stratégie selon les conclusions : S'il s'agit d'un problème d'utilisation, optimisez vos invites et la gestion de vos sessions ; s'il s'agit d'un problème de planification ou de quota, migrez vos tâches critiques vers des appels API contrôlés.
| Phénomène | Cause la plus probable | Méthode de vérification | Action recommandée |
|---|---|---|---|
| Réponse rapide mais raisonnement superficiel | Budget d'inférence réduit | Comparaison avec xhigh via API |
Passer les tâches critiques sur l'API avec un niveau fixe |
| Erreurs fréquentes en fin de session longue | Dilution du contexte ou dépassement de la zone 272K | Retester dans une nouvelle session | Diviser les tâches, simplifier le contexte |
| Performance inégale sur une même tâche | Forte variance de sortie du modèle | Exécuter l'invite 3 à 5 fois | Ajouter des étapes de vérification ou échantillonnage multiple |
| Notification soudaine de quota insuffisant | Limite des 5 heures ou hebdomadaire atteinte | Vérifier le panneau d'utilisation | Attendre la réinitialisation ou basculer sur l'API |
| Qualité du code en baisse | Changement de niveau ou dérive de l'invite | Comparer avec la base de référence initiale | Figer l'invite système et le niveau |
🎯 Conseil de diagnostic : L'étape 4 est cruciale pour distinguer un "problème de plateforme" d'un "problème de modèle". Nous vous recommandons d'utiliser APIYI (apiyi.com) pour exécuter la même série d'invites avec les niveaux
highetxhigh. Cette plateforme propose gpt-6-astra via un service proxy API officiel, avec des paramètres d'appel identiques à l'interface native d'OpenAI, ce qui rend la comparaison beaucoup plus probante.
Que faire quand le quota de gpt-6-astra est épuisé ?
Même si le modèle n'est pas bridé, les problèmes de quota suffisent à casser votre rythme de travail. Selon les informations compilées par les médias et la communauté internationale, Astra utilise une double restriction dans ChatGPT Work et Codex : un « quota glissant de 5 heures + un quota hebdomadaire ». Il faut que les deux soient disponibles pour continuer à utiliser le service. De plus, il a été rapporté qu'après la réinitialisation globale des quotas le 5 septembre, les plafonds de certains utilisateurs intensifs ont été encore resserrés. Le tableau ci-dessous présente les estimations collectées par la communauté ; les chiffres officiels du tableau de bord OpenAI font foi.
| Formule d'abonnement | Quota estimé Astra (Work/Codex) | GPT-6 Pro (Chat) | Public cible |
|---|---|---|---|
| Plus | Env. 5-45 messages / 5h | Non disponible | Usage léger, tâches complexes occasionnelles |
| Pro 100 $ | Env. 25-225 messages / 5h | Env. 50 messages / semaine | Développement quotidien intensif |
| Pro 200 $ | Env. 100-900 messages / 5h | Env. 200 messages / semaine | Usage professionnel 24h/24 |
| API (paiement à l'usage) | Pas de limite de messages, contraintes RPM/TPM | Non applicable | Tâches par lots, missions critiques, secours |
L'écart important dans ces fourchettes s'explique par le fait que la consommation de quota par message dépend de la complexité de la tâche, du niveau de raisonnement et de la longueur du contexte. Une session de 40 minutes d'automatisation informatique ne consomme pas la même chose qu'une simple question-réponse. Pour la plupart des développeurs, passer à la formule à 200 $ juste pour quelques pics de consommation n'est pas rentable. La stratégie la plus économique consiste à conserver son abonnement actuel et à utiliser l'API en complément lorsque le quota est épuisé.
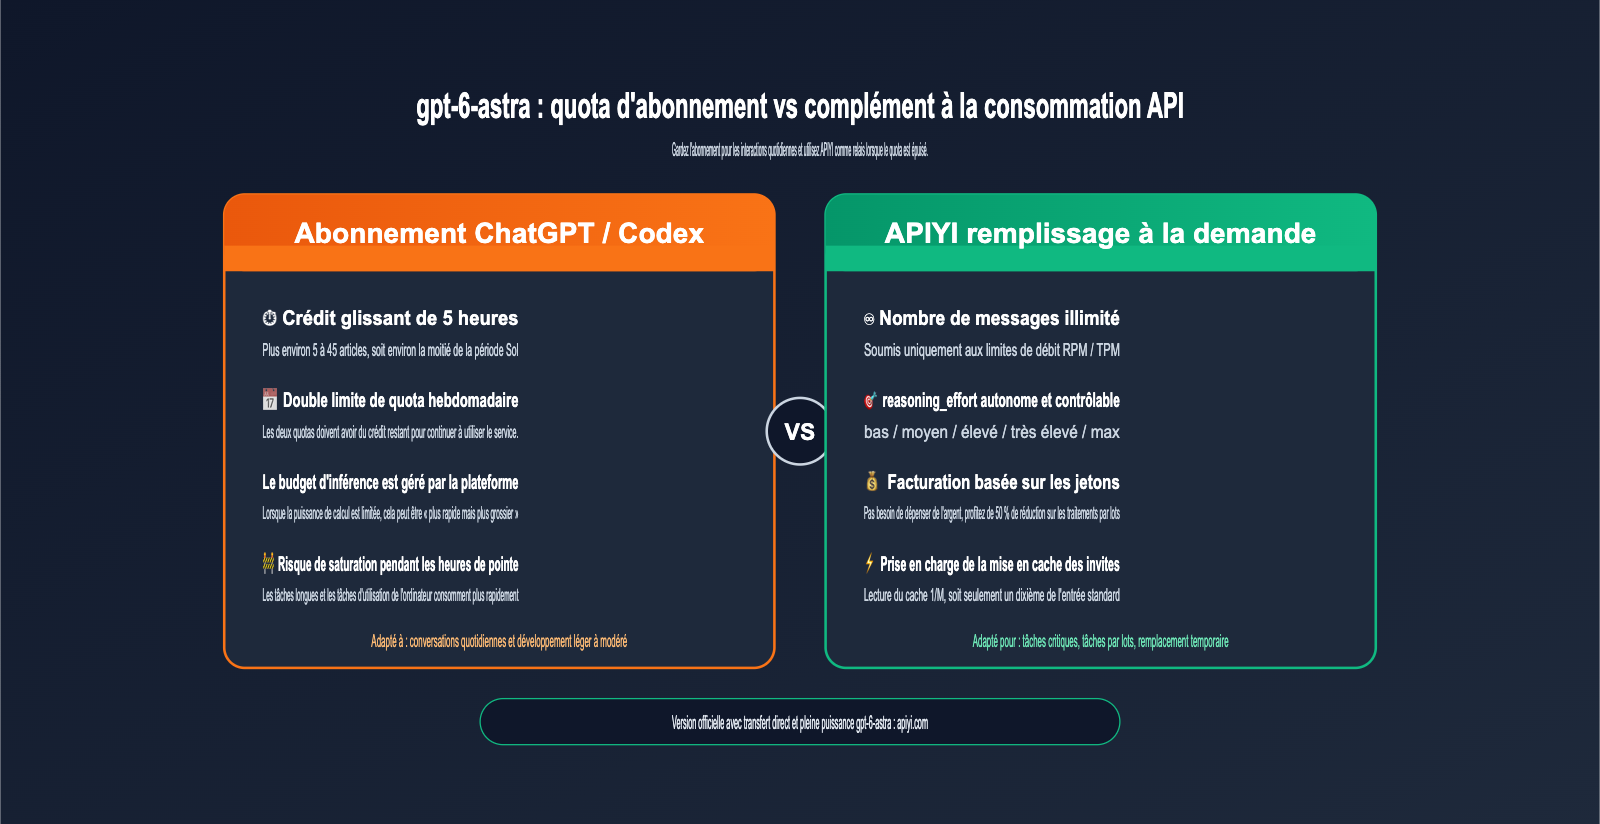
Trois avantages de l'utilisation de l'API gpt-6-astra en secours
Utiliser l'API en dépannage ne signifie pas seulement « obtenir plus de quota », c'est surtout reprendre le contrôle. Premièrement, l'intensité du raisonnement est explicitement définie par vous, sans ajustement silencieux de la plateforme, ce qui compense l'incertitude liée au « bridage ». Deuxièmement, l'API est facturée au token : vous ne payez rien quand vous ne l'utilisez pas, ce qui est idéal pour les besoins intermittents. Troisièmement, l'API prend en charge le traitement par lots (Batch) et la mise en cache des invites, permettant une maîtrise des coûts sur le long terme.
Lors du choix d'un fournisseur, vérifiez s'il s'agit d'un accès direct officiel. Certains tiers utilisent des interfaces inversées ou redirigent les requêtes vers d'autres modèles, ce qui aggrave les problèmes de performance. Le service gpt-6-astra proposé par APIYI (apiyi.com) offre une version complète, avec un routage direct officiel via OpenAI et Azure. Les paramètres d'interface sont strictement identiques à ceux de l'officiel, ce qui en fait un complément stable idéal en dehors de votre abonnement.
Démarrage rapide avec l'API gpt-6-astra
gpt-6-astra prend en charge les points de terminaison Chat Completions, Responses et Batch. Les entrées acceptent texte et images, et la sortie est textuelle. L'exemple minimal ci-dessous utilise le SDK officiel OpenAI ; il suffit de remplacer base_url et la clé API pour l'exécuter.
Exemple d'invocation minimale de gpt-6-astra
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "Vous êtes un ingénieur backend senior, vos réponses doivent inclure du code exécutable."},
        {"role": "user", "content": "Implémentez un cache LRU avec expiration en Python"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # Surveillez prompt_tokens_details.cached_tokens
Voir le code complet : encapsulation avec clé de cache, tentatives et statistiques d’utilisation
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# L'invite système longue et fixe est placée au début pour faciliter la mise en cache
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """Appel de gpt-6-astra avec intensité de raisonnement fixe et clé de cache réutilisée"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"Entrée {usage.prompt_tokens} | Cache {cached} "
                  f"| Taux de succès {hit_rate:.1%} | Sortie {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"Limite atteinte, nouvelle tentative dans {wait} secondes")
            time.sleep(wait)
        except APIError as e:
            print(f"Erreur d'interface : {e}")
            time.sleep(1)
    raise RuntimeError("Échec après plusieurs tentatives")


if __name__ == "__main__":
    tasks = [
        "Examinez l'utilisation des index dans ce SQL : SELECT ...",
        "Concevez une solution de réessai idempotente pour le service de commande",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 Conseil d'utilisation : Pour vos premiers appels, commencez par le niveau
mediumpour valider la chaîne, puis augmentez progressivement selon la difficulté de la tâche. Vous pouvez obtenir un quota de test après inscription sur APIYI (apiyi.com) pour vérifier que la qualité de sortie répond à vos attentes avant de migrer vos tâches réelles.
Utiliser l'API gpt-6-astra en secours dans Codex
Si vous utilisez principalement Astra via Codex CLI, inutile d'interrompre votre travail en cas d'épuisement du quota. Vous pouvez configurer un fournisseur de modèle personnalisé dans ~/.codex/config.toml pour utiliser votre clé API :
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Une fois configuré, exécutez export APIYI_API_KEY=votre_clé avant de lancer Codex. Lorsque votre quota d'abonnement est réinitialisé, il suffit de commenter model_provider pour revenir au mode de connexion initial. Vous pouvez basculer entre les deux modes selon vos besoins.
Comment choisir l'intensité de raisonnement de gpt-6-astra ?
L'intensité de raisonnement détermine directement la qualité, le temps de traitement et le coût. Il est recommandé de segmenter vos choix par type de tâche plutôt que de tout mettre au maximum.
| Intensité | Scénarios typiques | Qualité | Temps et coût |
|---|---|---|---|
| low | Conversion de format, questions simples, extraction | Basique | Minimum |
| medium | Complétion de code, rédaction de documents | Équilibré | Faible |
| high | Refactorisation complexe, architecture, analyse | Stable et fiable | Moyen |
| xhigh | Débogage complexe, agents multi-étapes | Proche de l'expérience initiale | Élevé |
| max | Preuves mathématiques, audit de sécurité, décisions critiques | Maximale | Très élevé, à limiter |
🎯 Conseil de sélection : Si vous soupçonnez un « bridage » sur votre abonnement, vous pouvez fixer les tâches critiques que vous exécutez habituellement dans ChatGPT sur le niveau
xhigh. Via APIYI (apiyi.com), l'intensité est entièrement contrôlée par vos paramètres, ce qui permet de maintenir une qualité constante et prévisible.
Optimisation des coûts et du taux de succès du cache pour gpt-6-astra
Le prix officiel de gpt-6-astra est de 10 $ pour l'entrée et 50 $ pour la sortie (par million de jetons), soit plusieurs fois le prix de lancement du GPT-5.6 Sol. Par conséquent, le contrôle des coûts doit être une priorité lors de l'utilisation de cette API en remplacement. La bonne nouvelle est que le prix de l'entrée en cache pour Astra n'est que de 1 $, soit 10 % du prix d'entrée standard. Le taux de succès du cache aura donc un impact direct et significatif sur votre facture.
| Élément de facturation | Prix officiel (par million de jetons) | Remarques |
|---|---|---|
| Entrée standard | 10 $ | Applicable si l'entrée ne dépasse pas 272K jetons |
| Lecture du cache | 1 $ | Pour la partie correspondant au cache de l'invite, économie de 90 % |
| Écriture du cache | 12,5 $ | Préfixe nouvellement écrit en cache, légèrement supérieur à l'entrée standard |
| Sortie standard | 50 $ | Inclut les jetons d'inférence |
| Contexte long | 2x entrée/cache, 1,5x sortie | Déclenché si l'entrée dépasse 272K jetons |
| Batch / Flex | 50 % du prix standard | Adapté aux tâches ne nécessitant pas de réponse en temps réel |
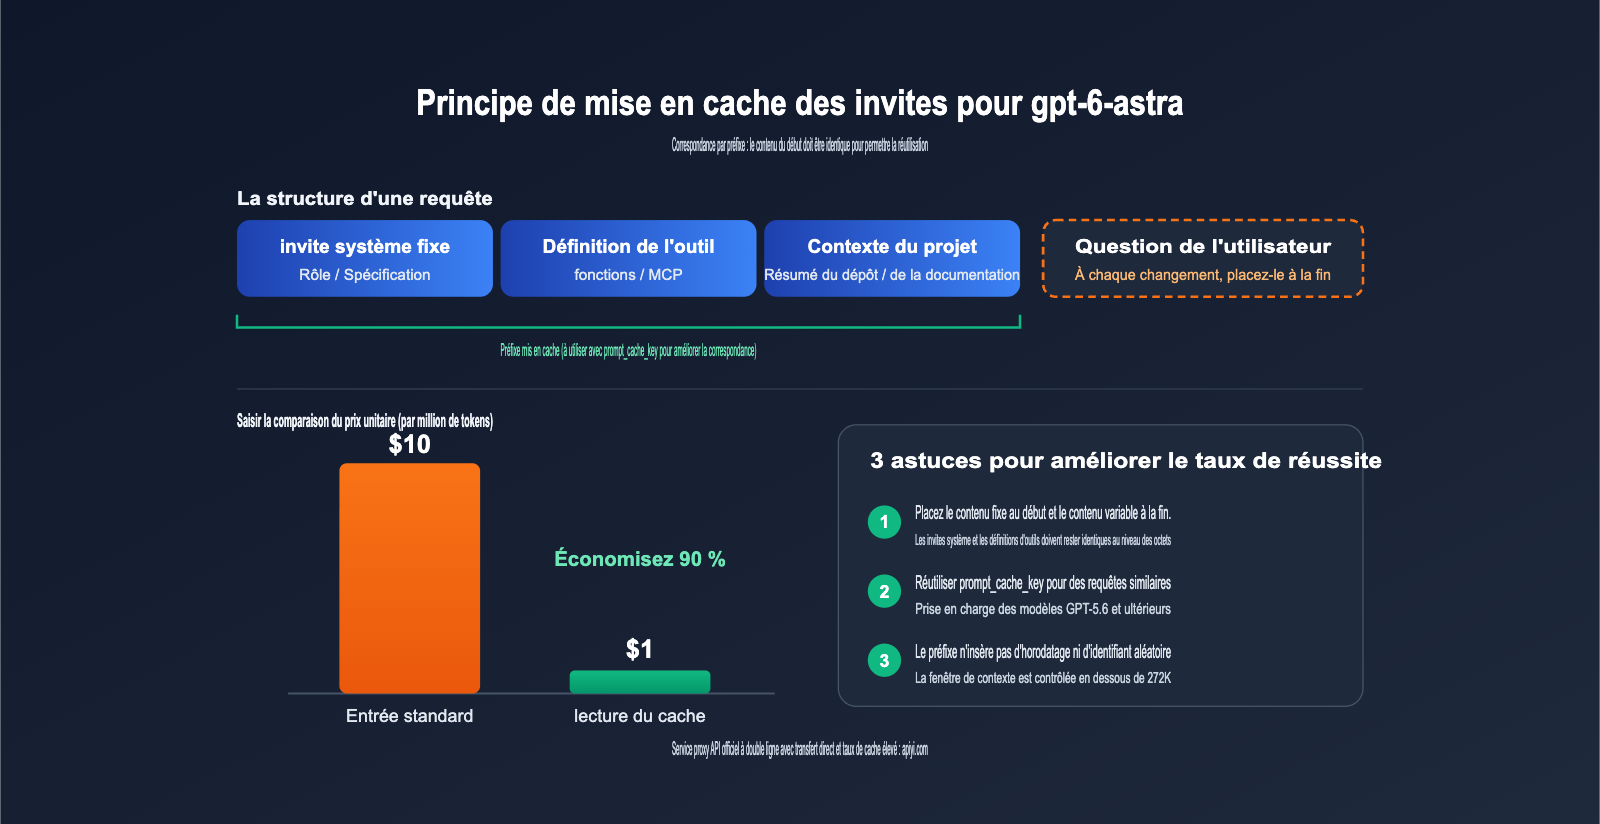
4 astuces pour améliorer le taux de succès du cache de gpt-6-astra
Le cache d'invite fonctionne par correspondance de "préfixe" : tant que le début de la requête est identique, les résultats de calcul précédents peuvent être réutilisés. En suivant ce mécanisme, vous pouvez optimiser vos performances comme suit :
- Placez le contenu fixe au début : Les invites système, les définitions d'outils, les spécifications de projet et tout contenu immuable doivent être placés au tout début du message. Les questions des utilisateurs, les horodatages et autres éléments variables doivent être placés à la fin.
- Utilisez
prompt_cache_key: Les modèles GPT-5.6 et ultérieurs prennent en charge ce paramètre. L'utilisation de la même clé de cache pour les requêtes partageant un long préfixe permet d'augmenter considérablement la probabilité de correspondance. - Évitez d'insérer des valeurs dynamiques dans le préfixe : L'insertion de l'heure actuelle ou d'identifiants aléatoires dans l'invite système rendra le préfixe différent à chaque requête, ce qui invalidera immédiatement le cache.
- Maintenez le contexte en dessous de 272K : Dépasser ce seuil déclenche la tarification pour contexte long et double le prix de lecture du cache. Pour les documents longs, il est conseillé d'effectuer une recherche avant d'envoyer le contenu au modèle.
Le taux de succès du cache dépend également de la stabilité de l'infrastructure sous-jacente. Si les requêtes basculent fréquemment entre différents backends, le cache aura du mal à rester efficace. APIYI (apiyi.com) utilise un service proxy API avec des lignes directes officielles OpenAI et Azure, et a optimisé le routage pour le cache de gpt-6-astra. Dans les scénarios avec des préfixes fixes, vous pouvez obtenir un taux de succès élevé. Vous pouvez vérifier les résultats directement via le champ cached_tokens dans la réponse.
FAQ sur la dégradation des performances et le remplacement de gpt-6-astra
Q1 : gpt-6-astra a-t-il vraiment été bridé par OpenAI ?
Il n'existe actuellement aucune preuve officielle indiquant que les poids du modèle ont été modifiés, et OpenAI n'a fait aucune déclaration à ce sujet. L'explication la plus probable réside dans des changements dans la planification du budget d'inférence côté abonnement, combinés à la variance naturelle des sorties du modèle. Nous vous conseillons d'utiliser la méthode de dépannage en 5 étapes décrite dans cet article et d'effectuer des tests comparatifs avec des paramètres API fixes avant de tirer des conclusions.
Q2 : Le gpt-6-astra appelé via API est-il le même que celui de ChatGPT ?
Il s'agit du même modèle. La différence est que l'API vous permet de spécifier explicitement l'intensité de l'inférence, tandis que le budget d'inférence des produits par abonnement est géré par la plateforme. APIYI (apiyi.com) propose une version "pleine puissance" directement issue des serveurs officiels, où l'intensité de l'inférence est exécutée exactement selon les paramètres que vous transmettez.
Q3 : Puis-je utiliser simultanément mon abonnement et l’API ?
Oui, les deux sont indépendants. Une approche recommandée consiste à utiliser votre abonnement pour les interactions quotidiennes et à basculer vers l'API lorsque votre quota est épuisé ou pour des traitements par lots. Vous pouvez basculer rapidement via le fichier de configuration dans Codex.
Q4 : Le remplacement par API est-il coûteux ?
Cela dépend de votre utilisation. En contrôlant les niveaux d'inférence, en augmentant le taux de réussite du cache et en déplaçant les tâches non urgentes vers des traitements par lots (Batch), vous pouvez réduire les coûts de plus de moitié. Nous vous suggérons d'effectuer des tests sur APIYI (apiyi.com) avec quelques tâches réelles pour calculer le coût unitaire avant de définir l'échelle de votre remplacement.
Q5 : Comment combiner gpt-6-astra et GPT-5.6 Sol ?
Sol est beaucoup moins cher, ce qui le rend idéal pour le codage classique et les tâches par lots. Astra excelle dans l'utilisation de l'ordinateur, le raisonnement complexe et les tâches d'agent à longue chaîne. Vous pouvez utiliser Sol comme modèle par défaut et ne passer à Astra que pour les problèmes difficiles ; cela garantit la qualité tout en maîtrisant les coûts.
Conclusion : Transformer l'incertitude de gpt-6-astra en variable contrôlable
gpt-6-astra est actuellement le modèle phare le plus performant d'OpenAI, mais la controverse sur sa "dégradation" et le resserrement des quotas au lancement révèlent une caractéristique essentielle des produits par abonnement : le budget d'inférence et les limites d'utilisation sont décidés par la plateforme, et l'utilisateur doit les accepter passivement. Face à cette situation, plutôt que de spéculer sur une éventuelle baisse de performance, il vaut mieux établir votre propre base de référence de qualité en utilisant des invites fixes et des niveaux d'inférence constants.
En pratique, vous pouvez suivre trois étapes : utilisez d'abord la méthode de dépannage en 5 étapes pour distinguer la planification de la plateforme, la variance du modèle et votre propre usage ; ensuite, utilisez l'API pour prendre le relais lorsque votre quota est épuisé, en fixant les tâches critiques aux niveaux high ou xhigh ; enfin, réduisez les coûts grâce à des préfixes fixes, au prompt_cache_key et au traitement par lots (Batch). Ainsi, peu importe les ajustements de la plateforme, votre flux de travail principal restera stable.
Si vous avez besoin d'un canal de remplacement stable, nous vous recommandons d'utiliser la version "pleine puissance" de gpt-6-astra via APIYI (apiyi.com). La plateforme propose un accès direct et officiel aux API d'OpenAI et d'Azure, avec une compatibilité totale et un excellent taux de réussite du cache, ce qui en fait un complément fiable à vos abonnements ChatGPT et Codex.
Références :
- Documentation des modèles OpenAI (gpt-6-astra) : developers.openai.com/api/docs/models/gpt-6-astra
- Centre d'aide OpenAI – Utilisation d'Astra : help.openai.com
- Rapport de Decrypt sur la controverse de la dégradation d'Astra : decrypt.co
- Documentation sur la mise en cache des invites Microsoft Foundry : learn.microsoft.com
- Documentation des modèles APIYI : docs.apiyi.com
À propos de l'auteur : L'équipe technique d'APIYI, spécialisée dans l'intégration d'API de grands modèles de langage et les pratiques d'ingénierie IA. N'hésitez pas à échanger avec nous sur l'optimisation des appels et le contrôle des coûts de gpt-6-astra via APIYI (apiyi.com).