Das Modell gpt-6-astra wurde am 3. September 2026 veröffentlicht und am darauffolgenden Tag für alle Nutzer freigeschaltet. Nur eine Woche nach dem Start häuften sich in den sozialen Medien Beschwerden: „gpt-6-astra ist dümmer geworden“. Die Nutzer berichten, dass bei identischen Eingabeaufforderungen die Ausgabequalität nicht mehr an die der ersten Tage heranreicht. Zudem läuft die „Extra high“-Inferenzstufe zwar schneller, liefert jedoch gröbere Ergebnisse. Gleichzeitig wurden die Astra-Kontingente für ChatGPT und Codex im Vergleich zur Vorgängergeneration GPT-5.6 Sol deutlich gekürzt, sodass viele Entwickler mitten in der Arbeit durch Limits blockiert werden. Dieser Artikel stellt eine 5-Schritte-Analyse vor, um zu prüfen, ob gpt-6-astra tatsächlich „dümmer“ geworden ist, sowie eine Lösung für den API-Proxy-Dienst, um bei erschöpften Kontingenten temporär auf die offizielle API auszuweichen, damit Ihr Workflow stabil bleibt.
Kernnutzen: Nach der Lektüre dieses Artikels können Sie zwischen einer „echten Verschlechterung“ und „subjektiver Wahrnehmung“ unterscheiden, kennen die tatsächlichen Grenzen Ihres Kontingents und wissen, wie Sie durch kontrollierte Inferenzstärken und Caching-Strategien das volle Potenzial von gpt-6-astra zu vernünftigen Kosten nutzen.
Kernpunkte der Kontroverse um gpt-6-astra
Bevor wir mit der Fehlersuche beginnen, sollten wir die bekannten Fakten klären. Laut Berichten internationaler Medien wie Decrypt begannen die massiven Beschwerden eine Woche nach der Astra-Veröffentlichung. Einige Entwickler (darunter das opencode-Team) kehrten zu GPT-5.6 Sol zurück, da sich die Kosten verdoppelten und die Qualität hinter den Erwartungen zurückblieb. Bis zum Redaktionsschluss hat OpenAI jedoch keine offizielle Stellungnahme zu Astra veröffentlicht. Viele erfahrene Nutzer sind zudem der Meinung, dass sich das Modell selbst nicht verändert hat, sondern dass die Nutzer nach der „Flitterwochen-Phase“ einfach sensibler für Fehler geworden sind.
| Punkt | Bekannte Fakten | Bedeutung für Sie |
|---|---|---|
| Veröffentlichungsdatum | 03.09.2026 für zugelassene Nutzer, 04.09. allgemein verfügbar | Das Modell befindet sich noch in der Anfangsphase; serverseitige Strategien können sich häufig ändern |
| Beschwerden | Nutzer melden schlechtere Ausgaben bei gleicher Eingabeaufforderung und kürzere Laufzeiten bei hohen Inferenzstufen | Erfordert eine reproduzierbare Überprüfung, kein bloßes Bauchgefühl |
| Offizielle Reaktion | Bisher keine offizielle Stellungnahme zu Astra | Es lässt sich nicht bestätigen, ob die Standard-Inferenzstärke angepasst wurde |
| Historische Präzedenzfälle | Im Juli 2026 gab es ähnliche Zweifel an Sol; OpenAI bestritt eine bewusste Schwächung, räumte aber Experimente mit der „Inferenzstärke“ ein | Das Inferenzbudget in ChatGPT wird nicht vollständig von Ihnen kontrolliert |
| Kontingentkürzung | Plus in Work/Codex bei ca. 5-45 Anfragen/5 Stunden, etwa die Hälfte der Sol-Zeit | Power-User stoßen zu Spitzenzeiten leicht an ihre Grenzen |
Warum sich gpt-6-astra „dümmer anfühlt“
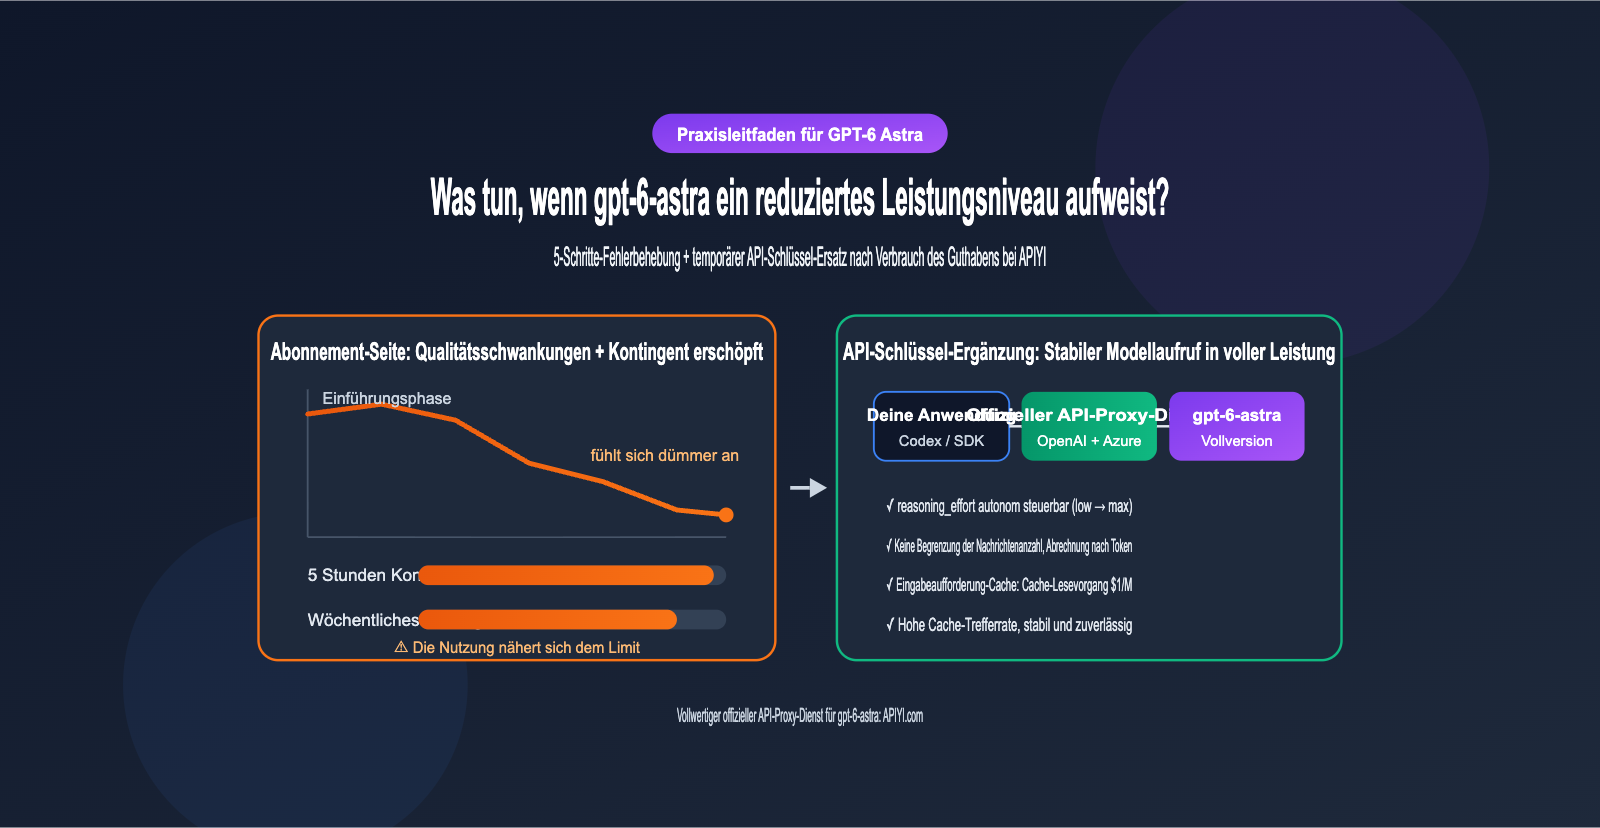
Die Wahrscheinlichkeit, dass die Modellgewichte heimlich ausgetauscht wurden, ist sehr gering. Häufiger liegt das Problem beim „Inferenzbudget“. gpt-6-astra unterstützt in der API fünf Inferenzstärken: low, medium, high, xhigh und max. Je höher die Stufe, desto mehr Denkschritte führt das Modell vor der Antwort aus, was Qualität und Rechenzeit erhöht. Bei Abonnement-Produkten wie ChatGPT und Codex wird das Inferenzbudget zentral von der Plattform gesteuert. Wenn die Plattform das tatsächliche Budget drosselt, um den Rechenlastdruck zu bewältigen, sehen die Nutzer „schnellere, aber gröbere“ Ergebnisse, was exakt mit den Beschwerden übereinstimmt.
Andererseits weisen Entwickler wie Theo darauf hin, dass die Ausgabevarianz von Astra ohnehin recht hoch ist. Bei derselben Aufgabe kann das Modell sowohl brillante Ergebnisse liefern als auch Flüchtigkeitsfehler begehen. Zum Start bleiben die brillanten Fälle besser im Gedächtnis; nach längerer Nutzung werden die Fehlerfälle stärker wahrgenommen. Diese psychologische Diskrepanz wird oft als „Dümmerwerden“ interpretiert. Der Schlüssel zur Analyse liegt also darin, die drei Variablen „Plattformsteuerung“, „Modellvarianz“ und „eigene Nutzung“ getrennt voneinander zu betrachten.
5-Schritte-Checkliste zur Fehlerbehebung bei gpt-6-astra-Leistungsabfällen
Dieser Prozess hilft dir dabei, systematisch vorzugehen, wenn du den Verdacht hast, dass die Leistung von gpt-6-astra nachgelassen hat. So vermeidest du es, voreilig zwischen Modellen zu wechseln.
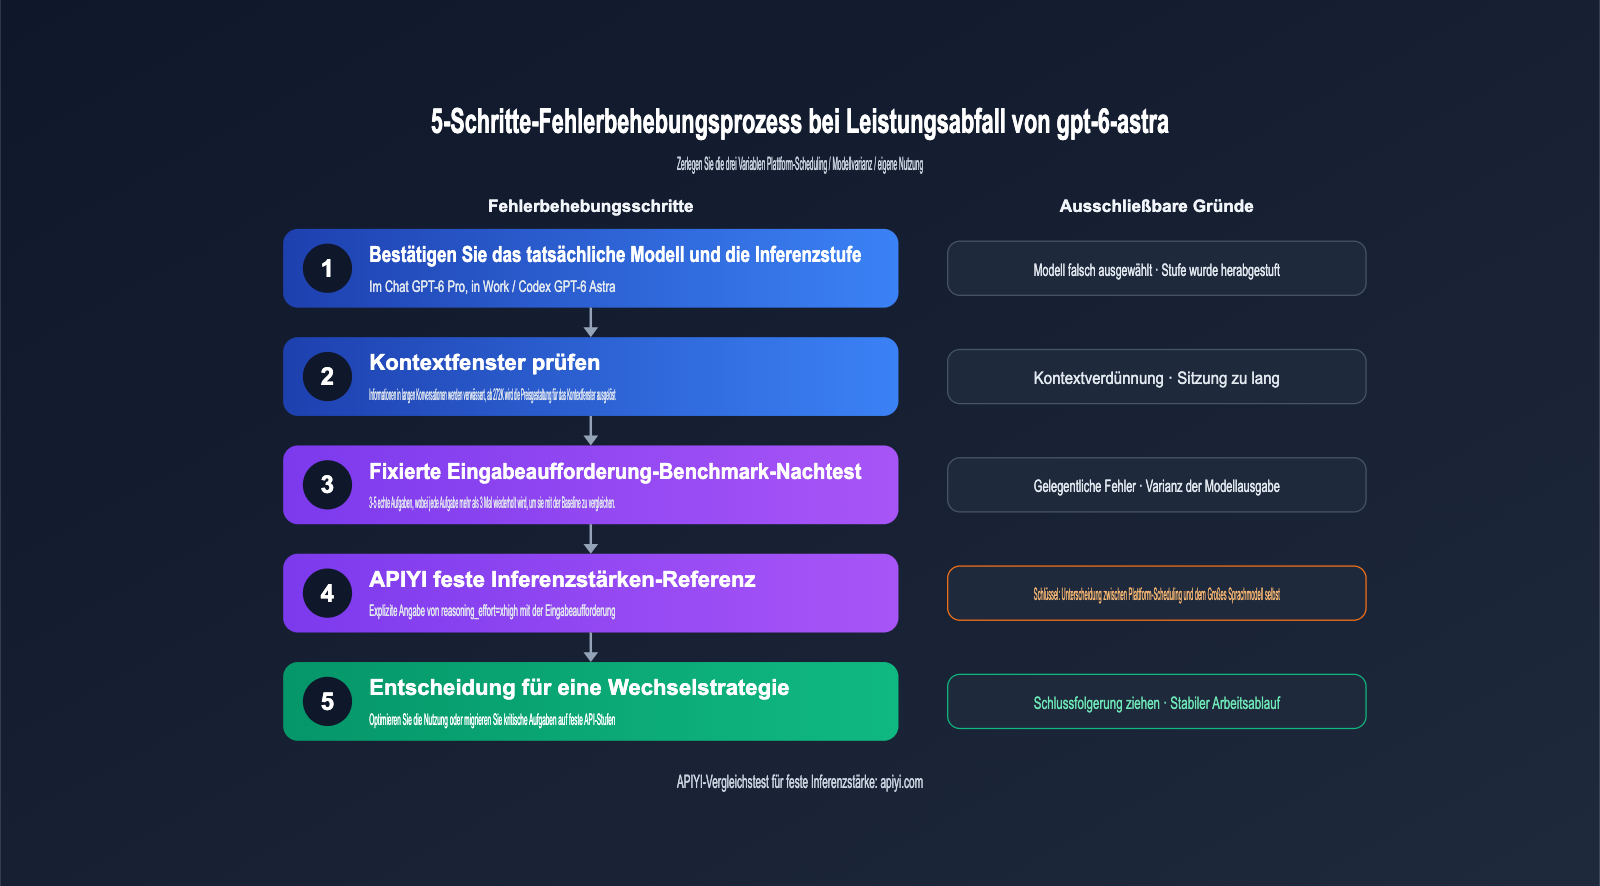
- Modell und Stufe verifizieren: In ChatGPT erscheint Astra im Chat als GPT-6 Pro, während es in Work und Codex als GPT-6 Astra geführt wird – beide haben unterschiedliche Kontingentsysteme. Prüfe zuerst, welches Modell und welche Denkintensität du tatsächlich nutzt und ob das Interface bei Erschöpfung des Kontingents bereits eine Herabstufung signalisiert.
- Kontextfenster prüfen: Astra bietet ein Kontextfenster von 1.050.000 Tokens, doch die Verwässerung früherer Informationen in langen Sitzungen ist ein bekanntes Problem bei allen großen Sprachmodellen. Wenn eine Codex-Sitzung bereits stundenlang läuft, starte eine neue Sitzung und fasse die Hintergrundinformationen prägnant zusammen.
- Benchmark-Test mit fester Eingabeaufforderung: Wähle 3-5 bekannte Aufgaben aus und vergleiche die Ergebnisse mit den Ausgaben aus der Anfangsphase. Führe die gleiche Eingabeaufforderung mindestens dreimal aus, um zu sehen, ob es sich um einen stabilen Leistungsabfall oder nur um gelegentliche Fehler handelt. Ein einzelner Vergleich ist statistisch nicht aussagekräftig.
- Vergleich mit API-gesteuerter Inferenzintensität: Nutze die API, um
reasoning_effortexplizit festzulegen, und vergleiche die Ergebnisse mit der ChatGPT-Oberfläche bei gleicher Eingabeaufforderung. Wenn diexhigh-Ergebnisse der API deutlich besser sind als die der Abo-Version, liegt das Problem wahrscheinlich am Inferenzbudget der Plattform und nicht am Modell selbst. - Strategie festlegen: Liegt es an der eigenen Anwendung, optimiere die Eingabeaufforderung und das Sitzungsmanagement. Handelt es sich um ein Problem der Plattform-Planung oder des Kontingents, verlagere kritische Aufgaben auf steuerbare API-Aufrufe.
| Phänomen | Wahrscheinlichste Ursache | Überprüfungsmethode | Empfohlene Maßnahme |
|---|---|---|---|
| Antwort schnell, aber Inferenz oberflächlich | Inferenzbudget wurde gedrosselt | API-Vergleich mit xhigh |
Kritische Aufgaben über API mit fester Stufe ausführen |
| Fehler in langen Sitzungen | Kontextverwässerung oder Überschreitung des 272K-Bereichs | Neue Sitzung starten | Aufgaben aufteilen, Kontext kürzen |
| Schwankende Qualität bei gleicher Aufgabe | Hohe Varianz der Modellausgabe | 3-5 Testläufe | Validierungsschritte oder mehrfache Stichproben |
| Plötzliche Meldung: Kontingent erschöpft | 5-Stunden- oder Wochenlimit erreicht | Nutzungsübersicht prüfen | Auf Reset warten oder API-Backup nutzen |
| Deutlicher Rückgang der Code-Qualität | Stufenwechsel oder Drift der Eingabeaufforderung | Vergleich mit Baseline der Anfangsphase | System-Eingabeaufforderung und Stufe fixieren |
🎯 Tipp zur Fehlerbehebung: Schritt 4 ist entscheidend, um zwischen einem "Plattform-Problem" und einem "Modell-Problem" zu unterscheiden. Wir empfehlen, über APIYI (apiyi.com) mit denselben Eingabeaufforderungen die Stufen
highundxhighzu testen. Die Plattform bietet gpt-6-astra als direkten offiziellen Proxy an, wobei die Parameter exakt den nativen OpenAI-Schnittstellen entsprechen, was die Vergleichsergebnisse deutlich verlässlicher macht.
Was tun, wenn das Kontingent für gpt-6-astra erschöpft ist?
Auch wenn das Modell nicht gedrosselt wurde, reicht ein erschöpftes Kontingent aus, um den Arbeitsfluss zu unterbrechen. Laut Informationen aus internationalen Medien und Communities unterliegt Astra in ChatGPT Work und Codex einer doppelten Beschränkung: einem „5-Stunden-Rollkontingent“ und einem „Wochenkontingent“. Beide müssen noch über Kapazitäten verfügen, um die Nutzung fortzusetzen. Zudem wurde berichtet, dass nach dem Zurücksetzen der Kontingente für alle Nutzer am 5. September die Obergrenzen für einige Power-User weiter verschärft wurden. Die folgende Tabelle zeigt die von der Community geschätzten Werte; maßgeblich ist jedoch das offizielle Nutzungs-Dashboard von OpenAI.
| Abonnement-Plan | Geschätztes Astra-Kontingent in Work/Codex | GPT-6 Pro in Chat | Zielgruppe |
|---|---|---|---|
| Plus | ca. 5-45 Nachrichten / 5 Std. | Nicht verfügbar | Gelegentliche Nutzung, einfache Aufgaben |
| Pro $100 | ca. 25-225 Nachrichten / 5 Std. | ca. 50 Nachrichten / Woche | Hauptnutzer für tägliche Entwicklung |
| Pro $200 | ca. 100-900 Nachrichten / 5 Std. | ca. 200 Nachrichten / Woche | Intensive Nutzung rund um die Uhr |
| API (Pay-as-you-go) | Keine Nachrichtenbeschränkung, nur RPM/TPM-Limits | Nicht anwendbar | Batch-Aufgaben, kritische Tasks, Backup |
Die große Spanne erklärt sich dadurch, dass der Verbrauch pro Nachricht von der Komplexität der Aufgabe, der Stufe der Schlussfolgerung (Reasoning) und der Länge des Kontextfensters abhängt. Eine 40-minütige Computer-Automatisierung verbraucht deutlich mehr als eine einfache Frage-Antwort-Interaktion. Für die meisten Entwickler lohnt sich ein Upgrade auf den $200-Plan für gelegentliche Spitzenlasten kaum. Wirtschaftlicher ist es, das bestehende Abo beizubehalten und bei Erschöpfung des Kontingents auf den API-Proxy-Dienst auszuweichen.
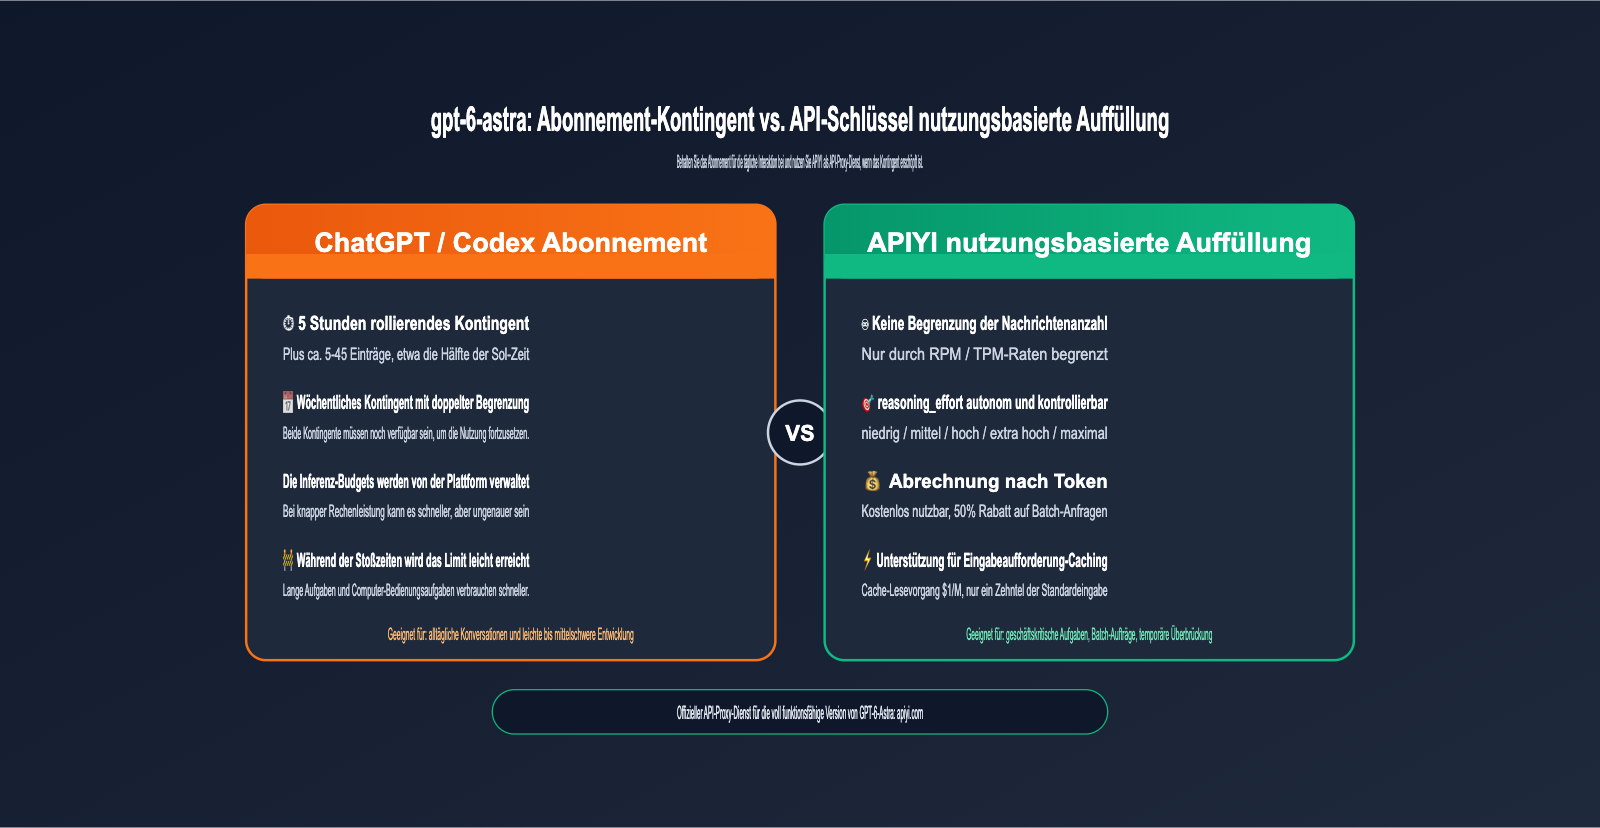
Drei Vorteile des gpt-6-astra API-Backups
Die Nutzung der API als temporäres Backup bietet nicht nur „mehr Kontingent“, sondern gibt Ihnen vor allem die Kontrolle zurück. Erstens bestimmen Sie die Stärke der Schlussfolgerung explizit, ohne dass die Plattform diese im Hintergrund anpasst – das wirkt der Unsicherheit durch „Drosselung“ entgegen. Zweitens erfolgt die Abrechnung der API nach Token, sodass keine Kosten anfallen, wenn sie nicht genutzt wird; ideal für sporadische Bedarfsspitzen. Drittens unterstützt die API Kostenoptimierungen wie Batch-Verarbeitung und Caching von Eingabeaufforderungen, was die Kosten langfristig kontrollierbar macht.
Bei der Wahl des Anbieters ist entscheidend, ob es sich um eine direkte offizielle Weiterleitung handelt. Einige Drittanbieter nutzen Reverse-Interfaces oder leiten Anfragen an andere Modelle um, was das Problem der „Drosselung“ verschärfen kann. Das von APIYI (apiyi.com) bereitgestellte gpt-6-astra ist die „Full-Power“-Version, die direkt über offizielle OpenAI- und Azure-Leitungen läuft. Die Schnittstellenparameter sind identisch mit dem Original und eignen sich daher hervorragend als stabile Ergänzung zu Ihrem Abonnement.
Schnelleinstieg in die gpt-6-astra API
gpt-6-astra unterstützt die Endpunkte Chat Completions, Responses und Batch. Die Eingabe unterstützt Text und Bilder, die Ausgabe erfolgt als Text. Das folgende minimalistische Beispiel verwendet das offizielle OpenAI-SDK; ersetzen Sie einfach base_url und den API-Schlüssel, um zu starten.
Minimalistisches Aufrufbeispiel für gpt-6-astra
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "Du bist ein erfahrener Backend-Entwickler. Antworte mit ausführbarem Code."},
        {"role": "user", "content": "Implementiere einen LRU-Cache mit Ablaufzeit in Python"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # Achten Sie auf prompt_tokens_details.cached_tokens
Vollständigen Code anzeigen: Kapselung mit Cache-Keys, Retry-Logik und Nutzungsstatistik
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Feste, lange System-Eingabeaufforderung am Anfang, um das Caching zu optimieren
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """Ruft gpt-6-astra mit fester Schlussfolgerungsstärke und Cache-Key auf"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"Eingabe {usage.prompt_tokens} | Cache {cached} "
                  f"| Trefferquote {hit_rate:.1%} | Ausgabe {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"Rate-Limit erreicht, erneuter Versuch in {wait} Sekunden")
            time.sleep(wait)
        except APIError as e:
            print(f"Schnittstellenfehler: {e}")
            time.sleep(1)
    raise RuntimeError("Fehler nach mehreren Versuchen")


if __name__ == "__main__":
    tasks = [
        "Überprüfe die Indexnutzung dieses SQL-Statements: SELECT ...",
        "Entwirf ein idempotentes Retry-Schema für den Bestellservice",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 Tipp für den Start: Wir empfehlen, den ersten Aufruf mit der Stufe
mediumzu testen und die Stufe je nach Aufgabenkomplexität schrittweise zu erhöhen. Sie können sich bei APIYI (apiyi.com) registrieren, um Testguthaben zu erhalten und die Ausgabequalität zu prüfen, bevor Sie produktive Aufgaben migrieren.
Wechsel auf gpt-6-astra API in Codex
Wenn Sie Astra hauptsächlich über das Codex CLI nutzen, müssen Sie Ihre Arbeit bei erschöpftem Kontingent nicht unterbrechen. Sie können in der Datei ~/.codex/config.toml einen benutzerdefinierten Modellanbieter konfigurieren und stattdessen Ihren API-Schlüssel verwenden:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Nach der Konfiguration führen Sie export APIYI_API_KEY=Ihr_Schlüssel aus und starten Codex neu. Sobald Ihr Abonnement-Kontingent zurückgesetzt wurde, können Sie den model_provider einfach auskommentieren, um zur ursprünglichen Anmeldemethode zurückzukehren. Beide Modi lassen sich je nach Bedarf wechseln.
Wie wählt man die richtige Schlussfolgerungsstärke für gpt-6-astra?
Die Stärke der Schlussfolgerung bestimmt direkt die Qualität, die Dauer und die Kosten. Es empfiehlt sich, die Stufe je nach Aufgabentyp anzupassen, anstatt sie pauschal auf das Maximum zu setzen.
| Schlussfolgerungsstärke | Typisches Szenario | Qualität | Dauer & Kosten |
|---|---|---|---|
| low | Formatkonvertierung, einfache Fragen, Extraktion | Grundbedarf gedeckt | Am niedrigsten |
| medium | Tägliche Code-Vervollständigung, Dokumentation | Ausgewogen | Niedrig |
| high | Komplexe Refactorings, Architekturdesign, Datenanalyse | Stabil & zuverlässig | Mittel |
| xhigh | Schwierige Bug-Suche, komplexe Agenten-Aufgaben | Nahe am Original-Erlebnis | Hoch |
| max | Mathematische Beweise, Sicherheitsaudits, wichtige Entscheidungen | Höchstes Niveau | Maximal (Aufrufhäufigkeit steuern) |
🎯 Empfehlung: Wenn Sie vermuten, dass die Abo-Version „gedrosselt“ wurde, können Sie kritische Aufgaben, die Sie normalerweise in ChatGPT ausführen, fest auf die Stufe
xhighsetzen. Bei Aufrufen über APIYI (apiyi.com) wird die Schlussfolgerungsstärke vollständig durch die Anfrageparameter bestimmt, was die Qualitätsunterschiede nachvollziehbar macht.
Kostenkontrolle und Optimierung der Cache-Trefferquote für gpt-6-astra
Der offizielle Preis für gpt-6-astra liegt bei 10 $ für die Eingabe und 50 $ für die Ausgabe (pro Million Tokens). Das ist ein Vielfaches des Einführungspreises von GPT-5.6 Sol, weshalb die Kostenkontrolle bei der Nutzung der API oberste Priorität haben muss. Die gute Nachricht: Der Preis für die Cache-Eingabe bei Astra beträgt nur 1 $, was einem Zehntel des Standard-Eingabepreises entspricht. Eine hohe Cache-Trefferquote macht sich daher direkt auf der Rechnung bemerkbar.
| Abrechnungsposten | Offizieller Preis (pro Mio. Tokens) | Erläuterung |
|---|---|---|
| Standard-Eingabe | 10 $ | Gilt bei Eingaben bis zu 272K Tokens |
| Cache-Lesen | 1 $ | Bei Treffern im Prompt-Cache, 90 % Ersparnis |
| Cache-Schreiben | 12,5 $ | Für neu geschriebene Cache-Präfixe, leicht über Standard-Eingabe |
| Standard-Ausgabe | 50 $ | Beinhaltet Inferenz-Tokens |
| Langer Kontext | 2x Eingabe/Cache, 1,5x Ausgabe | Wird bei Eingaben über 272K Tokens ausgelöst |
| Batch / Flex | 50 % des Standardpreises | Ideal für Aufgaben ohne Echtzeitanforderung |
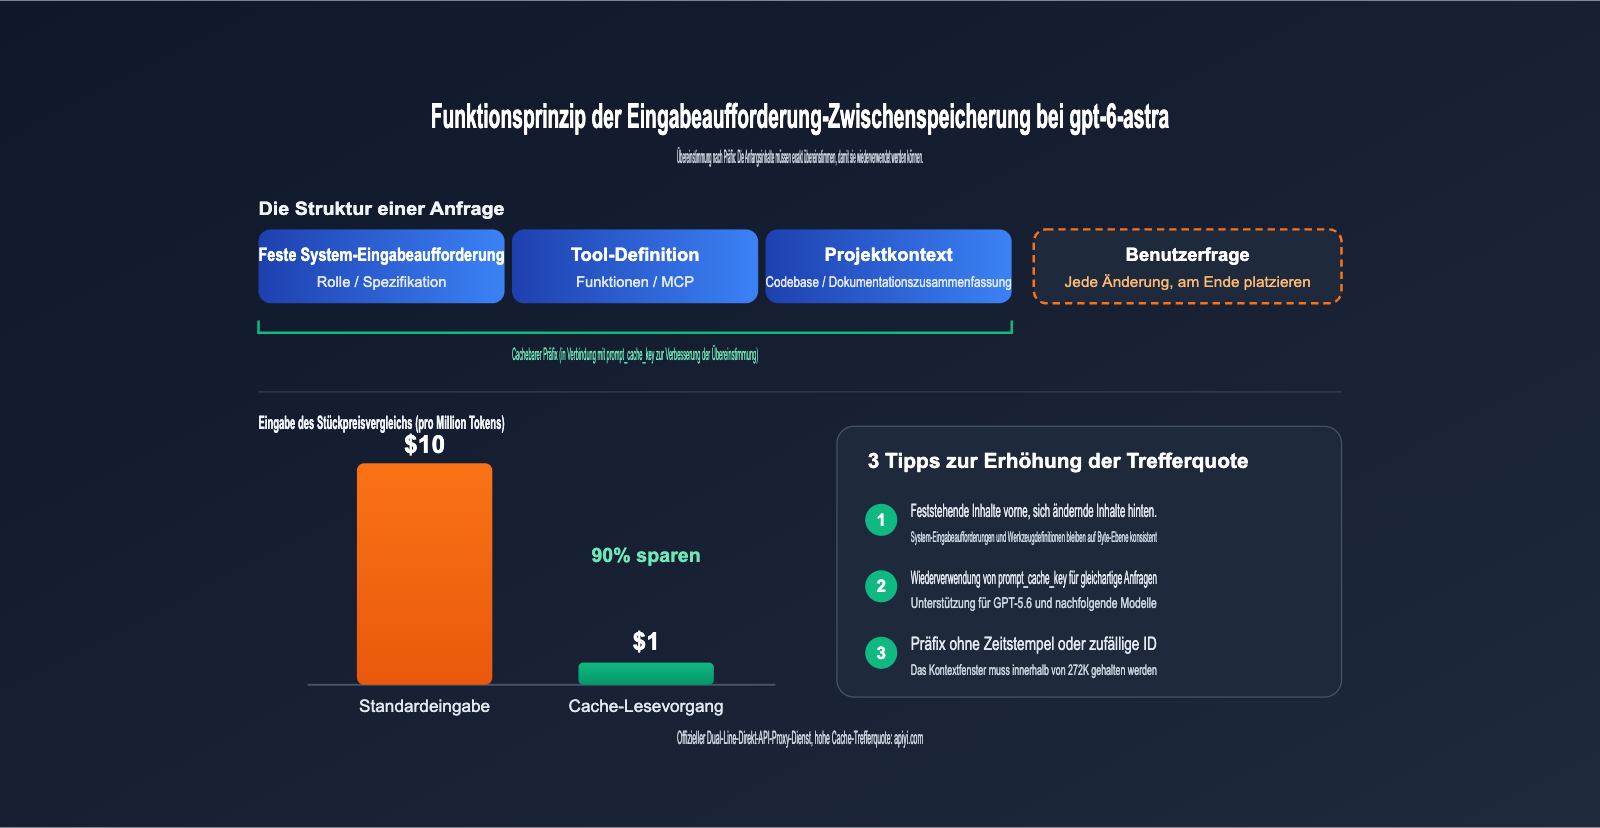
4 Tipps zur Steigerung der Cache-Trefferquote bei gpt-6-astra
Die Eingabeaufforderung-Zwischenspeicherung erfolgt über einen „Präfix“-Abgleich. Solange der Anfang der Anfrage identisch ist, können die vorherigen Berechnungsergebnisse wiederverwendet werden. Basierend auf diesem Mechanismus können Sie die Performance wie folgt optimieren:
- Feste Inhalte an den Anfang: System-Eingabeaufforderungen, Tool-Definitionen und Projektvorgaben sollten ganz am Anfang der Nachricht stehen, während sich ändernde Inhalte wie Benutzerfragen oder Zeitstempel am Ende platziert werden.
- Verwendung von
prompt_cache_key: Modelle ab GPT-5.6 unterstützen diesen Parameter. Durch die Verwendung desselben Cache-Schlüssels für Anfragen mit gemeinsamem langen Präfix lässt sich die Trefferwahrscheinlichkeit deutlich erhöhen. - Vermeidung dynamischer Werte im Präfix: Das Einfügen von aktuellen Zeitstempeln oder zufälligen IDs in die System-Eingabeaufforderung führt dazu, dass sich das Präfix bei jeder Anfrage ändert, wodurch der Cache sofort ungültig wird.
- Kontext unter 272K halten: Das Überschreiten dieses Schwellenwerts löst die Abrechnung für langen Kontext aus, wodurch sich auch die Kosten für das Cache-Lesen verdoppeln. Bei langen Dokumenten empfiehlt es sich, diese erst zu durchsuchen (Retrieval), bevor sie an das Modell gesendet werden.
Die Cache-Trefferquote hängt auch von der Stabilität der zugrunde liegenden Verbindung ab. Wenn Anfragen häufig zwischen verschiedenen Backends hin- und herwechseln, ist eine konsistente Cache-Nutzung schwierig. APIYI (apiyi.com) nutzt direkte Verbindungen über OpenAI- und Azure-Backends und bietet eine für gpt-6-astra optimierte, cache-freundliche Routenführung. Bei festen Präfixen erzielen Sie so eine hohe Trefferquote, die Sie direkt über das Feld cached_tokens in der Antwort überprüfen können.
Häufige Fragen zu gpt-6-astra: „Intelligenzverlust“ und Ersatzlösungen
Q1: Wurde gpt-6-astra von OpenAI wirklich „dümmer“ gemacht?
Es gibt derzeit keine offiziellen Beweise dafür, dass die Modellgewichte ausgetauscht wurden, und OpenAI hat dazu keine Stellungnahme abgegeben. Eine wahrscheinlichere Erklärung sind Änderungen bei der Zuweisung des Inferenzbudgets für Abonnenten, kombiniert mit der natürlichen Varianz der Modellausgabe. Wir empfehlen, die in diesem Artikel beschriebene 5-Schritte-Prüfung anzuwenden und das Modell mittels API-Festwerten zu vergleichen, bevor Sie voreilige Schlüsse ziehen.
Q2: Ist das gpt-6-astra-Modell über die API dasselbe wie in ChatGPT?
Ja, es handelt sich um dasselbe Modell. Der Unterschied besteht darin, dass Sie über die API die Inferenzstärke explizit festlegen können, während das Inferenzbudget bei Abonnement-Produkten von der Plattform gesteuert wird. APIYI (apiyi.com) bietet eine reine, offizielle und ungekürzte Version von gpt-6-astra an, bei der die Inferenzstärke exakt gemäß Ihren übermittelten Parametern ausgeführt wird.
Q3: Kann ich mein Abonnement-Guthaben und die API gleichzeitig nutzen?
Ja, beides ist unabhängig voneinander. Wir empfehlen, für die tägliche Interaktion weiterhin das Abonnement-Guthaben zu nutzen und bei Erschöpfung des Kontingents oder für Batch-Verarbeitungen auf die API zu wechseln. In Codex lässt sich dies schnell über die Konfigurationsdatei umschalten.
Q4: Ist die Nutzung der API als Ersatzlösung sehr teuer?
Das hängt von der Nutzung ab. Durch die Steuerung der Inferenzstufen, die Erhöhung der Cache-Trefferquote und das Auslagern nicht zeitkritischer Aufgaben in Batches lassen sich die Kosten um mehr als die Hälfte senken. Wir empfehlen, die Kosten pro Aufgabe zunächst mit einer kleinen Anzahl echter Anfragen über APIYI (apiyi.com) zu kalkulieren, bevor Sie den Umfang der Ersatzlösung festlegen.
Q5: Wie kombiniere ich gpt-6-astra am besten mit GPT-5.6 Sol?
Sol ist deutlich günstiger und eignet sich hervorragend für Routine-Codierung und Batch-Aufgaben. Astra spielt seine Stärken bei der Computerbedienung, komplexen Schlussfolgerungen und langen Agent-Ketten aus. Sie können Sol als Standardmodell verwenden und nur bei schwierigen Aufgaben auf Astra upgraden – so sichern Sie die Qualität bei gleichzeitig kontrollierten Kosten.
Fazit: Die Unsicherheit von gpt-6-astra in eine steuerbare Variable verwandeln
gpt-6-astra ist derzeit das leistungsfähigste Flaggschiff-Modell von OpenAI. Die Kontroverse um den „Intelligenzverlust“ und die Kontingentbeschränkungen nach dem Start verdeutlichen jedoch eine grundlegende Eigenschaft von Abonnement-Produkten: Das Inferenzbudget und die Nutzungsobergrenzen werden von der Plattform bestimmt, der Nutzer ist hier passiv. Anstatt darüber zu spekulieren, ob das Modell „dümmer“ geworden ist, sollten Sie lieber mit festen Eingabeaufforderungen und definierten Inferenzstufen Ihre eigene Qualitäts-Baseline etablieren.
In der Praxis empfiehlt sich ein Drei-Stufen-Plan: Zuerst die 5-Schritte-Prüfung nutzen, um zwischen Plattform-Steuerung, Modellvarianz und eigener Anwendung zu unterscheiden; dann bei erschöpftem Guthaben die API als Ersatz nutzen und kritische Aufgaben auf die Stufen high oder xhigh festlegen; schließlich die Kosten durch feste Präfixe, prompt_cache_key und Batches optimieren. So bleibt Ihr Workflow stabil, egal wie die Abonnement-Seite angepasst wird.
Wenn Sie einen stabilen Kanal für Ersatzlösungen suchen, empfehlen wir den Zugriff auf die ungekürzte gpt-6-astra-Version über APIYI (apiyi.com). Die Plattform bietet eine direkte Anbindung an OpenAI und Azure, ist vollständig kompatibel mit den offiziellen Schnittstellen und bietet hohe Cache-Trefferquoten – eine zuverlässige Ergänzung zu Ihren ChatGPT- und Codex-Abonnements.
Referenzen:
- OpenAI Modelldokumentation (gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI Hilfe-Center Astra-Nutzungshinweise: help.openai.com
- Decrypt-Bericht zur Astra-Kontroverse: decrypt.co
- Microsoft Foundry Dokumentation zum Prompt-Caching: learn.microsoft.com
- APIYI Modelldokumentation: docs.apiyi.com
Über den Autor: Das APIYI-Technikteam ist auf die API-Anbindung von großen Sprachmodellen und deren technische Implementierung spezialisiert. Wir laden Sie ein, sich über APIYI (apiyi.com) zu Optimierungen beim Modellaufruf und zur Kostenkontrolle von gpt-6-astra auszutauschen.